
文章内容
1. 先有硬件,才有软件——计算机体系结构
聊操作系统,如果一上来就讲进程、讲调度,其实是从半山腰开始爬。真正的起点在硬件——因为操作系统存在的全部意义,就是把一堆冷冰冰的硬件包装成程序员能用的东西。不先看清楚硬件长什么样,后面很多设计你只会觉得"它就是这样",而不知道"它为什么必须这样"。
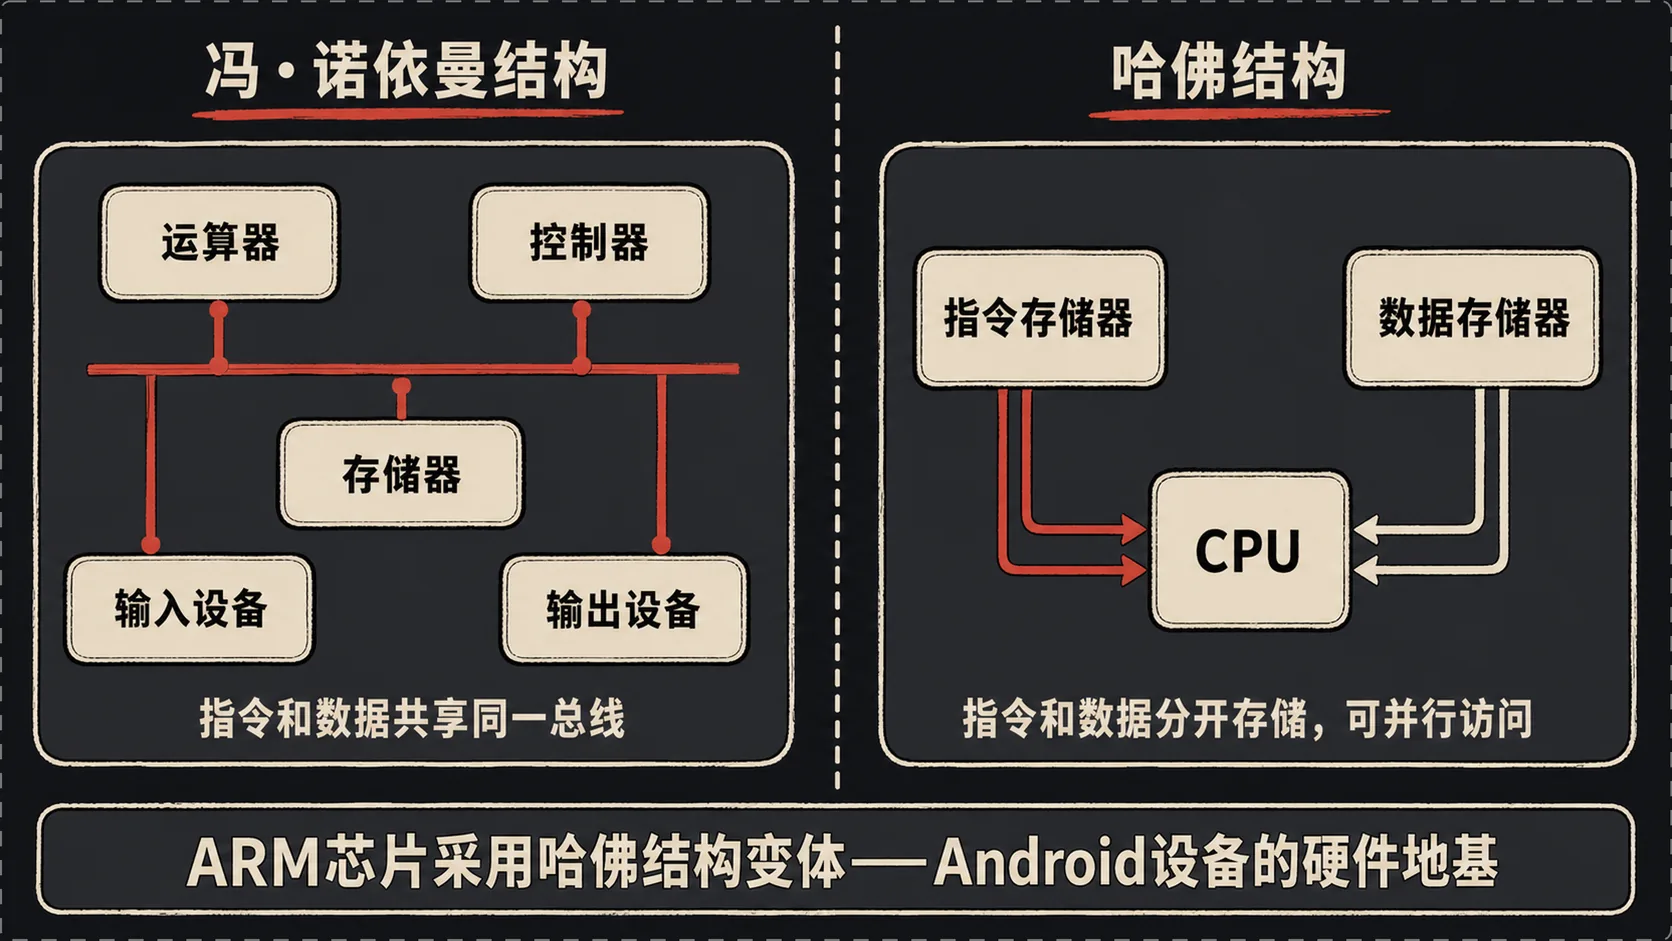
我们从 1945 年冯·诺依曼名字说起。他提出的冯·诺依曼结构,奠定了此后几乎所有通用计算机的骨架,核心就两条:
- 用二进制表示指令和数据;
- 程序存储(stored-program)——把要执行的指令,和指令要处理的数据,一视同仁地放在同一块存储器里。
在这个结构下,计算机被拆成五大部件:运算器、控制器、存储器、输入设备、输出设备。运算器加控制器合起来就是我们今天说的 CPU。这五个部件靠一组共享总线连在一起。CPU 干活的节奏永远是那个循环:从存储器取一条指令(取指)→ 看懂它要干嘛(译码)→ 执行 → 把结果写回。周而复始。
冯·诺依曼结构最漂亮的地方,是"指令和数据同等对待"带来的极大灵活性——程序可以像数据一样被读写、被加载、被生成,这才有了后来的编译器、加载器、虚拟机。但这份优雅也埋了一个先天的坎:指令和数据挤在同一条总线上。CPU 要取指令时,就没法同时取数据;取数据时,就没法同时取指令。这就是有名的"冯·诺依曼瓶颈"——总线成了独木桥。
怎么破?答案是哈佛结构。它的思路很直接:既然一条总线不够用,那就修两条。指令存储器和数据存储器彻底分开,各走各的总线,于是取指令和取数据可以在同一个时钟周期里并行进行。代价是硬件更复杂、成本更高,但换来了吞吐量的实打实提升。
这跟 Android 有什么关系? Android 设备用的绝大多数是 ARM 架构的 SoC,而现代 ARM 内核(Cortex 系列)采用的是哈佛结构的变体——严格说是"改进型哈佛结构":在离 CPU 最近的 L1 缓存这一级,指令缓存(I-Cache)和数据缓存(D-Cache)是分开的两块,各自独立通道;但再往下到 L2、主存,又统一成一块物理内存(冯·诺依曼式)。这是一种务实的折中:既拿到哈佛结构在缓存层的并行红利,又保留了冯·诺依曼结构"指令数据同一存储"带来的编程灵活性(否则 JIT、动态加载这些都没法做)。
理解这一层,才能回答一个很多人含糊带过的问题:bionic 为什么不直接用 glibc? 一部分原因就在体系结构这里。glibc 是为桌面/服务器上的 x86 生态几十年打磨出来的,历史包袱重、体积大,很多为 CISC 指令集、为大内存环境做的优化,搬到 ARM 上并不划算。Android 干脆重写了一套 libc——bionic,从一开始就是为 ARM、为移动设备的资源约束量身定制的:更小的体积、更贴合 ARM 缓存行为的内存布局、直接内建对系统属性和 linker 命名空间的支持。当然,体系结构只是原因之一,许可证(glibc 的 LGPL 对静态链接不友好,bionic 用 BSD)和定制需求也是重要因素,这个后面还会提。
事实与推断的边界:ARM 采用改进型哈佛结构、Android 主要跑在 ARM 上,这些是事实。"bionic 不用 glibc 主要是因为哈佛结构"——这是过度简化,准确说法是"体系结构 + 体积 + 许可证 + 定制"多因素共同作用,我在下文会拆开讲。
2. 操作系统的本质——硬件大管家
有了硬件的底子,我们给操作系统一个尽量精确的定义:操作系统是一组管理硬件资源、并向上层软件提供统一编程接口的软件集合。 它干两个方向的活。
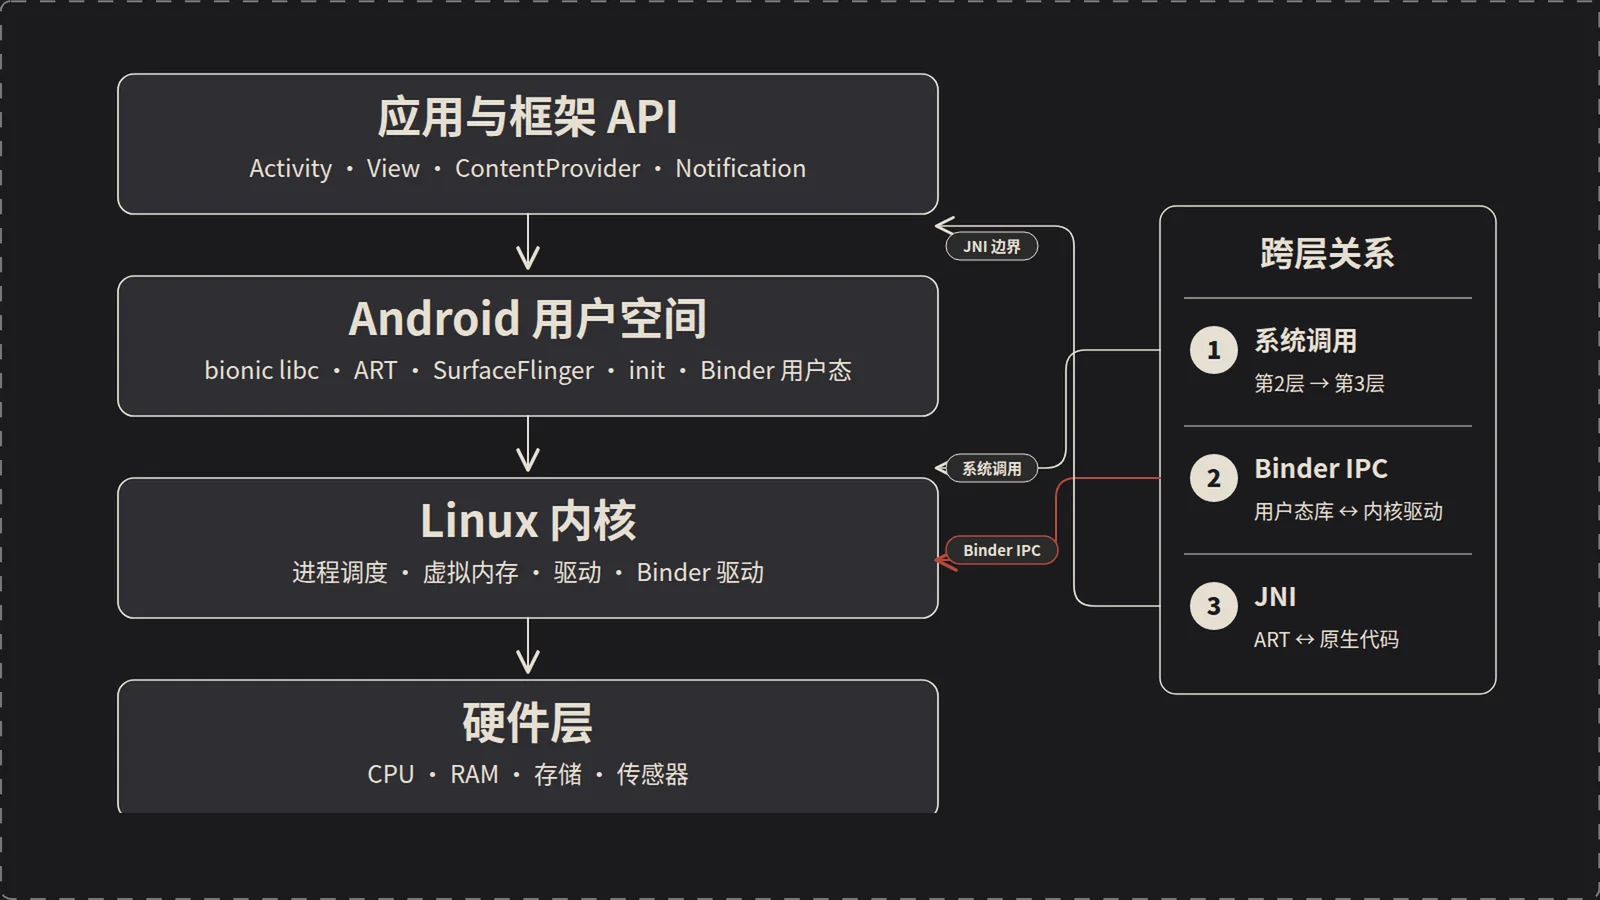
向下,它管理硬件。 CPU 只有那么几个核,但系统里跑着几百个进程,谁先跑、跑多久、什么时候被打断换下——这是CPU 调度。物理内存就那么大,每个进程都觉得自己独占一大片地址空间——这是内存管理。磁盘、屏幕、传感器速度天差地别,怎么协调——这是 I/O 控制。这些资源如果放任程序自己抢,系统瞬间就乱套了,所以必须有一个"大管家"统一分配。
向上,它提供服务。 应用程序不会(也不该)直接去操作硬件寄存器。它通过系统调用(open、read、write、mmap、ioctl……)向内核请求服务,内核在特权态里替它完成危险操作,再把结果交回来。系统调用之上,还有一层层的库和框架 API,最终包装成 App 开发者调的那个 Activity、那个 View。
那么,Android 为什么选 Linux 内核当这个大管家? Google 当年的工程负责人 Patrick Brady 在 2008 年那场著名的 Android 架构演讲里,给过五条理由,到今天看依然成立:
- 成熟的内存与进程管理——现成的、经过海量生产环境验证的调度器和 MM 子系统;
- 基于权限的安全模型——Linux 的 UID/GID 机制,Android 直接拿来给每个 App 分配独立 UID 做沙箱隔离;
- 成熟的驱动模型——庞大的驱动生态,硬件厂商适配成本低;
- 共享内存等 IPC 基础设施——虽然 Android 后来自己搞了 Binder,但底层仍建立在内核提供的能力上;
- 开源——可自由裁剪、修改,且社区活跃。
但这里要纠正一个普遍的误解:Android 不是"在 Linux 上跑 Java 程序"。 它借用了 Linux 内核,可用户空间几乎是推倒重写的。你在一台 Android 手机里,找不到 glibc(换成了 bionic)、找不到 GNU coreutils(换成了 toolbox/toybox)、找不到 systemd(换成了 Android 自己的 `system/core/rootdir/init.rc` 驱动的 init)、找不到 X11(换成了 SurfaceFlinger)。内核之上,Android 是另起炉灶的一套操作系统。 这也是为什么把 Android 简单归为"Linux 发行版"是不准确的。
想清楚了"操作系统在管什么",接下来这篇文章就沿着操作系统最核心的三大机制——进程间通信、同步、内存管理——一路往下拆,每讲一个经典原理,就立刻看 Android 12 在它的基础上做了什么改造。这就是本文的主线:经典 OS 原理 → Android 12 的实现与特化。
3. 进程间通信——为什么进程不能直接说话
先问个最朴素的问题:两个进程为什么不能直接读对方的内存、直接"说话"?
因为内存保护。这是操作系统给每个进程画的牢笼——进程 A 的地址空间和进程 B 的地址空间被 MMU 隔离得死死的,A 拿着自己的指针去访问 B 的地址,硬件直接给你一个段错误(Segfault)。这道墙是安全和稳定的基石(一个进程崩了不会带崩别人),但也带来了必须解决的问题:进程之间确实需要交换数据,怎么办?答案就是操作系统提供的一组进程间通信(IPC) 机制。经典的有这么四类。
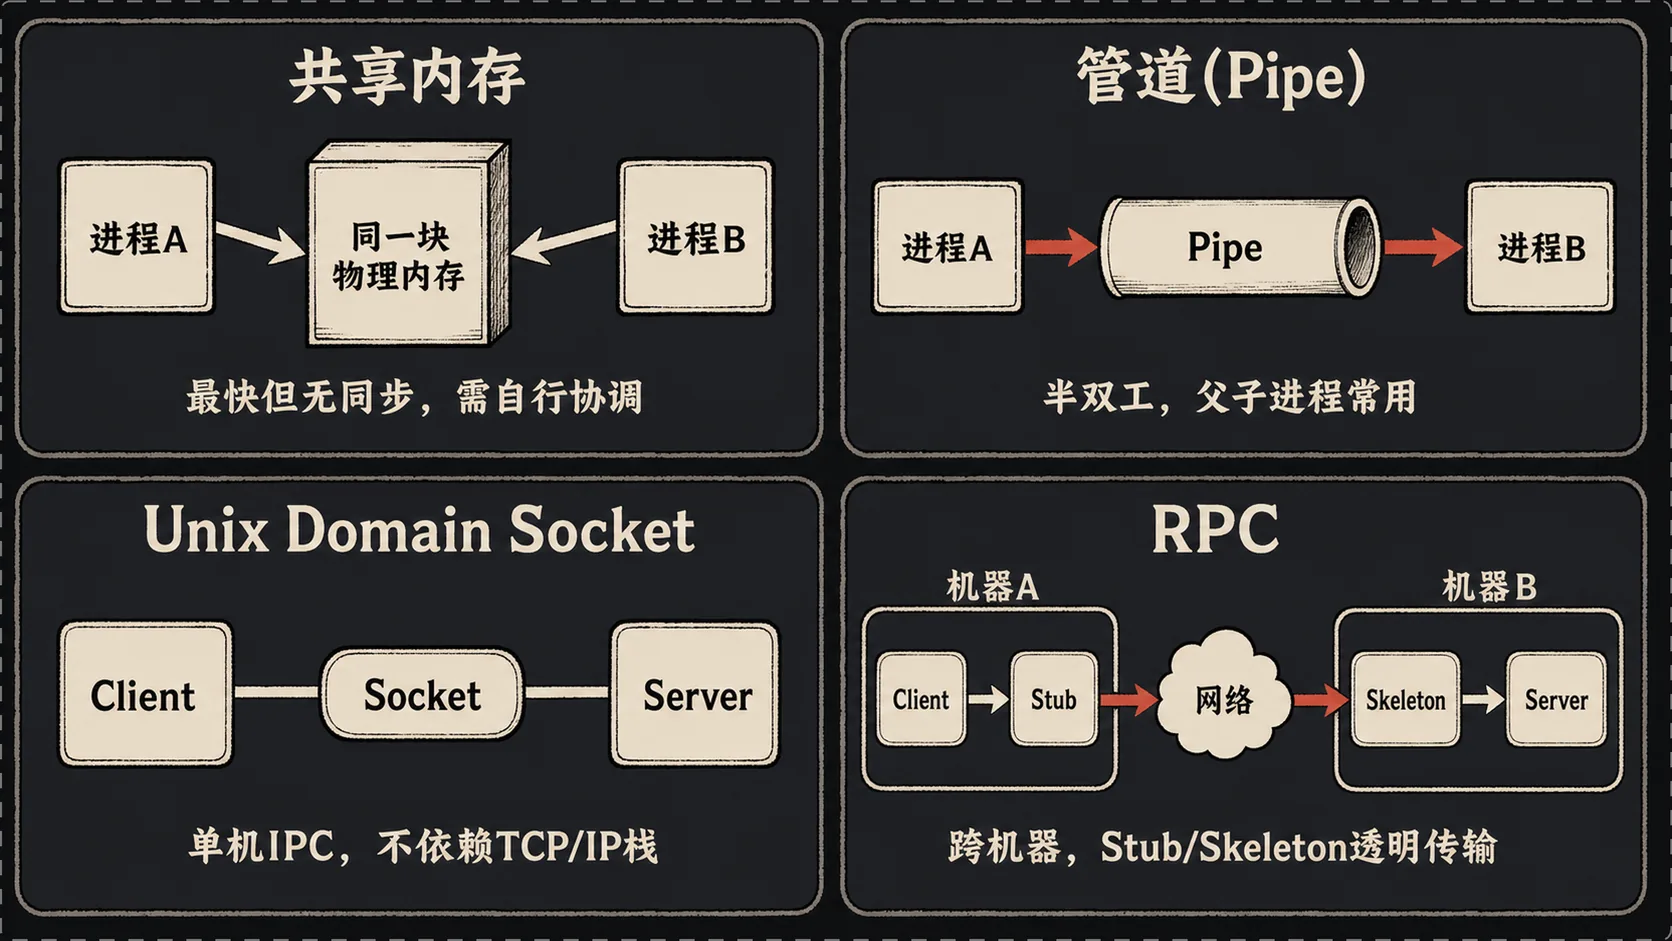
3.1 共享内存(Shared Memory)。 思路最直接:既然墙隔开了两块地址空间,那就在墙上开一扇"公共窗口"——让两个进程各自把同一块物理内存映射到自己的地址空间里。System V 的一套接口是这个流程:shmget 创建/获取一块共享内存段 → shmat(attach)把它映射进自己的地址空间 → 直接像访问普通内存一样读写 → shmdt(detach)解除映射 → shmctl 做控制/销毁。
共享内存的优点无可替代:它是最快的 IPC,数据不用在内核和用户空间之间来回拷贝,两个进程读写的就是同一份物理内存,零拷贝。但它有个致命短板:它只管"共享",不管"同步"。A 正在写、B 同时在读,读到写一半的脏数据怎么办?共享内存本身一句话都不说。所以它几乎从不单独使用,永远要配一套同步机制(信号量、互斥锁)来协调访问——见第 4 节。
下面的程序把这条链路缩小到一个可运行的 System V 示例:父进程创建一段共享内存,把一把 PTHREAD_PROCESS_SHARED 互斥锁也放进去;fork() 后父子进程各自对同一个计数器加 10 000 次。没有这把锁,最终值可能小于 20 000;有锁时,两个进程的修改不会互相覆盖。可用 cc shared_counter.c -pthread && ./a.out 编译运行。
// shared_counter.c:System V 共享内存 + 进程共享 pthread mutex。#include <errno.h>#include <pthread.h>#include <stdio.h>#include <stdlib.h>#include <sys/shm.h>#include <sys/wait.h>#include <unistd.h> enum { kIterations = 10000 }; // 这整个结构体位于共享内存中;因此两个进程看到的是同一把锁、同一个 counter。typedef struct { pthread_mutex_t lock; int counter;} SharedState; static void die(const char* message) { perror(message); exit(EXIT_FAILURE);} static void add_many_times(SharedState* state) { for (int i = 0; i < kIterations; ++i) { // 加锁、修改、解锁构成临界区,不能只保护其中某一步。 if (pthread_mutex_lock(&state->lock) != 0) die("pthread_mutex_lock"); ++state->counter; if (pthread_mutex_unlock(&state->lock) != 0) die("pthread_mutex_unlock"); }} int main(void) { // IPC_PRIVATE 保证这是本次运行独有的内存段;0600 限制为当前用户可读写。 int shmid = shmget(IPC_PRIVATE, sizeof(SharedState), IPC_CREAT | 0600); if (shmid == -1) die("shmget"); SharedState* state = shmat(shmid, NULL, 0); if (state == (void*)-1) die("shmat"); pthread_mutexattr_t attr; if (pthread_mutexattr_init(&attr) != 0) die("pthread_mutexattr_init"); // 默认锁只能在一个进程内使用;这个属性让锁的等待队列对多个进程可见。 if (pthread_mutexattr_setpshared(&attr, PTHREAD_PROCESS_SHARED) != 0) { die("pthread_mutexattr_setpshared"); } if (pthread_mutex_init(&state->lock, &attr) != 0) die("pthread_mutex_init"); pthread_mutexattr_destroy(&attr); state->counter = 0; pid_t pid = fork(); if (pid == -1) die("fork"); if (pid == 0) { add_many_times(state); // 子进程通过自己的虚拟地址映射同一物理页。 shmdt(state); // 子进程只解除自己的映射,不销毁该内存段。 _exit(EXIT_SUCCESS); } add_many_times(state); // 父进程并发执行同样的操作。 if (waitpid(pid, NULL, 0) == -1) die("waitpid"); printf("counter = %d(期望值 %d)\n", state->counter, 2 * kIterations); pthread_mutex_destroy(&state->lock); shmdt(state); // 解除父进程映射。 shmctl(shmid, IPC_RMID, NULL); // 标记删除;最后一个 attach 者离开后内核回收。 return EXIT_SUCCESS;}3.2 管道(Pipe)。 pipe() 系统调用一次给你两个文件描述符:一个读端、一个写端。数据从写端进、读端出,像一根真实的水管。特点是单向、半双工、有容量限制(内核缓冲区满了写端就阻塞)。匿名管道只能用在有亲缘关系的进程之间(父子进程,靠 fork 继承 fd),想在无关进程间用就得上命名管道(FIFO)。管道简单可靠,Shell 里的 a | b 就是它,但它是字节流、无消息边界,且吞吐和灵活性都一般。
3.3 Unix Domain Socket(UDS)。 名字里有 Socket,但它不走 TCP/IP 协议栈——数据不经过网卡、不做协议封装,纯粹在内核里从一个进程的缓冲搬到另一个进程的缓冲。所以它比走本地回环(127.0.0.1)的 Network Socket 快得多,同时又保留了 Socket 那套成熟的编程模型(Client-Server、socketpair 造一对全双工的连接)。而且它还能通过辅助数据(SCM_RIGHTS)在进程间传递文件描述符。这个能力后面在 Android 里会反复出现——Zygote 和 AMS 之间就是用 UDS 通信的。
3.4 RPC(远程过程调用)。 前三种是单机内的,RPC 面向的是跨机器:让你像调本地函数一样去调另一台机器上的函数。核心是 Stub/Skeleton 模型——客户端调本地的 Stub(存根),Stub 负责把参数打包(序列化/marshal)、通过网络发出去;服务端的 Skeleton 收到后解包、调真正的实现、再把结果原路送回。调用者感觉不到网络的存在。RPC 的思想极其重要,因为它把"跨越边界的调用"抽象成了"普通的方法调用"——记住这个抽象,因为 Android 的 Binder 本质上就是一套单机内的、内核加持的 RPC。
那 Android 选了哪个?都没选,它自己造了个 Binder。 为什么?简单说:
- 共享内存快但不安全、没有身份;管道太简陋;
- UDS 通用但要两次拷贝、且没有内建的对象化调用模型;
- RPC 的模型好但传统实现面向网络、太重。
移动设备要的是一个**又快(尽量少拷贝)、又安全(能验证调用方 UID/PID)、又好用(面向对象、支持传 fd、支持死亡通知)**的 IPC。Binder 就是把 RPC 的调用模型、共享内存的高效、以及内核背书的身份校验揉在一起的产物。Binder 的完整实现在 `frameworks/native/libs/binder/`,一次调用从客户端的 `BpBinder::transact` 出发,经 `IPCThreadState::talkWithDriver` 里的ioctl(mDriverFD, BINDER_WRITE_READ, &bwr)陷入内核驱动,最终落到服务端的 `BBinder::onTransact`。Binder 值得单独一篇长文,这里先记住它在 IPC 家谱里的位置和取舍逻辑。
4. 同步机制——多进程/多线程的"交通规则"
共享内存只管共享、不管同步。本章节主要讲下"同步"。打个比方:如果说多个执行流是路上跑的车,那同步机制就是红绿灯和交规——没有它,共享资源这个十字路口必然连环追尾。
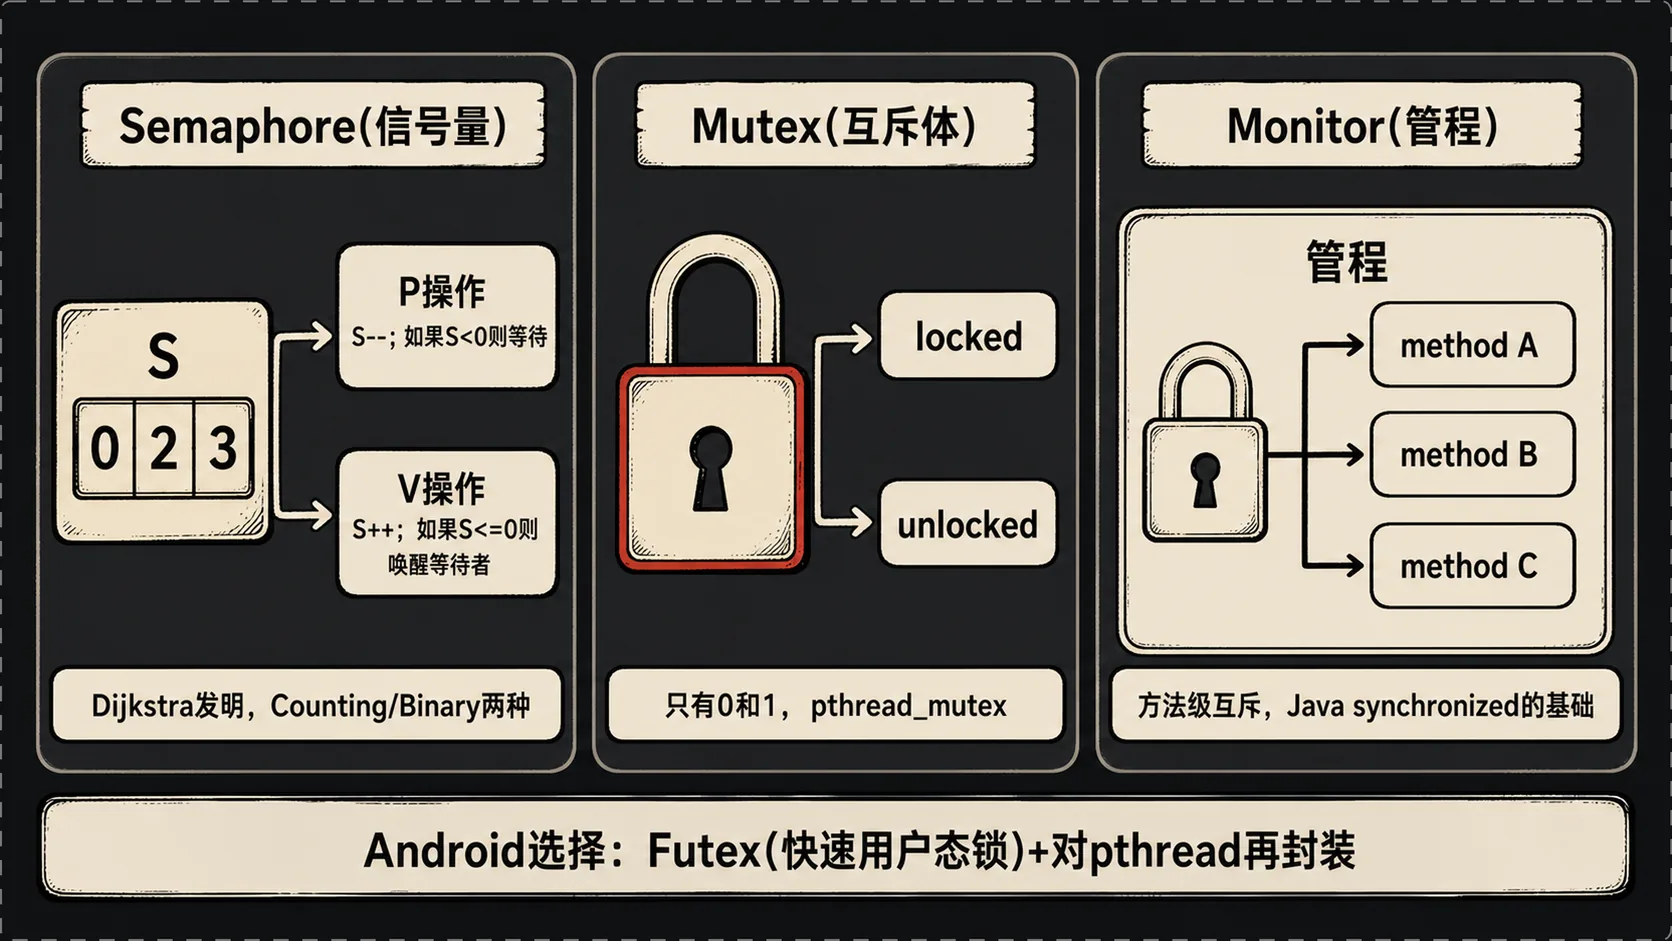
4.1 信号量(Semaphore)。 这是 Dijkstra 提出的鼻祖级同步原语,核心是一个整数计数器 S 和两个原子操作:
- P 操作(也叫 wait/down):
S = S - 1;如果减完S < 0,说明资源不够,当前执行流阻塞等待。 - V 操作(也叫 signal/up):
S = S + 1;如果加完S <= 0,说明有人在等,唤醒一个。
P/V 必须是原子的(不可被打断),这是信号量能工作的前提。按 S 的取值范围分两种:计数信号量(Counting Semaphore),S 可以是任意非负数,用来管理"有 N 份的资源"(比如连接池有 10 个连接);二元信号量(Binary Semaphore),S 只有 0 和 1,用来实现互斥——这就退化成了下面的 Mutex。
4.2 互斥锁(Mutex)。 只有"锁上(0)"和"打开(1)"两个状态,pthread_mutex_lock 拿锁、pthread_mutex_unlock 放锁。它和二元信号量看着像,但有个关键区别:Mutex 讲究"所有权"——谁锁的必须谁来解,而信号量没有所有者概念,A 锁的 B 可以解。所以 Mutex 更适合保护"临界区"(一段同一时刻只能一个线程进的代码),而信号量更适合表达"资源计数"或"事件通知"。
4.3 管程(Monitor)。 信号量好用但太底层、太容易出错——P 和 V 必须严格配对,少写一个或写反顺序,就是死锁或数据竞争,而且这种 bug 极难复现。管程是对它的工程化改进:把共享数据和操作它的方法封装在一起,并由编译器/运行时保证同一时刻只有一个线程能进入管程的方法(方法级互斥)。程序员不用手动 P/V,只管调方法,互斥由管程自动保证。Java 的 synchronized 关键字就是管程思想的体现——你锁的是对象,进入 synchronized 方法/块时自动获得对象锁,退出时自动释放。
4.4 Futex(Fast Userspace muTEX)。 前面几种如果每次加解锁都要陷入内核,开销就太大了——绝大多数时候锁根本没有竞争,为一次"顺畅通过绿灯"也去惊动内核,太浪费。Futex 是 Linux 给出的漂亮答案,它的精髓一句话:无竞争时完全在用户态用一条原子指令搞定,根本不进内核;只有真的发生了竞争、需要把线程挂起排队时,才通过 futex() 系统调用陷入内核让内核帮忙。 这样把绝大多数"快路径"留在用户态,只把少数"慢路径"交给内核。今天 Linux/Android 上你用的 pthread_mutex、各种高级锁,底层几乎都是 Futex。
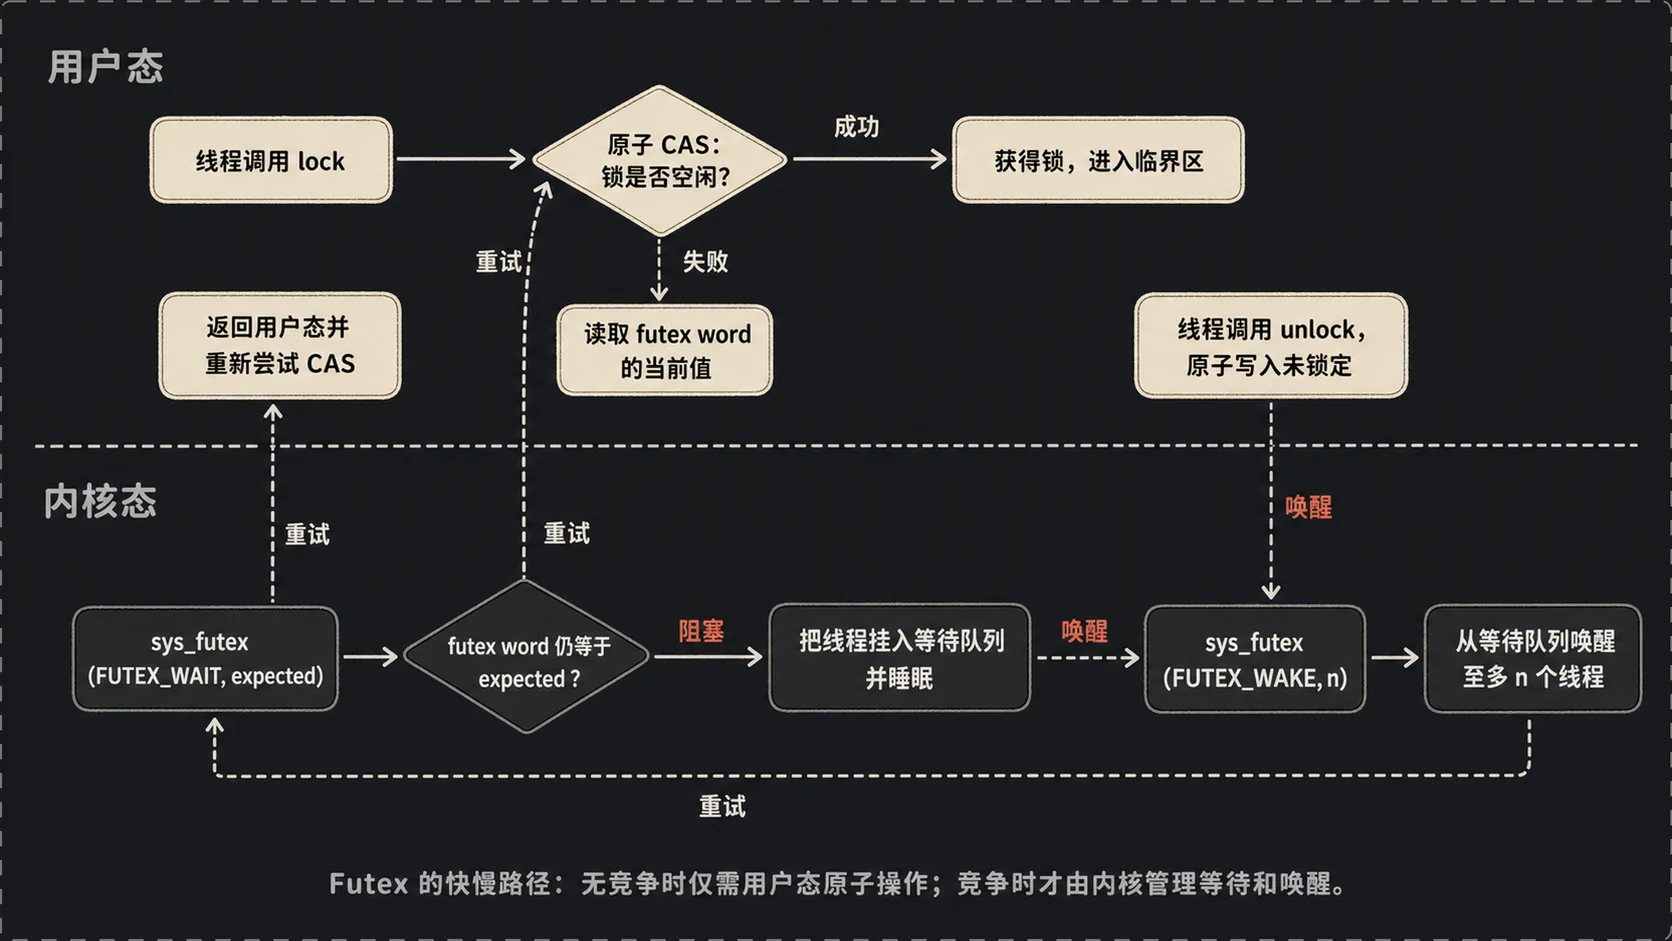
Futex 的快慢路径:无竞争时仅需用户态原子操作;竞争时才由内核管理等待和唤醒。
CAS 是锁算法在用户态使用的原子比较并交换;Futex 内核只以一个共享内存地址(futex word)为键管理等待者,并不知道更高层锁的所有权、递归等策略。
FUTEX_WAIT会先在内核中再次比较该值:值已变化时立即返回,从而避免"先检查、后睡眠"之间丢失唤醒;被FUTEX_WAKE唤醒也不等于已经拿到锁,必须回到用户态重新竞争。
4.5 经典的生产者-消费者问题。
mutex(二元,初值 1):保护缓冲区本身的互斥访问;empty(计数,初值 = 缓冲区容量 N):表示还有多少空位,生产者 P 它、消费者 V 它;full(计数,初值 0):表示已有多少产品,消费者 P 它、生产者 V 它。
生产者流程:P(empty) → P(mutex) → 放入 → V(mutex) → V(full)。消费者对称。注意两个信号量的加锁顺序不能乱——先抢资源信号量(empty/full)再抢互斥锁(mutex),反了就可能死锁。这个例子把"计数"和"互斥"两种同步需求同时演示了,值得记牢。
下面给出一个完整的 C++20 实现。emptySlots 和 filledSlots 分别对应上文的 empty、full;std::mutex 对应 mutex。程序生产、消费 20 个整数,末尾用一个特殊值让消费者干净退出。可用 c++ -std=c++20 producer_consumer.cpp -pthread && ./a.out 编译运行。
// producer_consumer.cpp:三个同步原语协作实现有界队列。#include <array>#include <chrono>#include <iostream>#include <mutex>#include <semaphore>#include <thread> constexpr int kCapacity = 4;constexpr int kStop = -1; // 不会作为正常产品出现,专门通知消费者退出。 class BoundedBuffer {public: void put(int value) { emptySlots_.acquire(); // P(empty):没有空位时在这里阻塞。 { std::lock_guard<std::mutex> guard(mutex_); // P(mutex),作用域结束自动 V(mutex)。 data_[writeIndex_] = value; writeIndex_ = (writeIndex_ + 1) % kCapacity; } filledSlots_.release(); // V(full):发布一个可消费的元素。 } int take() { filledSlots_.acquire(); // P(full):队列为空时在这里阻塞。 int value; { std::lock_guard<std::mutex> guard(mutex_); value = data_[readIndex_]; readIndex_ = (readIndex_ + 1) % kCapacity; } emptySlots_.release(); // V(empty):归还一个空槽位。 return value; } private: std::array<int, kCapacity> data_{}; int readIndex_ = 0; int writeIndex_ = 0; std::mutex mutex_; // 只保护数组和两个下标。 std::counting_semaphore<kCapacity> emptySlots_{kCapacity}; std::counting_semaphore<kCapacity> filledSlots_{0};}; int main() { BoundedBuffer buffer; std::thread producer([&] { for (int value = 0; value < 20; ++value) { buffer.put(value); std::cout << "produce " << value << '\n'; } buffer.put(kStop); // 正常数据结束后再投递退出信号。 }); std::thread consumer([&] { for (;;) { int value = buffer.take(); if (value == kStop) break; std::cout << "consume " << value << '\n'; std::this_thread::sleep_for(std::chrono::milliseconds(10)); } }); producer.join(); consumer.join();}5. Android 的同步机制
Android 12 里同步机制分两个世界:一个是 C++ 世界(libutils 和各种 native 组件用的),一个是 ART 虚拟机内部用的(服务于 Java 线程和 GC)。
5.1 Mutex——对 pthread_mutex 的薄封装`system/core/libutils/include/utils/Mutex.h`。这个 android::Mutex 类本质就是把 pthread_mutex_t 包一层 C++ 外壳:
class CAPABILITY("mutex") Mutex { public: enum { PRIVATE = 0, SHARED = 1 }; Mutex(); explicit Mutex(int type, const char* name = nullptr); status_t lock() ACQUIRE(); void unlock() RELEASE(); status_t tryLock() TRY_ACQUIRE(0); ... private: pthread_mutex_t mMutex;};构造函数里支持 PRIVATE 和 SHARED 两种类型:
inline Mutex::Mutex(int type, __attribute__((unused)) const char* name) { if (type == SHARED) { pthread_mutexattr_t attr; pthread_mutexattr_init(&attr); pthread_mutexattr_setpshared(&attr, PTHREAD_PROCESS_SHARED); pthread_mutex_init(&mMutex, &attr); pthread_mutexattr_destroy(&attr); } else { pthread_mutex_init(&mMutex, nullptr); }}其中比较关键的是 PTHREAD_PROCESS_SHARED 这个属性——它让这把锁可以放在共享内存里、给多个进程共用。共享内存负责"共享数据",一把 PROCESS_SHARED 的 Mutex 放在同一块共享内存里负责"同步访问",两者配合,跨进程的安全共享就成立了。
第二个要点,得诚实说明版本现状:这个类头上明明白白写着注释——"其用法已弃用(deprecated),不为 Win32 构建的新代码应改用 std::mutex 和 std::lock_guard"。所以在 Android 12 里,android::Mutex 是历史遗留的封装,大量老代码还在用,但新代码 Google 推荐直接用 C++ 标准库。老教材里把它当"Android 首选锁"来讲是有时代局限的。
5.2 Condition——搭配 Mutex 使用的条件变量。 `system/core/libutils/include/utils/Condition.h`。条件变量解决的是"等待某个条件成立":wait(mutex) 会原子地释放传入的锁并让线程睡下,被 signal()(唤醒一个)或 broadcast()(唤醒全部)叫醒后再重新拿回锁。它必须和 Mutex 搭配,因为"检查条件"和"睡下等待"这两步之间不能有缝隙,否则会丢失唤醒信号。这个头文件同样开门见山写着 // DO NOT USE: please use std::condition_variable instead——和 Mutex 一样,是弃用状态。注释里还特别提醒:被唤醒后必须重新检查条件谓词(predicate),因为存在虚假唤醒(spurious wake-up)。这是条件变量的经典坑,写法上永远要用 while (条件不满足) cond.wait(mutex); 而不是 if。
5.3 Barrier。 很多讲 Android 同步的老资料(包括《深入理解 Android 内核设计思想》)会讲一个 Barrier 类,说它是"Condition 的实例化",用于"栅栏"式同步——一堆线程都到齐了才一起放行,或者一个线程等另一个线程完成某件事。但要如实说明:在我检出的 Android 12 AOSP 主树里,libutils 下已经没有一个独立通用的 android::Barrier 类了(早年 SurfaceFlinger 里有过一个私有的小 Barrier 实现,后来被重构掉)。所以与其去引一个不存在的类,不如讲清楚它的模式:栅栏本质就是"一个布尔状态 + 一个 Condition + 一把 Mutex"——状态没开时 wait,某个线程把状态置为"开"并 broadcast,所有等待者被放行。理解了 Condition,你随手就能拼出一个 Barrier。这是原理比具体类更重要的典型例子。(版本注:如需在新代码里用栅栏,C++20 提供了 std::barrier/std::latch。)
5.4 Autolock——用 RAII 自动加解锁。 还是在 Mutex.h 里,有个嵌套类 Mutex::Autolock:
class SCOPED_CAPABILITY Autolock { public: inline explicit Autolock(Mutex& mutex) ACQUIRE(mutex) : mLock(mutex) { mLock.lock(); } inline ~Autolock() RELEASE() { mLock.unlock(); } private: Mutex& mLock;};这是 C++ RAII 思想的教科书式应用。 构造时自动 lock(),析构(离开作用域)时自动 unlock()。它彻底解决了手动加解锁最容易犯的错——中间 return 了、抛异常了,忘了解锁导致死锁。有了 Autolock,你只要 Mutex::Autolock _l(mMutex); 一行,这个函数从此往下到作用域结束都被这把锁保护,出去的任何路径都自动放锁。这跟 C++ 标准库的 std::lock_guard 是一个思想。
5.5 ReaderWriterMutex——ART 的读写锁。 前面都是"一把锁一次只让一个人进",但很多场景是"读多写少":一份数据大量线程只读、偶尔有人写。全用互斥锁就太亏了——多个只读的线程明明可以并发,却被迫排队。读写锁就是为此而生:允许多个读者同时持有(Shared),但写者独占(Exclusive)。ART 里的实现在 `art/runtime/base/mutex.h`,它的注释画了一张极清晰的状态转移表:
// State | ExclusiveLock | ExclusiveUnlock | SharedLock | SharedUnlock// ----------------------------------------------------------------------------// Free | Exclusive | error | SharedLock(1) | error// Exclusive | Block | Free | Block | error// Shared(n) | Block | error | SharedLock(n+1)* | Shared(n-1) or Free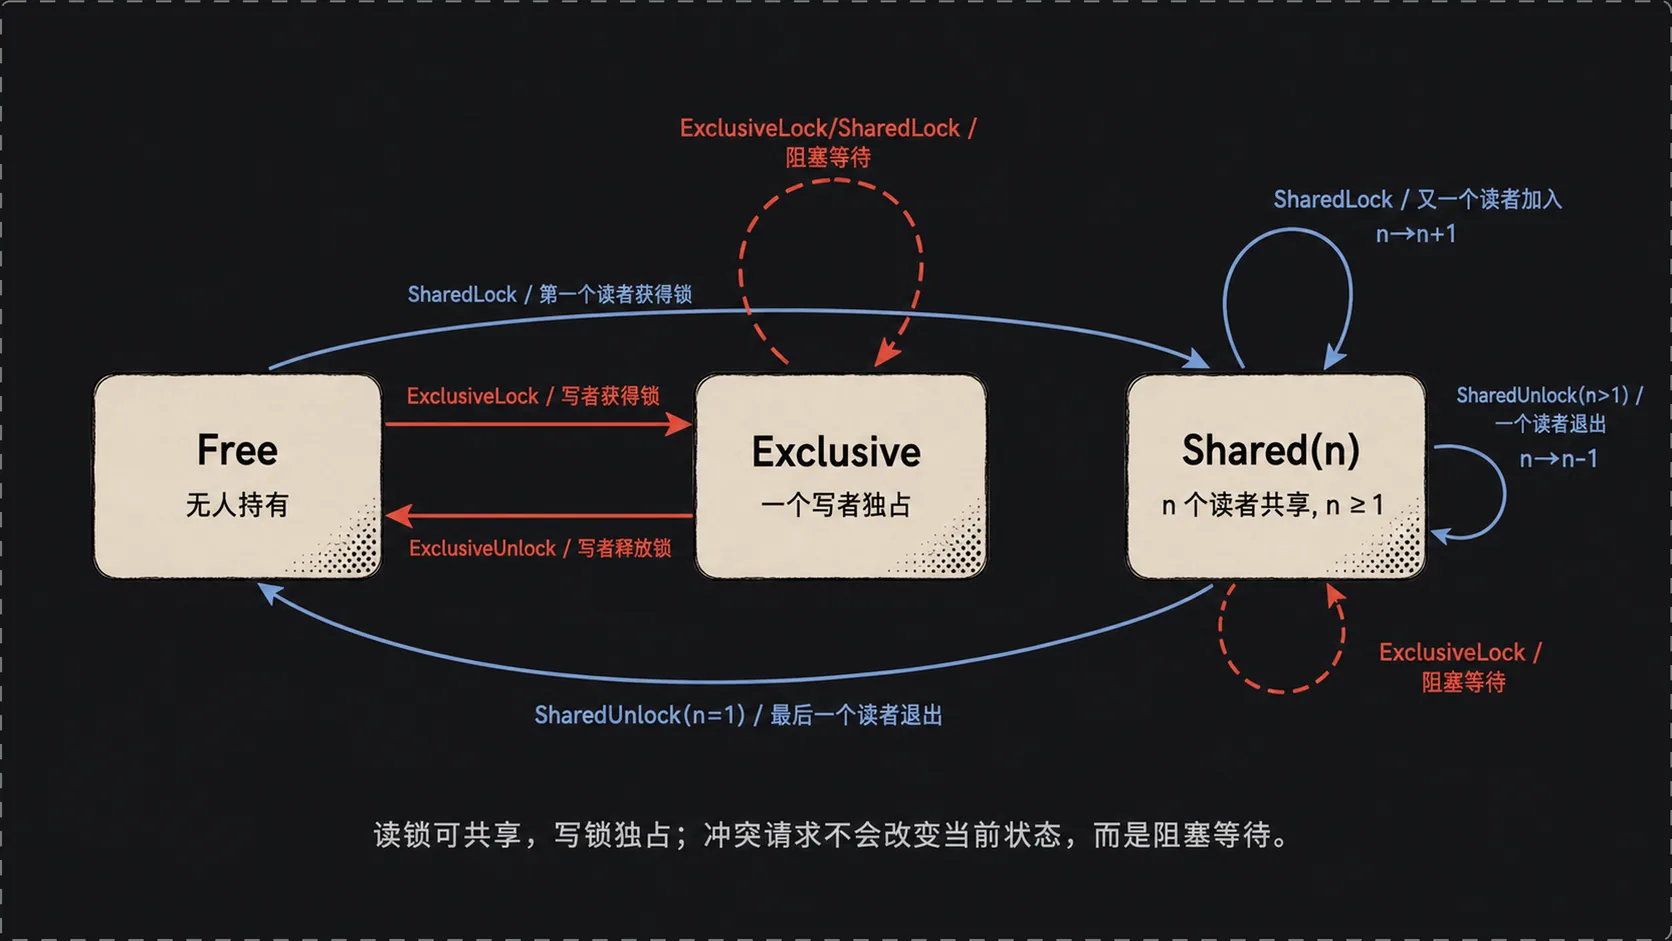
ReaderWriterMutex 的状态流转:读锁可共享,写锁独占;冲突请求不会改变当前状态,而是阻塞等待。
这张表证明了读写锁的核心语义: 三种状态——Free(无人持有)、Exclusive(一个写者独占)、Shared(n)(n 个读者共享)。从 Free 可以进入 Exclusive(一个写者)或 Shared(1)(第一个读者);处于 Shared(n) 时,再来读者就变 Shared(n+1),但来写者只能 Block(等所有读者退出);处于 Exclusive 时,无论来读来写都得 Block。ART 大量用它保护虚拟机的全局数据结构(比如堆、类表),因为这些数据读远多于写。
5.6 ART_USE_FUTEXES——回到 Futex。 上面这些 ART 的锁,底层怎么实现的?答案就是第 4.4 节讲的 Futex。看 `art/runtime/base/mutex.cc` 里 Mutex::ExclusiveLock 的核心片段:
void Mutex::ExclusiveLock(Thread* self) { ...#if ART_USE_FUTEXES ... if (futex(state_and_contenders_.Address(), FUTEX_WAIT_PRIVATE, cur_state, nullptr, nullptr, 0) != 0) { ... } ...#endif}6. 内存管理
如果说 IPC 和同步是操作系统的两条重要机制,那内存管理就是操作系统的看家本领,重中之重。
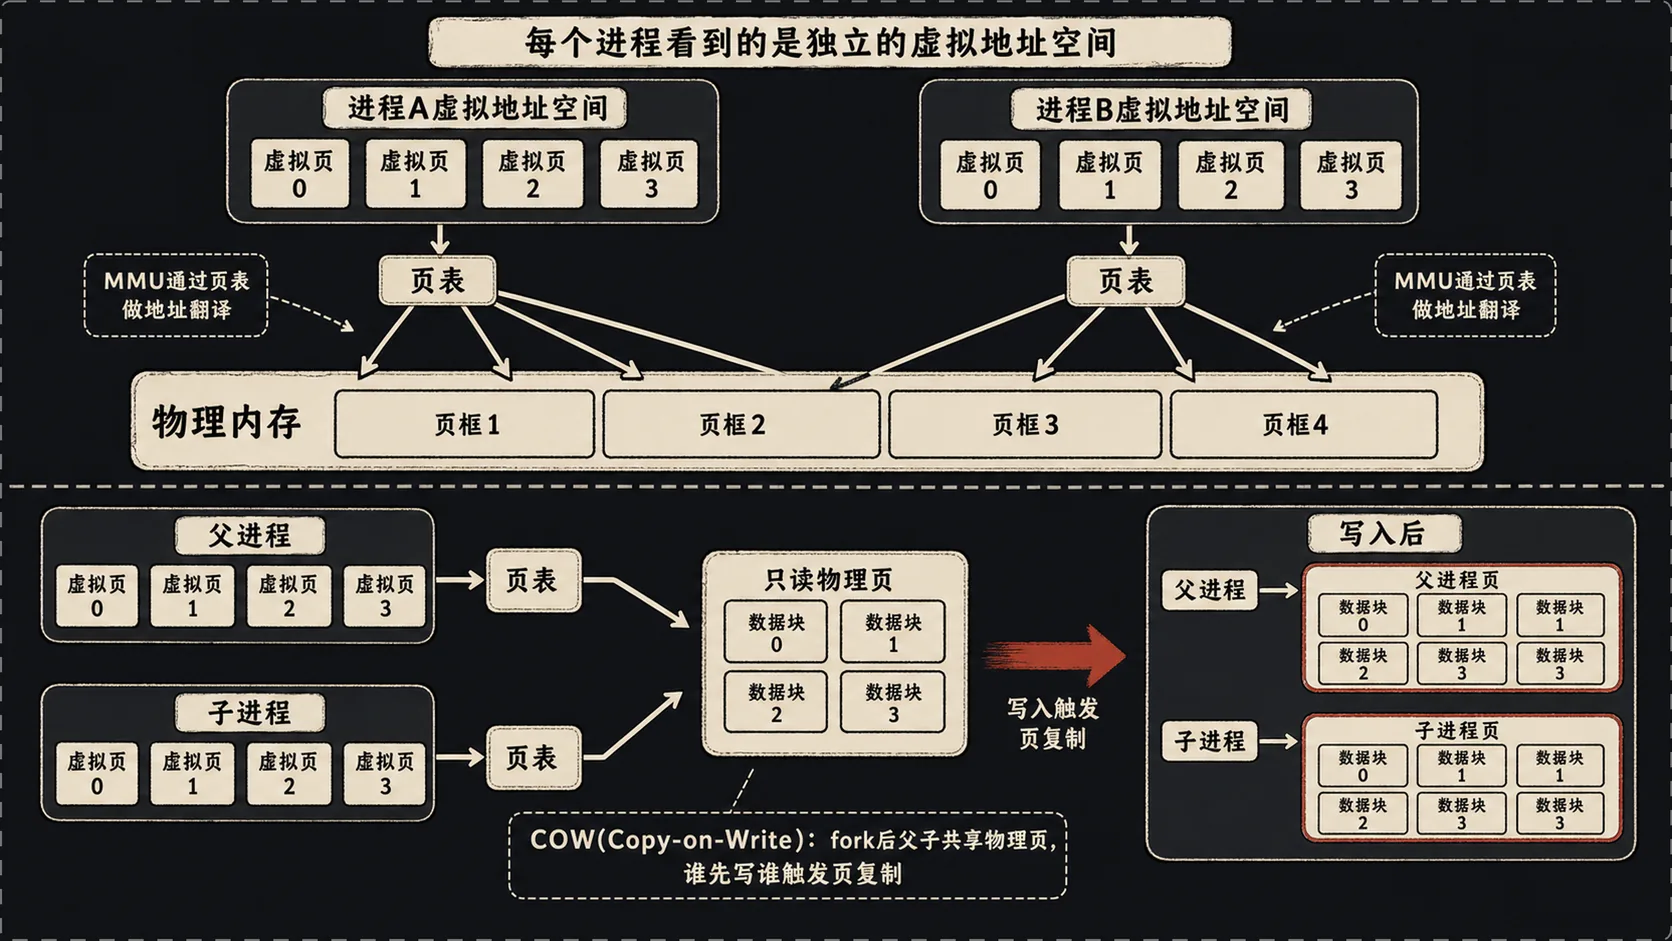
6.1 虚拟内存——每个进程都活在"楚门的世界"里。 现代操作系统一个最核心的魔法是:每个进程看到的地址都是假的。进程里 &变量 打印出来的那个地址,不是它在物理内存条上的真实位置,而是一个虚拟地址。CPU 里有个专门的硬件叫 MMU(内存管理单元),它拿着操作系统为每个进程维护的页表,在每次访存时把虚拟地址实时翻译成物理地址。
这套机制解决了三个大问题:
- 一是隔离,每个进程有自己独立的虚拟地址空间和页表,进程 A 的虚拟地址
0x1000和进程 B 的0x1000映射到完全不同的物理页,互不干扰; - 二是灵活,物理内存可以碎片化地分配,虚拟地址却能是连续的,还能把暂时不用的页换出到磁盘(swap);
- 三是超额,所有进程的虚拟地址空间加起来可以远大于物理内存。
6.2 内存保护——那道隔离进程崩溃的墙。 页表里除了地址映射,还记着每一页的权限(可读?可写?可执行?)。进程去访问一个没映射的虚拟地址,或者往只读页里写,MMU 会立刻触发一个缺页异常/保护异常,操作系统接手,通常就是给进程发 SIGSEGV——也就是我们天天见的段错误。Segfault 不是 bug 本身,而是操作系统内存保护机制在正常工作的证据:它在你的程序捅娄子、可能破坏别人数据之前,果断把它拦下。
6.3 mmap——内存管理的瑞士军刀。 mmap 系统调用把一个文件(或匿名区域)映射进进程的虚拟地址空间,之后读写这段内存就等于读写那个文件,由内核负责在背后同步。它用途极广:加载可执行文件和动态库(.so 被 mmap 进来)、高效读大文件(省掉 read/write 的拷贝)、以及——实现共享内存。怎么实现?让两个进程 mmap 同一个文件(或同一个匿名内存对象),它们各自的一段虚拟地址就都指向了同一块物理内存。第 3.1 节的共享内存、第 7 节的 ashmem,底层都是 mmap。
6.4 写时拷贝(Copy-On-Write,COW)——又想省又想快的智慧。 这是内存管理里最优雅的设计之一,理解它才能理解下一节 Zygote 的魔法。fork() 创建子进程时,理论上要把父进程的整个地址空间复制一份给子进程。但这太贵了——很多进程 fork 完马上就 exec 别的程序,刚复制的内容立刻作废。COW 的做法是:fork 时根本不真复制,父子进程的虚拟页暂时都指向同一批物理页,并且这些页被标记为只读。 父子谁都可以放心地读(读不改变内容,共享完全没问题)。只有当某一方要写某一页时,MMU 触发保护异常,内核这才为写入方真正复制出一份该页的副本,让它写自己的副本,父进程的原页不受影响。"写的时候才拷贝",没写到的页永远共享——这就是 COW 的全部精髓。
下面的 Linux 程序把 fork 后的两种页映射放在一起对照:privatePage 是普通私有匿名页,子进程写它会触发 COW,所以父进程仍读到 P;sharedPage 用 MAP_SHARED 建立,子进程写后父进程读到 C。它不是通过打印物理地址来“证明”COW(用户态并不能可靠拿到物理页号),而是用两种映射的可观察语义说明内核在何时隔离、何时共享。可用 cc cow_demo.c && ./a.out 运行。
// cow_demo.c:对比 fork 后的私有页(COW)与显式共享页(MAP_SHARED)。#include <stdio.h>#include <stdlib.h>#include <sys/mman.h>#include <sys/wait.h>#include <unistd.h> static void die(const char* message) { perror(message); exit(EXIT_FAILURE);} int main(void) { long pageSize = sysconf(_SC_PAGESIZE); if (pageSize <= 0) die("sysconf"); // 两个映射都在 fork 前创建:一个私有,一个显式共享。 char* privatePage = mmap(NULL, (size_t)pageSize, PROT_READ | PROT_WRITE, MAP_PRIVATE | MAP_ANONYMOUS, -1, 0); char* sharedPage = mmap(NULL, (size_t)pageSize, PROT_READ | PROT_WRITE, MAP_SHARED | MAP_ANONYMOUS, -1, 0); if (privatePage == MAP_FAILED || sharedPage == MAP_FAILED) die("mmap"); privatePage[0] = 'P'; sharedPage[0] = 'P'; pid_t pid = fork(); if (pid == -1) die("fork"); if (pid == 0) { privatePage[0] = 'C'; // 第一次写私有页:内核为子进程复制该页(COW)。 sharedPage[0] = 'C'; // 写共享页:父子进程继续看到同一页。 munmap(privatePage, (size_t)pageSize); munmap(sharedPage, (size_t)pageSize); _exit(EXIT_SUCCESS); } if (waitpid(pid, NULL, 0) == -1) die("waitpid"); // 等子进程完成写入再观察。 printf("privatePage = %c(期望 P:子进程的写被 COW 隔离)\n", privatePage[0]); printf("sharedPage = %c(期望 C:MAP_SHARED 允许跨进程可见)\n", sharedPage[0]); munmap(privatePage, (size_t)pageSize); munmap(sharedPage, (size_t)pageSize); return EXIT_SUCCESS;}6.5 COW 在 Android 的神来之笔——Zygote。 现在把 COW 和 Android 接上。Android 里所有 Java 进程(App、system_server)都不是从零启动一个虚拟机,而是从一个叫 Zygote 的"母体"进程 fork 出来的。Zygote 在开机时干一件重活:预加载——把几千个最常用的框架类(Activity、View、String……)和公共资源统统加载进自己的内存。看 `frameworks/base/core/java/com/android/internal/os/ZygoteInit.java` 的 main(第 888 行)里会调 `preload`(第 136 行)。之后每当要启动一个 App,Zygote 就 fork 自己。
关键就在这里:fork 出来的 App 进程,靠 COW 白白继承了 Zygote 预加载的那几千个类和资源,几乎不占额外物理内存。 这些框架类库是只读的(加载完就不改了),所以所有 App 进程和 Zygote 在物理内存上共享同一份——你手机里开着几十个 App,但那套庞大的 Android 框架代码在物理内存里其实只有一份。这一下同时省了两样东西:省时间(App 启动不用重新加载框架)和省内存(COW 共享只读页)。
7. Android 的内存管理特化
7.1 Low Memory Killer——比 OOM Killer 更懂手机。 桌面 Linux 内存耗尽时会触发内核的 OOM Killer,它按一套评分(oom_score)挑个进程杀掉,相对粗暴,也不了解"应用"这个概念。但手机的诉求很不一样:用户切到后台的音乐 App 最好别杀、刚退出的 App 留着能快速切回、纯粹的空进程可以随便清。Android 于是搞了 Low Memory Killer(LMK),并且在演进中把它从内核驱动迁移到了用户空间的 lmkd 守护进程。lmkd 由 init 启动,它监听内核通过 **PSI(Pressure Stall Information)**报上来的内存压力信号,再结合 AMS 给每个进程打的 oom_adj 分值(前台进程 adj 低、越不重要 adj 越高)来决定杀谁。这样杀进程就从"内核随机挑"变成了"按应用重要性精准清理"。init.rc 里能看到为它准备的 cgroup 内存压力节点。这就是"后台 App 被系统清掉"的技术真相——不是玄学,是 lmkd 按 adj 从高到低在清理。
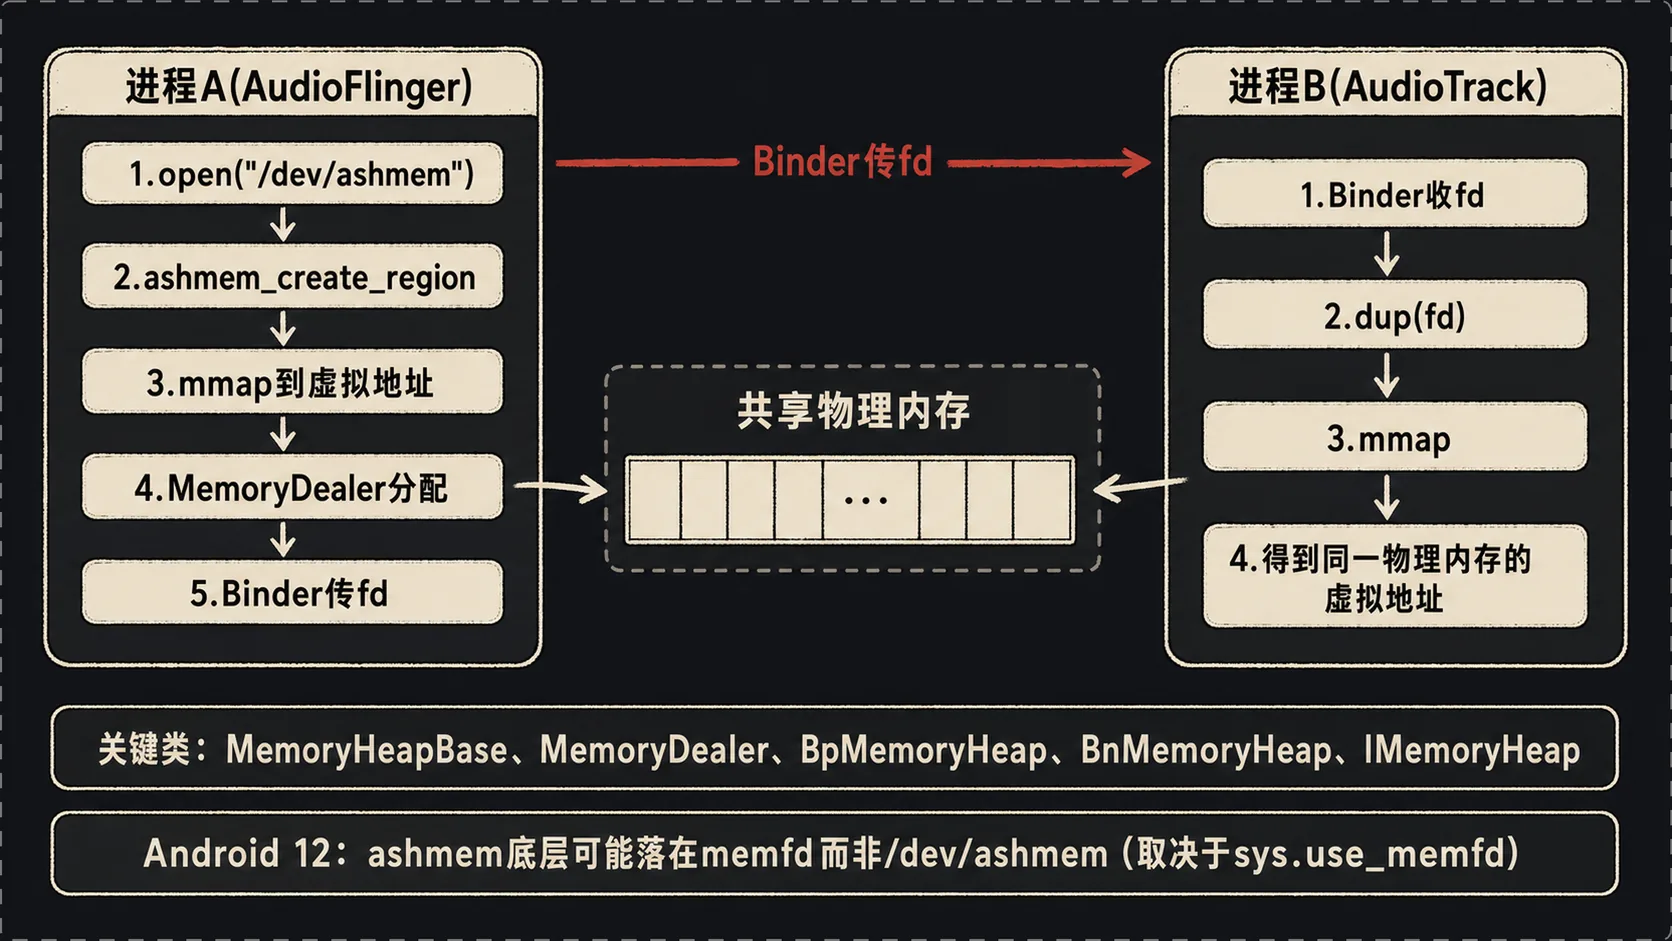
7.2 ashmem——可被内核回收的匿名共享内存。 第 3.1 节说传统 System V 共享内存对移动设备有个痛点:内存吃紧时它不好回收(它是持久的、有意义的资源,内核不敢乱动)。Android 于是设计了 ashmem(Anonymous Shared Memory)。用法上,一个进程通过 ashmem_create_region 创建一块命名的匿名共享内存区,底层 open("/dev/ashmem") 拿到 fd,再 mmap 映射进自己的地址空间;然后把这个 fd 通过 Binder 传给另一个进程(还记得第 3.3 节说 UDS/Binder 能传 fd 吗),对方 mmap 同一个 fd,两个进程就共享同一块物理内存了。ashmem 相比 System V 共享内存最大的特点,就是它对内核更"友好"——它支持"pin/unpin"语义,那些被 unpin 的、暂时没人用的共享内存页,内核在内存压力下可以直接回收掉,事后需要时再重新分配。这对内存永远紧张的手机太重要了。
7.4 一个完整实例:音频的共享内存传递。 把上面的零件串成一条真实的链路——Android 音频里,AudioTrack(App 侧)和 AudioFlinger(服务侧)之间要高效地传递音频数据,走的就是共享内存。角色分工看这几个类:
- `MemoryHeapBase`(第 49 行)——最底层,它在构造时调
ashmem_create_region拿到一块共享内存,再mmap(第 123 行)映射好,代表"一整块共享内存堆"。 - `MemoryDealer`(
allocate在第 239 行)——它持有一个 MemoryHeapBase,并在这块大堆上做二次分配(内部用SimpleBestFitAllocator最佳适配算法切小块),谁要用共享内存就找它allocate(size)切一小片出来。 - `IMemoryHeap` /
BnMemoryHeap/ `BpMemoryHeap`——这是共享内存的 Binder 接口。服务端是BnMemoryHeap,客户端拿到的是代理BpMemoryHeap。getHeapID()(IMemory.h 第 41 行)返回的就是那块共享内存的 fd。
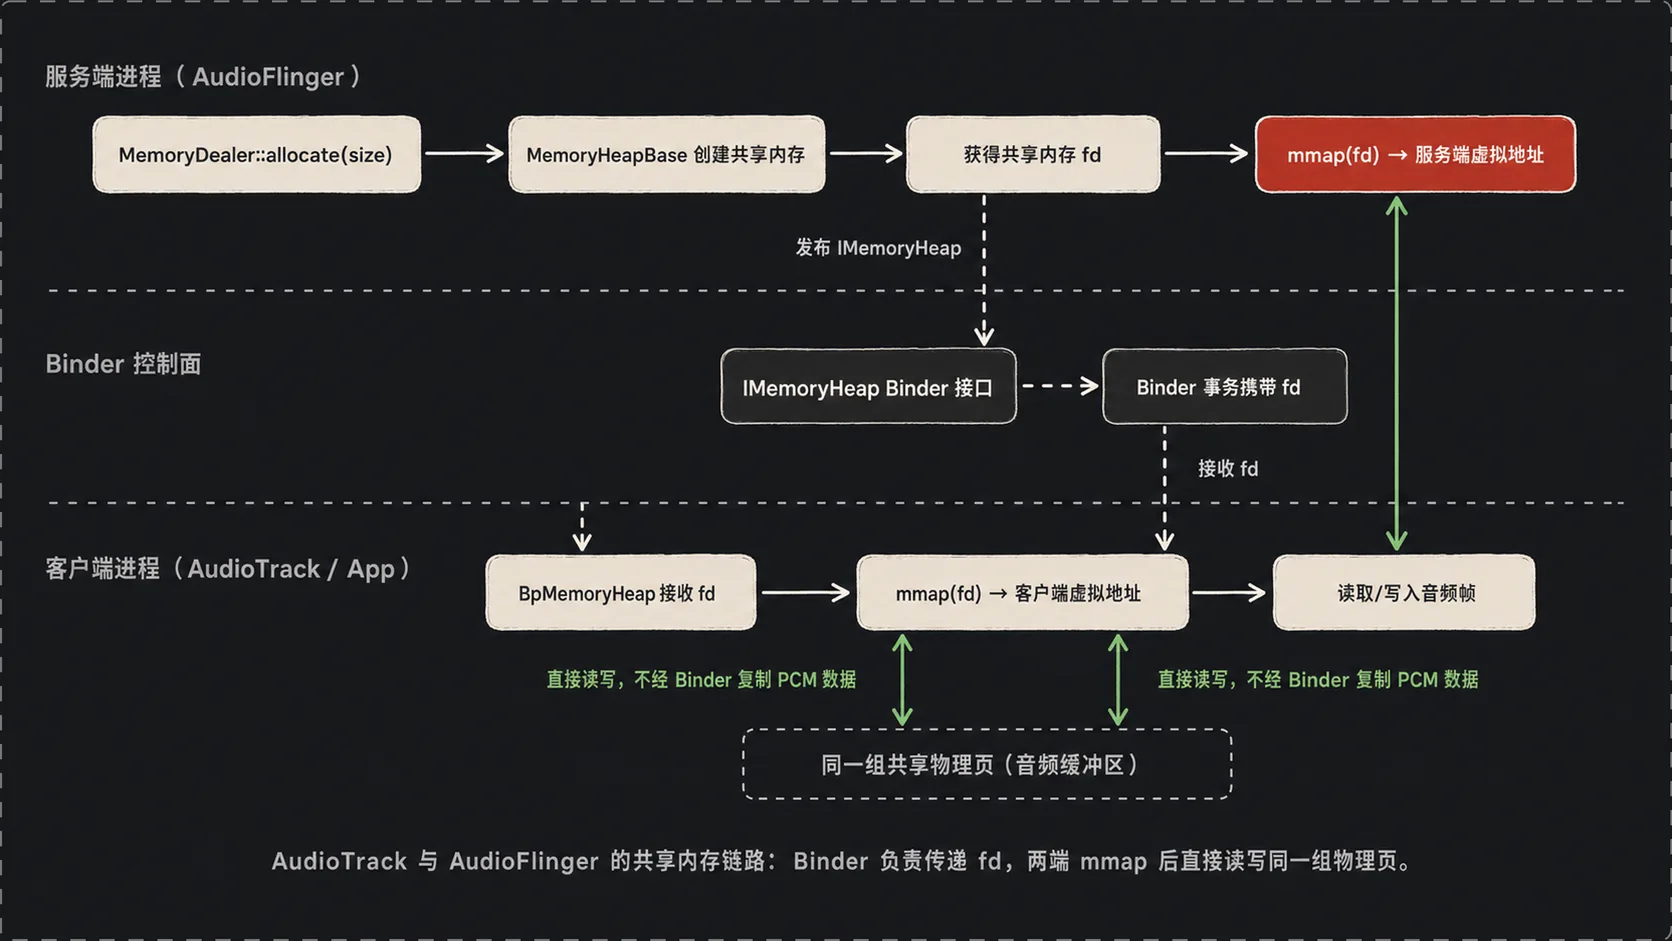
AudioTrack 与 AudioFlinger 的共享内存链路:Binder 负责传递 fd,两端 mmap 后直接读写同一组物理页。
MemoryDealer在MemoryHeapBase所代表的大块共享内存上进行子分配;IMemoryHeap是 Binder 接口,BpMemoryHeap是客户端代理。Binder 在建立共享关系时传递 fd,但持续的音频数据不走 Binder 消息缓冲区,而是由两端对同一共享物理页的映射直接访问。实际生产者/消费者仍需额外的缓冲区索引、同步与生命周期管理。
于是完整流程是:AudioFlinger 用 MemoryDealer(背后是 MemoryHeapBase + ashmem)分配好共享内存 → 通过 Binder 把 IMemoryHeap 接口传给 AudioTrack,Binder 底层把那个 ashmem 的 fd 传过去 → AudioTrack 侧的 BpMemoryHeap 收到 fd 后 mmap 它 → 现在两个进程指向同一块物理内存,音频数据往里一写、那边直接读,全程零拷贝。
8. JNI——Java 和 C/C++ 的桥梁
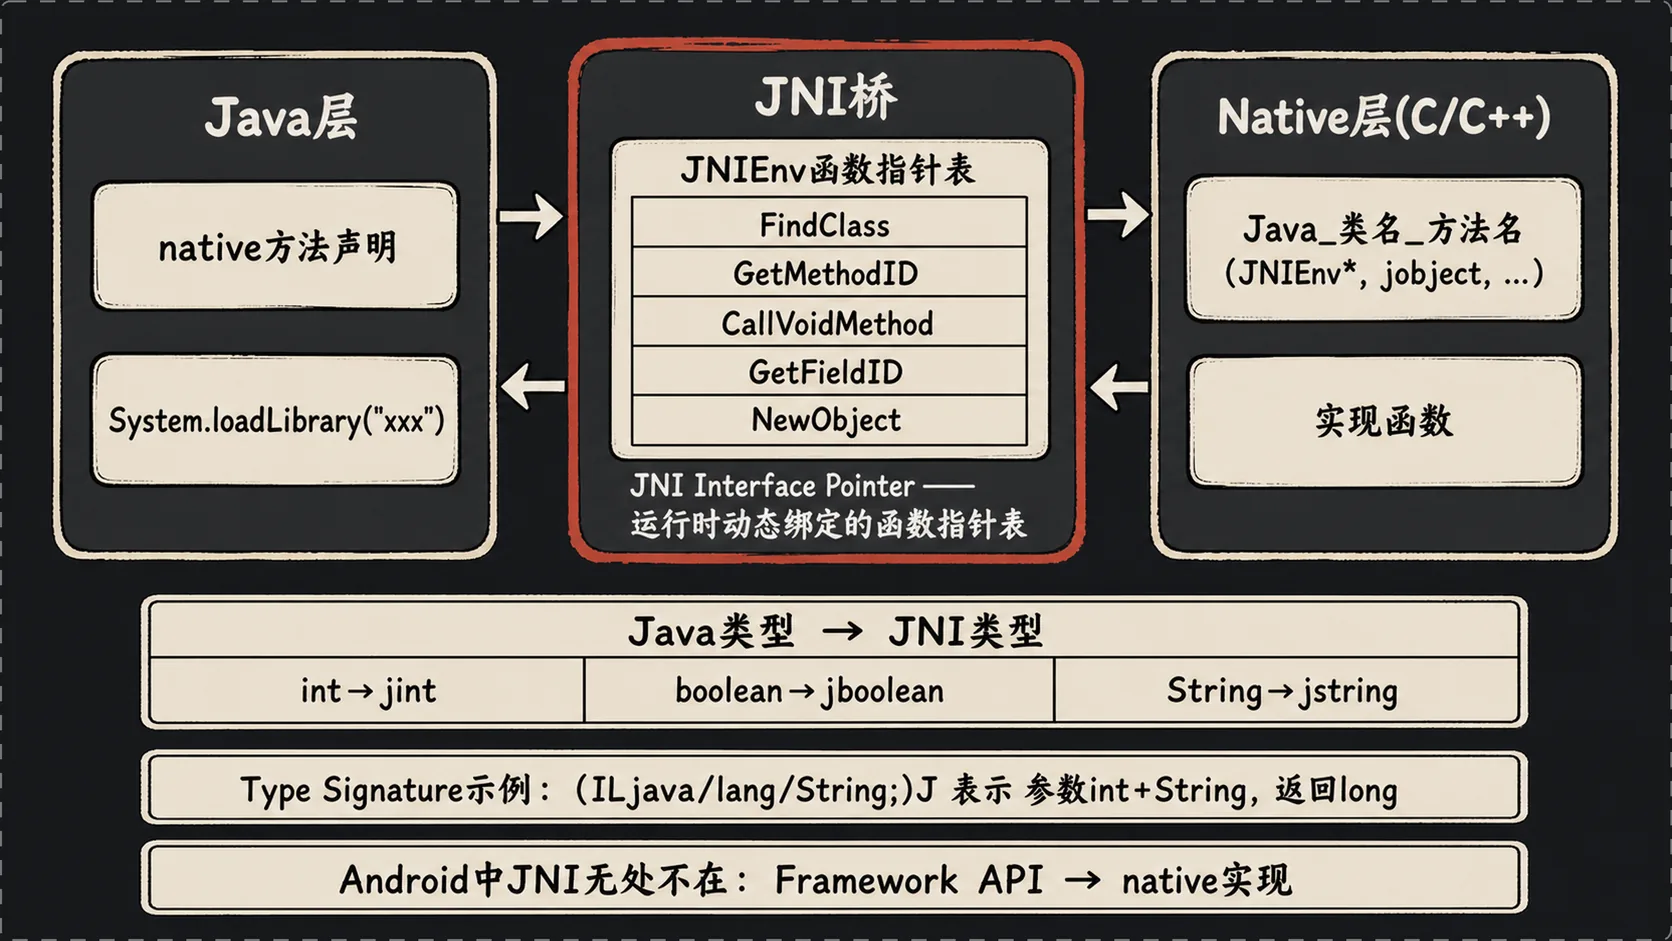
前面反复出现一个场景:Java 代码要调到 C/C++(Zygote 的 fork 是 native 的、ART 是 C++ 写的、共享内存也在 native 层)。这道横跨两个语言世界的桥,就是 JNI(Java Native Interface)。
8.1 为什么需要 JNI?
- 一,平台特性——有些能力(直接操作硬件、调系统调用)Java 层根本够不着,必须下到 native;
- 二,复用旧库——世界上海量成熟的 C/C++ 库(编解码、加密、OpenGL)没必要用 Java 重写一遍;
- 三,性能关键路径——对延迟极敏感的地方(图形、音频、密集计算),native 代码更可控。
8.2 Java → Native 的路径。 标准流程是:在 Java 里用 native 关键字声明一个没有方法体的方法 → javac 编译 → (历史上用 javah,现在多由构建系统)生成对应的 C 函数头 → 在 C/C++ 里实现这个函数 → 编译成 .so 动态库 → Java 侧用 System.loadLibrary("xxx") 把库加载进来。之后 Java 调那个 native 方法,JVM/ART 就会去 .so 里找到对应的 C 函数执行。函数名有一套固定的命名规则(Java_包名_类名_方法名),或者用下面 8.5 讲的注册表方式绑定。
8.3 Native → Java 的路径。 反过来,C/C++ 也能调 Java——靠的是每个 native 方法第一个参数 JNIEnv*。JNIEnv 本质是一张函数指针表,里面几百个函数指针,就是 JNI 提供给 native 代码反向操作 Java 世界的全部能力。典型套路:FindClass("java/lang/String") 拿到类 → GetMethodID(clazz, "方法名", "签名") 拿到方法 ID → CallObjectMethod/CallIntMethod(...) 真正调用。native 代码就是这样在 C++ 里"遥控"Java 对象的。
8.4 类型对照与 Type Signature。 跨语言要解决类型对不上的问题。JNI 给每个 Java 基础类型定义了 C 侧的别名:jint ↔ int、jlong ↔ long、jboolean ↔ boolean、jfloat ↔ float……对象则统一是 jobject(jstring、jclass 是它的特化)。更精妙的是方法签名(Type Signature)——一种紧凑的字符串编码,用来在运行时唯一标识一个方法的参数和返回值类型。规则:I=int,J=long,Z=boolean,V=void,[=数组,L类全名;=对象。比如 (ILjava/lang/String;)J 表示"参数是一个 int 和一个 String,返回 long"。
8.5 Android 里 JNI 无处不在。 Android 12 里 Zygote 的 native 实现 `frameworks/base/core/jni/com_android_internal_os_Zygote.cpp`,它底部有一张 gMethods 注册表(第 2645 行),把 Java 的 native 方法和 C 函数一一绑定:
static const JNINativeMethod gMethods[] = { {"nativeForkAndSpecialize", "(II[II[[IILjava/lang/String;Ljava/lang/String;[I[IZ...)I", (void*)com_android_internal_os_Zygote_nativeForkAndSpecialize}, {"nativeForkSystemServer", "(II[II[[IJJ)I", (void*)com_android_internal_os_Zygote_nativeForkSystemServer}, ...};这段是活生生的证据。 你看 nativeForkSystemServer 那一行的签名 "(II[II[[IJJ)I"——用 8.4 的规则解一下就是:参数依次是 int、int、int数组、int、int的二维数组、long、long,返回 int。它绑定的 C 函数是 com_android_internal_os_Zygote_nativeForkSystemServer。而 Java 侧 `Zygote.java` 里 forkAndSpecialize(第 339 行)调的 nativeForkAndSpecialize(native 声明在第 368 行),最终就通过这张表跳到 native 去真正执行 fork。文件末尾 register_com_android_internal_os_Zygote(第 2699 行)用 RegisterMethodsOrDie 完成注册。换句话说,第 6 节讲的"Zygote fork 出 App"这个 Android 最核心的动作,Java 层根本 fork 不了,它是通过 JNI 调到这里的 native fork 完成的。 JNI 就是这样一道你几乎察觉不到、却支撑着整个框架运转的旋转门——从进程创建,到几乎每一个最终要碰硬件的 Framework API,底下都趟过 JNI。
9. Java 反射——运行时的动态能力
和 JNI 并列的另一项"动态能力"是反射(Reflection),它同样是理解 Android 很多机制的前提,顺带讲一下。
9.1 为什么需要反射? 正常写代码,类名在编译期就定死了:new Foo(),编译器知道 Foo 是什么。但有些场景,编译期根本不知道要用哪个类——类名是运行时才从配置文件、从网络、从一个字符串里得到的。反射就是让程序在运行时根据一个字符串名字去动态地加载类、创建对象、调用方法、访问字段的能力。入口就是 Class.forName("com.example.Foo") 和拿到 Class 后的 newInstance()、getMethod().invoke() 那一套。
9.2 从 Java 一路到 ART 的调用链。 `libcore/ojluni/src/main/java/java/lang/Class.java` 里 forName 的实现(第 454 行),它调了一个 native 方法 classForName(native 声明在第 467 行)。这个 native 方法落到 ART 的 `art/runtime/native/java_lang_Class.cc` 里的 Class_classForName(第 179 行)——注意,这又是一次 JNI 跨界(第 8 节的桥又出现了)。它最终会走到 ART 类加载的核心 `ClassLinker::FindClass`(class_linker.cc 第 2826 行)。ClassLinker 是 ART 里负责"查找、加载、链接、初始化类"的组件——反射的 Class.forName,本质就是显式地触发了一次它平时隐式在做的类加载。
9.3 Android 里的反射应用。 最典型的两个:
- 一是 Intent 的隐式启动——你 startActivity 一个 Intent,系统在运行时根据 action/category 匹配出目标组件、再把那个 Activity 类加载并实例化出来,这背后有反射的影子;
- 二是插件化/热修复框架——它们要动态加载宿主 App 里编译期不存在的类(来自另一个 dex/apk),几乎全靠反射 + 自定义 ClassLoader 撑起来。理解了反射的调用链,你才明白这些"黑科技"框架不是绕过了系统,而是精准地利用了
ClassLoader+ 反射这套系统本就提供的动态能力。
10. 总结
Q:操作系统到底做了什么?
A:它把冷冰冰的硬件,抽象和管理成程序员能用的资源和接口。而 Android 12 的做法是:站在 Linux 内核这套经典 OS 机制(虚拟内存、Futex、mmap、COW)的肩膀上,针对移动场景做大量特化——用 Binder 取代传统 IPC、用 ashmem/memfd 优化共享内存、用 lmkd 替代粗暴的 OOM Killer、用 Futex 手搓高性能锁、用 JNI 打通 Java 与 native。理解这些"通用原理"与"Android 特化"之间的对应关系,就是读懂 AOSP 源码的钥匙。
理解一个系统,我的建议是抓住两条线索,它们在中间交叉的地方,就是你理解得最深的地方:
- 主线(自底向上,硬件视角):计算机体系结构 → 硬件如何工作。 从冯·诺依曼/哈佛结构,到 CPU 的取指-执行循环,到 MMU/页表怎么做虚拟内存,到 Futex 怎么用一条原子指令避免陷入内核。这条线回答"底层到底发生了什么"。
- 辅线(自顶向下,软件视角):Android 五层框架 → 软件如何组织。 从 App、到 Framework 系统服务、到 ART 运行时、到 native 守护进程、到 Linux 内核。这条线回答"代码是怎么分层协作的"。
本文由 AgentPlanFlow 生成