
文章内容
- 一、界面刷新链路:从 View 到屏幕
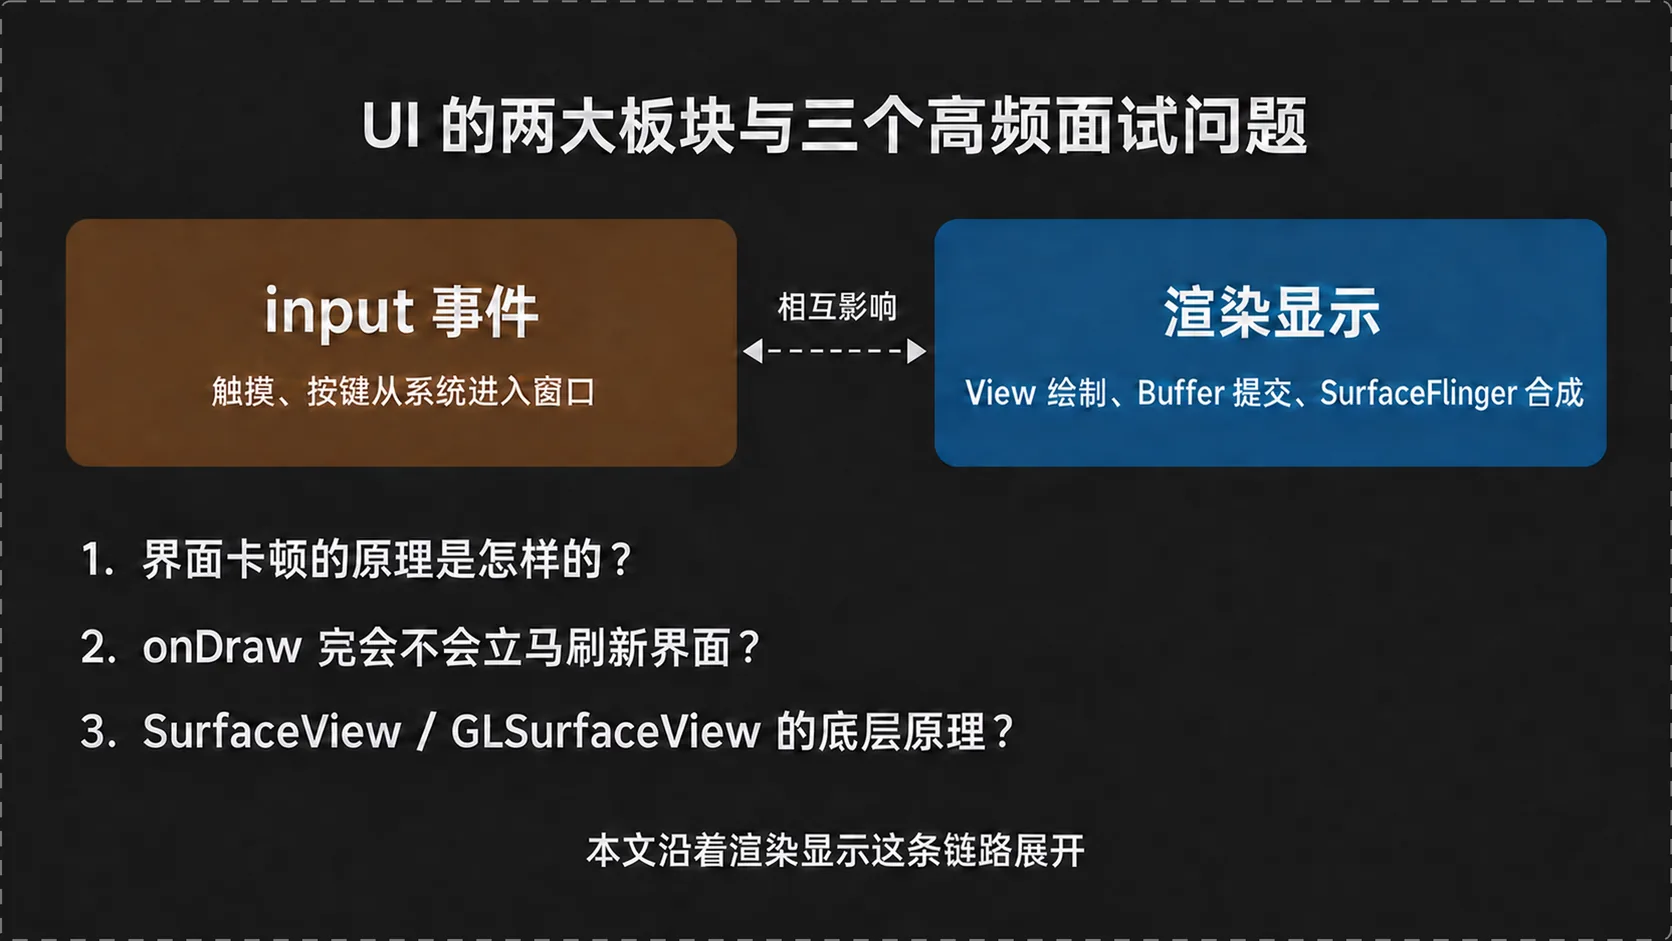
- 1.1 UI 的两大板块:输入事件与渲染显示
- 1.2 一次绘制的完整链路
- 1.3 SurfaceFlinger:独立进程的渲染系统服务
- 1.4 大块数据跨进程:Binder + 共享内存
- 二、vsync:屏幕刷新的节奏
- 2.1 为什么不能“一提交就画”
- 2.2 丢帧
- 2.3 绘制同步:把提交对齐到 vsync
- 2.4 双缓冲与三缓冲
- 三、SurfaceFlinger 启动 vsync
- 3.1 main() 入口
- 3.2 init() 里干了什么
- 3.3 加载 vsync 硬件模块
- 3.4 注册回调与软件模拟兜底
- 四、vsync 的分发:四级回调链
- 4.1 第一级:硬件回调 hookvsync
- 4.2 第二级:SurfaceFlinger::onVSyncReceived
- 4.3 第三级:DispSync 与 DispSyncThread
- 4.4 第四级:EventThread
- 4.5 EventThread::threadLoop 与 Connection
- 4.6 节流语义:一次请求,一次通知
- 五、小结
- 5.1 界面卡顿
- 5.2 onDraw 之后不会立即刷新
- 5.3 SurfaceView / GLSurfaceView
在 onDraw() 里画完的东西不会立刻出现在屏幕上。这不是 Android 故意拖慢刷新,而是因为“画进内存”和“显示到屏幕”本来就是两件事:App 先把像素写进一块 Buffer,再把它交出去;SurfaceFlinger 等到合适的刷新时刻,合成各个窗口的 Buffer,最后才把结果送给显示硬件。
这条链路真正的节拍器是 Vsync,即垂直同步信号。对 60Hz 屏幕来说,它约每 16.6ms 到来一次。App 的绘制、Buffer 的提交、SurfaceFlinger 的合成,以及卡顿和丢帧的判断,都围绕这个周期展开。
一、界面刷新链路:从 View 到屏幕
1.1 UI 的两大板块:输入事件与渲染显示
Android UI 系统可以从两个方向理解。
- 一边是输入事件:触摸、按键等事件从系统进入窗口,再沿 View 树分发;
- 另一边是渲染显示:View 生成绘制命令,像素进入 Buffer,多个窗口的内容经系统合成后显示。
二者会在应用交互中互相影响,但负责的对象和调用链不同。
这里仅追踪渲染显示。起点是 App 进程中的 ViewRootImpl 和根布局,终点是手机屏幕。中间最容易被忽略的事实是:App 并不直接操作屏幕,Canvas 也不是屏幕本身。SkCanvas 把绘制操作落到 SkBitmap 或图形 Buffer 上,屏幕何时读取这些像素由另一套时序控制。
1.2 一次绘制的完整链路
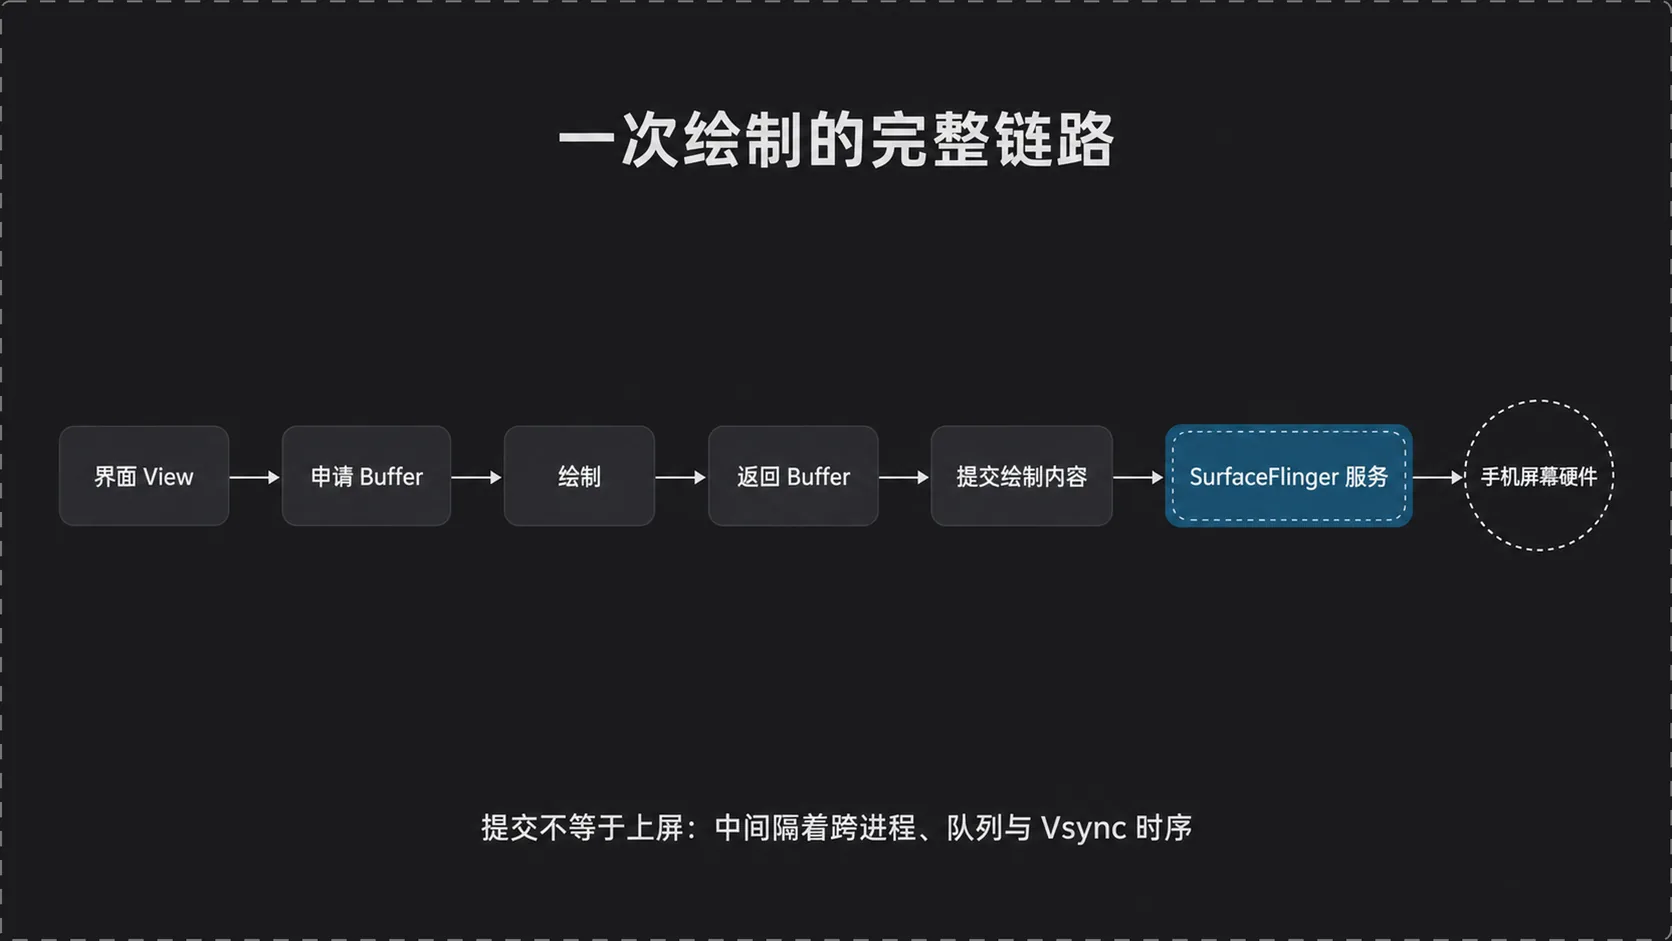
一帧画面的正常路径可以压缩为七步:界面 View 发起绘制,App 向 BufferQueue 申请可写 Buffer,在 Buffer 上完成绘制,把 Buffer 归还队列,提交本次绘制内容,SurfaceFlinger 取出各个 Surface 的最新内容进行合成,显示硬件扫描最终结果。
BufferQueue 是生产者与消费者之间的缓冲队列。App 是生产者,负责申请、写入和提交;SurfaceFlinger 一侧是消费者,负责取得可用 Buffer。提交只表示“这帧已经可供消费”,不表示屏幕此刻已经换成了它。两者之间还隔着进程通信、队列状态、合成动作和 Vsync 时序。
1.3 SurfaceFlinger:独立进程的渲染系统服务
SurfaceFlinger 在开机阶段启动,运行于独立进程。它不是 App 的绘图库,而是系统级合成服务:收集各个窗口和 Surface 提交的图层,结合位置、层级、透明度等状态决定如何合成,再通过 Hardware Composer(HWC,硬件合成器接口)与显示硬件交互。
App 只负责自己的内容,不能直接控制最终屏幕;SurfaceFlinger 站在全局视角管理所有可见图层。Window 与 SurfaceFlinger 如何通信之所以常被拿来提问,关键就在这里:窗口状态和控制消息要跨进程,像素数据也要跨进程,但两类数据不能用同一种方式粗暴搬运。
1.4 大块数据跨进程:Binder + 共享内存
假设一屏分辨率为 720×1280,每个像素用 4 字节表示 RGB 与透明度,一帧约占 720 × 1280 × 4 = 3,686,400 字节,也就是约 3.5MiB。若把整块像素数组反复塞进 Binder 消息,不仅复制成本高,也不适合 Binder 的事务模型。
Android 因此把控制与数据分开:申请 Buffer、返回 Buffer、传递句柄和状态等控制动作走 Binder;真正的大块图像数据放在可跨进程映射的共享内存中。可以把 Binder 理解为交接单,把共享内存理解为仓库。交接时不搬整个仓库,只传一张“哪块货已经准备好”的清单。
二、vsync:屏幕刷新的节奏
2.1 为什么不能“一提交就画”
App 在一秒钟内可能因为动画、触摸或无效请求提交几百次,但 60Hz 屏幕一秒只扫描约 60 帧。如果每次提交都立刻触发合成,上游会做大量屏幕根本来不及显示的工作,还可能在屏幕扫描过程中替换像素,导致画面不完整。
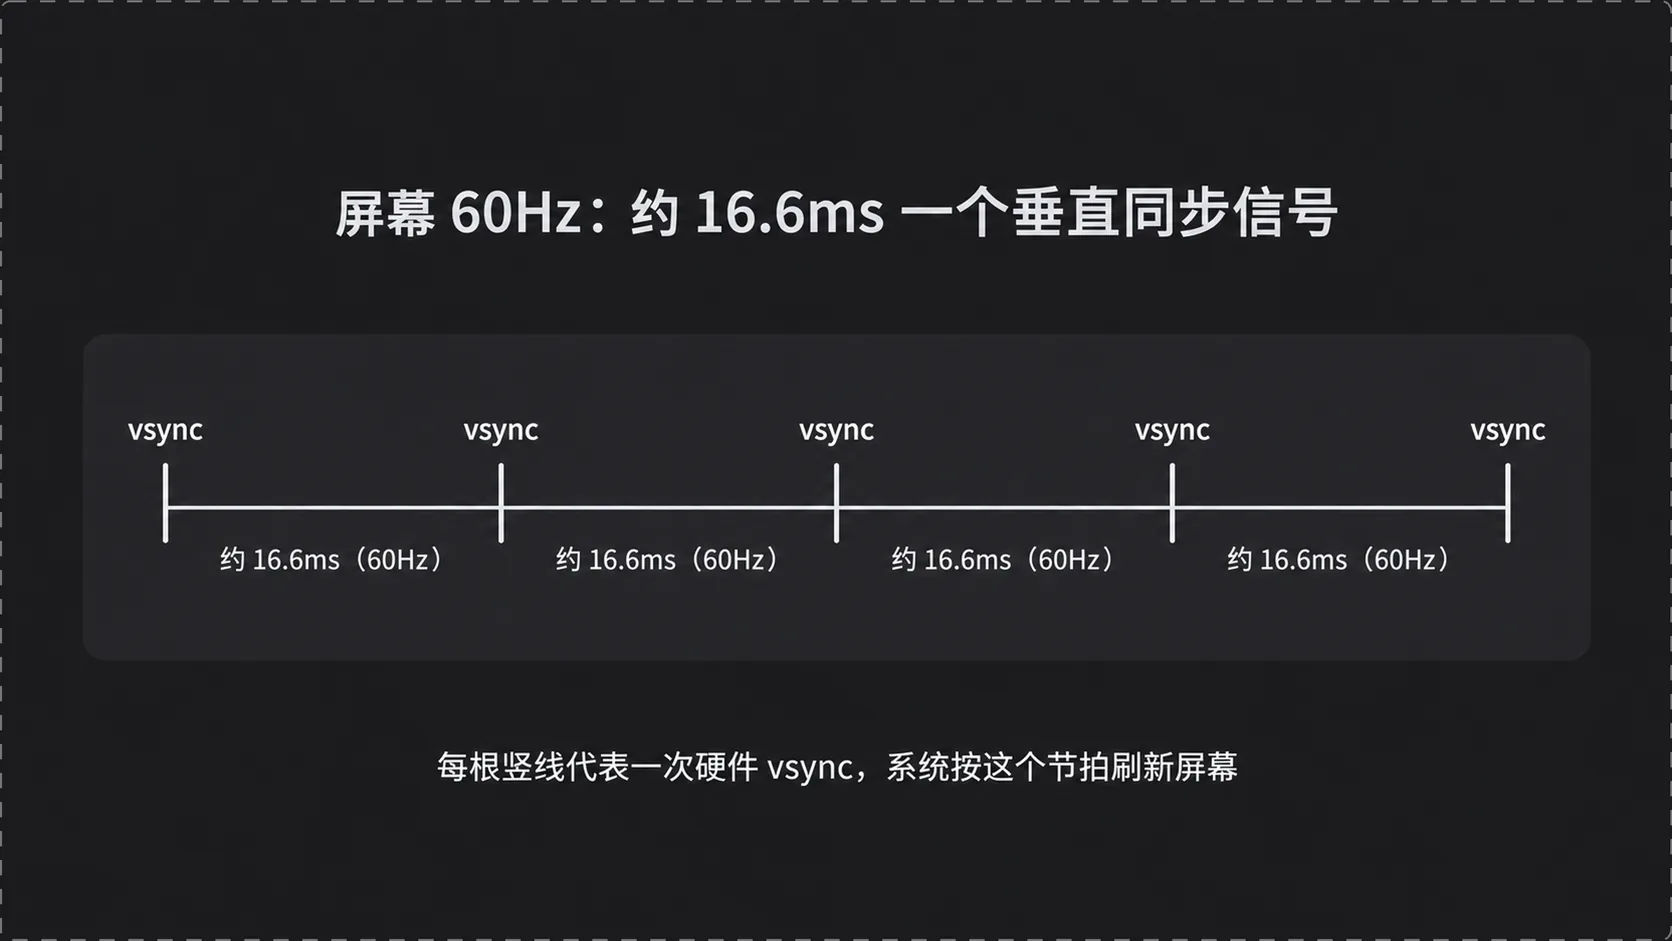
Vsync 给系统提供固定节拍。60Hz 对应的刷新周期约为 16.6ms,显示硬件每到一个周期产生一次垂直同步信号。系统不追逐每次提交,而是在刷新边界附近安排 App 生产下一帧、SurfaceFlinger 合成可用帧。这样做的重点不是让所有工作都变成 16.6ms,而是让提交和消费尽量对齐同一条时间轴。
2.2 丢帧
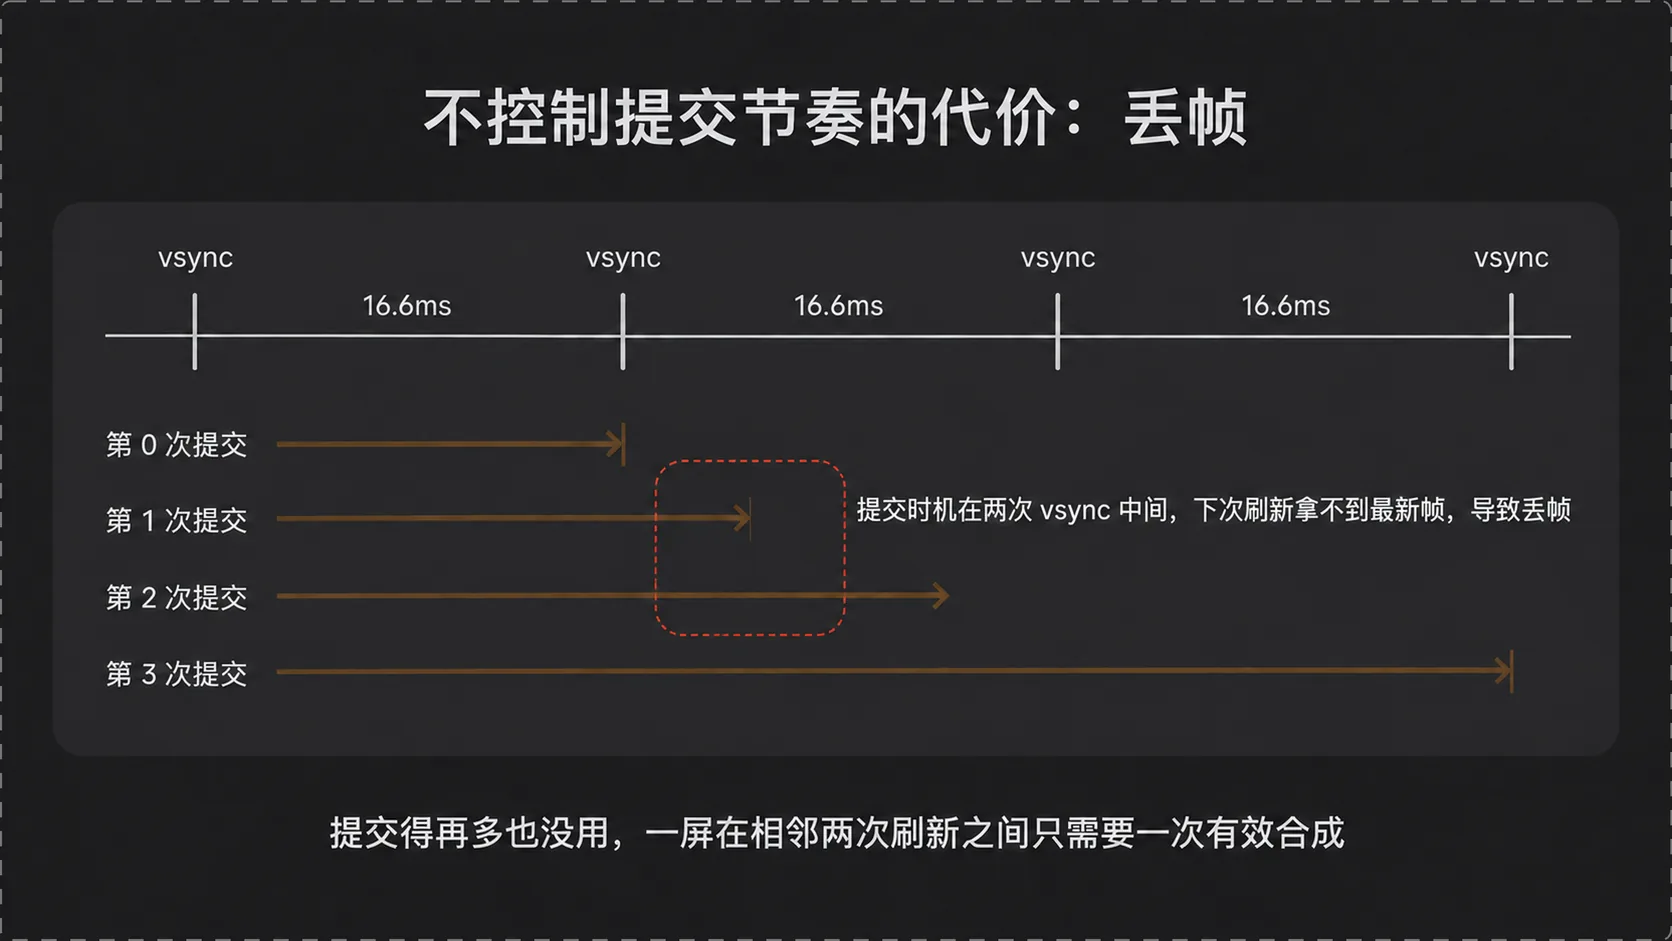
如果 App 在两次 Vsync 中间才开始或才完成提交,SurfaceFlinger 到下一个合成点时可能拿不到这块最新 Buffer,只能继续使用上一帧。屏幕便重复显示旧内容,用户看到的结果就是动画停顿或跳跃,也就是丢帧。
同一屏内容在相邻两次刷新之间只需要一次有效合成;同一窗口连续提交多帧,中间帧没有显示机会。真正有效的优化是控制生产时间,让目标帧在消费点之前准备好,而不是无节制地增加绘制次数。
2.3 绘制同步:把提交对齐到 vsync
Android 把 Vsync 分发给 App,App 收到通知后安排遍历、布局和绘制,完成后提交 Buffer。内容没有变化时不必重绘;内容需要更新时,则应在一个刷新预算内完成。如果 60Hz 设备上的一帧持续超过约 16.6ms,它就可能错过原定消费点,界面优化需要从主线程耗时、布局复杂度、绘制量和资源调度等方向寻找原因。
Vsync 不是保证流畅的魔法,它只提供统一时钟。上游按时开工、在截止时间前交付,SurfaceFlinger 才能在这一拍拿到新帧。
2.4 双缓冲与三缓冲
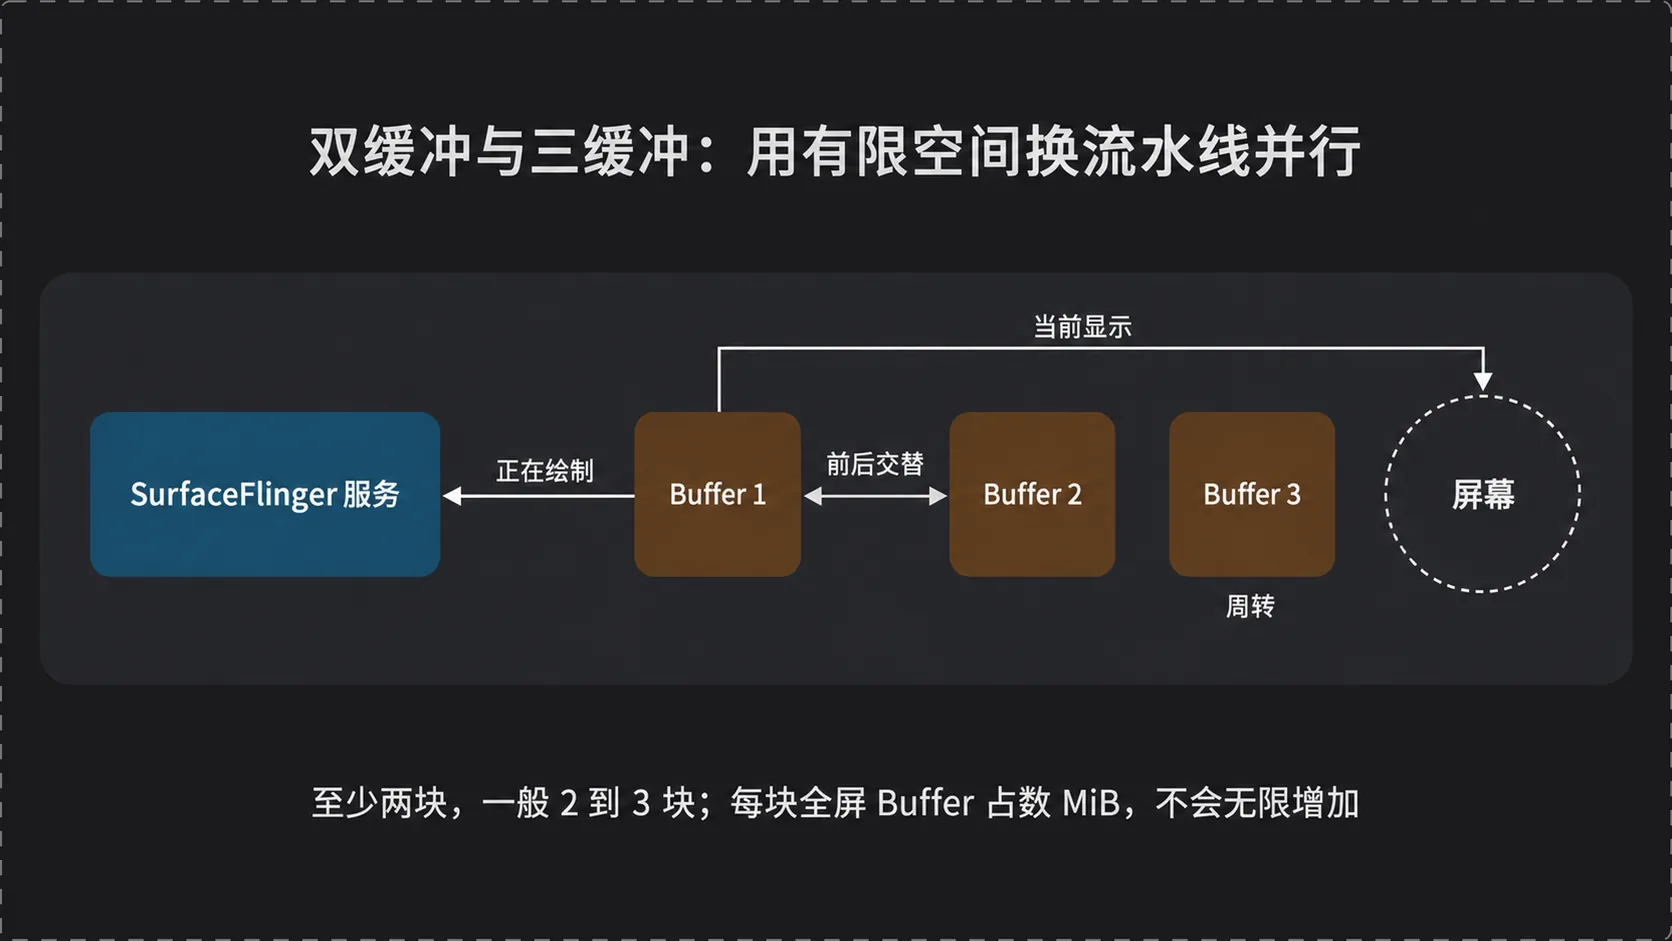
只有一块 Buffer 时,屏幕读取和 App 写入会争用同一块内存。显示硬件可能读到一半旧内容、一半新内容,形成撕裂;或者 App 必须等读取结束才能画,流水线完全串行。
双缓冲让两块 Buffer 前后交替:一块用于显示,另一块供 App 绘制,下一次刷新时交换角色。三缓冲再增加一块周转空间,在某一帧延迟时减少生产者和消费者互相等待。Buffer 数量可以在 1 到 N 之间按状态调整,实践中通常是 2~3 块。它不会无限增加,因为每块全屏 Buffer 都占数 MiB 内存,队列越深还会带来更高延迟。现代系统常见三缓冲,但核心原则仍是用有限空间换流水线并行。
三、SurfaceFlinger 启动 vsync
3.1 main() 入口
SurfaceFlinger 的入口做三组事:配置并启动 Binder 线程池,创建和初始化 SurfaceFlinger 后注册系统服务,最后在当前线程进入运行循环。初始化必须发生在客户端连接之前,因为显示设备、BufferQueue 和 Vsync 分发器都是后续服务的基础。
// 代码位置 frameworks/native/services/surfaceflinger/main_surfaceflinger.cpp// 定义 SurfaceFlinger 独立进程的入口int main(int, char**) { // 把 Binder 线程池上限设为 4 ProcessState::self()->setThreadPoolMaxThreadCount(4); // 取得进程级 Binder 状态对象 sp<ProcessState> ps(ProcessState::self()); // 启动 Binder 线程池 ps->startThreadPool(); // 创建 SurfaceFlinger 服务实例 sp<SurfaceFlinger> flinger = new SurfaceFlinger(); // 提高当前进程的显示任务优先级 setpriority(PRIO_PROCESS, 0, PRIORITY_URGENT_DISPLAY); // 把当前线程放入前台调度组 set_sched_policy(0, SP_FOREGROUND); // 在客户端可连接前完成初始化 flinger->init(); // 取得系统服务管理器 sp<IServiceManager> sm(defaultServiceManager()); // 注册 SurfaceFlinger 系统服务 sm->addService(String16(SurfaceFlinger::getServiceName()), flinger, false); // 在当前线程进入消息循环 flinger->run(); // 正常结束时返回成功 return 0;// 结束 main 函数}3.2 init() 里干了什么
init() 先建立 EGL 与 RenderEngine 等渲染基础,再创建 HWComposer。每个内建显示设备拥有 BufferQueue,producer 端提供 Buffer,consumer 端由 FramebufferSurface 接收。mPrimaryDispSync 根据硬件采样建立稳定的刷新模型,两个 DispSyncSource 再以不同相位提供 App 与 SurfaceFlinger 所需的信号。
这里有两条明确的分发支路:mEventThread 通知 App 开始绘制,mSFEventThread 通知 SurfaceFlinger 合成上屏。两者共用显示节拍,却可以设置不同的相位偏移,给绘制和合成预留各自的工作窗口。
// 代码位置 frameworks/native/services/surfaceflinger/SurfaceFlinger.cpp// 创建 Hardware Composer 并把 SurfaceFlinger 作为事件接收者mHWComposer = new HWComposer(this); // 为内建显示创建生产者与消费者组成的 BufferQueueBufferQueue::createBufferQueue(&producer, &consumer);// 用消费者端创建帧缓冲表面sp<FramebufferSurface> fbs = new FramebufferSurface(...); // 创建供 App 使用的 Vsync 源sp<DispSyncSource> vSyncSrc = new DispSyncSource(&mPrimaryDispSync, // 传入 App 分支的相位、抖动设置和名称 VSyncPhaseOffsetNs, true, "app");// 创建供 SurfaceFlinger 使用的 Vsync 源sp<DispSyncSource> sfVsyncSrc = new DispSyncSource(&mPrimaryDispSync, // 传入合成分支的相位、抖动设置和名称 SFVsyncPhaseOffsetNs, true, "sf"); // 创建通知 App 绘制的事件线程mEventThread = new EventThread(vSyncSrc);// 创建通知 SurfaceFlinger 合成的事件线程mSFEventThread = new EventThread(sfVsyncSrc, ...);// 创建负责开关硬件 Vsync 的控制线程mEventControlThread = new EventControlThread(this);3.3 加载 vsync 硬件模块
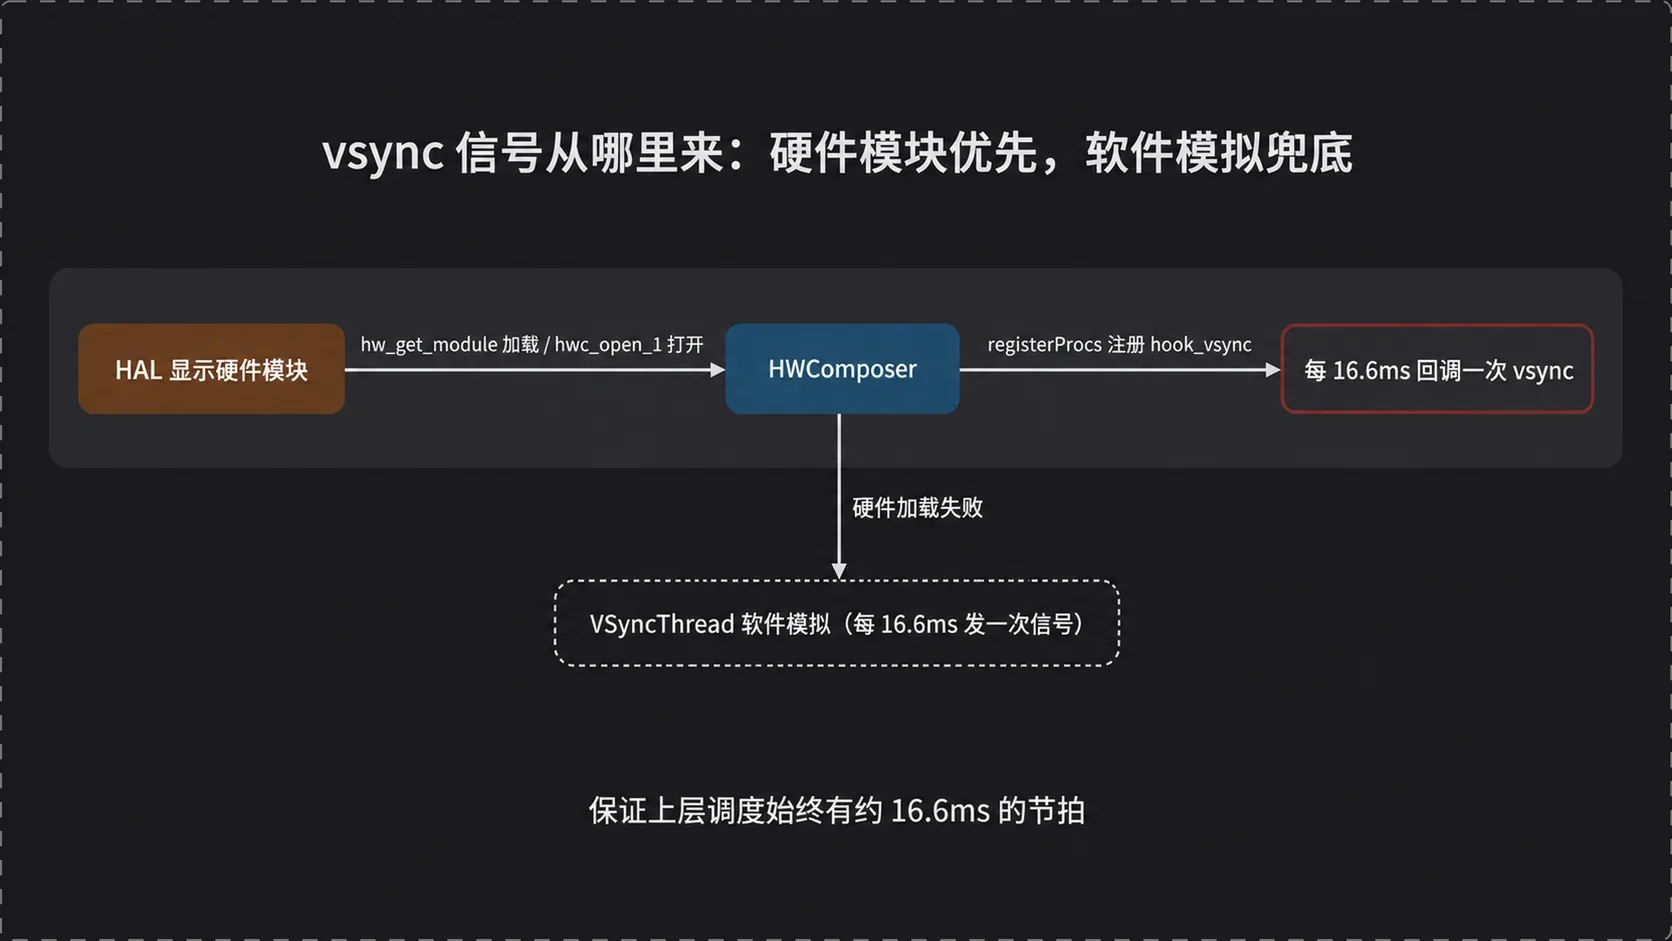
HWComposer 构造阶段会尝试加载帧缓冲和 HWC 模块。hw_get_module() 按 HAL 模块 ID 找到实现,hwc_open_1() 打开设备并取得句柄,随后校验 API 与头部版本。
// 代码位置 frameworks/native/services/surfaceflinger/DisplayHardware/HWComposer.cpp// 定义加载并准备硬件合成器模块的方法void HWComposer::loadHwcModule() { // 声明 HAL 模块指针 hw_module_t const* module; // 按 HWC 模块 ID 尝试加载模块 if (hw_get_module(HWC_HARDWARE_MODULE_ID, &module) < 0) { // 记录模块未找到错误 ALOGE("%s module not found", HWC_HARDWARE_MODULE_ID); // 加载失败后返回 return; // 结束模块加载失败分支 } // 打开 HWC 设备并保存句柄 int err = hwc_open_1(module, &mHwc); // 判断设备打开是否失败 if (err) { // 记录设备初始化错误 ALOGE("%s device failed to initialize (%s)", // 补齐日志参数 HWC_HARDWARE_COMPOSER, strerror(-err)); // 初始化失败后返回 return; // 结束设备初始化失败分支 } // 校验设备 API 与头部版本范围 if (!hwcHasApiVersion(mHwc, HWC_DEVICE_API_VERSION_1_0) || // 继续检查最低头部版本 hwcHeaderVersion(mHwc) < MIN_HWC_HEADER_VERSION || // 继续检查最高头部版本 hwcHeaderVersion(mHwc) > HWC_HEADER_VERSION) { // 记录版本不兼容错误 ALOGE("%s device version %#x unsupported, will not be used", // 补齐设备名与版本号 HWC_HARDWARE_COMPOSER, mHwc->common.version); // 关闭不兼容设备 hwc_close_1(mHwc); // 清空无效设备句柄 mHwc = NULL; // 结束加载 return; // 结束版本校验分支 }// 结束模块加载方法}3.4 注册回调与软件模拟兜底
硬件模块需要知道事件到来时调用谁。HWComposer 把当前对象和 invalidate、vsync、hotplug 三个函数放进回调上下文,再通过 registerProcs() 注册给 HWC。若硬件模块加载失败,系统会启动 VSyncThread 用软件定时模拟信号,确保刷新调度仍有约 16.6ms 的节拍。软件信号不是硬件反馈的等价物,但它保证了整条上层链路不会因为缺少 HWC 而失去时钟。
// 代码位置 frameworks/native/services/surfaceflinger/DisplayHardware/HWComposer.cpp// 创建 HWC 回调上下文mCBContext = new cb_context;// 保存当前 HWComposer 对象mCBContext->hwc = this;// 注册失效通知入口mCBContext->procs.invalidate = &hook_invalidate;// 注册 Vsync 通知入口mCBContext->procs.vsync = &hook_vsync;// 注册热插拔通知入口mCBContext->procs.hotplug = &hook_hotplug;// 把整组回调交给硬件模块mHwc->registerProcs(&mCBContext->procs);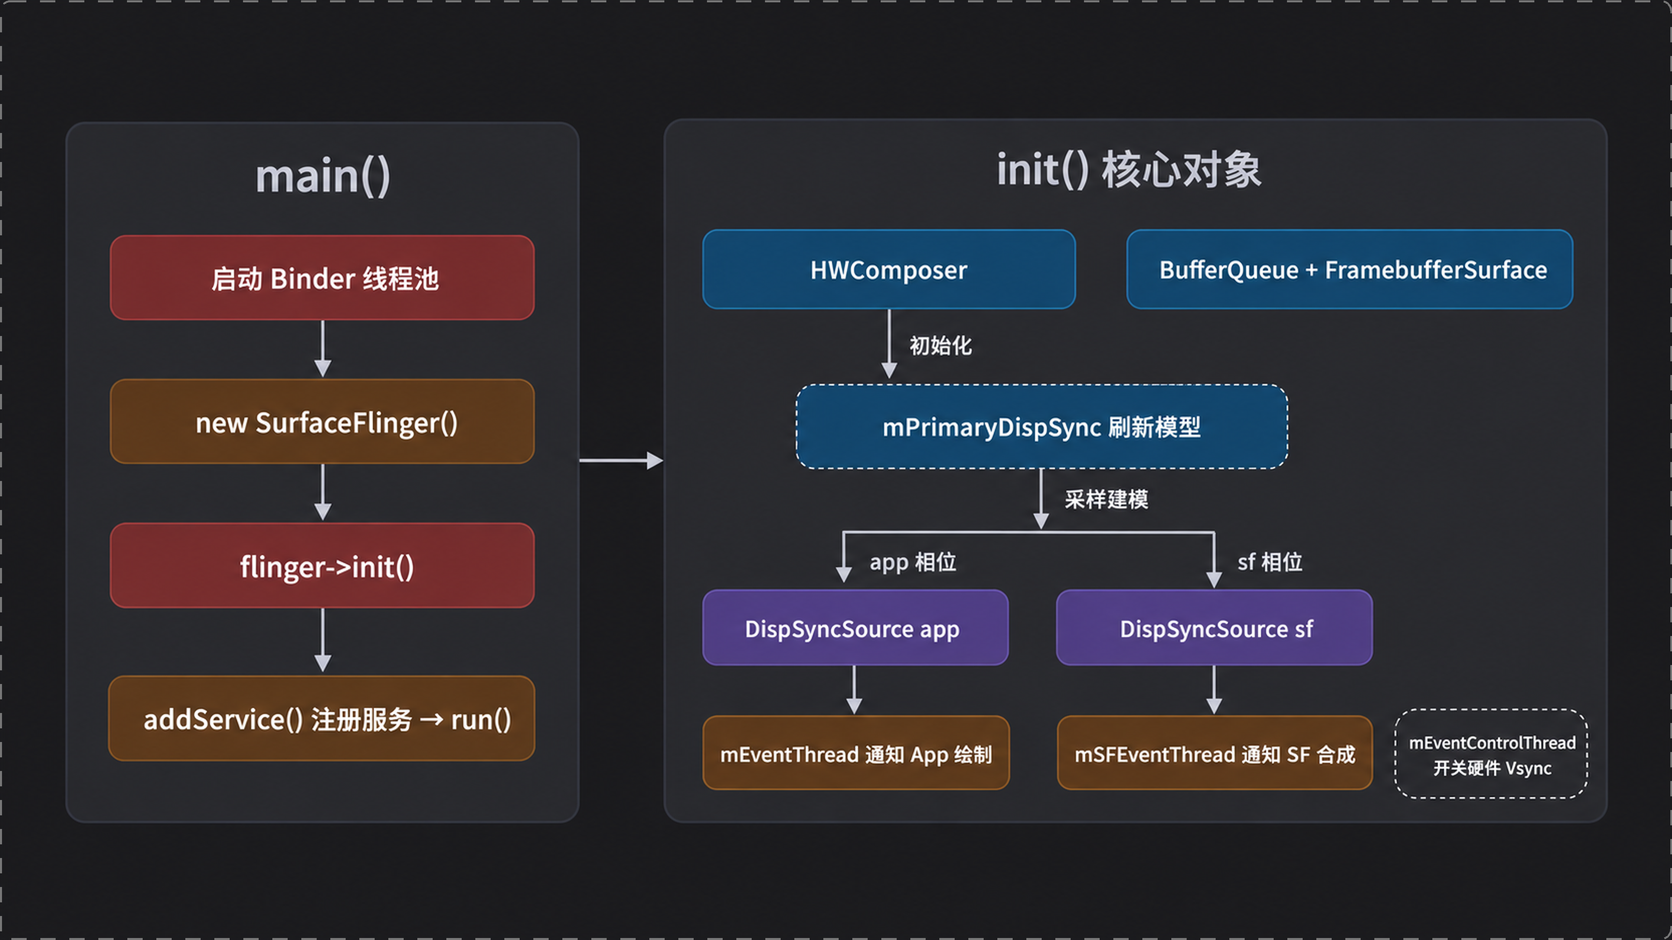
四、vsync 的分发:四级回调链
自己写一个小程序时,一个回调就能完成通知;Android 系统却要经过三四层。原因不是刻意复杂,而是这条链同时跨越 HAL 与 Framework、采样模型与事件调度、多个线程以及 App 进程。每一层只知道相邻接口,硬件实现可以替换,时序算法可以调整,App 也不必了解 SurfaceFlinger 内部对象。
主链路是:HWC 硬件 Vsync 中断进入 hook_vsync,转到 HWComposer::vsync 和 SurfaceFlinger::onVSyncReceived;DispSync 吸收采样并由 DispSyncThread 在预测时刻触发 DispSyncSource;EventThread 收集等待连接,经 Connection、DisplayEventReceiver 和 BitTube 把事件写入 App 可读的文件描述符。
4.1 第一级:硬件回调 hook_vsync
hook_vsync 是注册给 HWC 的静态式入口。硬件只持有 hwc_procs,因此函数先用 reinterpret_cast 恢复出包含宿主对象的 cb_context,再把显示编号和时间戳交给 HWComposer::vsync。热插拔采用相同桥接结构。
// 代码位置 frameworks/native/services/surfaceflinger/DisplayHardware/HWComposer.cpp// 定义 HWC 触发 Vsync 时调用的桥接函数void HWComposer::hook_vsync(const struct hwc_procs* procs, int disp, // 接收硬件给出的 Vsync 时间戳 int64_t timestamp) { // 从通用 procs 指针恢复回调上下文 cb_context* ctx = reinterpret_cast<cb_context*>( // 去掉常量限定以取得上下文对象 const_cast<hwc_procs_t*>(procs)); // 转给当前 HWComposer 实例处理 ctx->hwc->vsync(disp, timestamp);// 结束 Vsync 桥接函数} // 定义显示设备热插拔桥接函数void HWComposer::hook_hotplug(const struct hwc_procs* procs, int disp, // 接收连接状态 int connected) { // 从通用 procs 指针恢复回调上下文 cb_context* ctx = reinterpret_cast<cb_context*>( // 去掉常量限定以取得上下文对象 const_cast<hwc_procs_t*>(procs)); // 转给当前 HWComposer 实例处理热插拔 ctx->hwc->hotplug(disp, connected);// 结束热插拔桥接函数}4.2 第二级:SurfaceFlinger::onVSyncReceived
SurfaceFlinger 收到硬件时间戳后,不是立刻向所有 App 广播,而是先把主屏采样交给 mPrimaryDispSync.addResyncSample()。返回值表示当前模型是否仍需要硬件采样:模型不稳定或仍有监听需求时继续开启;满足条件后可以关闭硬件 Vsync 以节省功耗。
// 代码位置 frameworks/native/services/surfaceflinger/SurfaceFlinger.cpp// 定义 SurfaceFlinger 接收硬件 Vsync 的入口void SurfaceFlinger::onVSyncReceived(int type, nsecs_t timestamp) { // 默认不继续请求硬件 Vsync bool needsHwVsync = false; // 建立锁的局部作用域 { // 保护硬件 Vsync 状态 Mutex::Autolock _l(mHWVsyncLock); // 仅在主屏(HWC_DISPLAY_PRIMARY 编号为 0)硬件 Vsync 已开启时接收采样 if (type == 0 && mPrimaryHwVsyncEnabled) { // 把时间戳加入 DispSync 并取得后续采样需求 needsHwVsync = mPrimaryDispSync.addResyncSample(timestamp); // 结束采样条件分支 } // 结束锁作用域 } // 根据模型状态决定继续开启硬件信号 if (needsHwVsync) { // 打开硬件 Vsync enableHardwareVsync(); // 处理不再需要硬件采样的情况 } else { // 关闭硬件 Vsync 以降低功耗 disableHardwareVsync(false); // 结束开关判断 }// 结束硬件 Vsync 接收方法}4.3 第三级:DispSync 与 DispSyncThread
硬件时间戳会有细微波动,直接把每次中断当作上层调度时间不够稳定。DispSync 把采样保存在环形缓冲中,利用相邻差值估算平均周期,再把采样映射到单位圆上求平均相位。周期回答“多久一次”,相位回答“这个周期中的哪个位置发生”。
// 代码位置 frameworks/native/services/surfaceflinger/DispSync.cpp// 定义加入一次重新同步采样的方法bool DispSync::addResyncSample(nsecs_t timestamp) { // 锁住采样与模型数据 Mutex::Autolock lock(mMutex); // 计算环形缓冲的写入位置 size_t idx = (mFirstResyncSample + mNumResyncSamples) % MAX_RESYNC_SAMPLES; // 写入本次时间戳 mResyncSamples[idx] = timestamp; // 判断环形缓冲是否尚未写满 if (mNumResyncSamples < MAX_RESYNC_SAMPLES) { // 增加有效采样数 mNumResyncSamples++; // 处理环形缓冲已满的情况 } else { // 前移最早采样位置 mFirstResyncSample = (mFirstResyncSample + 1) % MAX_RESYNC_SAMPLES; // 结束容量判断 } // 根据新采样更新模型 updateModelLocked(); // 省略关键帧未完整展示的 present fence 处理 ... /* ……(未完整收录) */ // 判断当前配置是否忽略 present fence if (kIgnorePresentFences) { // 只要仍有监听者就继续请求硬件 Vsync return mThread->hasAnyEventListeners(); // 结束忽略 present fence 分支 } // 模型未建立或误差过大时继续采样 return mPeriod == 0 || mError > kErrorThreshold;// 结束加入采样的方法}// 代码位置 frameworks/native/services/surfaceflinger/DispSync.cpp// 定义根据采样拟合周期和相位的方法void DispSync::updateModelLocked() { // 确认采样数达到建模门槛 if (mNumResyncSamples >= MIN_RESYNC_SAMPLES_FOR_UPDATE) { // 初始化相邻采样间隔总和 nsecs_t durationSum = 0; // 遍历除首个采样外的全部采样 for (size_t i = 1; i < mNumResyncSamples; i++) { // 计算当前采样的环形索引 size_t idx = (mFirstResyncSample + i) % MAX_RESYNC_SAMPLES; // 计算前一个采样的环形索引 size_t prev = (idx + MAX_RESYNC_SAMPLES - 1) % MAX_RESYNC_SAMPLES; // 累加相邻时间差 durationSum += mResyncSamples[idx] - mResyncSamples[prev]; // 结束周期差遍历 } // 用时间差平均值估算周期 mPeriod = durationSum / (mNumResyncSamples - 1); // 初始化相位向量的 X 分量 double sampleAvgX = 0; // 初始化相位向量的 Y 分量 double sampleAvgY = 0; // 计算时间到圆周角度的缩放量 double scale = 2.0 * M_PI / double(mPeriod); // 遍历全部采样计算平均相位 for (size_t i = 0; i < mNumResyncSamples; i++) { // 计算当前采样的环形索引 size_t idx = (mFirstResyncSample + i) % MAX_RESYNC_SAMPLES; // 取得采样时间 nsecs_t sample = mResyncSamples[idx]; // 把采样在周期中的位置换算成角度 double samplePhase = double(sample % mPeriod) * scale; // 累加余弦分量 sampleAvgX += cos(samplePhase); // 累加正弦分量 sampleAvgY += sin(samplePhase); // 结束相位遍历 } // 计算 X 分量平均值 sampleAvgX /= double(mNumResyncSamples); // 计算 Y 分量平均值 sampleAvgY /= double(mNumResyncSamples); // 由平均向量反推时间相位 mPhase = nsecs_t(atan2(sampleAvgY, sampleAvgX) / scale); // 把负相位归一化到当前周期 if (mPhase < 0) { // 加一个周期得到正相位 mPhase += mPeriod; // 结束负相位修正 } // 省略关键帧未完整展示的误差计算 ... /* ……(未完整收录) */ // 结束采样数量判断 } // 省略关键帧未完整展示的其他模型逻辑 ... /* ……(未完整收录) */ // 把最新周期与相位传给分发线程 mThread->updateModel(mPeriod, mPhase);// 结束模型更新方法}模型更新后,DispSyncThread 计算下一个事件时刻,用条件变量休眠到目标时刻附近,收集已到期的监听者,再在锁外逐个回调。锁外调用很重要:监听者可能进入其他模块并再次取锁,持锁回调会放大阻塞甚至制造死锁。
// 代码位置 frameworks/native/services/surfaceflinger/DispSync.cpp// 定义 Vsync 分发线程的循环virtual bool threadLoop() { // 声明等待结果 status_t err; // 读取单调时钟 nsecs_t now = systemTime(SYSTEM_TIME_MONOTONIC); // 初始化下一事件时刻 nsecs_t nextEventTime = 0; // 持续执行分发循环 while (true) { // 创建本轮待触发回调列表 Vector<CallbackInvocation> callbackInvocations; // 初始化本轮目标时刻 nsecs_t targetTime = 0; // 建立锁的局部作用域 { // 保护模型与监听者列表 Mutex::Autolock lock(mMutex); // 检查线程停止标志 if (mStop) { // 退出线程循环 return false; // 结束停止检查 } // 检查模型是否尚未建立 if (mPeriod == 0) { // 等待模型或事件更新 err = mCond.wait(mMutex); // 检查等待错误 if (err != NO_ERROR) { // 记录条件变量等待错误 ALOGE("error waiting for new events: %s (%d)", // 补齐错误文本和错误码 strerror(-err), err); // 终止异常线程 return false; // 结束错误检查 } // 重新开始循环 continue; // 结束无周期模型分支 } // 根据当前时间计算下一事件时刻 nextEventTime = computeNextEventTimeLocked(now); // 保存本轮目标时刻 targetTime = nextEventTime; // 初始化超时唤醒标志 bool isWakeup = false; // 当前时间尚未到目标时刻时等待 if (now < targetTime) { // 相对等待到目标时刻 err = mCond.waitRelative(mMutex, targetTime - now); // 判断是否因到时而唤醒 if (err == TIMED_OUT) { // 标记本轮已到触发点 isWakeup = true; // 结束超时判断 } // 省略关键帧未完整展示的时间更新逻辑 ... /* ……(未完整收录) */ // 结束等待分支 } // 判断是否应触发本轮事件 if (now >= targetTime || isWakeup) { // 收集全部到期监听者 callbackInvocations = gatherCallbackInvocationsLocked(now); // 省略关键帧未完整展示的统计逻辑 ... /* ……(未完整收录) */ // 结束触发判断 } // 结束锁作用域 } // 在锁外逐个执行回调 fireCallbackInvocations(callbackInvocations); // 结束持续循环 }// 结束线程循环方法} // 定义收集到期回调的方法Vector<CallbackInvocation> DispSyncThread::gatherCallbackInvocationsLocked( // 接收当前时间 nsecs_t now) { // 创建待触发回调列表 Vector<CallbackInvocation> callbackInvocations; // 以一个周期前作为计算参考 nsecs_t ref = now - mPeriod; // 遍历全部事件监听者 for (size_t i = 0; i < mEventListeners.size(); i++) { // 计算当前监听者下一次事件时刻 nsecs_t t = computeListenerNextEventTimeLocked(mEventListeners[i], ref); // 判断事件是否已经到期 if (t < now) { // 创建一次回调调用记录 CallbackInvocation ci; // 保存监听者回调对象 ci.mCallback = mEventListeners[i].mCallback; // 保存应触发的事件时刻 ci.mEventTime = t; // 把调用记录加入列表 callbackInvocations.push(ci); // 更新监听者上次事件时刻 mEventListeners.editItemAt(i).mLastEventTime = t; // 结束到期判断 } // 结束监听者遍历 } // 返回本轮待触发列表 return callbackInvocations;// 结束回调收集方法} // 定义批量触发回调的方法void fireCallbackInvocations(const Vector<CallbackInvocation>& callbacks) { // 遍历待触发回调 for (size_t i = 0; i < callbacks.size(); i++) { // 把预测事件时刻交给对应监听者 callbacks[i].mCallback->onDispSyncEvent(callbacks[i].mEventTime); // 结束回调遍历 }// 结束批量触发方法}4.4 第四级:EventThread
DispSyncSource 实现了 DispSync::Callback,因此会收到 onDispSyncEvent;它再调用已设置的 VSyncSource::Callback,也就是对应的 EventThread。回调对象的取出和调用分在两段执行:锁内只拷贝指针,出锁后才进入上层,和 DispSyncThread::fireCallbackInvocations 锁外回调的原则一致,避免持锁期间调用可能再次取锁的 EventThread。
// 代码位置 frameworks/native/services/surfaceflinger/DispSyncSource.cpp// 定义 DispSync 触发事件时调用的回调方法virtual void onDispSyncEvent(nsecs_t when) { // 声明局部回调对象,避免持锁期间调用上层代码 sp<VSyncSource::Callback> callback; // 建立锁的局部作用域 { // 保护回调指针 Mutex::Autolock lock(mCallbackMutex); // 取出已注册的回调对象 callback = mCallback; // 结束锁作用域 } // 判断是否已经设置回调 if (callback != NULL) { // 把事件时间转交给 EventThread callback->onVSyncEvent(when); // 结束回调判断 }// 结束 DispSync 事件回调方法}EventThread 把时间戳封装成 DISPLAY_EVENT_VSYNC,递增序号并唤醒等待分发的线程。至此,连续时间模型变成了可交付给连接的离散事件。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义 Vsync 事件进入 EventThread 的入口void EventThread::onVSyncEvent(nsecs_t timestamp) { // 锁住事件状态 Mutex::Autolock _l(mLock); // 标记事件类型为 Vsync mVSyncEvent[0].header.type = DisplayEventReceiver::DISPLAY_EVENT_VSYNC; // 标记内建显示设备编号 mVSyncEvent[0].header.id = 0; // 写入事件时间戳 mVSyncEvent[0].header.timestamp = timestamp; // 递增 Vsync 序号 mVSyncEvent[0].vsync.count++; // 唤醒等待事件的分发线程 mCondition.broadcast();// 结束 Vsync 事件接收方法}4.5 EventThread::threadLoop 与 Connection
EventThread 不会把每次 Vsync 无差别广播给所有连接。waitForEvent() 先取出最新事件,再遍历连接,只有 count >= 0、也就是正在等待 Vsync 的连接才进入发送列表。没有事件但有人等待时开启 Vsync;有事件却无人等待时关闭 Vsync;两边都没有工作时线程休眠。热插拔等普通事件也在这里处理:onHotplugReceived 把事件写进 mPendingEvents,waitForEvent() 在暂无 Vsync 时从这个队列取事件。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义热插拔事件到达时的处理方法void EventThread::onHotplugReceived(int disp, bool connected) { // 声明待入队的显示事件 DisplayEventReceiver::Event event; // 标记事件类型为热插拔 event.header.type = DisplayEventReceiver::DISPLAY_EVENT_HOTPLUG; // 记录发生热插拔的显示设备编号 event.header.id = disp; // 记录事件发生的时间戳 event.header.timestamp = systemTime(); // 记录当前连接状态 event.hotplug.connected = connected; // 锁住事件队列 Mutex::Autolock _l(mLock); // 把事件加入待发送队列 mPendingEvents.add(event); // 唤醒分发线程处理新事件 mCondition.broadcast();// 结束热插拔事件处理方法}// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义等待事件并收集目标连接的方法Vector< sp<EventThread::Connection> > EventThread::waitForEvent( // 接收输出事件的地址 DisplayEventReceiver::Event* event) { // 锁住事件与连接状态 Mutex::Autolock _l(mLock); // 创建本轮目标连接列表 Vector< sp<EventThread::Connection> > signalConnections; // 至少循环到找到可通知连接 do { // 初始化普通事件待处理标志 bool eventPending = false; // 初始化是否有人等待 Vsync bool waitForVSync = false; // 初始化可分发的 Vsync 配额 size_t vsyncCount = 0; // 初始化事件时间戳 nsecs_t timestamp = 0; // 遍历内建显示设备 for (int32_t i = 0; i < DisplayDevice::NUM_BUILTIN_DISPLAY_TYPES; i++) { // 读取该显示设备最新时间戳 timestamp = mVSyncEvent[i].header.timestamp; // 判断是否存在待发 Vsync if (timestamp) { // 复制待发事件 *event = mVSyncEvent[i]; // 清空槽位时间戳表示已经取走 mVSyncEvent[i].header.timestamp = 0; // 取得本轮 Vsync 配额 vsyncCount = mVSyncEvent[i].vsync.count; // 找到事件后停止遍历 break; // 结束时间戳判断 } // 结束显示设备遍历 } // 没有 Vsync 时检查其他事件 if (!timestamp) { // 判断普通事件队列是否非空 eventPending = !mPendingEvents.isEmpty(); // 存在普通事件时取出队首 if (eventPending) { // 复制队首事件 *event = mPendingEvents[0]; // 从队列移除已取事件 mPendingEvents.removeAt(0); // 结束普通事件判断 } // 结束无 Vsync 分支 } // 取得显示事件连接数量 size_t count = mDisplayEventConnections.size(); // 遍历全部连接 for (size_t i = 0; i < count; i++) { // 尝试把弱引用提升为强引用 sp<Connection> connection(mDisplayEventConnections[i].promote()); // 跳过已经销毁的连接 if (connection != NULL) { // 初始化当前连接是否应加入列表 bool added = false; // 非负计数表示连接正在等待 Vsync if (connection->count >= 0) { // 标记至少有一个连接等待 waitForVSync = true; // 判断本轮是否还有 Vsync 配额 if (vsyncCount > 0) { // 消耗连接的一次通知计数 connection->count--; // 消耗本轮一次 Vsync 配额 vsyncCount--; // 标记连接应接收事件 added = true; // 结束配额判断 } // 结束连接等待判断 } // 普通事件存在且连接尚未加入时也应通知 if (eventPending && !timestamp && !added) { // 标记连接应接收普通事件 added = true; // 结束普通事件判断 } // 判断是否加入发送列表 if (added) { // 保存目标连接 signalConnections.add(connection); // 结束加入判断 } // 结束有效连接判断 } // 结束连接遍历 } // 有事件却无人等待时关闭 Vsync if (timestamp && !waitForVSync) { // 关闭 Vsync 源 disableVSyncLocked(); // 无事件但有人等待时开启 Vsync } else if (!timestamp && waitForVSync) { // 开启 Vsync 源 enableVSyncLocked(); // 结束开关判断 } // 无事件也无人等待时进入休眠 if (!timestamp && !eventPending && !waitForVSync) { // 等待状态变化 mCondition.wait(mLock); // 结束休眠判断 } // 列表为空时继续等待 } while (signalConnections.isEmpty()); // 返回本轮目标连接 return signalConnections;// 结束事件等待方法}拿到连接列表后,threadLoop() 逐个调用 postEvent()。通道暂时写满时丢弃事件;管道已经断开时清理连接。Vsync 是时效性信号,过期事件排队补发通常没有价值。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义 EventThread 的分发循环bool EventThread::threadLoop() { // 创建本轮显示事件 DisplayEventReceiver::Event event; // 创建目标连接列表 Vector< sp<EventThread::Connection> > signalConnections; // 等待事件并收集目标连接 signalConnections = waitForEvent(&event); // 取得目标连接数量 const size_t count = signalConnections.size(); // 遍历所有目标连接 for (size_t i = 0; i < count; i++) { // 取得当前连接引用 const sp<Connection>& conn(signalConnections[i]); // 尝试把事件写入连接 status_t err = conn->postEvent(event); // 处理通道暂时不可写 if (err == -EAGAIN || err == -EWOULDBLOCK) { // 记录并丢弃本次过期事件 ALOGW("EventThread: dropping event (%#x) for connection %p", // 补齐事件类型和连接地址 event.header.type, conn.get()); // 处理其他写入错误 } else if (err < 0) { // 从 EventThread 中移除失效连接 removeDisplayEventConnection(signalConnections[i]); // 结束写入错误判断 } // 结束目标连接遍历 } // 保持线程继续运行 return true;// 结束事件线程循环}每个 App 通过一个 Connection 接入 EventThread。连接向服务端注册自己,暴露 BitTube 数据通道,并把频率设置、单次请求和事件发送转交给对应对象。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义连接首次获得强引用时的动作void EventThread::Connection::onFirstRef() { // 向 EventThread 注册当前连接且不形成服务端强引用环 mEventThread->registerDisplayEventConnection(this);// 结束首次引用处理} // 定义取得跨进程数据通道的方法sp<BitTube> EventThread::Connection::getDataChannel() const { // 返回当前连接持有的通道 return mChannel;// 结束数据通道获取方法} // 定义设置 Vsync 频率的方法void EventThread::Connection::setVsyncRate(uint32_t count) { // 把频率设置交给 EventThread mEventThread->setVsyncRate(count, this);// 结束频率设置方法} // 定义请求下一次 Vsync 的方法void EventThread::Connection::requestNextVsync() { // 把单次请求交给 EventThread mEventThread->requestNextVsync(this);// 结束单次请求方法} // 定义向当前连接投递事件的方法status_t EventThread::Connection::postEvent( // 接收待投递的显示事件 const DisplayEventReceiver::Event& event) { // 通过 DisplayEventReceiver 写入一条事件 ssize_t size = DisplayEventReceiver::sendEvents(mChannel, &event, 1); // 把写入结果转换为状态码 return size < 0 ? status_t(size) : status_t(NO_ERROR);// 结束事件投递方法}最后由 DisplayEventReceiver 与 BitTube 完成。BitTube 底层使用 socketpair 文件描述符,SOCK_SEQPACKET 保持消息边界;服务端写入完整事件对象,App 端从对应 fd 读取。Binder 建立和控制连接,频繁的 Vsync 数据则走这条轻量通道。
// 代码位置 frameworks/native/libs/gui/DisplayEventReceiver.cpp 与 BitTube.cpp// 定义 App 侧请求下一次 Vsync 的方法status_t DisplayEventReceiver::requestNextVsync() { // 检查事件连接是否已经建立 if (mEventConnection != NULL) { // 通过 Binder 连接请求下一次 Vsync mEventConnection->requestNextVsync(); // 返回请求成功 return NO_ERROR; // 结束连接检查 } // 返回尚未初始化 return NO_INIT;// 结束 Vsync 请求方法} // 定义向 BitTube 发送显示事件的方法ssize_t DisplayEventReceiver::sendEvents(const sp<BitTube>& dataChannel, // 接收事件数组与数量 Event const* events, size_t count) { // 把事件数组作为对象写入通道 return BitTube::sendObjects(dataChannel, events, count);// 结束事件发送方法} // 定义从 BitTube 接收显示事件的方法ssize_t DisplayEventReceiver::getEvents(const sp<BitTube>& dataChannel, // 接收输出数组与最大数量 Event* events, size_t count) { // 从通道读取完整事件对象 return BitTube::recvObjects(dataChannel, events, count);// 结束事件接收方法} // 定义 BitTube 的对象发送方法ssize_t BitTube::sendObjects(const sp<BitTube>& tube, // 接收对象地址、数量与单个大小 void const* events, size_t count, size_t objSize) { // 把对象首地址转换为字节指针 const char* vaddr = reinterpret_cast<const char*>(events); // 向文件描述符写入全部对象字节 ssize_t size = tube->write(vaddr, count * objSize); // 检查是否出现不完整对象 LOG_ALWAYS_FATAL_IF((size >= 0) && (size % static_cast<ssize_t>(objSize)), // 报告发送半包错误 "BitTube::sendObjects(count=%zu, size=%zu), res=%zd (partial events were sent!)", // 补齐错误消息参数 count, objSize, size); // 返回错误码或完整对象数量 return size < 0 ? size : size / static_cast<ssize_t>(objSize);// 结束对象发送方法} // 定义 BitTube 的对象接收方法ssize_t BitTube::recvObjects(const sp<BitTube>& tube, // 接收输出地址、数量与单个大小 void* events, size_t count, size_t objSize) { // 把输出地址转换为字节指针 char* vaddr = reinterpret_cast<char*>(events); // 从文件描述符读取对象字节 ssize_t size = tube->read(vaddr, count * objSize); // 检查是否收到不完整对象 LOG_ALWAYS_FATAL_IF((size >= 0) && (size % static_cast<ssize_t>(objSize)), // 报告接收半包错误 "BitTube::recvObjects(count=%zu, size=%zu), res=%zd (partial events were received!)", // 补齐错误消息参数 count, objSize, size); // 返回错误码或完整对象数量 return size < 0 ? size : size / static_cast<ssize_t>(objSize);// 结束对象接收方法}4.6 节流语义:一次请求,一次通知
连接的 count 体现节流语义。默认状态是 -1,不接收连续 Vsync;App 调用 requestNextVsync() 后,服务端把 count 从 -1 置为 0(进入等待),waitForEvent() 据此把连接加入发送列表,发出一条事件后递减回 -1,不再继续发送。下一帧需要更新时,App 再请求一次。setVsyncRate(n) 则把 count 置为 n-1,实现每 n 拍发一次的连续模式。这样既避免空闲 App 每 16.6ms 被唤醒,也让绘制调度显式地与帧需求绑定。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义处理单次 Vsync 请求的方法void EventThread::requestNextVsync( // 接收发起请求的连接 const sp<EventThread::Connection>& connection) { // 锁住连接状态 Mutex::Autolock _l(mLock); // 仅在连接当前未等待时才重新计数 if (connection->count < 0) { // 标记一次性事件待触发 connection->count = 0; // 唤醒分发线程重新评估状态 mCondition.broadcast(); // 结束等待状态判断 }// 结束单次请求处理方法} // 定义设置连续 Vsync 频率的方法void EventThread::setVsyncRate(uint32_t count, // 接收发起设置的连接 const sp<EventThread::Connection>& connection) { // 只接受合法的频率取值 if (int32_t(count) >= 0) { // 锁住连接状态 Mutex::Autolock _l(mLock); // count 为 0 表示停止连续接收,其余按周期数换算 const int32_t newCount = (count == 0) ? -1 : int32_t(count) - 1; // 仅在取值变化时更新并唤醒 if (connection->count != newCount) { // 保存新的计数状态 connection->count = newCount; // 唤醒分发线程重新评估状态 mCondition.broadcast(); // 结束变化判断 } // 结束合法性判断 }// 结束频率设置方法}当至少有连接等待时,EventThread 给 DispSyncSource 设置回调并开启信号;无人等待时关闭。这个开关会继续影响 DispSync 是否保留监听者,以及 SurfaceFlinger 是否需要硬件采样,节流因此贯穿从 App 请求到硬件 Vsync。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp// 定义在有连接等待时开启 Vsync 的方法void EventThread::enableVSyncLocked() { // 仅在未使用软件 Vsync 时进入硬件分支 if (!useSoftwareVSync) { // 检查 Vsync 当前是否关闭 if (!vsyncEnabled) { // 更新 Vsync 状态 vsyncEnabled = true; // 把当前 EventThread 设置为回调目标 vsyncSource->setCallback( // 转换为 VSyncSource 的回调接口 static_cast<VSyncSource::Callback*>(this)); // 开启 VsyncSource vsyncSource->setVSyncEnabled(true); // 更新调试状态 debugVsyncEnabled = true; // 发送 Vsync 性能提示 sendVsyncHintOnLocked(); // 结束启用状态判断 } // 结束软件 Vsync 判断 }// 结束开启 Vsync 方法} // 定义无人等待时关闭 Vsync 的方法void EventThread::disableVSyncLocked() { // 检查 Vsync 当前是否开启 if (vsyncEnabled) { // 更新 Vsync 状态 vsyncEnabled = false; // 关闭 VsyncSource vsyncSource->setVSyncEnabled(false); // 更新调试状态 debugVsyncEnabled = false; // 结束启用状态判断 }// 结束关闭 Vsync 方法}// 代码位置 frameworks/native/services/surfaceflinger/DispSyncSource.cpp// 定义开启或关闭 DispSyncSource 的方法virtual void setVSyncEnabled(bool enable) { // 锁住 VsyncSource 状态 Mutex::Autolock lock(mVsyncMutex); // 判断是否需要启用 if (enable) { // 按相位偏移向 DispSync 注册当前监听者 status_t err = mDispSync->addEventListener(mPhaseOffset, // 把当前对象转换为 DispSync 回调接口 static_cast<DispSync::Callback*>(this)); // 检查注册是否失败 if (err != NO_ERROR) { // 记录注册错误 ALOGE("error registering vsync callback: %s (%d)", // 补齐错误文本和错误码 strerror(-err), err); // 结束注册错误判断 } // 记录 Vsync 开启跟踪值 ATRACE_INT(mVsyncOnLabel.string(), 1); // 处理关闭请求 } else { // 从 DispSync 注销当前监听者 status_t err = mDispSync->removeEventListener( // 把当前对象转换为 DispSync 回调接口 static_cast<DispSync::Callback*>(this)); // 检查注销是否失败 if (err != NO_ERROR) { // 记录注销错误 ALOGE("error unregistering vsync callback: %s (%d)", // 补齐错误文本和错误码 strerror(-err), err); // 结束注销错误判断 } // 记录 Vsync 关闭跟踪值 ATRACE_INT(mVsyncOnLabel.string(), 0); // 结束启用与关闭分支 } // 保存最终启用状态 mEnabled = enable;// 结束 VsyncSource 开关方法} // 定义设置上层回调对象的方法virtual void setCallback(const sp<VSyncSource::Callback>& callback) { // 锁住回调指针 Mutex::Autolock lock(mCallbackMutex); // 保存 EventThread 提供的回调对象 mCallback = callback;// 结束回调设置方法}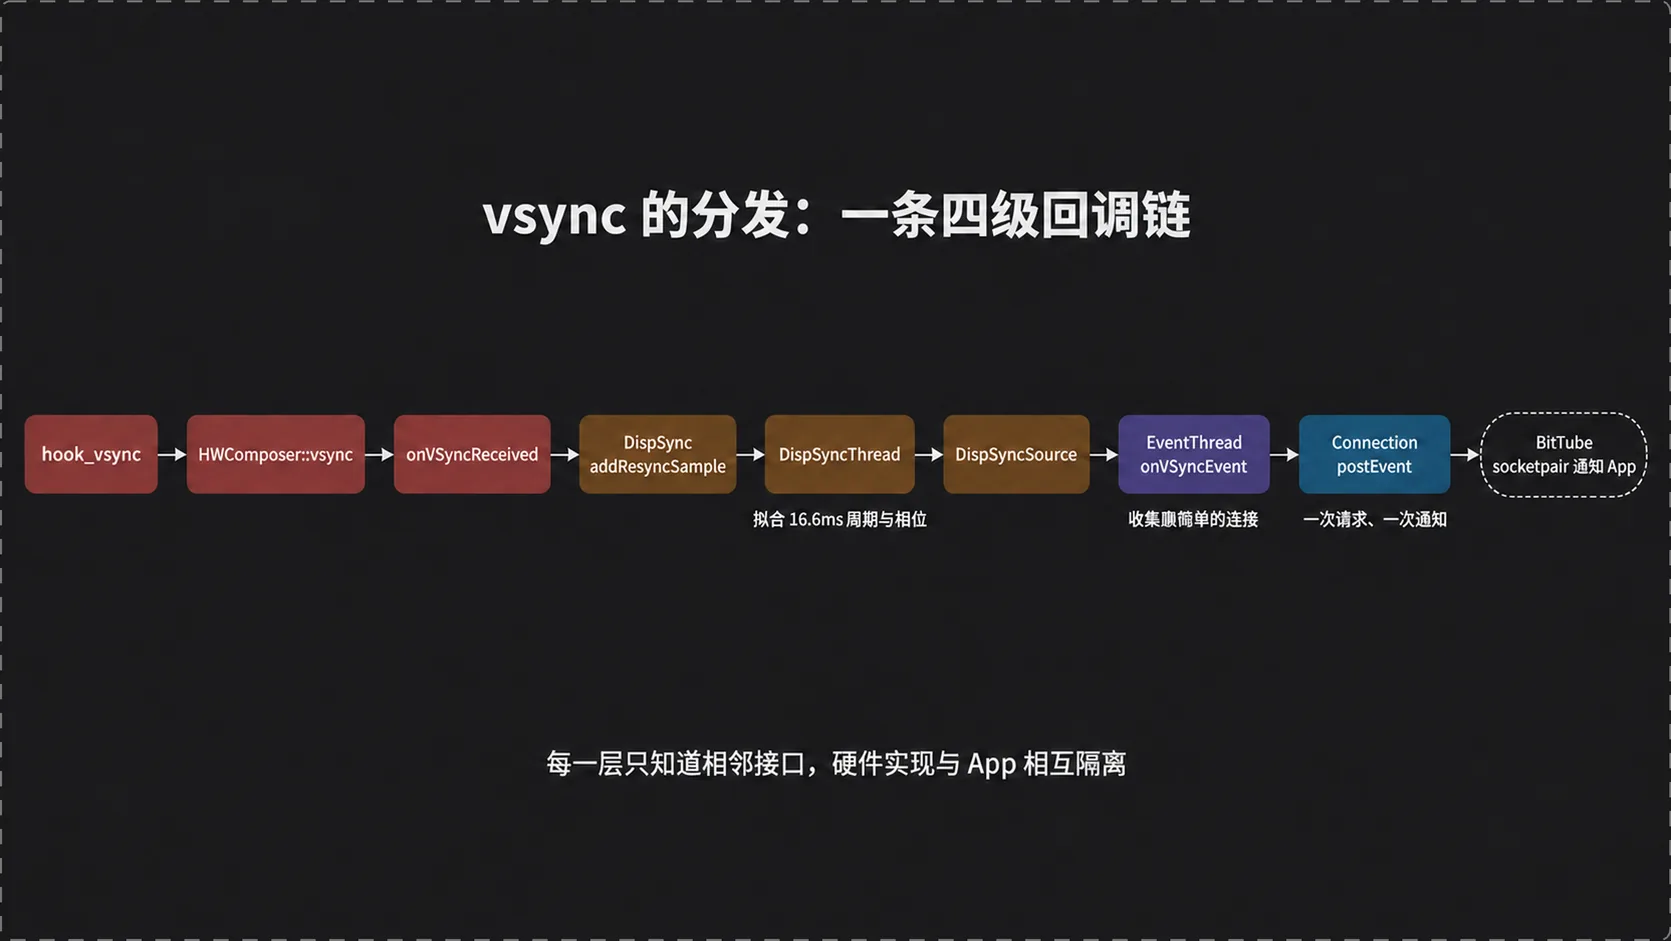
五、小结
5.1 界面卡顿
界面卡顿的直接表现是某个刷新点没有新帧可显示。对 60Hz 屏幕而言,App 若没能在约 16.6ms 的预算内完成需要的工作并提交 Buffer,就可能错过目标 Vsync;SurfaceFlinger 只能合成上一帧,屏幕重复旧画面。两次刷新之间提交再多次也不会让屏幕多扫描几次,反而可能浪费 CPU、GPU 与内存带宽。
因此排查卡顿不能只问“有没有调用 invalidate”或“有没有进入 onDraw”,还要问:这一帧何时收到调度、主线程何时完成、Buffer 何时入队、SurfaceFlinger 在合成点拿到的是哪一帧。卡顿是整条生产—消费链路的截止时间问题。
5.2 onDraw 之后不会立即刷新
onDraw() 完成只说明绘制命令已经把内容写进当前 Buffer。之后还要归还并提交 Buffer,等待 Vsync 节拍,等待 SurfaceFlinger 取得各图层并完成合成,再由显示硬件在扫描周期中输出。任何一环尚未发生,物理屏幕都不会立刻变化。
这也解释了为什么在 onDraw() 后立即观察屏幕,不能把“方法已经返回”当作“像素已经发光”。代码执行完成与硬件显示完成属于不同时间域。
5.3 SurfaceView / GLSurfaceView
普通 View 的内容通常进入宿主窗口的 Surface,跟随主界面一起遍历和提交。SurfaceView 拥有独立 Surface 与 BufferQueue,内容生产者可以不依赖主 View 树的每次绘制而单独更新;SurfaceFlinger 最终仍会把它作为一个图层参与合成。所谓“单独刷新”不是绕过 SurfaceFlinger,而是拥有独立的生产队列和提交节奏。
GLSurfaceView 建立在 SurfaceView 之上,用 EGL 管理渲染上下文和显示表面,用 OpenGL ES 生成 Buffer 内容。它改变的是 Buffer 如何被生产,不改变最后的系统边界:新 Buffer 仍需入队,仍要在 Vsync 驱动的合成节拍中被 SurfaceFlinger 取用并显示。
Android 的界面刷新不是“画完就上屏”,而是由 SurfaceFlinger 以硬件 Vsync 为节拍统一调度:App 在 Vsync 到来时绘制并提交 Buffer,SurfaceFlinger 按同一节奏合成并输出到屏幕。丢帧、缓冲和多级回调看似分散,实际上都在解决同一件事——让生产、交付与消费对齐约 16.6ms 的刷新周期。
从 HWC 的硬件回调到 App 端 BitTube 中的一条事件,这套设计把硬件差异、时钟拟合、线程调度和跨进程通信拆成清晰边界。理解这些边界后,onDraw() 为什么不立即上屏、卡顿为何发生、SurfaceView 为什么能独立更新,都会落回同一条可追踪的链路。
本文由 AgentWorkFlow 生成