
文章内容
- 一、VSync 要解决的问题:为什么不能想画就画
- 1.1 一次 requestLayout 到一次真正上屏
- 1.2 一次 vsync 的两个接收方:SurfaceFlinger 与 App
- 1.3 为什么必须由 App 主动请求
- 二、信号从哪来:SurfaceFlinger
- 2.1 init 里创建的两个 EventThread 与 DispSyncSource
- 2.2 DispSync 的周期与 16.67ms 兜底
- 2.3 硬件 vsync 到来后如何变成 EventThread::onVSyncEvent
- 三、App 侧: requestLayout 如何变成vsync 请求
- 3.1 scheduleTraversals:mTraversalScheduled 合并
- 3.2 mTraversalBarrier:同步屏障与紧急的异步消息
- 3.3 Choreographer.postCallback 到 postCallbackDelayedInternal
- 3.4 scheduleFrameLocked 的两个分支与 scheduleVsyncLocked
- 四、请求如何跨进程送到 SurfaceFlinger
- 4.1 DisplayEventReceiver 的构造与 nativeInit
- 4.2 NativeDisplayEventReceiver.initialize 与 Looper.addFd
- 4.3 DisplayEventReceiver.cpp:createDisplayEventConnection 与数据通道
- 4.4 EventThread::Connection 的 count 状态位:一次请求只换一次通知
- 五、接收:信号如何到达 App 主线程
- 5.1 EventThread::threadLoop 与 waitForEvent 的筛选条件
- 5.2 Connection::postEvent 到 BitTube::write
- 5.3 Looper 的 epoll:addFd、pollInner 与回调派发
- 5.4 handleEvent、getEvents 与 JNI dispatchVsync
- 5.5 FrameDisplayEventReceiver.onVsync 到 Choreographer.doFrame
- 5.6 丢帧判定与 doTraversal 的收尾
- 六、小结
一帧画面为什么要等 VSync?requestLayout() 发起布局请求后,App 如何申请下一个信号,SurfaceFlinger 又如何把它送回 App 主线程?这条链路横跨 Java、JNI、Binder、Unix socket 与 Looper。
一、VSync 要解决的问题:为什么不能想画就画
1.1 一次 requestLayout 到一次真正上屏
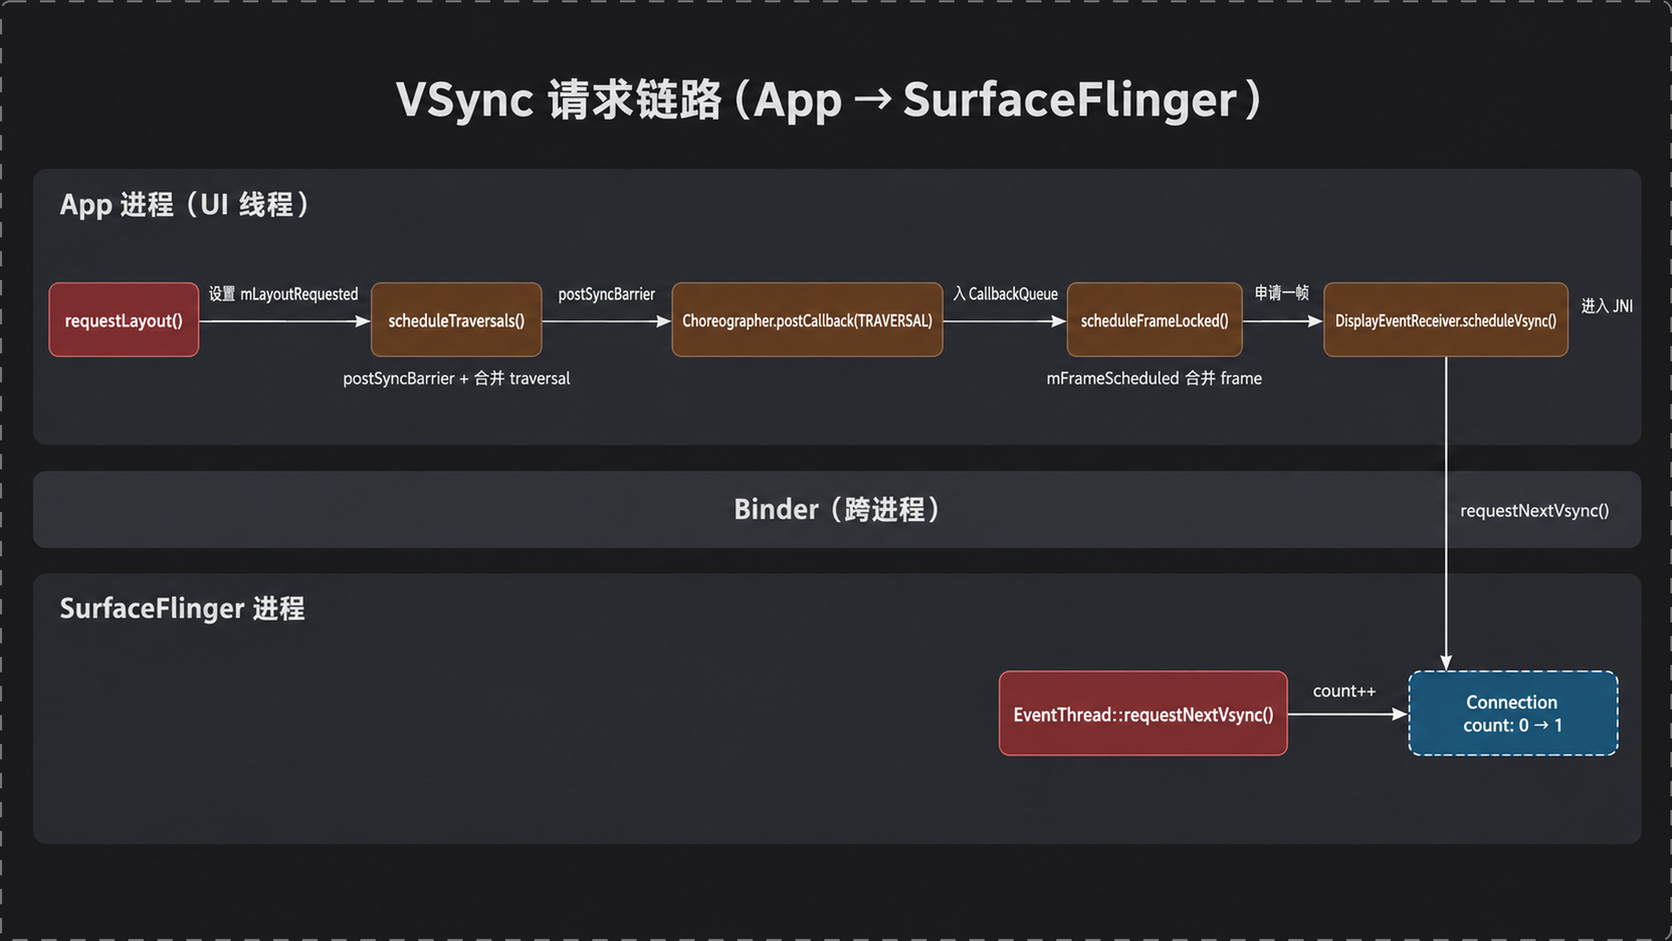
requestLayout() 不直接执行 measure、layout、draw。它检查线程,设置 mLayoutRequested,再交给 scheduleTraversals() 安排一次遍历。invalidate() 的入口不同:它扩大脏区,在当前没有即将发生的绘制时同样进入 scheduleTraversals()。两条入口在这里汇合。
这段代码明确了布局与重绘请求的职责:更新状态并安排遍历。实际绘制仍由后续帧回调驱动。
// 代码位置 frameworks/base/core/java/android/view/ViewRootImpl.java 第 905—911 行、第 918—923 行 // 标记该方法实现父类或接口定义。 @Override // 接收一次重新布局请求。 public void requestLayout() { // 避免在布局请求处理阶段重复进入。 if (!mHandlingLayoutInLayoutRequest) { // 要求调用发生在创建视图树的线程。 checkThread(); // 记录下一次遍历需要执行布局。 mLayoutRequested = true; // 安排一次视图树遍历。 scheduleTraversals(); // 结束条件分支。 } // 结束方法。 } // 接收一次整棵根视图的失效请求。 void invalidate() { // 把根视图范围写入脏区域。 mDirty.set(0, 0, mWidth, mHeight); // 当前没有即将发生的绘制时才安排遍历。 if (!mWillDrawSoon) { // 复用统一的遍历调度入口。 scheduleTraversals(); // 结束条件分支。 } // 结束方法。 }布局或失效请求在这里生成“下一帧需要遍历”的状态。调用栈此时还没有进入 performTraversals(),因此多次调用 API 不会立即执行多次渲染。
从状态变化看,requestLayout() 主要影响下一次遍历是否重新测量和布局,invalidate() 主要记录需要重绘的区域。二者都没有自行选择显示时刻。若每次属性变化都立刻遍历,连续修改多个 View 会反复计算中间状态,生成的部分帧也未必赶得上显示设备的扫描节拍。集中到一次帧回调后,视图树可以基于这一帧开始前已经累积的状态执行遍历。
1.2 一次 vsync 的两个接收方:SurfaceFlinger 与 App
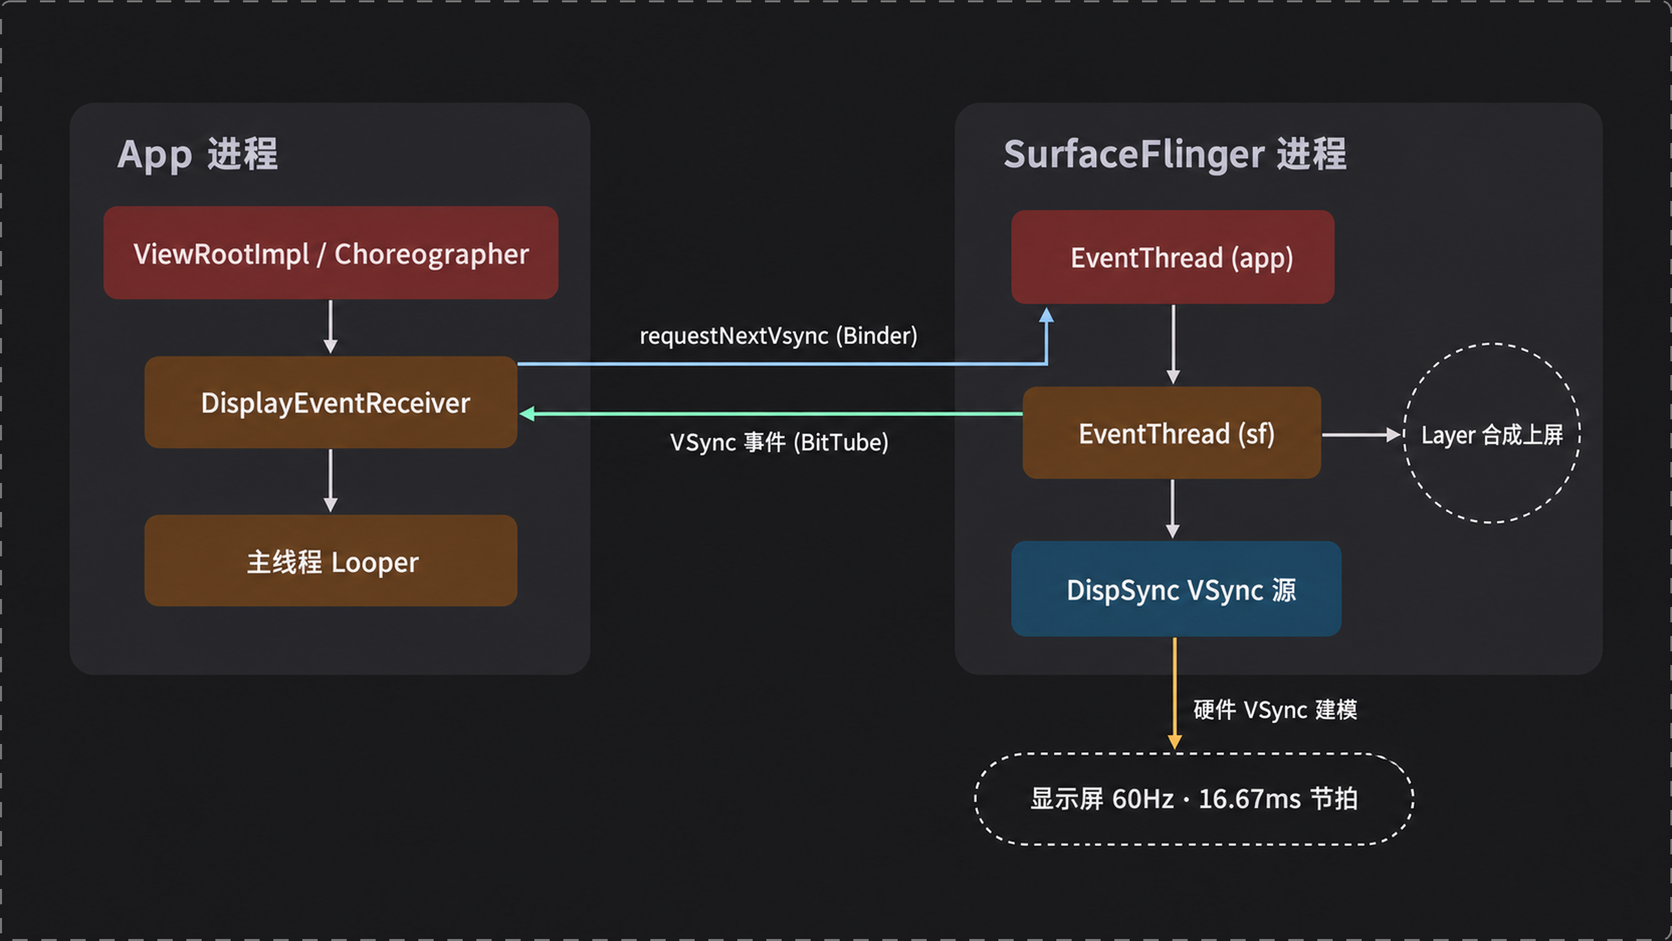
VSync 节拍有两个直接消费者。SurfaceFlinger 一侧需要按节拍合成各个 Layer 并提交显示;App 一侧需要在合适的帧边界准备下一帧的 UI 内容。二者处于不同进程,也使用不同的 EventThread。这能让 App 的渲染准备与 SurfaceFlinger 的合成显示围绕同一显示周期运行,同时保留各自的相位偏移。
对 60Hz 屏幕而言,一个周期约为 16.67ms。这个数字表示帧节拍,不表示每次 measure/layout/draw 必然耗时 16.67ms。如果主线程错过目标帧时间,后续 doFrame() 会根据时间抖动估算跳过的帧数。
1.3 为什么必须由 App 主动请求
SurfaceFlinger 无法获知每个 App 当前是否产生了新的绘制任务。若向所有连接持续广播,空闲进程也会频繁被唤醒,信号到达时却可能没有待执行的遍历。requestNextVsync() 让产生绘制需求的 App 决定是否申请信号:App 有任务时申请一次,在下一个 VSync 到来后收到一次通知。
这个设计还限定了通知到达率。一次性请求在服务端由 count 状态记录,未请求的连接不会被加入本轮发送列表。持续监听由 setVsyncRate() 控制,其状态与 App 常用的单次请求不同。
二、信号从哪来:SurfaceFlinger
2.1 init 里创建的两个 EventThread 与 DispSyncSource
SurfaceFlinger 初始化时创建名为 app 和 sf 的两个 DispSyncSource,并各自绑定一个 EventThread。mEventThread 服务于 App 建立的显示事件连接,mSFEventThread 接入 SurfaceFlinger 自己的事件队列。
// 代码位置 frameworks/native/services/surfaceflinger/SurfaceFlinger.cpp 第 496—511 行 // 标记显示事件线程开始初始化。 // start the EventThread // 为 App 侧创建带相位偏移的 VSync 源。 sp<VSyncSource> vsyncSrc = new DispSyncSource(&mPrimaryDispSync, // 传入 App 相位偏移、启用标志与名称。 vsyncPhaseOffsetNs, true, "app"); // 创建负责向 App 分发事件的线程。 mEventThread = new EventThread(vsyncSrc); // 为 SurfaceFlinger 创建另一条 VSync 源。 sp<VSyncSource> sfVsyncSrc = new DispSyncSource(&mPrimaryDispSync, // 传入合成侧相位偏移、启用标志与名称。 sfVsyncPhaseOffsetNs, true, "sf"); // 创建合成侧显示事件线程。 mSFEventThread = new EventThread(sfVsyncSrc); // 把 SurfaceFlinger 事件队列连接到合成侧线程。 mEventQueue.setEventThread(mSFEventThread); // 创建硬件 VSync 控制线程。 mEventControlThread = new EventControlThread(this); // 以紧急显示优先级启动控制线程。 mEventControlThread->run("EventControl", PRIORITY_URGENT_DISPLAY); // 说明以下分支用于没有硬件合成器时设置模拟周期。 // set a fake vsync period if there is no HWComposer // 检查硬件合成器初始化是否失败。 if (mHwc->initCheck() != NO_ERROR) { // 把主 DispSync 周期设置为 16666667 纳秒。 mPrimaryDispSync.setPeriod(16666667); // 结束兜底分支。 }初始化的结果是两条分发路径共享 mPrimaryDispSync 的时间基准,但连接和回调互不混用。App 通过 SurfaceFlinger::createDisplayEventConnection() 获得的连接归入 mEventThread。
2.2 DispSync 的周期与 16.67ms 兜底
16666667 的单位是纳秒,换算后约为 16.67ms。硬件合成器不可用时,mPrimaryDispSync.setPeriod(16666667) 提供 60Hz 的软件周期。EventThread::waitForEvent() 还保留 ms2ns(16) 的超时模拟路径:没有连接请求时等待条件变量;需要软件模拟时,超时后构造 DISPLAY_EVENT_VSYNC。
这里需要区分“信号来源”和“交付策略”。硬件或软件周期负责产生时间事件,EventThread 根据连接状态决定哪些事件应交付给 App。后者才是本文所分析的请求与接收边界。
2.3 硬件 vsync 到来后如何变成 EventThread::onVSyncEvent
硬件 VSync 进入 SurfaceFlinger::onVSyncReceived() 后,时间戳作为重同步样本交给 mPrimaryDispSync。DispSyncSource 在软件时间线上收到 onDispSyncEvent,随后调用已经注册的 mCallback->onVSyncEvent(when);该回调指向 EventThread::onVSyncEvent()。
onVSyncEvent() 填充事件类型、显示 ID、时间戳并递增计数,然后唤醒 waitForEvent()。至此,信号已进入分发线程,但尚未发送给任何 App。发送对象仍要由每条 Connection 的 count 决定。
三、App 侧: requestLayout 如何变成vsync 请求
3.1 scheduleTraversals:mTraversalScheduled 合并
scheduleTraversals() 的第一层控制是 mTraversalScheduled。第一次调用把它设为 true 并安排回调;这次遍历完成或被取消前,后续调用都无法再次进入分支(即使连续调用一百次 requestLayout(),也只会保留一次待执行的 traversal)。
正常执行和取消任务都会复位标志并移除同步屏障,两条路径的清理操作相互对应。
// 代码位置 frameworks/base/core/java/android/view/ViewRootImpl.java 第 1075—1114 行 // 定义统一的遍历调度入口。 void scheduleTraversals() { // 只允许一个尚未执行的遍历任务存在。 if (!mTraversalScheduled) { // 记录遍历已经进入待执行状态。 mTraversalScheduled = true; // 插入同步屏障并保存屏障令牌。 mTraversalBarrier = mHandler.getLooper().getQueue().postSyncBarrier(); // 向 Choreographer 登记 traversal 类型回调。 mChoreographer.postCallback( // 传入回调类型、任务对象和空令牌。 Choreographer.CALLBACK_TRAVERSAL, mTraversalRunnable, null); // 未开启无缓冲输入分发时先安排批量输入事件的合并处理。 if (!mUnbufferedInputDispatch) { // 安排一次批量输入事件的消费。 scheduleConsumeBatchedInput(); // 结束输入分发判断。 } // 通知渲染线程有新的一帧正在等待。 notifyRendererOfFramePending(); // 按需持有绘制锁,避免过早进入休眠。 pokeDrawLockIfNeeded(); // 结束去重分支。 } // 结束调度方法。 } // 定义取消遍历的方法。 void unscheduleTraversals() { // 仅处理已经安排的遍历。 if (mTraversalScheduled) { // 清除待遍历标志。 mTraversalScheduled = false; // 用保存的令牌移除同步屏障。 mHandler.getLooper().getQueue().removeSyncBarrier(mTraversalBarrier); // 从 Choreographer 移除 traversal 回调。 mChoreographer.removeCallbacks( // 指定相同的类型、任务对象和令牌。 Choreographer.CALLBACK_TRAVERSAL, mTraversalRunnable, null); // 结束条件分支。 } // 结束取消方法。 } // 定义遍历执行入口。 void doTraversal() { // 确认本次遍历仍处于待执行状态。 if (mTraversalScheduled) { // 在执行前释放合并状态。 mTraversalScheduled = false; // 移除此前插入的同步屏障。 mHandler.getLooper().getQueue().removeSyncBarrier(mTraversalBarrier); // 需要采样时开启方法级别的性能跟踪。 if (mProfile) { // 以固定标签开始记录调用链耗时。 Debug.startMethodTracing("ViewAncestor"); // 结束性能采样判断。 } // 进入 measure、layout、draw 的总入口。 performTraversals(); // 采样开启时在遍历结束后停止跟踪。 if (mProfile) { // 停止本次方法级别的性能采样。 Debug.stopMethodTracing(); // 采样只执行一次,用完即关闭开关。 mProfile = false; // 结束停止采样判断。 } // 结束条件分支。 } // 结束遍历方法。 }mTraversalScheduled 合并的是“尚未执行的遍历”,不会吞掉遍历期间新产生且需要下一帧处理的状态。unscheduleTraversals() 可撤销排队任务;doTraversal() 则在执行前清状态,随后进入 performTraversals()。
3.2 mTraversalBarrier:同步屏障与紧急的异步消息
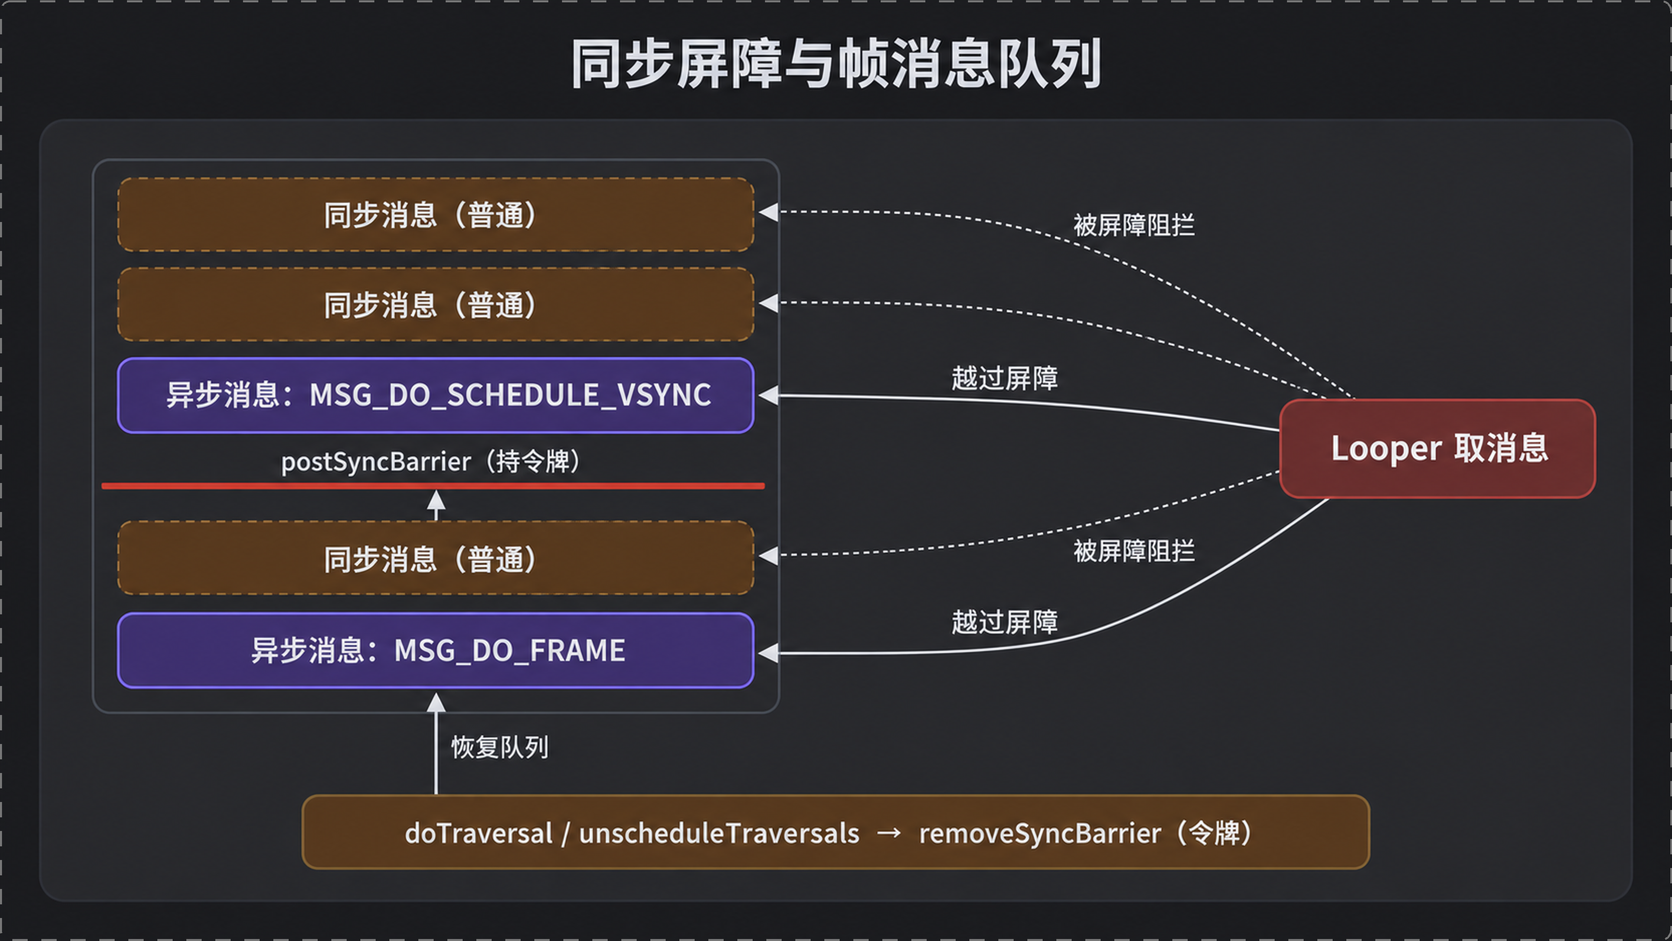
postSyncBarrier() 会让 MessageQueue 暂时跳过屏障后的同步消息,异步消息仍能被取出。帧调度相关消息通过 setAsynchronous(true) 标记,因此可以越过普通同步消息,尽快完成 VSync 请求或执行帧回调。
这里的“越过”有明确范围:它改变屏障存在期间的消息选择,并不代表任意插队,也不意味着直接抢占正在执行的主线程任务。主线程若被长任务占用,异步消息仍要等 Looper 重新取消息。
屏障的移除时机同样影响消息队列能否恢复。scheduleTraversals() 保存 postSyncBarrier() 返回的令牌,doTraversal() 与 unscheduleTraversals() 都用该令牌调用 removeSyncBarrier()。前者对应正常执行,后者对应取消任务。两条路径都清理屏障,避免普通同步消息长期停在队列中。VSync 调度消息和帧消息采用异步标记,目的是让“申请帧、处理帧”这条控制路径在屏障期间保持可运行。
3.3 Choreographer.postCallback 到 postCallbackDelayedInternal
ViewRootImpl 提交的是 CALLBACK_TRAVERSAL。postCallback() 把延迟设为 0,经 postCallbackDelayed() 进入内部方法。回调先加入对应类型的 CallbackQueue;到期时间不晚于当前时间时,立即调用 scheduleFrameLocked(now)。有延迟时才发送 MSG_DO_SCHEDULE_CALLBACK,该消息同样被标为异步。
代码把“保存待执行回调”和“请求一帧”分成两个状态:回调进入队列后,帧调度可以继续合并。
// 代码位置 frameworks/base/core/java/android/view/Choreographer.java 第 330—332 行、第 360—382 行 // 暴露无延迟的回调登记入口。 public void postCallback(int callbackType, Runnable action, Object token) { // 把请求转换为延迟为零的调用。 postCallbackDelayed(callbackType, action, token, 0); // 结束公开方法。 } // 定义回调登记的内部实现。 private void postCallbackDelayedInternal(int callbackType, // 接收回调对象、令牌和延迟时间。 Object action, Object token, long delayMillis) { // 调试开关打开时记录本次回调登记的参数。 if (DEBUG_FRAMES) { // 输出回调类型、动作对象、令牌与延迟时间。 Log.d(TAG, "PostCallback: type=" + callbackType // 拼接动作对象和令牌。 + ", action=" + action + ", token=" + token // 拼接延迟时间。 + ", delayMillis=" + delayMillis); // 结束调试日志分支。 } // 在锁内维护回调队列和帧状态。 synchronized (mLock) { // 读取当前运行时间。 final long now = SystemClock.uptimeMillis(); // 计算回调的到期时间。 final long dueTime = now + delayMillis; // 把回调加入对应类型的队列。 mCallbackQueues[callbackType].addCallbackLocked(dueTime, action, token); // 已到期时立即申请一帧。 if (dueTime <= now) { // 进入帧调度合并逻辑。 scheduleFrameLocked(now); // 未到期时安排延迟消息。 } else { // 创建到期后触发调度的消息。 Message msg = mHandler.obtainMessage(MSG_DO_SCHEDULE_CALLBACK, action); // 保存回调类型。 msg.arg1 = callbackType; // 允许消息越过同步屏障。 msg.setAsynchronous(true); // 按到期时间发送消息。 mHandler.sendMessageAtTime(msg, dueTime); // 结束到期时间分支。 } // 释放调度锁。 } // 结束内部方法。 }traversal 回调以零延迟进入 CallbackQueue,同时触发一次帧调度尝试。addCallbackLocked() 不执行回调;回调要等 doFrame() 按类型调用 doCallbacks()。
3.4 scheduleFrameLocked 的两个分支与 scheduleVsyncLocked
mFrameScheduled 是第二层合并开关。启用 VSync 时,如果调用线程就是目标 Looper 线程,代码直接执行 scheduleVsyncLocked();否则发送置于队首的异步 MSG_DO_SCHEDULE_VSYNC,把 native 请求切回 UI 线程。未启用 VSync 时,代码按 sFrameDelay 计算 MSG_DO_FRAME 的时间,这是一条不同的定时消息路径。
代码节选包含请求 VSync 所需的两个线程分支。
// 代码位置 frameworks/base/core/java/android/view/Choreographer.java 第 518—547 行、第 704—710 行(节选) // 省略调试日志与未启用 VSync 时的定时消息分支。 // 在锁内安排下一帧。 private void scheduleFrameLocked(long now) { // 确保同一时刻只有一个待处理帧。 if (!mFrameScheduled) { // 记录已有帧等待执行。 mFrameScheduled = true; // 选择基于 VSync 的路径。 if (USE_VSYNC) { // 判断当前线程是否为目标 Looper 线程。 if (isRunningOnLooperThreadLocked()) { // 同线程时立即向显示事件接收器请求信号。 scheduleVsyncLocked(); // 其他线程需要把操作转交给 UI 线程。 } else { // 创建专用的 VSync 调度消息。 Message msg = mHandler.obtainMessage(MSG_DO_SCHEDULE_VSYNC); // 将消息标为异步以越过同步屏障。 msg.setAsynchronous(true); // 放到队首以减少请求延迟。 mHandler.sendMessageAtFrontOfQueue(msg); // 结束线程判断。 } // 结束 VSync 路径。 } // 结束帧合并分支。 } // 结束帧调度方法。 } // 封装显示事件接收器的 VSync 请求。 private void scheduleVsyncLocked() { // 把请求交给 DisplayEventReceiver。 mDisplayEventReceiver.scheduleVsync(); // 结束方法。 } // 判断当前线程持有的 Looper 是否为目标 Looper。 private boolean isRunningOnLooperThreadLocked() { // 返回两个 Looper 是否相同。 return Looper.myLooper() == mLooper; // 结束判断方法。 }到这里,请求链已从 requestLayout() 走到 DisplayEventReceiver.scheduleVsync()。两层布尔状态分别合并 traversal 和 frame,避免同一帧内重复向 SurfaceFlinger 发请求。
四、请求如何跨进程送到 SurfaceFlinger
4.1 DisplayEventReceiver 的构造与 nativeInit
Java 层 DisplayEventReceiver 保存 MessageQueue,防止 native 对端使用期间被垃圾回收。构造函数用自身弱引用和队列调用 nativeInit();返回的 NativeDisplayEventReceiver 对象指针存入 mReceiverPtr。后续 nativeScheduleVsync() 与 nativeDispose() 都通过这个指针找到同一个 C++ 对象。
dispatchVsync() 和 dispatchHotplug() 是 native 回调 Java 的入口。本文只沿 VSync 分支:scheduleVsync() 检查指针有效性后进入 nativeScheduleVsync(),接收时由 native 调用 dispatchVsync(),再转给可覆写的 onVsync()。
这段代码连接了 Java 对象生命周期、MessageQueue 与 native 接收器。
// 代码位置 frameworks/base/core/java/android/view/DisplayEventReceiver.java 第 48—66 行、第 129—148 行(节选) // 省略与请求和派发主链无关的字段及资源清理代码。 // 声明创建 native 接收器的 JNI 方法。 private static native long nativeInit(WeakReference<DisplayEventReceiver> receiver, // 把主线程消息队列传入 native 层。 MessageQueue messageQueue); // 声明释放 native 接收器的方法。 private static native void nativeDispose(long receiverPtr); // 声明申请下一次 VSync 的方法。 private static native void nativeScheduleVsync(long receiverPtr); // 用指定 Looper 创建显示事件接收器。 public DisplayEventReceiver(Looper looper) { // 拒绝空 Looper。 if (looper == null) { // 抛出参数异常。 throw new IllegalArgumentException("looper must not be null"); // 结束参数检查。 } // 保存 Looper 对应的消息队列。 mMessageQueue = looper.getQueue(); // 创建 native 对象并保存其指针。 mReceiverPtr = nativeInit(new WeakReference<DisplayEventReceiver>(this), mMessageQueue); // 登记资源关闭检查。 mCloseGuard.open("dispose"); // 结束构造函数。 } // 请求下一次垂直同步信号。 public void scheduleVsync() { // native 对象已释放时只记录警告,不再请求。 if (mReceiverPtr == 0) { // 输出对象已释放但仍尝试调度的告警。 Log.w(TAG, "Attempted to schedule a vertical sync pulse but the display event " // 拼接告警文本的后一部分。 + "receiver has already been disposed."); // 对象仍然有效时才真正发起请求。 } else { // 通过对象指针进入 JNI。 nativeScheduleVsync(mReceiverPtr); // 结束有效性判断。 } // 结束请求方法。 } // 标记该方法由 native 代码调用。 @SuppressWarnings("unused") // 接收 JNI 派发的 VSync 参数。 private void dispatchVsync(long timestampNanos, int builtInDisplayId, int frame) { // 转交给子类实现。 onVsync(timestampNanos, builtInDisplayId, frame); // 结束派发方法。 }4.2 NativeDisplayEventReceiver.initialize 与 Looper.addFd
NativeDisplayEventReceiver::initialize() 检查 gui 层 DisplayEventReceiver 的初始化状态,再取出接收端 fd。它把 fd、EVENT_INPUT 以及自身回调对象交给主线程 Looper 的 addFd()。这项注册在请求 VSync 之前完成,因而接收端从创建时就处于 epoll 监听中。
mWaitingForVsync 又做了一层 native 侧合并;仅当当前没有等待信号时才清空旧事件并调用 requestNextVsync()。
// 代码位置 frameworks/base/core/jni/android_view_DisplayEventReceiver.cpp 第 88—101 行、第 111—130 行(节选)// 省略不影响控制流的调试与告警日志。// 定义 native 接收器初始化流程。status_t NativeDisplayEventReceiver::initialize() { // 检查 gui 层接收器状态。 status_t result = mReceiver.initCheck(); // 初始化失败时进入错误分支。 if (result) { // 返回具体失败状态。 return result; // 结束状态检查。 } // 把接收 fd 和当前对象注册到主线程 Looper。 int rc = mMessageQueue->getLooper()->addFd(mReceiver.getFd(), 0, Looper::EVENT_INPUT, // 当前对象负责处理 fd 就绪事件。 this, NULL); // 注册失败时返回通用错误。 if (rc < 0) { // 报告初始化失败。 return UNKNOWN_ERROR; // 结束注册结果检查。 } // 初始化成功。 return OK;// 结束初始化方法。} // 定义单次 VSync 请求。status_t NativeDisplayEventReceiver::scheduleVsync() { // 当前没有请求在途时才继续。 if (!mWaitingForVsync) { // 准备保存排空事件后留下的最后时间戳。 nsecs_t vsyncTimestamp; // 准备保存对应的显示 ID。 int32_t vsyncDisplayId; // 准备保存对应的 VSync 计数。 uint32_t vsyncCount; // 丢弃通道里残留的旧事件并保留最后值。 processPendingEvents(&vsyncTimestamp, &vsyncDisplayId, &vsyncCount); // 经 gui 层对象发起跨进程请求。 status_t status = mReceiver.requestNextVsync(); // 请求失败时返回错误。 if (status) { // 把错误状态交给上层。 return status; // 结束失败分支。 } // 标记已有一个 VSync 请求在等待。 mWaitingForVsync = true; // 结束合并分支。 } // 返回成功。 return OK;// 结束请求方法。}nativeInit() 创建对象、调用 initialize(),增加强引用后以 jlong 返回地址。这个地址充当 Java 层再次调用 native 方法时使用的对象句柄,本身不承载事件数据。
4.3 DisplayEventReceiver.cpp:createDisplayEventConnection 与数据通道
gui 层 DisplayEventReceiver 从 ComposerService 取得 ISurfaceComposer,通过 Binder 调用 SurfaceFlinger::createDisplayEventConnection()。服务端返回 EventThread::Connection 的 Binder 接口,getDataChannel() 则把 BitTube 接收端带回 App 进程。
Connection 第一次获得强引用时,onFirstRef() 调用 registerDisplayEventConnection(),把连接以弱引用形式加入 mDisplayEventConnections。这一步建立了 Binder 连接与 App 侧数据通道的对应关系;销毁 App 连接不会因为 EventThread 持有强引用而受到阻碍。
控制请求走 Binder,事件数据走 BitTube;这是两条用途不同的跨进程通道。
// 代码位置 frameworks/native/libs/gui/DisplayEventReceiver.cpp 第 34—42 行、第 71—95 行(节选)// 省略 getFd() 与 sendEvents(),正文说明它们在链路中的作用。// 构造 gui 层显示事件接收器。DisplayEventReceiver::DisplayEventReceiver() { // 获取 SurfaceFlinger 的 Binder 接口。 sp<ISurfaceComposer> sf(ComposerService::getComposerService()); // 确认服务接口有效。 if (sf != NULL) { // 创建服务端显示事件连接。 mEventConnection = sf->createDisplayEventConnection(); // 确认连接创建成功。 if (mEventConnection != NULL) { // 取得 BitTube 数据通道的接收端。 mDataChannel = mEventConnection->getDataChannel(); // 结束连接检查。 } // 结束服务检查。 }// 结束构造函数。} // 请求连接的下一次 VSync。status_t DisplayEventReceiver::requestNextVsync() { // 仅在 Binder 连接有效时请求。 if (mEventConnection != NULL) { // 发起异步的 Binder 请求。 mEventConnection->requestNextVsync(); // 表示请求已提交。 return NO_ERROR; // 结束连接检查。 } // 报告连接尚未初始化。 return NO_INIT;// 结束请求方法。} // 从 BitTube 批量接收显示事件。ssize_t DisplayEventReceiver::getEvents(const sp<BitTube>& dataChannel, // 接收目标数组与最大数量。 Event* events, size_t count)// 开始函数体。{ // 委托 BitTube 的对象接收接口读取。 return BitTube::recvObjects(dataChannel, events, count);// 结束函数体。}sendEvents() 与 getEvents() 对称,前者最终调用 BitTube::sendObjects(),后者调用 recvObjects()。因此 Binder 只传递“申请下一次 VSync”及连接管理操作,不承载每一帧的事件负载。
这组接口也解释了请求方向与通知方向为何使用不同机制。App 发出的 requestNextVsync() 是一次方法调用,需要定位服务端 Connection 并修改其状态,Binder 适合承担这类控制操作。VSync 返回时只需交付一个紧凑的事件结构;BitTube 写入后会让接收 fd 就绪,已经注册到 Looper 的回调随即得到调度。控制面与事件通道分开后,App 无需为每个显示周期发起 Binder 查询。
4.4 EventThread::Connection 的 count 状态位:一次请求只换一次通知
连接创建时 count=-1,表示单次事件已发送或当前禁用。Connection::requestNextVsync() 会调用 EventThread::requestNextVsync();当前值为负数时,服务端将其改为 0,并唤醒条件变量。0 表示单次请求正在等待。VSync 到来且该连接被选中时,waitForEvent() 把状态恢复为 -1,再将连接加入 signalConnections。
服务端在发送前复位状态,同一个请求不会在后续周期重复命中。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp 第 126—133 行、第 243—267 行(节选)// waitForEvent 片段位于该方法的 do { ... } while 循环内。// 接收某条连接的一次性 VSync 请求。void EventThread::requestNextVsync( // 指定发起请求的连接。 const sp<EventThread::Connection>& connection) { // 对连接状态加锁。 Mutex::Autolock _l(mLock); // 仅允许禁用态或已触发态进入等待态。 if (connection->count < 0) { // 零表示等待一次 VSync。 connection->count = 0; // 唤醒事件线程重新检查条件。 mCondition.broadcast(); // 结束状态判断。 }// 结束请求方法。} // 遍历正在等待事件的连接。 size_t count = mDisplayEventConnections.size(); // 逐个检查弱引用连接。 for (size_t i=0 ; i<count ; i++) { // 提升当前连接的弱引用。 sp<Connection> connection(mDisplayEventConnections[i].promote()); // 跳过已经销毁的连接。 if (connection != NULL) { // 记录当前连接是否已加入本轮发送列表。 bool added = false; // 只处理启用或等待中的连接。 if (connection->count >= 0) { // 表明至少有一条连接需要 VSync。 waitForVSync = true; // 时间戳有效时才消费本轮事件。 if (timestamp) { // 零表示这是一次性请求。 if (connection->count == 0) { // 发送前恢复为已触发状态。 connection->count = -1; // 把连接加入本轮发送列表。 signalConnections.add(connection); // 标记当前连接已经加入列表。 added = true; // 连续模式按设定频率筛选。 } else if (connection->count == 1 || // 对高于一的频率值执行取模判断。 (vsyncCount % connection->count) == 0) { // 把满足持续频率的连接加入列表。 signalConnections.add(connection); // 标记当前连接已经加入列表。 added = true; // 结束单次与持续模式分支。 } // 结束时间戳检查。 } // 结束连接状态检查。 } // 结束连接有效性检查。 } // 结束连接遍历。 }setVsyncRate() 对应 count>=1 的持续模式,1 表示每次都接收,大于 1 时按 vsyncCount 取模。App 的单次调度使用 -1→0→-1 的迁移,这就是一次请求只换一次通知的源码依据。
Connection 还要先进入 mDisplayEventConnections 才能参与上述筛选。注册方法在持锁状态下追加连接并唤醒事件线程:
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp 第 100—106 行// 把新连接加入等待列表并唤醒线程重新评估状态。status_t EventThread::registerDisplayEventConnection( // 接收待注册的连接对象。 const sp<EventThread::Connection>& connection) { // 对连接列表加锁。 Mutex::Autolock _l(mLock); // 把连接追加到等待事件的连接集合。 mDisplayEventConnections.add(connection); // 唤醒线程重新检查等待条件。 mCondition.broadcast(); // 返回注册成功。 return NO_ERROR;// 结束注册方法。}Connection 构造时建立 BitTube 并把 count 设为 -1;首次获得强引用时完成注册。请求与事件发送则分别转交给 EventThread 和 BitTube:
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp 第 382—414 行// 构造一条显示事件连接。EventThread::Connection::Connection( // 接收所属的事件线程。 const sp<EventThread>& eventThread) // count 初始为 -1,表示尚未被请求。 : count(-1), mEventThread(eventThread), mChannel(new BitTube())// 开始构造函数体。{// 构造函数体为空。} // 声明该方法在对象首次被强引用时调用。void EventThread::Connection::onFirstRef() { // 说明 mEventThread 不持有对本连接的强引用。 // NOTE: mEventThread doesn't hold a strong reference on us // 把自己注册进所属线程的等待列表。 mEventThread->registerDisplayEventConnection(this);// 结束首次引用回调。} // 返回本连接持有的数据通道。sp<BitTube> EventThread::Connection::getDataChannel() const { // 直接返回构造时创建的 BitTube。 return mChannel;// 结束方法。} // 转发一次性 VSync 请求给所属线程。void EventThread::Connection::requestNextVsync() { // 调用线程级别的请求处理,传入自身。 mEventThread->requestNextVsync(this);// 结束请求方法。} // 把事件写入本连接的数据通道。status_t EventThread::Connection::postEvent( // 接收待发送的事件引用。 const DisplayEventReceiver::Event& event) { // 调用 BitTube 发送单个事件对象。 ssize_t size = DisplayEventReceiver::sendEvents(mChannel, &event, 1); // 负数转换为错误码,否则视为成功。 return size < 0 ? status_t(size) : status_t(NO_ERROR);// 结束发送方法。}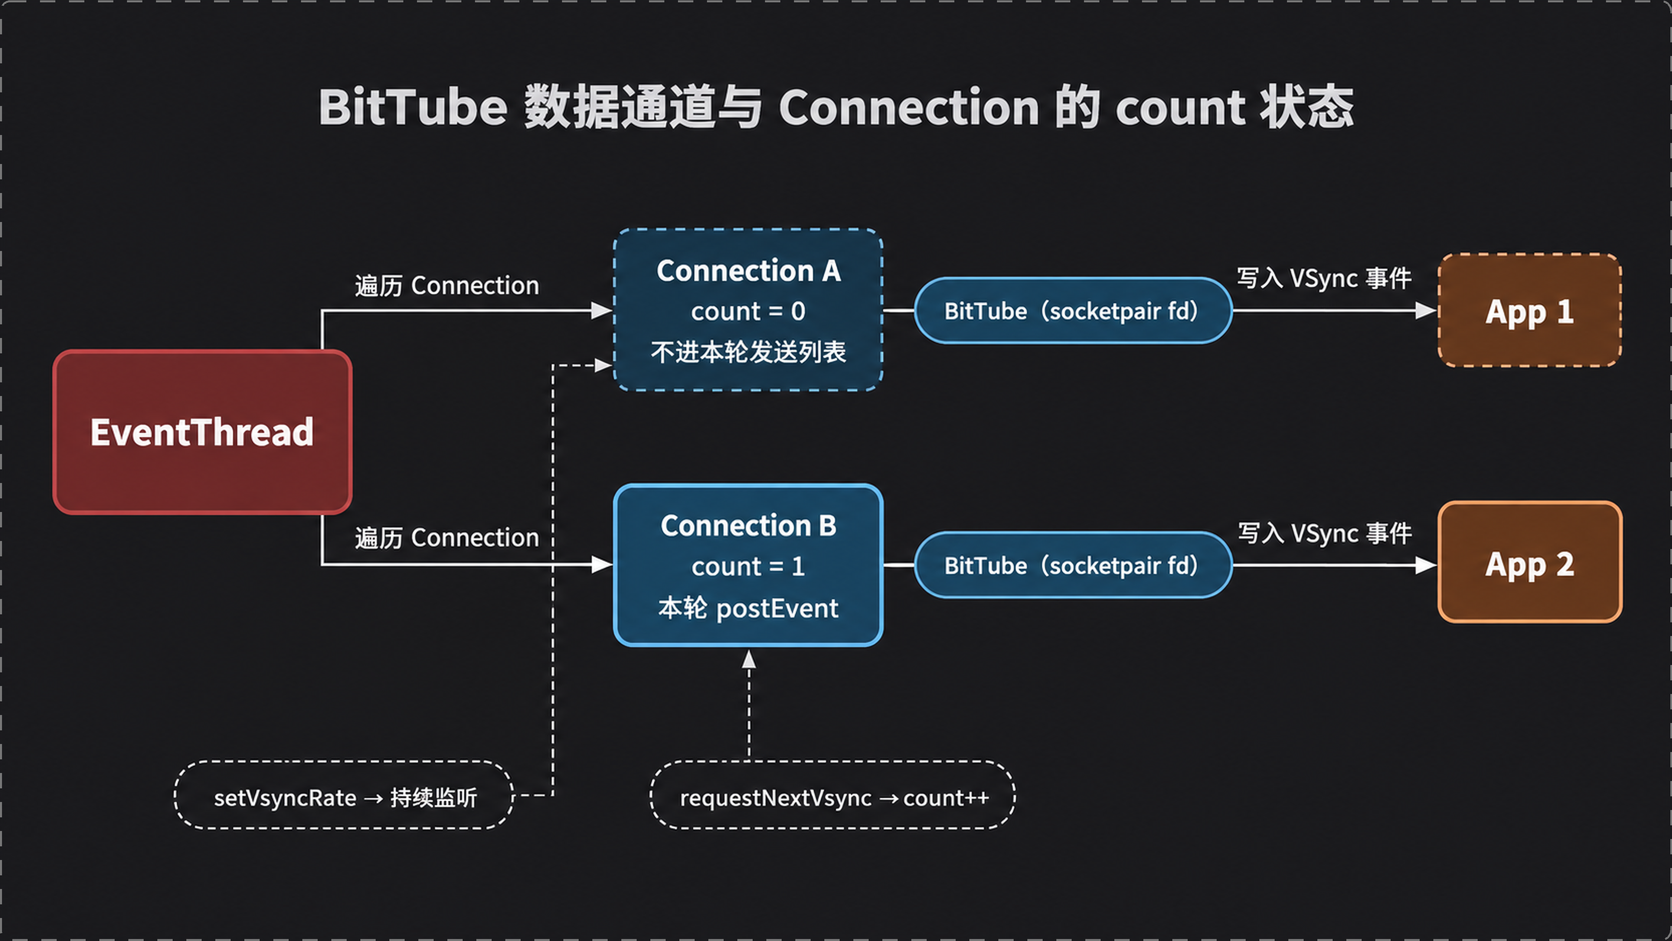
五、接收:信号如何到达 App 主线程
5.1 EventThread::threadLoop 与 waitForEvent 的筛选条件
EventThread::onVSyncEvent() 更新共享事件并广播条件变量。threadLoop() 通过 waitForEvent() 取得本轮需要通知的连接集合,再逐条调用 Connection::postEvent()。发送缓冲区暂时不可写时返回 -EAGAIN 或 -EWOULDBLOCK,该事件会被丢弃;其他负错误会导致连接移除。
筛选发生在写通道之前。没有请求的 Connection 保持 count<0,不会出现在集合中。SurfaceFlinger 因而无需把每个节拍送往所有 App,也不会依赖 App 进程轮询共享状态。
// 代码位置 frameworks/native/services/surfaceflinger/EventThread.cpp 第 178—205 行// 事件线程的主循环体。bool EventThread::threadLoop() { // 声明本轮要广播的事件缓冲。 DisplayEventReceiver::Event event; // 声明本轮需要通知的连接集合。 Vector< sp<EventThread::Connection> > signalConnections; // 阻塞等待事件就绪并筛选出目标连接。 signalConnections = waitForEvent(&event); // 说明接下来要把事件分发给监听者。 // dispatch events to listeners... // 记录本轮需要通知的连接数量。 const size_t count = signalConnections.size(); // 逐条处理待通知连接。 for (size_t i=0 ; i<count ; i++) { // 取出当前连接的强引用。 const sp<Connection>& conn(signalConnections[i]); // 说明接下来要确认该事件是否仍需要上报。 // now see if we still need to report this event // 把事件写入该连接对应的 BitTube。 status_t err = conn->postEvent(event); // 发送缓冲区暂时不可写时判断为丢弃场景。 if (err == -EAGAIN || err == -EWOULDBLOCK) { // 说明目的端暂时无法接收,这里直接丢弃事件。 // The destination doesn't accept events anymore, it's probably // full. For now, we just drop the events on the floor. // 目前还没有为不可丢的事件设计重发机制。 // FIXME: Note that some events cannot be dropped and would have // to be re-sent later. // Right-now we don't have the ability to do this. // 记录一次丢弃事件的告警日志。 ALOGW("EventThread: dropping event (%08x) for connection %p", // 补充事件类型与连接地址参数。 event.header.type, conn.get()); // 出现其它负数错误时判定为连接失效。 } else if (err < 0) { // 说明这里按致命错误处理管道异常,最常见的是 -EPIPE。 // handle any other error on the pipe as fatal. the only // reasonable thing to do is to clean-up this connection. // The most common error we'll get here is -EPIPE. // 从活跃连接集合中移除该连接。 removeDisplayEventConnection(signalConnections[i]); // 结束错误类型判断。 } // 结束连接遍历。 } // 主循环返回 true,交由 Thread 基类继续调度下一轮。 return true;// 结束主循环方法。}5.2 Connection::postEvent 到 BitTube::write
每个 Connection 构造时创建一个 BitTube。BitTube::init() 用 socketpair(AF_UNIX, SOCK_SEQPACKET, ...) 建立一对本地 socket,把两端设为非阻塞:SurfaceFlinger 持有发送端,App 获得接收端。SOCK_SEQPACKET 保留消息边界,适合传递固定结构的显示事件。
事件从 Connection::postEvent() 出发,依次经过 DisplayEventReceiver::sendEvents() 与 BitTube::sendObjects()。写入成功后,接收 fd 变为可读。
// 代码位置 frameworks/native/libs/gui/BitTube.cpp 第 70—72 行、第 79—87 行、第 107—119 行(节选)// init() 省略四条 socket 缓冲区 setsockopt() 调用。// 初始化 BitTube 的双端 socket。void BitTube::init(size_t rcvbuf, size_t sndbuf) { // 保存 socketpair 返回的两个 fd。 int sockets[2]; // 创建本地顺序数据包 socket 对。 if (socketpair(AF_UNIX, SOCK_SEQPACKET, 0, sockets) == 0) { // 把两个 fd 都设置为非阻塞模式。 fcntl(sockets[0], F_SETFL, O_NONBLOCK); // 设置发送端为非阻塞模式。 fcntl(sockets[1], F_SETFL, O_NONBLOCK); // 保存 App 侧读取使用的 fd。 mReceiveFd = sockets[0]; // 保存服务端写入使用的 fd。 mSendFd = sockets[1]; // 创建失败时进入错误分支。 } else { // 保存负 errno 作为失败状态。 mReceiveFd = -errno; // 结束创建分支。 }// 结束初始化方法。} // 向发送端写入一个完整数据包。ssize_t BitTube::write(void const* vaddr, size_t size)// 开始函数体。{ // 声明错误码和写入长度。 ssize_t err, len; // 遇到中断时重试。 do { // 以非阻塞且忽略 SIGPIPE 的方式发送。 len = ::send(mSendFd, vaddr, size, MSG_DONTWAIT | MSG_NOSIGNAL); // 成功时错误码为零,失败时读取 errno。 err = len < 0 ? errno : 0; // 仅对 EINTR 重试。 } while (err == EINTR); // 返回写入长度或负错误码。 return err == 0 ? len : -err;// 结束写入方法。}数据写入是事件链的跨进程交付点。recvObjects() 与 sendObjects() 对称,内部通过 BitTube::read() 从接收端取出完整事件对象。
接收端 fd 由 SurfaceFlinger 侧 writeToParcel() 复制进 Binder 回复,App 侧再从 Parcel 中 dup() 出本地 fd。复制后两端各自管理本进程内的描述符,而底层仍指向同一条 socket 通道。
// 代码位置 frameworks/native/libs/gui/BitTube.cpp 第 50—59 行// 从 Parcel 构造 BitTube,用于跨进程接收数据通道。BitTube::BitTube(const Parcel& data) // 发送端置为无效,只重建接收端。 : mSendFd(-1), mReceiveFd(-1)// 开始构造函数体。{ // 复制 Parcel 中携带的文件描述符得到本地可用的接收 fd。 mReceiveFd = dup(data.readFileDescriptor()); // 复制失败时记录负 errno。 if (mReceiveFd < 0) { // 保存失败状态。 mReceiveFd = -errno; // 输出复制失败的错误日志。 ALOGE("BitTube(Parcel): can't dup filedescriptor (%s)", // 补充 errno 对应的错误文本。 strerror(-mReceiveFd)); // 结束失败分支。 }// 结束构造函数。}// 代码位置 frameworks/native/libs/gui/BitTube.cpp 第 133—142 行// 把接收端 fd 写入 Binder 回复的 Parcel,交给对端进程。status_t BitTube::writeToParcel(Parcel* reply) const// 开始函数体。{ // 接收 fd 无效时直接报错。 if (mReceiveFd < 0) // 返回无效参数错误。 return -EINVAL; // 把接收 fd 复制一份写入 Parcel。 status_t result = reply->writeDupFileDescriptor(mReceiveFd); // 关闭服务端本地持有的接收 fd。 close(mReceiveFd); // 标记本地不再持有该 fd。 mReceiveFd = -1; // 返回写入结果。 return result;// 结束写入方法。}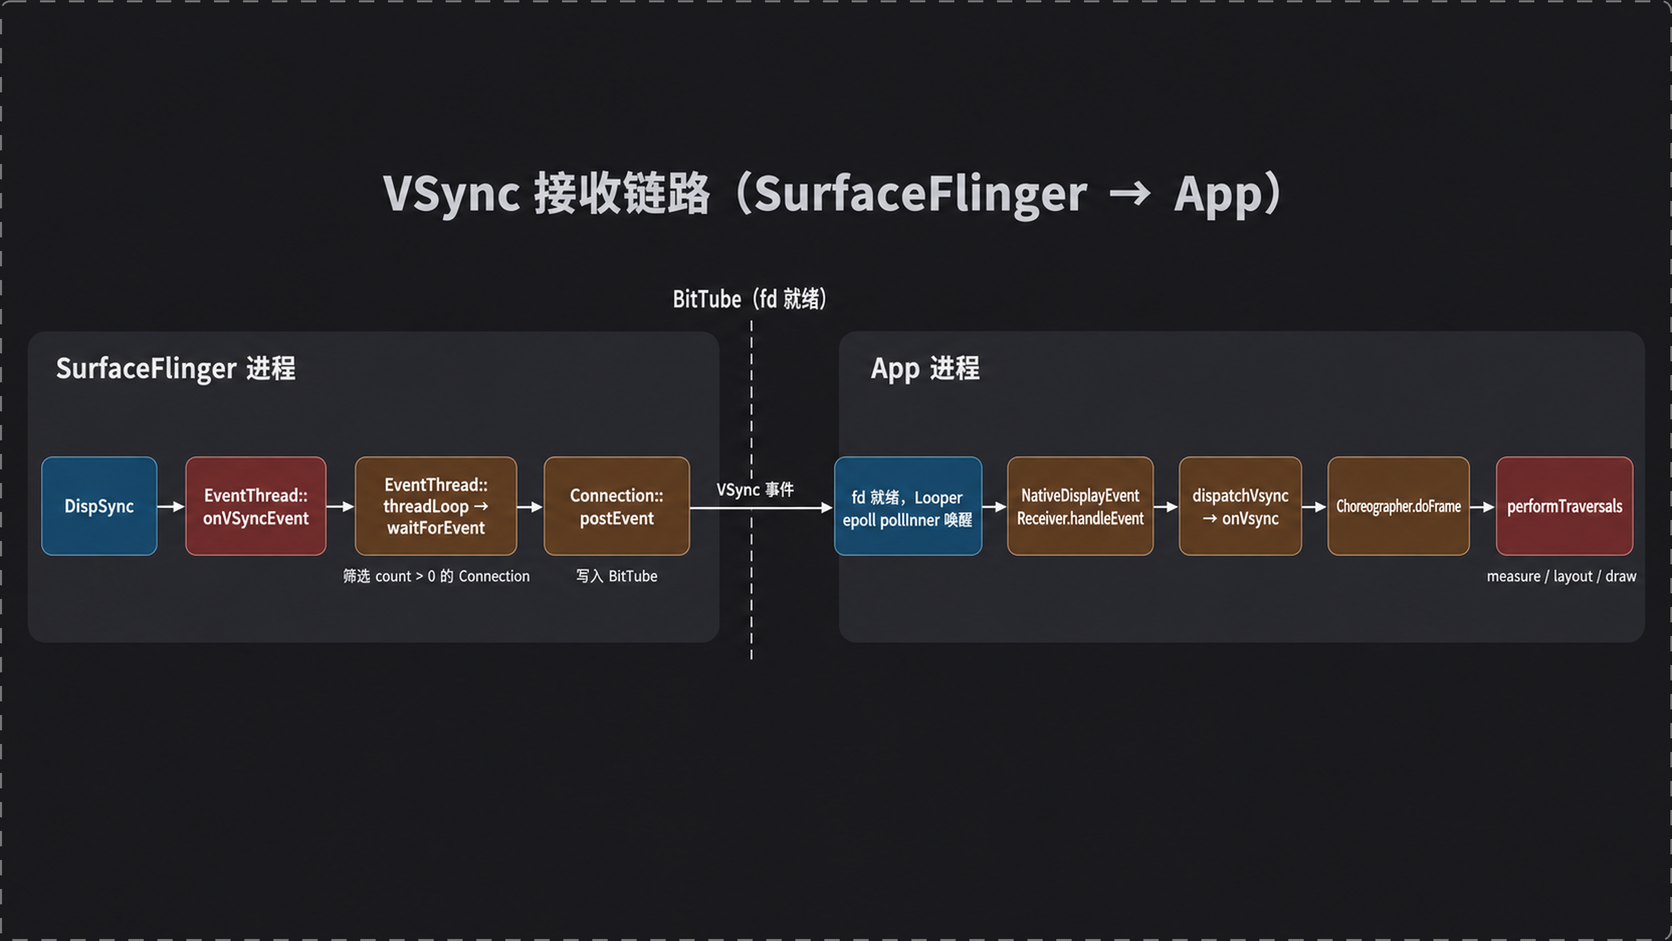
5.3 Looper 的 epoll:addFd、pollInner 与回调派发
Looper::addFd() 把接收 fd 与 NativeDisplayEventReceiver 回调保存为 Request,再通过 epoll_ctl(EPOLL_CTL_ADD) 加入 epoll。pollOnce() 外层循环调用 pollInner();后者在 epoll_wait() 阻塞,fd 可读后把对应 Request 压入 mResponses,随后执行 response.request.callback->handleEvent(fd, events, data)。
这里没有定时查询 BitTube。内核在 fd 就绪时唤醒 Looper,回调对象正是初始化时注册的 native 接收器。
// 代码位置 system/core/libutils/Looper.cpp 第 433—479 行、第 297—309 行、第 344—368 行(android-9.0.0_r8,节选)// 以下片段属于 Looper::addFd()。// 注册一个由回调对象处理的文件描述符。int Looper::addFd(int fd, int ident, int events, const sp<LooperCallback>& callback, void* data) { // 没有回调对象时要求 ident 为非负数。 if (!callback.get()) { // 无回调且 ident 非法时拒绝注册。 if (ident < 0) { // 返回失败。 return -1; // 结束 ident 检查。 } // 有回调对象时切换到回调响应类型。 } else { // 强制使用 POLL_CALLBACK 标识。 ident = POLL_CALLBACK; // 结束回调类型判断。 } // 构造 fd 对应的请求记录。 Request request; // 保存被监听的 fd。 request.fd = fd; // 保存调用者指定的标识。 request.ident = ident; // 保存关注的事件类型。 request.events = events; // 保存事件处理回调。 request.callback = callback; // 构造 epoll 使用的事件对象。 struct epoll_event eventItem; // 按请求内容初始化 epoll 事件。 request.initEventItem(&eventItem); // 查找该 fd 是否已经注册。 ssize_t requestIndex = mRequests.indexOfKey(fd); // 新 fd 进入添加分支。 if (requestIndex < 0) { // 把 fd 加入 epoll 实例。 int epollResult = epoll_ctl(mEpollFd, EPOLL_CTL_ADD, fd, & eventItem); // 注册失败时返回错误。 if (epollResult < 0) { // 返回失败标志。 return -1; // 结束失败检查。 } // 保存 fd 与请求的映射。 mRequests.add(fd, request); // 结束新 fd 分支。 }// 结束注册方法。} // 以下片段属于 Looper::pollInner() 的事件转换段。 // 从就绪事件中查找原始请求。 ssize_t requestIndex = mRequests.indexOfKey(fd); // 找到请求时构造响应。 if (requestIndex >= 0) { // 初始化 Looper 事件掩码。 int events = 0; // 把 epoll 可读事件转换为 Looper 输入事件。 if (epollEvents & EPOLLIN) events |= EVENT_INPUT; // 把响应和原始请求加入待处理队列。 pushResponse(events, mRequests.valueAt(requestIndex)); // 结束请求查找分支。 } // 以下片段属于 Looper::pollInner() 的回调执行段。 // 遍历本轮收集到的所有响应。 for (size_t i = 0; i < mResponses.size(); i++) { // 取得当前可修改的响应记录。 Response& response = mResponses.editItemAt(i); // 只在回调类型响应上直接执行 callback。 if (response.request.ident == POLL_CALLBACK) { // 取出回调对应的 fd。 int fd = response.request.fd; // 取出已经转换的 Looper 事件掩码。 int events = response.events; // 取出注册时保存的附加数据。 void* data = response.request.data; // 调用注册时保存的 handleEvent。 int callbackResult = response.request.callback->handleEvent(fd, events, data); // 返回零时移除 fd 监听。 if (callbackResult == 0) { // 按 fd 与序列号删除注册项。 removeFd(fd, response.request.seq); // 结束回调结果判断。 } // 清除本轮响应持有的回调强引用。 response.request.callback.clear(); // 标记本轮处理过回调响应。 result = POLL_CALLBACK; // 结束回调类型判断。 } // 结束响应遍历。 }addFd() 收到非空 callback 时,会把调用者传入的 ident 强制改为 POLL_CALLBACK。pollInner() 在返回前遍历 mResponses,并在“Invoke all response callbacks”阶段直接调用 response.request.callback->handleEvent();pollOnce() 自己的循环只取出 ident>=0 且未走 callback 的响应。NativeDisplayEventReceiver::initialize() 传入 this 作为非空回调,所以这次 fd 事件由 pollInner() 直接处理,不经 pollOnce() 的结果返回路径。
5.4 handleEvent、getEvents 与 JNI dispatchVsync
fd 可读后,NativeDisplayEventReceiver::handleEvent() 调用 processPendingEvents()。该函数循环执行 mReceiver.getEvents(),经 gui 层 getEvents() 和 BitTube::recvObjects() 读取通道中的事件,并保留最后一次 VSync。取到事件后,代码清除 mWaitingForVsync,再调用 native dispatchVsync()。
JNI 使用构造时保存的 Java 弱引用取得对象,调用 DisplayEventReceiver.dispatchVsync(timestamp, id, count)。
// 代码位置 frameworks/base/core/jni/android_view_DisplayEventReceiver.cpp 第 132—164 行、第 192—204 行(节选)// handleEvent() 省略错误事件处理,dispatchVsync() 省略调试日志。// 处理 Looper 派发的 fd 就绪事件。int NativeDisplayEventReceiver::handleEvent(int receiveFd, int events, void* data) { // 准备保存最后一个 VSync 的时间戳。 nsecs_t vsyncTimestamp; // 准备保存显示 ID。 int32_t vsyncDisplayId; // 准备保存 VSync 计数。 uint32_t vsyncCount; // 排空待处理事件并检查是否收到 VSync。 if (processPendingEvents(&vsyncTimestamp, &vsyncDisplayId, &vsyncCount)) { // 允许后续再次申请 VSync。 mWaitingForVsync = false; // 把最后一次 VSync 派发到 Java 层。 dispatchVsync(vsyncTimestamp, vsyncDisplayId, vsyncCount); // 结束事件检查。 } // 保留当前 Looper 回调注册。 return 1;// 结束事件处理方法。} // 向 Java 对象派发 VSync。void NativeDisplayEventReceiver::dispatchVsync(nsecs_t timestamp, int32_t id, uint32_t count) { // 取得当前线程的 JNI 环境。 JNIEnv* env = AndroidRuntime::getJNIEnv(); // 从弱引用取得 Java 接收器对象。 ScopedLocalRef<jobject> receiverObj(env, jniGetReferent(env, mReceiverWeakGlobal)); // 仅在 Java 对象仍存活时回调。 if (receiverObj.get()) { // 调用 Java 层 dispatchVsync 方法。 env->CallVoidMethod(receiverObj.get(), // 传入时间戳、显示 ID 与计数。 gDisplayEventReceiverClassInfo.dispatchVsync, timestamp, id, count); // 结束对象存活检查。 } // 把 JNI 异常转交给消息队列处理。 mMessageQueue->raiseAndClearException(env, "dispatchVsync");// 结束 JNI 派发方法。}handleEvent() 返回 1,Looper 因而保留监听;清除的是“已有请求在途”的状态,不是 fd 注册。下次 UI 又有工作时,同一通道可以继续完成一轮请求与接收。
5.5 FrameDisplayEventReceiver.onVsync 到 Choreographer.doFrame
Java 的 dispatchVsync() 调到 FrameDisplayEventReceiver.onVsync()。非主显示器事件会重新 scheduleVsync() 后返回;主显示器事件保存时间戳与帧计数,再发送以自身为 callback 的异步 Message。消息到期执行 run(),由它调用 doFrame()。
native 回调没有直接在 JNI 栈内执行整套视图遍历,而是再经过主线程消息队列。这使帧执行服从 Looper 的消息调度,并可携带 VSync 时间戳。
// 代码位置 frameworks/base/core/java/android/view/Choreographer.java 第 785—846 行(节选) // 省略内部类字段、构造函数以及非主显示器和时间戳校正分支。 // 接收 Java 层 VSync 回调。 @Override // 处理时间戳、显示 ID 和帧计数。 public void onVsync(long timestampNanos, int builtInDisplayId, int frame) { // 已有一次 VSync 等待处理时,记录重复到达的告警。 if (mHavePendingVsync) { // 提示不应该同时存在多个待处理的 VSync。 Log.w(TAG, "Already have a pending vsync event. There should only be " // 拼接告警文本的后一部分。 + "one at a time."); // 否则标记进入等待处理状态。 } else { // 标记当前已有一个 VSync 等待 doFrame 消费。 mHavePendingVsync = true; // 结束合并状态判断。 } // 保存本次 VSync 的时间戳。 mTimestampNanos = timestampNanos; // 保存帧计数。 mFrame = frame; // 创建以当前 Runnable 为目标的消息。 Message msg = Message.obtain(mHandler, this); // 允许帧消息越过同步屏障。 msg.setAsynchronous(true); // 按 VSync 时间戳换算后的毫秒时间投递。 mHandler.sendMessageAtTime(msg, timestampNanos / TimeUtils.NANOS_PER_MS); // 结束 VSync 回调。 } // 标记该方法实现 Runnable。 @Override // 执行帧消息。 public void run() { // 清除待处理 VSync 标志。 mHavePendingVsync = false; // 进入 Choreographer 帧处理。 doFrame(mTimestampNanos, mFrame); // 结束运行方法。 }mHavePendingVsync 构成接收端的第三层状态合并。上一次 VSync 对应的 Message 尚未执行时,新的 VSync 到达会触发告警,但不会重复把待处理状态从 false 改为 true;run() 消费 Message 时才复位标志。后续时间戳更新和消息发送代码仍会执行,因此该字段合并的是 pending 状态并暴露异常到达,并非用于截断 onVsync()。
doFrame() 随后按回调类型调用 doCallbacks()。执行到 CALLBACK_TRAVERSAL 时,队列中的 mTraversalRunnable 被取出;CallbackRecord.run() 对普通 Runnable 调用 action.run(),最终进入 TraversalRunnable.run()。
同一个 doFrame() 内存在输入、动画、遍历等不同类型的回调队列,CALLBACK_TRAVERSAL 只是其中一类。postCallbackDelayedInternal() 早先保存的类型决定回调在哪一阶段执行,VSync 时间戳则作为这一帧的时间基准传入。视图遍历因而没有在收到 socket 数据时立刻展开;接收器先把硬件或软件节拍转换为主线程异步消息,Choreographer 再按帧阶段取出已到期的任务。
5.6 丢帧判定与 doTraversal 的收尾
doFrame() 用 System.nanoTime() 减去 VSync 的 frameTimeNanos 得到 jitterNanos。若抖动不小于一个帧间隔,便以整数除法估算 skippedFrames;超过警告阈值时输出 Skipped N frames!。这条日志表明主线程开始处理该帧时已经落后若干周期,不能单凭它判断具体是哪一个业务方法耗时。
// 代码位置 frameworks/base/core/java/android/view/Choreographer.java 第 549—594 行// 定义每次收到 VSync 回调后的帧处理入口。void doFrame(long frameTimeNanos, int frame) { // 声明本次测量起始时间的最终变量。 final long startNanos; // 进入帧调度锁的保护范围。 synchronized (mLock) { // 没有帧被安排时直接返回,不做任何工作。 if (!mFrameScheduled) { // 没有工作时直接返回。 return; // 结束空转判断。 } // 调试开关打开且需要打印帧时间差时进入分支。 if (DEBUG_JANK && mDebugPrintNextFrameTimeDelta) { // 打印一次后关闭该调试开关。 mDebugPrintNextFrameTimeDelta = false; // 输出与上一帧时间的差值。 Log.d(TAG, "Frame time delta: " // 拼接计算后的毫秒差值。 + ((frameTimeNanos - mLastFrameTimeNanos) * 0.000001f) + " ms"); // 结束调试分支。 } // 保存调用方传入的原始帧时间。 long intendedFrameTimeNanos = frameTimeNanos; // 记录方法真正开始执行的系统时间。 startNanos = System.nanoTime(); // 计算实际开始时间相对 VSync 时间戳的抖动。 final long jitterNanos = startNanos - frameTimeNanos; // 抖动达到或超过一个帧间隔才视为发生丢帧。 if (jitterNanos >= mFrameIntervalNanos) { // 用整数除法估算跳过的帧数。 final long skippedFrames = jitterNanos / mFrameIntervalNanos; // 跳过帧数达到告警阈值时输出日志。 if (skippedFrames >= SKIPPED_FRAME_WARNING_LIMIT) { // 打印跳帧数量并提示主线程可能过载。 Log.i(TAG, "Skipped " + skippedFrames + " frames! " // 拼接主线程工作过载提示。 + "The application may be doing too much work on its main thread."); // 结束告警判断。 } // 计算超出整数帧间隔之外的剩余偏移。 final long lastFrameOffset = jitterNanos % mFrameIntervalNanos; // 调试开关打开时输出更详细的丢帧信息。 if (DEBUG_JANK) { // 打印错过 VSync 的具体时长与帧间隔。 Log.d(TAG, "Missed vsync by " + (jitterNanos * 0.000001f) + " ms " // 拼接帧间隔提示。 + "which is more than the frame interval of " // 拼接帧间隔数值。 + (mFrameIntervalNanos * 0.000001f) + " ms! " // 拼接跳过帧数。 + "Skipping " + skippedFrames + " frames and setting frame " // 拼接回拨后的时间偏移。 + "time to " + (lastFrameOffset * 0.000001f) + " ms in the past."); // 结束调试分支。 } // 把帧时间回拨到剩余偏移对应的时刻,仅保留未对齐部分。 frameTimeNanos = startNanos - lastFrameOffset; // 结束丢帧判定分支。 } // 回拨后的帧时间仍早于上一帧时间,说明发生了时间倒退。 if (frameTimeNanos < mLastFrameTimeNanos) { // 调试开关打开时输出提示信息。 if (DEBUG_JANK) { // 说明这通常是此前跳帧遗留的影响。 Log.d(TAG, "Frame time appears to be going backwards. May be due to a " // 拼接等待下一次 VSync 的提示。 + "previously skipped frame. Waiting for next vsync."); // 结束调试分支。 } // 放弃本次帧,重新申请下一次 VSync。 scheduleVsyncLocked(); // 直接返回,不再继续本轮帧处理。 return; // 结束时间倒退判断。 } // 记录本次的期望帧时间与实际使用的帧时间。 mFrameInfo.setVsync(intendedFrameTimeNanos, frameTimeNanos); // 复位帧已调度标志,为下一次申请让路。 mFrameScheduled = false; // 保存本次帧时间供下一次丢帧判定使用。 mLastFrameTimeNanos = frameTimeNanos; // 释放帧调度锁。 }// 结束 doFrame 节选。}帧回调的最后一步由这个 Runnable 执行。
// 代码位置 frameworks/base/core/java/android/view/ViewRootImpl.java 第 6010—6016 行 // 定义视图遍历任务。 final class TraversalRunnable implements Runnable { // 标记该方法实现 Runnable。 @Override // 接收 Choreographer 的执行调用。 public void run() { // 进入 ViewRootImpl 的遍历流程。 doTraversal(); // 结束运行方法。 } // 结束内部类。 } // 创建可重复登记的遍历任务实例。 final TraversalRunnable mTraversalRunnable = new TraversalRunnable();doTraversal() 复位 mTraversalScheduled,移除 mTraversalBarrier,再调用 performTraversals()。同步屏障至此完成使命,普通同步消息恢复通行;视图树开始按状态执行 measure、layout、draw。一次从 UI 请求出发的 VSync 往返,也在这里转换为实际渲染工作。
六、小结
调用 requestLayout() 或 invalidate() 后,ViewRootImpl 用 mTraversalScheduled 合并尚未执行的遍历,插入同步屏障,并向 Choreographer 登记 CALLBACK_TRAVERSAL。Choreographer 再用 mFrameScheduled 合并帧申请;帧调度消息被标为异步,因此能在屏障存在时到达 scheduleVsyncLocked()。
请求跨过 Java/JNI 后,gui 层通过 Binder 调用 EventThread::Connection::requestNextVsync()。服务端把 count 从 -1 改为 0。下一个符合条件的节拍到来时,waitForEvent() 将状态恢复为 -1,并把该连接加入发送列表。这个状态迁移完成单次节流:一个请求对应一次通知;后续帧需要 App 再次提出申请。
事件返回不走轮询。SurfaceFlinger 把事件写入 BitTube 的发送端,App 主线程 Looper 通过 epoll 监听接收 fd。fd 可读触发 NativeDisplayEventReceiver::handleEvent(),事件经 dispatchVsync()、FrameDisplayEventReceiver.onVsync() 和异步 Message 到达 doFrame()。doCallbacks() 执行 mTraversalRunnable,随后 doTraversal() 移除屏障并进入 performTraversals()。
这条往返链可归纳为三个机制:mTraversalScheduled、mFrameScheduled 与 mHavePendingVsync 分别合并遍历、帧申请和待处理 VSync 状态;Connection 的 count 控制单次或持续交付;Binder 负责请求和连接管理,BitTube 配合 Looper 的 epoll 负责事件通知。VSync 提供帧边界,App 只在有绘制需求时申请下一次边界,SurfaceFlinger 也只把本轮事件发送给满足状态条件的连接。
本文由 AgentWorkFlow 生成