
文章内容
- 一、简介
- 一维前缀和
- 二维前缀和
- 一维差分
- 二、一维前缀和
- 2.1 算法详解
- 2.2 LeetCode 303:区域和检索——数组不可变
- 三、二维前缀和:从一条线到一张网
- 3.1 算法详解
- 3.2 LeetCode 304:二维区域和检索——矩阵不可变
- 四、前缀和 + 哈希表
- 4.1 算法详解
- 4.2 LeetCode 560:和为 K 的子数组
- 4.3 LeetCode 525:连续数组
- 五、差分数组
- 5.1 算法详解
- 5.2 LeetCode 1094:拼车
- 5.3 LeetCode 1109:航班预订统计
- 六、前缀异或
- 6.1 算法详解
- 6.2 LeetCode 1310:子数组异或查询
- 七、环状数组中的前缀和
- 7.1 算法详解
- 7.2 LeetCode 918:环形子数组的最大和
- 八、归纳
- 九、总结
一、简介
📋 速查模板图解:https://algo.zhiyuansofts.cn/blog/sanyinchen/t4omlybe8j
一维前缀和
long[] s = new long[n + 1]; // s[0]=0,1-basedfor (int i = 0; i < n; i++) s[i + 1] = s[i] + a[i];// 查询 [l, r](1-based):s[r] - s[l - 1]// 0-based 区间 [l, r]:s[r+1] - s[l]二维前缀和
long[][] s = new long[m + 1][n + 1];for (int i = 1; i <= m; i++) for (int j = 1; j <= n; j++) s[i][j] = s[i-1][j] + s[i][j-1] - s[i-1][j-1] + grid[i-1][j-1];// 查询 (r1,c1)~(r2,c2):s[r2+1][c2+1] - s[r1][c2+1] - s[r2+1][c1] + s[r1][c1]一维差分
long[] b = new long[n + 2]; // 多开 2 防越界void insert(int l, int r, long v) { // 1-based b[l] += v; b[r + 1] -= v;}for (int i = 1; i <= n; i++) b[i] += b[i - 1]; // 还原先带入一个问题:
- 内存里有一份长度为
100000的整数数组,接下来会收到100000次查询。每次查询给出两个下标left和right,要求返回闭区间[left, right]里所有元素的和。
再扩展到实际场景: - 订单按天汇总后查某段日期的销售额、监控指标按分钟落点后查某个时间段的累计值、游戏战绩按局记录后查一段比赛的数据,都是一个原理。这类问题都有同一个特性:原始数据是静态的,读取非常频繁。
代码示例:
public class BruteRangeSum { public static long sumRange(int[] nums, int left, int right) { long sum = 0; for (int i = left; i <= right; i++) { sum += nums[i]; } return sum; }}输入是数组与闭区间两端,输出是区间元素和;方法内部没有保存任何状态,每次调用都从头累加目标区间。答案没问题,但是问题是一次查询最坏要扫 n 个元素,m 次查询就是 O(n*m)。
那能不能通过缓存一些中间结果进行优化?当然可以,但是不能缓存所有区间。所有区间有 O(n^2) 个,真存下来,空间先炸了。更划算的办法是只记“从开头走到当前位置,一共累加了多少”。把这些结果记为 prefix:
prefix[0] = nums[0]prefix[i] = prefix[i - 1] + nums[i],i >= 1这就是前缀和。类比一下,它像里程表:想知道从第 left 站到第 right 站走了多远,不必重新丈量这一段,只要拿“起点到 right 的总里程”减去“起点到 left 前一站的总里程”。回到精确定义,区间和就是两个前缀累计值之差。
这里其实有三种可选方向:
- 继续暴力,省空间,但把成本留给每一次查询;
- 缓存所有区间答案,查询确实能做到常数时间,可预处理和空间都膨胀到
O(n^2); - 使用前缀和,只缓存
n个从共同起点出发的累计值,且使用任意区间都能表示成两个“共同起点区间”的差。
前瞻总结:**前缀和负责频繁区间查询,二维前缀和把它铺到网格,前缀和加哈希表用来寻找满足条件的子数组,差分数组反过来优化区间修改,前缀异或则把“加法”换成了另一种可逆运算。**后面所有变化,都沿着“预处理并缓存可复用的累计状态”这条主链展开。
二、一维前缀和
2.1 算法详解
设 prefix[i] 表示原数组前 i 个元素的和:
prefix[i + 1] = prefix[i] + nums[i] (i >= 0)预处理时只遍历一次数组,时间 O(n)。prefix 数组长度为 n+1,查询闭区间 [left, right] :
sum = prefix[right + 1] - prefix[left]两次数组访问、一次减法,O(1),而且没有任何 left == 0 的分支。
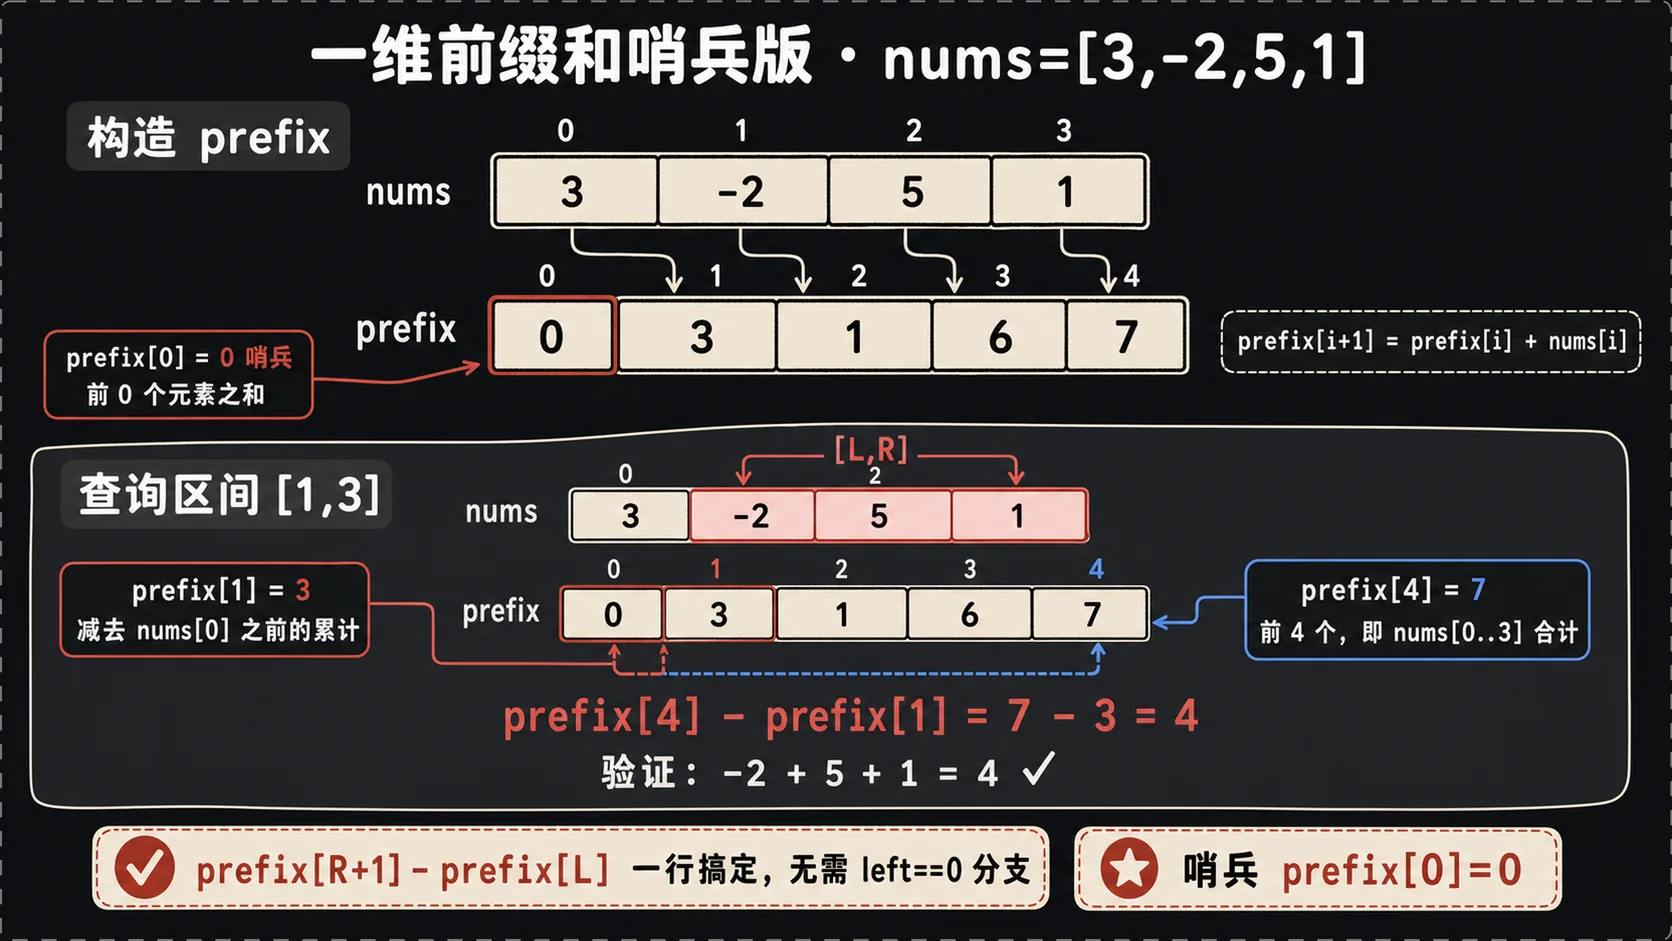
prefix[right + 1] = nums[0] + ... + nums[left - 1] + nums[left] + ... + nums[right]prefix[left] = nums[0] + ... + nums[left - 1]两式相减 = nums[left] + ... + nums[right]前半段完全抵消,剩下的恰好是目标区间。多出来的那个 prefix[0]=0 让 left=0 时也能优雅消去:prefix[0]=0 表示"前0个元素的和",正好是空格子,不会算漏也不会多算。
拿 nums=[3,-2,5,1] 手算一遍。哨兵前缀是 [0,3,1,6,7](长度为5)。区间 [1,3] 的和是 prefix[3+1]-prefix[1]=7-3=4,等价该区域元素相加 `-2+5+1=4。
代码实现:
CODE8
哨兵技巧:
- 输入
nums = [-2, 0, 3, -5, 2, -1],构造后状态变成prefix = [0, -2, -2, 1, -4, -2, -3](0为哨兵),调用sumRange(2, 5)输出prefix[6] - prefix[2] = -3 - (-2) = -1。
因此不论left是否为 0,公式都不需要任何 if 分支判断是否越界。
2.2 LeetCode 303:区域和检索——数组不可变
LeetCode 303 要求实现 NumArray:构造函数接收整数数组,sumRange(left, right) 返回闭区间 [left, right] 的元素和。题目保证数组非空、0 <= left <= right < nums.length,并会多次调用查询方法。
CODE9
输入 [-2,0,3,-5,2,-1] 后,内部状态是 [0,-2,-2,1,-4,-2,-3];sumRange(0,2) 输出 prefix[3]-prefix[0]=1,sumRange(2,5) 输出 prefix[6]-prefix[2]=-1。prefix[left] 表示目标区间左边那些元素的和,prefix[right+1] 表示一直累加到右端点的和,相减后目标区间被完整保留,这就证明了查询式。
哨兵还有一个认知上的好处:prefix 的下标不再表示"原数组的当前位置",而表示"已经吃掉了多少个元素"。prefix[0] 吃掉零个,prefix[1] 吃掉 nums[0],prefix[n] 吃掉整个数组。于是 [left,right] 一共吃到 right+1,再吐掉前 left 个,公式自然是 prefix[right+1]-prefix[left]。遇到下标绕晕时,念一遍“前几个元素”,通常比盯着 +1、-1 硬猜有效。
常见错误有三个。其一,把闭区间右端写成 prefix[right],漏掉 nums[right];其二,构造循环从 1 开始,却仍读取 nums[i],导致首元素没进表;其三,为了“省内存”直接在调用方传进来的 nums 上原地做前缀和,悄悄修改了外部数据。最后一种在算法题里也许能过,在业务代码里却会制造很隐蔽的副作用。除非接口明确允许,否则保留独立前缀数组更稳妥。
算法复杂度:构造时访问每个元素一次,时间 O(n);每次查询 O(1);额外空间 O(n)。这就是“空间换时间”的标准答案。
三、二维前缀和:从一条线到一张网
3.1 算法详解
现在把数组换成矩阵。查询给出左上角 (row1, col1) 与右下角 (row2, col2),要求这个闭合子矩形的元素和,如果暴力每次扫过区域最坏是 O(m*n)。
二维前缀和——和一维一样加一圈零。prefix[i][j] 定义为原矩阵前 i 行、前 j 列这个矩形内的总和,prefix[0][*] 和 prefix[*][0] 全是 0。矩阵的 (i,j) 对应 prefix[i+1][j+1],构造公式为:
CODE10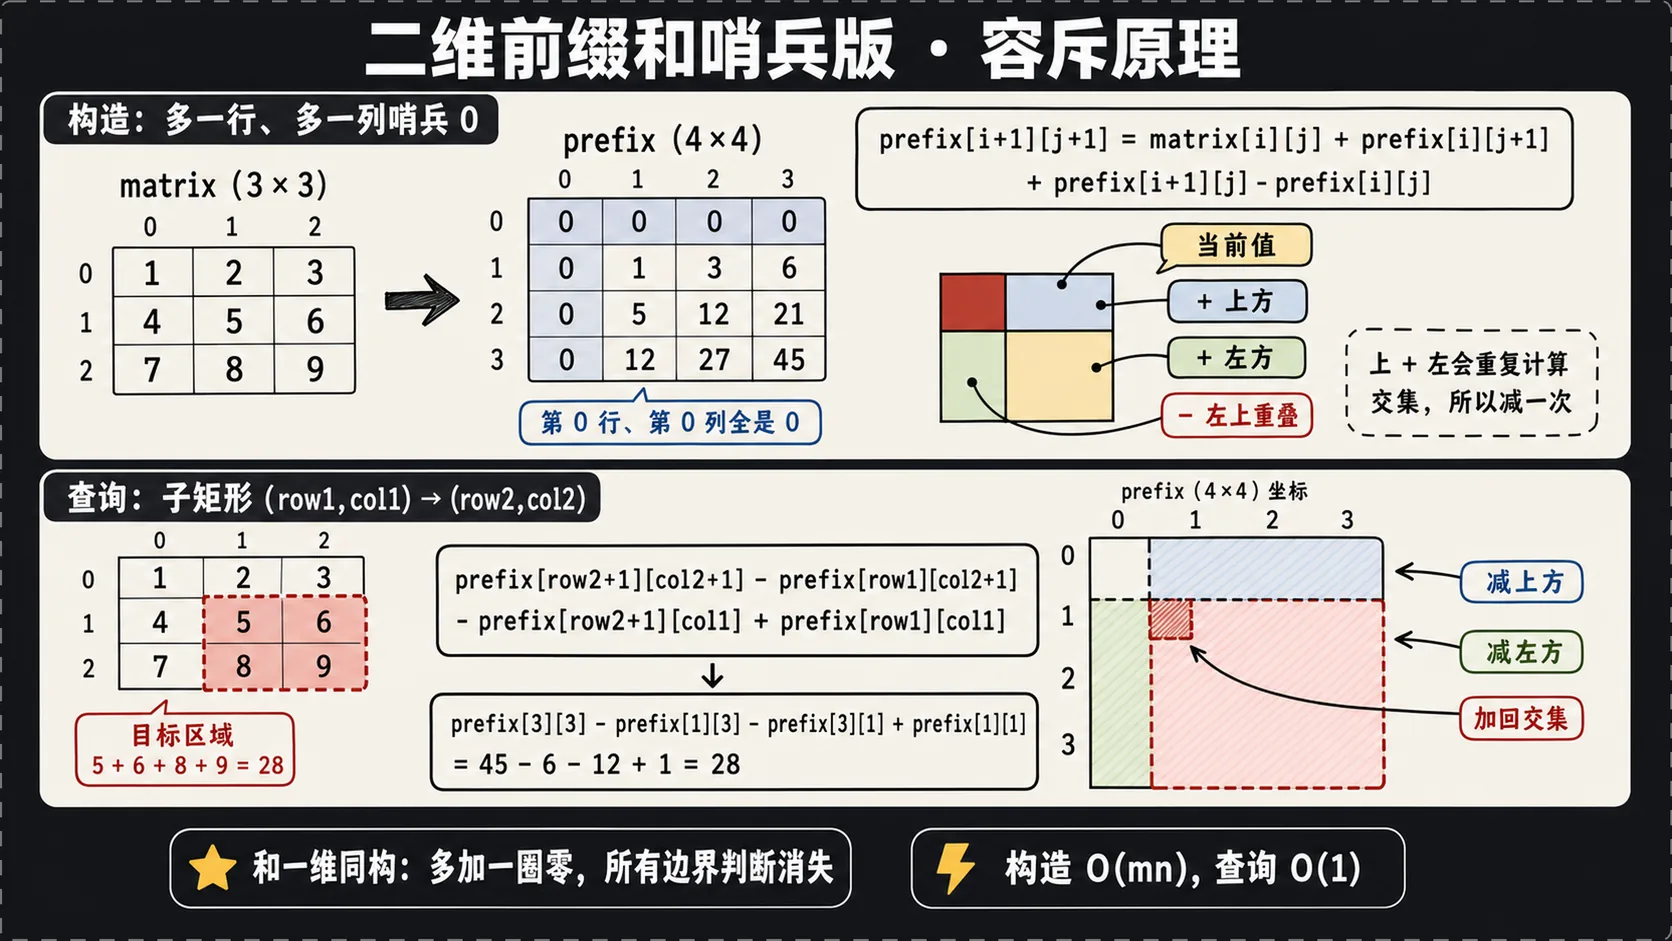
Q: 为什么最后要减?
A: 上方矩形和左方矩形都包含左上角重叠区,两个区域相加时重叠部分算了两次,所以减掉一次。打个比方,两份参会名单合并,既参加 A 组又参加 B 组的人会被抄两遍,统计总人数时必须去重。回到精确定义,这就是集合容斥:|A∪B| = |A| + |B| - |A∩B|。
子矩形 (row1,col1) 到 (row2,col2) 的查询:
CODE11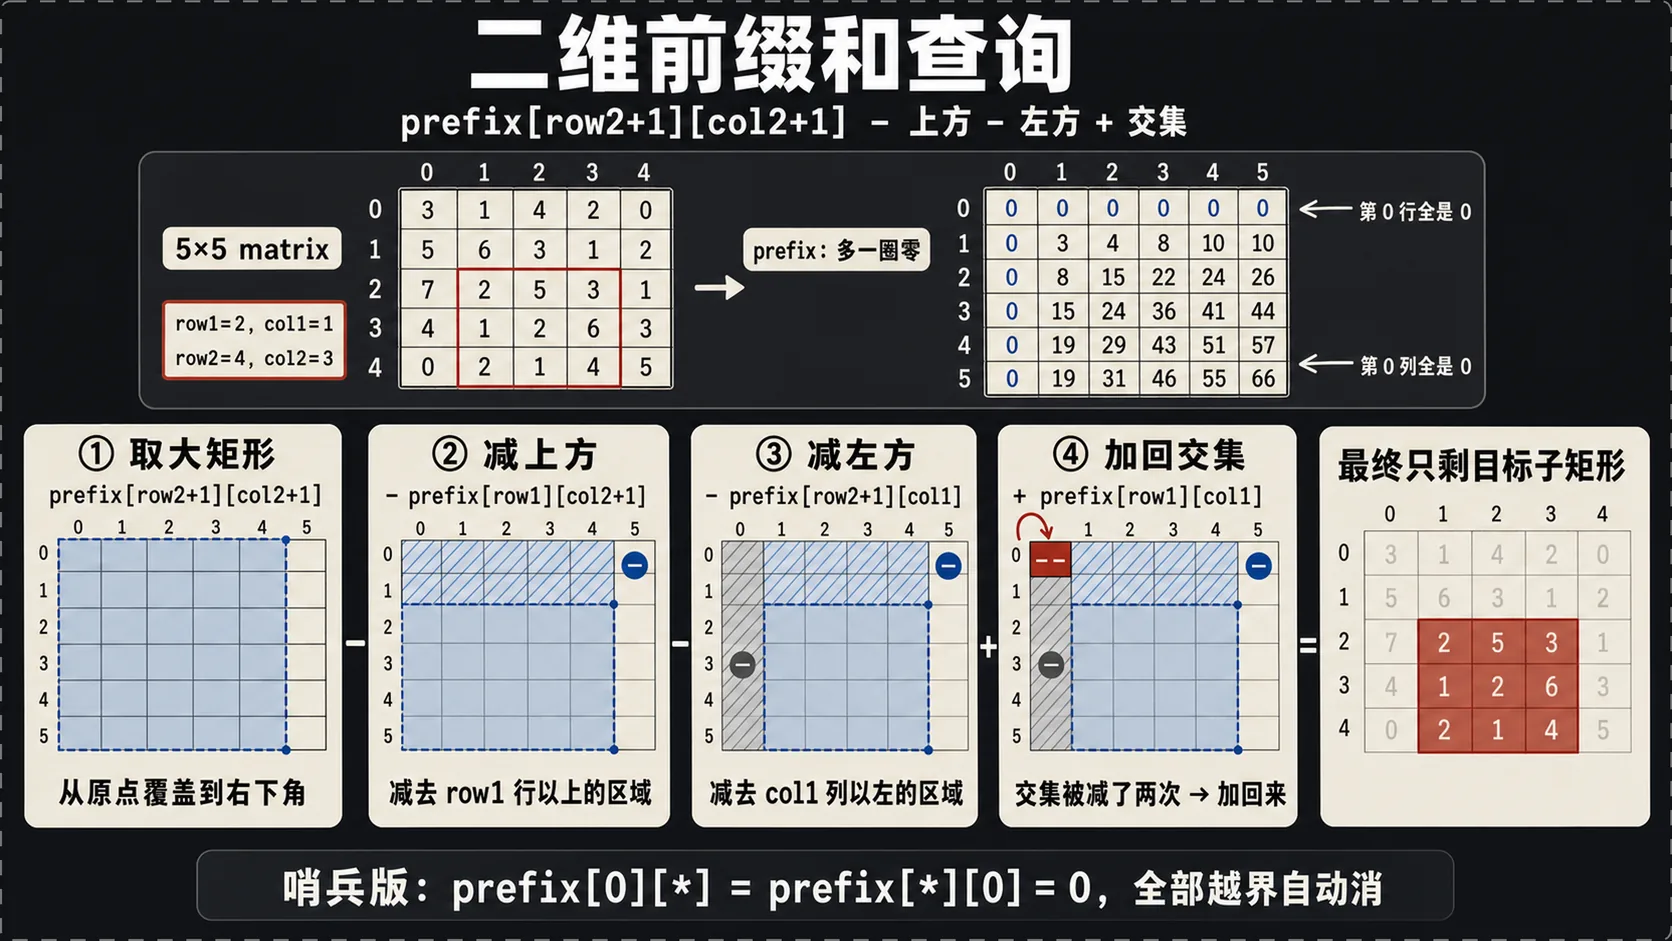
为什么构造时左上角减、查询时左上加?不矛盾。构造时两个大块相加交集重复,所以减;查询时两个无关区域从大块里减,交集被删了两回,所以要加一次。
3.2 LeetCode 304:二维区域和检索——矩阵不可变
LeetCode 304 要求实现 NumMatrix,支持多次 sumRegion(row1, col1, row2, col2),四个端点都是 0-based,目标区域包含两条边界。
代码实现:
CODE12
以题目常见示例矩阵为输入,构造函数把每个 prefix[i+1][j+1] 更新为原点到 (i,j) 的总和;查询 (2,1) 到 (4,3) 输出 8。状态的不变式是:任意时刻填完 (i,j) 后,当前前缀格已经覆盖且只覆盖原矩阵的 [0..i] x [0..j]。查询时按“大矩形减上方、减左方、补交集”组合,因此目标格子恰好各贡献一次。
算法复杂度:
- 预处理访问每个格子一次,时间
O(m*n); - 查询只读四个前缀值,时间
O(1); - 空间
O(m*n)。
四、前缀和 + 哈希表
4.1 算法详解
前缀和单独使用时,通常是“已知左右端点,计算区间和”;加上 HashMap 后,解决的是“左右端点都不知道,那么如何统计有多少个连续子数组的和等于 k?
先解释 HashMap 的作用:它是一本旧前缀和账本。
- 键:之前出现过的前缀和。
- 值:这个前缀和出现了多少次。
为什么查旧前缀和就能找到子数组?设扫描到下标 j 时,当前前缀和为 S。如果某个更早的前缀和为 P,那么两个前缀之间那段子数组的和就是 S-P。现在希望这段和等于 k:
CODE13
因此,每到一个位置,只要计算 S-k,再去 HashMap 查询它出现过几次即可。命中一次,代表找到一个合法起点;命中多次,代表有多个合法起点。暴力做法会逐个检查所有旧前缀,HashMap 则能平均 O(1) 得到它们的数量。
以 nums=[1,2,3,-2,5]、k=5 为例。开始扫描前,先在账本中放入 {0=1},表示“一个元素都没取时,前缀和 0 出现过一次”。每一步都先查询,再把当前前缀和记入账本:
扫描到 j |
当前元素 | 当前前缀和 S |
要查的键 S-k |
账本中的次数 | 本步新找到的子数组 |
|---|---|---|---|---|---|
| 0 | 1 | 1 | -4 | 0 | 无 |
| 1 | 2 | 3 | -2 | 0 | 无 |
| 2 | 3 | 6 | 1 | 1 | nums[1..2]=[2,3] |
| 3 | -2 | 4 | -1 | 0 | 无 |
| 4 | 5 | 9 | 4 | 1 | nums[4..4]=[5] |
最终命中两次,所以答案是 2。
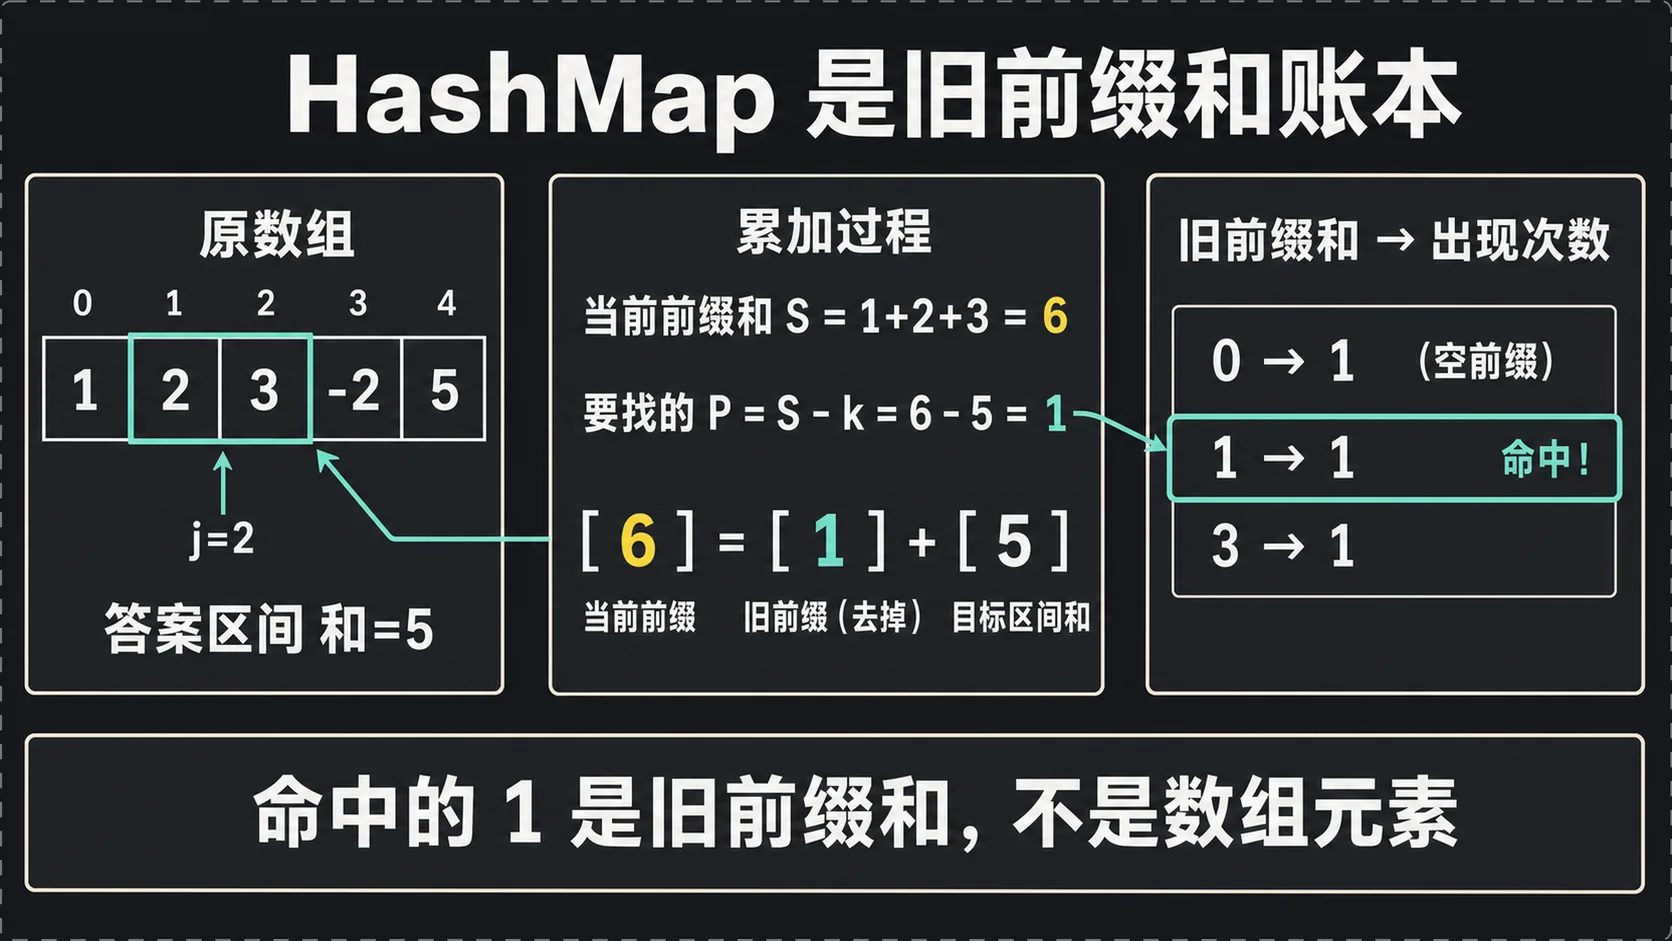
这张图只截取了表格中 j=2 的那一步,可以按下面的顺序阅读:
- 上方
nums是原数组;中间prefix是从开头累加到当前位置的和。 - 红圈中的
6是当前前缀和S,目标子数组和是k=5。 - 计算
S-k=6-5=1,然后查询右侧 HashMap。这里查找的是“旧前缀和1”,不是查找值为1的数组元素。 - 旧前缀和
1表示它前面那段[1]的和为1。从当前累计的[1,2,3]中去掉这段,剩下[2,3],其和正好是5。 - 图中 HashMap 里的
0来自扫描前放入的空前缀;中间的prefix行没有把这个空前缀画出来。
把整套做法压缩成三步就是:累加当前前缀和 S → 用 S-k 查询旧前缀和账本并累加次数 → 把 S 记入账本。HashMap 的唯一任务,就是把“回头遍历所有可能起点”变成一次按键查询。
这里的 O(1) 是 Java HashMap 常规使用下的平均复杂度;整个数组只扫描一次,所以算法平均时间复杂度为 O(n),额外空间为 O(n)。
4.2 LeetCode 560:和为 K 的子数组
LeetCode 560 给定整数数组 nums 和整数 k,要求返回和恰好为 k 的连续非空子数组个数,数组允许负数。
代码实现:哈希表存次数、空前缀初始化为一次、先查再更新。
CODE14
输入 nums=[1,1,1], k=2。初始状态 {0=1};扫到第一个 1,前缀和为 1,找 -1,没找到;扫到第二个 1,前缀和为 2,找到 0 一次,答案变 1;扫到第三个 1,前缀和为 3,找到 1 一次,答案变 2。输出 2。每次命中的旧前缀都与当前位置组成一个不同子数组,所以累加“出现次数”恰好完成计数。
count.put(0,1):假设当前位置前缀和刚好等于 k,我们要找到 prefix-k=0,这对应“当前区间从下标 0 开始”。空前缀并不是真实数组元素,而是一个数学哨兵。
Q: 为什么先查询再更新?
A: 因为哈希表只应该保存当前位置之前的前缀。尤其 k=0 时,如果先把当前前缀放进去,它会和自己配对,凭空算出长度为 0 的子数组,而题目要非空子数组。
Q: 为什么存次数而不是布尔值?
A: 负数和零会让同一个前缀和反复出现。比如多个不同起点都能与当前终点组成答案,漏掉任何一次都会少计。遍历一次,平均时间 O(n),哈希表最坏保存 O(n) 个不同前缀和,空间 O(n)。
用 nums=[1,-1,0], k=0 能一次看清“重复前缀”的意义。空前缀和为 0;扫过 1 得到 1;扫过 -1 又回到 0,这时找到旧的 0,得到子数组 [1,-1];再扫过 0,前缀仍是 0,而旧的 0 已出现两次,所以新增两个答案:整个 [1,-1,0] 和单独 [0]。最终是 3。若哈希表只记“出现过”,最后一步就只会加 1,答案直接少掉一个。
4.3 LeetCode 525:连续数组
LeetCode 525 给定只包含 0 和 1 的数组,要求 0 和 1 数量相同的最长连续子数组长度。
解题思路:把 0 当成 -1,把 1 当成 +1。一段区间的和为 0,就等价于其中 +1 与 -1 数量相同,也就是原数组中 0、1 一样多。
代码实现:
CODE15
输入 [0,1,0]:前缀状态依次为 -1,0,-1。0 最早在 -1 位置出现,所以扫到下标 1 时得到长度 2;-1 最早在下标 0,扫到下标 2 时长度也是 2,最终输出 2。两个相同前缀之间的变化量为零,因此对应区间里 0、1 数量相同,这证明了配对逻辑。
560 与 525 很像,前者问“有几个”,需要保留每个前缀的频次;后者问“最长”,同一前缀只保留第一次出现的位置。题目要什么,决定哈希表的 value 存什么。
保留最早位置:当前下标 i 固定时,长度是 i-firstIndex,firstIndex 越小,区间越长。如果 nums[0..i] 自身平衡,长度就是 i-(-1)=i+1。
把 560 和 525 放在一起,可以提炼出更通用的套路:先定义一个能表达条件的“状态前缀”,再问两个状态满足什么关系,最后决定哈希表保存哪个统计量。求数量就存频次,求最长通常存最早位置,求最短可能存最近位置。前缀和只负责把区间条件转成端点状态,哈希表里存什么,则由目标函数决定。
五、差分数组
5.1 算法详解
差分数组解决的是批量区间修改问题:给定一个长度为 n 的数组,接下来有 m 次操作,每次把闭区间 [left, right] 中的所有元素都增加 value,最后再统一查看修改后的数组。例如,航班座位预订、公交区间载客量统计,以及一段时间内统一增加某个数值,都可以抽象成这种操作。
如果每次都遍历整个区间,一次修改最坏需要 O(n),m 次就是 O(n*m)。当 n 和 m 都很大时,真正的瓶颈不是计算加法,而是同一批数组元素被反复访问。差分数组把每次修改压缩为两个边界标记,单次只需 O(1);等所有修改完成后,再用一次 O(n) 的前缀累加还原结果,总复杂度降为 O(n+m)。
这个优化有一个前提:允许先完成所有区间修改,再统一还原结果。如果修改与查询必须实时交错,基础差分数组并不适用,通常要改用树状数组或线段树。
差分数组定义:
CODE16
差分记录的不是“当前位置有多少”,而是“当前位置相对前一个位置变化了多少”。想让 nums[left..right] 全部增加 value,只需要修改两个边界:
CODE17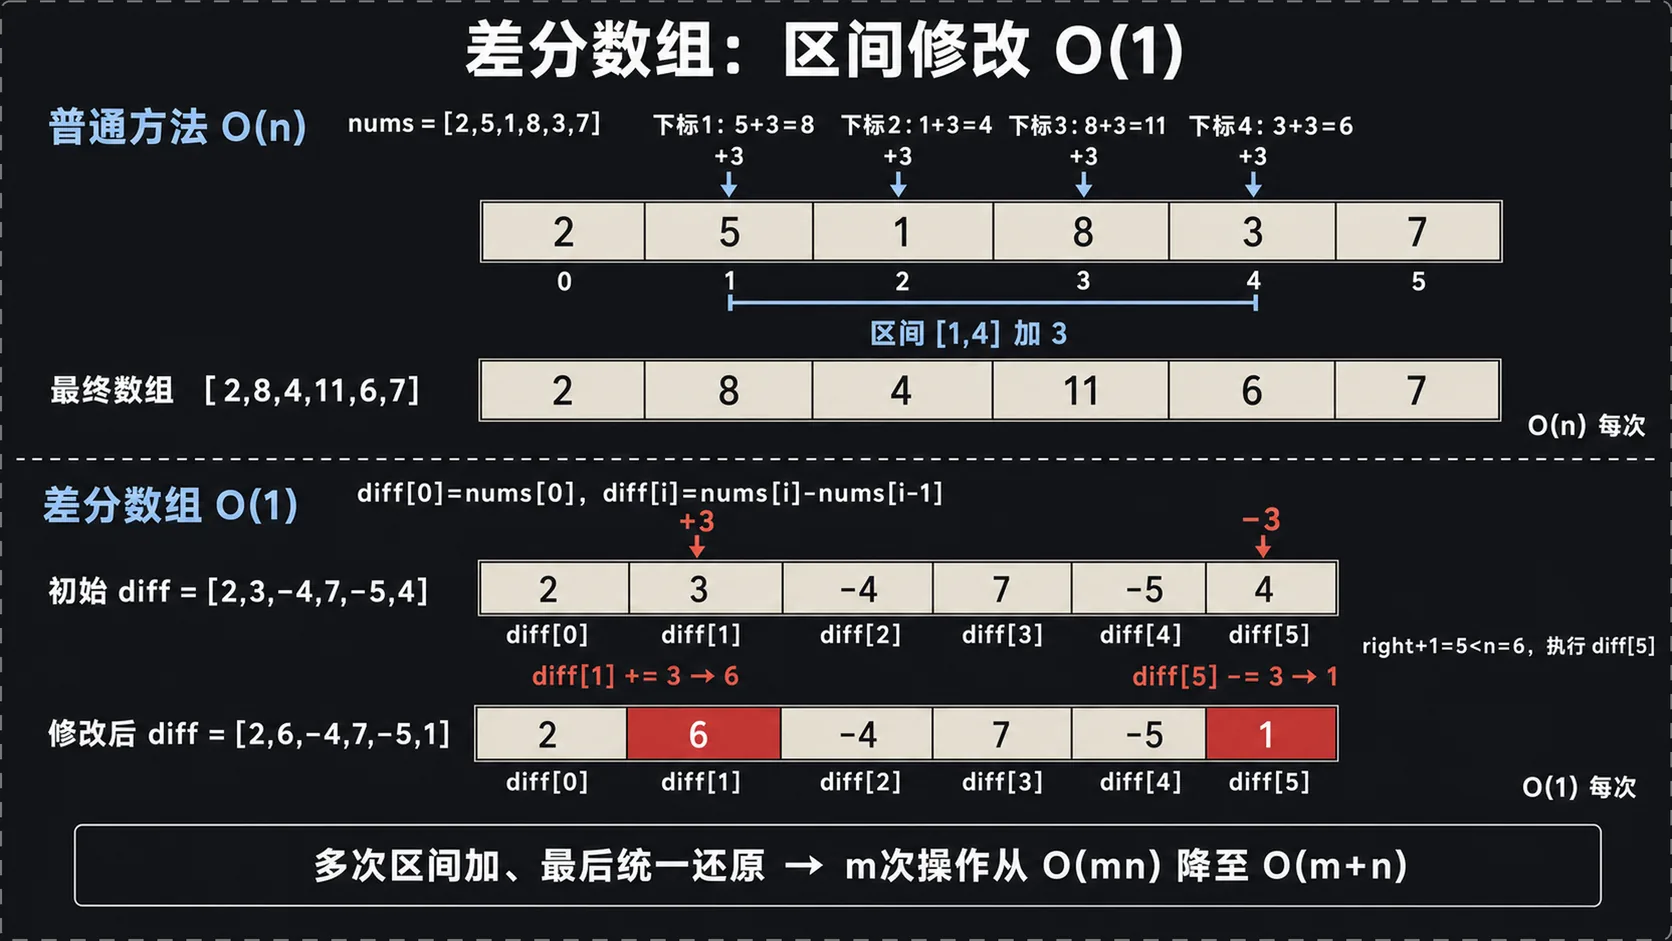
为什么中间一个都不用碰?对 diff 做前缀累加时,diff[left] 新增的 value 会进入 left,并随着累计一直传到右边;到了 right+1,那里的 -value 把影响抵消,所以 right+1 及以后恢复原样。打个比方,diff[left] 像打开水龙头,diff[right+1] 像关掉水龙头;精确定义仍然是累计和:位置 i 的恢复值为 diff[0]+...+diff[i]。
查看如下示范例:修改期间只记边界、最后一次性还原。
CODE18
输入 [2,2,2,2],初始 diff=[2,0,0,0];调用 add(1,2,3) 后,状态为 [2,3,0,-3];result() 前缀累加后输出 [2,5,5,2]。区间内正好多 3,区间外不变,两个边界操作因此得到验证。
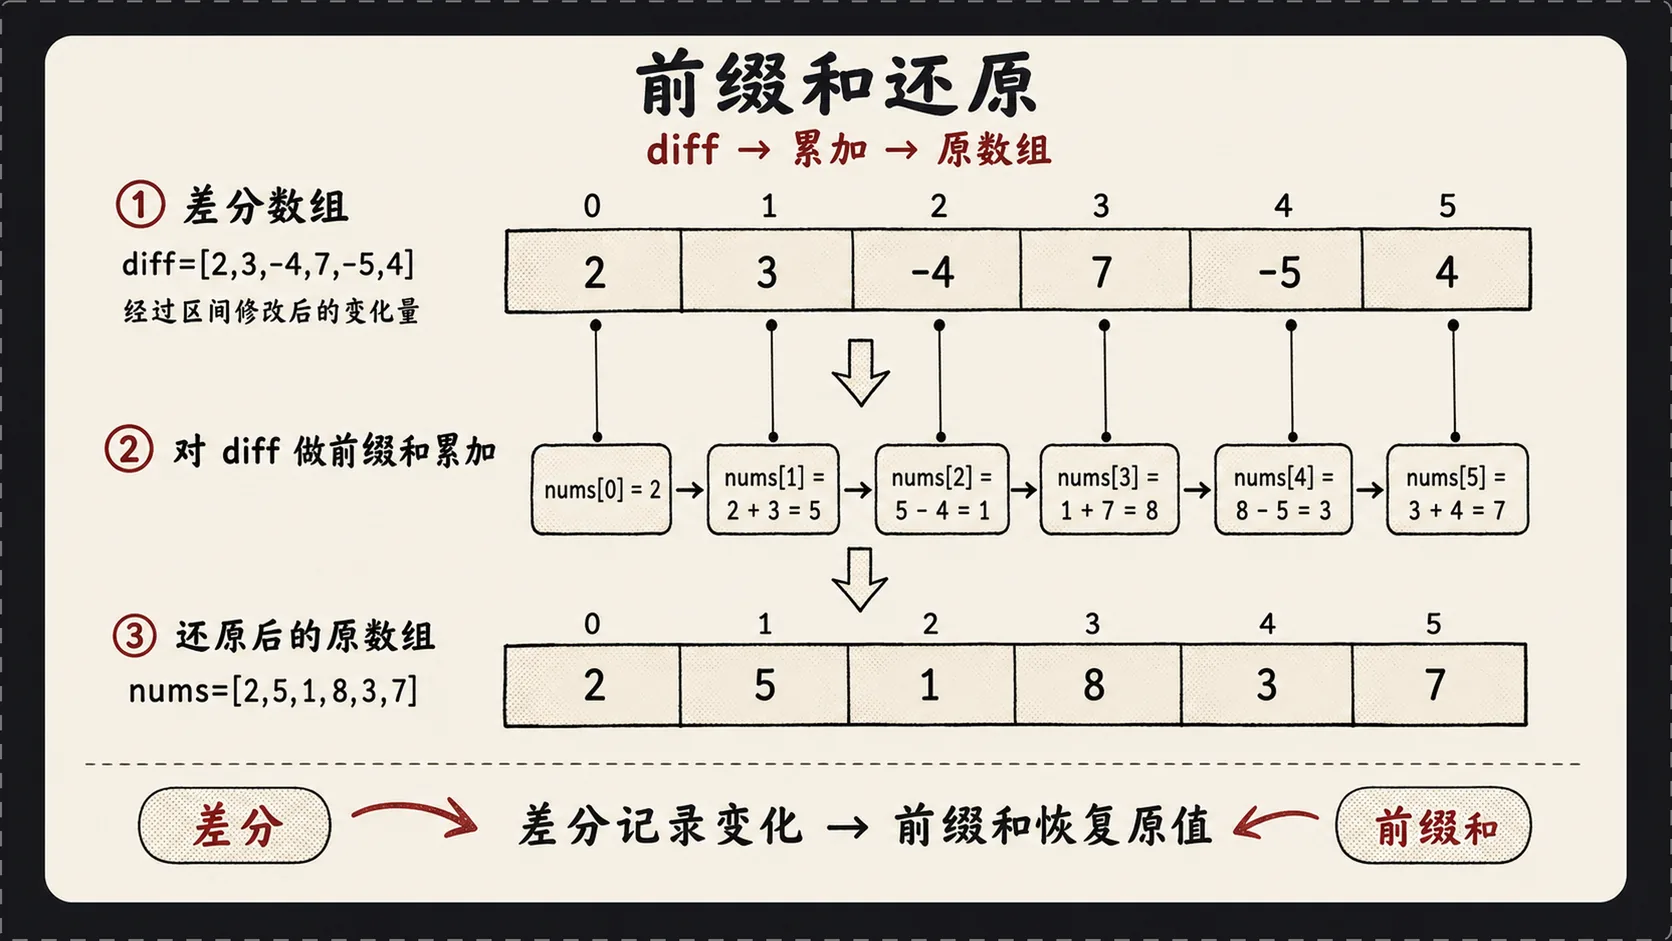
差分与前缀和是离散意义下的逆操作:数组做差分得到变化量,差分做前缀和还原数组。不过常见说法“差分修改 O(1)、查询 O(n)”需要加边界:这里的“查询”指完成全部批量修改后还原整个数组。若每修改一次就立刻询问任意区间结果,朴素差分并不能都做到高效。
闭区间和半开区间需要注意:对于闭区间 [left,right],影响在 right+1 结束,所以减在 diff[right+1];对于半开区间 [left,right),最后受影响的是 right-1,影响恰好在 right 结束,所以直接 diff[right]-=value。
5.2 LeetCode 1094:拼车
LeetCode 1094 中,trips[i] = [numPassengers, from, to] 表示乘客在 from 上车,在 to 下车;车有 capacity 个座位,问能否完成全部行程。关键语义是区间 [from, to):乘客到达 to 就下车,不再占用从 to 出发后的座位。
这就是差分事件流。from 位置载客量增加,to 位置减少;按位置累加变化量,就得到每一段路上的真实乘客数。
代码实现:
CODE19
输入所有行程与容量,第一轮确定位置范围,第二轮只记录上下车变化,最后输出布尔值。遍历到任意位置 x 时,onBoard 等于所有满足 from <= x < to 的乘客数;因为上车被加、到站被减,这个不变式成立。只要它从未超过容量,全部行程就可完成。
算法复杂度:设行程数为 t,最远位置为 L,时间 O(t+L),空间 O(L)。若坐标上界极大而行程很少,数组会浪费空间,可以把事件放进有序映射再扫描。
5.3 LeetCode 1109:航班预订统计
LeetCode 1109 给出 bookings[i]=[first,last,seats],表示从编号 first 到 last 的每个航班都新增 seats 个预订,区间两端都包含。航班编号从 1 到 n,返回长度为 n 的各航班预订总数。
代码实现:
CODE20
输入 bookings=[[1,2,10],[2,3,20],[2,5,25]], n=5,边界更新完成后再原地累加,输出 [10,55,45,25,25]。每条预订从 left 开始生效,在 right+1 终止;所以累加到航班 i 时,恰好包含所有覆盖 i 的预订,结论成立。
每条预订做常数次更新,最后扫描 n 个航班,时间 O(bookings.length+n),空间 O(n)。而且这里直接复用 diff 作为答案,无需再新开辟一个ans数组。
六、前缀异或
6.1 算法详解
前缀和真正的本质:不是名字里那个“和”,而是把一段可合并、可消去的运算结果提前累计起来。
那么扩展到异或:a ^ b ^ b = a(结合律),因此异或的“逆操作”就是它自己。
前缀异或主要解决的是:数组不变,但需要反复查询某个连续区间的异或结果。例如用整数的二进制位记录开关状态、权限标记或奇偶出现次数时,想知道某段记录合并后的状态;如果每次都从 left 枚举到 right 再异或,单次查询需要 O(right-left+1),查询很多时会重复计算大量相同的前缀。
演示一下这种重复。对于 arr=[3,8,2,6],若连续查询 [1,3]、[0,2] 和 [2,3],暴力法分别计算 8 ^ 2 ^ 6、3 ^ 8 ^ 2、2 ^ 6,一共做 3+3+2=8 次元素异或。先把前缀结果算好后,每次查询只需让两个前缀异或一次;预处理花 O(n),之后每个区间查询都是 O(1)。它和前缀和的收益完全相同,只是把“相减去掉左侧部分”换成“再异或一次去掉左侧部分”。
定义:
CODE21
举个具体例子:arr=[3,8,2,6],使用哨兵后得到 prefixXor=[0,3,11,9,15]。查询区间 [1,3] 时,不必重新计算三个元素,直接取 prefixXor[4] ^ prefixXor[1] = 15 ^ 3 = 12;逐个计算也是 8 ^ 2 ^ 6 = 12。两种结果一致,而前缀写法只做一次异或。
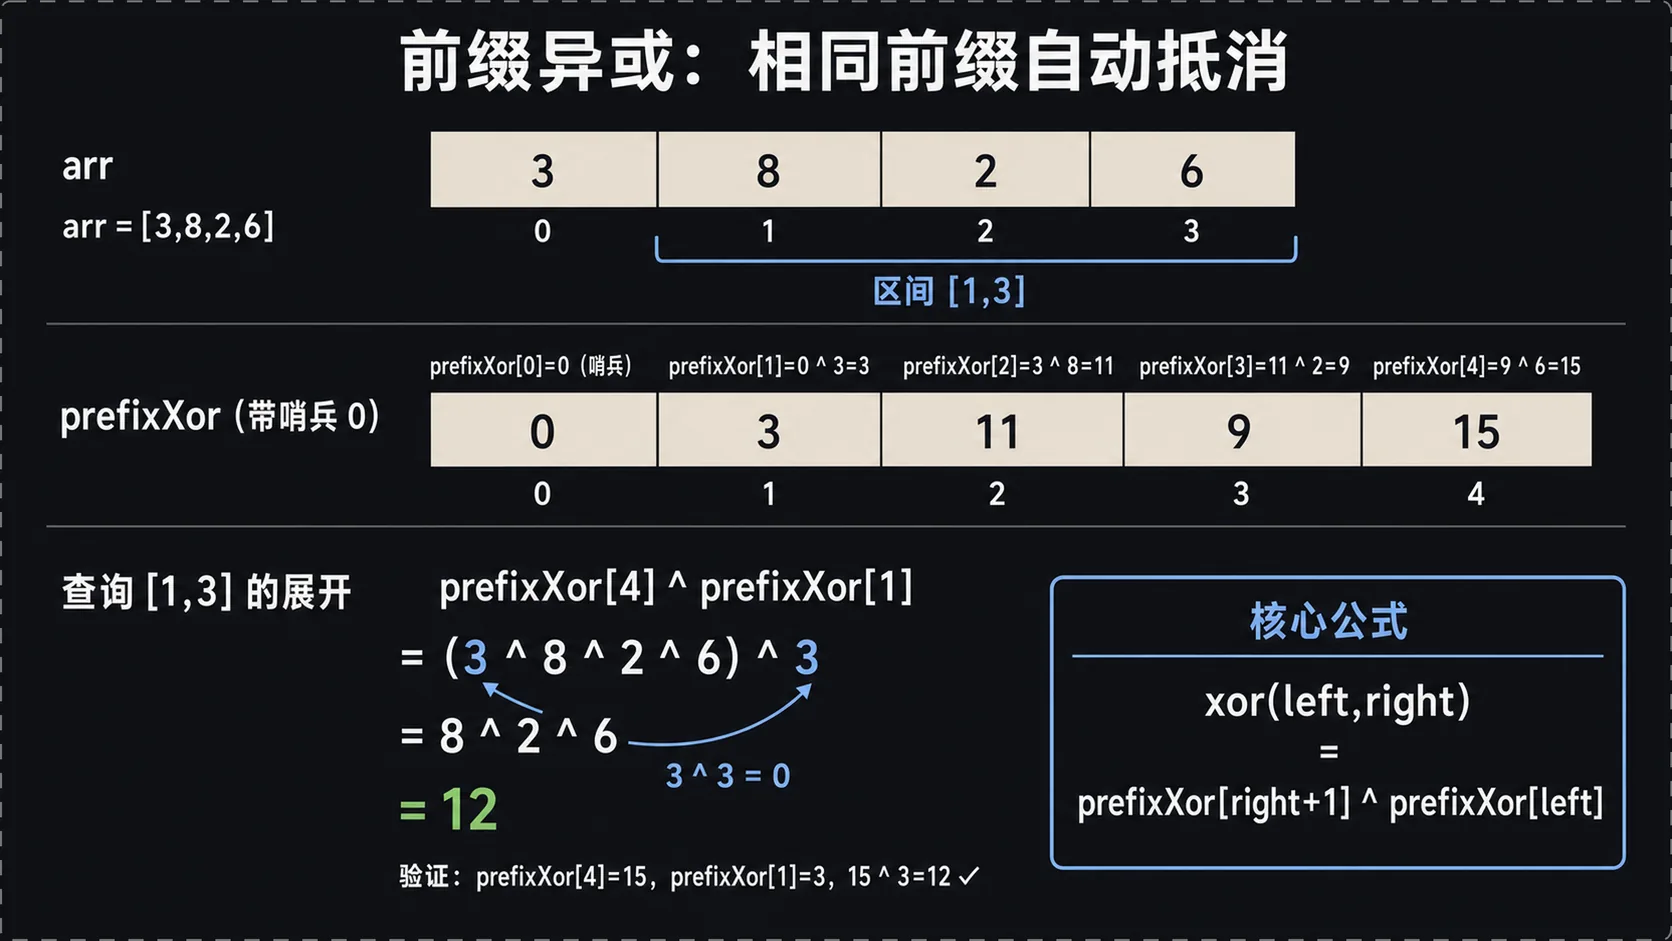
为什么能消去?prefixXor[right] 与 prefixXor[left-1] 中相同的前半段异或两次,全部变成零,最后只剩 [left,right]。使用哨兵写法则更整齐:prefixXor[0]=0,答案为 prefixXor[right+1] ^ prefixXor[left]。
但不能随便把任何运算都套进前缀模板。比如普通的 min 没有可用逆运算:知道 [0..right] 的最小值和 [0..left-1] 的最小值,无法还原 [left..right] 的最小值。可结合只够做累计,还要能消去左侧贡献,才能用两个前缀直接得到区间答案。
6.2 LeetCode 1310:子数组异或查询
LeetCode 1310 给定正整数数组 arr 和查询数组 queries。每个查询 [left,right] 都要求返回该闭区间所有元素的异或值,最终按原顺序返回答案数组。
为什么看代码?它几乎复刻 303 的哨兵结构,能直观看到“前缀思想不依赖加法,公式里的减号换成异或就行”。
CODE22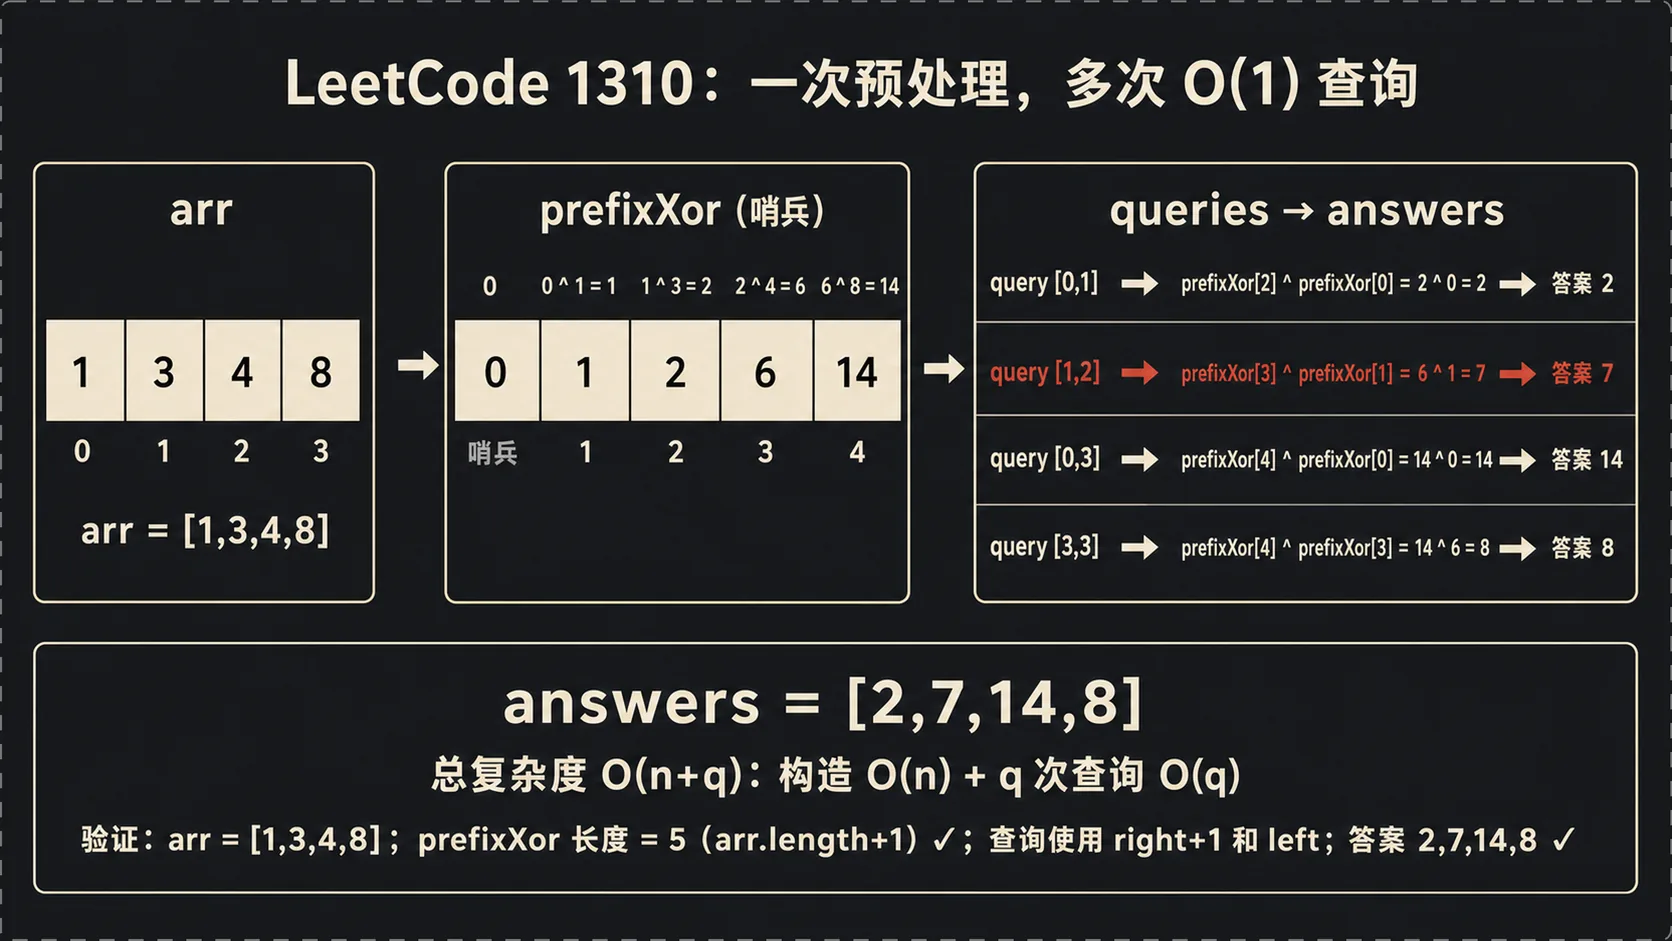
输入 arr=[1,3,4,8] 与查询 [[0,1],[1,2],[0,3],[3,3]],构造状态 prefixXor=[0,1,2,6,14],输出 [2,7,14,8]。每个查询中,左侧前缀出现两次被抵消,只剩目标区间,证明与前缀和的消去过程完全同构。
构造时间 O(n),处理 q 个查询要 O(q),总时间 O(n+q);前缀与答案空间分别为 O(n)、O(q)。如果只计算额外工作空间,通常不把必须返回的答案数组计入其中。
七、环状数组中的前缀和
7.1 算法详解
普通数组有明确的开头和结尾,环状数组却允许区间从末尾绕回开头。一个常见处理技巧是把数组复制一倍:长度 n 的数组变成长度 2n,任何长度不超过 n 的环形连续区间,都能在复制后的数组中表示成普通连续区间。再建前缀和,就可以 O(1) 计算这些窗口的和。
例如 nums=[5,-3,5],复制成 [5,-3,5,5,-3,5],再建立前缀和 prefix=[0,5,2,7,12,9,14]。现在查询从原下标 2 绕到原下标 0 的区间,元素是 [5,5];它在复制数组中对应普通区间 [2,3],区间和为 prefix[4]-prefix[2]=12-2=10。如果继续取到复制数组的下标 4,窗口就包含 [5,5,-3],长度恰好为 n,结果是 prefix[5]-prefix[2]=9-2=7。
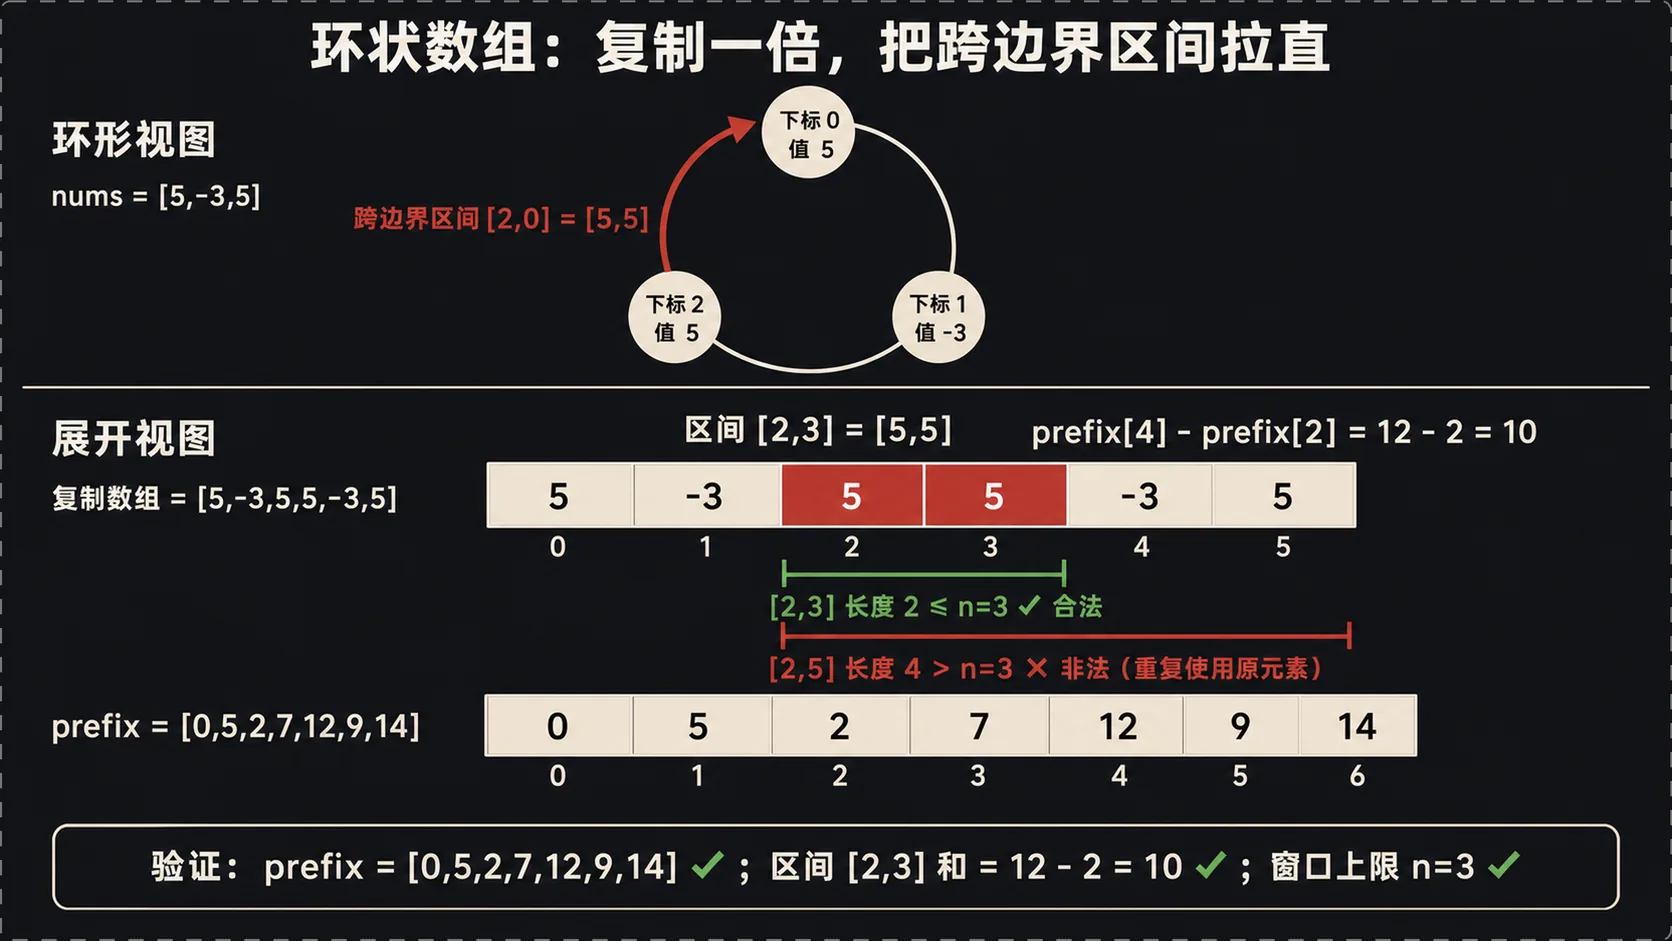
复制数组并不意味着窗口可以无限向右延伸:起点固定后,终点最多到 start+n-1。超过这个范围就会再次使用同一个原始元素,算出的已不再是合法环形子数组。
7.2 LeetCode 918:环形子数组的最大和
LeetCode 918“环形子数组的最大和”可以从这个视角理解:复制数组把环拆开,再配合长度受限的窗口处理。不过这道题更常见、更省空间的最优写法是 Kadane:答案要么是不跨边界的最大子数组和,要么是“总和减去中间最小子数组和”,还要单独处理全负数。那属于最大子数组动态规划的主场,这里不展开,免得一篇文章突然长出另一篇文章。
所以,“复制一倍 + 前缀和”是环形区间表示技巧,不代表所有环形最值题都应该照搬。若只是若干已知环形区间求和,它很直接;若要枚举最优区间,还要结合滑动窗口、单调队列或动态规划,具体看约束。
八、归纳
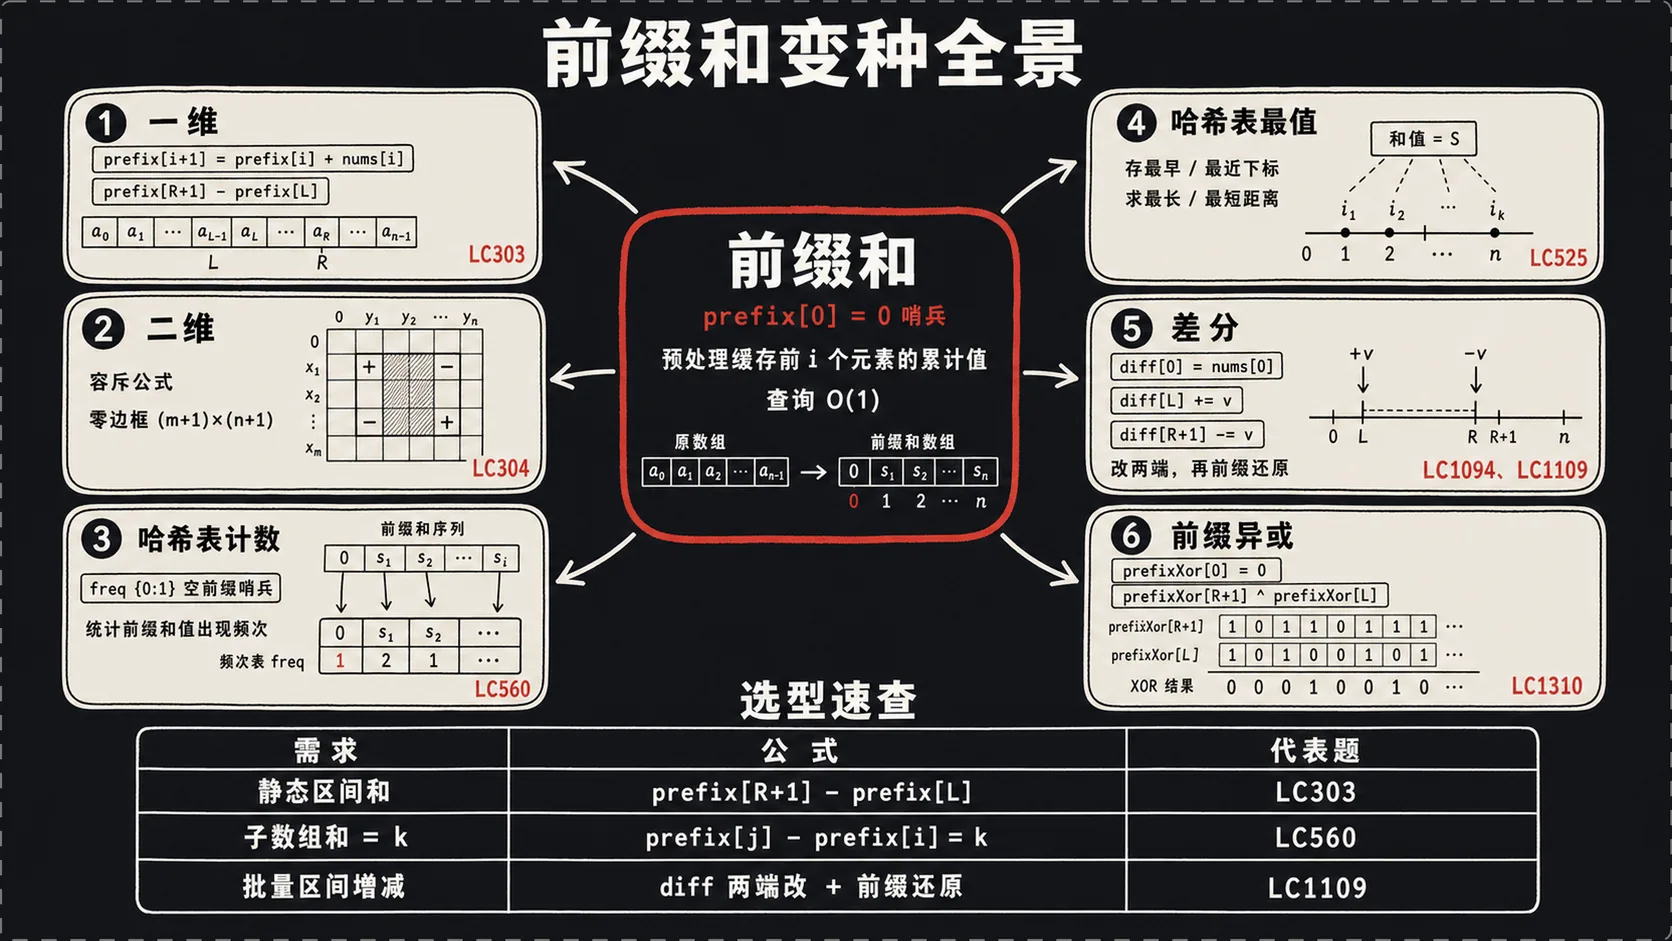
| 变种 | 预处理 | 查询/修改 | 适用场景 |
|---|---|---|---|
| 一维前缀和 | O(n) |
区间和 O(1) |
静态数组上的频繁区间求和 |
| 二维前缀和 | O(mn) |
子矩阵和 O(1) |
图像区域统计、矩阵热力数据 |
| 前缀和 + 哈希表 | 扫描 O(n) |
找特定和子数组共 O(n) |
子数组计数、最长条件区间 |
| 差分数组 | 单次修改 O(1) |
全量还原 O(n) |
多次区间增减后统一结算 |
| 前缀异或 | O(n) |
区间异或 O(1) |
静态数组上的异或查询 |
选型时别先问“这题是不是前缀和”,先问数据怎么动、问题要什么:
- 数组静态,给定很多区间,求和或异或? 用一维前缀;矩阵就升到二维前缀。
- 区间端点未知,要数出或找出满足条件的连续区间? 尝试把条件改写成两个前缀的关系,再决定哈希表存次数、最早位置还是别的信息。
- 很多次区间统一增减,最后才要全部结果? 用差分。若修改与查询在线交错,朴素差分通常不够。
- 运算能否用两个前缀消去? 加法用减法,异或用异或自己;
min、max这类不可逆运算不能硬套。 - 结果会不会溢出? LeetCode 这些题按各自约束使用
int可以通过;真实业务若总和可能超过约 21 亿,应把累计值与返回类型换成long。这是 Java 数值范围的事实,不要指望算法替你兜底。
还有一个容易混淆的点:滑动窗口也处理连续区间,但它通常依赖窗口状态随左右端点移动时具有单调性;前缀和加哈希表不要求元素非负。看到负数时,不是滑动窗口绝对不能用,而是“根据和的大小决定缩放”的那套逻辑可能失效,需要重新证明。
再补一条很有用的判断:查询多不等于一定建前缀,关键还看数据会不会变。静态数组上,一百万次查询也只是一次预处理;若每两次查询之间都修改数据,旧前缀可能大片失效。可以把选择过程想成三个轴:数据维度是一维还是二维,操作是查询还是修改,处理方式是离线还是在线。前缀和、差分分别占据“静态频繁查”和“离线频繁改”两个角落,树状数组、线段树则处理更动态的角落。
九、总结
回到开头:长度 10^5 的数组面对 10^5 次区间查询,暴力最坏要做 10^10 级别的累加。前缀和先花 O(n) 时间和 O(n) 空间,把从开头到每个位置的累计结果保存下来,之后任意闭区间只用两个前缀相减,查询被直接砸到 O(1)。
这就是前缀和最值得记住的观点:**它是“空间换时间”的极致典范,也是“预处理缓存中间结果”这种算法设计方式最干净的样子。**二维版本用容斥把一条线铺成一张网;配上哈希表,两个前缀的差值变成了子数组条件匹配;把关系反过来,就得到擅长批量区间修改的差分数组;把加法换成异或,只要运算能消去,整套思路依然成立。
本文由 AgentPlanFlow 生成