
文章内容
Android 里的跨进程通信有不少选择。管道适合字节流,Socket 通用而且能跨设备,共享内存适合大块数据,Binder 则承担了系统服务通信的主干。应用拿系统服务、AMS 调度组件、Media 服务接受调用,最后大多会经过 Binder。
主要链路:binder_open 给进程建档,binder_mmap 准备接收事务的内存,binder_ioctl 负责收发命令和调度事务。
一、Binder 在 Android 系统中的位置
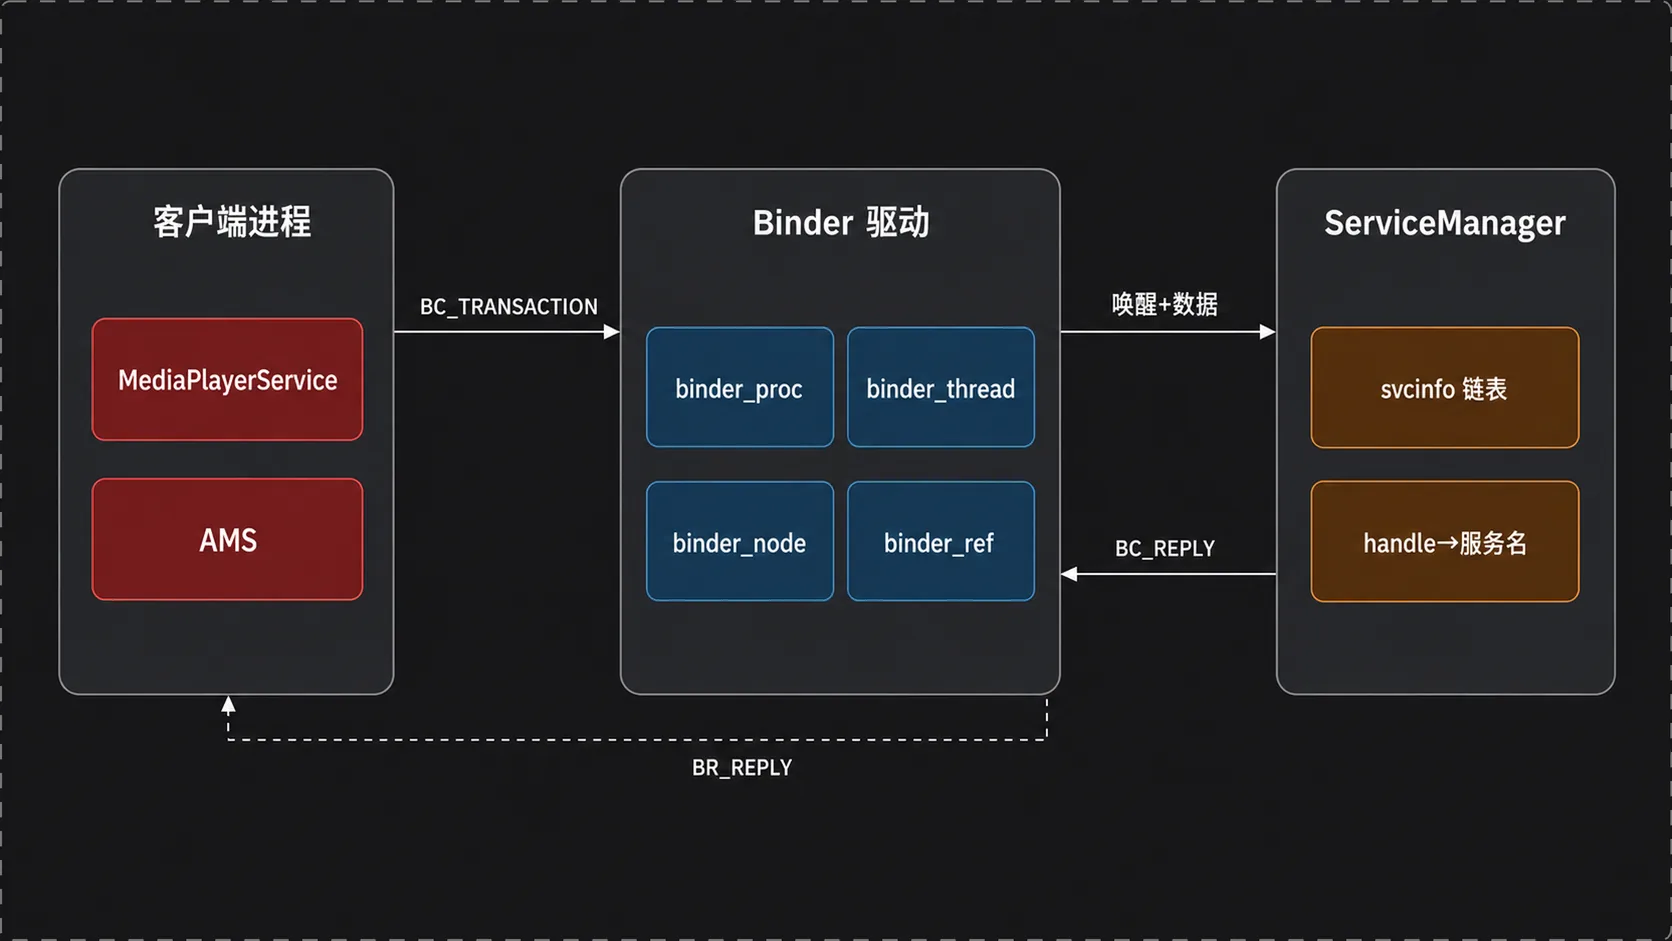
从参与者看,一次 Binder 调用涉及发起方、Binder 驱动和目标进程。ServiceManager 也在这套模型里,它承担服务注册与查询:服务端把名称和 Binder 实体交给它,客户端按名称取得 handle,再用 handle 发起事务。ServiceManager 内部用 svcinfo 链表维护服务名及 handle 等信息,驱动则维护更底层的进程、线程、节点和引用关系。
驱动里的几个结构可以先了解下:binder_proc 对应一个使用 Binder 的进程,binder_thread 对应该进程中进入驱动的线程,binder_node 表示 Binder 实体,binder_ref 表示其他进程持有的引用。老版本实现广泛使用红黑树索引这些对象,以便按 PID、节点或描述符查找;待处理事务则进入 todo 队列,线程睡眠和唤醒依靠等待队列完成。
这套对象关系也解释了 handle 的作用。客户端拿到的整数 handle 并不是服务端对象的地址,它在当前进程的引用表里对应一个 binder_ref,引用再关联驱动中的 binder_node。跨进程传递 Binder 对象时,驱动会检查并转换对象描述,让接收进程得到适用于自身引用空间的 handle。这样一来,用户态无需知道另一个进程的虚拟地址,驱动也能追踪引用关系和对象存活状态。
ServiceManager 在惯例中占用特殊的上下文管理者位置。客户端查询服务时把请求发往这个固定入口,ServiceManager 从 svcinfo 链表中查找名称,再把对应 Binder 引用返回。后续业务调用可以直接发给目标服务进程,不必让 ServiceManager 转发每笔事务。它更像名字服务,负责让通信双方建立联系。
上层的 Proxy、Parcel 和 IPCThreadState 最终都会收束到设备文件操作。驱动在初始化时通过 misc_register 注册 misc 设备,并把文件操作表交给内核。用户态对 /dev/binder 执行 open、mmap 和 ioctl,内核便能分派到对应函数。
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 3683—3691 行// 声明 Binder 驱动的文件操作表static const struct file_operations binder_fops = { // 指明当前模块持有这些操作 .owner = THIS_MODULE, // 注册轮询接口 .poll = binder_poll, // 注册本机位宽的 ioctl 接口 .unlocked_ioctl = binder_ioctl, // 注册兼容位宽的 ioctl 接口 .compat_ioctl = binder_ioctl, // 注册内存映射接口 .mmap = binder_mmap, // 注册设备打开接口 .open = binder_open, // 注册文件刷新接口 .flush = binder_flush, // 注册设备释放接口 .release = binder_release,// 结束文件操作表定义};二、读源码前需要的 Linux 内存知识
Linux 用 task_struct 描述一个进程,PID、调度状态和虚拟内存信息都能从这里关联出去。进程的地址空间由 mm_struct 管理,其中一段段连续区域用 vm_area_struct 表示。代码段、堆、栈以及 mmap 得到的区域,都是虚拟地址区间;CPU 发出虚拟地址后,MMU 根据页表找到物理页。
在常见的 32 位内核布局中,4GB 虚拟地址空间通常按 0~3GB 用户空间、3~4GB 内核空间划分(注意,这个比例属于特定架构和配置,不能套到所有 64 位设备上)。Binder 一次拷贝的思路也不依赖固定的 3G/1G 数字,它依赖的是页表能让两段虚拟地址指向同一组物理页。
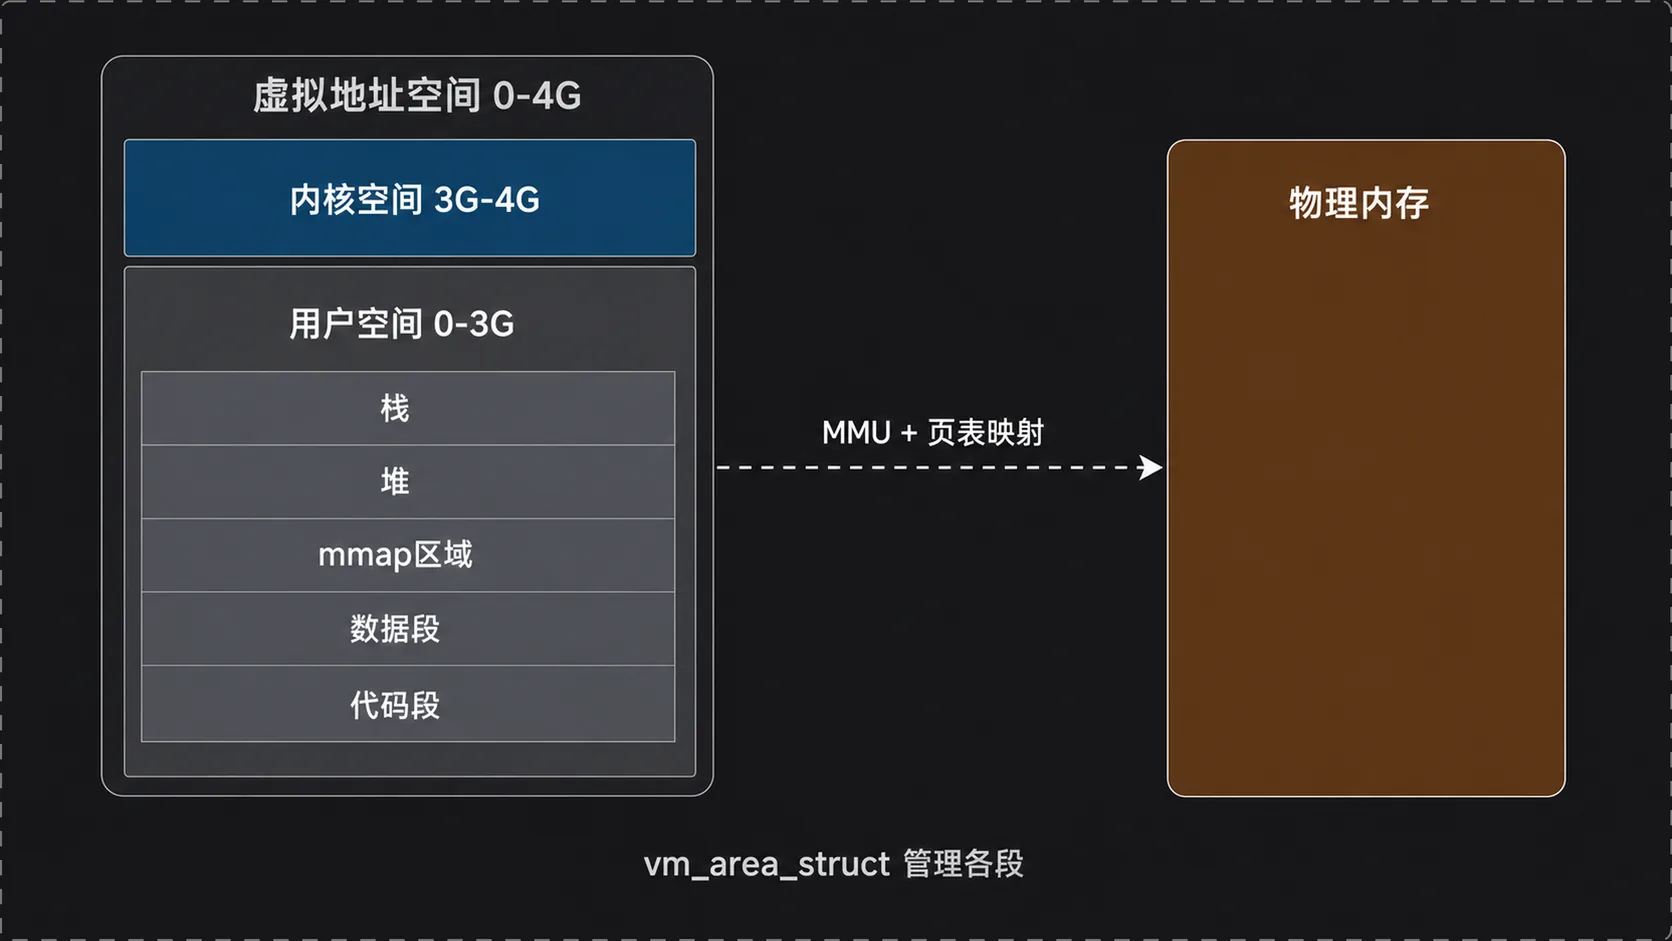
物理内存通常按页管理,常见页大小是 4KB,内核可通过伙伴系统等机制取得页面。虚拟连续也不代表物理连续,页表负责把各个虚拟页翻译到对应物理页。于是,同一个物理页可以在内核地址空间有一个映射,又在某个进程的用户地址空间有另一个映射。两个虚拟地址数值不同,读写的却是同一块物理内存。
进程进入系统调用后,执行上下文仍属于当前进程,只是 CPU 切到了内核态,并能访问内核地址空间。Binder 驱动借助这个条件处理发送方数据,再通过目标进程预先建立的映射交付事务。它没有把发送方和接收方的两段用户地址粗暴地连在一起。
三、binder_open:为进程建立驱动侧档案
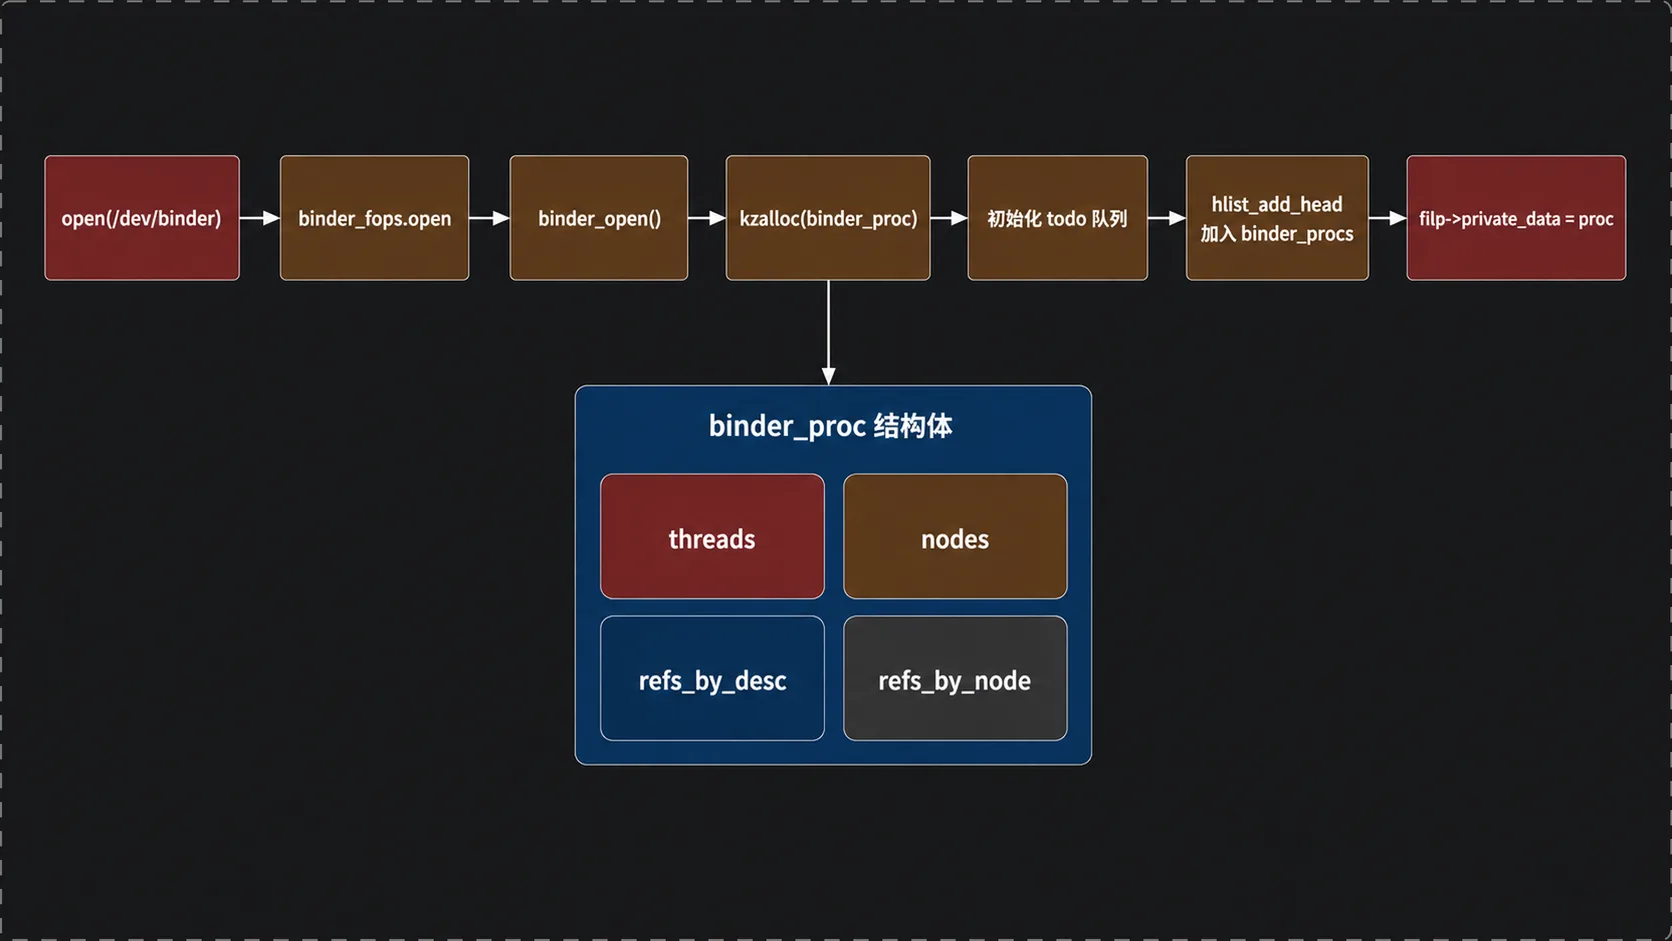
进程打开 Binder 设备时,VFS 根据 binder_fops.open 调用 binder_open。这个函数会分配并初始化 binder_proc,记录当前进程 PID,准备对象索引和队列,随后把指针放进 filp->private_data。后面的 mmap 与 ioctl 都从这里取回所属进程,因此 private_data 相当于三条路径之间的接头。
binder_open :
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 3004—3037 行// 声明 binder_open:为进程建立驱动侧档案static int binder_open(struct inode *nodp, struct file *filp) { // 声明即将创建的进程控制结构指针 struct binder_proc *proc; // 打印打开设备时的调试信息 binder_debug(BINDER_DEBUG_OPEN_CLOSE, "binder_open: %d:%d\n", // 参数是当前进程组长的 PID 和当前线程的 PID current->group_leader->pid, current->pid); // 在内核空间申请一小段连续内存并清零,用来保存这个进程的控制结构 proc = kzalloc(sizeof(*proc), GFP_KERNEL); // 分配失败时直接返回内存错误 if (proc == NULL) // 返回内存不足错误码 return -ENOMEM; // 增加当前进程 task_struct 的引用计数,防止使用期间被释放 get_task_struct(current); // 记录该进程对应的 task_struct proc->tsk = current; // 初始化待处理事务队列(todo 队列) INIT_LIST_HEAD(&proc->todo); // 初始化线程睡眠与唤醒所用的等待队列 init_waitqueue_head(&proc->wait); // 把这个 binder_proc 挂入驱动维护的全局进程链表 binder_procs hlist_add_head(&proc->proc_node, &binder_procs); // 让文件的私有数据指向这个 binder_proc,供后续 mmap、ioctl 复用 filp->private_data = proc; // 打开成功 return 0;// 结束 binder_open 函数}这几步刚好对应前一段的描述:kzalloc 分配并清零 binder_proc;get_task_struct 让驱动持有当前进程 task_struct 的引用,避免进程在使用期间被回收;todo 队列和等待队列先初始化好,供后续事务和线程调度使用;最后 hlist_add_head 把这个 binder_proc 登记进驱动全局维护的进程链表 binder_procs,filp->private_data = proc 则让同一个文件描述符在后续的 mmap、ioctl 调用里都能取回这个进程对象。
简化后的 binder_proc 能看出它管理的范围:
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 286—317 行// 定义每个 Binder 进程对应的控制结构struct binder_proc { // 挂入全局进程集合 struct hlist_node proc_node; // 按线程 PID 索引 binder_thread struct rb_root threads; // 按节点信息索引 binder_node struct rb_root nodes; // 按描述符索引 binder_ref struct rb_root refs_by_desc; // 按目标节点索引 binder_ref struct rb_root refs_by_node; // 保存进程 PID int pid; // 保存用户空间映射区域 struct vm_area_struct *vma; // 保存用户空间缓冲区首地址 void __user *buffer; // 管理已划分的 Binder 缓冲区 struct list_head buffers; // 省略与当前讨论无关的字段 // ... 其他字段// 结束进程控制结构定义};其中 threads、nodes、refs_by_desc、refs_by_node 是四棵常见的红黑树。它们解决的是快速定位:驱动收到一个线程 PID 或 Binder handle 时,不需要线性遍历进程内全部对象。缓冲区在不同源码版本中可能采用链表、红黑树或更细的分配器结构,阅读时应以当前内核分支为准,不能拿某一版字段布局反推所有版本。
binder_init 还会初始化工作项、调试节点和全局设备列表,再通过 misc_register 完成设备注册。binder_open 创建的 binder_proc 会加入全局进程集合,释放设备时由相应清理路径撤销对象关系、缓冲区和引用。到这里,驱动已经认识这个进程,但此时还没有准备好接收事务数据的用户空间缓冲区。
四、binder_mmap:同一物理页的两套虚拟地址
Binder 用户态库在打开设备后会执行 mmap。普通 Binder 进程常见的映射请求是 1M - 8K,ServiceManager 的映射通常更小,常见值为 128KB(Android 6.0)。
binder_mmap 同时处理两类虚拟内存描述:用户空间的区间由传入的 vm_area_struct 表示,内核侧另行建立 vm_struct。驱动记录两边起始地址的差值,这个差值会保存在 proc->user_buffer_offset 里。事务缓冲区位于其中一边时,通过固定偏移就能算出另一边的对应虚拟地址。
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 2905—3002 行// 声明 Binder 映射函数(保留主干逻辑,省略调试打印与部分回滚代码)static int binder_mmap(struct file *filp, struct vm_area_struct *vma) { // 从文件私有数据取得进程控制结构 struct binder_proc *proc = filp->private_data; // 声明内核侧要建立的虚拟内存区域 struct vm_struct *area; // 声明本次映射对应的第一块 Binder 缓冲区 struct binder_buffer *buffer; // 声明函数返回值,默认成功 int ret = 0; // mmap 只能由打开设备的那个进程自己发起 if (proc->tsk != current) // 调用者与打开设备时的进程不一致,参数错误 return -EINVAL; // 普通 Binder 进程常见请求 1M-8K,ServiceManager 常见请求 128K if ((vma->vm_end - vma->vm_start) > SZ_4M) // 单次映射统一限制在 4M 以内,超出则直接截断 vma->vm_end = vma->vm_start + SZ_4M; // 用互斥锁保护 proc->buffer 的检查与赋值 mutex_lock(&binder_mmap_lock); // 同一个进程只允许成功映射一次 if (proc->buffer) { // 已经映射过,返回设备忙错误 ret = -EBUSY; // 跳到已映射的错误处理分支 goto err_already_mapped; // 结束已映射检查 } // 在内核虚拟地址空间为同样大小的区间申请一段 vm_struct area = get_vm_area(vma->vm_end - vma->vm_start, VM_IOREMAP); // 申请失败则回退 if (area == NULL) { // 标记内存不足 ret = -ENOMEM; // 跳到区域申请失败的错误处理分支 goto err_get_vm_area_failed; // 结束区域申请检查 } // 内核侧看到的缓冲区起始地址 proc->buffer = area->addr; // 记录用户地址与内核地址之间的固定偏移,后续加减这个值即可换算 proc->user_buffer_offset = vma->vm_start - (uintptr_t)proc->buffer; // 释放互斥锁 mutex_unlock(&binder_mmap_lock); // 按页数申请一个数组,记录这段区间里每一页对应的 struct page proc->pages = kzalloc(sizeof(proc->pages[0]) * // 数组长度等于这段区间能容纳的页数 ((vma->vm_end - vma->vm_start) / PAGE_SIZE), GFP_KERNEL); // 分配失败则回退 if (proc->pages == NULL) { // 标记内存不足 ret = -ENOMEM; // 跳到页数组分配失败的错误处理分支 goto err_alloc_pages_failed; // 结束页数组分配检查 } // 记录整段缓冲区的大小 proc->buffer_size = vma->vm_end - vma->vm_start; // 把这段 vm_area_struct 的操作集指向 Binder 自己的 vm_operations_struct vma->vm_ops = &binder_vm_ops; // 让 vma 的私有数据指向该进程,供 open/close 回调使用 vma->vm_private_data = proc; // 先只分配第一页物理内存,其余页面等到真正用到时再补 if (binder_update_page_range(proc, 1, proc->buffer, // 只处理 [buffer, buffer + PAGE_SIZE) 这一页 proc->buffer + PAGE_SIZE, vma)) { // 标记内存不足 ret = -ENOMEM; // 跳到首块缓冲区分配失败的错误处理分支 goto err_alloc_small_buf_failed; // 结束首块缓冲区分配检查 } // 把第一页整体登记成一块空闲的 Binder 缓冲区 buffer = proc->buffer; // 初始化这个进程的缓冲区链表 INIT_LIST_HEAD(&proc->buffers); // 把这块缓冲区挂进链表 list_add(&buffer->entry, &proc->buffers); // 标记这块缓冲区当前是空闲的 buffer->free = 1; // 让空闲缓冲区可以按大小被快速检索到 binder_insert_free_buffer(proc, buffer); // 异步事务能占用的空间上限先设为总大小的一半 proc->free_async_space = proc->buffer_size / 2; // 记录该进程打开的文件表,转移文件描述符时会用到 proc->files = get_files_struct(current); // 保存这段用户虚拟内存区域,后续换算地址、处理缺页时要用 proc->vma = vma; // 保存这段区域所属的 mm_struct,用于校验调用者身份 proc->vma_vm_mm = vma->vm_mm; // 映射建立成功 return ret;// 结束 binder_mmap 函数}为了篇幅省略了调试打印、failure_string 记录和部分回滚跳转,保留了地址映射的主线。真正做逐页映射的是 binder_update_page_range,它对每一页做两件事:先用 alloc_page 申请一块物理内存,再用 map_vm_area 把它按 PAGE_KERNEL 权限映射进内核虚拟地址空间;随后用 proc->user_buffer_offset 换算出这一页在用户空间对应的地址,再用 vm_insert_page 把同一块物理页插入目标进程的用户虚拟内存区域。核心循环大致是这样:
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 627—734 行// 声明 binder_update_page_range:按页给一段虚拟地址区间分配物理内存static int binder_update_page_range(struct binder_proc *proc, int allocate, // 处理的虚拟地址区间为 [start, end),vma 用于建立用户侧映射 void *start, void *end, struct vm_area_struct *vma) { // 声明遍历用的页地址指针 void *page_addr; // 声明保存物理页指针的位置 struct page **page; // 声明换算出的用户空间地址 unsigned long user_page_addr; // 声明用于临时描述内核映射区域的结构 struct vm_struct tmp_area; // 按页大小逐页处理这段区间 for (page_addr = start; page_addr < end; page_addr += PAGE_SIZE) { // 取得这一页在 proc->pages 数组中的槽位 page = &proc->pages[(page_addr - proc->buffer) / PAGE_SIZE]; // 这个槽位理应还没有分配过物理页 BUG_ON(*page); // 申请一页物理内存并清零 *page = alloc_page(GFP_KERNEL | __GFP_HIGHMEM | __GFP_ZERO); // 分配失败则跳到相应错误处理 if (*page == NULL) // 跳到物理页分配失败分支 goto err_alloc_page_failed; // 准备把这一页映射进内核虚拟地址空间 tmp_area.addr = page_addr; // 描述这次内核映射的大小 tmp_area.size = PAGE_SIZE + PAGE_SIZE; // 建立内核虚拟地址到这一物理页的映射 if (map_vm_area(&tmp_area, PAGE_KERNEL, page)) // 跳到内核侧映射失败分支 goto err_map_kernel_failed; // 用固定偏移换算出同一物理页在用户空间对应的虚拟地址 user_page_addr = (uintptr_t)page_addr + proc->user_buffer_offset; // 把同一块物理页插入目标进程的用户地址空间 if (vm_insert_page(vma, user_page_addr, page[0])) // 跳到用户侧映射失败分支 goto err_vm_insert_page_failed; // 结束逐页处理循环 } // 全部页面处理成功 return 0; // 用户侧映射失败会走到这里err_vm_insert_page_failed: // 内核侧映射失败也会走到这里err_map_kernel_failed: // 物理页分配失败同样进入这里err_alloc_page_failed: // 出现错误时需要回滚已经处理过的页面,这里略去具体的 free_range 逻辑 return -ENOMEM;// 结束 binder_update_page_range 函数}固定偏移还有一个实用效果。驱动分配缓冲区时操作的是内核虚拟地址,返回给目标进程的事务数据指针却必须落在它的用户地址范围内。两边存在稳定的线性关系,驱动用加减偏移即可换算,不需要为每块小缓冲区再维护一套地址查询表。换算得到的是同一物理内容的另一种虚拟地址表达,不能拿这个偏移去访问其他进程的任意内存。
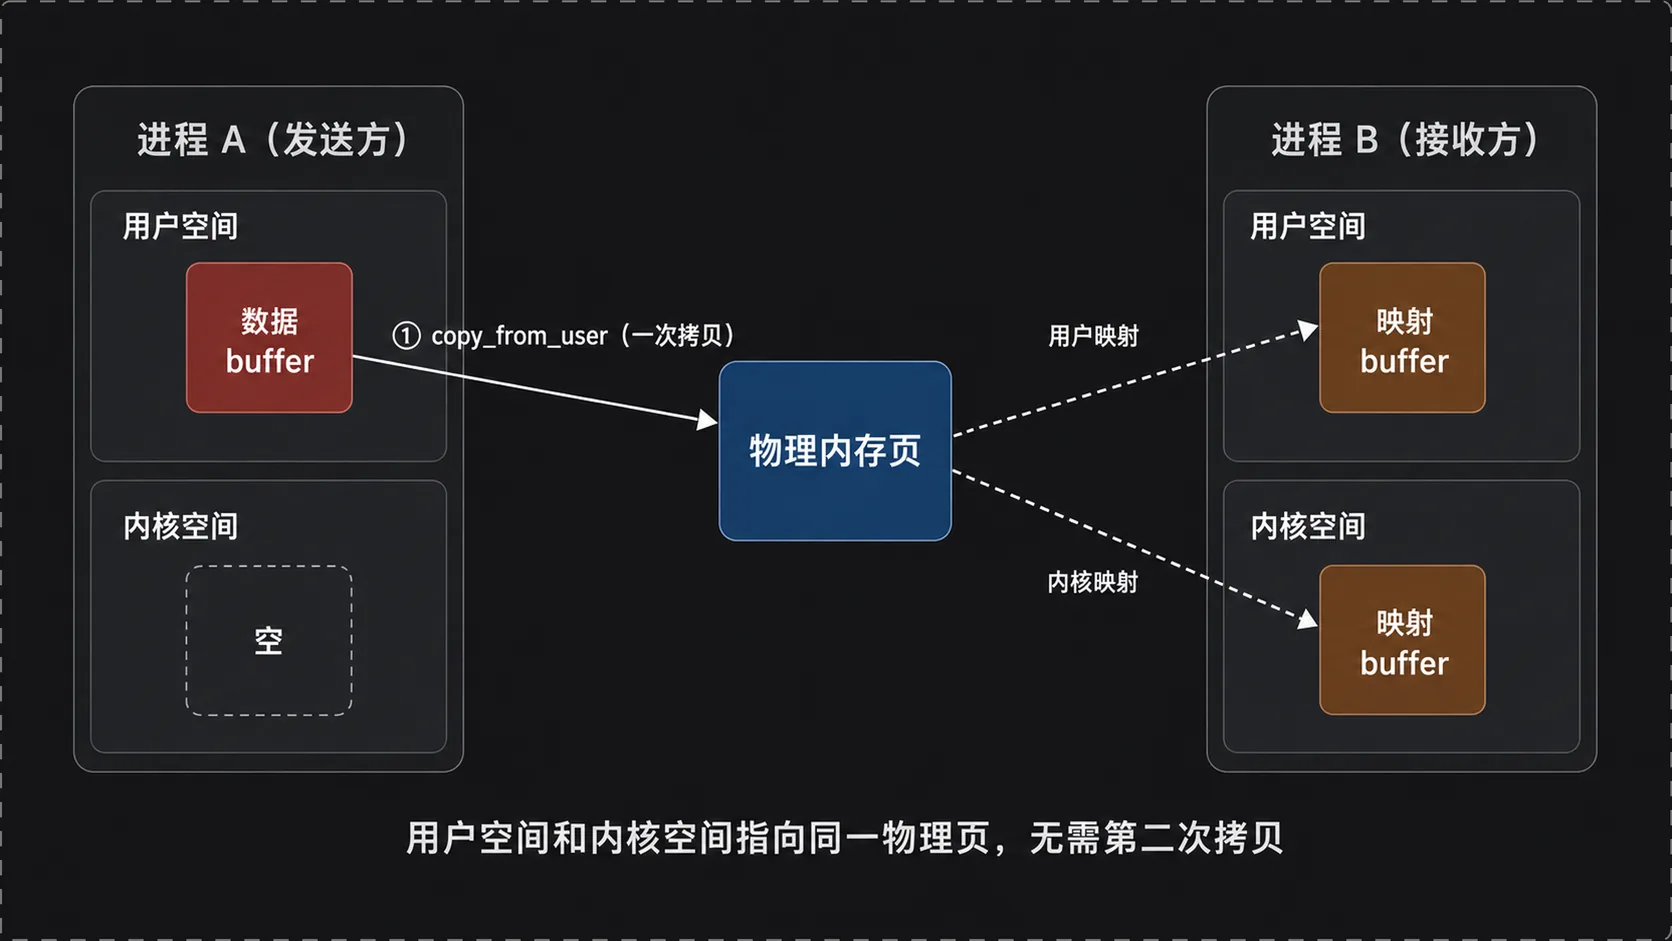
现在可以准确描述一次拷贝了。假设进程 A 调用进程 B:
- A 把事务数据放在自己的用户空间,随后通过
ioctl交给驱动。 - 驱动为 B 选择一块 Binder 接收缓冲区,用
copy_from_user一类操作把 A 的数据复制到该缓冲区对应的内核虚拟地址。这是实际的数据复制。 - 这组物理页已经映射到 B 的用户空间。B 被唤醒后,根据驱动返回的用户地址读取它,不需要内核再向 B 的用户缓冲区复制一遍。
传统的内核中转式 IPC 往往包含“发送方用户空间到内核缓冲区”和“内核缓冲区到接收方用户空间”两次复制。Binder 把第二段交付改成了映射读取,所以通常称为一次拷贝。共享内存允许双方访问同一片共享区域,数据路径可做到零拷贝,不过同步、对象引用和调用协议需要调用双方另行管理;Binder 把这些能力放进统一的事务模型里。
映射区的大小也不等于驱动立刻分配同等数量的物理内存。前面 binder_mmap 的代码里也能看到,binder_update_page_range 只针对 [proc->buffer, proc->buffer + PAGE_SIZE) 这一页被调用,也就是说 mmap 返回时驱动只真正准备了一页物理内存。其余页面等到 binder_ioctl 处理事务、需要一块新的 Binder 缓冲区时,再由 binder_alloc_buf 按需调用 binder_update_page_range 扩展。虚拟地址预留与物理页按需分配配合,避免每个 Binder 进程启动时就占满整块物理内存。
五、binder_ioctl:把命令变成事务
内存准备好以后,频繁工作的是 binder_ioctl。用户态把命令号和参数传入驱动,驱动从 filp->private_data 取得 binder_proc,再按 cmd 进入相应分支。上下文管理者注册、线程上限、版本查询以及事务读写都走这个入口。
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 2734—2875 行// 声明简化后的 ioctl 主入口static long binder_ioctl(struct file *filp, // 接收命令号和用户参数地址 unsigned int cmd, unsigned long arg) { // 取得当前文件关联的 Binder 进程 struct binder_proc *proc = filp->private_data; // 根据命令号选择处理路径 switch (cmd) { // 处理上下文管理者注册 case BINDER_SET_CONTEXT_MGR: // 将调用进程登记为 ServiceManager break; // 处理 Binder 线程上限设置 case BINDER_SET_MAX_THREADS: // 保存进程允许的最大 Binder 线程数 break; // 处理事务数据的读写 case BINDER_WRITE_READ: // 进入 Binder 读写协议处理函数 binder_ioctl_write_read(filp, arg, &bwr); // 完成当前命令分支 break; // 处理协议版本查询 case BINDER_VERSION: // 把驱动协议版本返回用户态 break; // 结束命令分发 }// 结束 ioctl 入口函数}真实实现在进入这个 switch 之前还有一步容易被忽略:驱动先用 wait_event_interruptible 等在一个专门的等待队列上,确认自己没有处于“需要用户态先处理错误”的状态,再调用 binder_lock 加锁,之后才去取 binder_thread。这把锁保护的正是接下来要操作的红黑树和队列,避免同一个 binder_proc 被多个线程同时改动。
同一进程可能有多个线程进入驱动,所以 binder_proc 之下还要管理 binder_thread。驱动用当前线程 PID 查询 threads 红黑树;首次进入时没有对应对象,便分配线程结构,初始化等待队列和 todo 队列,再插入红黑树。后续调用复用该对象,事务也能准确投递到进程或某个线程。真实的查找和插入是直接手写的红黑树操作,并没有额外包一层查找/分配的辅助函数:
// 代码位置 /kernel/msm/drivers/staging/android/binder.c 第 2626—2659 行// 声明按当前 PID 获取 Binder 线程的函数static struct binder_thread *binder_get_thread(struct binder_proc *proc) { // 最终返回的线程对象,初始为空 struct binder_thread *thread = NULL; // 记录查找路径上的父节点 struct rb_node *parent = NULL; // 从线程红黑树的根节点开始查找 struct rb_node **p = &proc->threads.rb_node; // 沿着红黑树往下走,直到找到当前 PID 或者走到空节点 while (*p) { // 记录当前节点,作为下一层的父节点 parent = *p; // 从红黑树节点还原出所在的 binder_thread thread = rb_entry(parent, struct binder_thread, rb_node); // 当前 PID 更小就往左子树找 if (current->pid < thread->pid) // 转向左子树继续查找 p = &(*p)->rb_left; // 当前 PID 更大就往右子树找 else if (current->pid > thread->pid) // 转向右子树继续查找 p = &(*p)->rb_right; // 相等说明已存在该线程对象 else // 提前结束查找 break; // 结束红黑树查找循环 } // 走到空节点说明这是该线程第一次进入驱动 if (*p == NULL) { // 为当前 PID 分配 Binder 线程结构 thread = kzalloc(sizeof(*thread), GFP_KERNEL); // 分配失败直接返回空 if (thread == NULL) // 返回空指针交由调用者处理 return NULL; // 统计信息:新建了一个线程对象 binder_stats_created(BINDER_STAT_THREAD); // 关联线程所属的 Binder 进程 thread->proc = proc; // 记录线程 PID thread->pid = current->pid; // 初始化线程睡眠和唤醒所用的等待队列 init_waitqueue_head(&thread->wait); // 初始化线程待办事务队列 INIT_LIST_HEAD(&thread->todo); // 把新节点按刚才找到的位置挂到红黑树上 rb_link_node(&thread->rb_node, parent, p); // 调整红黑树,恢复平衡和着色规则 rb_insert_color(&thread->rb_node, &proc->threads); // 标记这个线程下一次返回前需要检查退出条件 thread->looper |= BINDER_LOOPER_STATE_NEED_RETURN; // 默认的返回码先设为 BR_OK thread->return_error = BR_OK; // 第二个返回码字段同样设为 BR_OK thread->return_error2 = BR_OK; // 结束线程创建分支 } // 返回已找到或刚创建的线程对象 return thread;// 结束线程查询函数}current->pid 与已有节点比较、按大小走左右子树,是红黑树按 key 查找的标准写法;找到空位后用 rb_link_node 挂接、rb_insert_color 调整平衡,这两步合起来才是一次完整的红黑树插入。这段代码也印证了前面的说法:红黑树本身只负责按 PID 定位,todo 队列和等待队列的初始化仍然是各管各的。
Binder 的用户态与驱动之间有一组命令协议。BC_* 表示用户态写给驱动的命令,比如 BC_TRANSACTION 和 BC_REPLY;BR_* 是驱动让用户态读取的返回命令,比如 BR_TRANSACTION、BR_REPLY 和事务完成通知。BINDER_SET_CONTEXT_MGR 用于登记上下文管理者,BINDER_SET_MAX_THREADS 用于配置驱动建议的线程上限。
一次同步事务进入 BINDER_WRITE_READ 后,大致会经历这些动作:驱动检查 write_size,解析写缓冲区中的 BC_TRANSACTION,根据 handle 找到 binder_ref,继而定位目标 binder_node 与目标 binder_proc。驱动在目标进程的映射区分配事务缓冲区,复制数据和必要的 Binder 对象,构造工作项并放入目标线程或进程的 todo 队列,随后唤醒正在等待的 Binder 线程。
目标线程的选择也有上下文。如果事务指向某条已有调用链上的线程,驱动可以把工作交给相应线程;否则工作可以进入目标进程的待办队列,由空闲 Binder 线程领取。线程池数量不足时,驱动协议还能提示用户态扩充线程。红黑树负责快速找到线程对象,todo 队列保存等待执行的工作,等待队列负责睡眠与唤醒,三类结构各管一件事。
事务里的普通字节数据和 Binder 对象需要分开理解。Parcel 中的标量、字符串等内容复制进目标缓冲区;扁平化 Binder 对象还需要驱动校验类型、调整引用或文件描述符等附加信息。也正因为驱动参与对象转换,Binder 才能在一次数据复制之外提供带身份的对象调用语义。这里说的一次拷贝描述的是主要数据搬运次数,并不表示事务处理没有元数据解析、引用更新和队列操作。
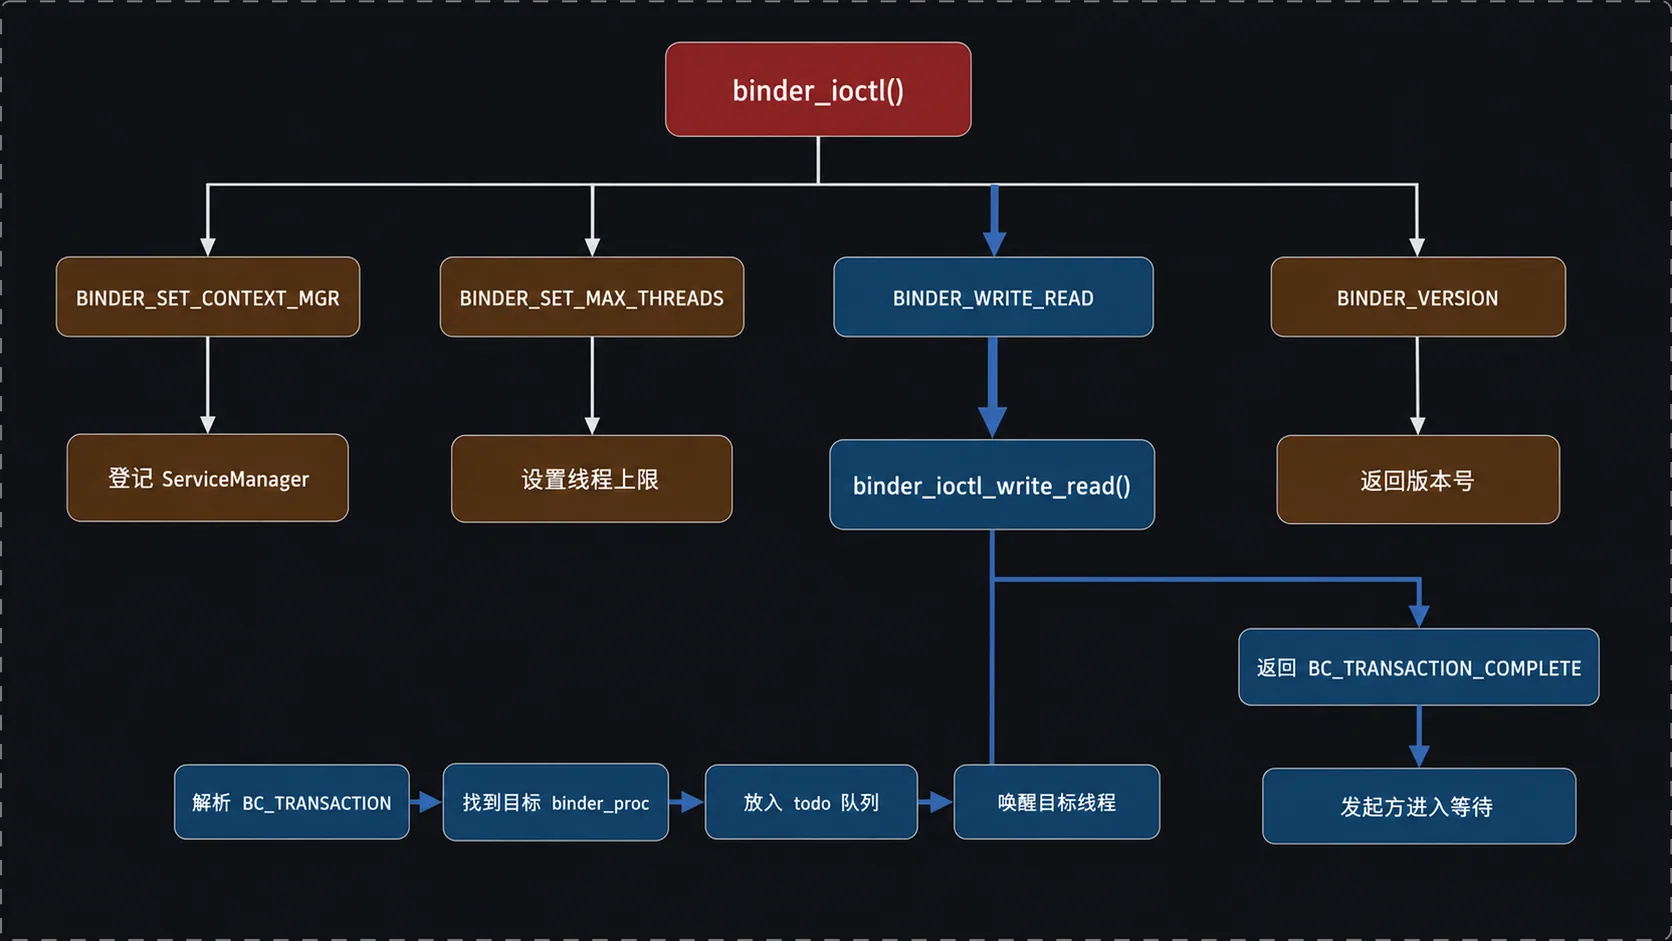
发送线程会收到事务已被驱动接收的完成通知。同步调用还会继续等待目标端回复;目标线程从 todo 队列取到 BR_TRANSACTION,完成用户态方法调用,再以 BC_REPLY 把结果送回驱动。驱动沿事务栈找到原发送线程,为它放入回复工作项并唤醒它,发送方最终读到 BR_REPLY。
“完成通知”和“业务回复”容易混在一起。前者表示驱动已处理发送命令,不代表目标方法已经执行完;后者才携带目标端的调用结果。异步 one-way 事务不等待业务回复,排队和串行约束也与同步事务有所区别。
六、总结
binder_open为每个参与进程创建binder_proc,驱动由此能够维护线程、节点、引用和缓冲区;binder_mmap给接收进程建立内核地址与用户地址到同一物理页的映射;binder_ioctl解析命令、定位目标、复制事务数据、安排队列并唤醒线程。
三者的协作关系可以压缩成一条数据路径:发送方用户缓冲区经过一次复制进入目标进程的 Binder 物理页,目标进程通过预先映射的用户地址读取这些页。少掉的是“内核临时缓冲区再复制到接收方用户缓冲区”这一步,进程身份、线程调度、对象引用和回复路径仍由驱动完整管理。
本文由 AgentWorkFlow 生成