
文章内容
一、面试题:一次拷贝是怎么做到的
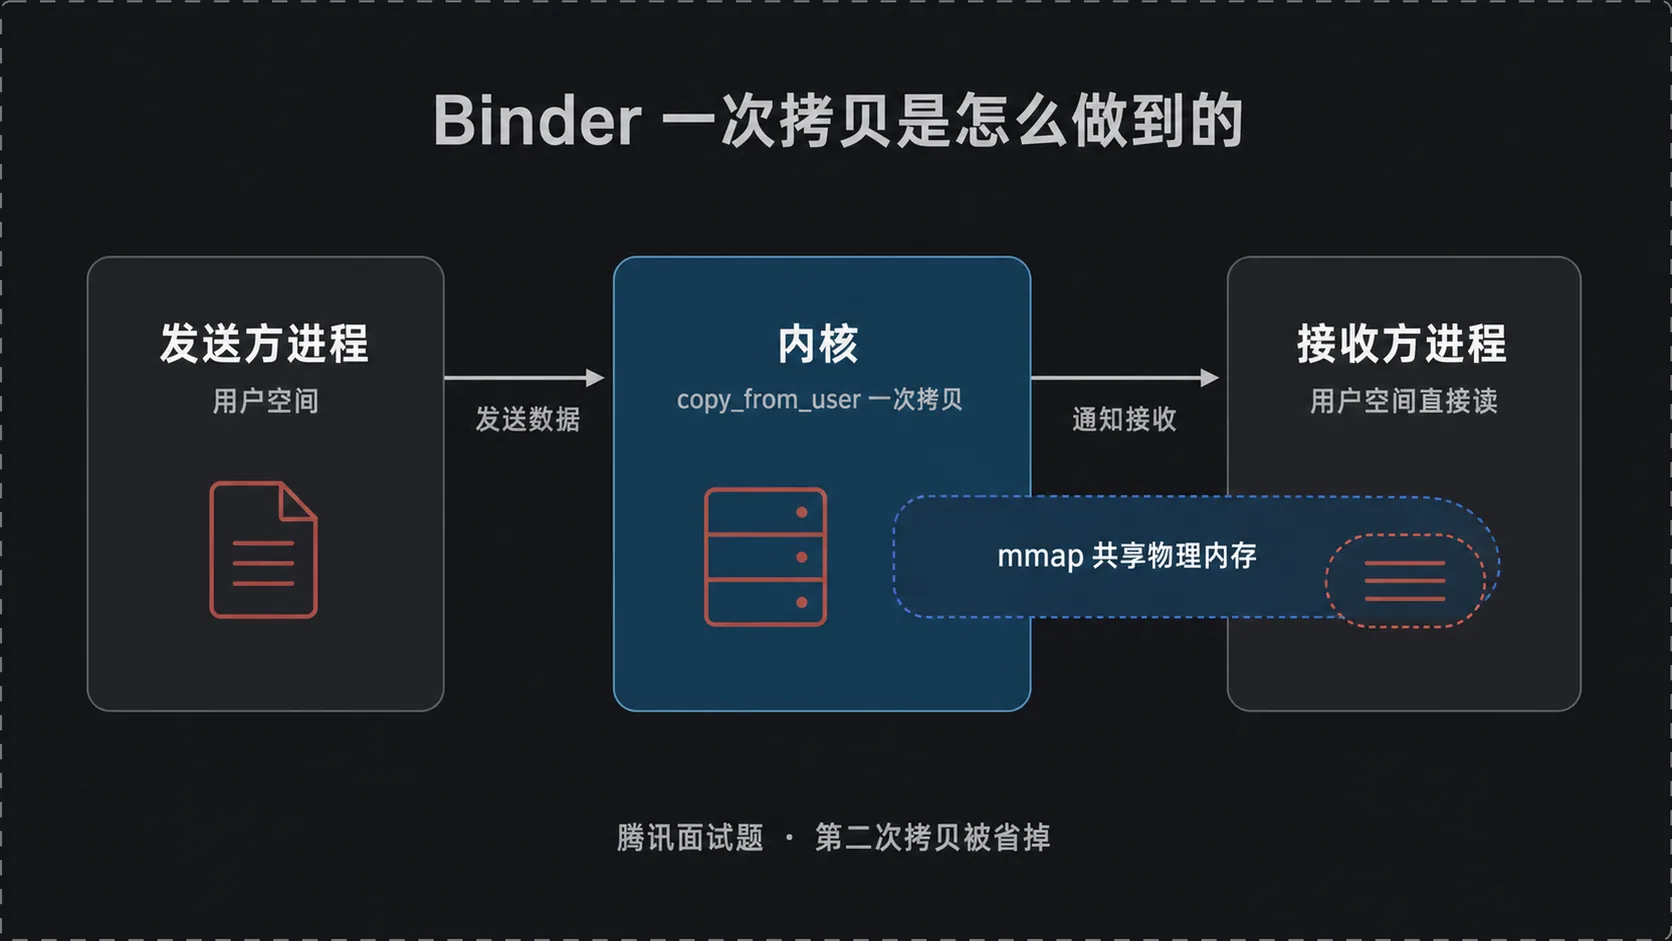
1.1 问题由来
上一篇讲 Binder 相对传统 IPC 的三点优势,第一条就是数据只拷贝一次。面试题接着往下追:既然管道、消息队列、Socket 都要拷两次,Binder 凭什么少一次,那一次省在哪里。
答案不在 Binder 自己身上。它没有发明新的数据搬运方式,只是把「谁和谁共享内存」这件事重新安排了一遍。
1.2 关键词:mmap
绕不开的机制是 mmap——一个把文件或者设备的某段内容、又或者一片匿名物理内存,直接映射到进程虚拟地址空间的系统调用。映射建立之后,进程读写这段地址就等于读写背后的那块内存,中间不再经过 read/write 这类需要拷贝的接口。
Binder 通信里,接收方进程就是靠 mmap 和内核共享了一块区域。剩下的推导都从这里展开。
二、先看传统方式浪费在哪
2.1 传统 IPC:两次拷贝,接收方还得在家等
寄快递的老规矩是当面签收。寄件人把包裹交给快递员,这算第一次交接;快递员没法自作主张,得先给收件人打电话——今天有你的快递,你在家等我——然后上门,收件人当面接过,这是第二次交接。
传统 IPC 是一样的节奏。发送方调 write,数据从它的用户空间拷进内核缓冲区(内核为这次传输临时分配的一段内存),这是第一次;接收方调 read,数据再从内核缓冲区拷进它自己的用户空间,这是第二次。真正难受的不只是多一次内存拷贝,而是接收方被这套流程拴住了:它必须阻塞在 read 上等这份数据落到自己手里,为了收一个包裹,一天什么都干不了。
2.2 快递柜模式:放柜子里,收件人随时取
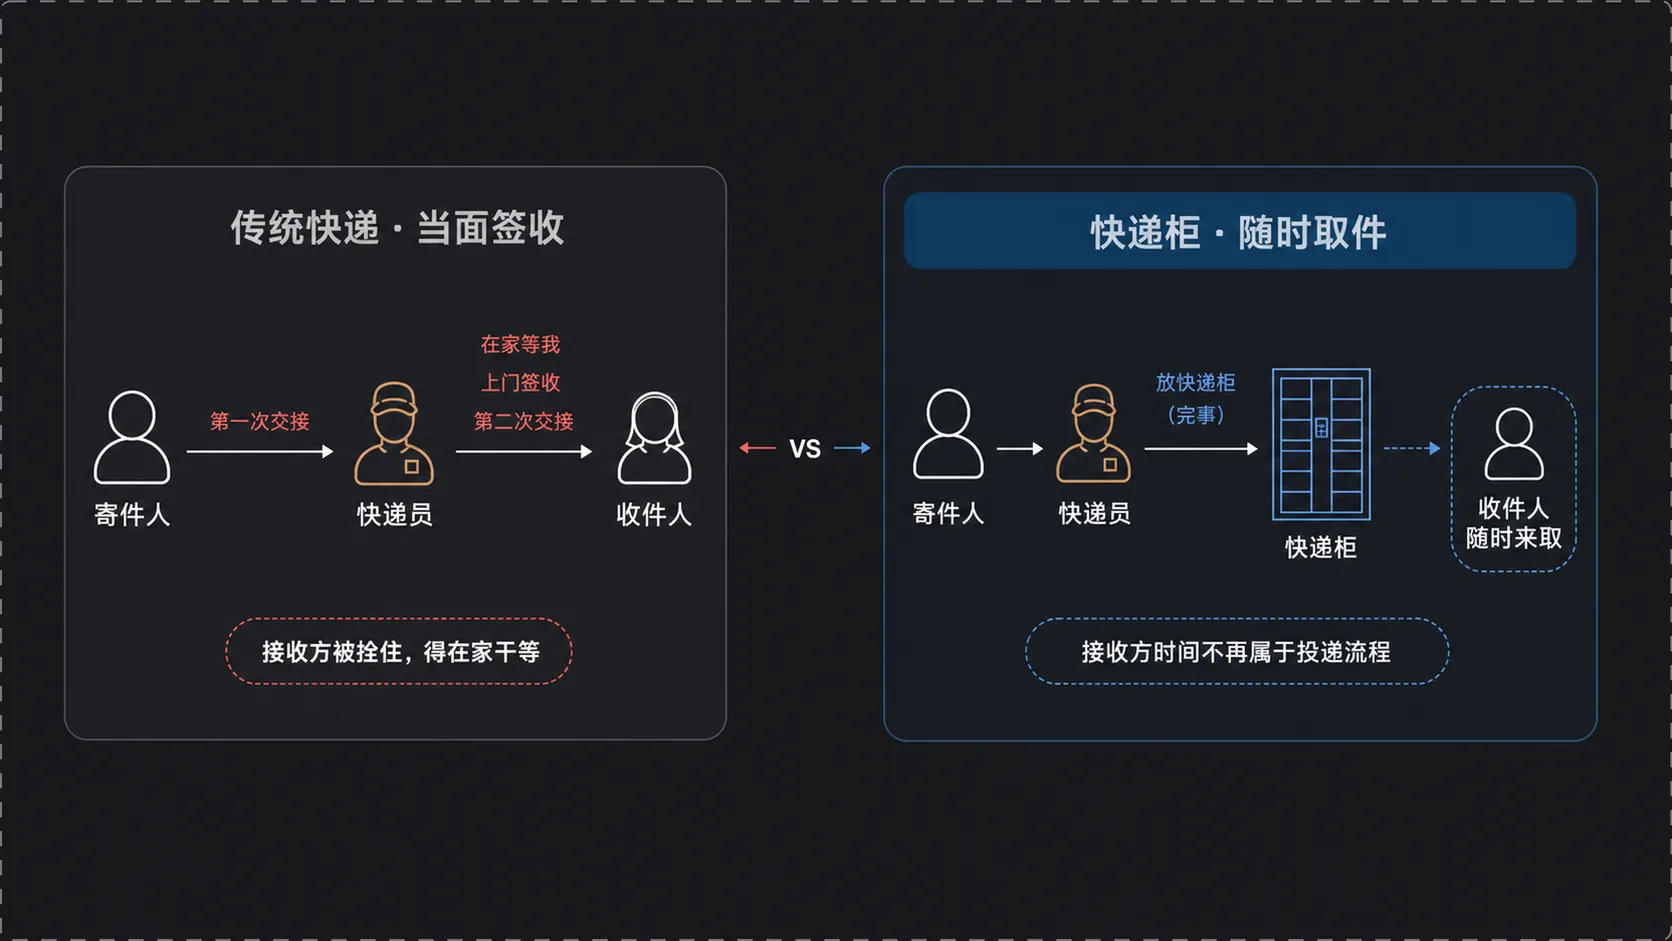
现在小区里都是菜鸟驿站、中邮速递易这类快递柜。寄件人把一支口红交给快递员,快递员塞进柜子就完事,顺手发条取件码短信。收件人下班路过取,晚上散步取,第二天取都行。
关键改动在于,快递柜是一块双方都能触达的中转空间。快递员把东西放进去就完成了投递,收件人的时间从此不再是投递流程的一部分。Binder 走的就是这条路子。
三、mmap:接收方与内核的共享区域
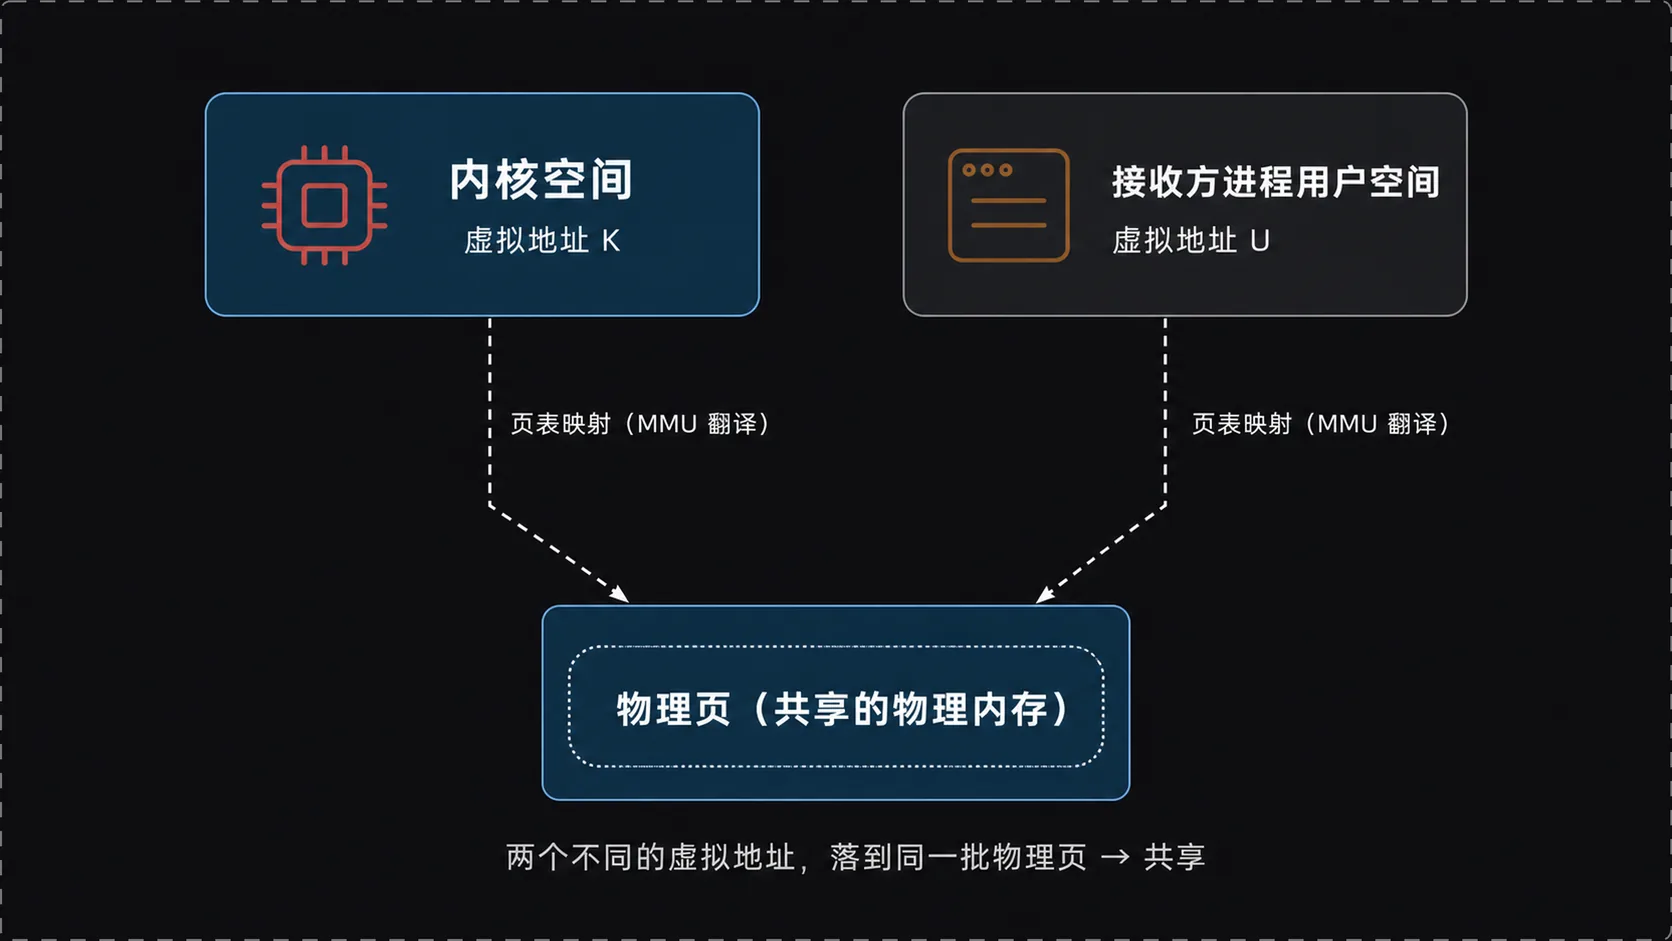
3.1 核心机制:接收方和内核共享一块物理内存
Binder 驱动给每个接收方进程准备的那块缓冲区,同时属于两边:内核能写,接收方进程能读。这块区域就是快递柜。
发送方那一次拷贝依然要做,数据得从发送方的用户空间进到内核。但数据进来之后就到站了,它落在的地方接收方本来就看得见,不存在「再搬一次给收件人」的步骤。省掉的是第二次拷贝,同时省掉的还有接收方干等的那段时间。
3.2 虚拟内存回顾:数据最终在物理内存,共享的是物理页
说「共享」之前得先分清楚地址的层次。用户空间和内核空间都是虚拟内存,进程手里拿的是虚拟地址,虚拟地址本身不装数据,它得经过 MMU 查页表,翻译成物理地址,数据真正躺在物理内存的页里——一页通常 4KB。
所以两个地址空间「共享一块内存」的准确含义是:两边不同的虚拟地址,经过各自的页表,落到同一批物理页上。所有进程共享内核空间是这个道理,接收方与内核共享 Binder 缓冲区也是这个道理。虚拟地址可以各写各的,物理层面是同一份。
3.3 一次拷贝的完整路径
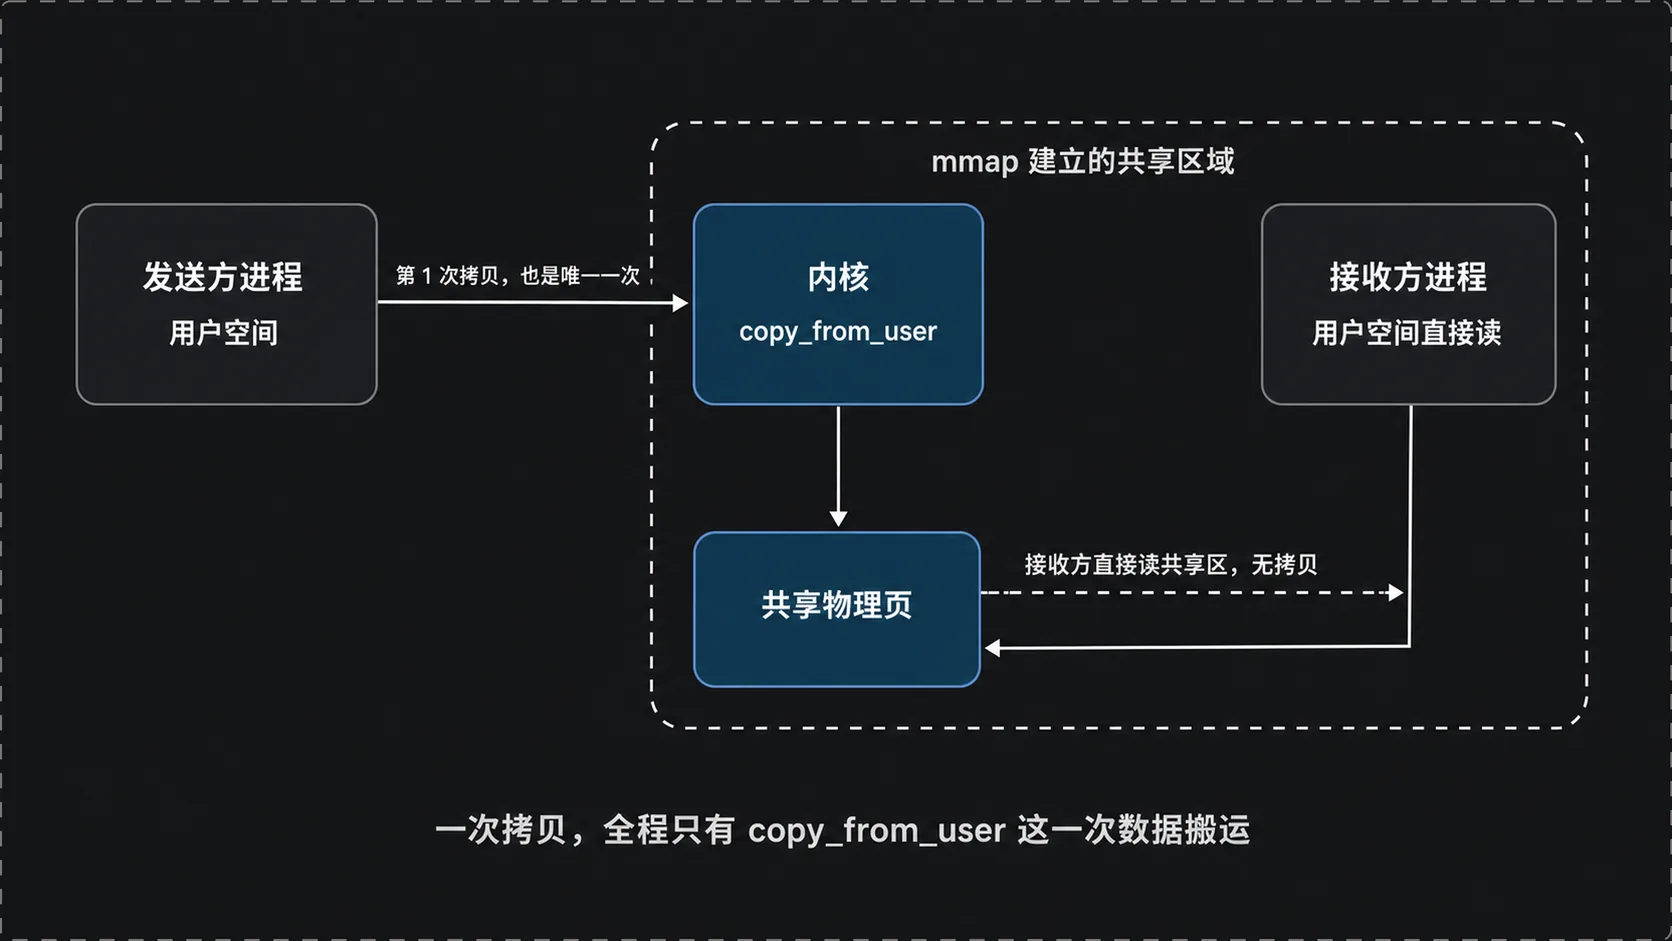
把整条链路拆开看:接收方进程启动时打开 /dev/binder(Binder 驱动对外暴露的字符设备节点),对它调 mmap,驱动分配一批物理页,一头映射到内核地址空间,一头映射到接收方的用户空间。
发送方发起一次事务,驱动调用 copy_from_user——内核从用户态地址读数据的标准接口,因为内核不能直接信任、也不能直接解引用用户传来的指针——把数据拷进那批物理页。拷贝到此为止。驱动唤醒接收方,交给它的是缓冲区里的一个偏移地址;接收方按这个地址读自己的用户空间,读到的正是刚写进去的那份数据。全程一次拷贝。
3.4 和共享内存的区别
这套共享区域不是 Android 独有的,Linux 早就有,POSIX 共享内存(shm)用的底层技术同样是 mmap。区别在映射的两端是谁。
共享内存让发送方和接收方同时映射到同一块物理内存,两个进程直接读写一块地,性能最高,代价是同步全得自己来:加锁、防死锁、控制读写顺序、处理一方崩溃留下的脏数据,全是调用者的活儿,而且谁映射了就谁都能改,权限边界模糊。Binder 面向的是系统里成百上千次跨进程调用,安全和易用比那点性能重要,于是它退了一步——发送方老老实实经 copy_from_user 拷一次,由内核统一校验和管理;接收方那一侧的共享交给 mmap,由系统保证。用一次拷贝的开销,换来了不用应用层做同步。
四、代码验证
4.1 C 的 mmap MAP_SHARED 演示
MAP_SHARED 是 mmap 的一个标志位,含义是这段映射对应的物理页在多个进程间共享,一方的写另一方立刻可见。下面用父子进程演示这个效果:父进程写,子进程不做任何读取系统调用,直接从自己的指针里拿到数据。
#include <stdio.h> // printf#include <string.h> // strcpy#include <unistd.h> // fork usleep#include <sys/mman.h> // mmap munmap#include <sys/wait.h> // wait int main(void) { // 程序入口 char *buf = mmap(NULL, 4096, // 让内核挑一段空闲虚拟地址,映射一页 4KB PROT_READ | PROT_WRITE, // 这段映射可读可写 MAP_SHARED | MAP_ANONYMOUS, // 共享映射 + 匿名映射(不关联任何文件) -1, 0); // 匿名映射不需要 fd 和文件偏移 if (buf == MAP_FAILED) return 1; // 映射失败直接退出 buf[0] = '\0'; // 首字节置零,当作“数据尚未就绪”的标记 pid_t pid = fork(); // 派生子进程;父子的用户空间彼此独立 if (pid == 0) { // 子进程分支:扮演接收方 while (buf[0] == '\0') usleep(1000); // 每毫秒轮询一次,等首字节被写成非零 printf("child read: %s\n", buf); // 直接读这段地址,没有 read,没有拷贝 return 0; // 子进程退出 } usleep(50 * 1000); // 父进程等 50ms,确保子进程已经在轮询 strcpy(buf, "one copy only"); // 扮演发送方:数据写进共享区,全程唯一一次拷贝 wait(NULL); // 等子进程结束 munmap(buf, 4096); // 解除映射,归还这段虚拟地址 return 0; // 程序结束}编译运行会打出 child read: one copy only。父进程只写了一次,子进程侧没有出现第二次数据搬运——因为两个进程的虚拟地址指向同一批物理页。Binder 省掉的那次拷贝,省的就是这里没出现的那一步。
4.2 Binder 驱动
接收方进程和 Binder 驱动建立共享区的过程,形态上和上面这段没有本质差别,只是映射的目标从匿名内存换成了 /dev/binder。下面这段只体现接口形态,不代表 libbinder 或驱动的真实实现。
// 示意代码:接收方进程建立 Binder 接收缓冲区的大致形态int fd = open("/dev/binder", O_RDWR | O_CLOEXEC); // 打开 Binder 驱动暴露的字符设备节点if (fd < 0) return -1; // 打不开说明驱动不可用,直接返回 size_t map_size = 1024 * 1024; // 申请的接收缓冲区大小(示意值)void *buffer = mmap(NULL, map_size, // 由内核选定一段空闲的用户态虚拟地址 PROT_READ, // 只读:数据由驱动写入,接收方不直接写 MAP_PRIVATE | MAP_NORESERVE, // Binder 使用的映射标志,不预留 swap fd, 0); // 映射目标是 /dev/binder 这个 fdif (buffer == MAP_FAILED) { close(fd); return -1; } // 映射失败则关闭 fd 收尾 // 映射建立后,驱动为这段区域分配的物理页同时挂在内核地址空间下;// 别的进程发来事务时,驱动用 copy_from_user 把数据拷进这些物理页——这是唯一一次拷贝;// 接收方随后按驱动返回的偏移读 buffer,读到的就是同一份数据,不需要第二次拷贝。映射一旦建立,接收方的读取就退化成一次普通的内存访问。所谓「一次拷贝」,指的就是从 copy_from_user 之后再没有任何数据搬运。
五、总结
5.1 一次拷贝的本质
Binder 没有取消拷贝,它取消的是投递的第二段路。发送方把数据交给内核(第一次拷贝,也是唯一一次),内核把它放进那块和接收方共享的缓冲区,接收方在自己的用户空间里直接取。快递柜就是这块 mmap 出来的共享区域,取件码就是驱动返回的缓冲区偏移。
对比共享内存能看清它的取舍:双方同时映射性能更好但同步和权限都得自己扛,Binder 用发送侧的一次 copy_from_user 买下了内核统一管理带来的安全与省心。
5.2 可验证的动作与延伸
4.1 那段代码可以直接编译运行,把 MAP_SHARED 换成 MAP_PRIVATE 再跑一次,子进程会永远卡在轮询里——私有映射写时复制,父进程的写落在自己的副本上,共享就断了,这个对照可以解释为「共享的是物理页」。
进程跑起来后 cat /proc/<pid>/maps,能看到 /dev/binder 对应的那段映射区间和它的权限位,Android 上任意一个应用进程都有。面试里问完一次拷贝,下一问基本就是 mmap 的原理,往下还会牵出它的其他用武之地——腾讯开源的键值存储 MMKV,底层写入走的同样是 mmap。
本文由 AgentPlanFlow 生成