
文章内容
本文内容整理自技术讲解视频《handler 运行的整个流程源码解析》。
主线程里有一个 for (;;) 死循环,从应用启动一直转到进程结束,应用却不卡。死循环与不卡顿为什么能同时成立?
原因可以总结为:send 系列方法把消息交给 Handler.enqueueMessage,消息带着一个执行时刻 when 被插进 MessageQueue 的单向链表(按 when 升序,所以它是优先级队列而不是 FIFO 队列),Looper.loop() 的死循环反复调 MessageQueue.next() 取队头,取到后调 msg.target.dispatchMessage(msg),最终落到 handleMessage。入队与出队的线程安全靠 synchronized (this);死循环不烧 CPU,靠 nativePollOnce 在 native 层的 epoll 上阻塞休眠。
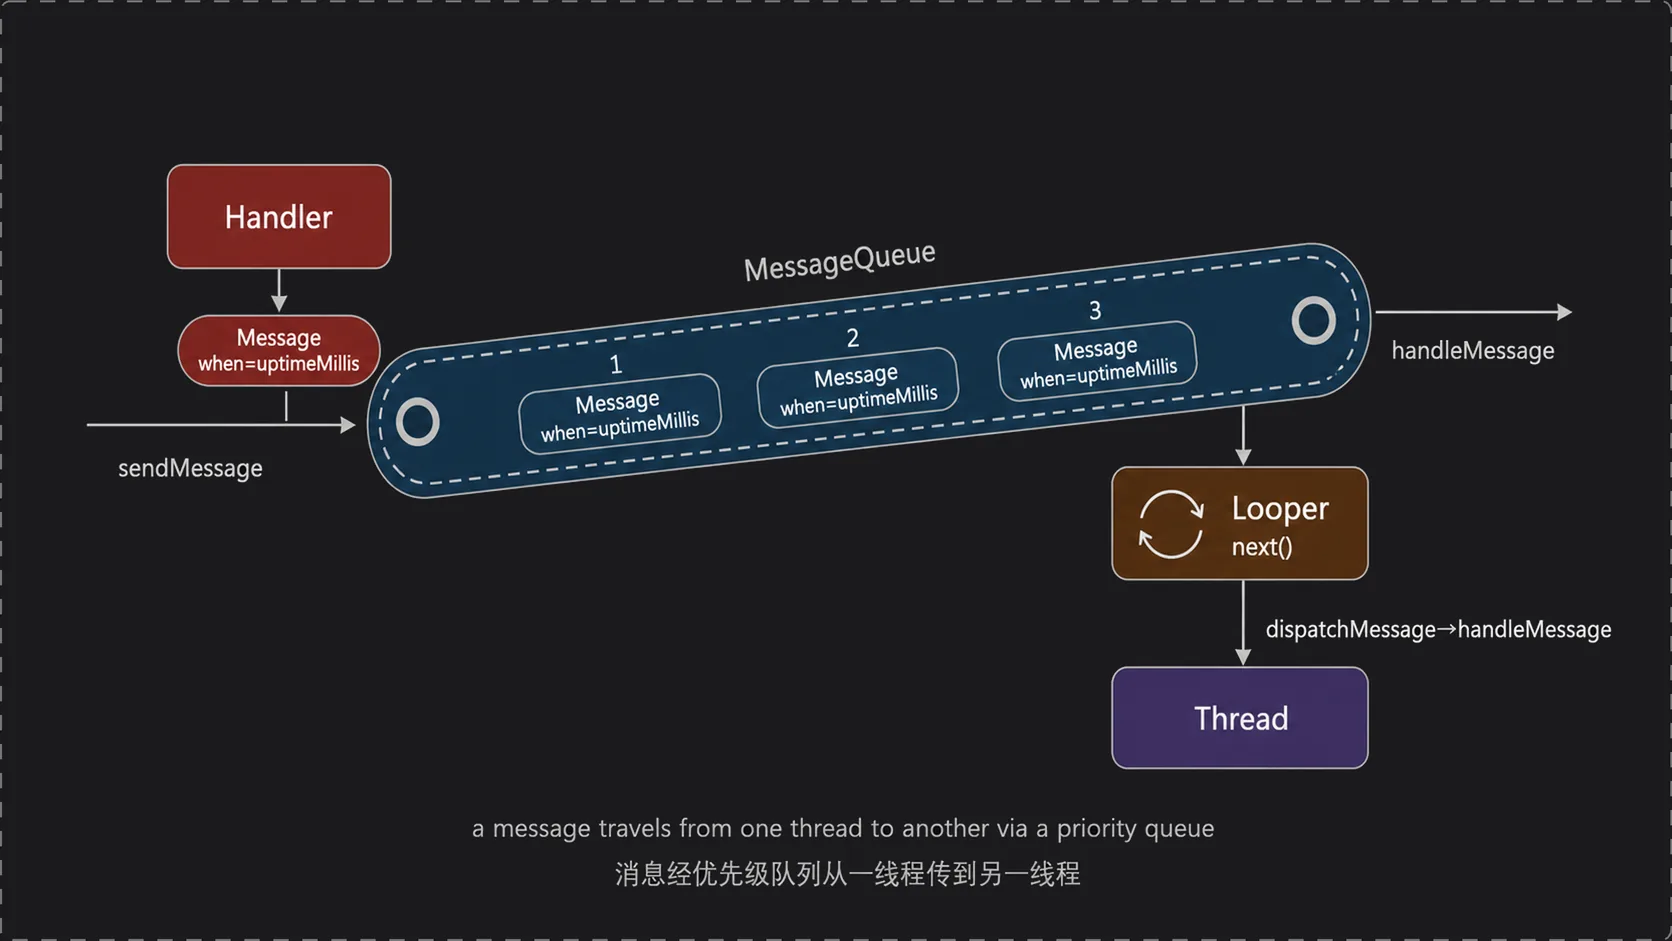
落到代码上,子线程发消息、主线程处理的最小写法是这样:
// 主线程:Looper 已由 ActivityThread.main() 准备好,直接绑定即可Handler handler = new Handler(Looper.getMainLooper()) { @Override public void handleMessage(Message msg) { // 这里已经回到主线程 textView.setText("got: " + msg.what); }}; // 任意子线程:handler.sendEmptyMessage(1); // 立即入队,when = nowhandler.sendEmptyMessageDelayed(2, 5000); // when = now + 5000handler.post(() -> textView.setText("ok")); // 包成 msg.callback 后走同一条链从 sendEmptyMessage(1) 这一行到 handleMessage 被调用,中间的完整调用链是:
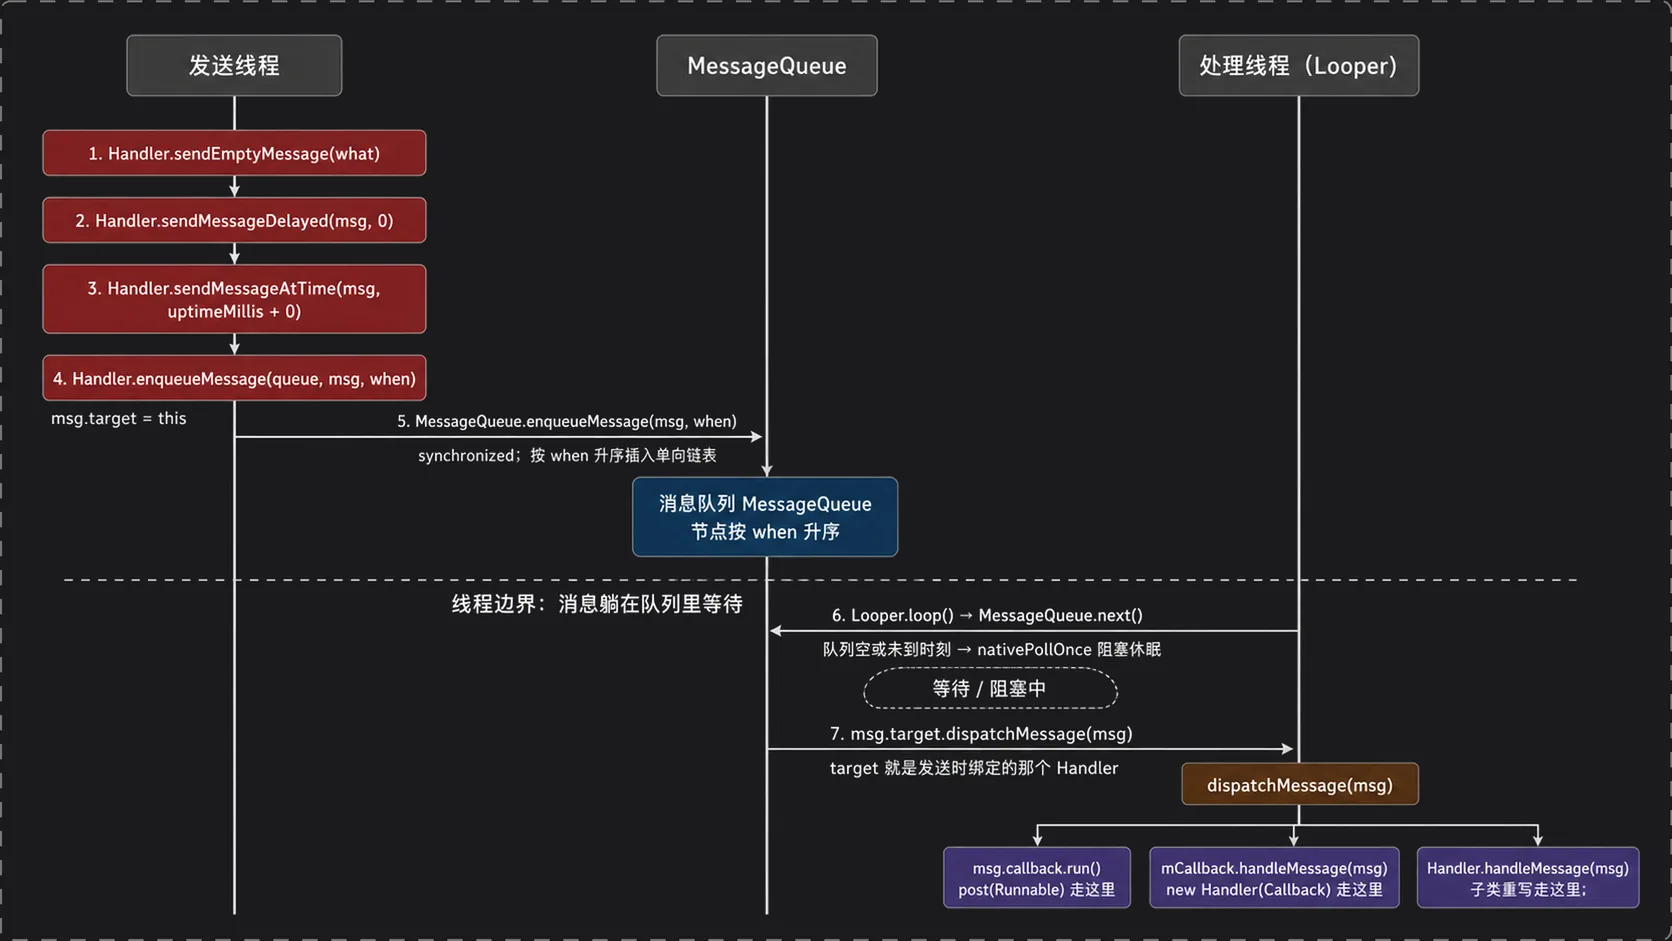
本文所有源码引用基于 AOSP 的 frameworks/base/core/java/android/os/ 下的 Handler.java、MessageQueue.java、Looper.java、Message.java。
一、全局概览:四个组件各管什么
1.1 简介
把 Handler 想成传送带:一端放东西,另一端有人取走处理。这个类比能解释「发送方和处理方在不同线程」这件事,但有两处会误导。
传送带按放上去的先后顺序送达,MessageQueue 按 when 排序,后发的消息完全可能排在先发的消息前面(比如 postDelayed(r, 5000) 之后紧接着 post(r2),r2 会插到 r 前面)。传送带空转时仍在耗电,Looper 在队列为空时会睡死在 epoll 上,CPU 占用是零。后面这条正是死循环不卡应用的答案。
1.2 组件边界
Thread 是宿主,一个线程最多绑一个 Looper。
Looper 通过 prepare() 配合 ThreadLocal<Looper> sThreadLocal 保证线程内唯一;loop() 是那个死循环,负责驱动整个消息泵。
MessageQueue 是消息的存放处,内部结构是单向链表 Message mMessages(队头),节点按 when 升序排列。对外只有两个动作:enqueueMessage(Message, long) 入队、next() 出队。
Handler 是使用者的门面,持有 mLooper 和 mQueue 两个引用。它的十几个 send/post 方法最终全部收敛到同一个私有出口,handleMessage 是留给使用者重写的回调。
Message 是载体,三个字段把它的去向定下来:target 指向发它的 Handler,决定消息最后回谁处理;when 是基于 SystemClock.uptimeMillis() 的执行时刻,决定它在队列里排第几;callback 是 post(Runnable) 传进来的那个 Runnable。
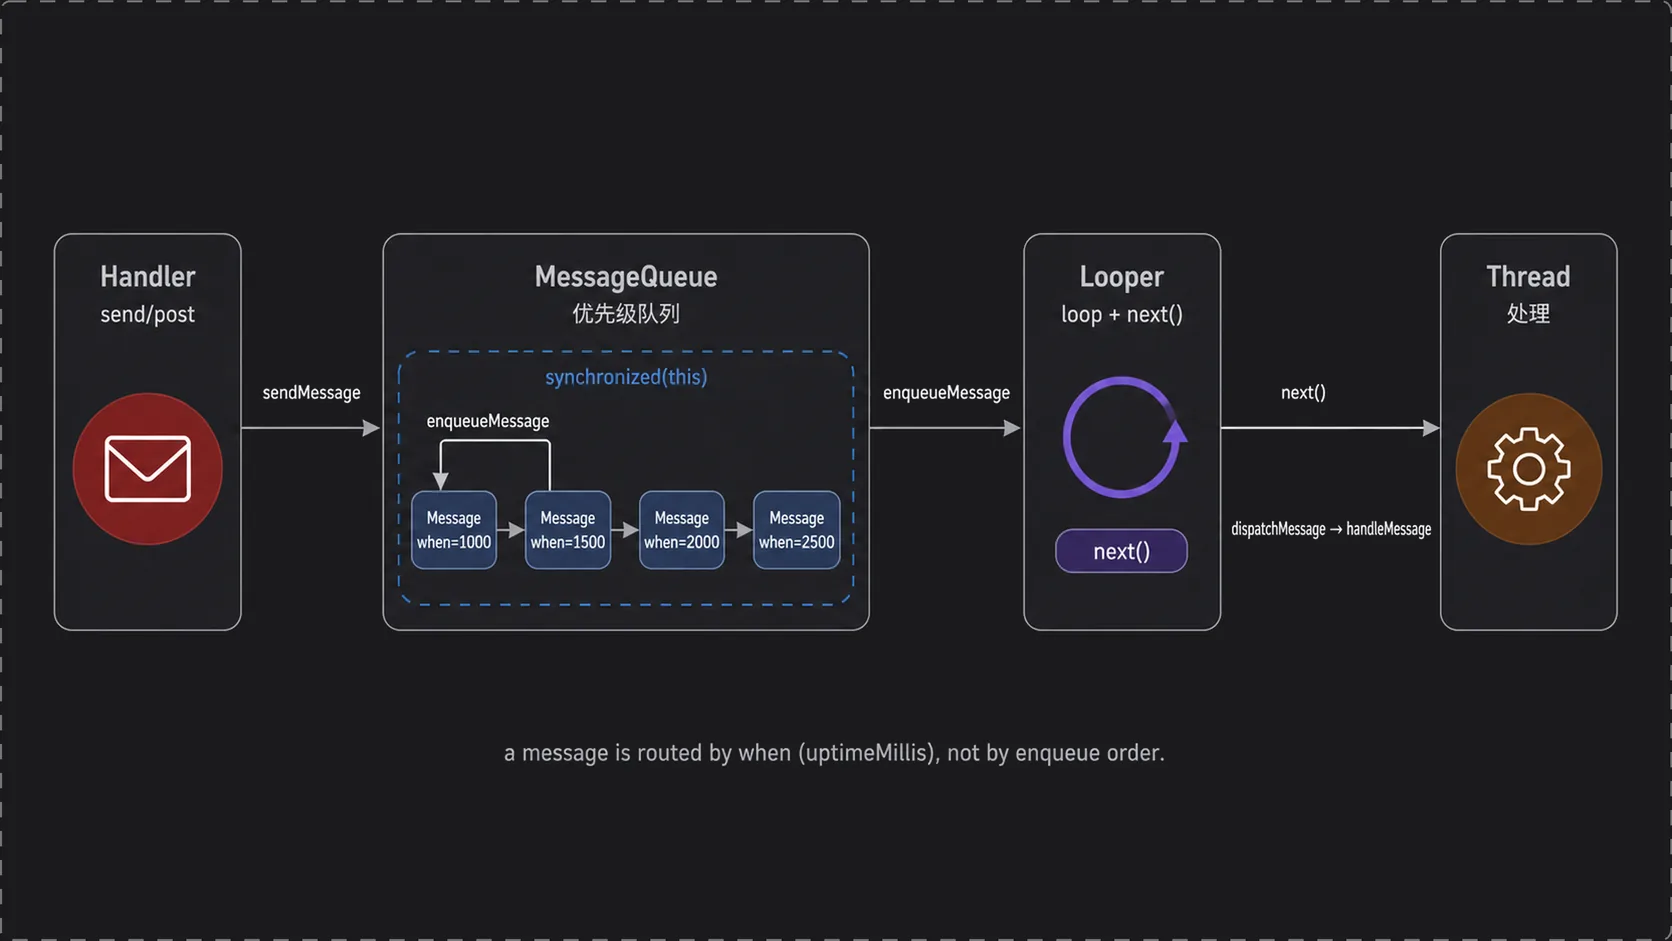
二、发送端:十几个入口,一个出口
2.1 收敛路径
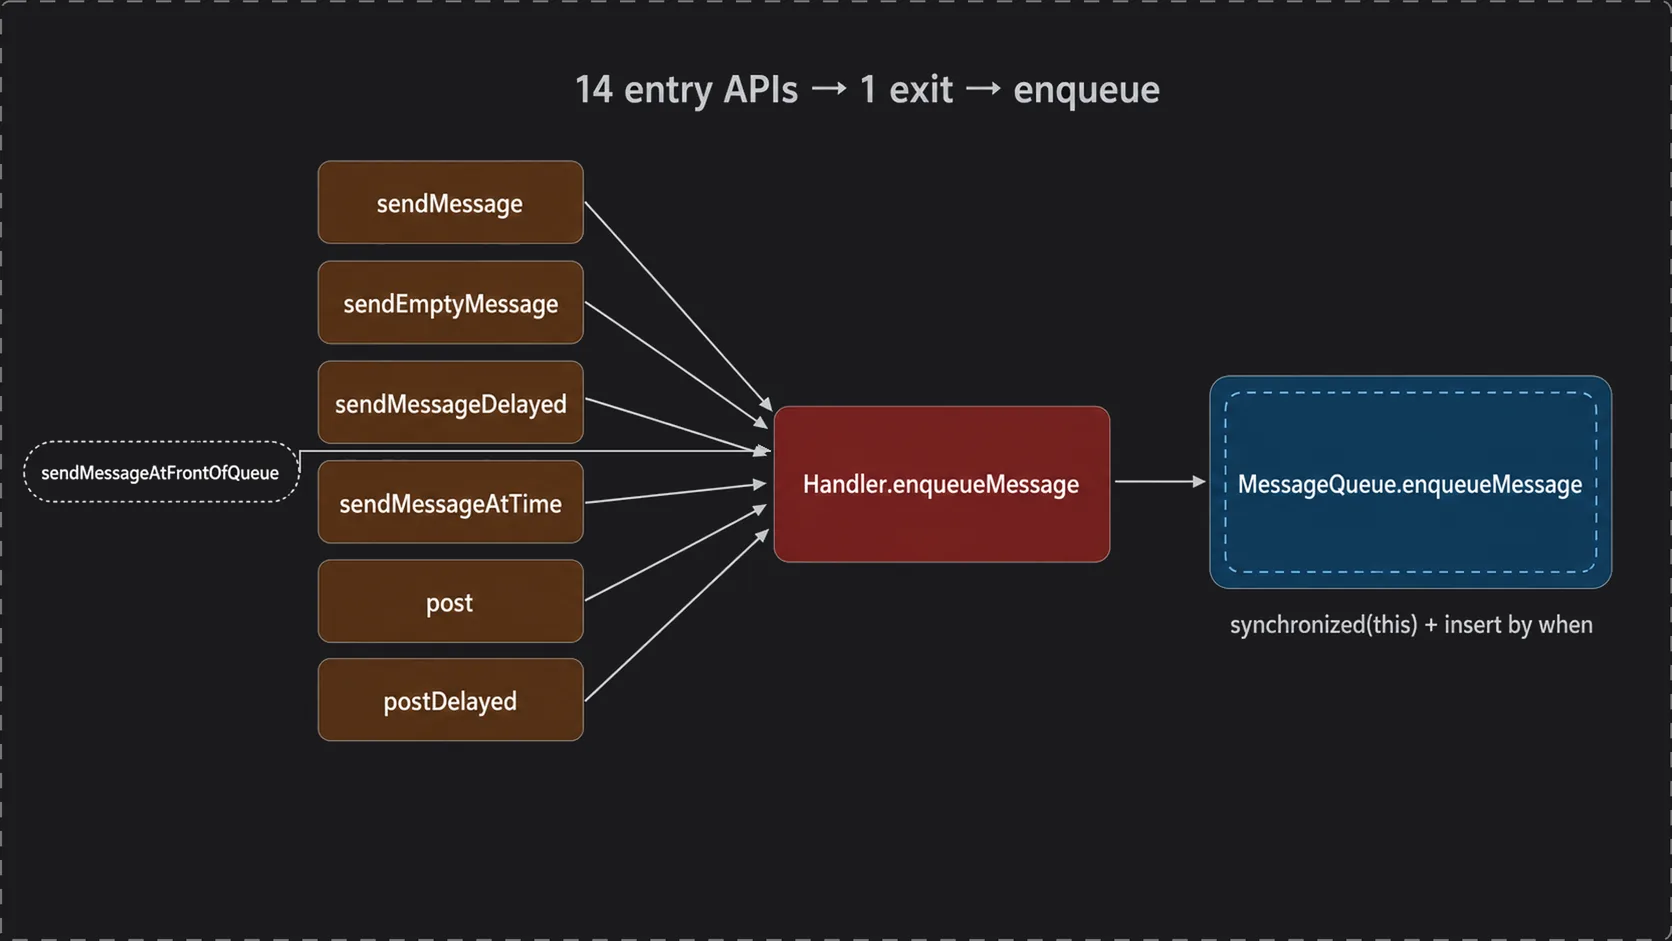
sendMessage(msg) 只做一件事:调 sendMessageDelayed(msg, 0)。后者把延迟换算成绝对时刻,调 sendMessageAtTime(msg, SystemClock.uptimeMillis() + delayMillis)。sendMessageAtTime 取出 mQueue,调 enqueueMessage(queue, msg, uptimeMillis)。
post(Runnable r) 的路径几乎一样,区别只在第一步:getPostMessage(r) 先把 Runnable 包成一个 msg.callback = r 的 Message,之后走同一条链。sendEmptyMessage(int what) 则是先 Message.obtain() 再 setWhat。
所以 Handler 对外暴露的 send* 与 post*(含 postAtTime、postAtFrontOfQueue、sendEmptyMessageAtTime、sendMessageAtFrontOfQueue 等重载)总数在十三到十四个之间,随 API 版本略有出入(postDelayed(Runnable, Object, long) 是 API 28 才加的)。它们无一例外,终点都是 Handler.enqueueMessage。在 AOSP 目录下跑这个命令可以自己数一遍:
grep -nE "public .*(send|post)[A-Za-z]*\(" frameworks/base/core/java/android/os/Handler.java只有 sendMessageAtFrontOfQueue 稍有不同:它直接传 when = 0,让消息插到队头,绕过时间排序。这个方法在框架内部有少量使用,业务代码里几乎也不用。
2.2 Handler.enqueueMessage 只做一件事
msg.target 是在这个方法里被赋值的,消息和 Handler 的绑定关系在此建立,而非在构造 Message 时。
// Handler.java —— 所有 send/post 的共同出口private boolean enqueueMessage(MessageQueue queue, Message msg, long uptimeMillis) { // target 在这里绑定:出队后 Looper 靠它找回处理者 msg.target = this; if (mAsynchronous) { msg.setAsynchronous(true); } return queue.enqueueMessage(msg, uptimeMillis);}输入是队列、消息和绝对时刻,输出是入队是否成功,状态变化只有一处:msg.target 被写成当前 Handler。有两个推论:消息回到哪个 Handler 在发送时就已确定,与出队时的上下文无关;一个线程可以有任意多个 Handler,它们共用同一条 mQueue,靠各自消息里的 target 区分归属。
三、MessageQueue 为什么是优先级队列
3.1 插入点怎么找
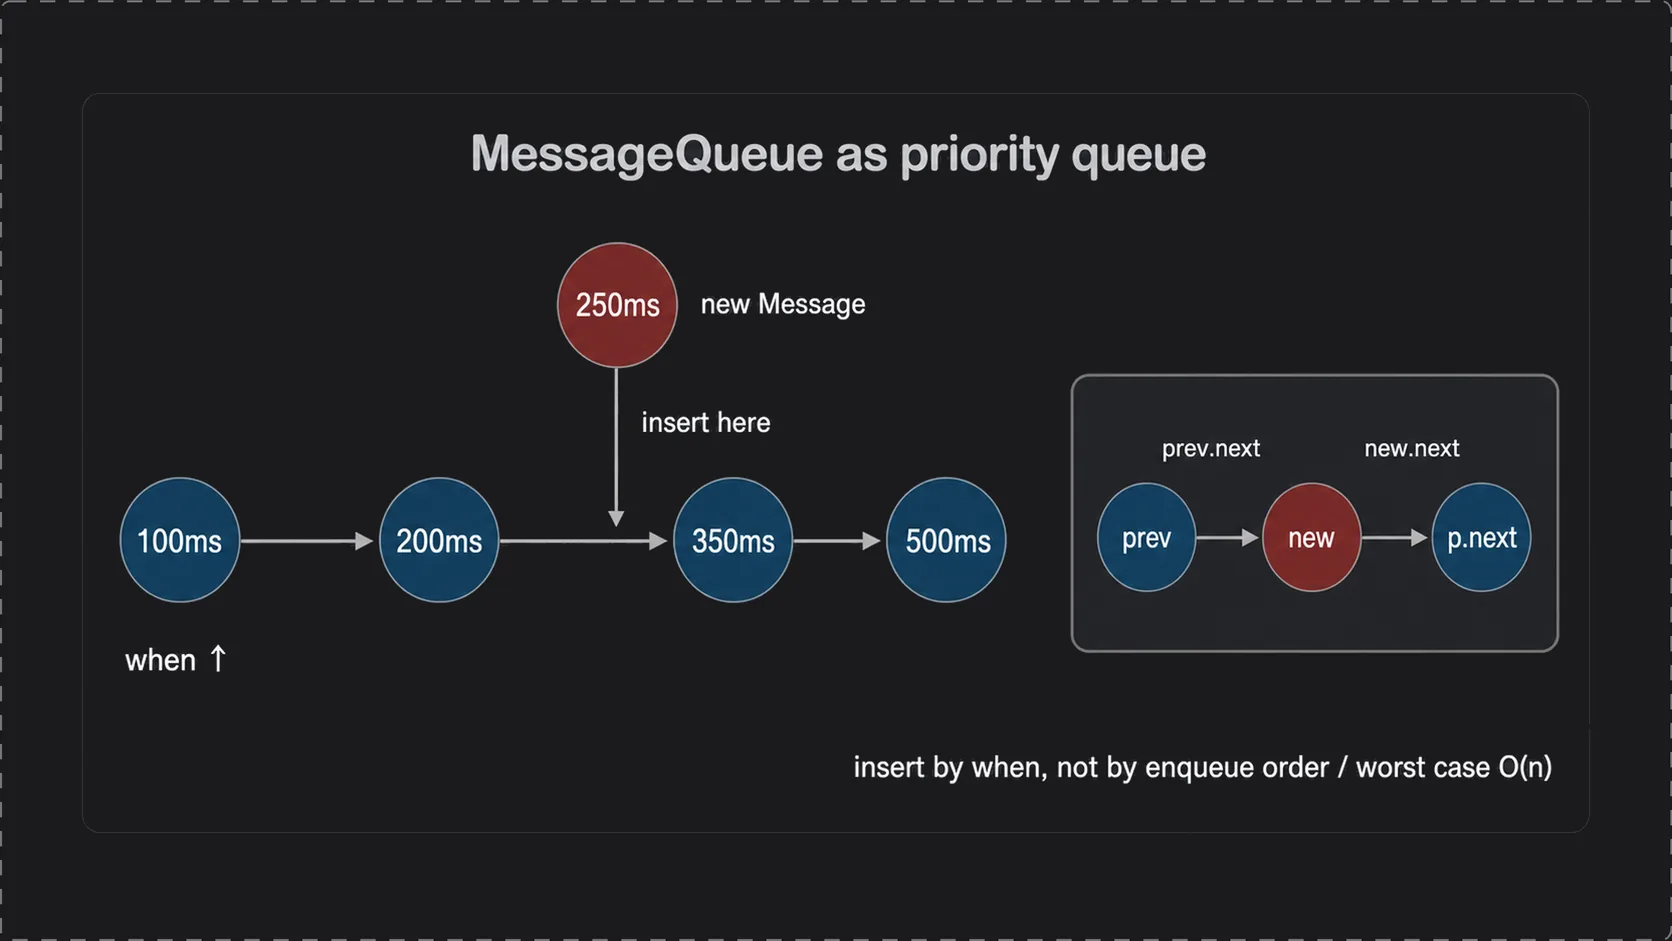
链表本身不会自动排序,顺序是插入时维护出来的。MessageQueue.enqueueMessage 的主体就是一次带比较的链表插入。
// MessageQueue.java —— 入队即排序,队列的"优先级"是在这里建立的boolean enqueueMessage(Message msg, long when) { // 没有 target 的消息是同步屏障,业务代码走到这里说明用错了 if (msg.target == null) { throw new IllegalStateException("Message must have a target."); } // 全程持锁:多个 Handler 可能来自不同线程 synchronized (this) { // 消息泵已退出,直接回收,不再接收新消息 if (mQuitting) { msg.recycle(); return false; } msg.when = when; Message p = mMessages; boolean needWake; // 队列为空,或新消息比队头还早:插到头部 if (p == null || when == 0 || when < p.when) { msg.next = p; mMessages = msg; needWake = mBlocked; } else { needWake = false; Message prev; // 向后遍历,遇到第一个 when 比自己晚的节点就停,插在它前面 for (;;) { prev = p; p = p.next; if (p == null || when < p.when) { break; } } msg.next = p; prev.next = msg; } // 插到队头时,唤醒可能正睡在 epoll 上的 Looper 重算超时 if (needWake) { nativeWake(mPtr); } } return true;}这个方法把 msg 按 when 插进链表:插到队头会改写 mMessages,插到中间改写 prev.next,成功返回 true;仅在消息泵已退出时才回收消息、返回 false。若插到队头且 mBlocked 为真,还会 nativeWake 叫醒 epoll 上睡着的 Looper。
这段插入能推出几点。队列的有序性来自插入时的线性查找,最坏复杂度 O(n)(队列里堆上千条延迟消息时,每次入队都要走一遍链表)。其次,when 是唯一的排序依据,跟调用 sendMessage 的先后无关。另外 p.when 与新消息 when 相等时循环继续往后走(when < p.when 才 break),所以同一时刻的消息按入队顺序排,相同 when 的消息之间是稳定的 FIFO。
3.2 锁保护的是什么
synchronized (this) 锁的是 MessageQueue 实例本身,next() 里用的是同一把锁。这是必要的:一个 UI 线程的 MessageQueue,可能同时被主线程的 Handler、若干工作线程的 Handler、以及 Looper 自己的 next() 访问。链表插入是多步操作(改 msg.next、改 prev.next 或 mMessages),中途被打断会直接断链。
所以「多个 Handler 跨线程往 MessageQueue 添加数据如何保证线程安全」这个问题的答案有两层:enqueueMessage 与 next() 共用一把对象锁做互斥,加上 nativeWake/nativePollOnce 这对唤醒—休眠原语协调阻塞状态。缺了后者,锁能保证正确性,但新插入的队头消息要等到旧的超时到期才被发现。
3.3 postDelayed 之后队列发生了什么
postDelayed(r, 3000) 展开后是:getPostMessage(r) 造出一条 callback = r 的消息 → when = uptimeMillis() + 3000 → 走上面那段插入逻辑。
队列的变化取决于这条消息落在哪里。如果它比现有队头还早(比如队列里全是 10 秒后才执行的消息),它成为新队头,mBlocked 为真则触发 nativeWake,正在 epoll 上等待的 Looper 被叫醒,重新计算下一次超时为 3000ms。如果它排在中间,链表插入完成,Looper 完全不需要被打扰(它现有的超时时间仍然指向更早的那条消息)。
顺带澄清一个常见误解:延迟消息不会占用任何定时器线程,也没有轮询。整个延迟机制就是「排序 + 一次 epoll 超时等待」。
四、Looper 死循环为什么不会卡死应用
4.1 next() 里的阻塞点
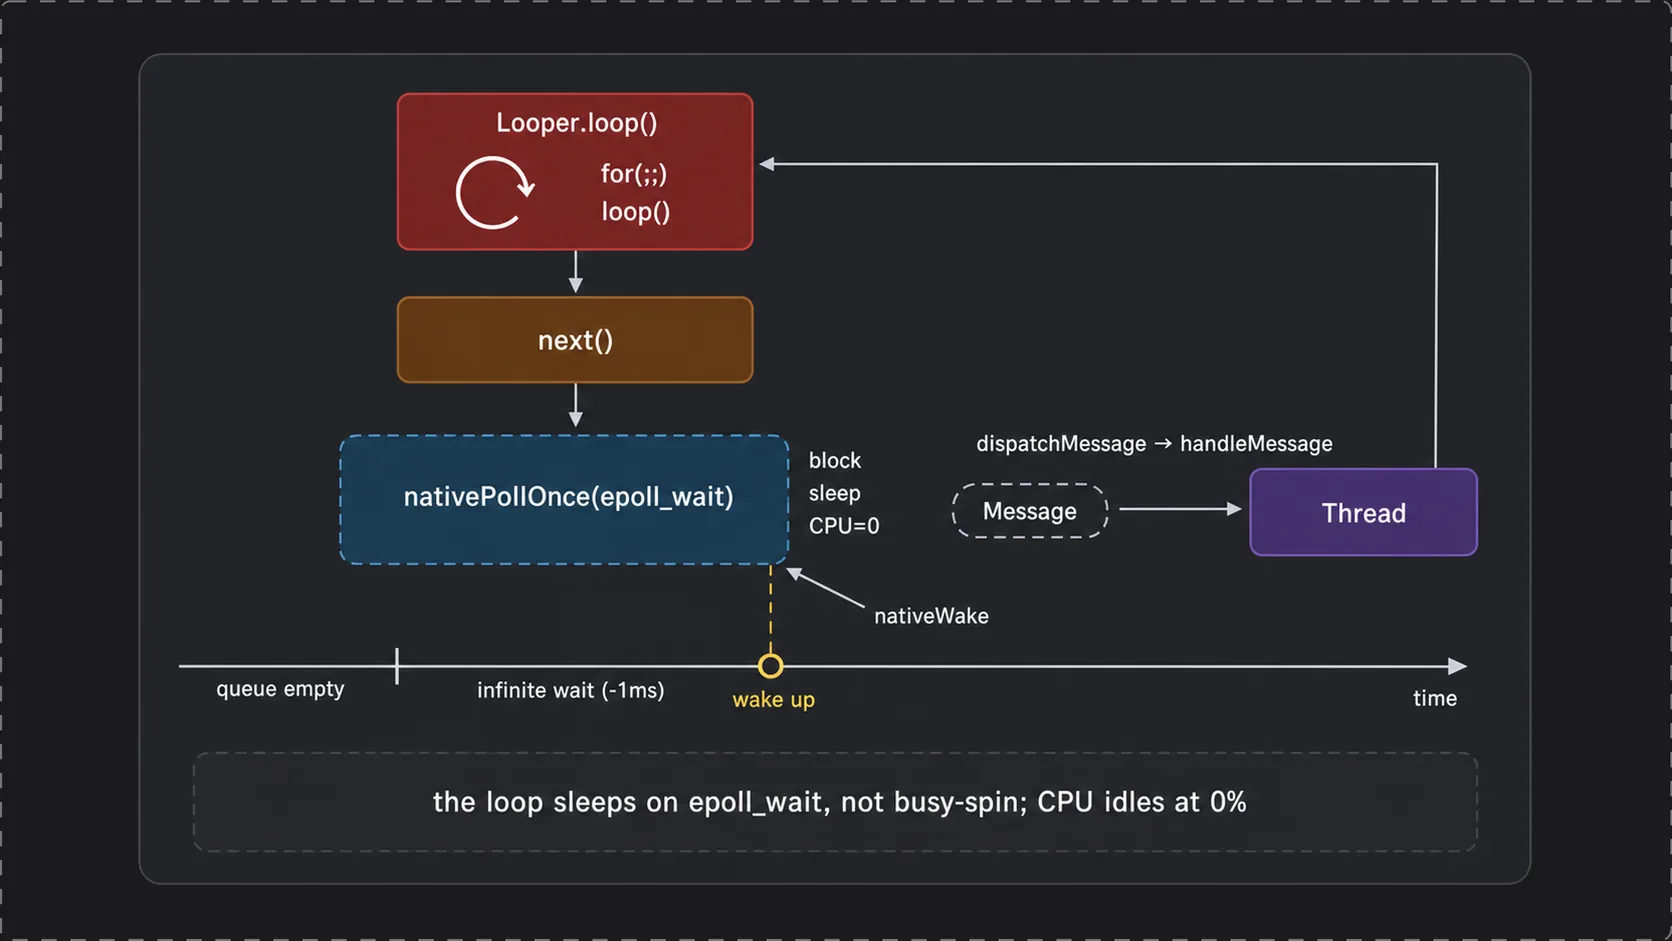
答案在 MessageQueue.next() 里,「死循环不耗 CPU」的阻塞触发点:
// MessageQueue.java —— 阻塞发生在这里,不在 Looper.loop()Message next() { int nextPollTimeoutMillis = 0; for (;;) { // native 层 epoll_wait:0 立即返回,-1 无限期睡,正数睡到超时 nativePollOnce(mPtr, nextPollTimeoutMillis); synchronized (this) { final long now = SystemClock.uptimeMillis(); Message msg = mMessages; if (msg != null) { if (now < msg.when) { // 队头还没到执行时刻,算出精确的剩余毫秒数继续睡 nextPollTimeoutMillis = (int) Math.min(msg.when - now, Integer.MAX_VALUE); } else { // 到点,摘下队头返回给 Looper mBlocked = false; mMessages = msg.next; msg.next = null; msg.markInUse(); return msg; } } else { // 队列空,无限期休眠,等 nativeWake 或 fd 事件 nextPollTimeoutMillis = -1; } mBlocked = true; } }}nativePollOnce 是 native 方法,实现在 frameworks/base/core/jni/android_os_MessageQueue.cpp,最终落到 Looper::pollOnce,用的是 Linux 的 epoll_wait。线程在 epoll_wait 上是真正的休眠状态,不参与 CPU 调度,不消耗时间片。
队列空时线程睡在 nativePollOnce(mPtr, -1) 上;延迟消息的精确触发靠 nextPollTimeoutMillis 算出 msg.when - now,把等待交给 epoll 的超时。至于为什么外面还要套一层 for (;;):nativePollOnce 可能因为 native 端的其他 fd 事件提前返回,此时队头仍未到期,需要重新计算超时再睡一次。
4.2 loop() 的主体
Looper.loop() 本身很薄,删掉日志和 Trace 之后只剩几行。
// Looper.java —— 死循环的全部内容public static void loop() { final Looper me = myLooper(); if (me == null) { throw new RuntimeException("No Looper; Looper.prepare() wasn't called on this thread."); } final MessageQueue queue = me.mQueue; for (;;) { // 队列空或未到点时阻塞在这里;返回 null 只发生在 quit() 之后 Message msg = queue.next(); if (msg == null) { return; } // target 是发送时绑定的 Handler,消息由此回到正确的处理者 msg.target.dispatchMessage(msg); // 清空所有字段后放回全局对象池 msg.recycleUnchecked(); }}for (;;) 里没有任何 sleep、没有轮询间隔、没有 CPU 让渡逻辑,这些都不需要,阻塞已经在 queue.next() 内部完成了。循环的唯一出口是 next() 返回 null,而这只在 quit() 把 mQuitting 置真之后发生。主线程的 Looper 由 ActivityThread.main() 启动,正常情况下不退出。
4.3 那 ANR 是怎么来的
死循环和 ANR 没有因果关系。ANR 的判定逻辑是:某类事件(输入事件 5 秒、前台 Service 20 秒、BroadcastReceiver 10 秒)在规定时间内没有被处理完。这些事件最终都是以消息的形式进入主线程 MessageQueue 的,超时的原因是某条消息的 handleMessage(或某个 Runnable)执行时间过长,把后面的消息全堵在队列里。
导致 ANR 的是循环体里某次 dispatchMessage 迟迟不返回,不是循环本身——循环停了应用直接退出,不会卡住。
界面刷新走的是另一条路:Choreographer 向 SurfaceFlinger 注册 VSYNC 信号,信号到来时通过 native 层的 fd 事件唤醒同一个 Looper,再以异步消息的形式执行 doFrame。这条路仍然复用了 Handler 机制,只是入口从 sendMessage 换成了 native fd 事件。
五、分发端:dispatchMessage 的三段优先级
消息出队后交给 msg.target.dispatchMessage(msg),这里决定了「重写 handleMessage」和「post 一个 Runnable」这两种写法为什么可以共存。
// Handler.java —— 分发的三级优先级,顺序固定public void dispatchMessage(Message msg) { // 第一级:post(Runnable) 塞进来的 callback,直接 run,不经过 handleMessage if (msg.callback != null) { handleCallback(msg); } else { // 第二级:构造 Handler 时传入的 Callback,返回 true 表示消息被消费掉 if (mCallback != null) { if (mCallback.handleMessage(msg)) { return; } } // 第三级:子类重写的 handleMessage handleMessage(msg); }}把三级同时装到一个 Handler 上,最能看清它们的抢占关系:
Handler.Callback callback = msg -> { Log.d(TAG, "第二级 Callback: what=" + msg.what); return msg.what == 1; // what==1 拦截;其余放行}; Handler h = new Handler(Looper.getMainLooper(), callback) { @Override public void handleMessage(Message msg) { Log.d(TAG, "第三级 handleMessage: what=" + msg.what); }}; h.sendEmptyMessage(1); // Ah.sendEmptyMessage(2); // Bh.post(() -> Log.d(TAG, "第一级 callback.run()")); // C输出:
第二级 Callback: what=1 ← A:Callback 返回 true,就此终止第二级 Callback: what=2 ← B:Callback 返回 false…第三级 handleMessage: what=2 ← …继续落到子类 handleMessage第一级 callback.run() ← C:msg.callback != null,两级 Callback 全部跳过三条消息各自停在不同的级别:A 被第二级吃掉,B 穿过第二级落到第三级,C 连第二级都没进(post 的 Runnable 存在 msg.callback 里,dispatchMessage 第一个 if 就分流走了)。所以同一个 Handler 上既传了 Callback、又重写了 handleMessage、还用 post 发任务时,这三套回调彼此不会互相触发。
所以三级之间是互斥的,先后顺序也固定。post 进来的消息永远不会触发 handleMessage;new Handler(callback) 传入的 Callback 返回 true 会拦截消息,返回 false 则继续往下走到子类的 handleMessage。这个 Callback 拦截机制是很多 Hook 方案(比如替换 ActivityThread.mH 的 Callback 来干预启动流程)的落地点。
六、一个线程一个 Looper:ThreadLocal 的强制约束
Looper.prepare() 只有五行,「一线程一 Looper」就靠这五行保证。
// Looper.java —— sThreadLocal 是 static 的,每个线程各存一份自己的 Looperprivate static void prepare(boolean quitAllowed) { // 二次调用直接抛异常,没有兜底、没有覆盖 if (sThreadLocal.get() != null) { throw new RuntimeException("Only one Looper may be created per thread"); } sThreadLocal.set(new Looper(quitAllowed));}sThreadLocal 是 static final ThreadLocal<Looper>,值存在每个 Thread 对象自己的 ThreadLocalMap 里,线程之间天然隔离。new Looper(quitAllowed) 的构造函数里会 mQueue = new MessageQueue(quitAllowed),Looper 和 MessageQueue 是一比一创建的。
主线程不需要手动 prepare,因为 ActivityThread.main() 里已经调了 Looper.prepareMainLooper()(内部是 prepare(false),主线程的 Looper 不允许 quit),随后 Looper.loop()。这也解释了为什么主线程可以直接 new Handler() 而子线程不行(Handler 的构造函数里有 mLooper = Looper.myLooper(),取到 null 就抛 "Can't create handler inside thread that has not called Looper.prepare()")。子线程要用 Handler,必须自己走一遍 Looper.prepare() → new Handler() → Looper.loop()。
所以数量关系是:一个线程一个 Looper、一条 MessageQueue,但可以有任意多个 Handler。Handler 只是队列的操作接口,它的构造函数不做任何计数或去重。
七、实践结论
**Handler 内存泄漏的成因:
- **非静态内部类 Handler 隐式持有外部 Activity 的引用。发出去的消息带着
target指向这个 Handler,只要消息还在 MessageQueue 里(延迟消息尤其明显),引用链就是MessageQueue → Message → Handler → Activity。而 MessageQueue 由主线程 Looper 持有,生命周期和进程一样长。Activity 已经finish但内存回收不掉,根因就在这条链上。两种断链方式:把 Handler 写成静态内部类并用WeakReference持有 Activity,或者在onDestroy里调removeCallbacksAndMessages(null)把队列里属于这个 Handler 的消息全部清掉。后者更彻底,因为它同时解决了「Activity 销毁后延迟消息仍然执行」的空指针问题。
**Message 的创建方式:
- ** 用
Message.obtain()或handler.obtainMessage(),不要new Message()。Message 内部维护一个静态链表对象池(sPool,上限MAX_POOL_SIZE = 50),obtain()从池头摘一个复用,池空时才 new。回收由Looper.loop()里的msg.recycleUnchecked()自动完成,它会清空所有字段再放回池里。高频消息场景下这一条能明显减少小对象分配和 GC 压力。handler.obtainMessage()比Message.obtain()更省一步,它顺手把target设成了当前 Handler。
**子线程 Looper 的用途:
- **一个自带 Looper 的子线程就是一条串行任务队列:外部通过 Handler 往里投任务,任务在该线程上按时间顺序逐个执行,空闲时线程休眠不占 CPU。
HandlerThread就是对这套模板的封装,IntentService内部用的正是它。相比每次起新线程,这种模式省掉了线程创建开销,也天然规避了任务之间的并发问题。
八、尝试
查看队列的实时状态,直接 dump:
// 打印当前 Looper 的 MessageQueue 里所有待处理消息,含 when 和 targetLooper.getMainLooper().dump(new LogPrinter(Log.DEBUG, "MQ"), "");输出里能看到每条消息的 what、when(相对当前时间的毫秒数)和 target 类名。连着 postDelayed 几条不同延迟的消息再 dump,可以直接观察到它们按 when 排序而非按发送顺序排列。
验证 Looper 休眠不占 CPU:应用静置时用 adb shell top -H -p <pid> 看主线程,CPU 占用应当是 0。如果不是,说明有消息在被反复投递(常见于某个 postDelayed 自己调自己的定时任务)。
排查主线程卡顿,入口是 Looper.setMessageLogging(Printer)。Looper 在 dispatchMessage 前后各打一次日志(">>>>> Dispatching to " 和 "<<<<< Finished to "),拦下这个 Printer 计算两次回调的时间差,就能定位到具体是哪个 Handler 的哪条消息执行超时。BlockCanary 这类工具的原理就是这个。
回到最初那个问题:一条消息从 sendMessage 到 handleMessage,中间经过绑定 target、按 when 排序入队、Looper 从 epoll 中被唤醒、next() 摘取队头、dispatchMessage 三级分发。MessageQueue 按 when 排序,所以是优先级队列而非 FIFO;阻塞发生在 epoll_wait 上,死循环不烧 CPU。
本文由 AgentPlanFlow 生成