
https://leetcode.cn/problems/increment-submatrices-by-one/description/
一、题目解析
1.1 题意
给定 n,初始有一个 n×n 的全零矩阵 mat。queries 中每个元素形如 [row1, col1, row2, col2],表示把以 (row1, col1) 为左上角、(row2, col2) 为右下角的子矩阵里的所有元素加 1。处理完全部 queries 后返回 mat。
坐标是闭区间,四条边界都算在子矩阵内。多个查询的效果互相叠加:某个格子被 k 个子矩阵覆盖,它的最终值就是 k。
1.2 暴力解法
暴力做法是对每个 query 开双层循环,把子矩阵里的格子逐个 +1。n 最大 500,queries 长度 m 最大 10^4,最坏情况下每个 query 覆盖整个矩阵,单次就是 25 万次写入,总量 25 亿,稳定超时。
这道题的形状是:大量区间修改,全部改完之后才需要读结果,修改过程中没有查询穿插。差分经典场景 —— 把每次 O(面积) 的修改摊成 O(1) 的标记,最后统一还原一次。
二、二维差分模板
一维差分:给 [l, r] 整段 +1,只需 diff[l] += 1、diff[r+1] -= 1,最后对 diff 求前缀和就得到原数组。
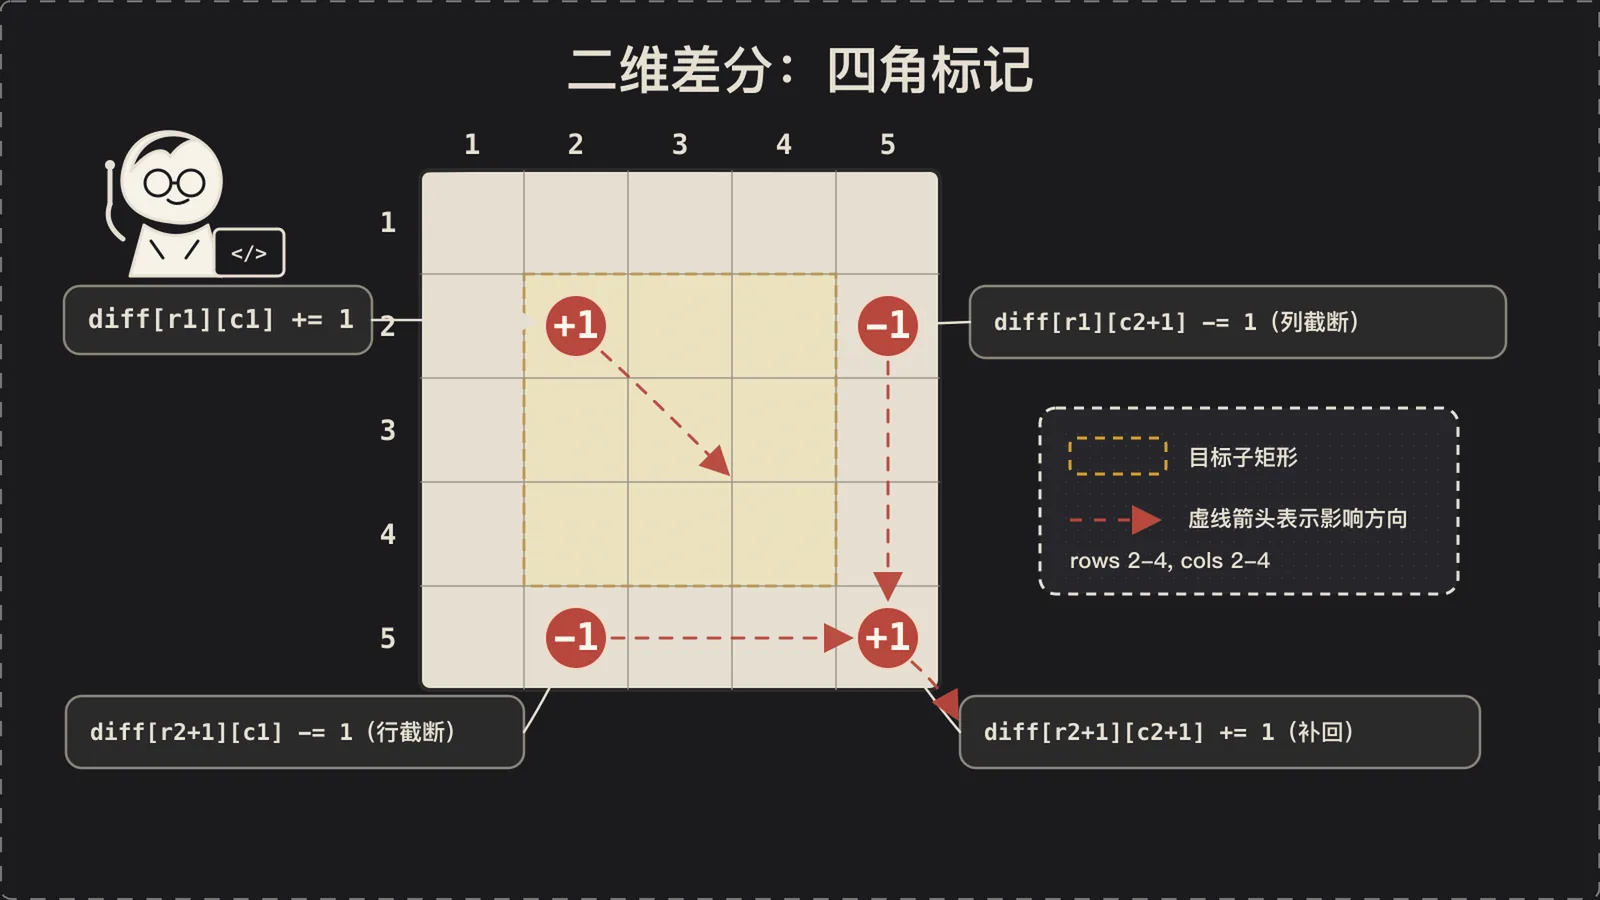
二维是同一套思路,区别在于"截断"要在行和列两个方向各做一次。给左上角 (r1, c1) 到右下角 (r2, c2) 的子矩阵 +1,需要打四个标记:
diff[r1][c1] += 1diff[r2+1][c1] -= 1diff[r1][c2+1] -= 1diff[r2+1][c2+1] += 1理解这四行的前提是:还原时用的是二维前缀和,所以在某个位置打一个 +1,它的影响会朝右下方无限扩散 —— 以该点为左上角、一直延伸到矩阵右下边界的整片区域都会 +1。后三行做的事情就是把这种过度扩散修掉。
diff[r1][c1] += 1:起点扩散。让 +1 从子矩阵左上角开始生效,覆盖它右下方的整片区域。diff[r2+1][c1] -= 1:行截断。第 r2+1 行往下不该被加,于是从那里再扩散一个 -1,抵消掉多出来的下方区域。diff[r1][c2+1] -= 1:列截断。同理抵消 c2+1 列往右多出来的部分。diff[r2+1][c2+1] += 1:补回。右下方那块区域同时落在前两个 -1 的扩散范围里,被扣了两次,补一个 +1 回来(容斥原理)。
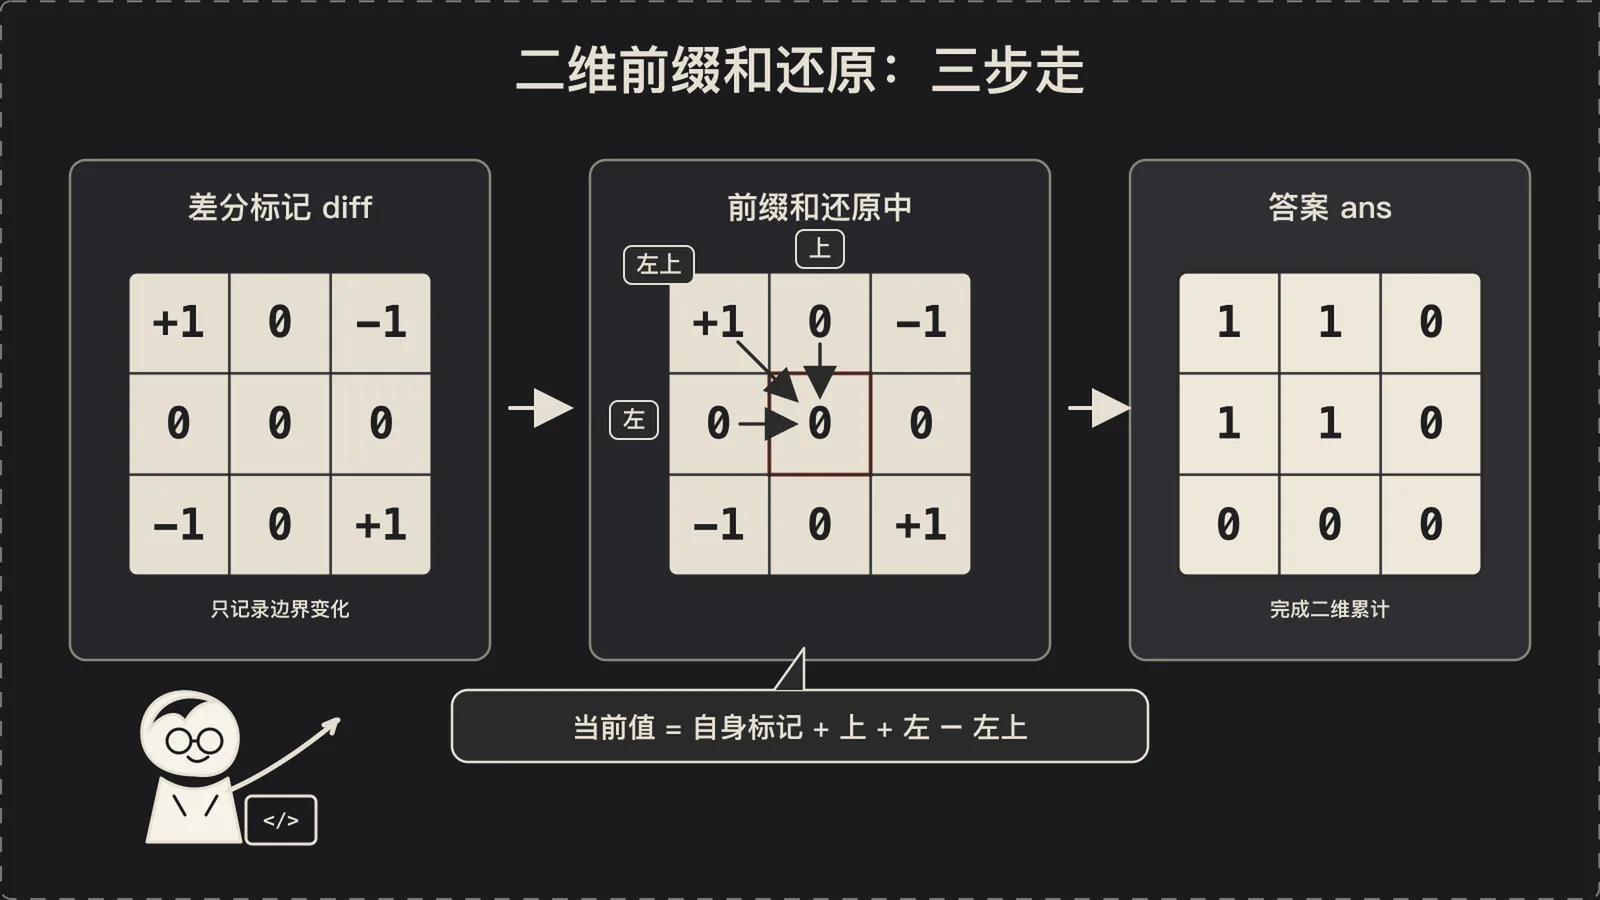
还原用二维前缀和进行还原:
diff[i+1][j+1] += diff[i+1][j] + diff[i][j+1] - diff[i][j]按行优先顺序遍历时,等号右边的三项都已经被算成了前缀和,而左边的 diff[i+1][j+1] 还是原始标记值。所以这行的含义是:当前格的真实值 = 自己的标记 + 左边一格的累计 + 上面一格的累计 − 左上角的累计。左和上各自都包含了左上那一块,重复了一次,减掉去重。
赋值完成后 diff[i+1][j+1] 就地变成前缀和。
三、代码详解
class Solution { public int[][] rangeAddQueries(int n, int[][] queries) { // diff 开 n+2,1-indexed,给右边界 +1 留余量 int[][] diff = new int[n + 2][n + 2]; int[][] ans = new int[n][n]; for (int i = 0; i < queries.length; i++) { // 转为 1-indexed,与 diff 数组对齐 int row1 = queries[i][0] + 1; int col1 = queries[i][1] + 1; int row2 = queries[i][2] + 1; int col2 = queries[i][3] + 1; // 二维差分四角标记 diff[row1][col1] += 1; diff[row2 + 1][col1] -= 1; diff[row1][col2 + 1] -= 1; diff[row2 + 1][col2 + 1] += 1; } // 二维前缀和还原,结果直接写入 ans for (int i = 0; i < n; i++) { for (int j = 0; j < n; j++) { diff[i + 1][j + 1] += diff[i + 1][j] + diff[i][j + 1] - diff[i][j]; ans[i][j] = diff[i + 1][j + 1]; } } return ans; }}diff 为什么开 n+2。两处越界风险叠加:
- 一是 1-indexed 之后行列下标最大到 n
- 二是标记要写
row2+1,当子矩阵贴着矩阵下边界时 row2 就是 n,row2+1等于 n+1。所以最大下标是 n+1,数组长度取 n+2。多出来的那一行一列是纯粹的哨兵,只吸收越界的 -1 和 +1 标记,还原阶段不会读进 ans。
1-indexed 转换。四个坐标统一 +1,把题目的 0-indexed 平移到 diff 的 1-indexed。这样做的收益在还原阶段:diff[i][j]、diff[i][j+1]、diff[i+1][j] 这些"上一行、左一列"的引用不需要判断 i、j 是否为 0,第 0 行和第 0 列天然是全零边界,公式对所有格子一致。
四角标记。每个 query 只写 4 个格子,O(1) 完成,与子矩阵面积无关。m 个 query 之间的标记直接在 diff 上累加,不用管它们是否重叠 —— 差分是线性的,多个子矩阵的标记叠在一起,还原出来就是叠加后的结果。
还原公式的三项加减。diff[i+1][j](左)覆盖的是当前格左侧那一竖条的累计,diff[i][j+1](上)覆盖的是上方那一横条的累计,两者的交集是 diff[i][j](左上)那一整块,被算了两遍,减一次。再加上当前格自己的差分标记,就是当前格的真实值。+= 而不是 =,就是因为左边此刻存的正是那个还没被消耗的标记。
ans 直接读 diff。还原是原位的,diff[i+1][j+1] 赋值完就已经是最终答案,同一层循环里直接拷进 ans[i][j],不用二次遍历。ans 单独开一份是因为返回值要求 n×n,而 diff 带着哨兵行列。
四、复杂度分析
时间 O(m + n²)。m 个 query 每个只做 4 次常数级标记,合计 O(m);还原阶段遍历 n×n 每格 O(1),合计 O(n²)。代入上界是 10^4 + 25 万,与暴力的 25 亿差了三个量级。
空间 O(n²)。diff 是 (n+2)×(n+2),ans 是 n×n,都是 O(n²)。ans 属于返回值本身,额外开销只有 diff 一份。
本文由 AgentPlanFlow 生成