Yinchen 的博客
首页
分类
归档
关于
首页
分类
归档
关于
登录
标签:稀疏化
清除筛选
Transformer 与 MoE:模型骨架上的稀疏化改造
2026/08/19
大模型
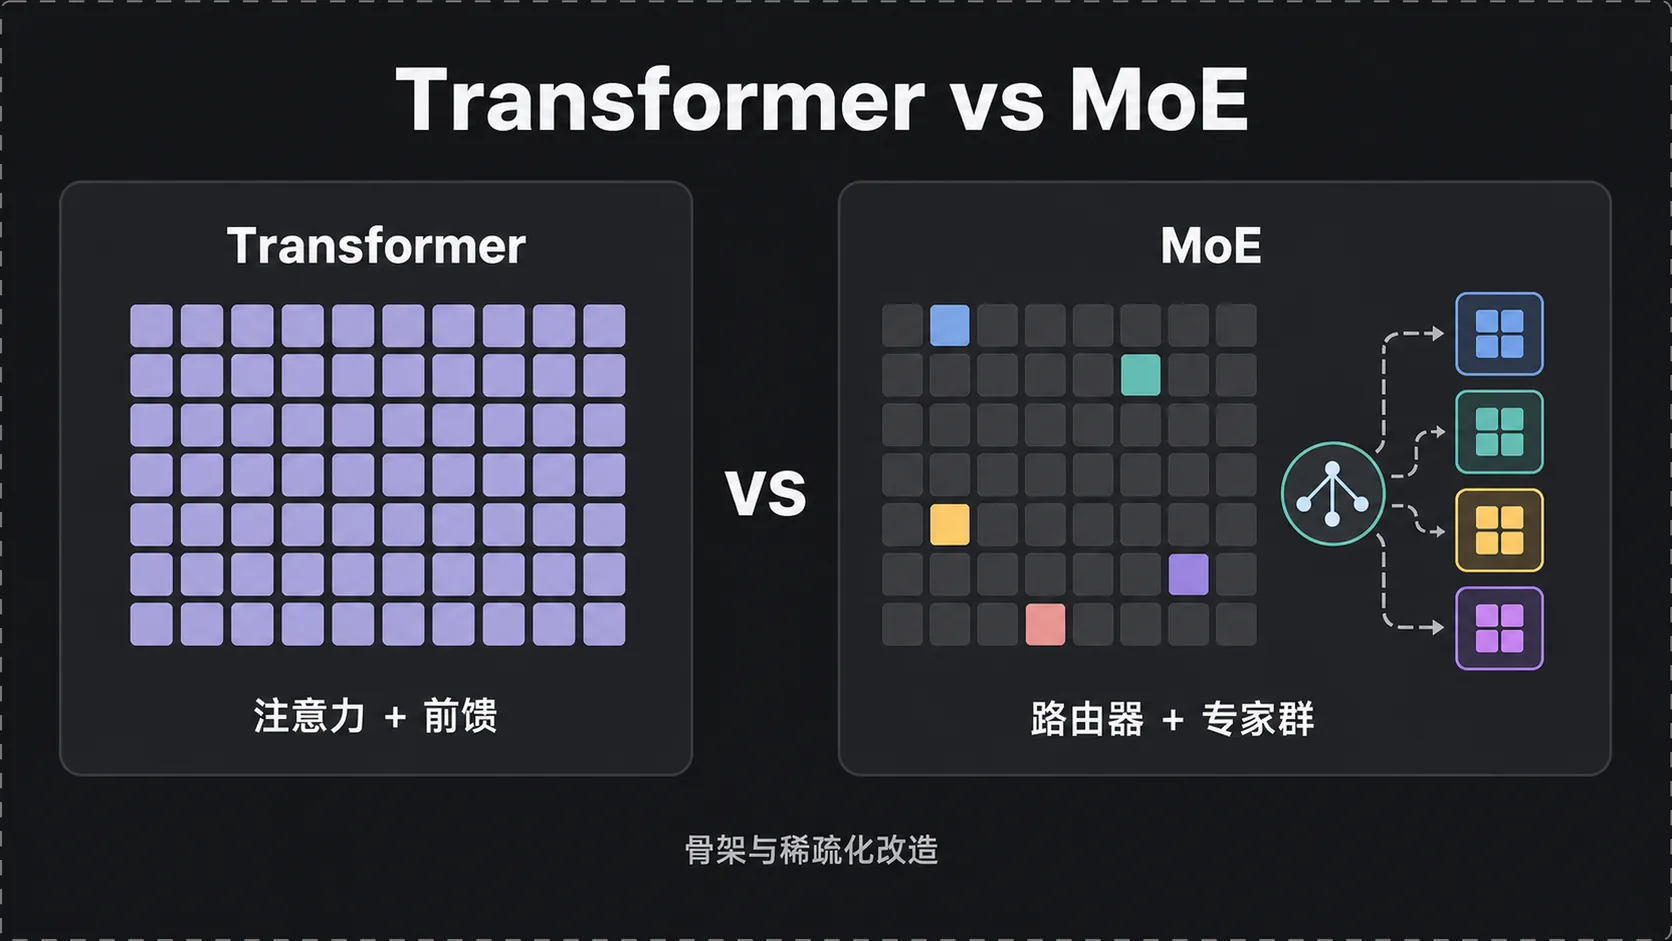
大模型发布会的话术这两年已经固定下来:总参数数万亿,MoE 架构加持,推理成本却比同级别模型低一大截。面试里也常出现同一道题,让人说清 Transformer 和 MoE 的区别,不少答案会把两者摆成并列的两种架构互相比较。 它们处在不同层级。Transformer 定义了「注意力 + 前馈」的主干结构,MoE 是在这条主干上针对前馈层做的一次去密集化改造,把单个庞大的前馈网络换成路由器加一组并行