
文章内容
大模型发布会的话术这两年已经固定下来:总参数数万亿,MoE 架构加持,推理成本却比同级别模型低一大截。面试里也常出现同一道题,让人说清 Transformer 和 MoE 的区别,不少答案会把两者摆成并列的两种架构互相比较。
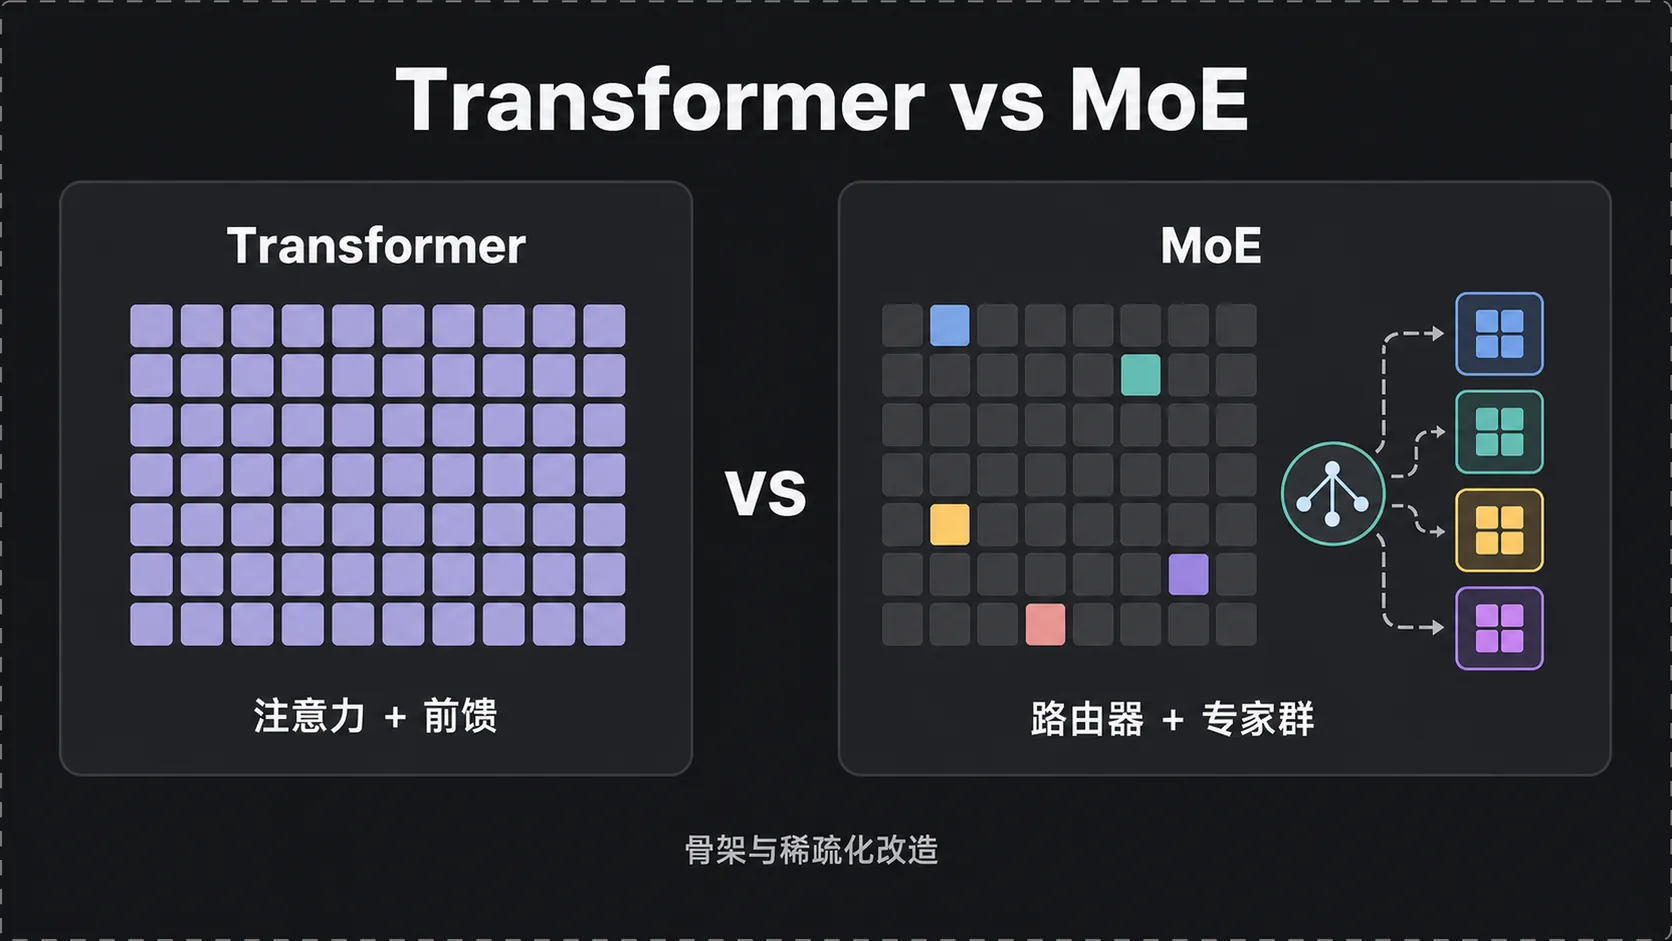
它们处在不同层级。Transformer 定义了「注意力 + 前馈」的主干结构,MoE 是在这条主干上针对前馈层做的一次去密集化改造,把单个庞大的前馈网络换成路由器加一组并行专家,用稀疏激活换掉一部分计算量。省下来的是计算,显存并没有省。
一、先认识 Transformer 的骨架
1.1 自注意力:同时看所有词
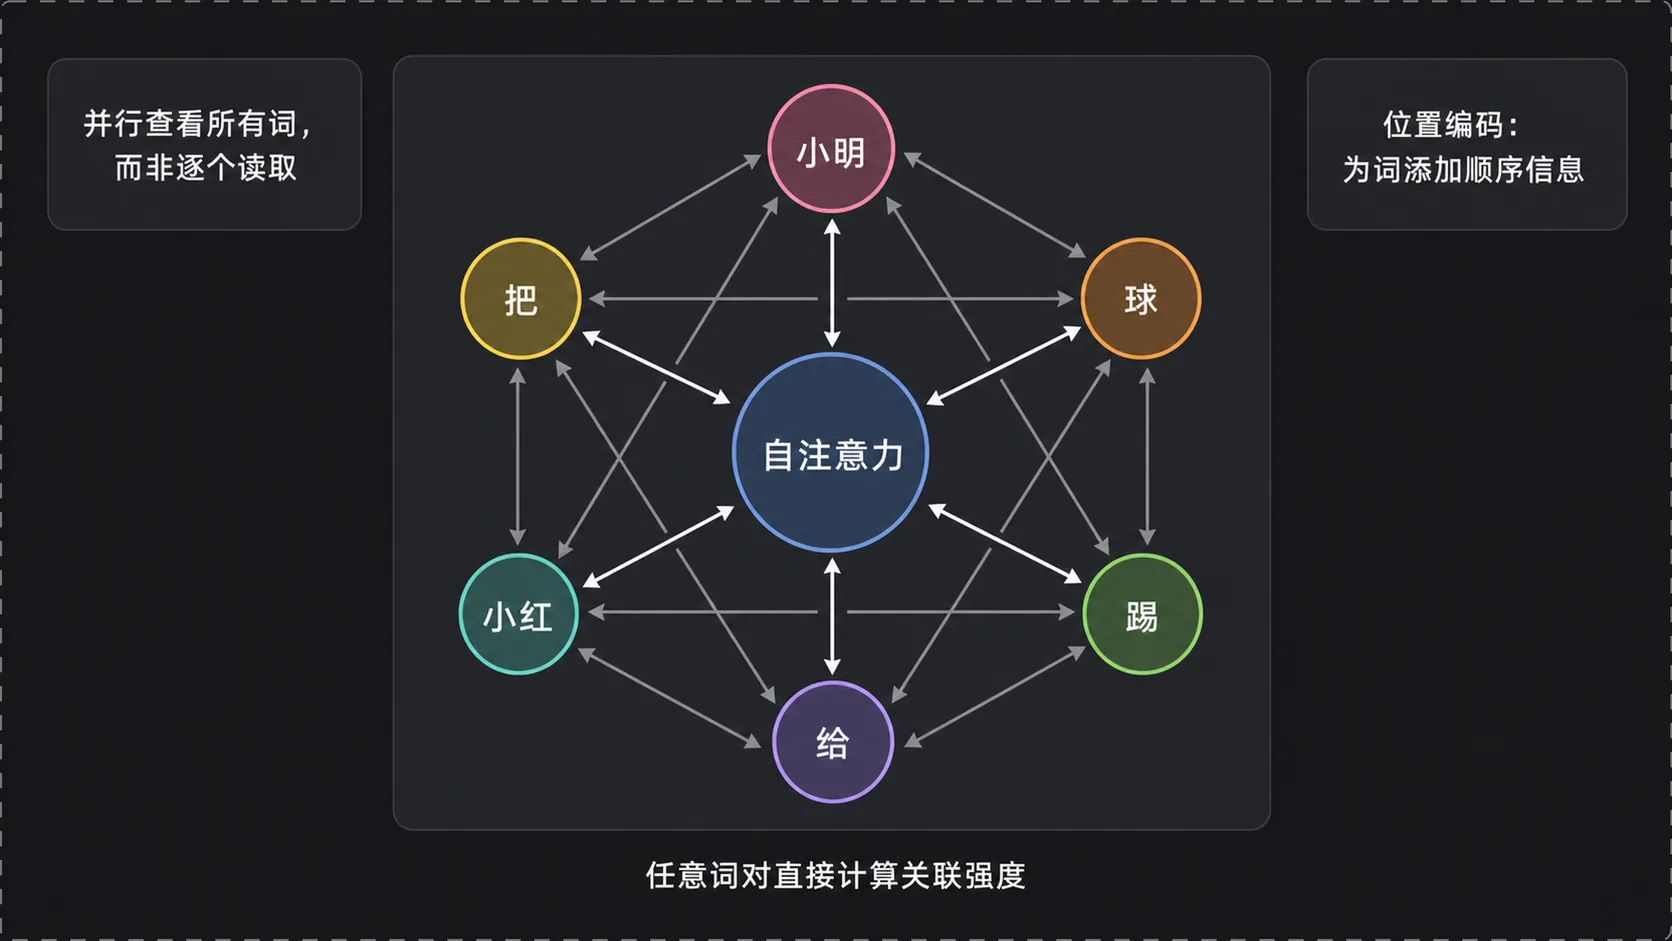
2017 年 Google 提出 Transformer,它带来的关键变化在自注意力机制:处理一句话时,模型能同时看到所有词,并计算任意两个词之间的关联强度。
拿「小明把球踢给小红」举例。模型在读到「踢」时,可以直接与「小明」「球」建立联系,权重高低反映谁是施动者、谁是受动对象。RNN 的做法则是按顺序一个词一个词往下读,前面的信息靠隐状态一路传递,距离一远,关联就被稀释掉了。自注意力把这种顺序依赖换成了全局的两两计算,句子内部无论隔多远,都有一条直接通路。
顺序信息由位置编码补上。注意力本身对词序不敏感,把位置信息加进词向量之后,模型才能区分「小明踢小红」和「小红踢小明」。注意力机制配合位置编码,构成了 Transformer 的基本盘。
全局的两两计算还带来一个工程上的好处:句子里所有位置的注意力可以一次算完,不必等前一个词的结果出来再算下一个,训练时的并行度比按时间步展开的结构高出一大截。
1.2 每层的两半:注意力 + 前馈网络
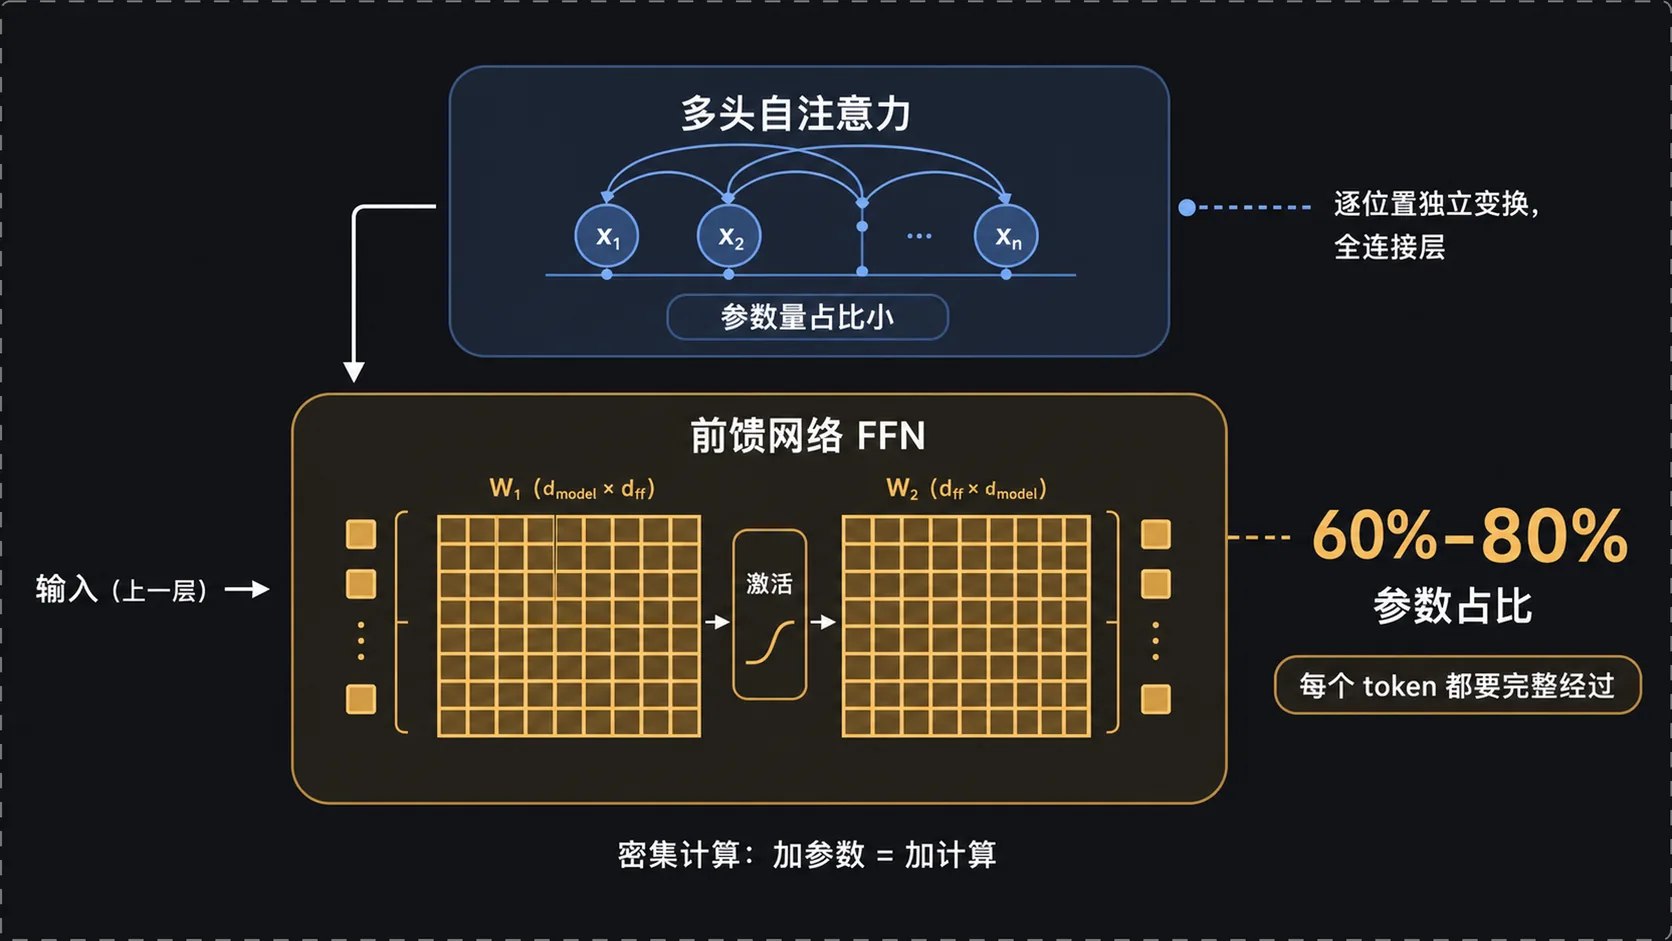
Transformer 的每一层都由两大部分组成,多头自注意力在前,前馈网络(FFN)在后。多头的作用是把注意力拆成若干组并行计算,每组关注不同的语义子空间,再把结果拼回去。
下面这段代码把单头自注意力的算法意图剥出来看(简化示意,省略多头拆分、掩码和 dropout):
import torchimport torch.nn.functional as F class SelfAttention(torch.nn.Module): def __init__(self, d_model): super().__init__() self.q_proj = torch.nn.Linear(d_model, d_model) # 投影成 Query,表达「我要找什么信息」 self.k_proj = torch.nn.Linear(d_model, d_model) # 投影成 Key,表达「我能提供什么信息」 self.v_proj = torch.nn.Linear(d_model, d_model) # 投影成 Value,携带实际要传递的内容 self.scale = d_model ** 0.5 # 缩放系数,避免点积过大让 softmax 饱和 def forward(self, x): # x 形状 [批量, 序列长度 L, 词向量维度] q = self.q_proj(x) # 每个词各自算出自己的查询向量 k = self.k_proj(x) # 每个词各自算出自己的键向量 v = self.v_proj(x) # 每个词各自算出自己的值向量 scores = q @ k.transpose(-2, -1) / self.scale # 两两点积,得到 [L, L] 的关联强度矩阵 weights = F.softmax(scores, dim=-1) # 按行归一化,得到每个词对全句的注意力分配 return weights @ v # 用权重对所有词的 Value 加权求和,输出融合全句信息的新表示scores 这个 [L, L] 的矩阵就是「任意两个词之间计算关联强度」的具体落点,句子里有多少个词,就有多少行多少列。
注意力算完,每个词向量会单独送进前馈网络。前馈网络是一组全连接层,对每个位置的词向量做独立变换,位置之间互不干扰,可以理解成注意力之后的加工层,负责把提取到的关联信息做进一步的特征变换和抽象。
两半的分工比较清楚:注意力解决「这个词该看谁」,前馈网络解决「看完之后这个词的表示该怎么改写」。信息在层与层之间交替经过这两道工序,堆叠得越深,抽象层次越高。
1.3 前馈网络是参数大户
结构上看,注意力负责建模序列内部的依赖关系,计算规模跟序列长度相关,参数占比反而不高。前馈网络的中间层通常被放得很宽,参数量极其庞大,在大模型里往往占到总参数的 60% 到 80%。
关键点在于,每个词进来都要完整经过这组庞大的矩阵运算。一层如此,几十上百层堆下来,前馈网络就成了整个模型里最重的部分。
二、密集计算的瓶颈
2.1 加参数 = 加计算
模型要提升能力,最直接的办法是加参数。前馈层加宽,模型能记住的模式更多,表达能力更强。
代价同时出现:每个 token 都得把所有参数算一遍。输入只有一个词,也要跑完整个网络的全部矩阵乘法,没有任何一部分参数可以跳过。这种模式叫密集计算,参数量涨多少,单 token 的计算量就跟着涨多少,训练和推理成本一起往上抬。
前馈层占了六到八成参数,这笔涨幅主要就压在它身上。扩容一版模型,训练要多烧的卡时、推理时每个 token 多出的延迟,大头都来自这组被无差别执行的矩阵运算。
2.2 能力想要,计算不想给
密集结构把参数量和计算量牢牢绑在一起。想要更强的能力,就得接受更高的单次推理开销;想控制推理成本,模型规模就上不去。算力预算摆在那里,两头无法兼得。
从利用效率看,这种全量执行也有可疑之处。同一层前馈网络要同时应付代码、诗歌、数学推导和日常对话,处理一个标点符号和处理一段公式推导,走的是完全相同的参数路径,投入的计算量也一模一样。
MoE 要处理的就是这个绑定关系。
三、MoE:让 token 走不同的路
3.1 混合专家的想法
MoE 全称 Mixture of Experts,混合专家。它的出发点很实际:既然每个 token 都过一遍完整的前馈网络存在浪费,能不能让不同的 token 走不同的路。
做法是把原来单一的前馈网络替换成一组并排的专家网络。每个专家自身仍然是一个前馈网络,结构比原来小得多。一层里可以并排放八个、几十个甚至上百个专家,总参数量随专家数量线性增长,而每个 token 实际走过的专家数量保持不变。
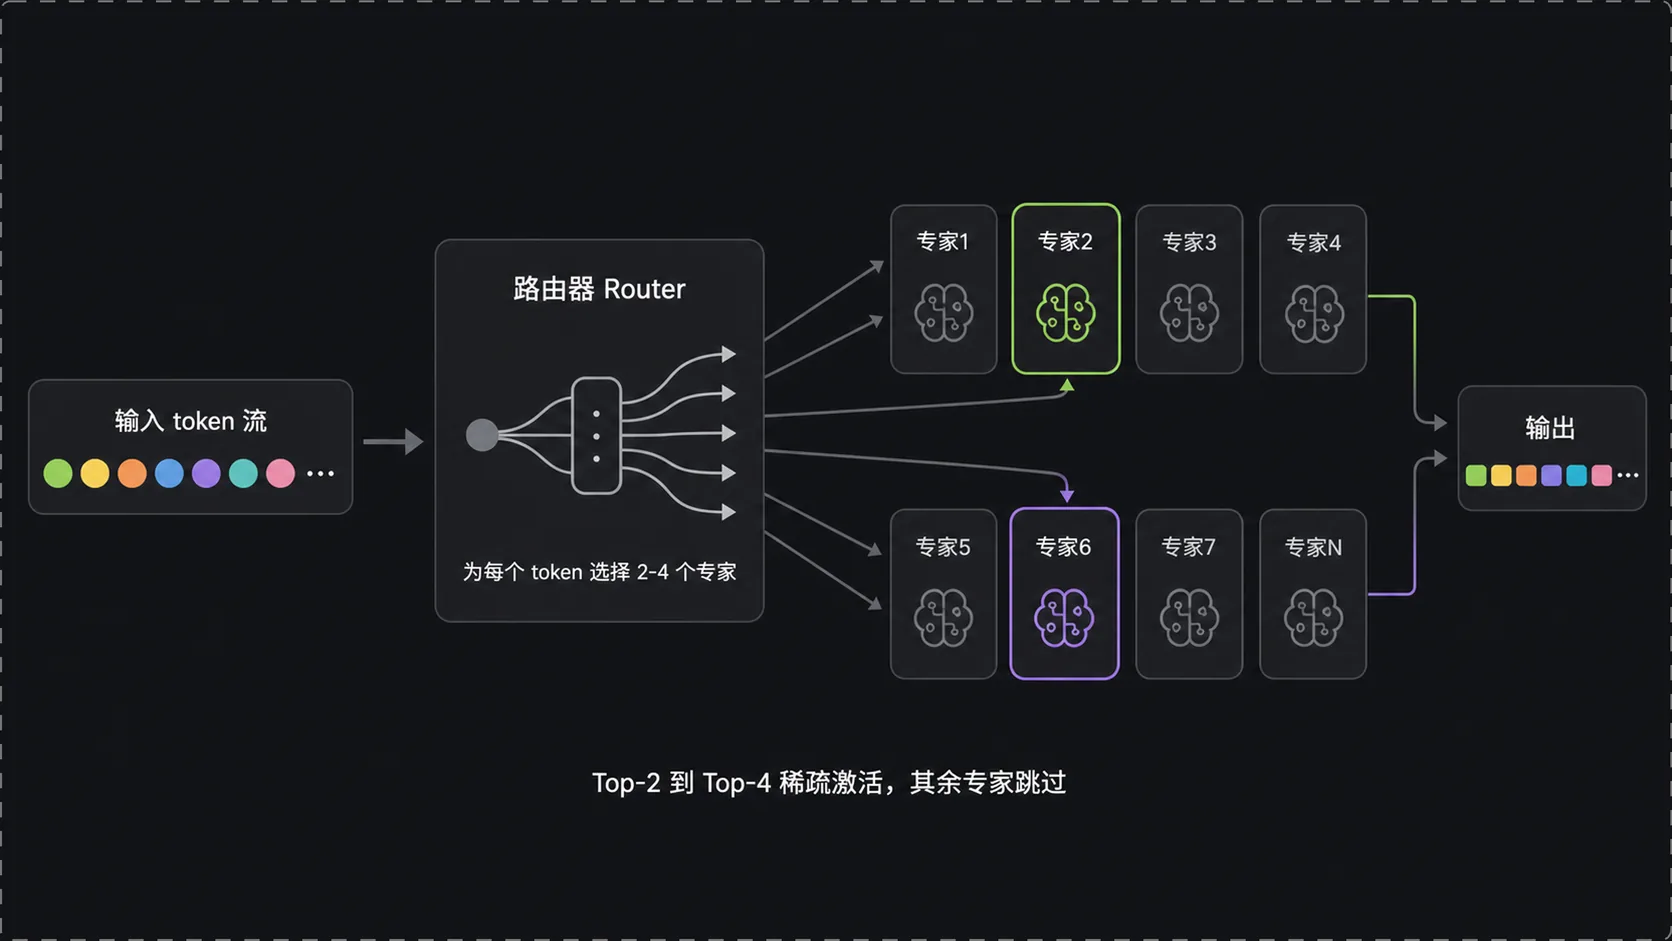
这组专家前面加一个路由器(Router),对进来的每个 token 做一次快速判断,决定把它交给哪些专家处理。原本一个 token 要经过一个大网络的全量计算,现在只需要经过几个小网络的局部计算。
3.2 路由器:Top-2 到 Top-4 的选择
路由器的实现比想象中轻。它通常就是一个线性层,把词向量映射成对每个专家的打分,softmax 归一化之后取分数最高的 k 个,常见做法是筛选排名靠前的 2 到 4 个专家,其余专家的门控值直接置零。
class TopKRouter(torch.nn.Module): def __init__(self, d_model, num_experts, k=2): super().__init__() self.gate = torch.nn.Linear(d_model, num_experts) # 门控层:把词向量映射成对每个专家的打分 self.k = k # 每个 token 实际激活的专家数,常见 2 到 4 def forward(self, x): # x 形状 [token 数 T, 词向量维度] logits = self.gate(x) # 每个 token 对全部专家的原始打分 [T, E] probs = torch.softmax(logits, dim=-1) # 归一化成概率,表示各专家的适配程度 topk_val, topk_idx = probs.topk(self.k, dim=-1) # 取分数最高的 k 个专家及其权重 gates = torch.zeros_like(probs) # 先建一个与专家数等长的全零门控向量 gates.scatter_(1, topk_idx, topk_val) # 只在被选中的位置写回权重,其余保持 0 gates = gates / gates.sum(dim=-1, keepdim=True) # 对选中权重重新归一化,保证加权和为 1 return gates, topk_idx # 门控为 0 的专家在后续计算中整体跳过,稀疏激活由此产生后续的专家计算只沿着 topk_idx 指向的那几个专家走,门控值充当加权系数,把这几个专家的输出合成为该 token 的最终结果。100 个专家里跳过 98 个,节省下来的就是这 98 个专家的矩阵乘法。
3.3 稀疏激活与全量存储
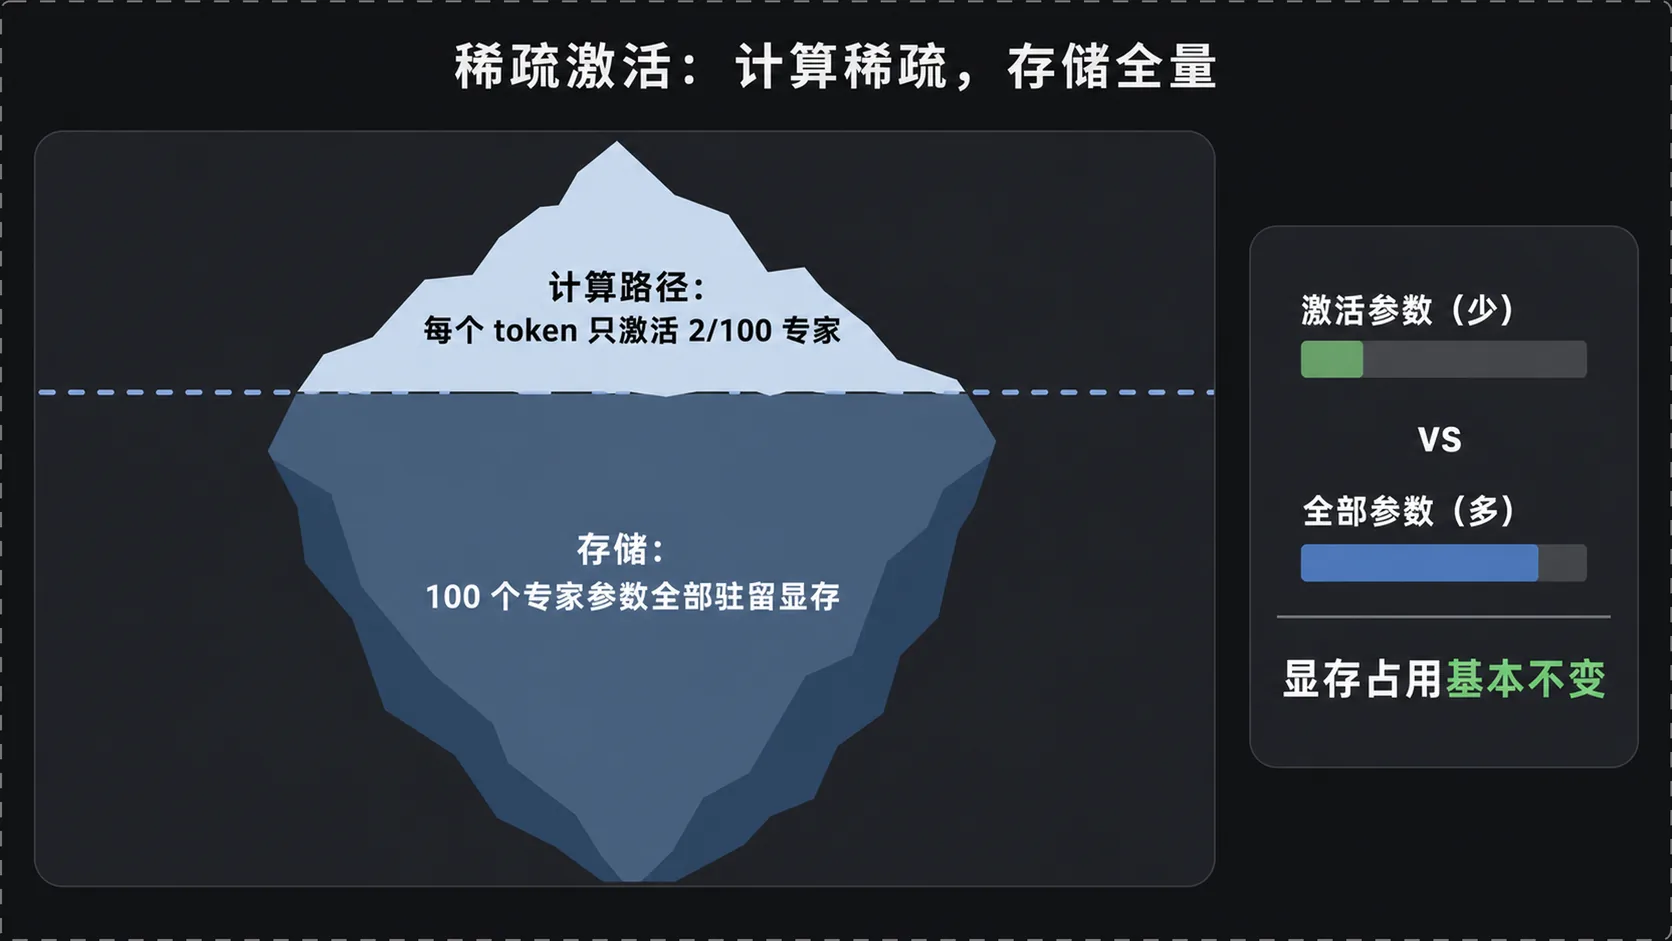
稀疏激活这个词最容易被读歪。它描述的是计算路径:每个 token 只激活少数几个专家,其他专家在这一步完全不动手。
存储层面的情况不同。所有专家的参数都得留在显存里,路由器随时可能把下一个 token 分给任何一个专家,谁都不能卸载。模型有 100 个专家、每个 token 只激活 2 个,单个 token 的计算量只有原来的百分之几,可是这 100 个专家的参数一份不少地占着显存。
批量推理时这一点更明显。一个批次里的 token 来自不同上下文,路由结果各不相同,几十个 token 分散下去,几乎会把整层专家覆盖一遍,激活比例在单 token 视角下很低,在批次视角下并不低。
省的是计算,显存没省。
3.4 省计算不省显存,为什么还火
价值在于它打破了参数量和计算量的绑定。同样的算力预算下,MoE 可以把总参数量做得更大来提升模型能力,同时把单次推理的计算量控制在可接受范围内。花差不多的计算代价,养一个大得多的知识储备库。
对于推理服务来说,延迟和吞吐主要由计算量决定,显存则可以靠堆卡解决。这笔账在工程上是算得过来的,MoE 也因此从论文里的技巧变成了主流大模型的标配。
四、MoE 的三个代价
4.1 训练不稳定
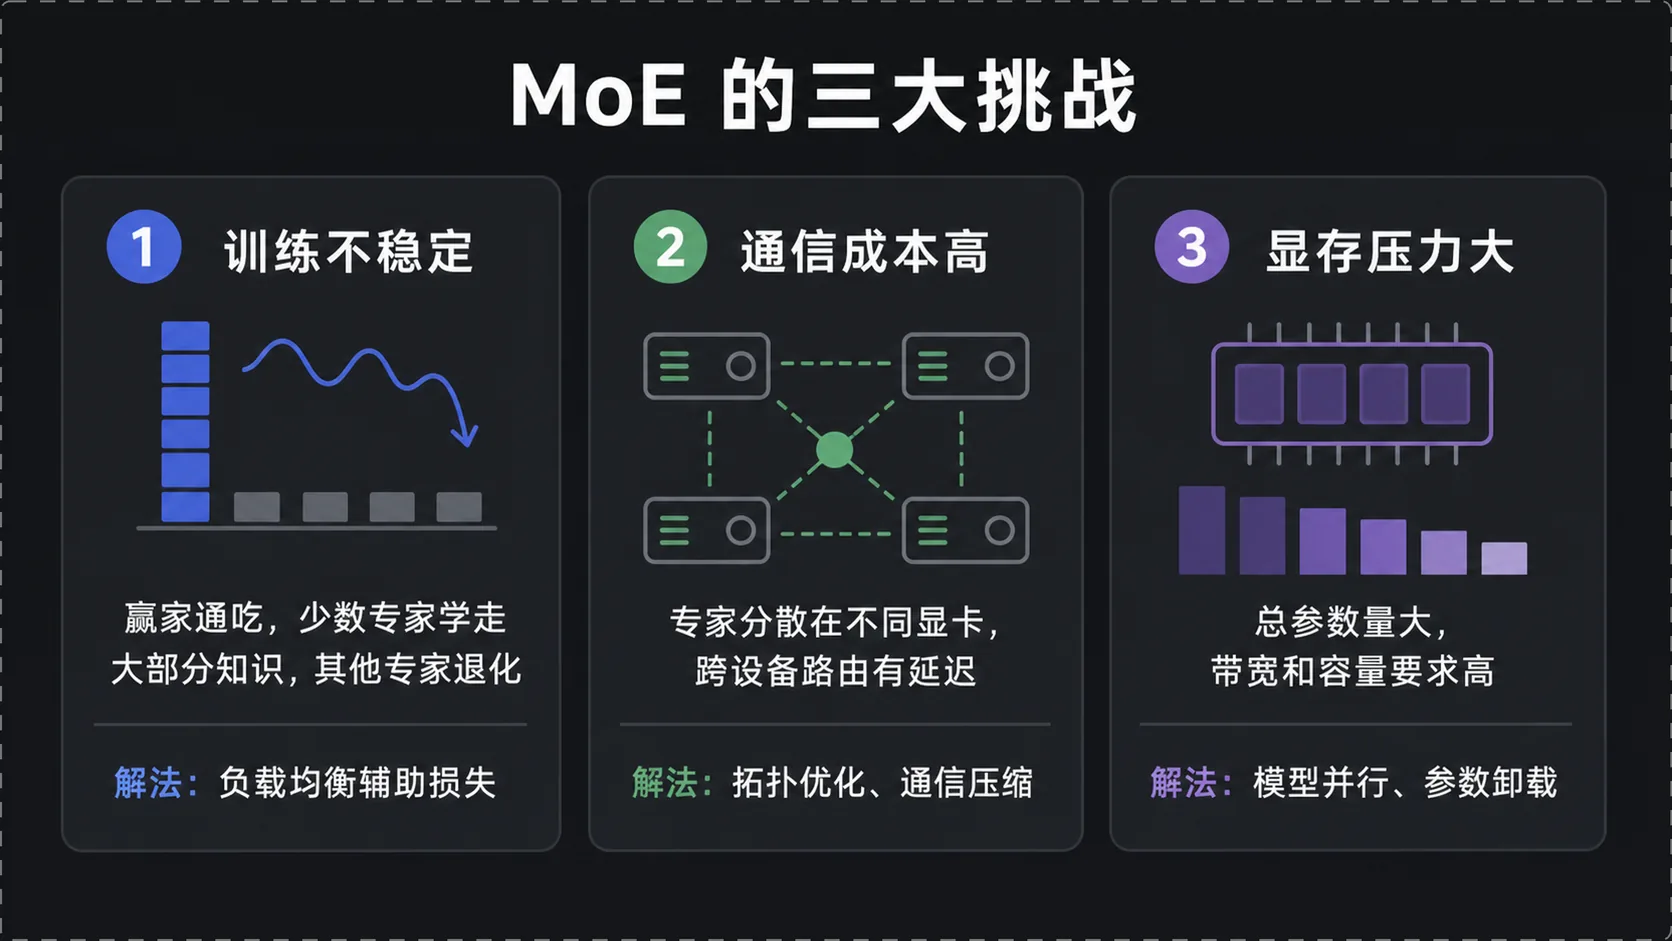
路由器一开始是乱分任务的,它的参数和专家参数一起从随机初始化开始学。训练早期容易出现赢家通吃:少数几个专家因为随机的初始优势拿到更多 token,学得更快,分数更高,于是拿到更多 token。其他专家分到的任务越来越稀疏,参数长期得不到充分更新,能力逐渐退化,模型的有效容量远小于账面参数量。
常规解法是在损失函数里加一项负载均衡的辅助损失,对分配过于集中的路由结果施加惩罚,强制 token 在专家之间分布得均匀一些。
4.2 推理通信成本
专家数量一多,单卡放不下,只能把不同专家分散到不同显卡上。路由器算出某个 token 该去哪几个专家之后,数据要跨设备发送过去,算完再收回来。这一来一回的通信延迟叠加在每一层 MoE 上,成为分布式推理里绕不开的开销,拓扑优化、通信压缩、专家并行策略都是围绕它做的。
通信量还受路由结果影响。分配均匀时各卡负载接近,整体等待时间可控;某张卡上的专家被集中挑中,同批次里其他设备就得等它算完,训练时的负载均衡损失在推理阶段同样能间接受益。
4.3 显存压力
总参数量大是 MoE 的立身之本,也是它对硬件最直接的压力来源。参数常驻显存,对容量提出高要求;专家参数在计算时被反复读取,对显存带宽同样提出高要求。模型规模一旦上去,显存往往先于算力成为部署瓶颈。
五、业界实践:GPT-4 们的稀疏化
5.1 骨架仍是 Transformer
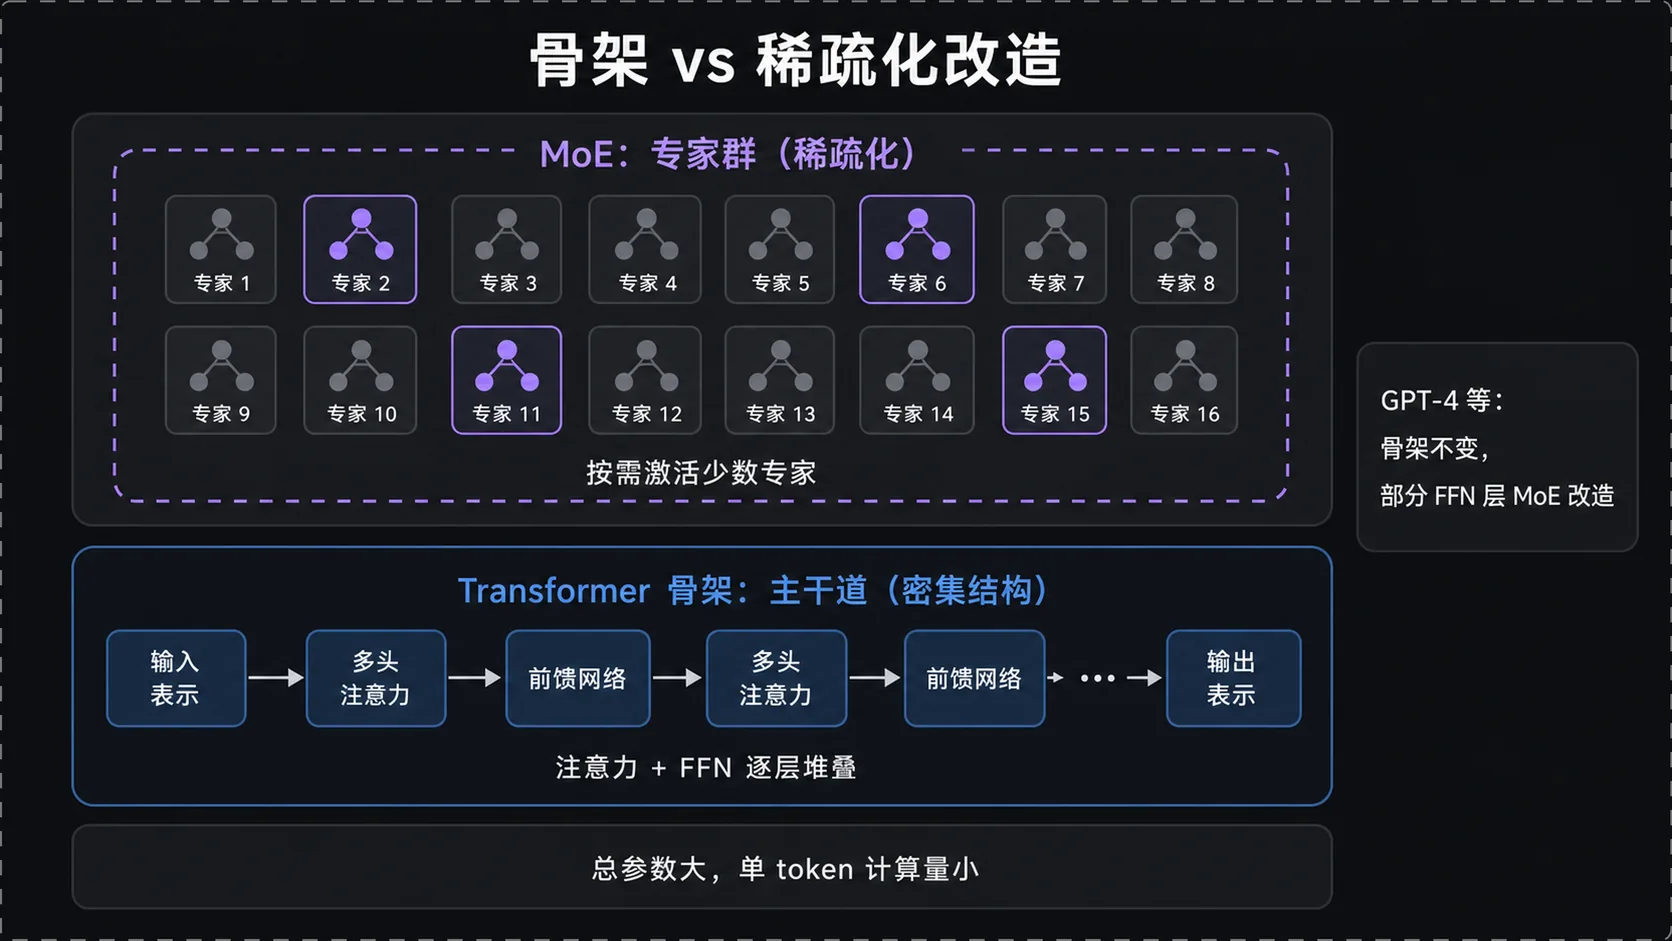
GPT-4 这类顶级模型,整个架构的骨架依然是 Transformer。输入表示进来,多头注意力和前馈网络逐层堆叠,一直到输出表示,这条主干道没有变。
变化发生在部分前馈层上:原来的一个庞大前馈网络被换成几十甚至上百个专家,前面挂一个路由器。注意力子层保持原样,改造只落在前馈这一半。
5.2 数万亿参数背后的计算账
这样一改,模型的总参数量可以做到数万亿级别,而实际每个 token 经过的计算量只相当于一个小得多的密集模型。稀疏大模型的收益就在这道差值上:账面容量按专家数量放大,单次推理开销按激活比例收缩。
看发布会的数字时,把两个量分开读会清楚很多。总参数量说明模型的知识容量上限和显存需求,单 token 激活参数量才对应推理时的计算开销。有些厂商会同时公布两个数字,有些只讲前一个。
两个数字对应的成本项也不同。总参数量决定了部署这套模型至少要准备多少显存、需要几张卡才装得下;激活参数量决定了每生成一个 token 要花掉多少浮点运算,直接映射到延迟和单位调用成本。只看总参数量去比较两个模型的能力或价格,容易得到偏离实际的结论。
六、总结:骨架与稀疏化改造
Transformer 定义了「注意力 + 前馈」的骨干结构,是大模型的主干道;MoE 在这条主干道上做了一次去密集化改造,把原来的单个前馈层换成多个并行调用的专家群,靠路由器决定每个 token 走哪几条支路。两者的关系是骨架与改造,而非并列的两种选择。
理清这一层,再回头看那些数万亿参数的宣传口径,需要追问的就变成了具体几个数:专家总数多少、每个 token 激活几个、单次推理的等效参数量是多少。这几个数字定下来,模型的能力上限、部署成本和硬件门槛也就基本定了。
本文由 AgentPlanFlow 生成