Yinchen 的博客
首页
分类
归档
关于
首页
分类
归档
关于
登录
标签:预训练
清除筛选
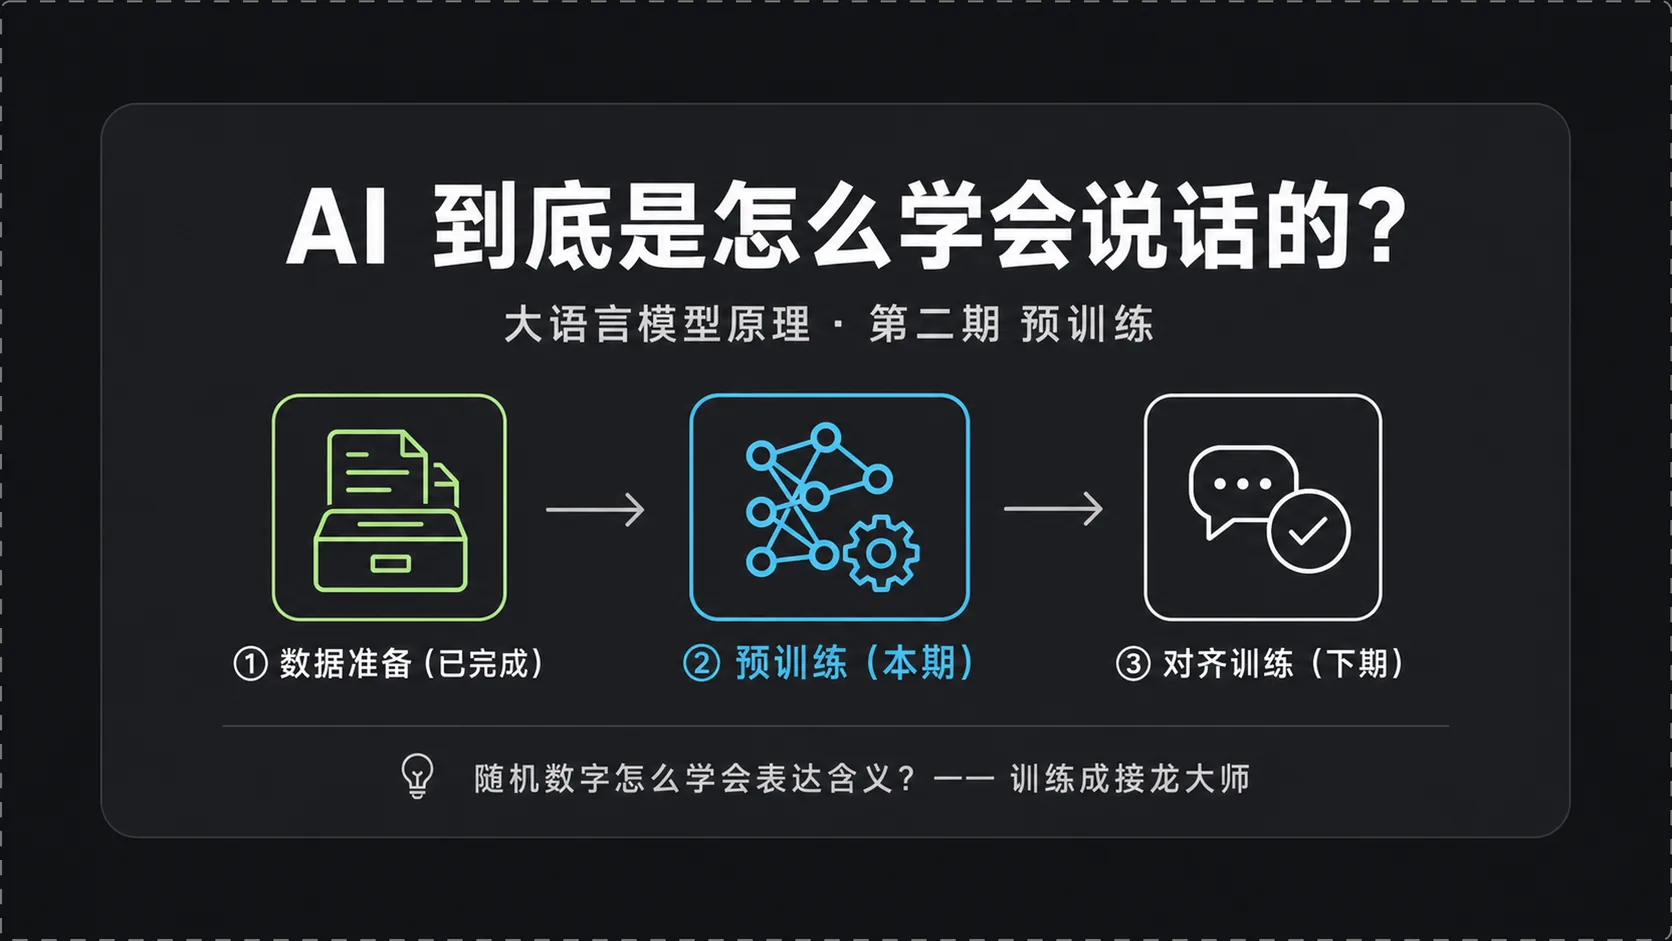
大语言模型原理(二):预训练——从随机向量到接龙大师
2026/08/19
大模型
上一篇讲完了数据准备:海量文本被切成带 ID 的 token,再通过预生成的 embedding 矩阵,让每个 token 按 ID 找到自己对应的高维向量。那批向量里的数字全是随机生成的,还没有承载任何语言含义。 随机数字怎么一步步学会表达含义,答案落在第二个阶段:预训练。 一、回顾:数字还没有含义 1.1 数据准备留下的东西 数据准备结束时,模型手上有两样东西:一份把 token 映射成 ID