
文章内容
上一篇讲完了数据准备:海量文本被切成带 ID 的 token,再通过预生成的 embedding 矩阵,让每个 token 按 ID 找到自己对应的高维向量。那批向量里的数字全是随机生成的,还没有承载任何语言含义。
随机数字怎么一步步学会表达含义,答案落在第二个阶段:预训练。
一、回顾:数字还没有含义
1.1 数据准备留下的东西
数据准备结束时,模型手上有两样东西:一份把 token 映射成 ID 的词表,一份把 ID 映射成高维向量的 embedding 矩阵。
矩阵里的向量形如 [0.21, 0.58, 0.13, ...],每个数字都是随机初始化的结果。这时候「金毛」和「小狗」的向量之间没有任何可解释的关系,两者的数值差异纯属偶然。
1.2 本期要解决的问题
预训练要回答的问题很具体:这些随机数字如何被调整成能表达含义的数值。调整的驱动力来自一个反复进行的任务,模型在这个任务里被迫理解语言。
这个任务就是接龙:给出前面的内容,猜下一个 token 是什么。语料里现成的文本已经写好了正确答案,模型每猜一次就能知道自己错在哪,错误的信息再被换算成对参数的修改。
二、预训练:把模型训练成接龙大师
2.1 目的与起手动作
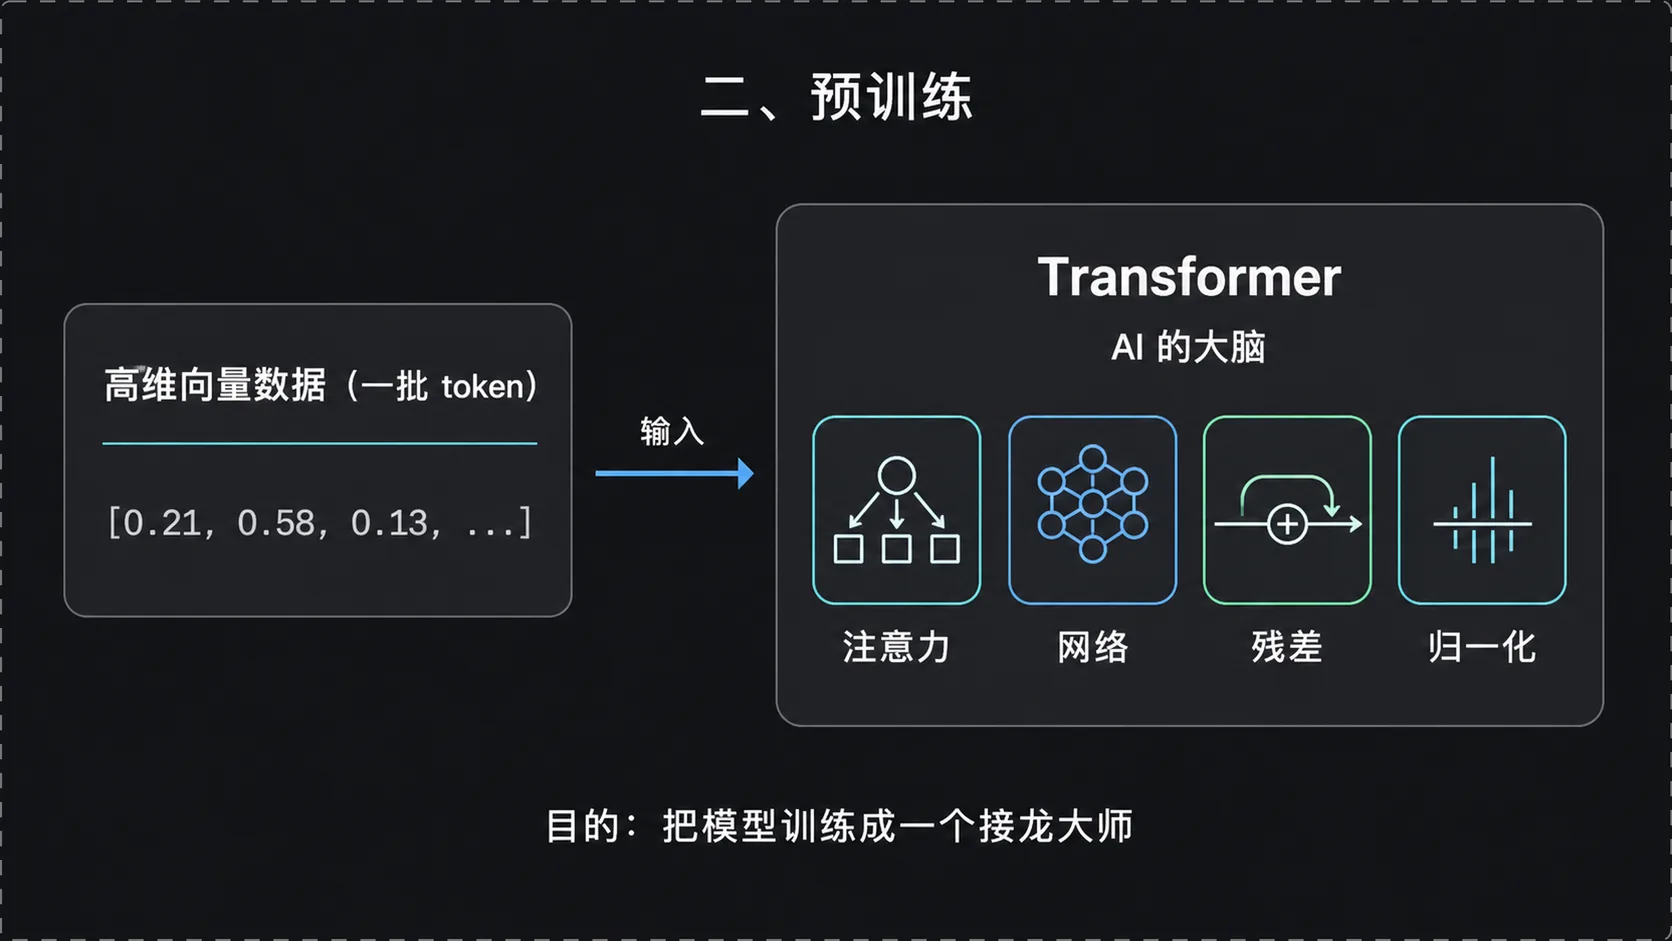
预训练的目的写成一句话:把模型训练成一个接龙大师。
训练时取出一部分处理好的数据,也就是一批高维向量,把它们送进 Transformer 处理。Transformer 是现在大语言模型最核心的网络结构,可以暂时理解成 AI 的大脑。
这个大脑此刻什么都不懂,训练要做的是往里面灌输知识,并且让它看懂。灌输的方式不是把知识条目写进去,而是让它在海量文本上反复做接龙,把规律自己找出来。
训练按批次进行。一批数据走完全部流程并更新参数,才轮到下一批,海量语料就这样被分成无数批次消化掉。
三、Transformer:AI 的大脑
3.1 自注意力机制
Transformer 里最核心的部分叫自注意力机制,作用是让每一个 token 计算出自己对其他 token 的关注程度。
拿「我喜欢金毛因为它很温顺」这句话来看。token 化之后送进自注意力,「温顺」对应的高维向量会发生变化,数字的改动里增加了它对其他词的理解:它知道「它」在修饰「金毛」,知道温顺是描述「它」的,也知道温顺在这句话里表达的是一种原因。
这些理解来自 token 之间关注程度的计算。注意力机制让每个 token 知道自己和句子里每个词之间的关系有多紧密,关系紧密的词,对它的向量影响就更大。
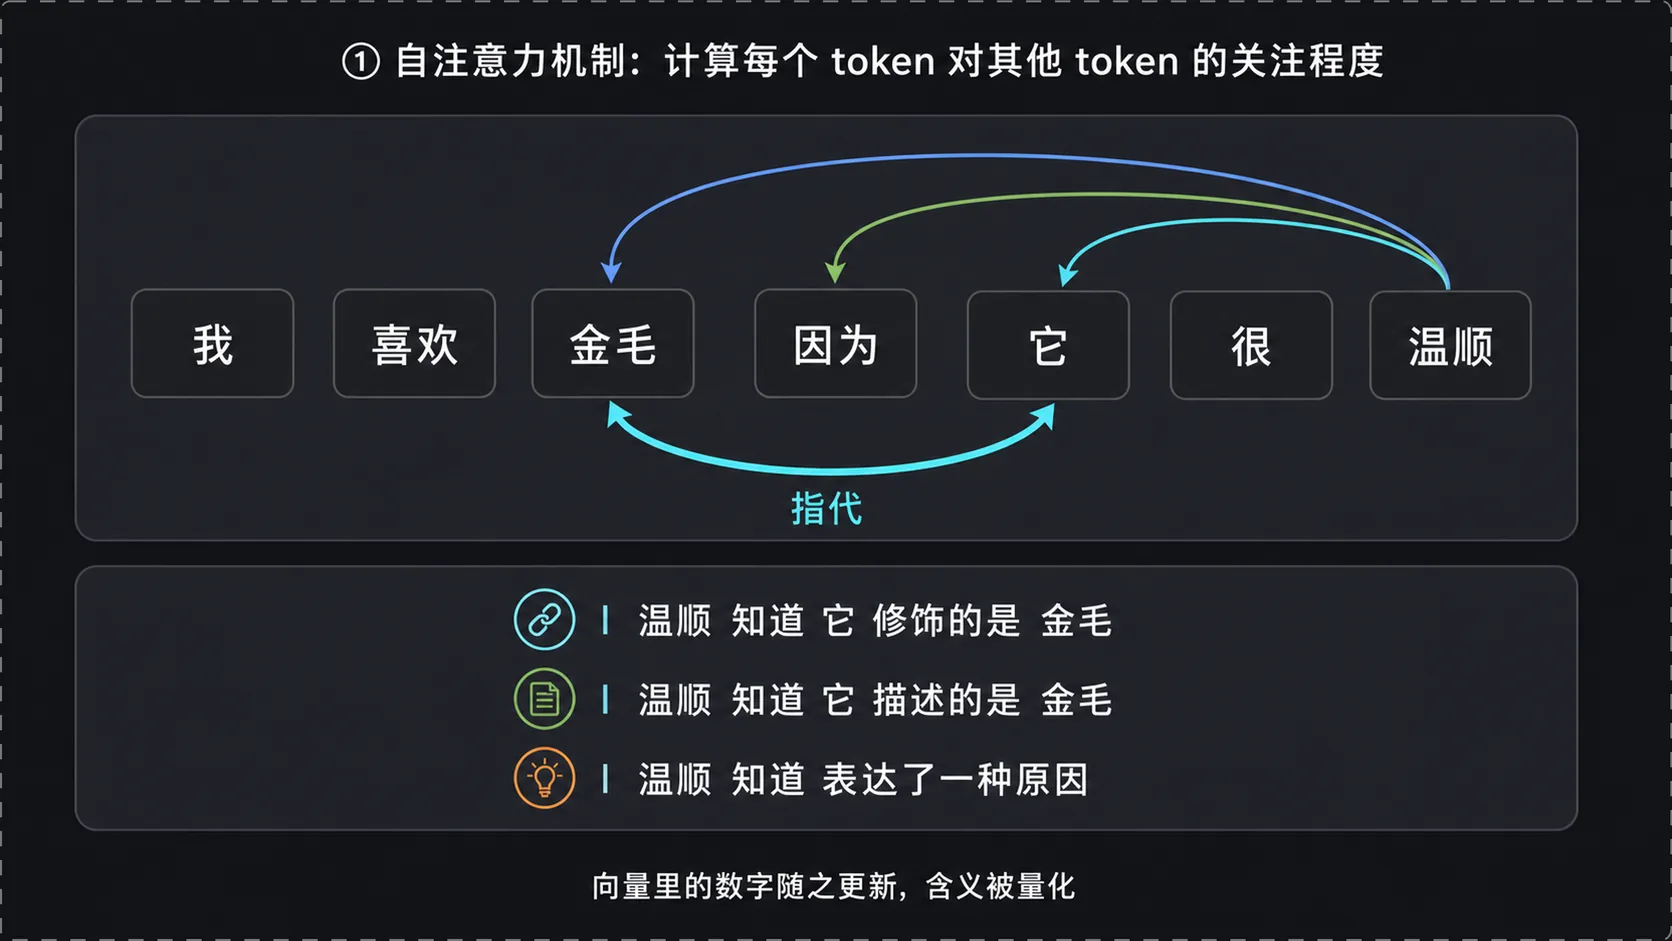
一轮自注意力计算完成后,每个 token 的高维向量更新了一次。含义的量化结果,就体现在这些改变后的数字大小里。
3.2 前馈神经网络
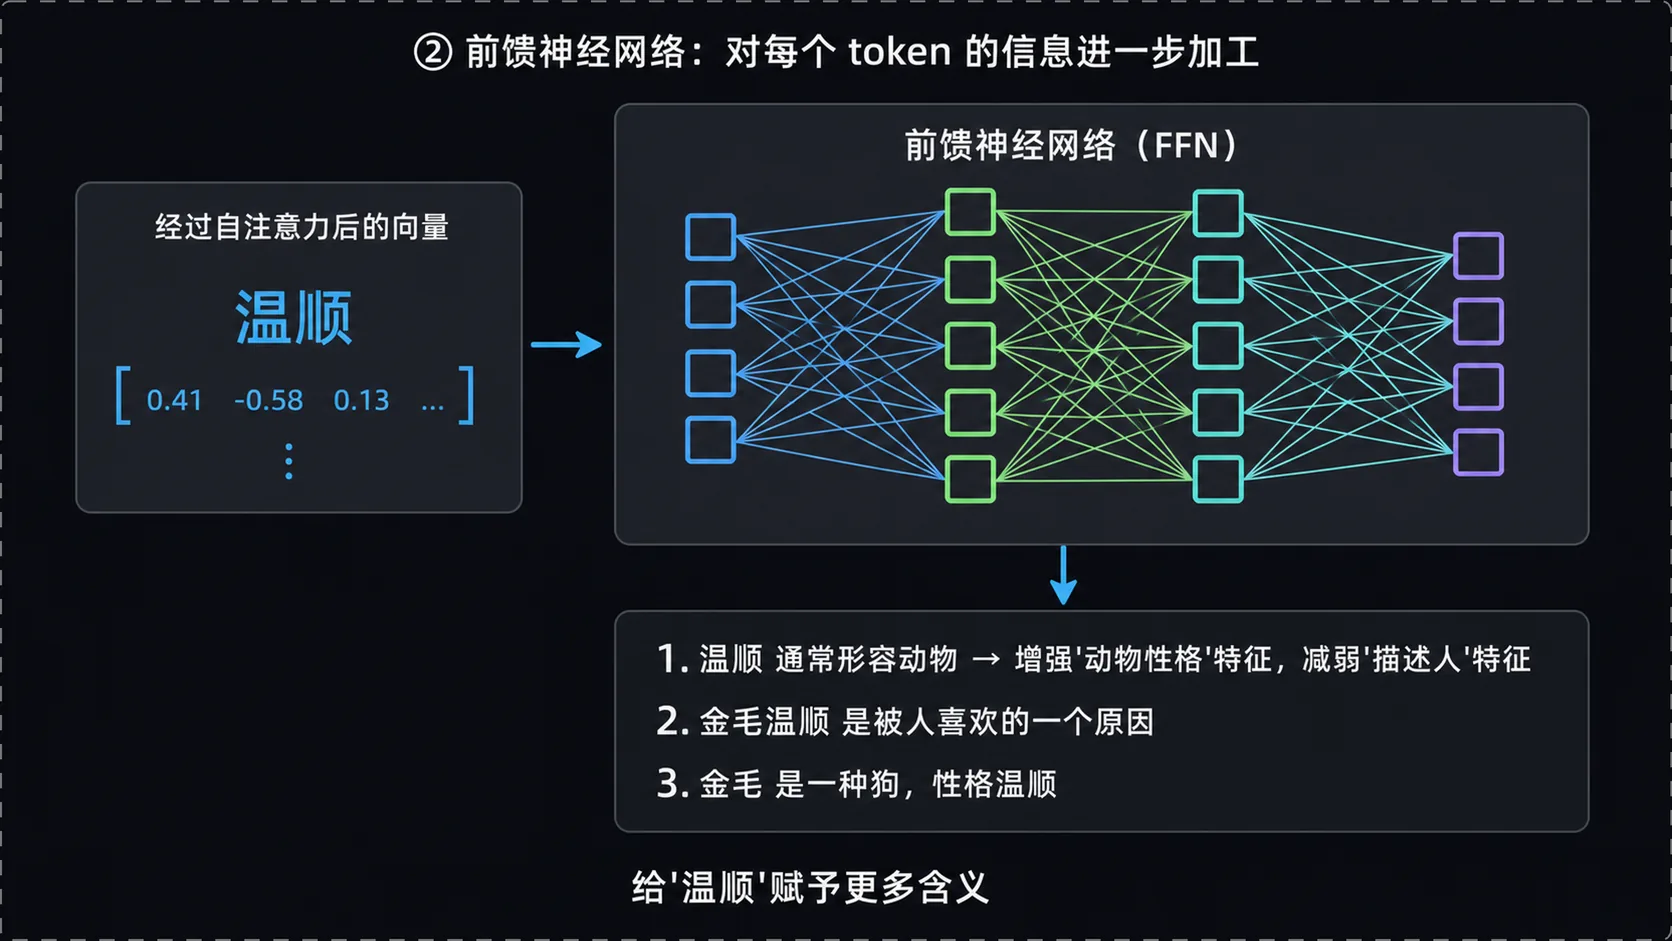
更新过的向量继续往下走,进入前馈神经网络(FFN),对每个 token 拿到的信息做进一步加工。
还是看「温顺」。经过前馈网络之后,它又获得一部分信息:温顺这个词大部分情况下用来形容动物,于是「描述动物性格」这个方向的特征被增强,「描述人」的特征被减弱;它还得知金毛温顺是被人喜欢的一个原因;甚至可以推断出金毛是狗的一个品种,具有温顺的性格。
前馈网络的作用,是给「温顺」赋予了更多含义。自注意力负责把上下文里的关系收集进来,前馈网络负责在这些关系之上做加工,两者在一层里配合使用。
3.3 残差连接与归一化
Transformer 里还有两个结构:残差连接和归一化。它们同样涉及复杂计算,但对理解大模型原理来说不是重点。
残差连接帮助模型保留原来的信息,避免一层层计算下去之后,前面的内容被完全冲掉。几十上百层叠起来,每层都在改写向量,没有这条通路,最初那份信息很难留到最后。
归一化负责让训练过程更稳定,数值在层与层之间传递时不至于跑偏到无法收敛。
3.4 一层四件套,堆叠几十上百层
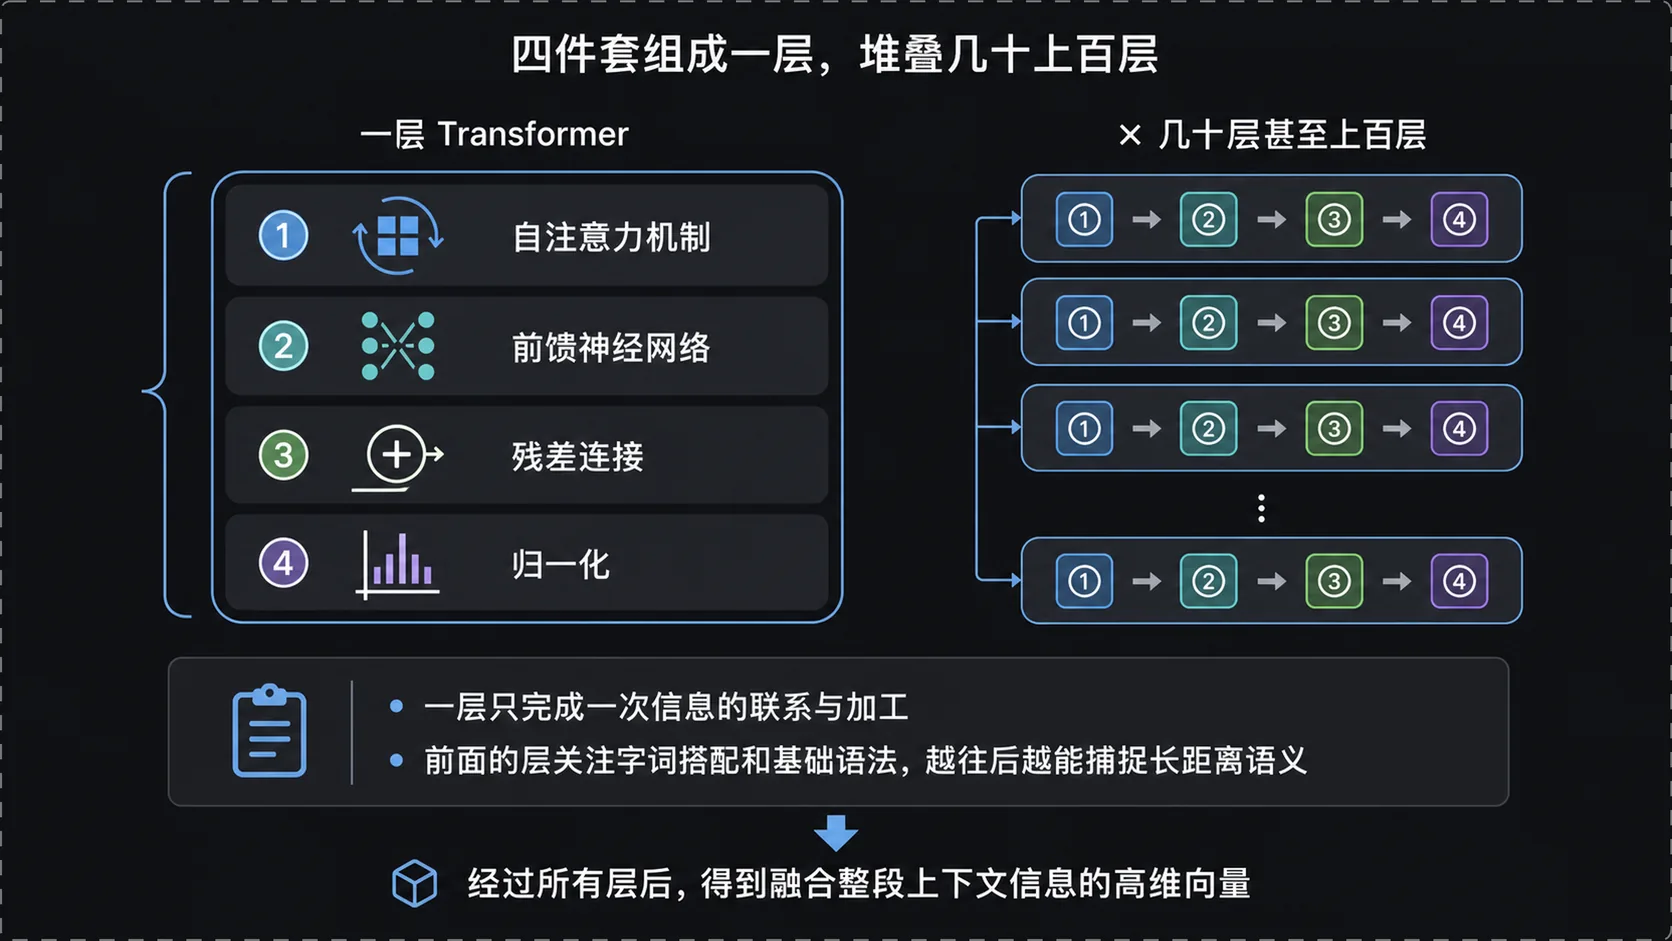
自注意力机制、前馈神经网络、残差连接、归一化,这四个结构共同组成一层 Transformer。一个大语言模型内部通常堆叠几十层甚至上百层。
层数需要这么多,原因在于一层 Transformer 只完成一次信息的联系与加工,而语言中复杂的含义往往需要一步一步形成。前面的层更关注字词搭配和基础语法,越往后越能捕捉长距离的语义关系。
经过几十上百层之后,模型手上的向量已经不再是开始时那批随机数字,而是融合了整段上下文信息的高维向量。同一个「温顺」出现在不同句子里,走完这些层得到的向量也不相同,因为它吸收的上下文不一样。
四、预测下一个 token
4.1 概率预测
token 走完所有 Transformer 层之后,进入下一步:预测下一个 token。
输入「我喜欢」,模型会给词表里的每一个 token 算出一个可能出现的概率,画面里给的示例是吃饭 0.1%、它 6%、金毛 35%。金毛的概率最大,预测结果就是它,这次预测算对了。
参与打分的是整张词表,数十万个条目每个都拿到一个概率值,所有概率加起来等于 1。模型的一次输出,就是在这张概率表上做选择。
# 简化示意,非真实实现import math # 走完所有 Transformer 层之后,最后一个位置得到的上下文向量hidden = [0.31, 0.75, 0.12] # 输出权重:词表里每个 token 各有一组权重,用来给这个 token 打分output_weights = { "吃饭": [0.1, 0.2, 0.1], "它": [0.4, 0.5, 0.3], "金毛": [0.9, 0.8, 0.6],} def next_token_probs(hidden, weights): # 点积打分:上下文向量与每个 token 的权重相乘求和,得到原始分数 scores = {tok: sum(h * w for h, w in zip(hidden, ws)) for tok, ws in weights.items()} exp = {tok: math.exp(s) for tok, s in scores.items()} # 指数化,放大分数差距 total = sum(exp.values()) # 求和用于归一化 return {tok: v / total for tok, v in exp.items()} # softmax:把分数变成概率分布 next_token_probs(hidden, output_weights) # 词表里每个 token 都拿到一个概率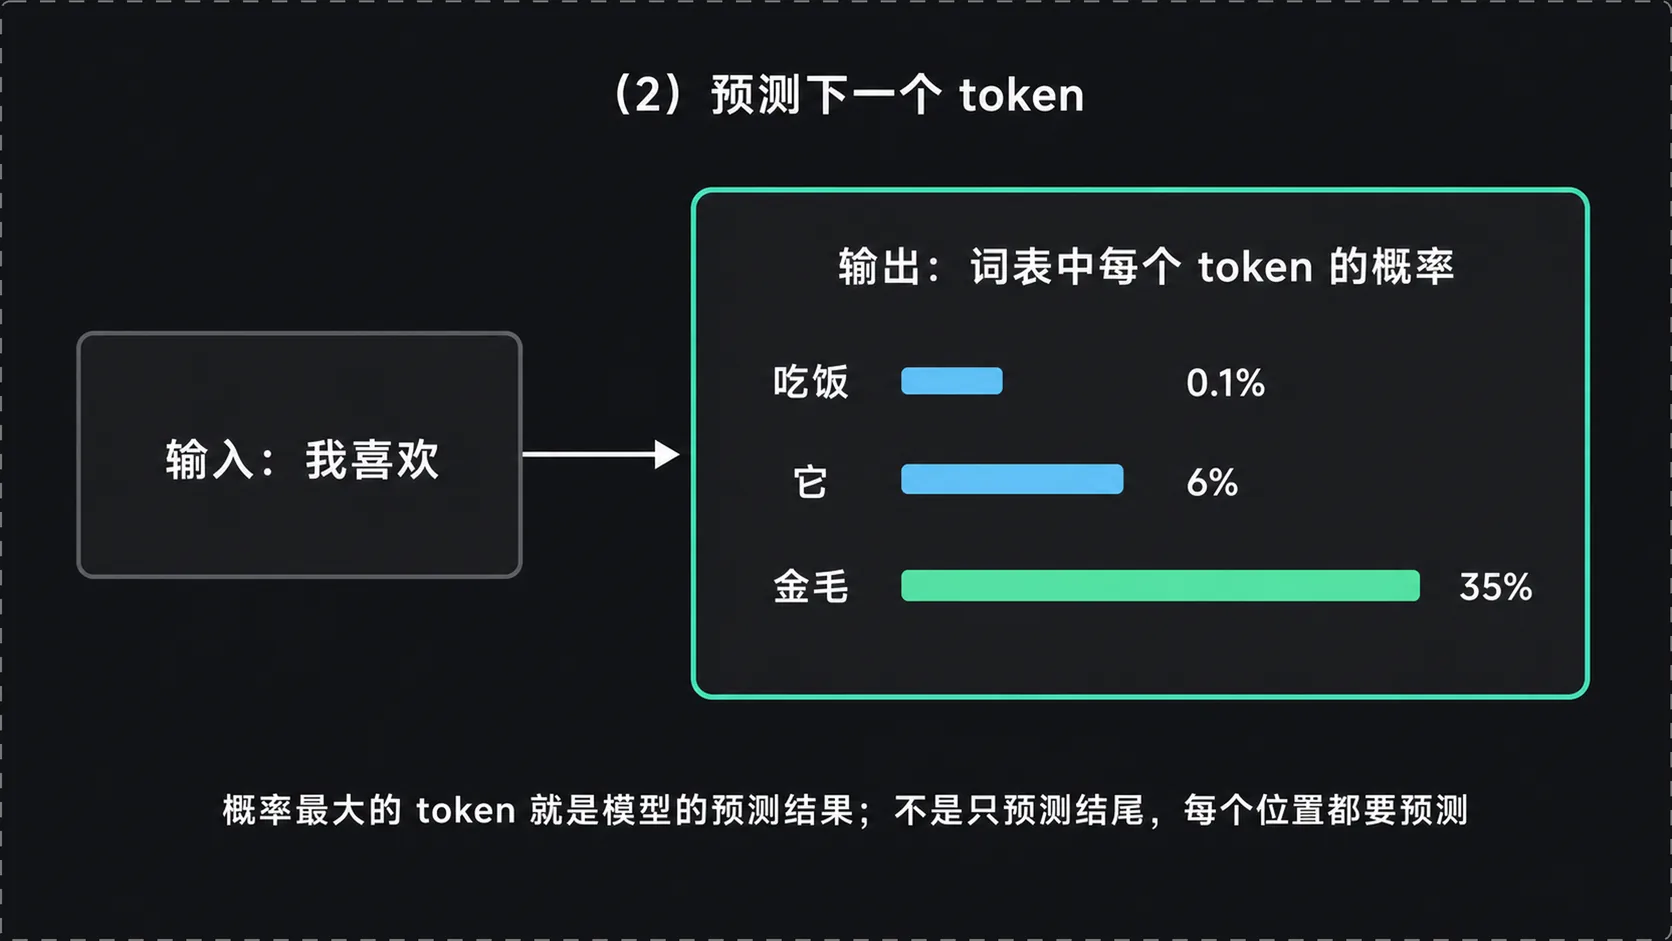
4.2 每个位置都要预测
预测的对象不局限于一句话结尾的那个词,句子里每一个位置都要做同样的事。
输入「我」,希望预测出「喜欢」;输入「我喜欢」,希望预测出「金毛」;输入「我喜欢金毛」,希望预测出「因为」。一句话因此能提供多次训练信号,海量文本里的每个位置都被这样利用起来。
这也是预训练不需要人工标注的原因。文本本身就带着答案,下一个词是什么,语料里写得清楚,训练规模因此可以直接堆到全网数据的量级。
五、反向传播与参数
5.1 预测错了怎么办
预测结果与实际的下一个 token 对不上时,训练进入反向传播这一步。
模型对预测的错误做损失计算,得出偏差有多大,再依据计算结果去调整参数,目的是让下一次预测更靠近正确答案。
损失的大小与预测质量挂钩:正确答案被给到的概率越低,损失越大,参数需要调整的幅度也越大。预测得准时损失接近于零,参数几乎不动。
# 简化示意,非真实实现import math probs = {"吃饭": 0.001, "它": 0.06, "金毛": 0.35} # 模型这次给出的概率分布target = "金毛" # 语料里实际出现的下一个 token # 交叉熵损失:正确答案的概率越低,损失越大loss = -math.log(probs[target]) params = {"w1": 0.9, "w2": 0.8} # 一小撮参数,真实模型有上千亿个grads = {"w1": -0.12, "w2": 0.05} # 反向传播算出的梯度,指出参数往哪调能减小损失learning_rate = 0.01 # 学习率,控制每次调整的幅度 for name in params: # 沿梯度反方向更新一步,这就是参数被调整的过程 params[name] -= learning_rate * grads[name] # 下一批数据进来时,模型用的就是更新之后的参数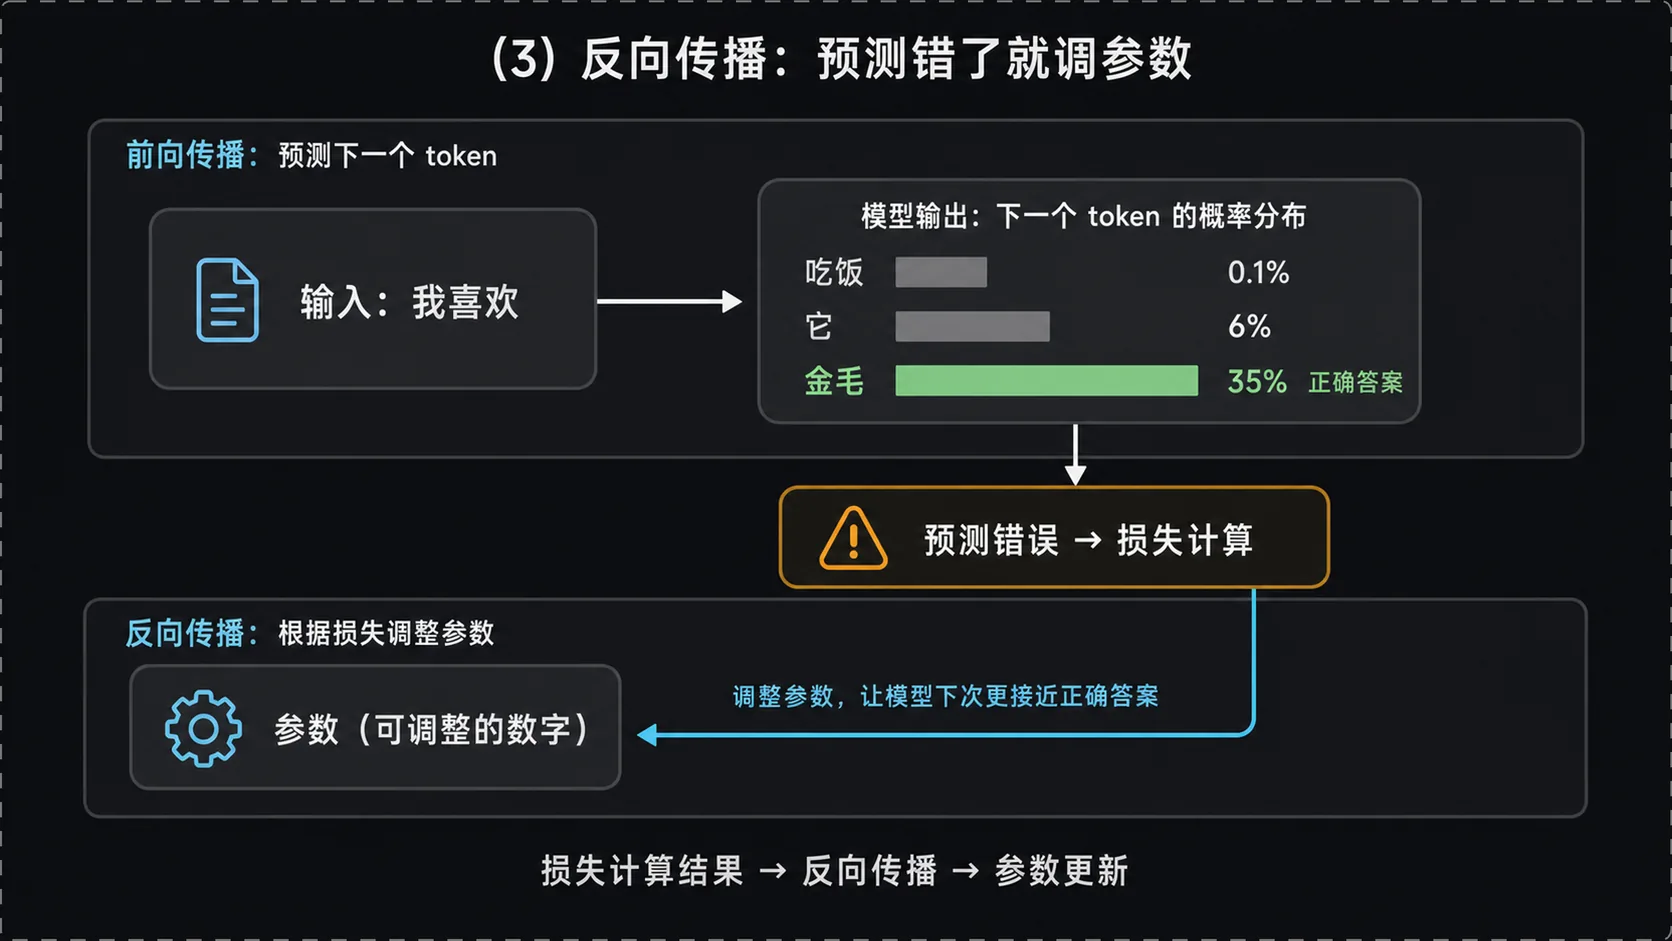
5.2 参数是什么
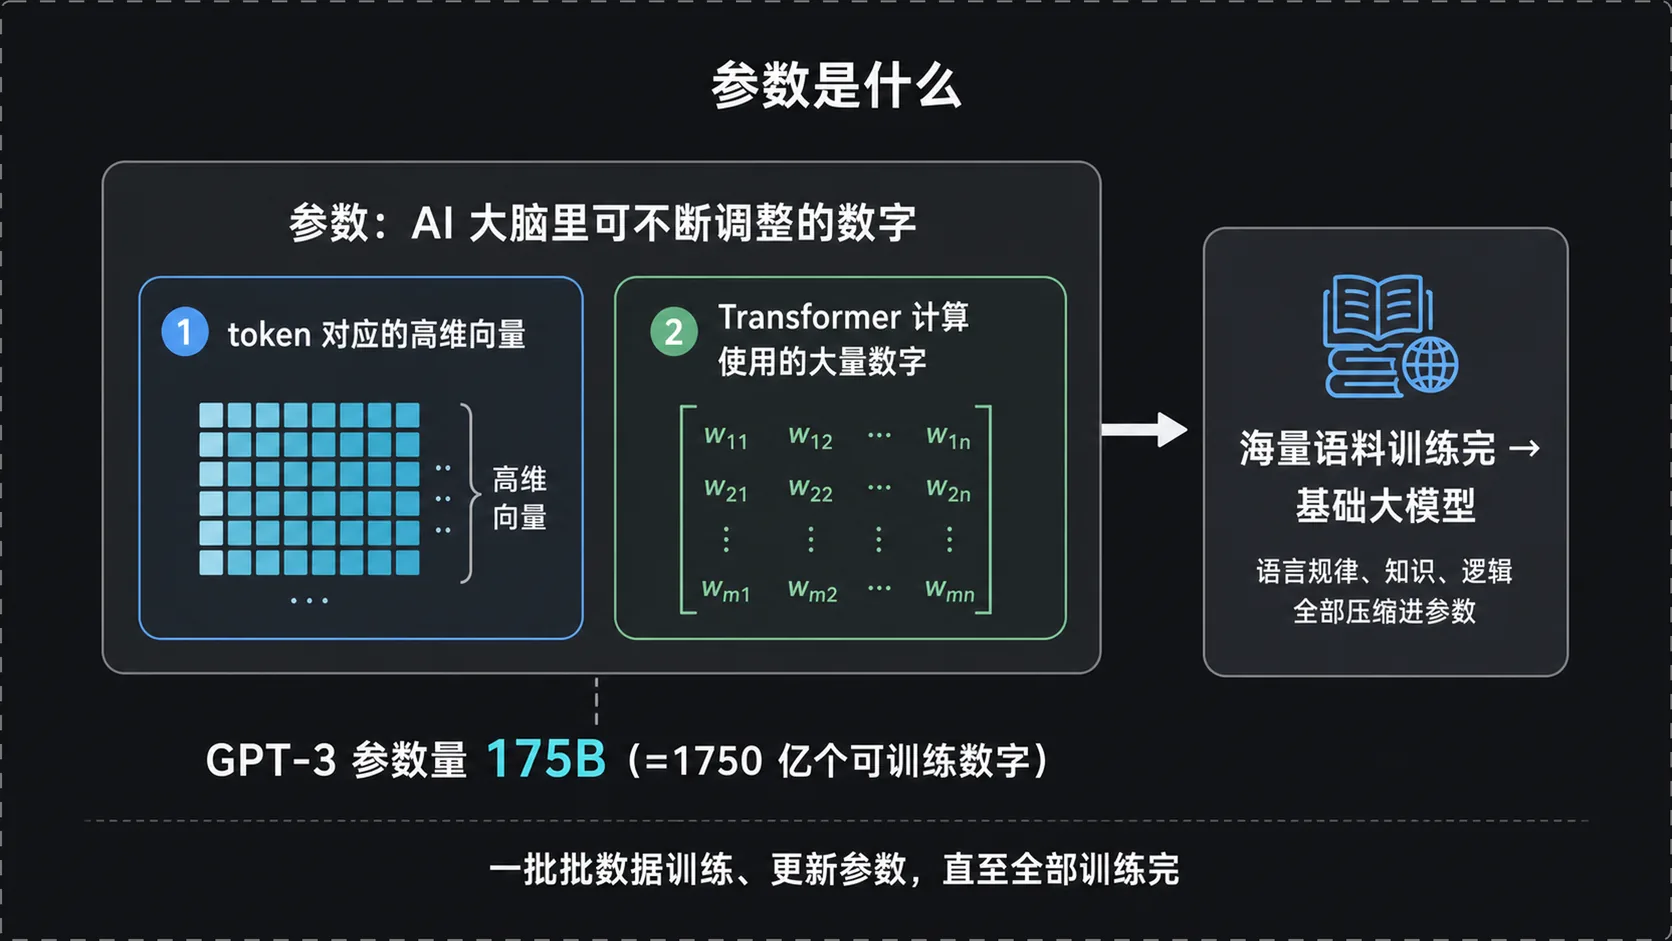
参数指的是 AI 大脑里那些可以不断调整的数字,包含两部分:每个 token 对应的高维向量,以及 Transformer 计算时使用的大量数字。
ChatGPT-3 的参数量是 175B,B 是英文 Billion,也就是 10 亿,175B 换算过来是 1750 亿个可以被训练和调整的数字。模型从海量文本中学到的所有语言规律、知识联系、表达方式、逻辑,全部被压缩进这些参数里。
发布会上比较的参数量,指的就是这批数字的规模。它们没有一条一条对应到具体知识,语言规律分散在整个参数空间里,改动其中一部分会影响到很多看似无关的表现。
5.3 分批数据训练
参数更新完成,这一批数据的训练就算结束,接着输入下一批数据,重复同样的流程:向量进 Transformer、预测下一个 token、算损失、调参数。
所有数据训练完之后,得到的产物是一个基础大模型。
六、预训练的结果:接龙大师
6.1 它听不懂命令
此时的 AI 与日常使用的 AI 还有距离,它的能力只够称作接龙大师:给它一段输入,它在后面朴素地输出最可能出现的内容。
输入「我是不是应该好好学习」,它给出的回答是「天天向上」,而不是「是应该」。语料里「好好学习」后面跟着「天天向上」的次数远多于其他搭配,接龙的结果就落在这里。它不知道人类在向它提问,也不知道要按指令回答,只是一味说出后面最可能出现的内容。
6.2 回答为什么每次不一样
接龙给出的也不一定是概率最高的那个 token。模型回答时有一些设置,可以从预测概率最高的几个词里随机选取一个。同一个问题问两次,得到的回答因此可以不同。
七、总结
数据准备留下的随机高维向量被送进 Transformer,经过自注意力、前馈网络、残差连接、归一化四件套逐层加工,在几十上百层之后融合了完整上下文;模型据此预测下一个 token,预测错了就算损失、做反向传播、调整那上千亿个参数;一批批数据训练完,语言规律被压缩进参数,产出一个只会接龙的基础大模型。
下一篇讲对齐训练,接龙大师如何变成能对话的助手。
本文由 AgentPlanFlow 生成