Yinchen 的博客
首页分类归档关于
首页分类归档关于登录
标签:Tokenization清除筛选

大语言模型原理(一):数据准备——从文本到数字

2026/08/19大模型
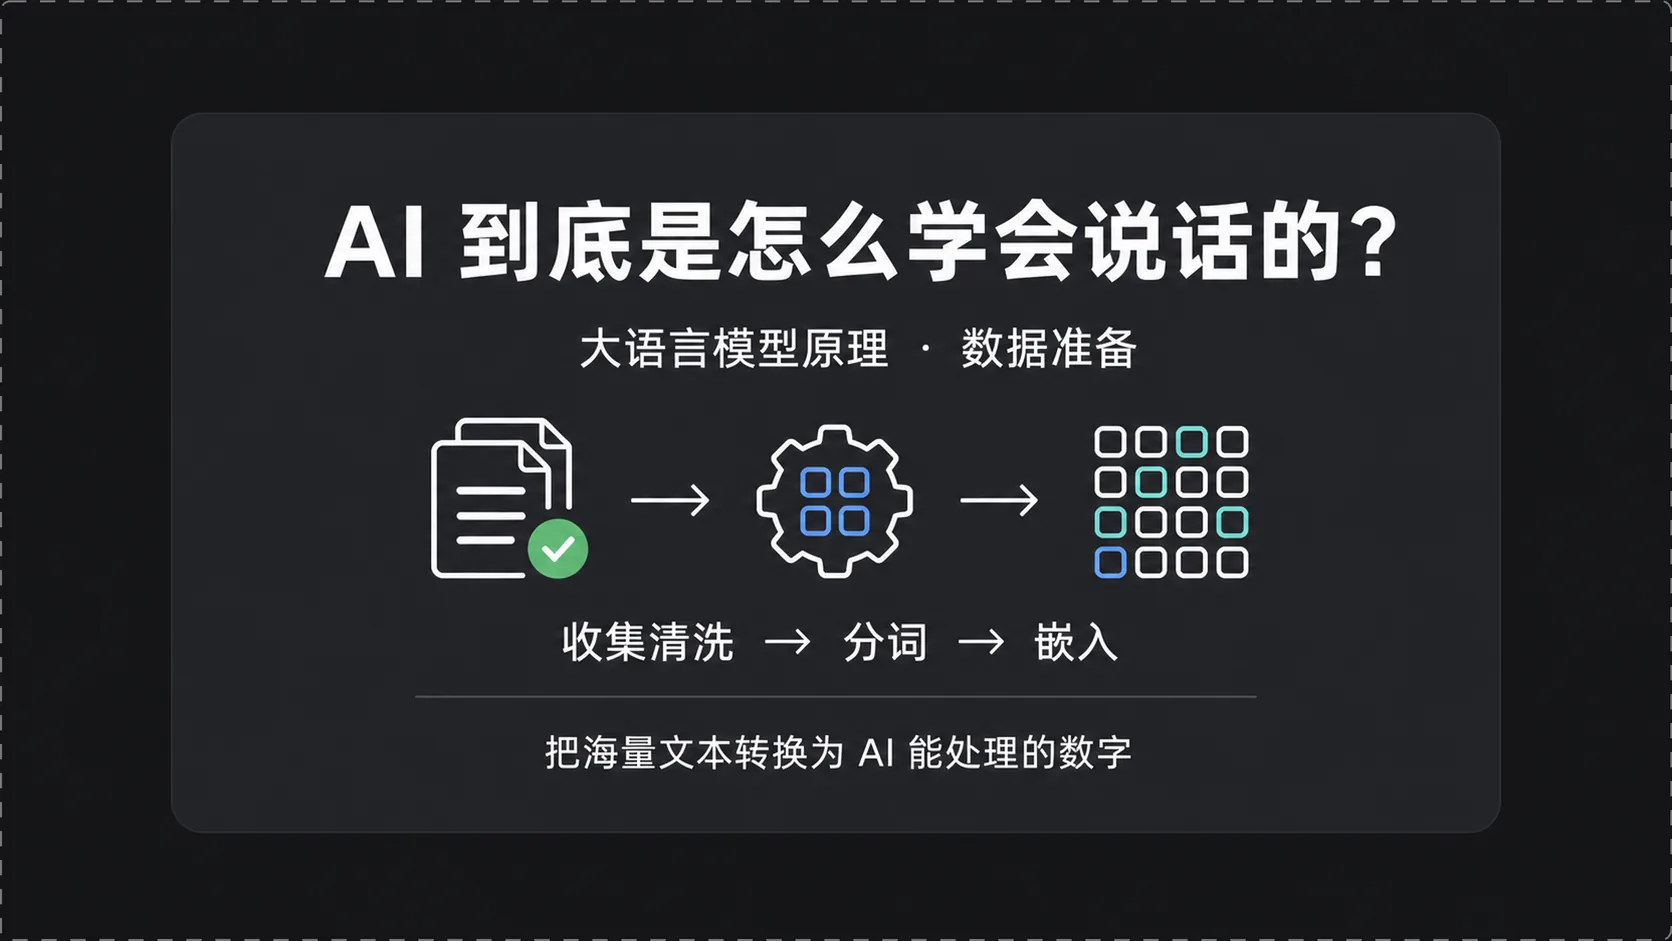
豆包、DeepSeek、ChatGPT 这类能直接对话的 AI,都属于大语言模型。模型在读懂任何一句话之前,得先把语言换成数字,因为计算机能做的只有数字计算。这步转换发生在数据准备阶段,拆开看是三件事:收集清洗、分词、嵌入。 一、三大阶段,与数据准备的目的 1.1 大模型诞生的三个阶段 一个大语言模型从无到有,要经过三个阶段:数据准备、预训练、对齐训练。 数据准备负责把原始语料整理成模型能吃进去的

sanyinchen

@sanyinchen

最近更新

  • Android Framework(二十五)Android底层渲染:Surface的底层实现原理
  • Android Framework(二十四)VSync 信号的请求与接收源码分析
  • Android-Framework(二十三)-SurfaceFlinger 源码分析:屏幕刷新、Vsync 与帧分发
  • Android View 事件分发机制入门
  • Android-Framework(二十二)-Input 事件的接受处理过程
  • Android-Framework(二十一)-Input 事件的分发过程

分类

算法 · 6Android系统 · 57题解 · 21设计模式 · 5Agent · 10大模型 · 7网络库 · 1c++ · 5Java · 1

© 2026 sanyinchen

主题适配自 LyraVoid/Mizuki·Wind Blog·文章归档·苏ICP备2025217901-2号