
文章内容
豆包、DeepSeek、ChatGPT 这类能直接对话的 AI,都属于大语言模型。模型在读懂任何一句话之前,得先把语言换成数字,因为计算机能做的只有数字计算。这步转换发生在数据准备阶段,拆开看是三件事:收集清洗、分词、嵌入。
一、三大阶段,与数据准备的目的
1.1 大模型诞生的三个阶段
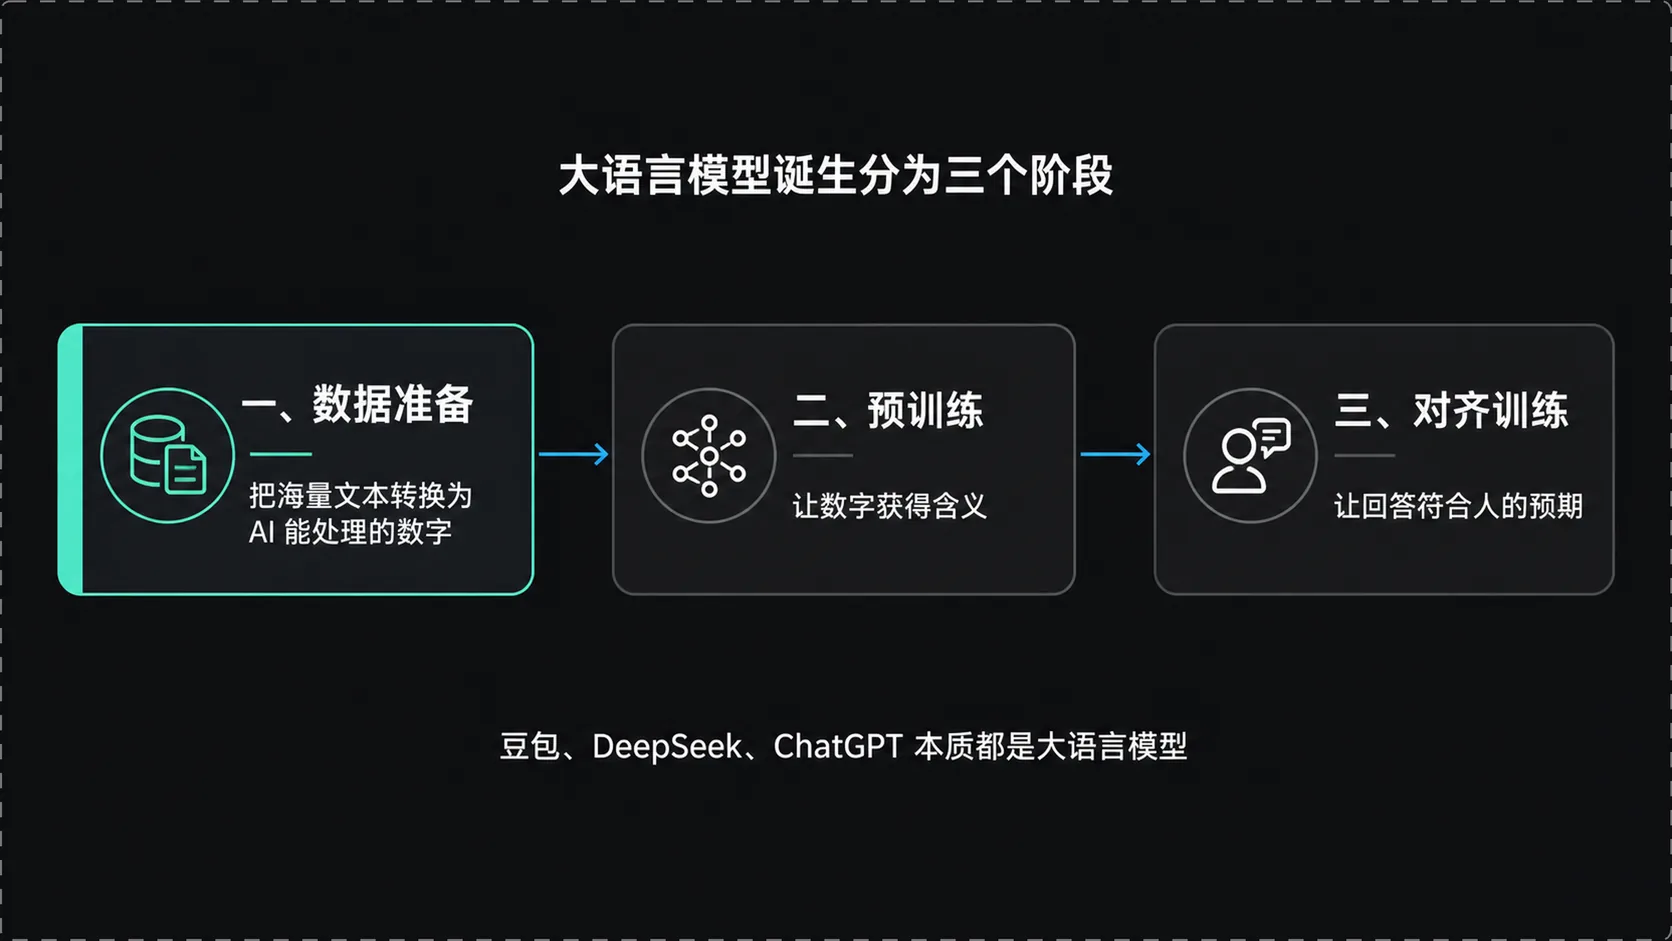
一个大语言模型从无到有,要经过三个阶段:数据准备、预训练、对齐训练。
数据准备负责把原始语料整理成模型能吃进去的形式;预训练让模型在这批数据上学到语言规律;对齐训练再把模型调成能听懂指令、按人的预期回答的样子。本文讲第一个阶段。
三个阶段的顺序不能调换。没有整理好的数据,预训练无从谈起;没有预训练打底,对齐训练也没有可调的对象。数据准备处在最前面,它的产出形态决定了后面两个阶段能拿到什么。
1.2 目的:把海量文本转换为数字
数据准备的目的写成一句话:把大量的文本转换为 AI 能处理的数字。
这个目标听上去朴素,中间的距离却不小。网页上的一段话对人来说是含义,对计算机来说只是一串字符,它既不知道哪几个字该算作一个整体,也不知道这些字之间有什么关联。三个步骤要解决的就是这段距离。
转换过程分成两层:先把文字切开并编号,让机器有东西可查;再把编号换成一组数字,让机器有东西可算。收集清洗则是这两层之前的准备工作,负责保证进入流水线的原料本身可用。
二、第一步:资料收集与清洗
2.1 收集:知识库从哪来
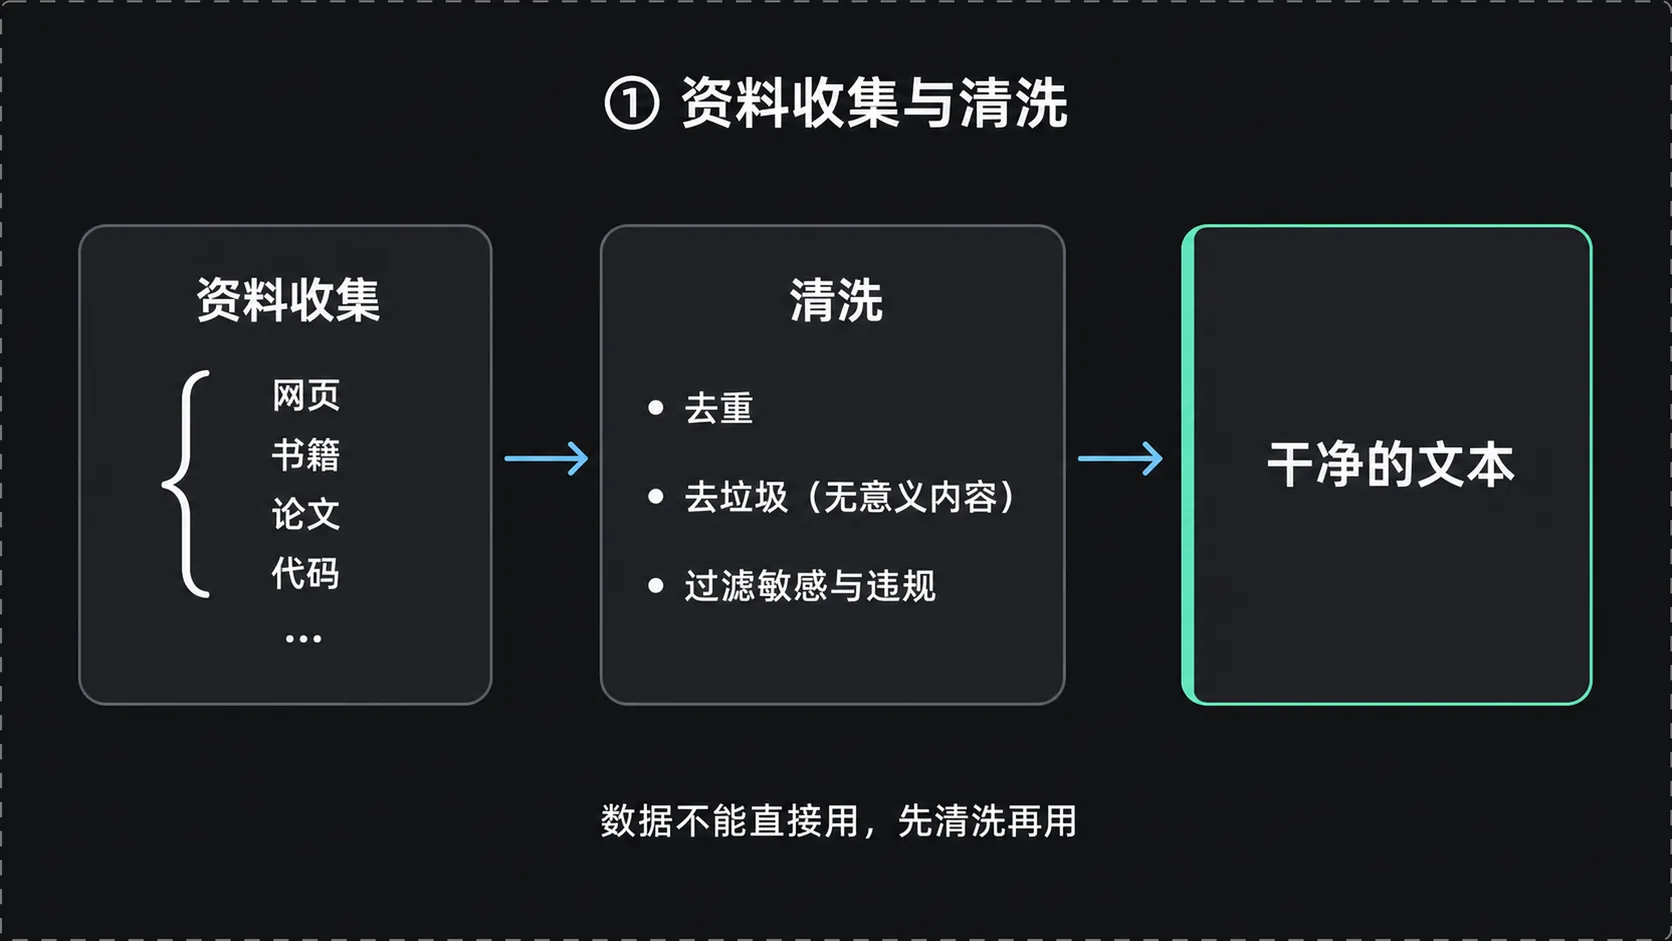
要教 AI 说话,前提是有一个足够庞大的知识库。语料来自网页、书籍、论文、代码这些渠道,规模越大,模型见过的语言现象越多。
不同来源承担的作用也不同。网页量大、覆盖面广,书籍和论文提供成体系的表达和专业内容,代码则带来结构严格的另一类语言。它们汇总起来,构成模型将来能力的上限。
2.2 清洗:去重、去垃圾、过滤违规
全网收集来的数据不能直接用。同一段内容在不同站点重复出现,需要去重;大量抓取结果里混着没有含义的垃圾内容,需要剔除;敏感与违规信息也要过滤掉。
清洗这步的作用容易被低估。语料里的重复和噪声会被模型一并学走,后续预训练的成本又极高,不可能等到模型学坏了再回头返工。
去重针对的是同一份内容被反复抓取的情况,重复越多,模型对这部分内容的印象越深,分布就被带偏。去垃圾针对的是导航栏、广告位这类没有含义的字符堆积。违规和敏感内容的过滤,则决定了模型将来会不会把不该说的东西说出来。
2.3 产出:干净的文本
收集加清洗,最后得到一批干净的文本。这批文本仍然是人能直接阅读的文字,还没有变成数字,它是后面两步的输入。
三、第二步:分词(Tokenization)
3.1 token:AI 处理文字的最小单位
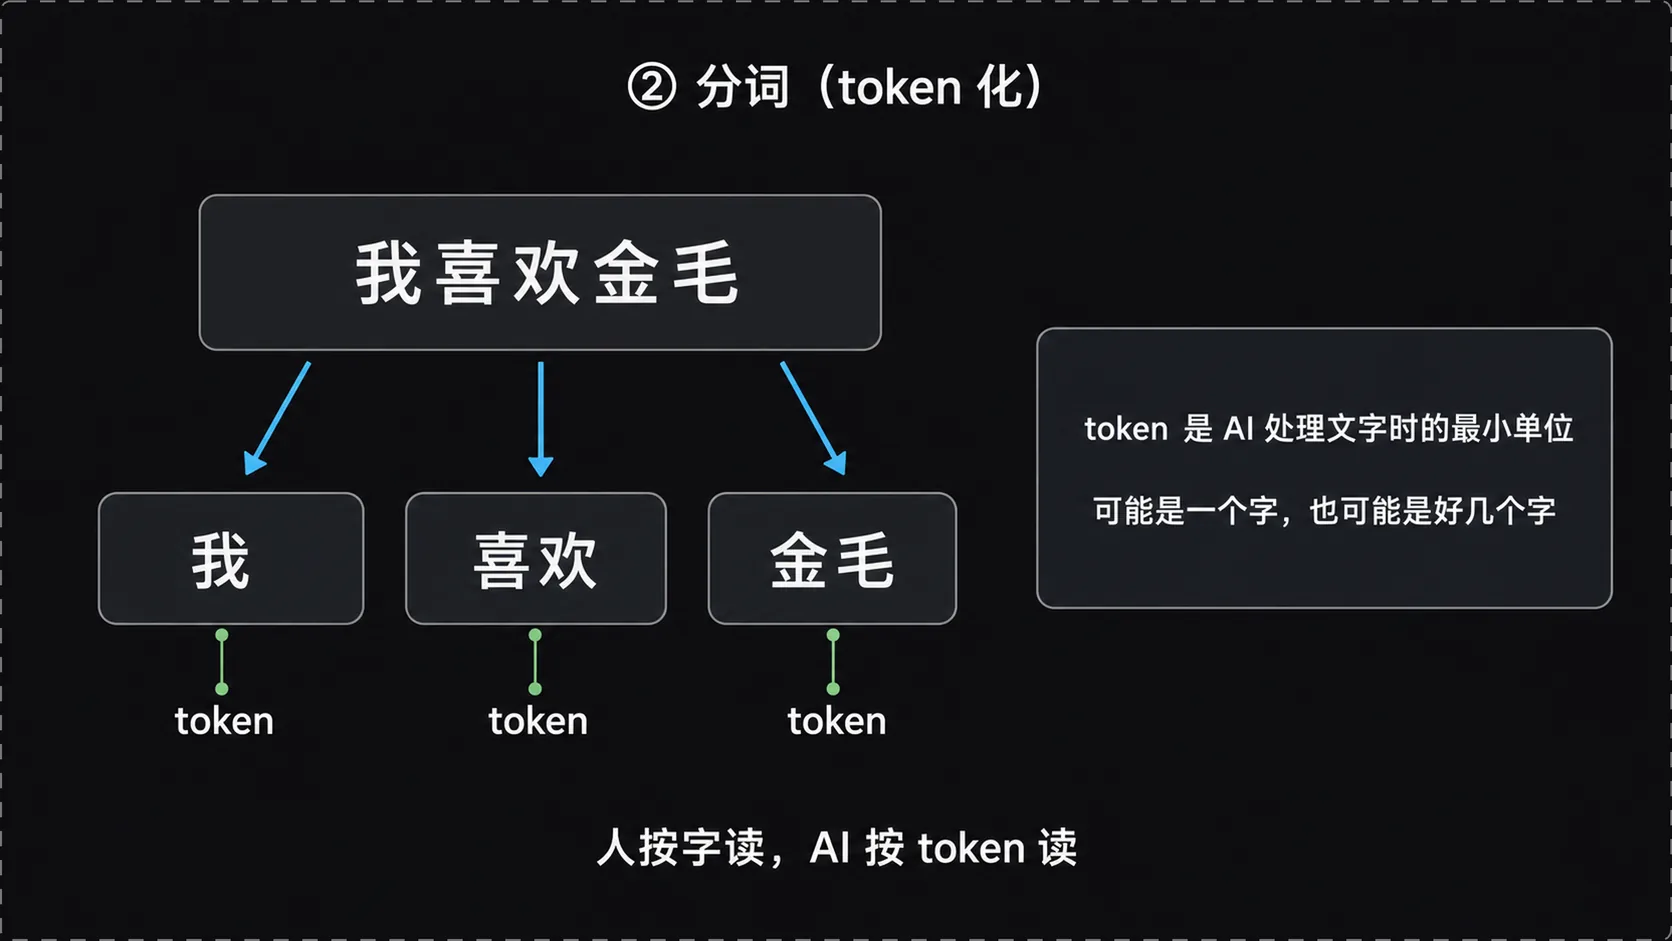
人阅读时的最小单位是一个字。AI 不按字来处理,它的最小单位叫 token,一个 token 可能对应一个字,也可能对应好几个字。
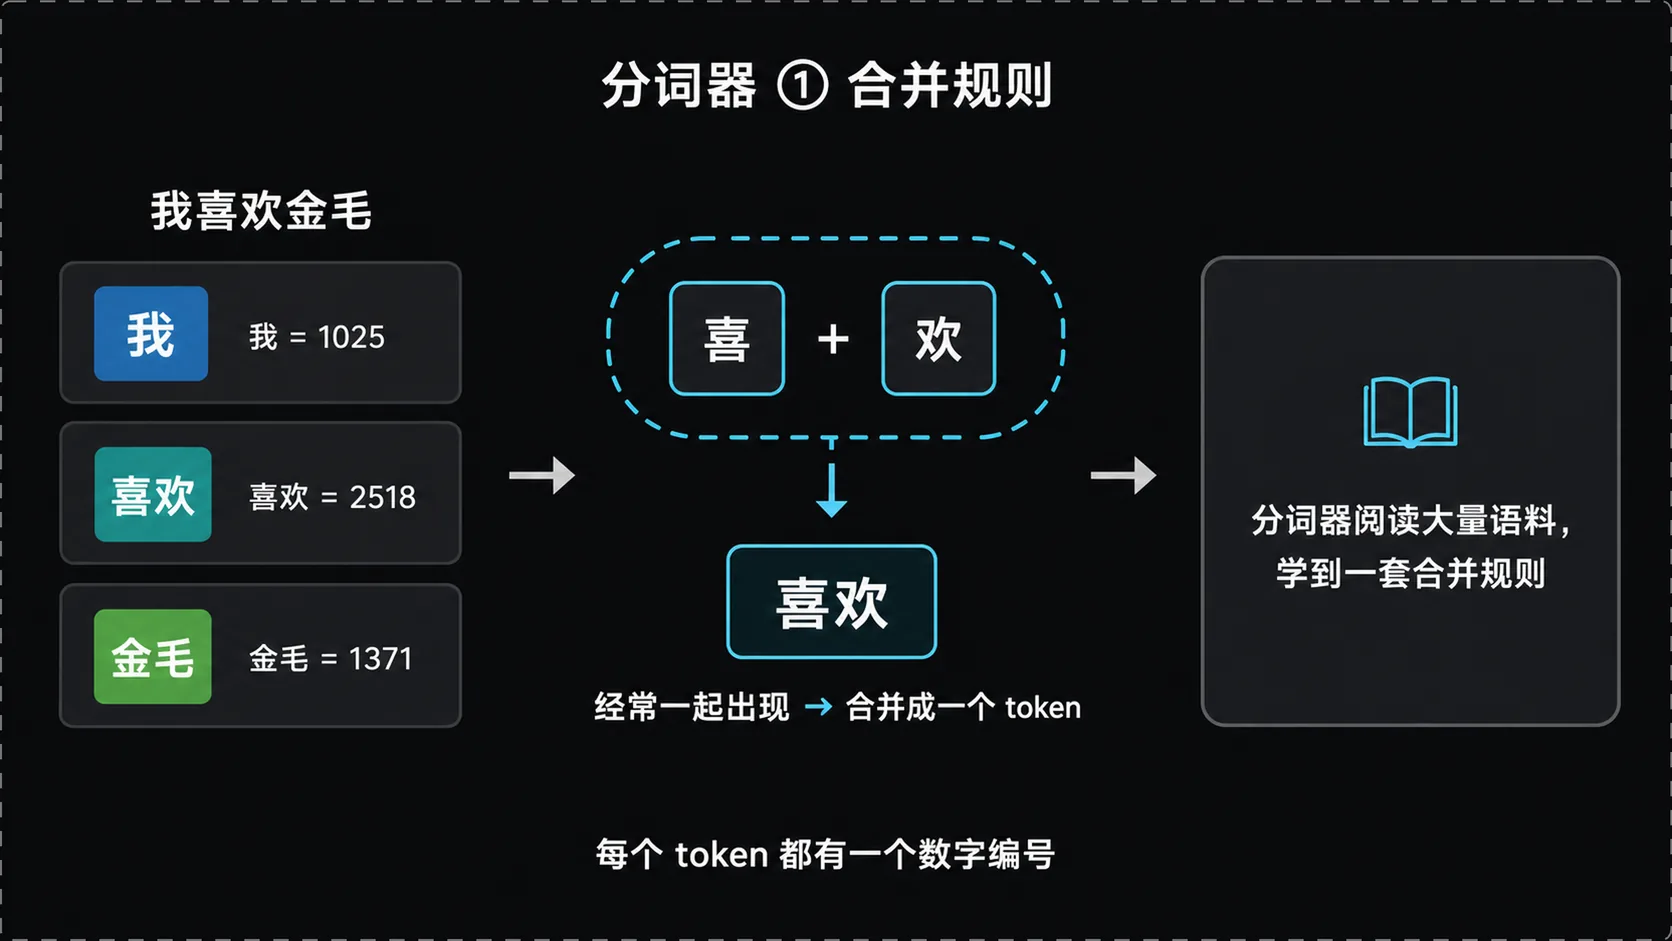
拿「我喜欢金毛」这句话举例,分词之后得到三个 token:我、喜欢、金毛。「喜欢」两个字被当成一个整体,「金毛」也是。每个 token 各自带一个数字编号,画面里给出的是 我=1025、喜欢=2518、金毛=1371。
五个汉字变成三个 token,这个数量差异贯穿模型工作的全过程。人数着字读,模型数着 token 算,两把尺子的刻度对不齐。
3.2 分词器的两件事
切分动作由分词器(Tokenizer)完成,而分词器本身也需要先训练。它训练时做两件事。
第一件是建立合并规则。让分词器阅读大量知识库,它会发现「喜欢」这两个字经常一起出现,于是学到一条规则:以后这两个字在一起就合并成一个 token。语料里高频共现的搭配,都会以这种方式被固定下来。
合并规则只看语料中的统计结果,不判断语法。以「喜欢」为例:如果「喜」和「欢」在训练语料中经常相邻出现,分词器就可能把它们合并成一个 token。反过来,即使某个组合在语言学上不算一个完整的词,只要它在语料中足够常见,也可能被合并。
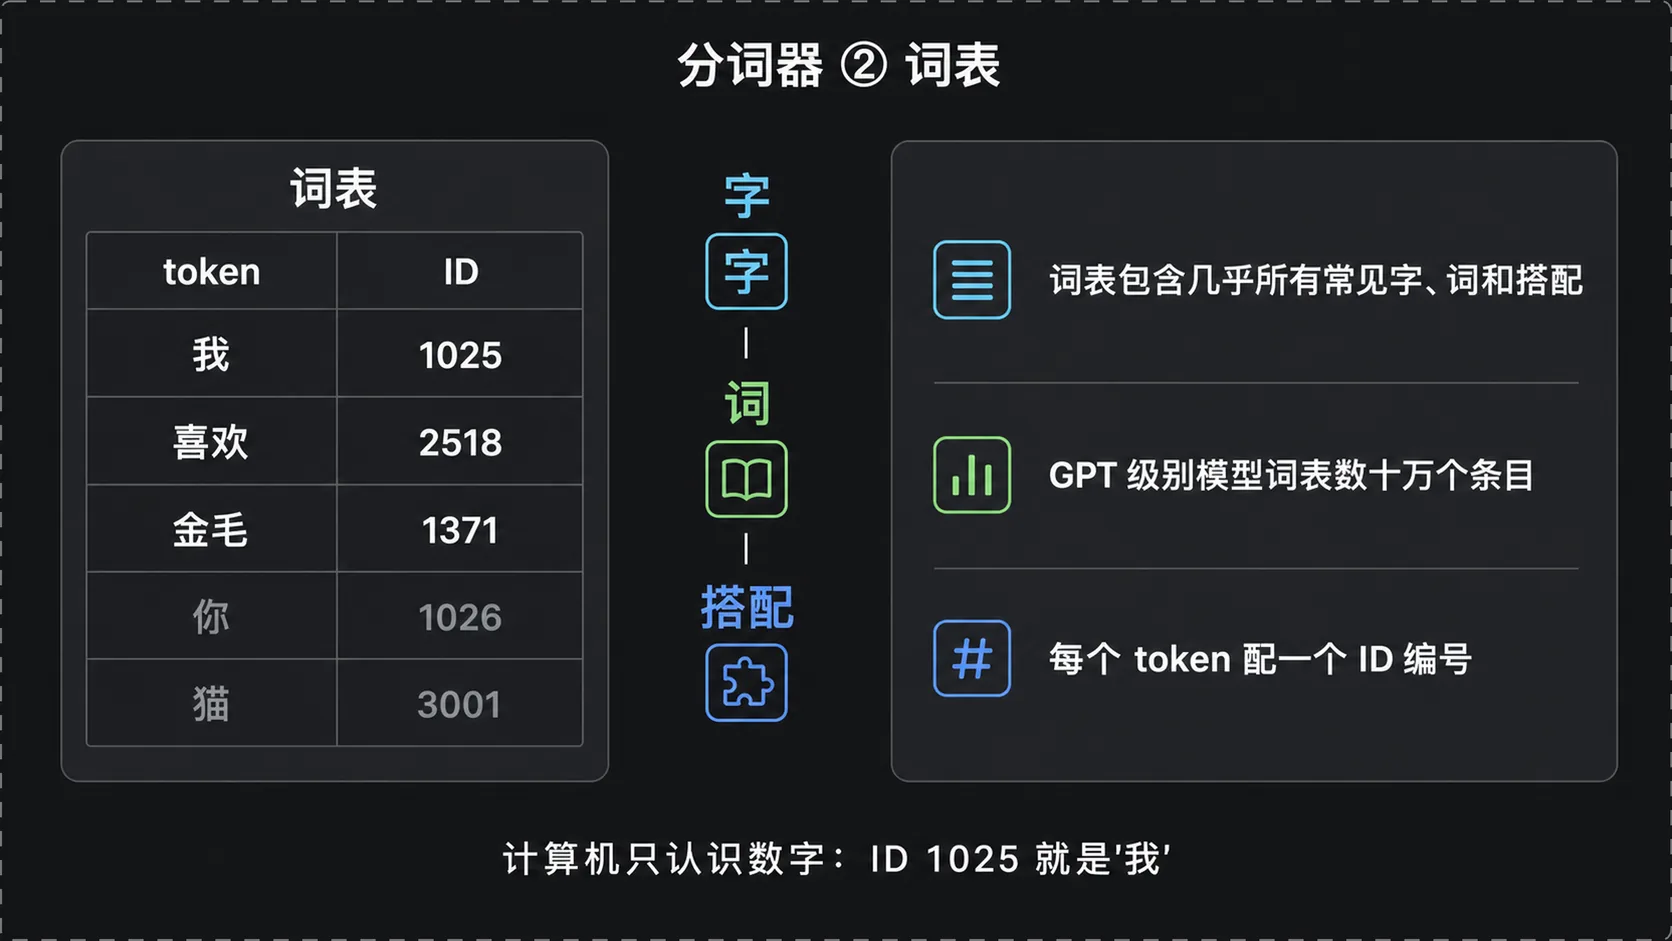
第二件是建立词表。词表收录几乎所有常见的字、词和搭配,每个条目包含两部分内容,token 本身与它的 ID 编号。GPT 这类大模型的词表一般有数十万个条目。
数十万这个量级要覆盖的东西不少:常用字、常用词、高频搭配,还要给没被收录的生僻内容留下退路,遇上词表里查不到的组合,仍要能拆成更小的单位处理。
3.3 计算机只认识数字
给 token 分配 ID 的理由很实际:计算机认的是数字。有了编号,程序看到 1025 就知道对应「我」这个字,看到 2518 就知道对应「喜欢」。
分词的完整过程因此是这样:所有资料按照合并规则切分成一个个 token,再根据词表给每个 token 配上 ID。用代码表达这两步,大致是下面的形状。
# 合并规则:训练分词器时从语料里学到的高频搭配merge_rules = ["喜欢", "金毛"] # 这些字组合出现频繁,切分时当作一个整体 # 词表:token 与 ID 编号的对应关系,真实词表有数十万条vocab = {"我": 1025, "喜欢": 2518, "金毛": 1371} def tokenize(text): tokens, i = [], 0 # tokens 存切分结果,i 是扫描位置 while i < len(text): # 从左往右扫描整句话 hit = None # 记录本次是否命中合并规则 for rule in merge_rules: # 逐条比对合并规则 if text.startswith(rule, i):# 当前位置能匹配上某条规则 hit = rule # 命中,这几个字合并成一个 token break if hit is None: # 没有命中任何规则 hit = text[i] # 就退回到单个字作为一个 token tokens.append(hit) # 收下这个 token i += len(hit) # 扫描位置向后移动它的长度 return [(t, vocab[t]) for t in tokens] # 查词表,给每个 token 配上 ID tokenize("我喜欢金毛") # 得到 [('我',1025), ('喜欢',2518), ('金毛',1371)]3.4 插曲:AI 为什么写不出精确的 100 字
让 AI「写一篇 100 字的短文」,字数往往对不上。原因就落在 token 上。
模型处理文字的最小单位是 token 而不是字,它生成回答时一个 token 一个 token 地往外吐,每个 token 具体对应几个字,模型自己并不掌握。要凑够 100 个字,它做的是估算:100 个字大概需要多少个 token。估算带来的偏差,直接体现成最后的字数不准。
同一类偏差还会出现在别处。凡是要求模型对字符做精确计数的任务,它面对的都是同一个障碍:它看到的是 token,不是字。
了解这类底层原理的意义也在这里。普通人不需要像研究者那样去啃复杂技术,知道 AI 为什么能做某些事、又为什么做不好另一些事,使用时就能绕开无谓的尝试,把要求换成模型擅长的表述方式。
四、第三步:嵌入(Embedding)
4.1 把 token 转换为高维向量
分词结束时,一句话已经变成了一串编号。编号解决了「计算机能不能读」的问题,还没解决「计算机能不能理解含义」的问题。1025 和 2518 之间的数值差距,与「我」和「喜欢」的语义关系没有任何关联。
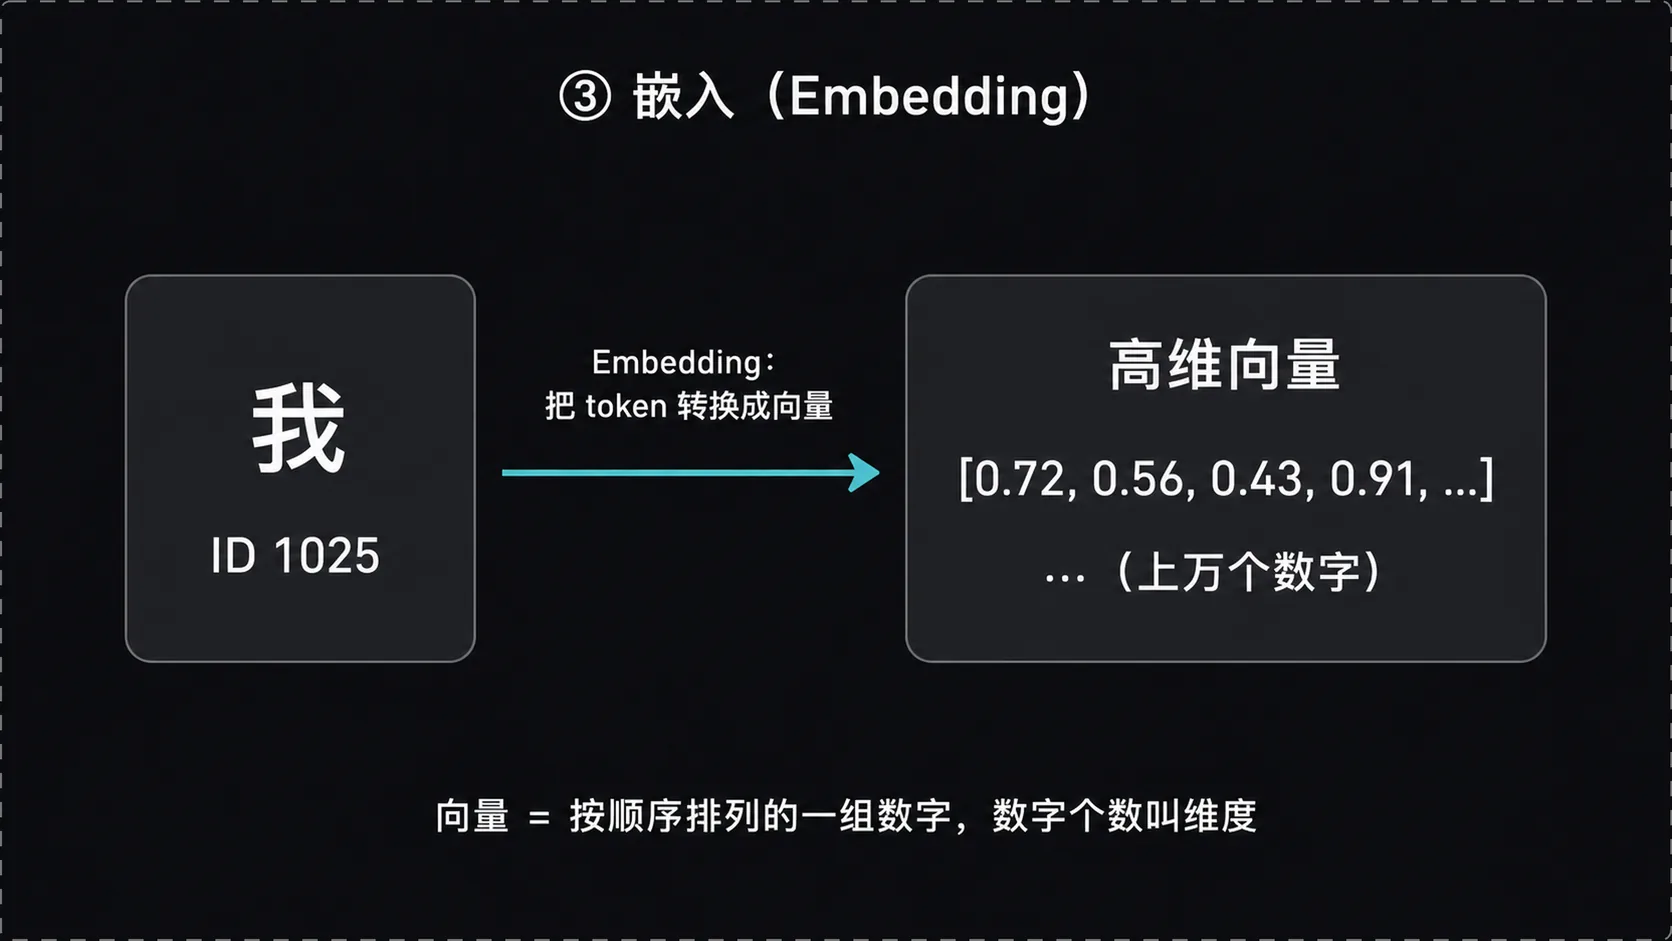
嵌入这一步把每个 token 转换成一个高维向量。
4.2 向量与维度
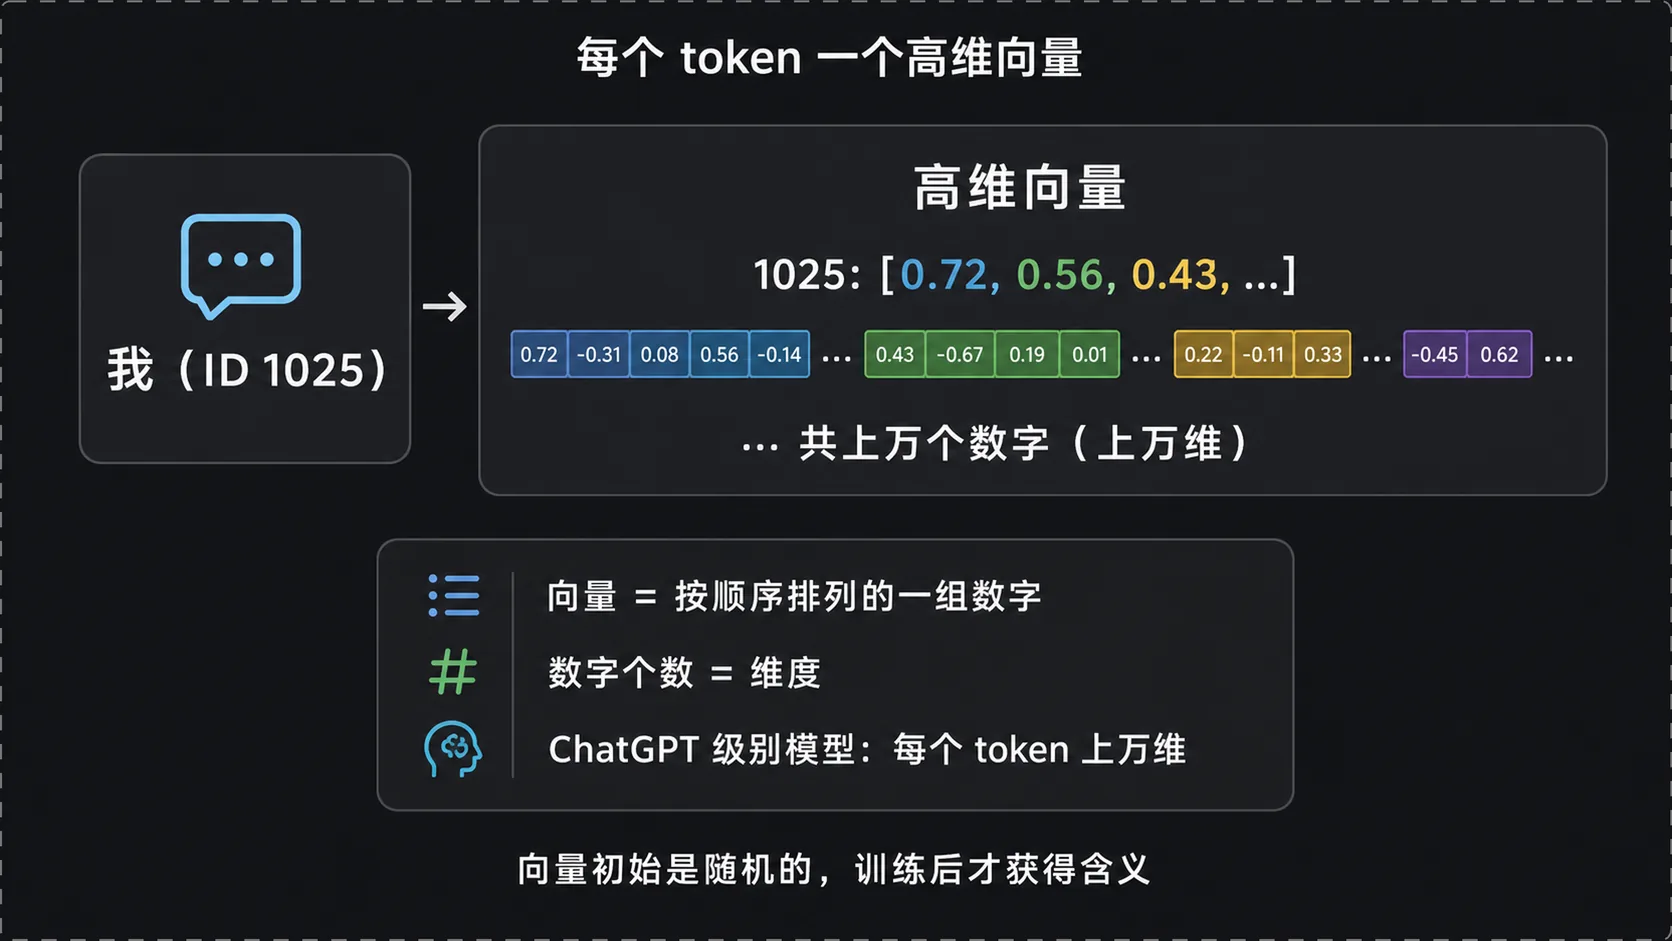
向量就是一组按顺序排列的数字集合,形如 [0.72, 0.56, 0.43, ...]。里面有多少个数字,就叫多少维。
ChatGPT 这类大模型可能把每个 token 表示成上万个小数组成的向量。ID 为 1025 的「我」,在模型内部对应的就是这样一个上万维的向量。
# 简化示意,非真实实现import random DIM = 8 # 演示用 8 维,真实模型可能上万维 # 嵌入表:每个 token ID 对应一个向量,初始值随机生成embedding_table = { tid: [round(random.random(), 2) for _ in range(DIM)] # 生成 DIM 个随机小数 for tid in (1025, 2518, 1371) # 分别对应 我 / 喜欢 / 金毛} def embed(token_ids): # 按 ID 到嵌入表里查向量,这一步叫 embedding lookup return [embedding_table[tid] for tid in token_ids] embed([1025, 2518, 1371]) # 一句话由此变成三个向量组成的序列# 此刻这些数字还没有含义,含义要等预训练阶段才被调出来4.3 为什么要用上万个数字表示一个词
计算机没法像人那样直接理解「我喜欢」这几个字的含义,它能做的运算都是数字运算,词的含义也就只能用数字来表达。
一个词承载的含义和联系数量可观。「喜欢」牵扯到情感强度、态度倾向,还和大量其他词存在关联。把这些含义与联系量化下来,一个数字远远不够,于是用一整组数字,每一维分担一部分信息。
维度多带来的是表达空间。上万个数字排在一起,能容纳的区分方式远超过一两个指标,词与词之间那些细微的差别才有地方安放。
向量在初始建立时是随机的。这时候的数字没有任何语义,仅仅是占了个位置,等着后面的预训练把它们调整成有含义的数值。
4.4 训练之后,数字里才有语义
预训练结束后,向量之间的数值关系开始对应语义关系。
「再见」和「拜拜」含义接近,它们的向量在数字上也比较接近。「小猫」和「小狗」指的不是同一种动物,但都和动物这个概念相关,向量的某些维度就会呈现出相似的取值,画面里用「有毛发」「玩伴」这类维度做了示意。
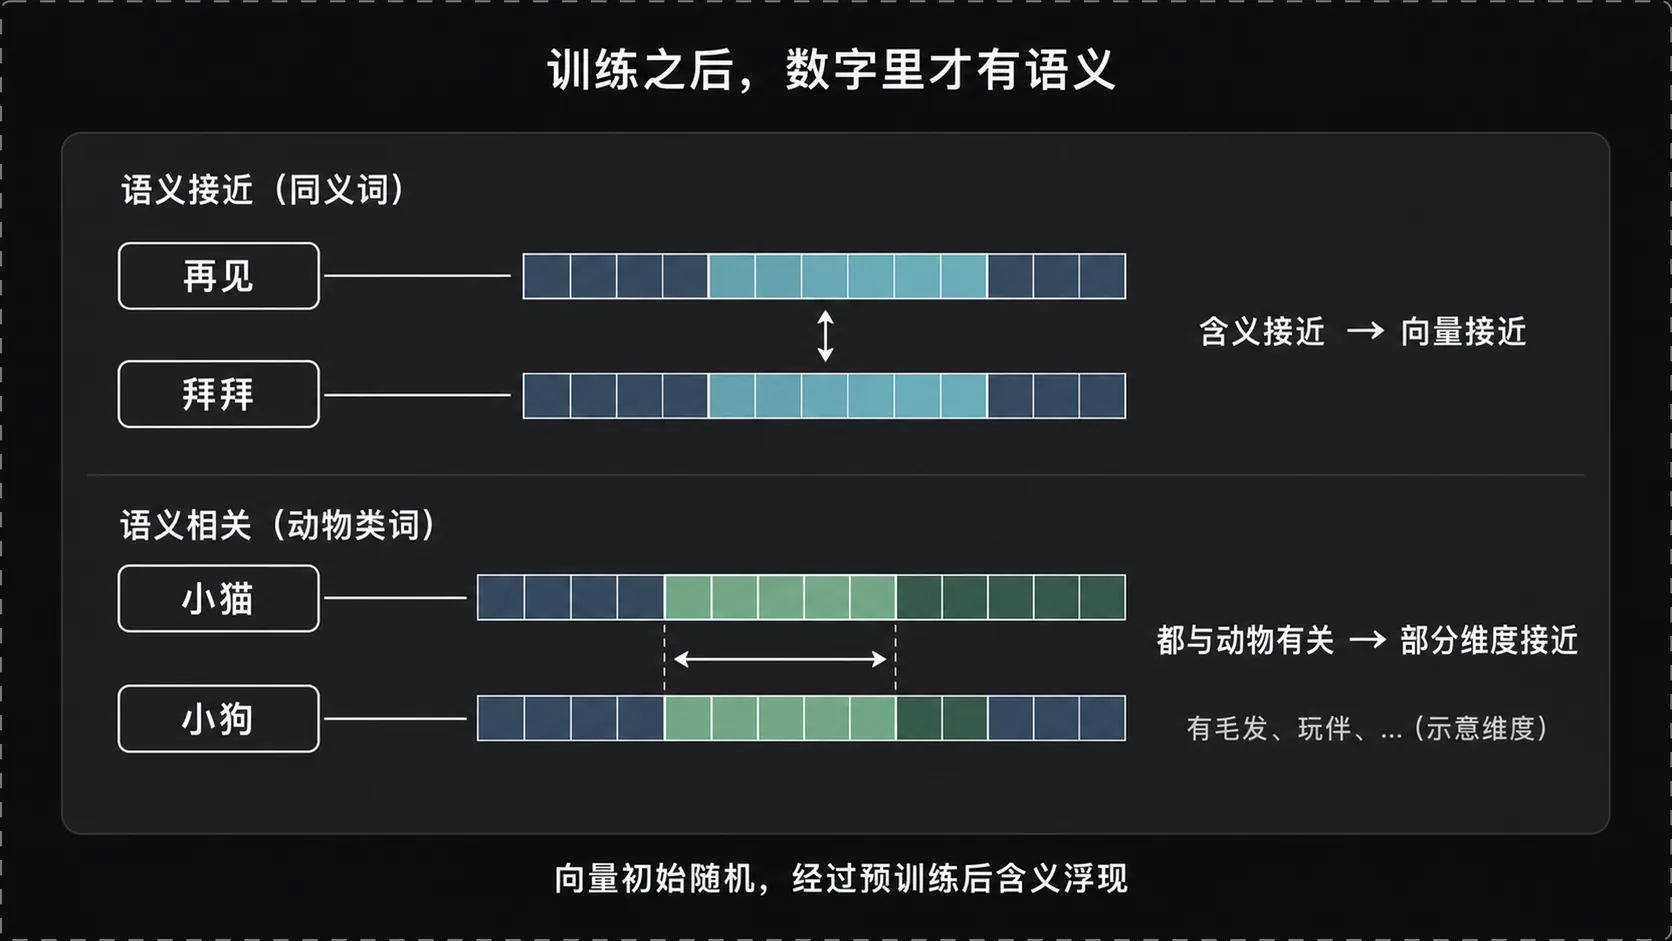
语义的相似程度,到这一步变成了向量之间可以计算的距离。模型后续的一切判断,都建立在这套数字表示上。
回头看嵌入这一步的位置:它在数据准备阶段搭好了容器,容器里装什么,由预训练决定。
五、总结
数据准备把一堆人类文字变成了一堆可计算的数字,路径是三段:
- 从网页、书籍、论文、代码里收集海量语料并清洗掉重复、垃圾与违规内容,得到干净的文本;
- 用分词器按合并规则把文本切成 token,再依据词表给每个 token 配上 ID;
- 最后为每个 ID 分配一个初始随机的高维向量。
此时的模型还什么都不会,向量里的数字全是随机值。让这些数字获得含义的过程,属于下一个阶段:预训练。
本文由 AgentPlanFlow 生成