
文章内容
本章节目标:
- 用循环控制重复执行的流程
- 用数组或
vector连续存放数据 - 用位运算拆分和重组二进制位。
三者合在一起,完成一个可运行的 Base16 编码与解码程序。
一、批量任务:用 for 驱动确定次数
1.1 初始化、条件与迭代
for 适合循环次数已知,或需要沿着下标、迭代器逐项访问数据的任务。它的括号内有三个部分:初始化只在进入循环时执行一次;条件在每轮开始前判断;迭代在循环体完成后执行。条件为假时,循环立即结束。
初始化部分定义的变量属于 for 语句的作用域。在现代 C++ 中,循环结束后不能继续访问这里的 i。循环体内部定义的局部变量则会在每轮进入代码块时重新创建。
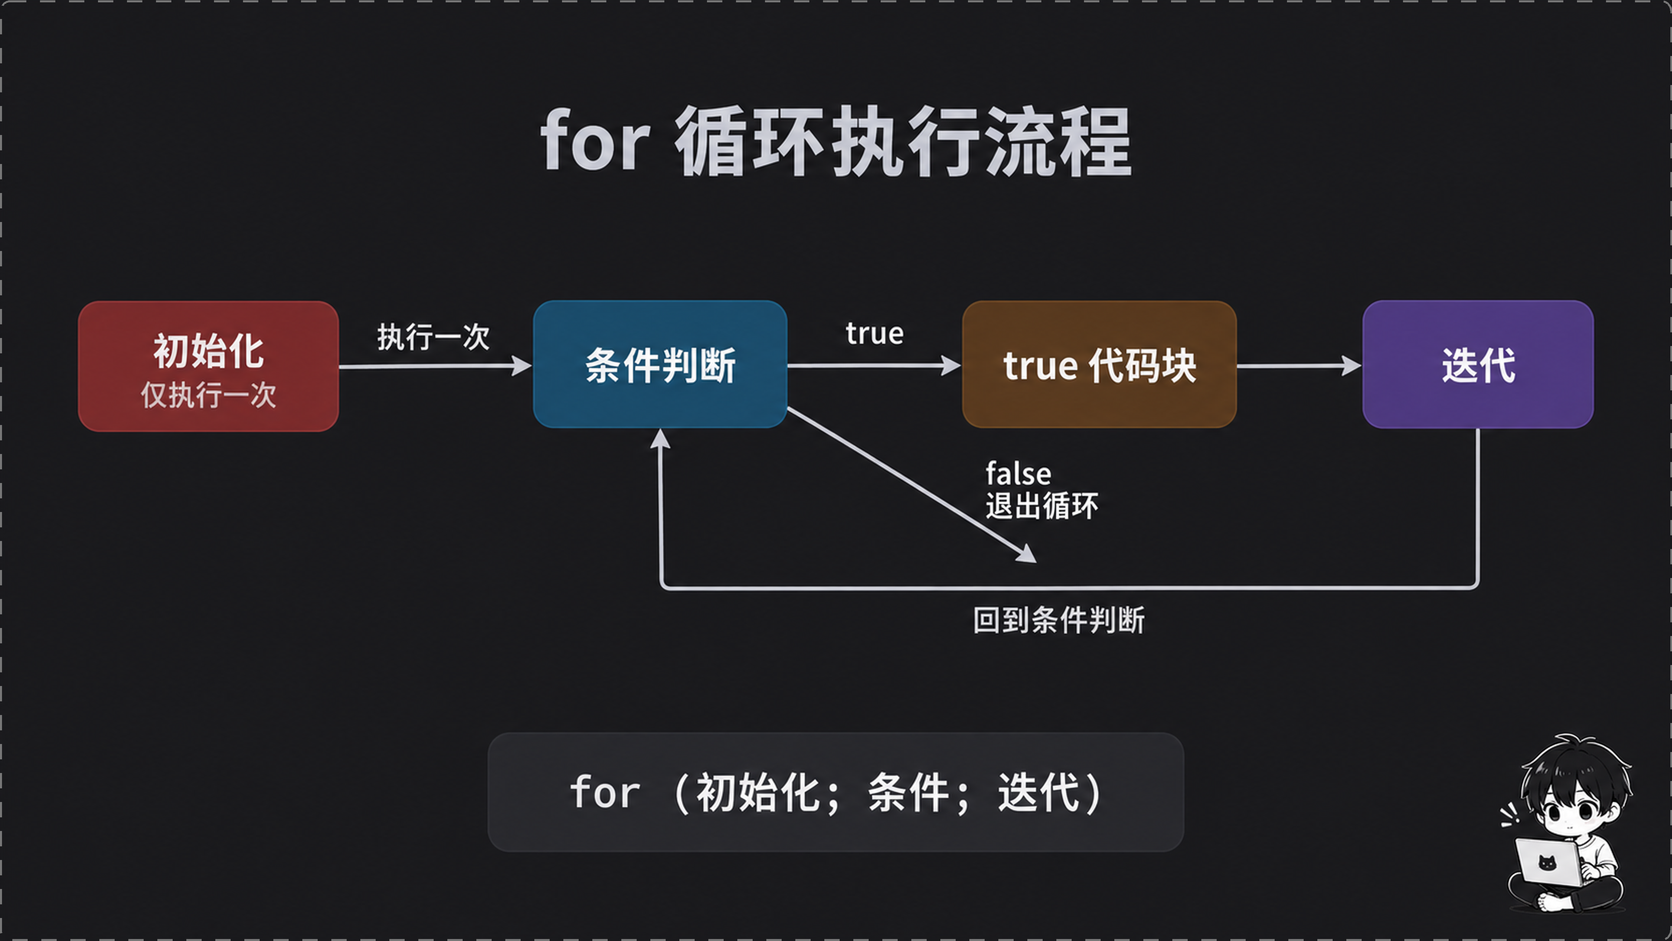
下面的课件代码先输出 0 到 9,再用 continue 跳过偶数。
第二段代码先输出奇数,再判断它是否大于 50,因此会在输出 51 后执行 break。
// 代码位置 1test_for.cpp 第 10—29 行 // 包含输入输出流头文件 #include <iostream> // 使用标准命名空间中的名称 using namespace std; // 定义程序入口并接收参数与环境变量 int main(int argc, char* argv[], char* env[]) // 开始主函数体 { // 依次令 i 取零到九 for (int i = 0; i < 10; i++) // 开始基础循环体 { // 输出当前下标 cout << "i = " << i << endl; // 结束基础循环体 } // 遍历零到九十九 for (int i = 0; i < 100; i++) // 开始流程控制示例 { // 判断当前数是否为偶数 if (i % 2 == 0) // 跳过本轮剩余语句 continue; // 输出没有被跳过的奇数 cout << i << " "; // 判断当前奇数是否已经超过五十 if (i > 50) // 结束整个循环 break; // 结束流程控制示例 } // 输出换行 cout << endl;实际编译运行(g++ -std=c++14)得到的输出:
i = 0i = 1i = 2i = 3i = 4i = 5i = 6i = 7i = 8i = 91 3 5 7 9 11 13 15 17 19 21 23 25 27 29 31 33 35 37 39 41 43 45 47 49 51第一段没有外部输入,输出为 i = 0 到 i = 9。第二段输出 1 3 5 ... 49 51。其中,continue 只结束当前轮,仍会执行 for 的迭代表达式;break 会越过迭代,直接离开循环。
1.2 嵌套、无限循环与环境变量
双层循环可以把行、列两个维度映射为一组坐标,常见于矩阵和图像像素处理。嵌套太深会使分支和状态难以追踪,此时可将内层逻辑提取为独立函数。
for (;;) 省略三个表达式后成为无限循环,因此循环体必须提供可靠的退出路径。
主函数的第三个参数 env 是课件所用实现提供的环境变量指针数组,以空指针结束。
// 代码位置 1test_for.cpp 第 31—55 行 // 遍历三行 for (int i = 0; i < 3; i++) // 开始外层循环体 { // 遍历当前行的三列 for (int j = 0; j < 3; j++) // 开始内层循环体 { // 输出行列坐标 cout << i << "-" << j << " "; // 结束内层循环体 } // 每行结束后换行 cout << endl; // 结束外层循环体 } // 在矩阵输出后再换一行 cout << endl; // 初始化无限循环的计数器 int index = 0; // 建立无限循环 for (;;) // 开始无限循环体 { // 判断计数器是否越过十 if (index > 10) // 满足退出条件时结束循环 break; // 输出当前计数器 cout << "index:" << index << endl; // 推进计数器 index++; // 结束无限循环体 } // 遍历以空指针结尾的环境变量数组 for (int i = 0; env[i] != nullptr; i++) // 开始环境变量循环体 { // 输出一条环境变量字符串 cout << env[i] << endl; // 结束环境变量循环体 }实际编译运行输出(环境变量部分因机器而异,仅截取矩阵与无限循环部分):
0-0 0-1 0-21-0 1-1 1-22-0 2-1 2-2 index:0index:1index:2index:3index:4index:5index:6index:7index:8index:9index:10嵌套循环输出九组 行-列 坐标;无限循环输出 index:0 到 index:10,随后由 break 结束。最后一段逐项输出当前进程收到的环境变量,数量由末尾的 nullptr 决定。
二、while 表达式
2.1 条件、退出标志与条件表达式
while 只有条件,没有专门的初始化与迭代位置。它更适合命令循环、消息循环这类无法预先确定次数的任务。continue 会直接回到条件判断,因此若计数器更新写在循环体尾部,前面的 continue 可能使更新永远无法执行。
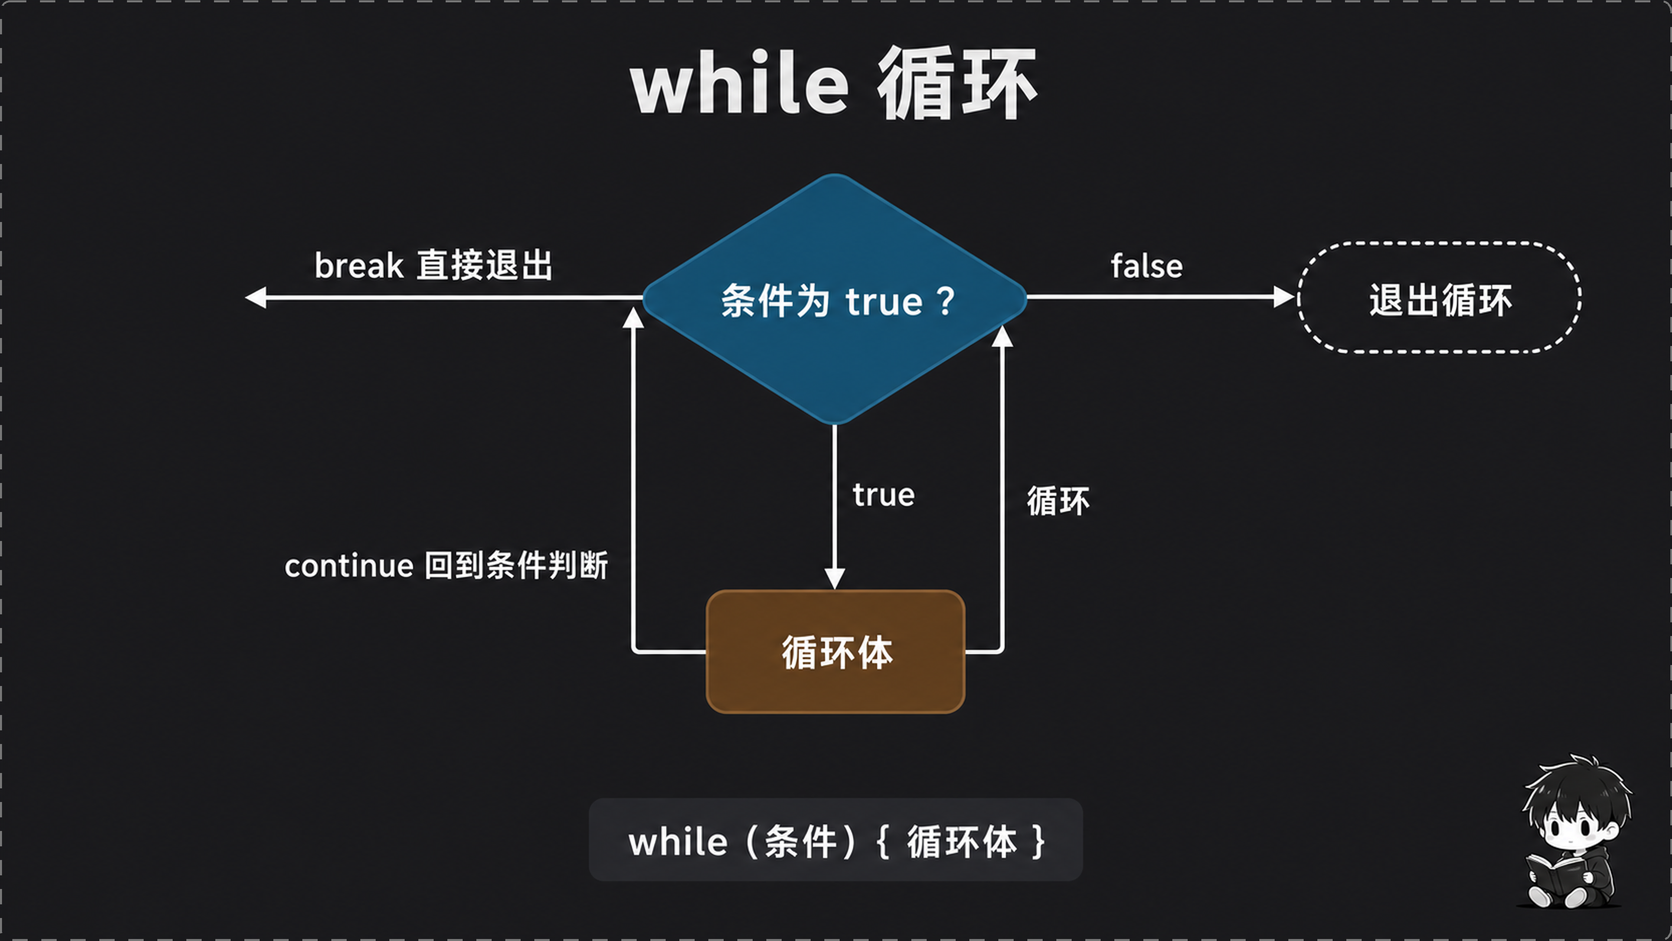
示例代码:
// 代码位置 2test_while.cpp 第 78—116 行 // 初始化循环计数器 int index{ 0 }; // 建立常量条件的无限循环 while (1) // 开始无限循环体 { // 先增加计数器 index++; // 判断计数器是否为偶数 if (index % 2 == 0) // 偶数直接进入下一轮 continue; // 判断奇数是否已经超过十 if (index > 10) // 结束无限循环 break; // 输出不大于十的奇数 cout << index << " "; // 结束无限循环体 } // 输出换行 cout << endl; // 初始化退出标志 bool is_exit{ false }; // 重置计数器 index = 0; // 在退出标志为假时循环 while (!is_exit) // 开始标志控制的循环体 { // 增加计数器 index++; // 判断计数器是否超过十 if (index > 10) // 设置退出标志 is_exit = true; // 输出本轮计数器 cout << index << " "; // 结束标志控制的循环体 } // 输出换行 cout << endl; // 重置计数器 index = 0; // 先取 index 的旧值比较,再执行自增 while (index++ < 10) // 输出已经自增后的值 cout << index << " "; // 输出换行 cout << endl; // 再次重置计数器 index = 0; // 先自增,再把新值用于比较 while (++index < 10) // 输出满足条件的新值 cout << index << " "; // 输出换行 cout << endl; // 重置计数器 index = 0; // 每次判断时声明 i,并以非零值表示真 while (int i = ++index) // 开始带条件声明的循环体 { // 输出当前计数器 cout << index << " "; // 判断本轮的 i 是否超过十 if (i > 10) // 主动结束循环 break; // 结束带条件声明的循环体 } // 输出换行 cout << endl;编译运行输出:
1 3 5 7 91 2 3 4 5 6 7 8 9 10 111 2 3 4 5 6 7 8 9 101 2 3 4 5 6 7 8 91 2 3 4 5 6 7 8 9 10 112.2 一个支持 ls 的最小 shell
这个练习把 while 用作命令主循环:读取命令,识别 ls,将其改写为 Windows 的 dir,再交给 system 执行;输入 exit 或 quit 后设置退出标志。
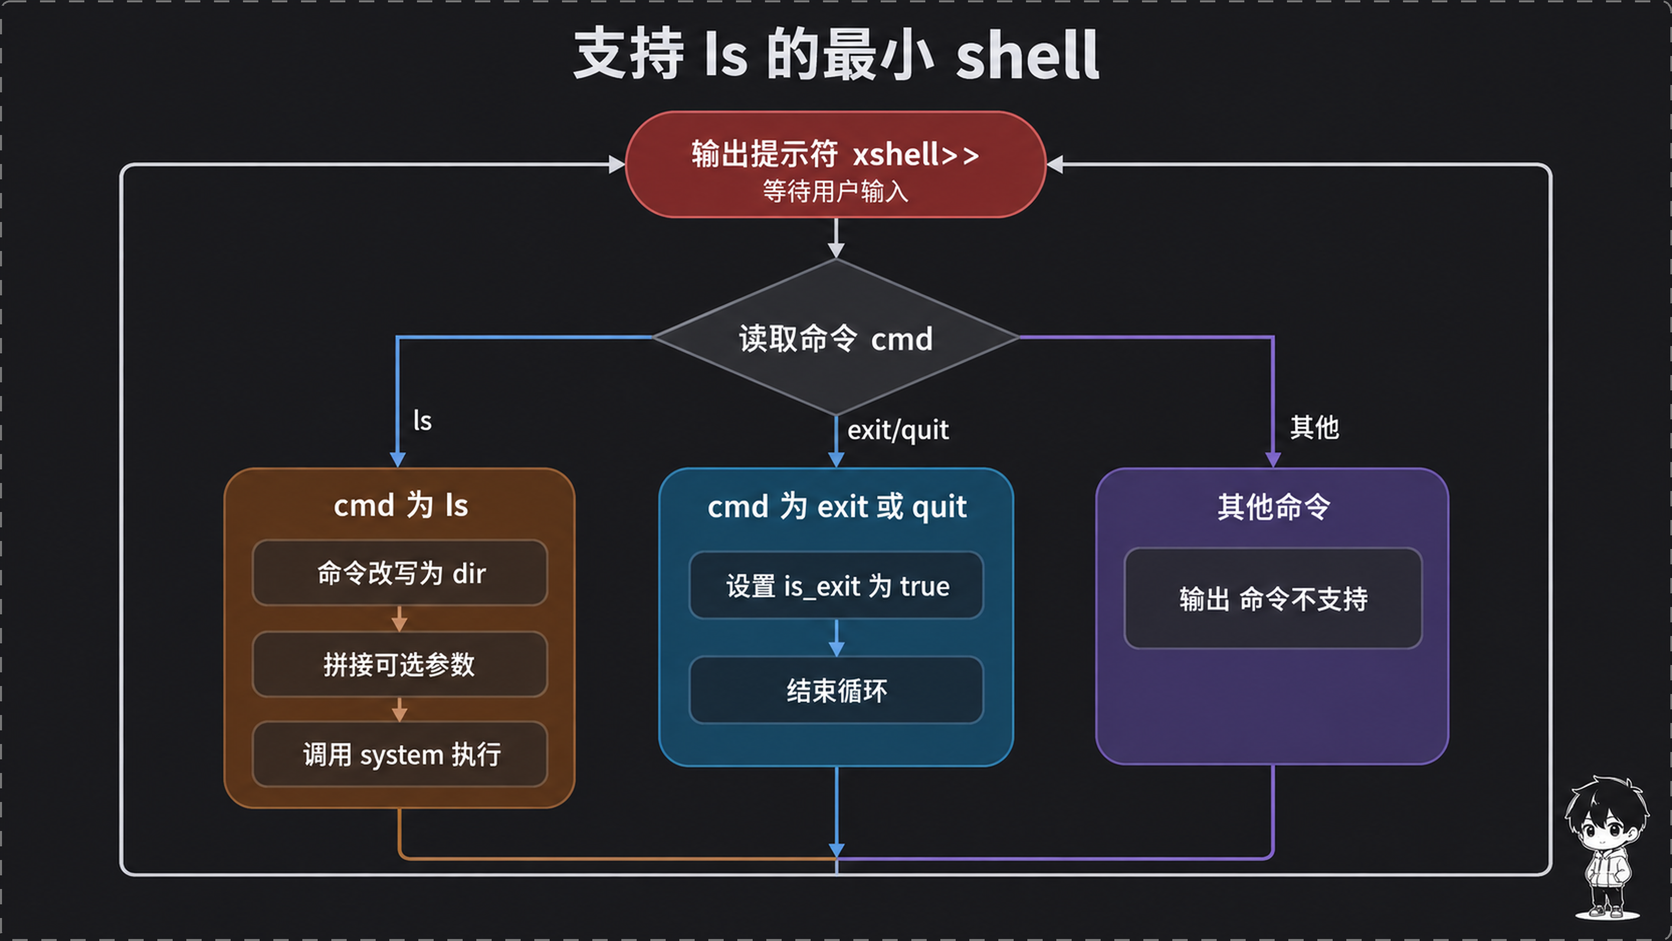
// 代码位置 2test_while.cpp 第 10—54 行 // 包含输入输出流头文件 #include <iostream> // 包含字符串类型头文件 #include <string> // 使用标准命名空间中的名称 using namespace std; // 定义程序入口 int main() // 开始主函数体 { // 建立局部作用域隔离 shell 变量 { // 初始化退出标志 bool is_exit{ false }; // 未收到退出命令时持续读取 while (!is_exit) // 开始命令循环体 { // 保存用户输入的命令名 string cmd; // 保存交给系统执行的命令 string execcmd; // 输出 shell 提示符 std::cout << "xshell>>"; // 读取第一个以空白分隔的单词 std::cin >> cmd; // 判断是否为 ls 命令 if (cmd == "ls") // 开始 ls 分支 { // 将 ls 映射为 Windows 的 dir execcmd = "dir"; // 保存可选参数 string arg; // 检查缓冲区中是否还有换行之外的内容 if (std::cin.rdbuf()->in_avail() > 1) // 开始参数读取分支 { // 读取一个参数 std::cin >> arg; // 将参数拼接到 dir 后面 execcmd += " " + arg; // 结束参数读取分支 } // 把 C++ 字符串转换为 C 字符串并执行 system(execcmd.c_str()); // 结束 ls 分支 } // 判断是否为两种退出命令之一 else if (cmd == "exit" || cmd == "quit") // 开始退出分支 { // 请求循环在下一次判断时退出 is_exit = true; // 跳过本轮剩余逻辑 continue; // 结束退出分支 } // 处理不支持的命令 else // 开始错误分支 { // 向标准错误输出提示 cerr << "命令" << cmd << "不支持!" << endl; // 结束错误分支 } // 结束命令循环体 } // 结束局部作用域 } // 正常结束程序 return 0; // main() 的收尾大括号实际在源文件第 117 行,中间是课件保留的早期练习代码输入 ls 时,execcmd 变成 dir。输入 ls C:\\ 时,示例试图组成 dir C:\\;输入 exit 或 quit 时循环结束。
三、数组:连续内存上的批量数据
3.1 地址、下标
数组是一段连续内存。已知首地址、元素类型和元素数量后,程序可以计算任意元素的位置:&arr[i] 等价于 arr + i,实际字节偏移是 i * sizeof(元素类型)。C++ 数组下标从 0 开始。
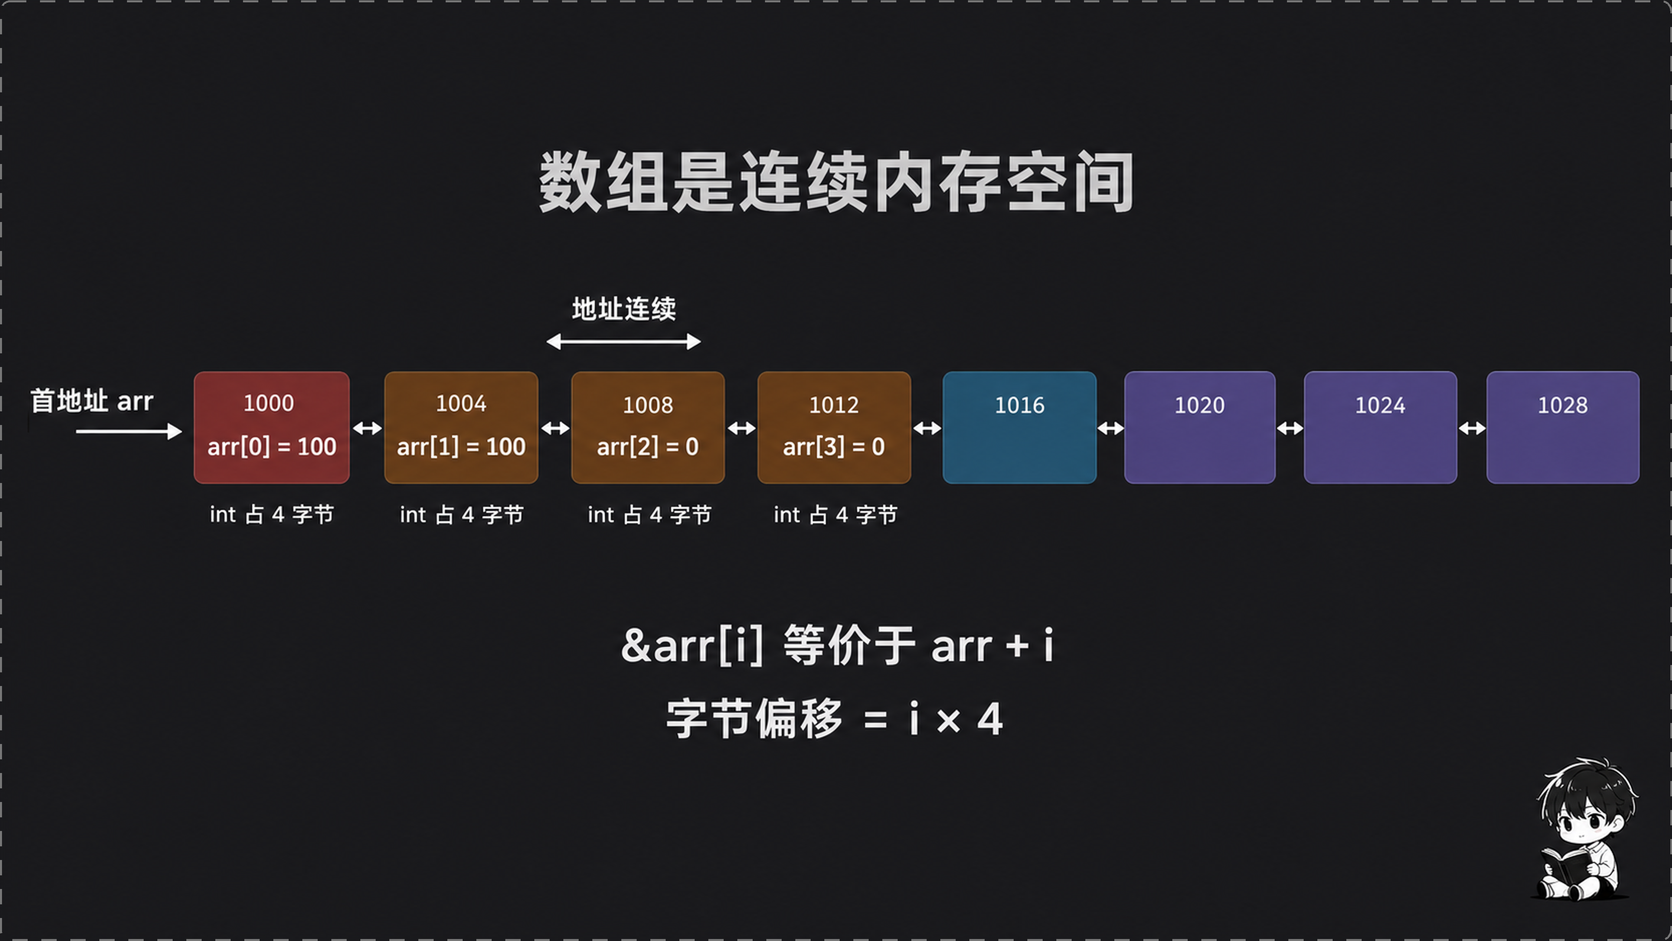
固定大小的局部数组随作用域结束而销毁;new[] 取得的动态数组必须配对 delete[];vector 自己管理动态存储,并提供大小、容量和增删接口。
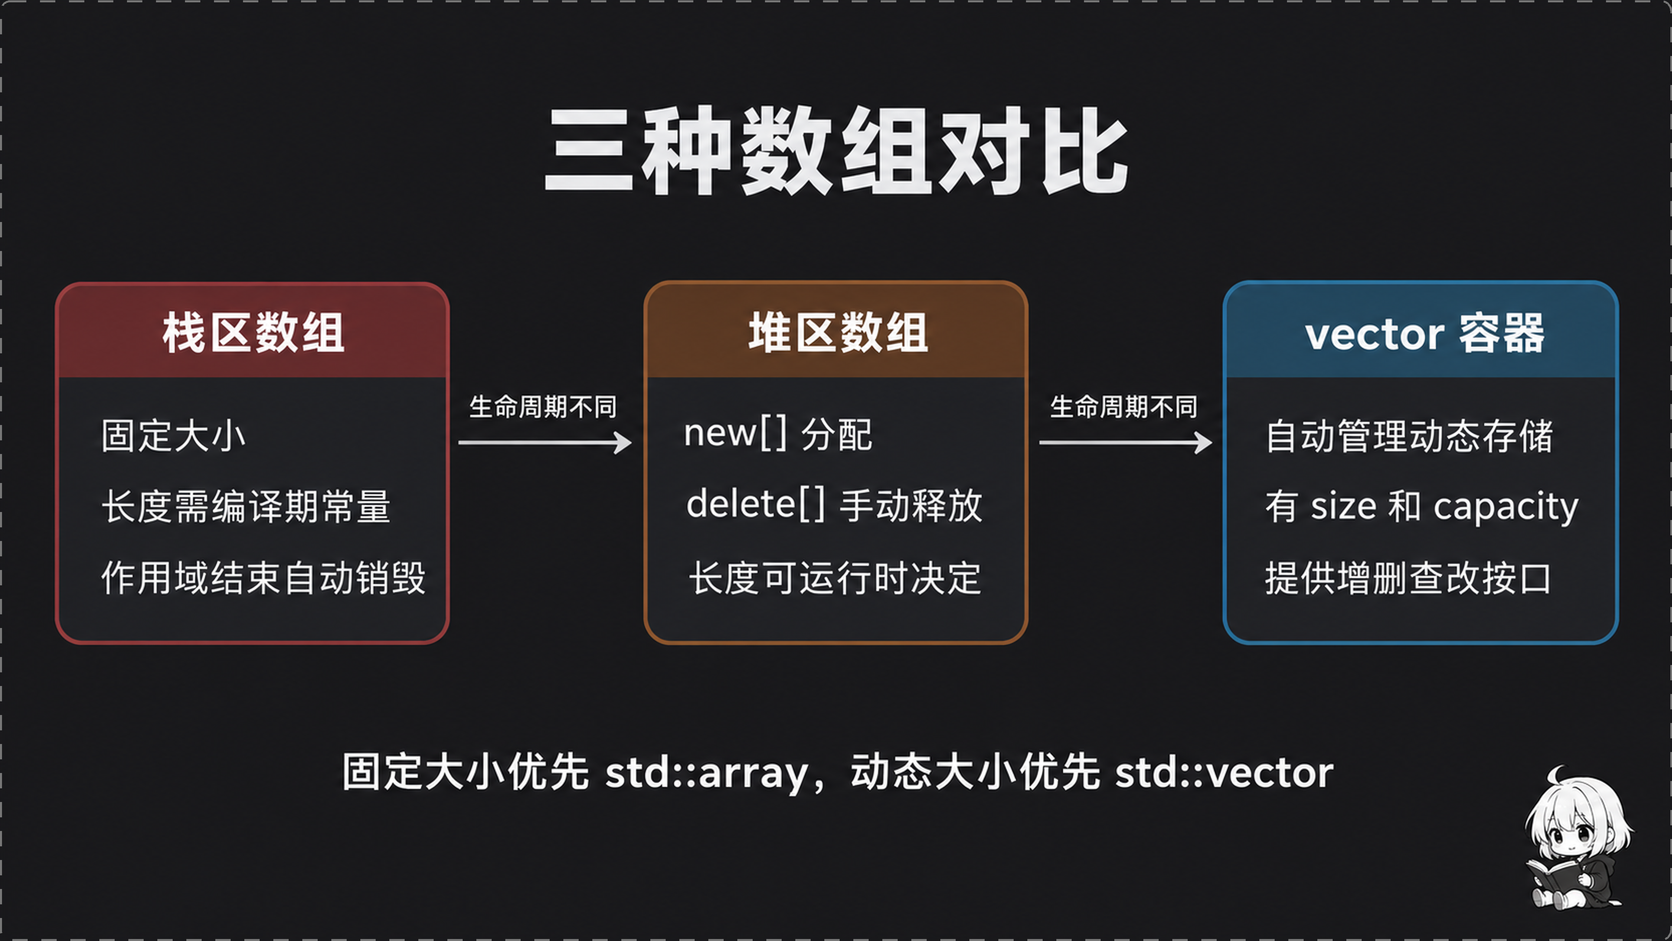
3.2 栈区数组
固定数组的长度必须是编译期常量表达式,变长数组不属于标准 C++。sizeof(arr1) 在数组尚未退化为指针时得到整个数组的字节数,因此可用总字节数除以单个元素字节数计算元素数量。
课件在数组长度之外,还对比了三种"看起来都像常量"的写法:const int csize = 5 由常量表达式初始化,可用于数组长度;constexpr int cesize = 5 是显式的编译期常量,同样可用;const int csize2 = size 由运行时变量 size 初始化,标准 C++ 不把它视为常量表达式,不能用于数组长度——所以源码只拿 csize 和 cesize 定义数组,没有用 csize2。
// 代码位置 3test_arr.cpp 第 11—74 行 // 包含输入输出流头文件 #include <iostream> // 使用标准命名空间中的名称 using namespace std; // 定义程序入口 int main() // 开始主函数体 { // 建立栈区数组示例的作用域 { // 定义四个元素并全部初始化为零 int arr1[4]{ 0 }; // 按值遍历数组元素 for (int a : arr1) // 输出当前元素 cout << a << " "; // 输出换行 cout << endl; // 修改第一个元素 arr1[0] = 99; // 修改第三个元素 arr1[2] = 88; // 再次按值遍历数组 for (int a : arr1) // 输出修改后的元素 cout << a << " "; // 输出换行 cout << endl; // 输出整个数组占用的字节数 cout << "sizeof(arr1) = " << sizeof(arr1) << endl; // 根据总字节数计算元素数量 for (int i = 0; i < sizeof(arr1) / sizeof(int); i++) // 开始下标遍历 { // 输出当前下标对应的元素 cout << arr1[i] << ","; // 结束下标遍历 } // 输出换行 cout << endl; // 定义未初始化的局部数组 int arr2[4]; // 按值遍历未初始化数组 for (int a : arr2) // 输出不确定值仅用于演示 cout << a << " "; // 输出换行 cout << endl; // 定义运行时变量 int size = 5; // 定义可作常量表达式的长度 const int csize = 5; // 定义由运行时值初始化的常量 const int csize2 = size; // 定义显式编译期常量 constexpr int cesize = 5; // 使用编译期常量定义数组 int arr3[csize]; // 使用 constexpr 常量定义数组 int arr4[cesize]; // 用部分初值初始化十个元素 int arr5[10] = { 1, 2, 3, 4, 5 }; // 由初值数量推导数组长度 int arr6[] = { 3, 4, 5, 6, 7, 8 }; // 定义包含字符串终止符的字符数组 char arr7[] = "test string"; // 输出 arr6 的总字节数 cout << "sizeof(arr6) = " << sizeof(arr6) << endl; // 输出 arr7 的总字节数 cout << "sizeof(arr7) = " << sizeof(arr7) << endl; // 输出数组首地址 cout << "arr1 = " << (long long)arr1 << endl; // 输出第一个元素地址 cout << "&arr1[0] = " << (long long)&arr1[0] << endl; // 输出第二个元素地址 cout << "&arr1[1] = " << (long long)&arr1[1] << endl; // 输出第三个元素地址 cout << "&arr1[2] = " << (long long)&arr1[2] << endl; // 输出第四个元素地址 cout << "&arr1[3] = " << (long long)&arr1[3] << endl; // 输出向后移动两个元素后的地址 cout << "arr1 + 2 = " << (long long)(arr1 + 2) << endl; // 输出向后移动三个元素后的地址 cout << "arr1 + 3 = " << (long long)(arr1 + 3) << endl; // 解引用第三个元素的位置 cout << "*(arr1 + 2) = " << *(arr1 + 2) << endl; // 结束栈区数组作用域 }编译运行(g++ -std=c++14):
0 0 0 099 0 88 0sizeof(arr1) = 1699,0,88,0,2135110968 32764 -2042182760 28896sizeof(arr6) = 24sizeof(arr7) = 12arr1 = 140722443596672&arr1[0] = 140722443596672&arr1[1] = 140722443596676&arr1[2] = 140722443596680&arr1[3] = 140722443596684arr1 + 2 = 140722443596680arr1 + 3 = 140722443596684*(arr1 + 2) = 88arr2 那一行的四个数字就是读取未初始化内存得到的垃圾值,每次运行、每台机器都可能不同;地址那几行同理,仅反映本次运行时的栈布局,不具有可重复性,列出只是为了验证相邻元素地址确实按 sizeof(int)(这里是 4 字节)递增。
arr1 初始输出四个 0,修改后输出 99 0 88 0。在常见的四字节 int 环境中,sizeof(arr1) 是 16,相邻地址相差 4。
3.3 堆区数组与 memcpy
动态数组的长度可以在运行时决定。变量 arr1 本身是指针,所以 sizeof(arr1) 得到指针大小,并非堆上数组的总大小。释放数组时要使用 delete[];随后置为 nullptr 可以避免误把悬空指针当作有效地址继续使用。
// 代码位置 3test_arr.cpp 第 79—105 行 // 建立堆区数组示例的作用域 { // 分配四个整数并初始化为零 int* arr1 = new int[4] { 0 }; // 分配四个整数并给出初值 auto arr2 = new int[4] { 1, 2, 3, 4 }; // 输出指针变量自身的字节数 cout << "sizeof(arr1) = " << sizeof(arr1) << endl; // 定义运行时数组长度 int size = 10; // 按运行时长度分配并清零 auto arr3 = new int[size] { 0 }; // 遍历动态数组的有效下标 for (int i = 0; i < size; i++) // 开始动态数组遍历 { // 输出当前元素 cout << arr3[i] << "|"; // 结束动态数组遍历 } // 输出换行 cout << endl; // 释放第一块数组内存 delete[] arr1; // 清空第一根指针 arr1 = nullptr; // 释放第二块数组内存 delete[] arr2; // 清空第二根指针 arr2 = nullptr; // 释放第三块数组内存 delete[] arr3; // 清空第三根指针 arr3 = nullptr; // 定义复制来源数组 int arr5[5] = { 1, 2, 3, 4, 5 }; // 为复制目标分配等量空间 auto* arr6 = new int[5]; // 按来源数组的总字节数复制 memcpy(arr6, arr5, sizeof(arr5)); // 遍历复制结果 for (int i = 0; i < 5; i++) // 输出目标数组元素 cout << arr6[i] << "-"; // 输出换行 cout << endl; // 释放复制目标 delete[] arr6; // 清空目标指针 arr6 = nullptr; // 结束堆区数组作用域 }实际编译运行得到的输出:
sizeof(arr1) = 80|0|0|0|0|0|0|0|0|0|1-2-3-4-5-sizeof(arr1) 得到的是指针本身的大小(本机是 8 字节,64 位环境),并非堆上数组占用的字节数。
四、vector:自动管理动态连续空间
4.1 类型、定义与三种遍历
std::vector 是类模板,vector<int>、vector<float> 和 vector<string> 是三个不同的实际类型。它们的元素仍连续存放,但内存申请、扩容和释放由容器管理。
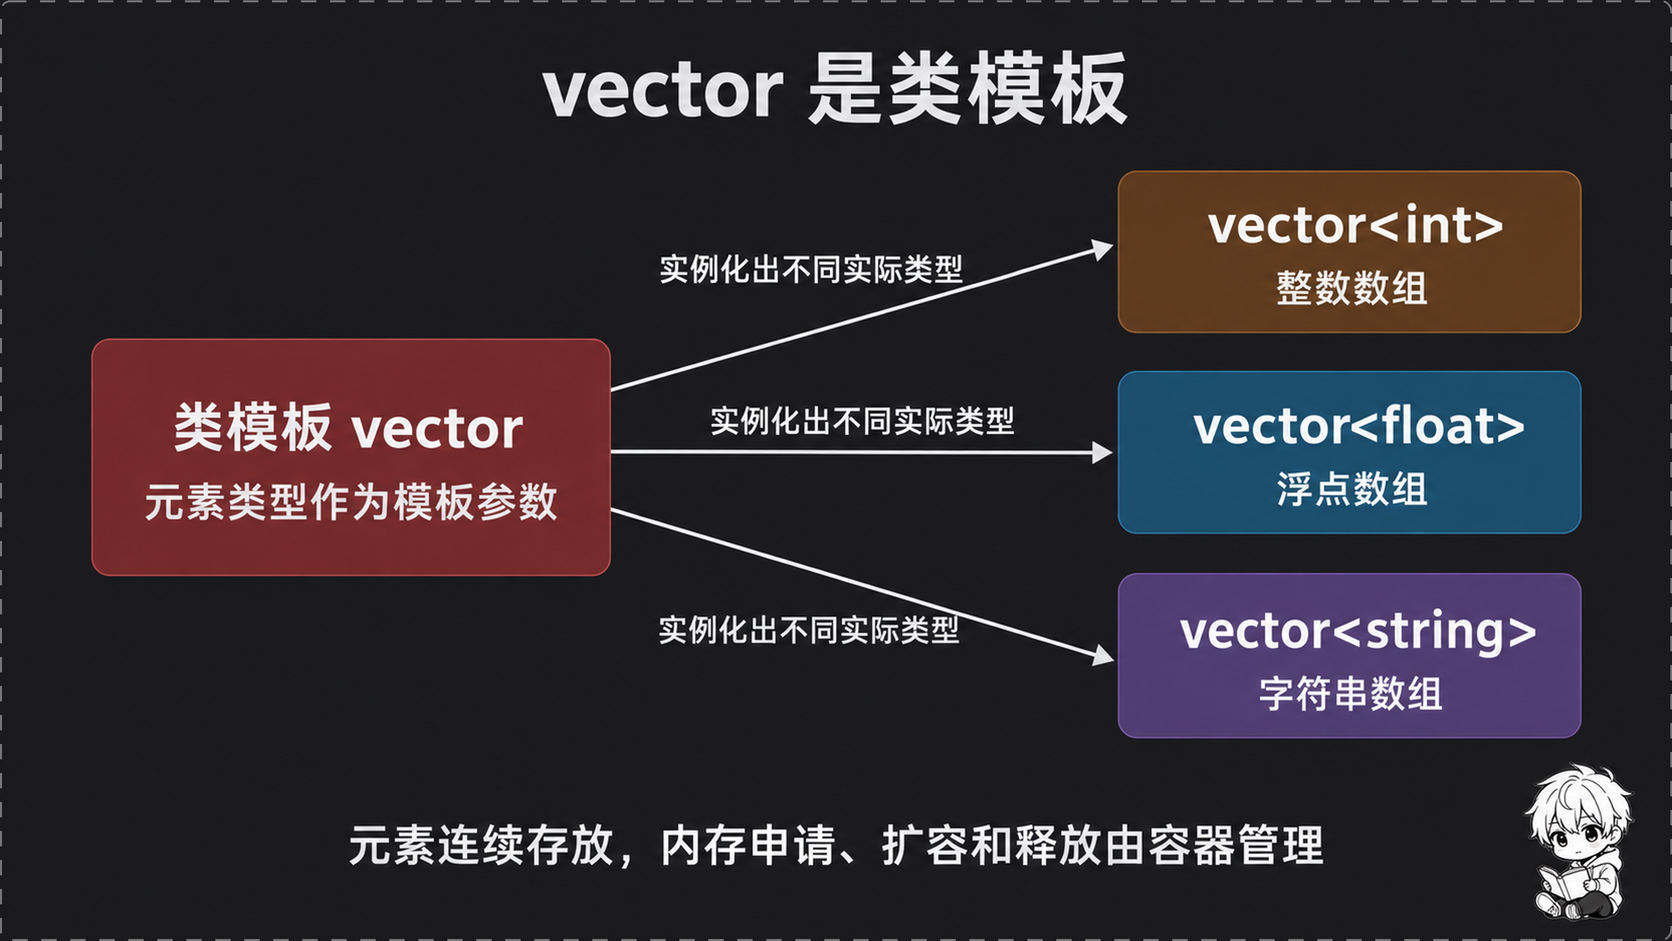
下面的代码展示空容器、指定元素数量、初始化列表和尾部插入。遍历可使用下标、迭代器或 C++11 范围 for;需要修改元素时使用引用 auto&,只读取时可用 const auto& 避免复制。
// 代码位置 4test_vector.cpp 第 2—45 行 // 包含输入输出流头文件 #include <iostream> // 包含 vector 容器头文件 #include <vector> // 包含算法头文件 #include <algorithm> // 包含字符串头文件 #include <string> // 使用标准命名空间中的名称 using namespace std; // 定义程序入口 int main() // 开始主函数体 { // 定义空的整数 vector std::vector<int> vi; // 定义空的字符串 vector vector<string> vs; // 定义空的浮点数 vector vector<float> vf; // 创建含十个零值元素的整数 vector vector<int> vd1(10); // 用初始化列表创建整数 vector vector<int> vd2{ 1, 2, 3, 4, 6 }; // 用初始化列表创建字符串 vector vector<string> vs1{ "ss1", "ss2", "ss3" }; // 建立基础操作的局部作用域 { // 定义空的数据容器 std::vector<int> datas; // 在末尾插入十 datas.push_back(10); // 在末尾插入十一 datas.push_back(11); // 在末尾插入十二 datas.push_back(12); // 通过下标修改第一个元素 datas[0] = 99; // 使用下标遍历全部元素 for (int i = 0; i < datas.size(); i++) // 输出当前下标的元素 cout << datas[i] << " "; // 输出换行 cout << "\n"; // 保存起始迭代器 std::vector<int>::iterator itr = datas.begin(); // 从起始迭代器走到尾后迭代器 for (auto itr = datas.begin(); itr != datas.end(); itr++) // 解引用并输出当前元素 cout << *itr << ","; // 输出换行 cout << "\n"; // 通过引用进行范围遍历 for (auto& d : datas) // 开始范围循环体 { // 输出当前元素 cout << d << "|"; // 结束范围循环体 } // 输出换行 cout << "\n"; // 结束基础操作作用域 }三种遍历都读取同一组状态 99、11、12,区别只在访问方式。end() 指向末尾元素之后的位置,不能解引用;循环在迭代器等于 end() 时停止。
4.2 查找、删除、插入与排序
标准算法 std::find 返回迭代器。找到元素时,迭代器减去 begin() 可得到下标;没有找到时返回 end()。erase 和 insert 会移动操作点之后的元素,并可能使已有迭代器失效。
// 代码位置 4test_vector.cpp 第 46—98 行 // 建立增删查排示例的局部作用域 { // 用初始数据创建容器 std::vector<int> datas{ // 写入第一段初始元素 7, 2, 3, 6, 5, 6, 7, 8, 0, 10, // 写入第二段初始元素 5, 12, 3312, 334, 11 // 结束初始化列表 }; // 查找第一个七 auto f = find(datas.begin(), datas.end(), 7); // 确认查找成功 if (f != datas.end()) // 开始查找成功分支 { // 输出元素值及其下标 cout << "find " << *f << " in " << f - datas.begin() << endl; // 删除找到的元素 datas.erase(f); // 结束查找成功分支 } // 查找三千三百一十二 f = find(datas.begin(), datas.end(), 3312); // 在找到的位置前插入三千三百一十一 datas.insert(f, 3311); // 在第三个位置插入九十九 datas.insert(datas.begin() + 2, 99); // 指定需要删除的数值 int fdata = 6; // 保存所有匹配位置 vector<int> datapos; // 从末尾向开头查找 for (int i = datas.size() - 1; i >= 0; i--) // 开始反向下标遍历 { // 判断当前元素是否匹配 if (datas[i] == fdata) // 开始匹配分支 { // 按从大到小的顺序保存下标 datapos.push_back(i); // 结束匹配分支 } // 结束反向下标遍历 } // 遍历已记录的位置 for (auto p : datapos) // 输出匹配位置 cout << p << " "; // 输出换行 cout << "\n"; // 按从后到前的顺序遍历位置 for (auto p : datapos) // 开始删除循环体 { // 删除对应位置的元素 datas.erase(datas.begin() + p); // 结束删除循环体 } // 遍历删除后的数据 for (auto d : datas) // 开始结果输出循环体 { // 输出当前元素 cout << d << "-"; // 结束结果输出循环体 } // 输出换行 cout << endl; // 按升序排列全部元素 std::sort(datas.begin(), datas.end()); // 遍历升序结果 for (auto d : datas) // 输出升序元素 cout << d << "-"; // 输出换行 cout << endl; // 使用 greater 比较器按降序排列 std::sort(datas.begin(), datas.end(), greater<int>()); // 遍历降序结果 for (auto d : datas) // 输出降序元素 cout << d << "-"; // 输出换行 cout << endl; // 结束增删查排作用域 }第一个 7 位于下标 0,删除后数据整体前移。所有值为 6 的位置按降序保存并删除,后面的删除便不会改变尚未处理的前方下标。
4.3 size、capacity 与扩容
size() 是已经构造的元素数量,capacity() 是当前存储无需重新分配便能容纳的元素数量。resize(8) 会把元素数量改为 8,并构造新增元素;reserve(16) 只申请至少能容纳 16 个元素的空间,不增加 size()。
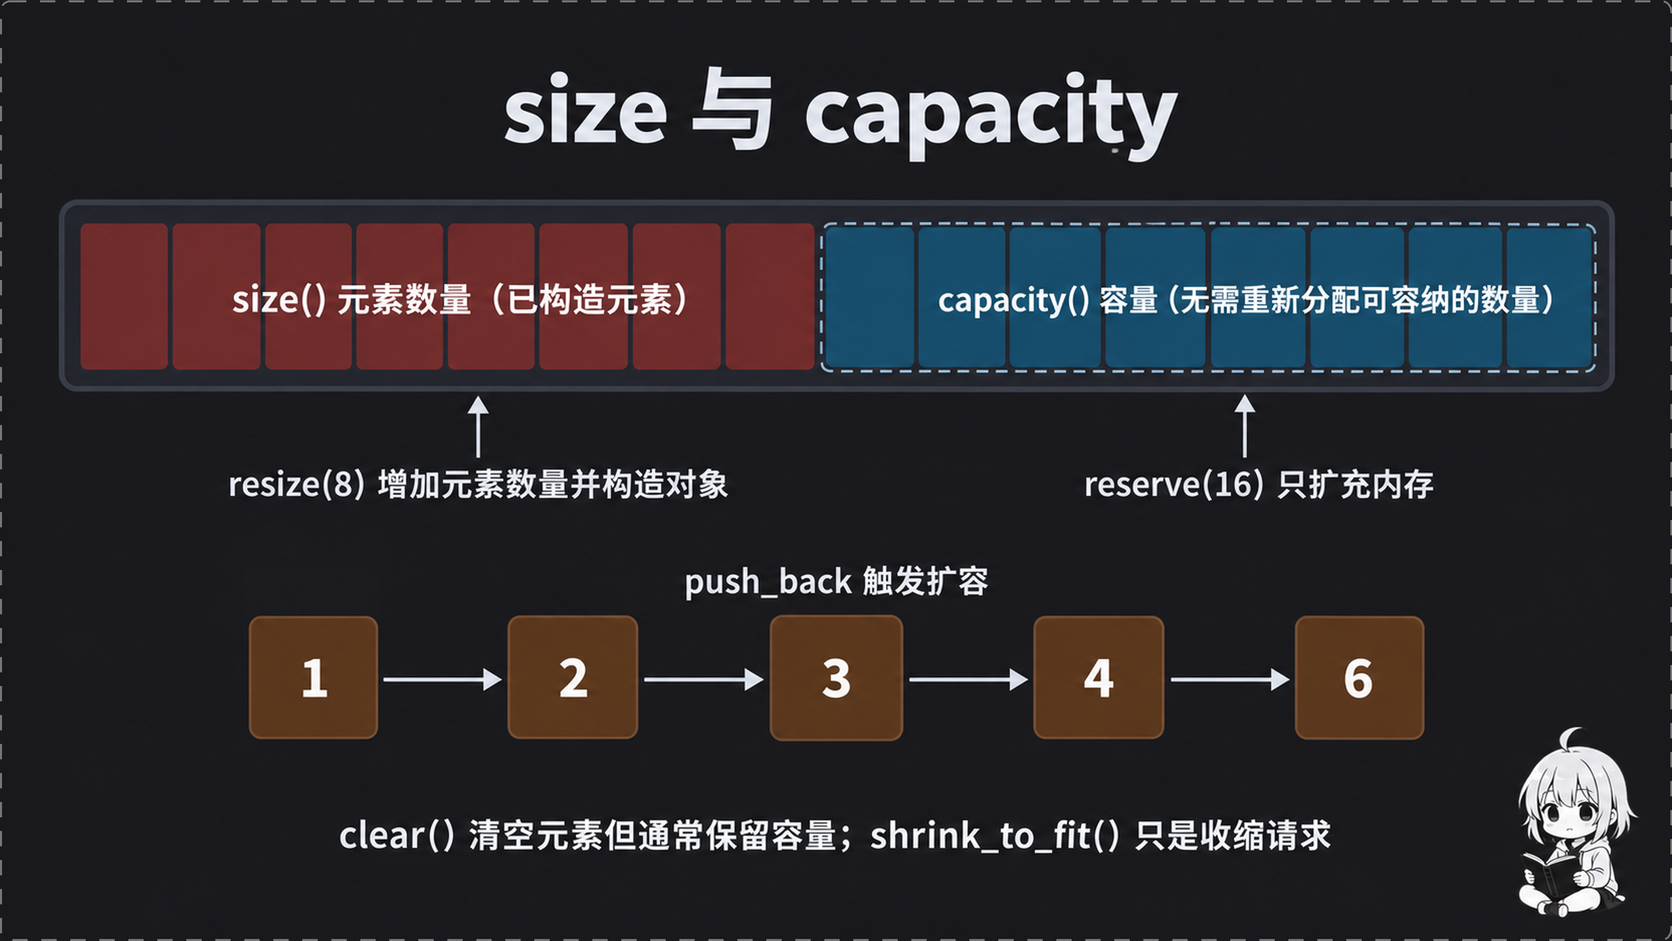
// 代码位置 4test_vector.cpp 第 101—135 行 // 建立容量观察的局部作用域 { // 定义空容器 vector<int> v1; // 创建十个零值元素 vector<int> vdata(10); // 输出空容器的元素数量 cout << "v1.size()" << v1.size() << endl; // 输出已初始化容器的元素数量 cout << "vdata.size()" << vdata.size() << endl; // 输出空容器的容量 cout << "v1.capacity():" << v1.capacity() << endl; // 输出已初始化容器的容量 cout << "vdata.capacity():" << vdata.capacity() << endl; // 将元素数量改为八 v1.resize(8); // 预留至少十六个元素的空间 v1.reserve(16); // 输出调整后的元素数量 cout << "v1.size():" << v1.size() << endl; // 输出调整后的容量 cout << "v1.capacity():" << v1.capacity() << endl; // 在八个零值元素后插入九十九 v1.push_back(99); // 遍历当前元素 for (auto v : v1) // 输出当前元素 cout << v << "|"; // 输出换行 cout << endl; // 销毁并移除全部元素 v1.clear(); // 请求收缩未使用的容量 v1.shrink_to_fit(); // 输出清空后的元素数量 cout << "v1.size():" << v1.size() << endl; // 输出收缩请求后的容量 cout << "v1.capacity():" << v1.capacity() << endl; // 输出分隔线 cout << "----------------\n"; // 保存上一次观察到的容量 int c = 0; // 连续插入二百个整数 for (int i = 0; i < 200; i++) // 开始扩容观察循环 { // 在尾部插入当前整数 v1.push_back(i); // 判断容量是否发生变化 if (c != v1.capacity()) // 开始容量变化分支 { // 输出变化前保存的容量 cout << "v1.capacity():" << c << endl; // 结束容量变化分支 } // 保存当前容量供下一轮比较 c = v1.capacity(); // 结束扩容观察循环 } // 结束容量观察作用域 }resize(8) 后插入的 99 位于第九个元素。clear() 把 size() 变为 0,但通常保留容量;shrink_to_fit() 只是收缩请求,标准不保证一定释放,也不保证容量恰好等于元素数量。增长倍率属于标准库实现细节,不能依赖某组固定序列。已知数据规模时提前 reserve,可以减少重新分配以及由此引起的移动和迭代器失效。
4.4 push_back 与 emplace_back
push_back 接收一个已经存在或临时构造的元素,再把它复制或移动进容器;emplace_back 接收构造参数,在容器的元素位置直接构造对象。差异取决于实参:emplace_back(string("test")) 已经显式创建临时对象,仍需移动;emplace_back("test") 才直接用字符串字面量构造容器内的 string。
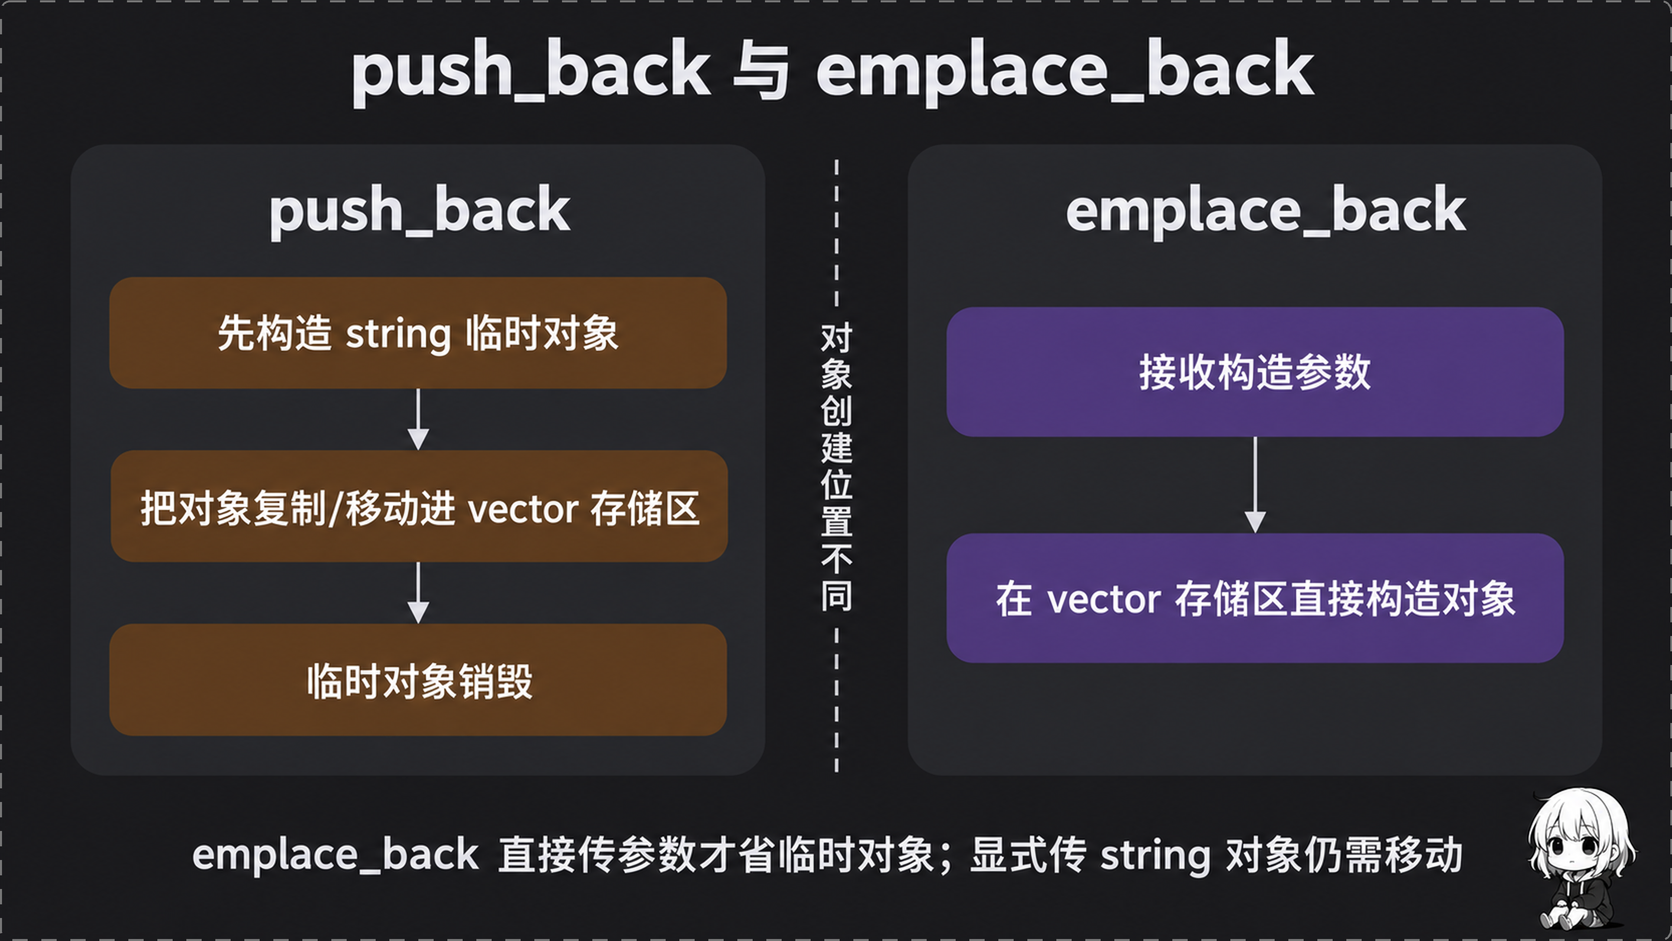
// 代码位置 4test_vector.cpp 第 139—154 行 // 建立插入方式对比的局部作用域 { // 定义字符串容器 vector<string> vs; // 显式创建临时 string 并移动到容器 vs.push_back(string("test")); // 显式创建临时 string 后交给原位构造接口 vs.emplace_back(string("test")); // 隐式构造临时 string 后插入 vs.push_back("test"); // 直接用字符指针构造容器内的 string vs.emplace_back("test"); // 在容器内默认构造空 string vs.emplace_back(); // 结束插入方式对比作用域 }执行结束后,vs 含五个元素:前四个是 "test",最后一个是空字符串。若构造参数可以直接生成目标元素,原位构造能够省去临时对象;push_back 的实参类型和插入对象则更醒目。二者应按调用语义选择。
五、Base16:循环、容器与位运算
5.1 一个字节怎样变成两个字符
Base16 使用 0123456789ABCDEF 这 16 个字符表示二进制数据。四个二进制位有 16 种取值,因此一个八位字节要拆成高、低两个四位值,每个值映射为一个字符。编码后的长度是原始字节数的两倍。
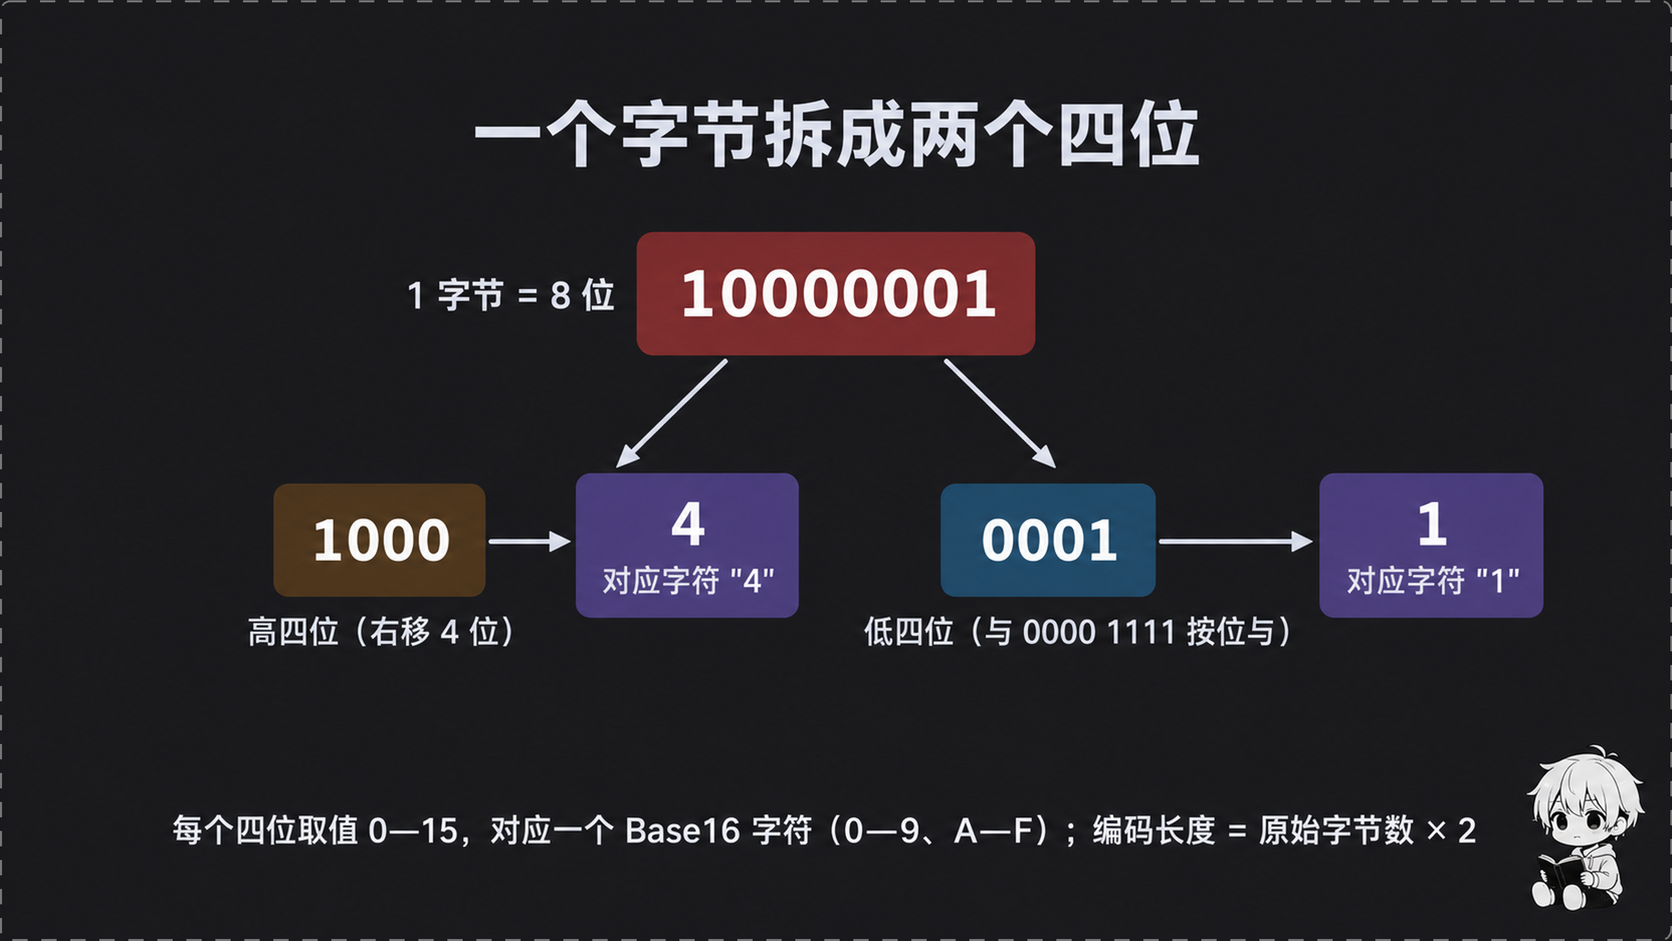
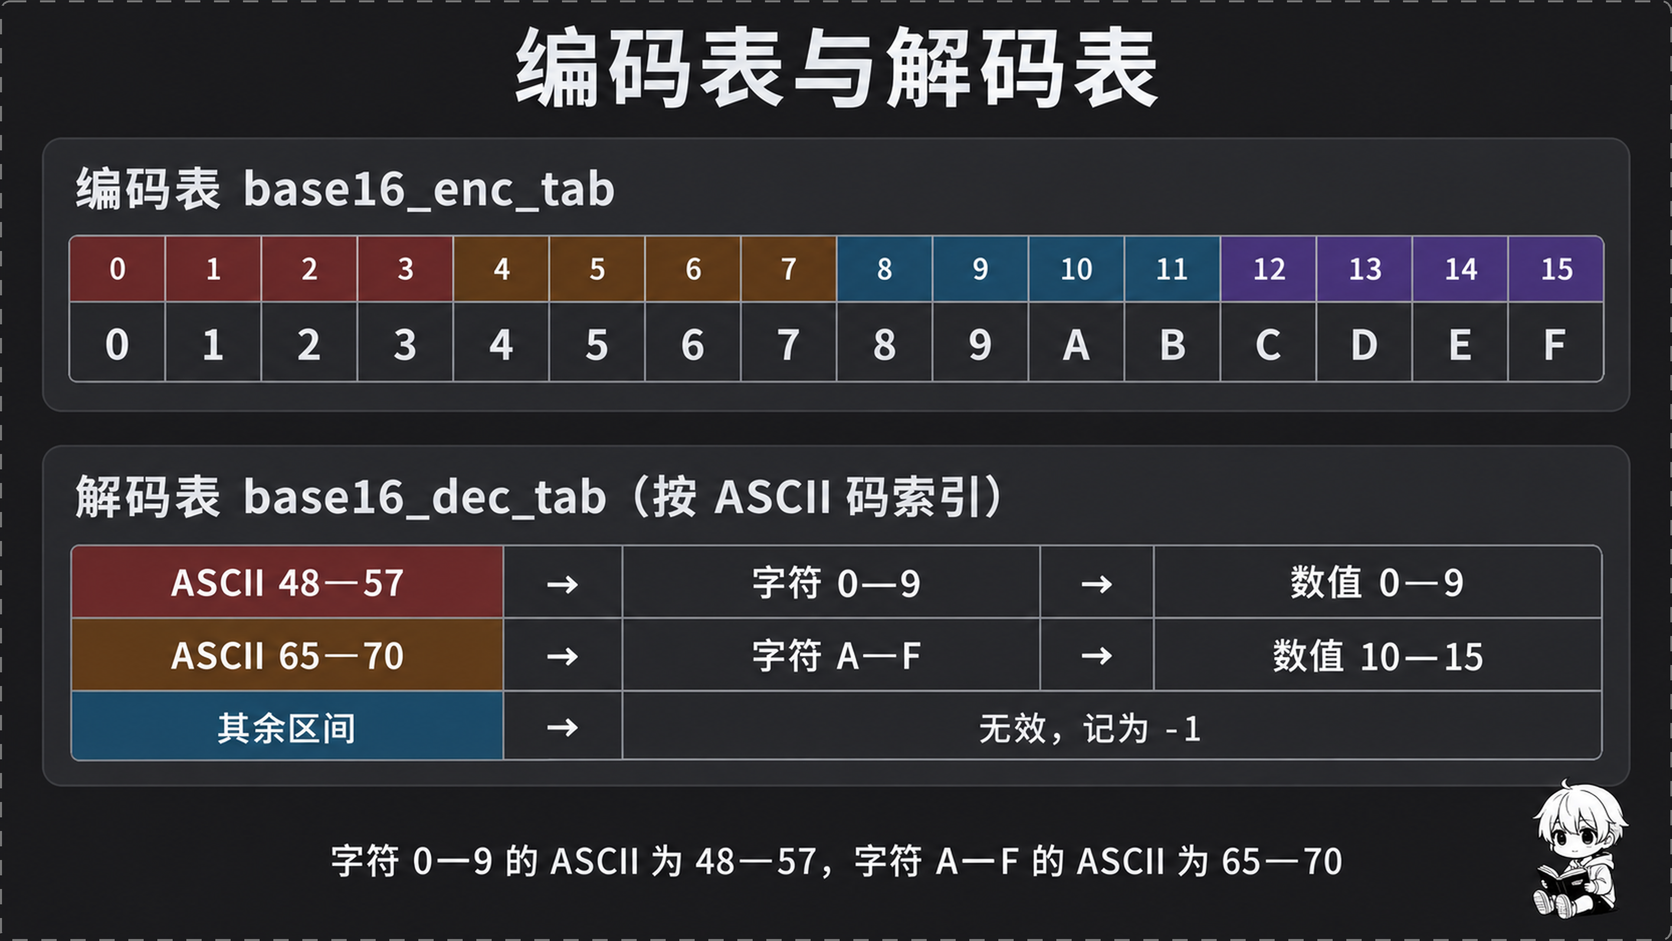
高四位通过右移四位得到,低四位通过与掩码 0b00001111 做按位与得到。两个结果都落在 0 到 15,可直接充当编码表下标。
课件用 for (unsigned char c : teststr) 遍历,而不是 char:char 在多数平台上有符号,UTF-8 中文字节最高位为 1 时会被解释成负数,对负数做 >> 是算术右移,高位补 1,结果会落在表外。unsigned char 保证右移高位补 0,结果稳定落在 0 到 15。
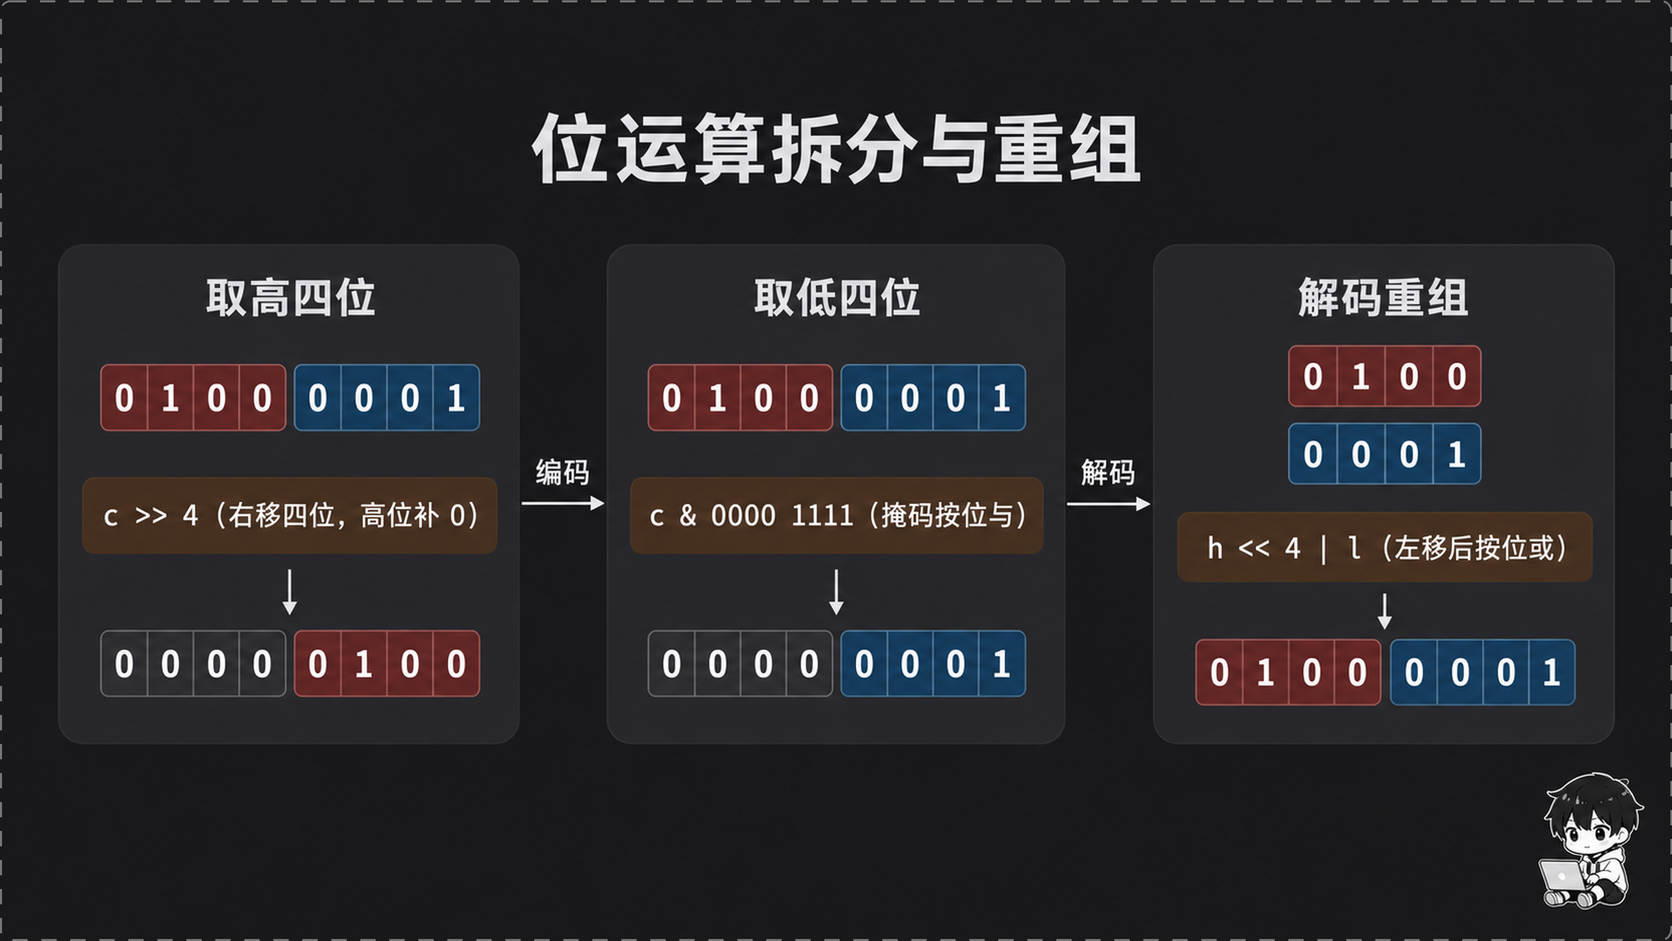
// 代码位置 5base16.cpp 第 10—33 行 // 包含输入输出流头文件 #include <iostream> // 包含字符串头文件 #include <string> // 包含 vector 头文件 #include <vector> // 使用标准命名空间中的名称 using namespace std; // 定义不可修改的 Base16 编码表 static const string base16_enc_tab{ "0123456789ABCDEF" }; // 定义程序入口 int main() // 开始主函数体 { // 准备待编码字符串 string teststr = "测试用于base16的字符串"; // 输出原始字符串 cout << "ori:\t" << teststr << endl; // 创建编码结果字符串 string base16str; // 按无符号字节遍历原始字符串 for (unsigned char c : teststr) // 开始编码循环体 { // 右移四位取得高四位 char h = c >> 4; // 使用掩码取得低四位 char l = c & 0b00001111; // 将高四位映射为字符并追加 base16str += base16_enc_tab[h]; // 将低四位映射为字符并追加 base16str += base16_enc_tab[l]; // 结束编码循环体 } // 输出 Base16 编码结果 cout << "Base16:\t" << base16str << endl;输入是 teststr 中的原始字节序列,输出是只含数字与大写 A 到 F 的 base16str。以字节 0100 0001(ASCII 的 'A')为例:右移四位得 0000 0100,即数值 4,映射为字符 '4';与 0000 1111 做按位与得 0000 0001,即数值 1,映射为字符 '1'。
5.2 用 ASCII 映射表解码
解码每次读取两个字符。程序定义了一张按 ASCII 码索引的映射表:字符 '0' 到 '9' 的编码为 48 到 57,对应数值 0 到 9;'A' 到 'F' 的编码为 65 到 70,对应数值 10 到 15。无效区间映射为 -1。
// 代码位置 5base16.cpp 第 34—62 行 // 创建解码后的字符串 string ostr; // 建立按 ASCII 码索引的解码表 const vector<char> base16_dec_tab{ // 为 ASCII 码零到九填入无效标记 -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, // 为 ASCII 码十到十九填入无效标记 -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, // 为 ASCII 码二十到二十九填入无效标记 -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, // 为 ASCII 码三十到三十九填入无效标记 -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, // 为 ASCII 码四十到四十七填入无效标记 -1, -1, -1, -1, -1, -1, -1, -1, // 将字符零到九映射为数值零到九 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, // 为 ASCII 码五十八到六十四填入无效标记 -1, -1, -1, -1, -1, -1, -1, // 将字符 A 到 F 映射为数值十到十五 10, 11, 12, 13, 14, 15 // 结束解码表初始化 }; // 每次读取两个 Base16 字符 for (int i = 0; i < base16str.size(); i += 2) // 开始解码循环体 { // 取得高四位对应的字符 char ch = base16str[i]; // 取得低四位对应的字符 char cl = base16str[i + 1]; // 查表得到高四位数值 unsigned char h = base16_dec_tab[ch]; // 查表得到低四位数值 unsigned char l = base16_dec_tab[cl]; // 左移高四位并与低四位合并 ostr += (h << 4 | l); // 结束解码循环体 } // 输出解码结果 cout << "Base16Decode:" << ostr << endl;这里的输入由前一段代码生成,长度为偶数,字符也限定为大写 Base16 字符。每两个字符都能安全查表,输出 ostr 与 teststr 的字节序列一致。
外部输入还要检查长度是否为偶数、字符下标是否处于表内、表项是否为 -1,也可以补充小写 a 到 f 的映射。缺少这些检查时,奇数长度或非 ASCII 字符可能造成越界访问。
本文由 AgentWorkFlow 生成