
文章内容
- 1.1 if、else if 与 else
- 1.2 大括号、嵌套与覆盖范围
- 2.1 分号与赋值表达式
- 2.2 不可达分支与兜底
- 3.1 true、false 与比较结果
- 3.2 返回码与布尔值方向相反
- 4.1 三种逐位运算
- 4.2 位运算与条件含义
- 5.1 bool 参与逐位运算
- 5.2 逻辑运算符与短路求值
- 6.1 初始化、赋值与复制
- 6.2 size 与 capacity
- 7.1 substr 的两个参数
- 7.2 判空与值比较
- 8.1 sto 系列转换函数
- 8.2 tostring 与拼接
- 9.1 find 与 npos
- 9.2 replace 会修改原串
- 10.1 传统 enum 与 enum class
- 10.2 比较与类型约束
- 11.1 argc、argv 与 env
- 11.2 参数从哪里传入
- 12.1 case、break 与作用域
- 12.2 枚举作为 case 标签
- 13.1 从参数得到最低输出级别
- 13.2 用 switch 映射级别名称
- 13.3 格式串替换练习
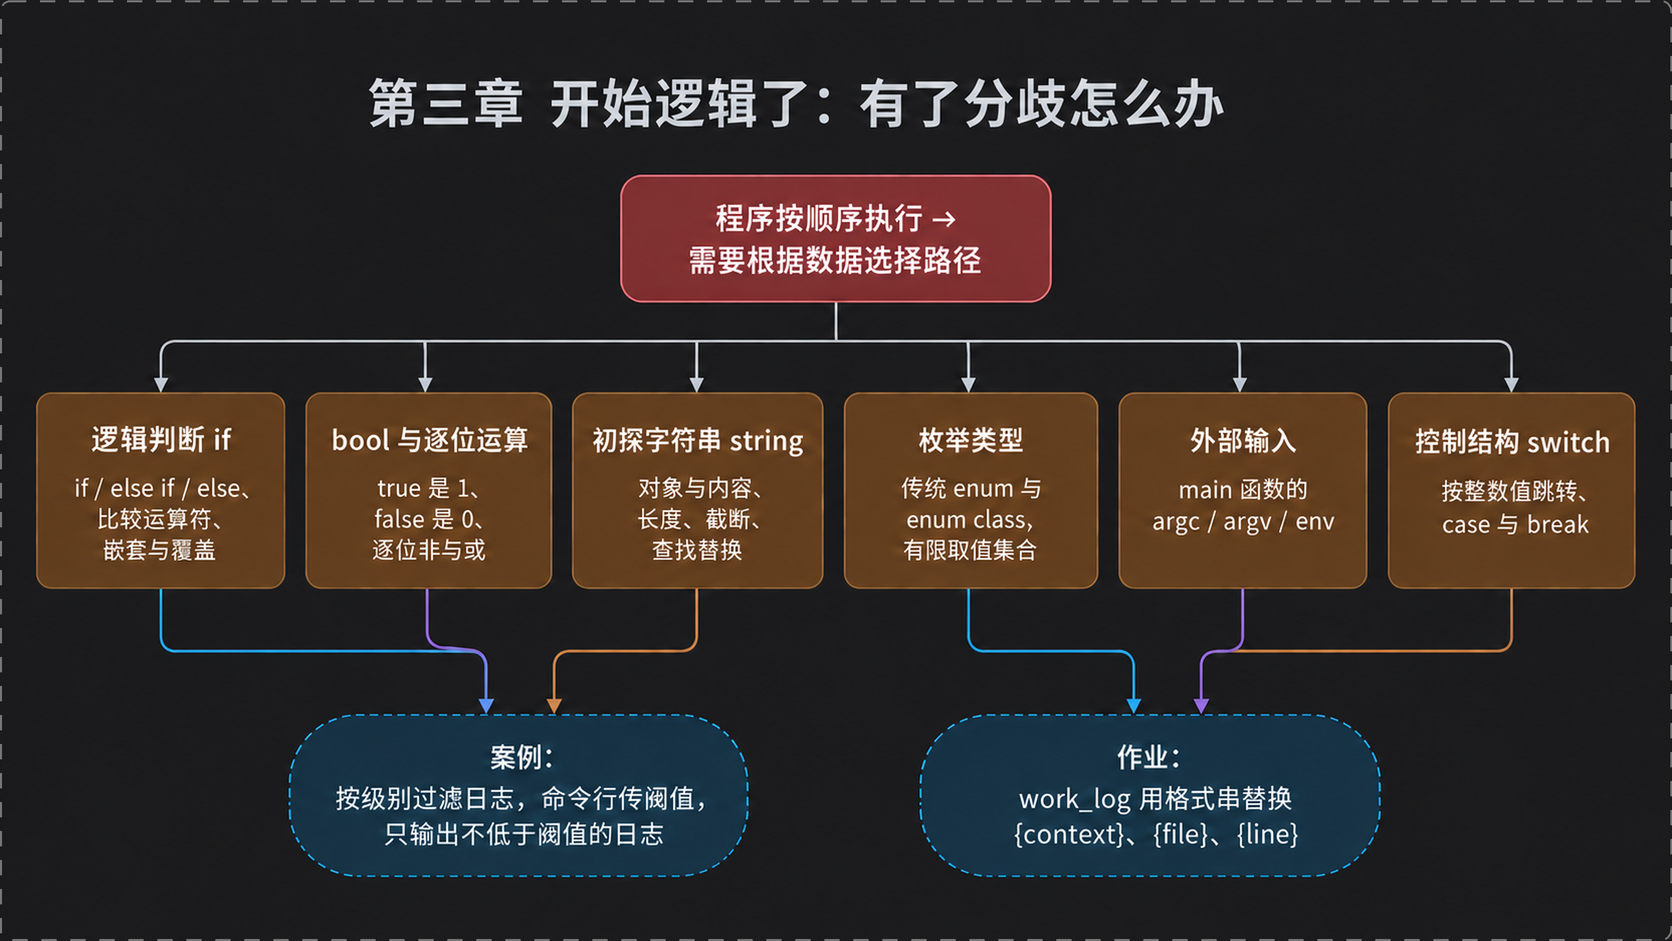
变量、作用域和运算符解决了“数据怎样存、表达式怎样算”,程序仍会默认按语句顺序执行。要让同一段程序面对不同数据时选择不同路径,需要能转换成 bool 的条件,也需要 if、switch 这样的控制结构。
上一章的 YUV 转换算完之后,越界的结果需要钳回 0 到 255,当时缺的正是判断。这一章从条件分支和它依赖的数据表示讲起,最后落在一个按级别过滤的日志模块上;后一个任务还会用到 std::string、枚举和 main 参数,它们分别负责文本、有限取值和外部输入。
一、条件分支:程序第一次出现分歧
1.1 if、else if 与 else
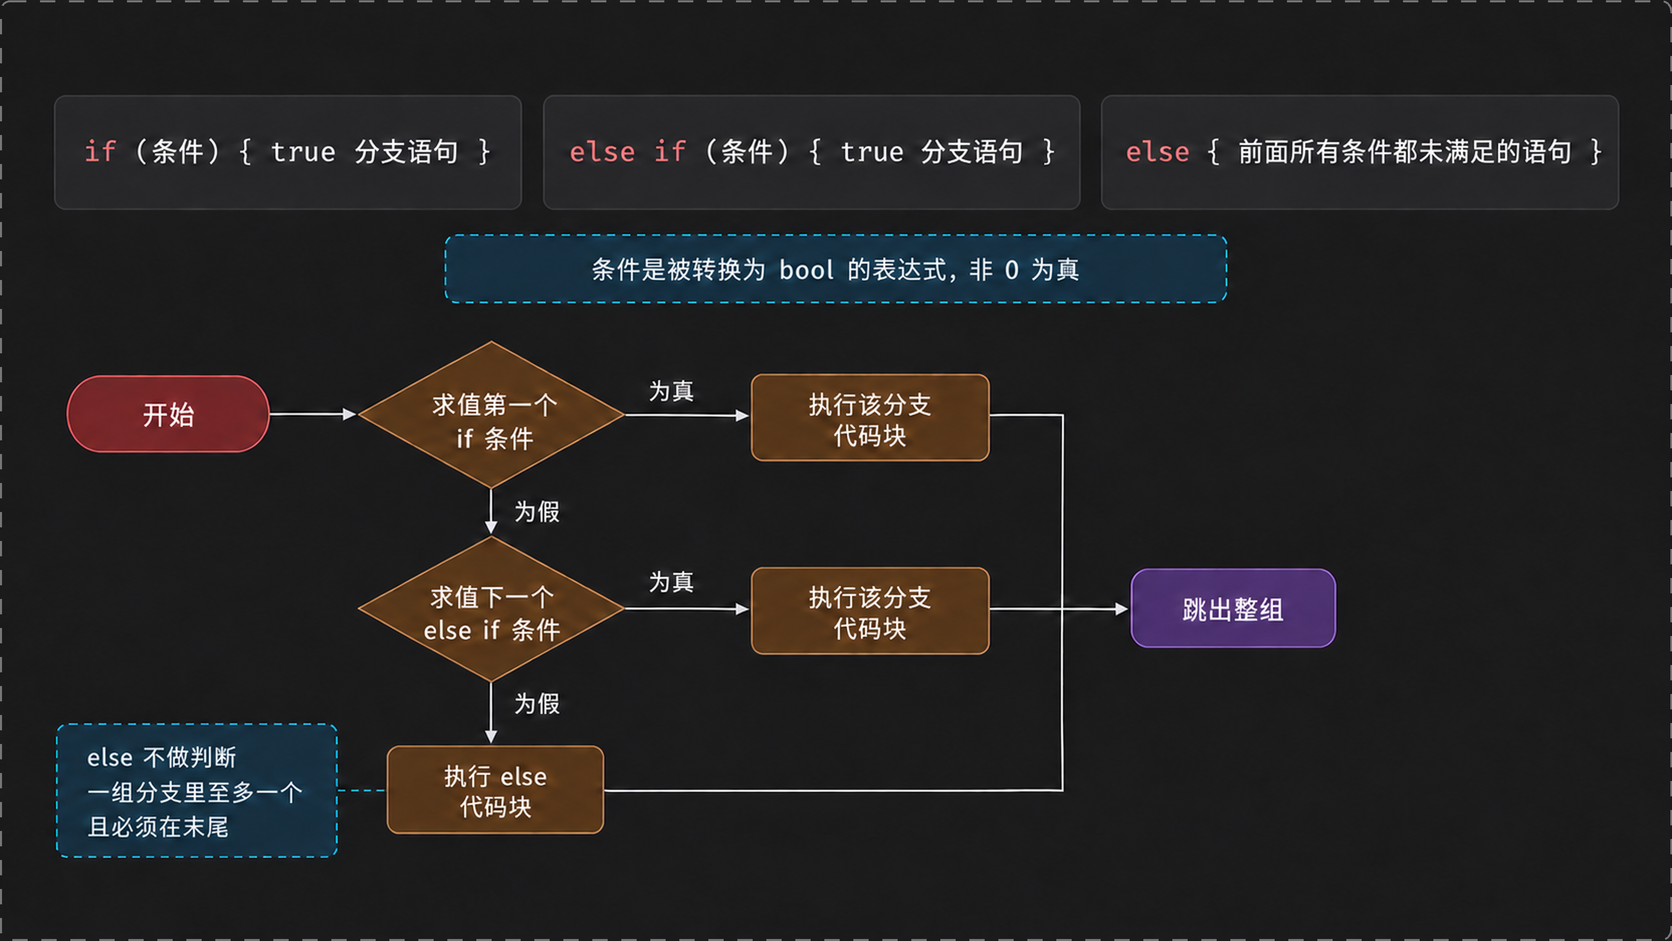
if (条件) { ... } 在条件为真时执行大括号中的语句。条件必须是能转换成 bool 的表达式:值为 0 时是假,非 0 时是真。没有求值结果的语句块不能充当条件。
需要继续判断时,可以在后面接 else if (条件) { ... };前面的条件全部不满足时,程序执行 else { ... } 中的语句。else 自己不判断,因此一组分支中至多有一个,并且要放在末尾。一组 if / else if / else 至多进入一个分支,某个条件命中后,后续条件不再判断。
1.2 大括号、嵌套与覆盖范围
分支内仅有一条语句时,C++ 允许省略大括号,但维护代码时容易误判第二行是否受条件控制。保留大括号通常更稳妥。嵌套达到三层以后,阅读和调试成本明显增加,此时应考虑重新组织条件或拆分职责。
条件的取值范围还要覆盖完整。下面的片段读入一个整数,用它演示普通分支、嵌套条件和省略大括号的单行分支。输入大于 100 的数会先输出 x > 100,再检查内部条件。
// 代码位置 1testif.cpp 第 109—125 行 // 提示输入整数 cout << "请输入一个整数:"; // 初始化输入变量 int x{ 0 }; // 读取用户输入 cin >> x; // 输出读入的值 cout << "x = " << x << endl; // 判断数值是否大于一百 if (x > 100) // 开始大于一百的分支 { // 输出分支命中信息 cout << "x > 100" << endl; // 判断数值是否等于一百零一 if (x == 101) // 输出相等提示 cout << "x==101" << endl; // 判断数值是否不等于一百零二 if (x != 102) cout << "[!=102]";若条件链写成 x > 100、x > 200、x < 50,第二项永远没有机会命中,而 50 到 100 之间又没有对应分支。末尾补一个 else,即使其中仅记录异常输入,也能暴露覆盖缺口。
二、if 的三个高频错误
2.1 分号与赋值表达式
条件右括号后多出的分号是一条空语句。if (x == 103); 实际控制的是这条空语句,后面的大括号已经成为普通代码块,所以输入 102 仍会输出 [103]。编译器通常接受这种写法,错误要到运行时才暴露。
将 == 误写成 = 同样可能通过编译。if (x = 104) 先把 104 赋给 x,赋值表达式的结果仍是 104;非 0 转成 bool 后为真,因此输入 103 也会输出 [104]。
把常量放在左侧可增加一道编译期保护:if (105 == x) 若误写成 105 = x,编译器会因为左侧不是可修改的左值而报错。编译期错误通常比运行期逻辑错误更容易定位。
// 代码位置 1testif.cpp 第 126—140 行 // 演示条件后的多余分号 if (x == 103); // 开始不受条件控制的代码块 { // 输出一百零三标签 cout << "[103]"; // 结束普通代码块 } // 演示赋值误写为比较 if (x = 104) // 输出一百零四标签 cout << "[104]"; // 将常量放在比较左侧 if (105 == x) // 开始相等分支 { // 输出一百零五标签 cout << "[105]"; // 结束相等分支 }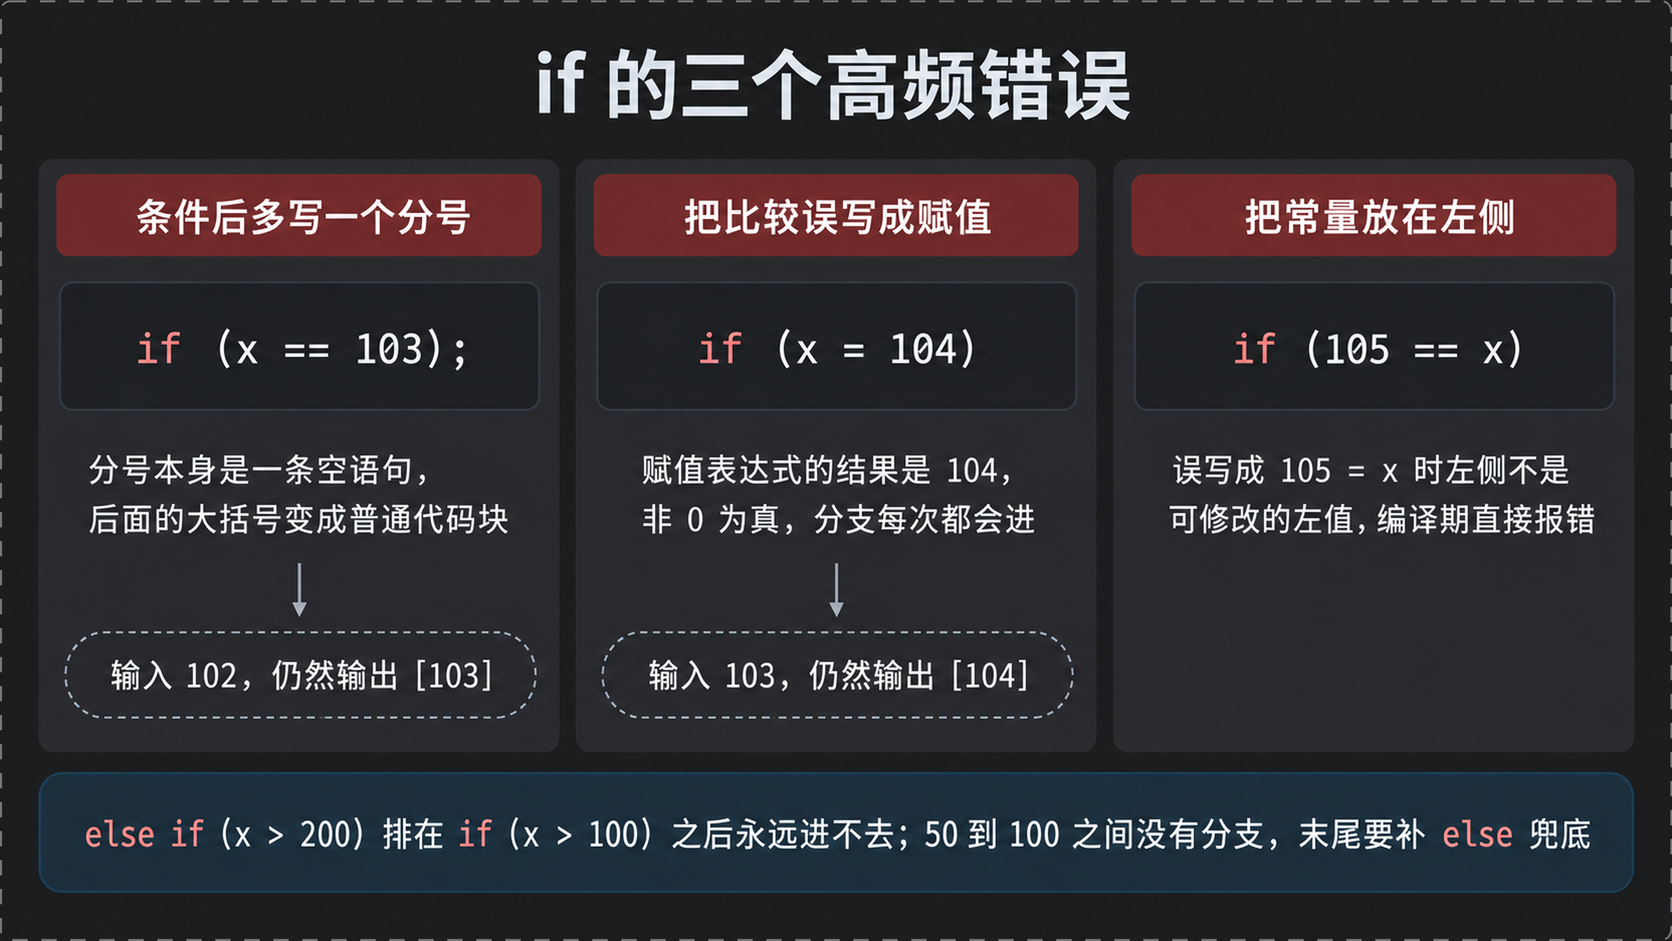
2.2 不可达分支与兜底
分支次序会改变可达性。第一个条件已经覆盖所有大于 100 的值,后面的 x > 200 永远不会执行。若暂时保留这种代码,应写明原因,避免维护者把它当成遗漏。下面的 else 负责 50 到 100 的剩余范围。
// 代码位置 1testif.cpp 第 141—157 行 // 结束前一个大于一百的分支 } // 尝试判断是否大于二百 else if (x > 200) // 开始大于二百的分支 { // 输出大于二百的信息 cout << "x > 200" << endl; // 结束大于二百的分支 } // 判断数值是否小于五十 else if (x < 50) // 开始小于五十的分支 { // 输出小于五十的信息 cout << "x < 50" << endl; // 结束小于五十的分支 } // 接住其余情况 else // 开始兜底分支 { // 输出兜底标签 cout << "else x = " // 输出具体数值并换行 << x << endl; // 结束兜底分支 }三、bool:两个取值表达判断结果
3.1 true、false 与比较结果
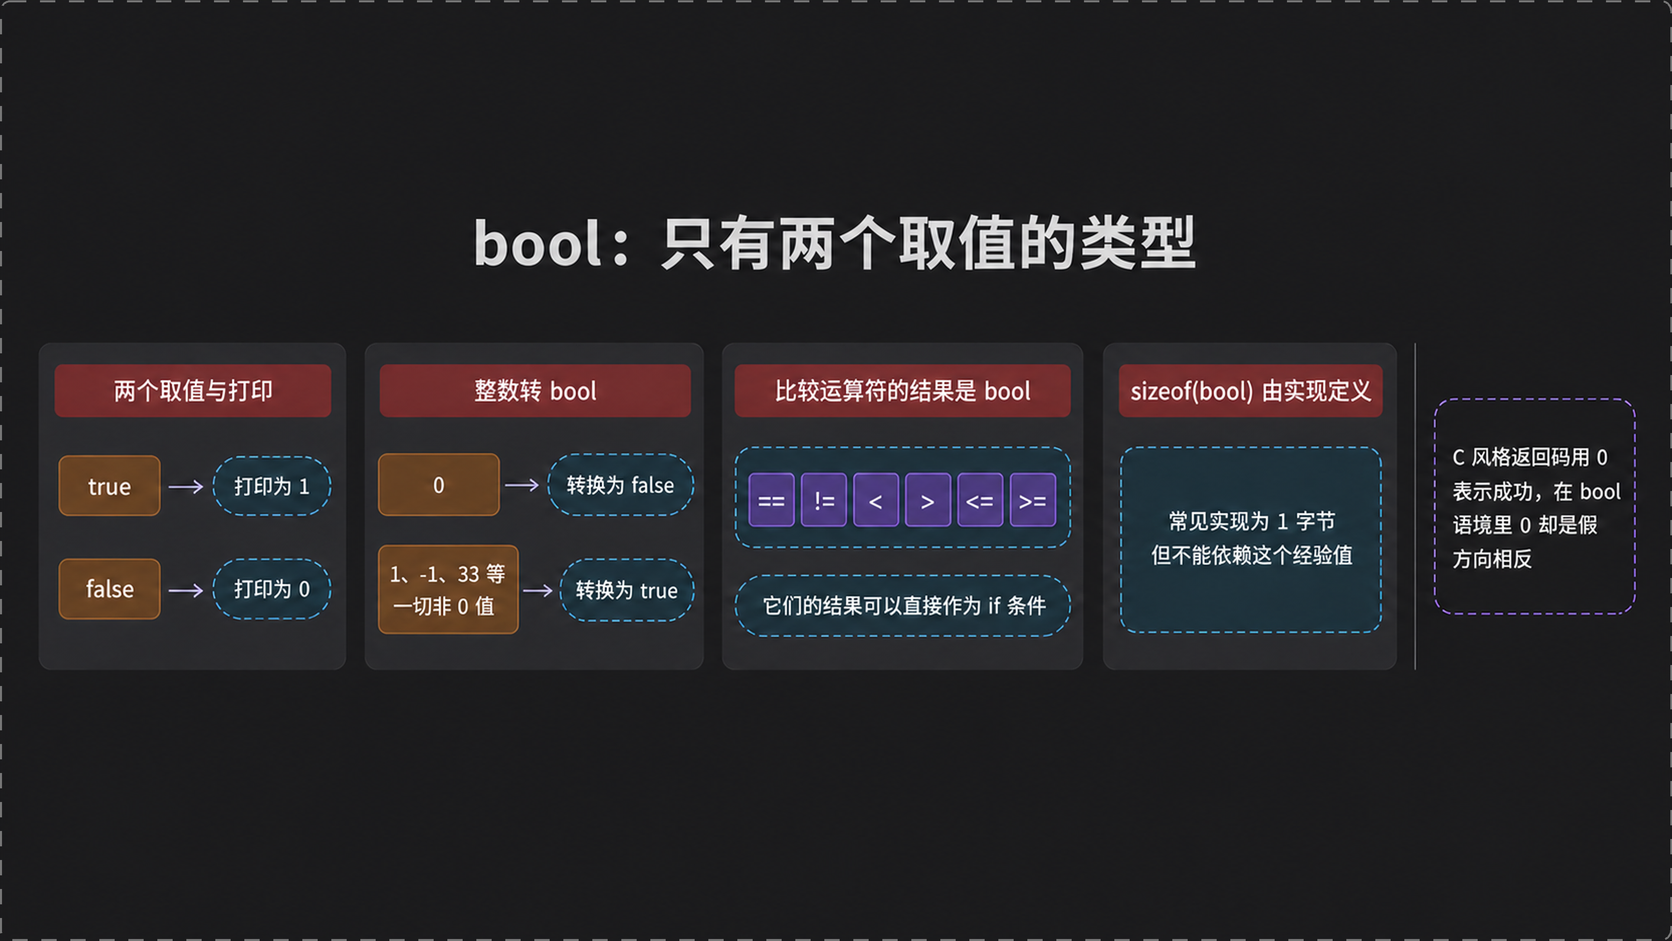
bool 只有 true 和 false 两个取值,cout 默认把它们打印成 1 和 0。整数转换为 bool 时,0 对应 false,1、-1、33 等非 0 值都对应 true。六个比较运算符 ==、!=、<、>、<=、>= 的结果也是 bool,可直接作为 if 条件。
sizeof(bool) 由实现定义,可以不等于 1。多数常见实现按 1 字节存放,但内存布局、通信协议和跨语言接口不应依赖这一惯例。
3.2 返回码与布尔值方向相反
C 风格函数和 main 通常用返回值 0 表示成功,非 0 表示某种错误;在布尔语境里,0 却表示假。直接把返回码当成布尔条件会让“成功”对应 false。使用返回值前应确认接口约定,避免仅根据真假含义推断。
四、逐位运算:逐个二进制位计算
4.1 三种逐位运算
数值在内存中以二进制形式存储。引入 <bitset> 后,std::bitset<8> 可以把 8 位结果打印出来,便于观察 char 上的逐位运算。逐位非 ~ 翻转每一位;逐位与 & 要求对应两位均为 1;逐位或 | 只要对应位中有一个 1,结果就为 1。
二进制字面量的 0b 前缀从 C++14 开始可用。此前的标准不支持这种写法,可以改用十六进制表示同一个位模式。下面片段中 a 的字面值是 129;如果当前实现的 char 为有符号类型,这个值超出范围,MSVC 会给出 C4309 截断常量值告警。程序能够编译运行,并不代表写入值与实际存储的数值相同。
// 代码位置 1testif.cpp 第 23—37 行 // 定义第一个八位模式 char a = 0b10000001; // 定义第二个八位模式 char b = 0b00000001; // 输出变量 a 的位模式 cout << "a:\t" << bitset<8>(a) << endl; // 输出 a 逐位取反的结果 cout << "~a:\t" << bitset<8>(~a) << endl; // 输出变量 b 的位模式 cout << "b:\t" << bitset<8>(b) << endl; // 输出 b 逐位取反的结果 cout << "~b:\t" << bitset<8>(~b) << endl; // 输出 a 与 b 逐位与的结果 cout << "a&b:\t" << bitset<8>(a & b) // 完成换行输出 << endl; // 输出 a 与 b 逐位或的结果 cout << "a|b:\t" << bitset<8>(a | b) // 完成换行输出 << endl;六条输出语句打印出来的结果,标签与数值之间由 \t 对齐:
a: 10000001~a: 01111110b: 00000001~b: 11111110a&b: 00000001a|b: 10000001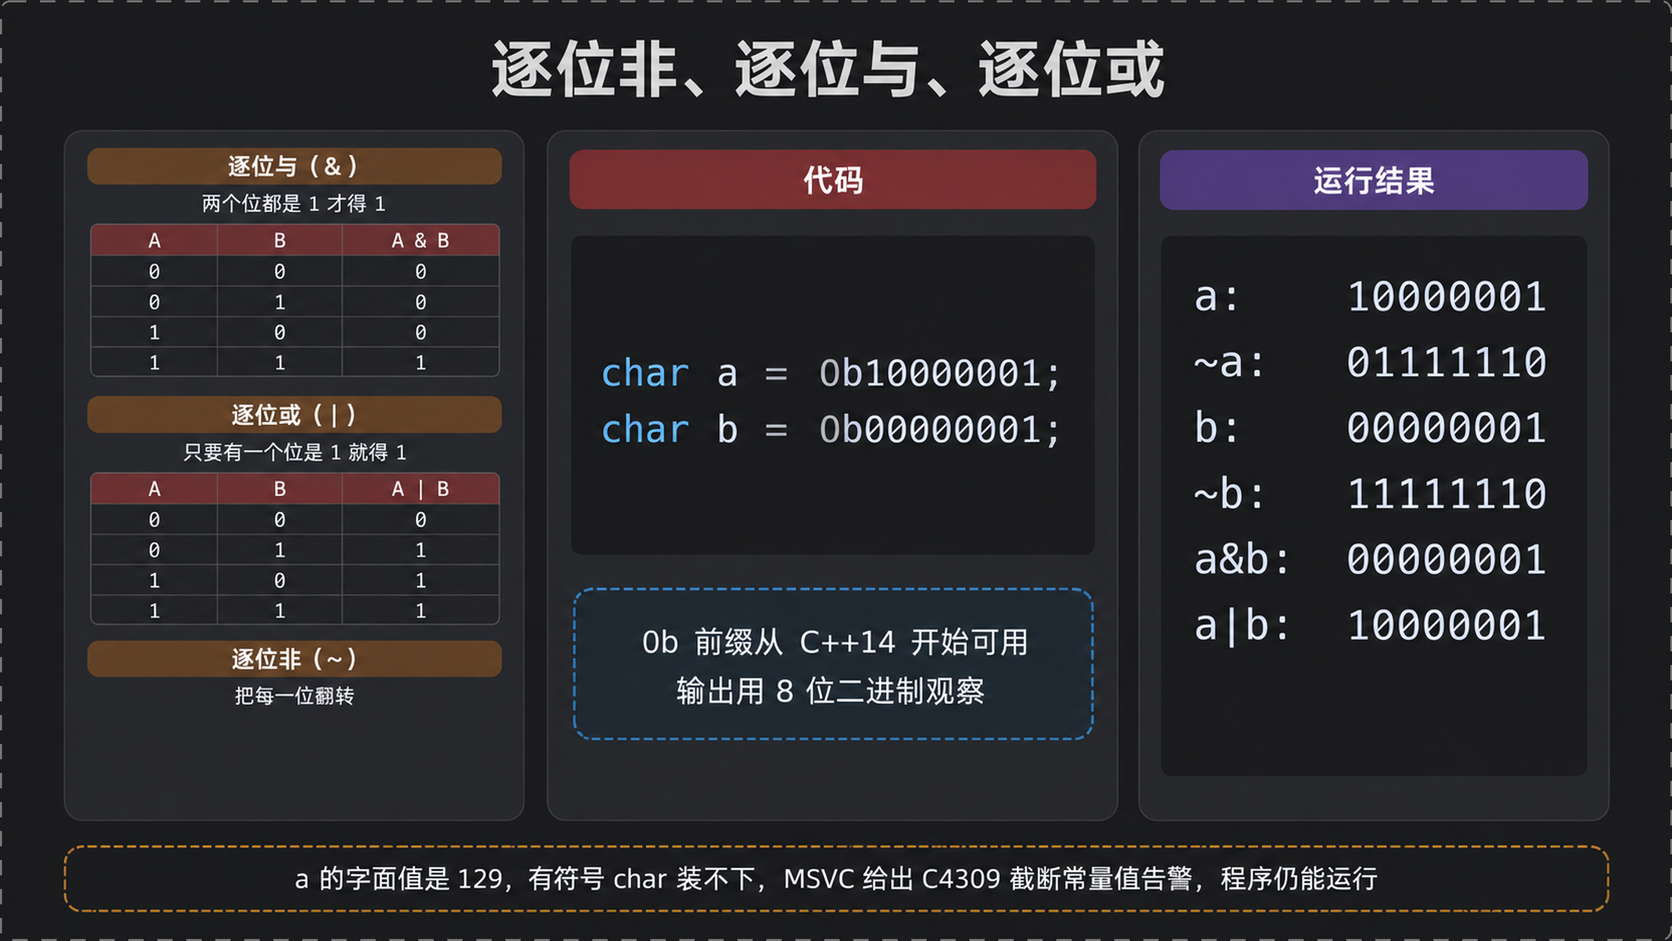
4.2 位运算与条件含义
把位运算借来描述条件时,& 类似“条件全部满足”,| 类似“至少一个条件满足”,~ 类似“逐位翻转”。旧代码中可能存在这样的写法,阅读时需要理解,但条件判断有专用的逻辑运算符,它们的求值规则不同。
五、bool、逐位运算与逻辑运算
5.1 bool 参与逐位运算
在常见表示中,true 是 0000 0001,false 是 0000 0000。对这两个值使用 & 和 |,结果与布尔与、布尔或相同。
// 代码位置 1testif.cpp 第 40—56 行 // 定义第一个假值 bool f1{ false }; // 定义第二个假值 bool f2{ false }; // 定义第一个真值 bool t1{ true }; // 定义第二个真值 bool t2{ true }; // 在真值条件下输出提示 if (t1)cout << "t1 is true" << endl; // 输出第一个假值 cout << "f1 = " << f1 << endl; // 输出第一个真值 cout << "t1 = " << t1 << endl; // 输出假值与真值逐位或的结果 cout << "f1|t1=" << (f1|t1) << endl; // 根据逐位或结果输出提示 if (f1 | t1) cout << "(f1|t1)true\n"; // 输出两个假值逐位或的结果 cout << "f1|f2=" << (f1 | f2) << endl; // 输出假值与真值逐位与的结果 cout << "f1&t2=" << (f1 & t2) << endl; // 输出两个真值逐位与的结果 cout << "t1&t2=" << (t1 & t2) << endl;逐位非不适合 bool:~true 和 ~false 会先经过整数提升,得到两个非 0 结果,再转换回 bool 时都是真,原有真假关系被破坏。三个以上操作数混用时还应加括号明确顺序。
5.2 逻辑运算符与短路求值
逻辑非、与、或分别写作 !、&&、||,也可以使用代用写法 not、and、or。符号形式必须使用 ASCII 半角字符,多条件表达式应通过括号明确分组。
// 代码位置 1testif.cpp 第 58—85 行 // 判断两个值是否至少一个为真 if (f1 or t1) // 开始逻辑或分支 { // 输出逻辑或命中信息 cout << "f1 or t1" << endl; // 结束逻辑或分支 } // 判断两个值是否都为真 if (f1 and t1) // 开始逻辑与分支 { // 结束逻辑与分支 } // 处理逻辑与为假的情况 else // 开始逻辑与的兜底分支 { // 输出逻辑与未命中的信息 cout << "f1 and t1 else" << endl; // 结束逻辑与的兜底分支 } // 判断第一个值取反后是否为真 if (not f1) // 开始逻辑非分支 { // 输出逻辑非命中信息 cout << "not f1" << endl; // 结束逻辑非分支 } // 对逻辑与结果取反 if (not (f1 and t1)) // 开始复合逻辑分支 { // 输出复合逻辑命中信息 cout << "not (f1 and t1)" << endl; // 结束复合逻辑分支 }逻辑运算符会短路:第一个操作数已经能确定结果时,第二个操作数不再求值。探针从 10 开始,可以避开自增表达式在 0 附近造成的误读。or 版本的第一个操作数已经为真,第二个操作数不求值,x1 变为 11。逐位或版本仍计算右侧,x1 最终变为 13。
// 代码位置 1testif.cpp 第 87—103 行 // 初始化短路测试变量 int x1{ 0 }; // 设置逻辑或测试初值 x1 = 10; // 用逻辑或测试短路求值 if ((x1++) or (x1 += 2)) // 开始逻辑或分支 { // 输出逻辑或表达式 cout << "(x1++) or (x1 += 2)" << endl; // 结束逻辑或分支 } // 输出逻辑或测试结果 cout << "x1 = " << x1 << endl; // 重置逐位或测试初值 x1 = 10; // 用逐位或计算两个操作数 if ((x1++) | (x1 += 2)) // 开始逐位或分支 { // 输出逐位或表达式 cout << "(x1++) | (x1 += 2)" << endl; // 结束逐位或分支 } // 输出逐位或测试结果 cout << "x1 = " << x1 << endl;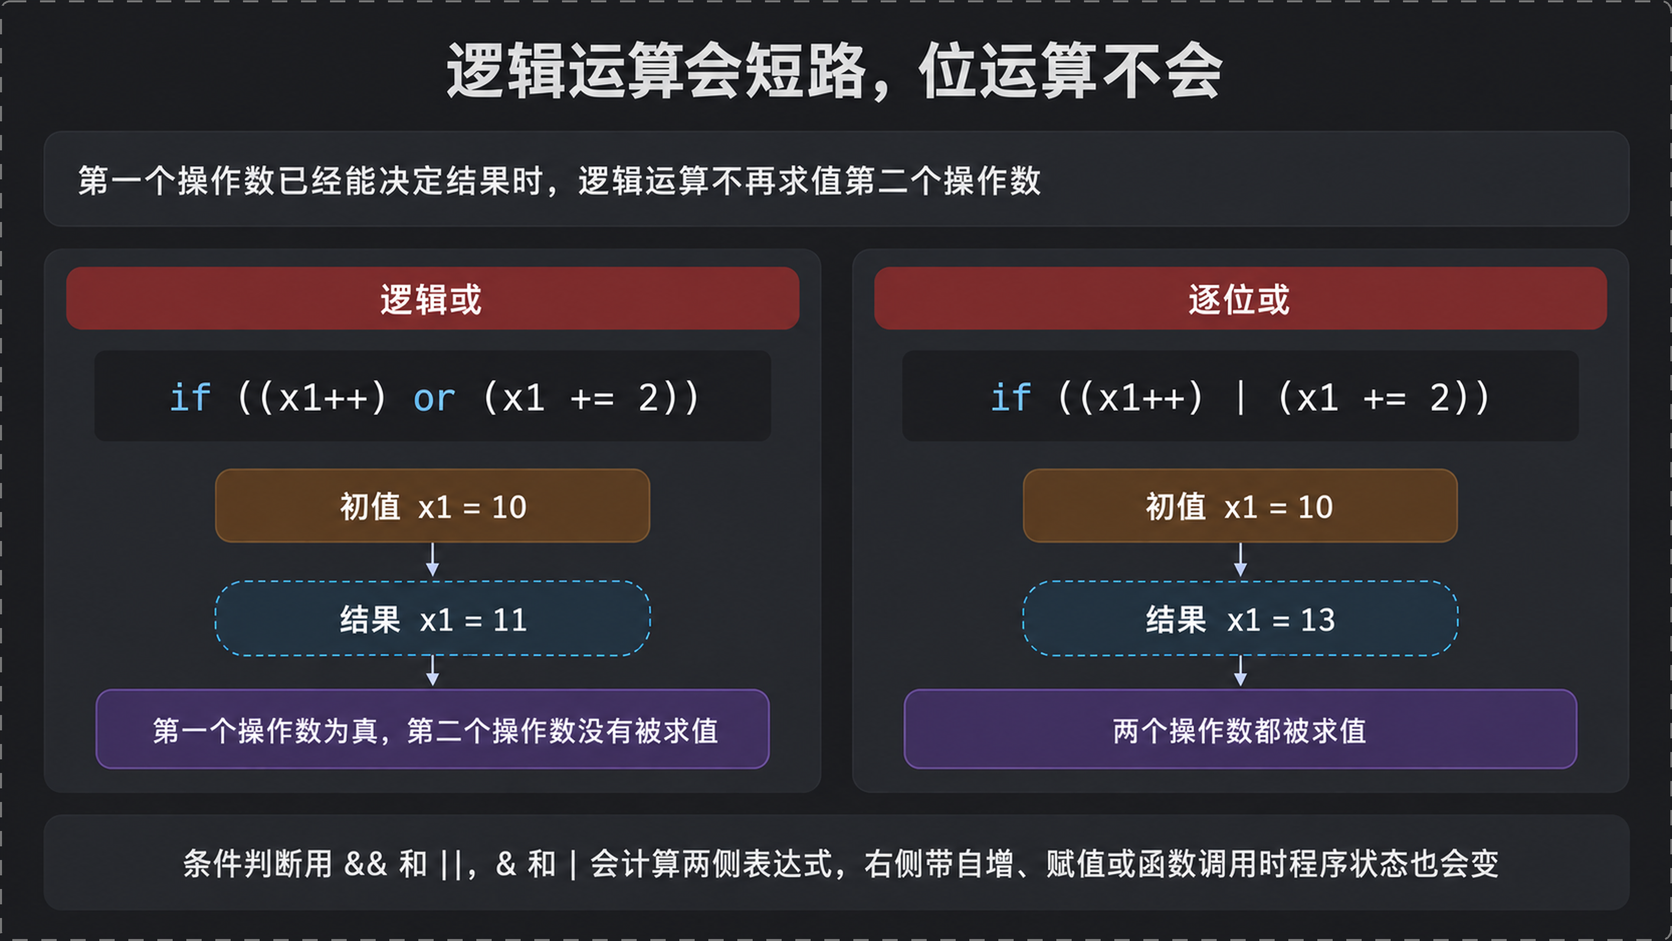
条件判断应使用 && 和 ||。它们不仅表达意图准确,还能在结果已经确定时省去后续求值;& 和 | 会计算两侧表达式,若右侧带有自增、赋值或函数调用,程序状态也会随之改变。
六、std::string:对象、内容与长度
6.1 初始化、赋值与复制
C++ 字符串头文件是 <string>,类型全名为 std::string;C 的 string.h 不是同一个头文件。头文件中也不宜随意写 using namespace std;,否则会把名字引入所有包含它的源文件。
char 表示单字节数值,'c' 和 '\n' 是字符字面量。"test string 1" 这样的字符串字面量由多个 char 组成,末尾还有值为 0 的 \0。字符 '0' 的 ASCII 值是 48,不能替代结束符。
大括号初始化会做类型检查。str2{ str1 } 复制字符串内容,两份字符串可以独立修改;默认构造的 str3 是空串。赋值会更新对象管理的内容,不等同于让裸指针改指向。代码里的 "str2:" 标签配合输出的 str1 是片段原有写法,这里保持不变。
// 代码位置 2test_string.cpp 第 16—23 行 // 用字面量初始化第一个字符串 std::string str1 { "test string 1" }; // 输出第一个字符串 cout << "str1:" << str1 << endl; // 为第一个字符串重新赋值 str1 = "test string 1-2"; // 复制构造第二个字符串 string str2{ str1 }; // 按原片段输出第一个字符串 cout << "str2:" << str1 << endl; // 默认构造空字符串 string str3; // 把第二个字符串赋给第三个 str3 = str2; // 输出第三个字符串 cout << "str3:" << str3 << endl;str1:test string 1str2:test string 1-2str3:test string 1-26.2 size 与 capacity
string 对象本身保存管理信息,字符内容由对象管理。较长内容通常位于动态分配的存储区;具体是否使用对象内缓冲区、何时重新分配,属于标准库实现细节。重新赋值时,实现可以复用已有容量,也可以申请更大的空间并释放旧空间,调用者不必手动管理。
"test string 1" 是 const char[14],其中 13 个可见字符加一个 \0;"test string 1-2" 是 const char[16]。size() 返回字符数量,不含结尾的 \0,length() 与它等价。capacity() 表示当前无需重新分配即可容纳的字符数,具体值由实现决定。下例在对应环境中得到 15,不能把这个数当成语言规格。
// 代码位置 2test_string.cpp 第 26—30 行 // 初始化九字符字符串 string str4{ "123456789" }; // 输出字符串长度 cout << "str4.size():" << str4.size() // 完成换行输出 << endl; // 开始输出字符串容量 cout << "str4.capacity() = " << // 输出容量并换行 str4.capacity() << endl;str4.size():9str4.capacity() = 15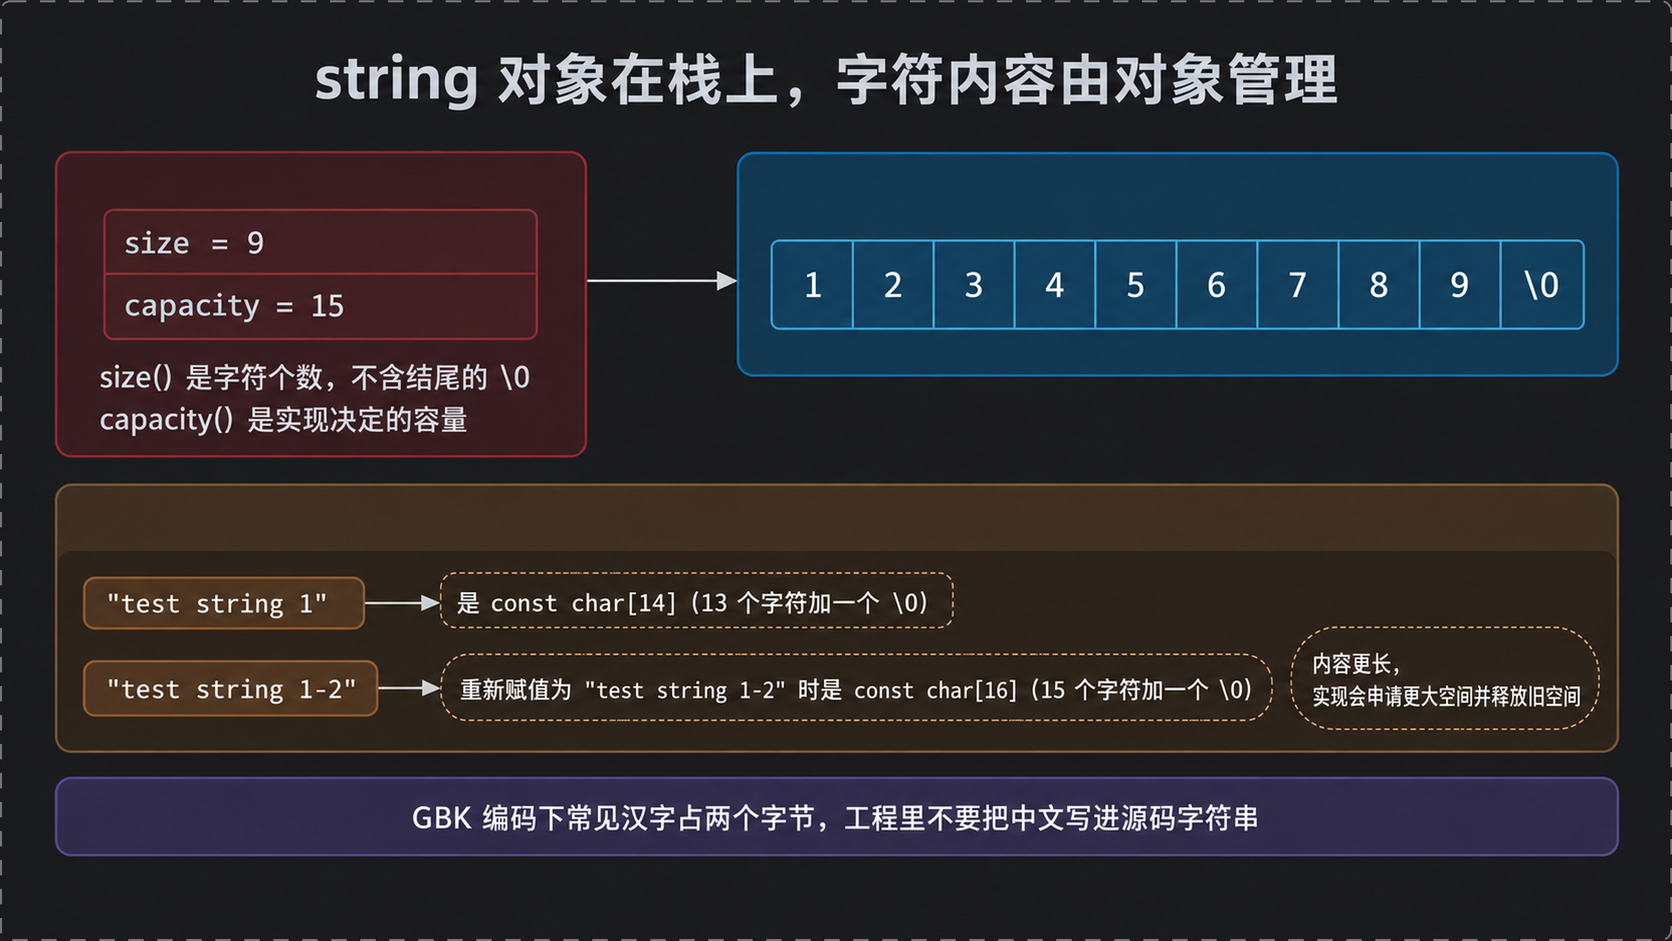
字符占用的字节数取决于编码。GBK 中常见汉字通常占两个字节,UTF-8、UTF-16 等编码有各自的表示方式。工程代码若直接嵌入中文文本,结果会受源文件编码和编译环境影响;需要本地化的文本更适合放在外部资源中。
七、截断、判空与比较
7.1 substr 的两个参数
substr 的起始偏移从 0 计数,第二个参数表示字符数量,不表示结束下标。省略第二个参数时会一直取到末尾,而且调用不会修改原字符串,而是返回新的 string。当 str4 为 "123456789" 时,substr(3) 得到 456789,substr(1, 3) 得到 234。
// 代码位置 2test_string.cpp 第 36—38 行 // 从下标三截取到末尾 cout << str4.substr(3)<<endl; // 从下标一截取三个字符 cout << str4.substr(1, 3) << endl;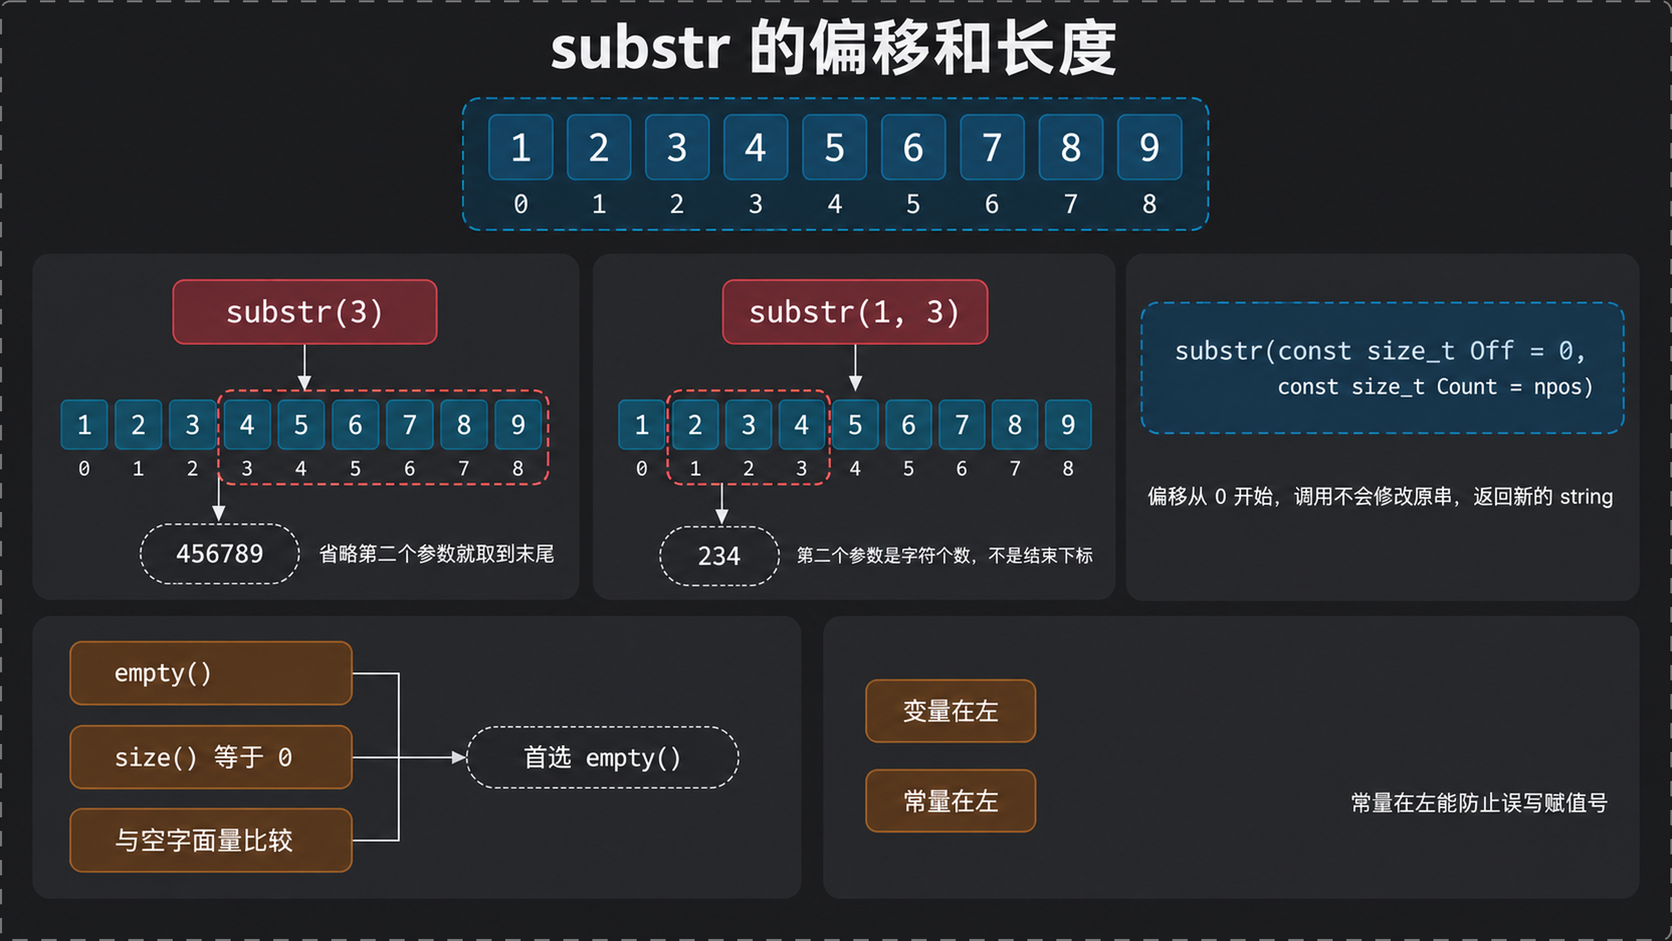
7.2 判空与值比较
空串可以用 empty()、size() == 0 或 == "" 判断。empty() 最贴合判空意图;已经需要长度时,size() == 0 也能复用现有结果。std::string 支持 ==、!= 值比较,也能与 const char* 字面量比较。把常量放在左侧仍能防止误写赋值号。
// 代码位置 2test_string.cpp 第 43—63 行 // 判断字符串是否为空 if (strif.empty()) // 开始 empty 分支 { // 输出空串提示 cout << "strif empty" << endl; // 结束 empty 分支 } // 通过长度判断空串 if (strif.size() == 0) // 开始长度判断分支 { // 输出长度为零的提示 cout << "strif.size() == 0" << endl; // 结束长度判断分支 } // 通过空字面量判断空串 if (strif == "") // 开始字面量判断分支 { // 输出空字面量比较提示 cout << "strif == " << endl; // 结束字面量判断分支 } // 为字符串赋测试值 strif = "test"; // 把相等比较的常量放在左侧 if ("test" == strif ) // 开始相等分支 { // 输出相等提示 cout << "strif == test" << endl; // 结束相等分支 } // 判断字符串是否不等于另一字面量 if ("test1" != strif) // 开始不等分支 { // 输出不等提示 cout << "strif != test1" << endl; // 结束不等分支 }strif emptystrif.size() == 0strif ==strif == teststrif != test1报文处理常用 substr(0, 4) 取前四个字符,再与协议头比较。实际调用前还应确认字符串长度符合协议要求。
八、字符串与数字互转、拼接
8.1 sto 系列转换函数
stoi、stod、stof、stoll 分别转换为 int、double、float、long long。用 auto 接收时,编译器按函数返回类型推导变量类型。stof("33.1f") 与 stof("33.2") 都能得到 float;字符串中的后缀并不改变函数的返回类型。
转换失败会抛出异常,不会静默返回 0。调用方需要按输入来源和可靠程度处理异常,否则错误输入会终止当前执行路径。
// 代码位置 2test_string.cpp 第 72—82 行 // 把整数字符串转换为 int auto i1 = stoi("1234"); // 将转换结果自增 i1++; // 输出自增后的整数 cout <<"i1 = "<< i1 << endl; // 保存浮点数字符串 string sd1 = "123.5"; // 把字符串转换为 double double d1 = stod(sd1); // 输出 double 结果 cout << d1 << endl; // 把带后缀文本转换为 float auto f1 = stof("33.1f"); // 输出第一个 float 结果 cout << f1 << endl; // 把普通小数字符串转换为 float auto f2 = stof("33.2"); // 输出第二个 float 结果 cout << f2 << endl; // 转换并输出 long long 结果 cout << stoll("-1231231231233") << endl;i1 = 1235123.533.133.2-12312312312338.2 to_string 与拼接
数字转字符串使用 to_string 的相应重载。浮点转换采用实现规定的格式和精度;在这里,3.1415926 得到 "3.141593",第七位发生四舍五入,所以它不适合需要自定义精度的格式化任务。
// 代码位置 2test_string.cpp 第 85—87 行 // 把圆周率近似值转成字符串 auto pistr = to_string(3.1415926); // 输出浮点转换结果 cout << "pistr = " << pistr << endl; // 转换并输出负整数 cout << to_string(-19998) << endl;string 使用 + 和 += 拼接,字符串对象与字面量可以组合。两个字面量不能直接相加,整数也不能直接与字符串相加;线程编号要先通过 to_string 转换。相关行为来自 operator+ 的重载。
// 代码位置 2test_string.cpp 第 90—98 行 // 定义日志结果字符串 string log; // 定义日志正文 string txt = "login success!"; // 定义用户名 string user = "xcj"; // 定义线程编号 int thread_id = 1023; // 拼接用户、正文和分隔符 log = user + ":" + txt + ":" // 转换线程编号后继续拼接 + to_string(thread_id); // 在日志前添加级别 log = "[debug]" + log; // 在日志末尾追加分号 log += ";"; // 输出完整日志 cout << log << endl;pistr = 3.141593-19998[debug]xcj:login success!:1023;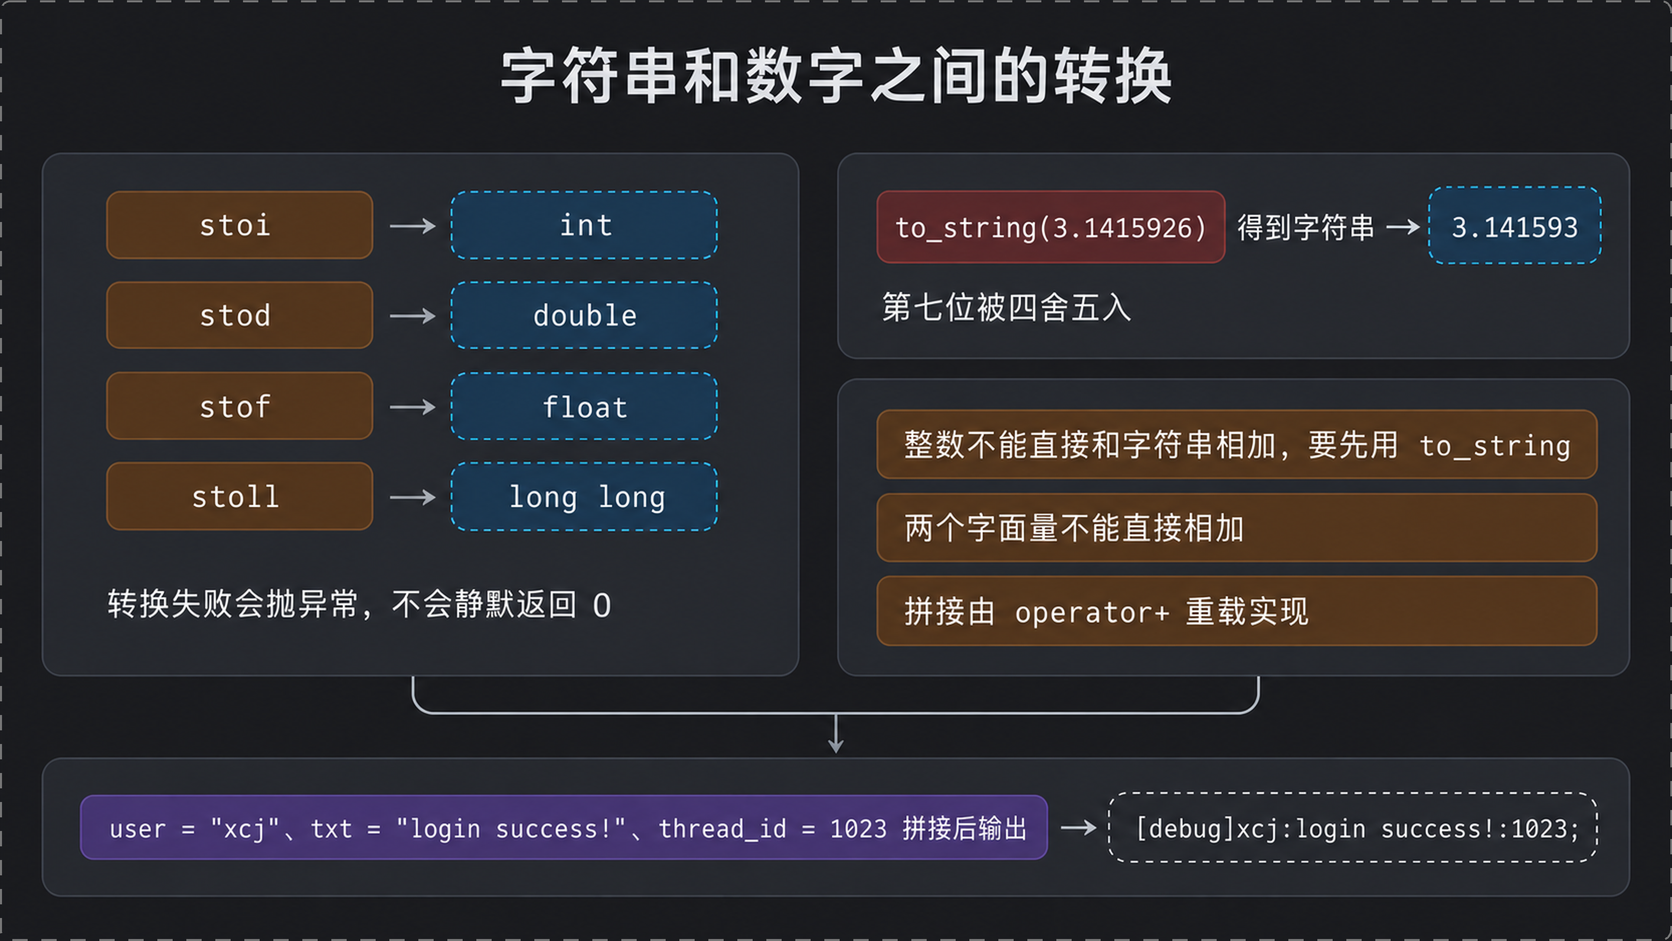
九、查找与替换
9.1 find 与 npos
find 返回子串第一次出现的下标,找不到时返回 string::npos。npos 等价于 static_cast<size_type>(-1),转换到无符号类型后通常表现为最大值,例如 64 位环境中的 18446744073709551615。标准写法是与 string::npos 比较,不要用字面量 -1 猜测实现细节。
每次查找后都要判断结果。若未经检查便将位置传给 substr 或 replace,可能触发越界错误。
9.2 replace 会修改原串
replace(起始位置, 被替换长度, 新字符串) 按位置和长度修改内容。它并不直接接受“旧子串”作为替换目标,因此通常先用 find 取得位置,再用旧子串的 size() 取得长度。新旧字符串长度可以不同。
replace 就地修改原字符串,并返回自身引用。后面还需要原内容时,要在调用前复制备份。下面片段先查找不存在的 [test],再找到 [user] 的位置 14,把六个字符替换为 xcj。
// 代码位置 2test_string.cpp 第 101—123 行 // 初始化待查找字符串 string strfind = "test for find [user] test"; // 查找不存在的测试标记 auto pos = strfind.find("[test]"); // 定义替换后的用户名 string suser = "xcj"; // 判断测试标记是否未找到 if (pos == string::npos) // 开始未找到分支 { // 输出未找到提示 cout << "[test] not find" << endl; // 结束未找到分支 } // 定义需要查找的键 string key = "[user]"; // 查找用户占位标记 pos = strfind.find(key); // 输出命中位置 cout << "pos = " << pos << endl; // 判断用户标记是否命中 if (pos != string::npos) // 开始命中分支 { // 输出命中位置之后的子串 cout << strfind.substr(pos)<<endl; // 备份替换前的字符串 auto bak = strfind; // 调用原地替换并保存返回引用 auto re = strfind.replace( // 传入替换起点 pos, // 传入旧标记长度 key.size(), // 传入新的用户名 suser // 结束替换调用 ); // 输出替换前的备份 cout << bak << endl; // 输出替换后的字符串 cout << re << endl; // 结束命中分支 }[test] not findpos = 14[user] testtest for find [user] testtest for find xcj test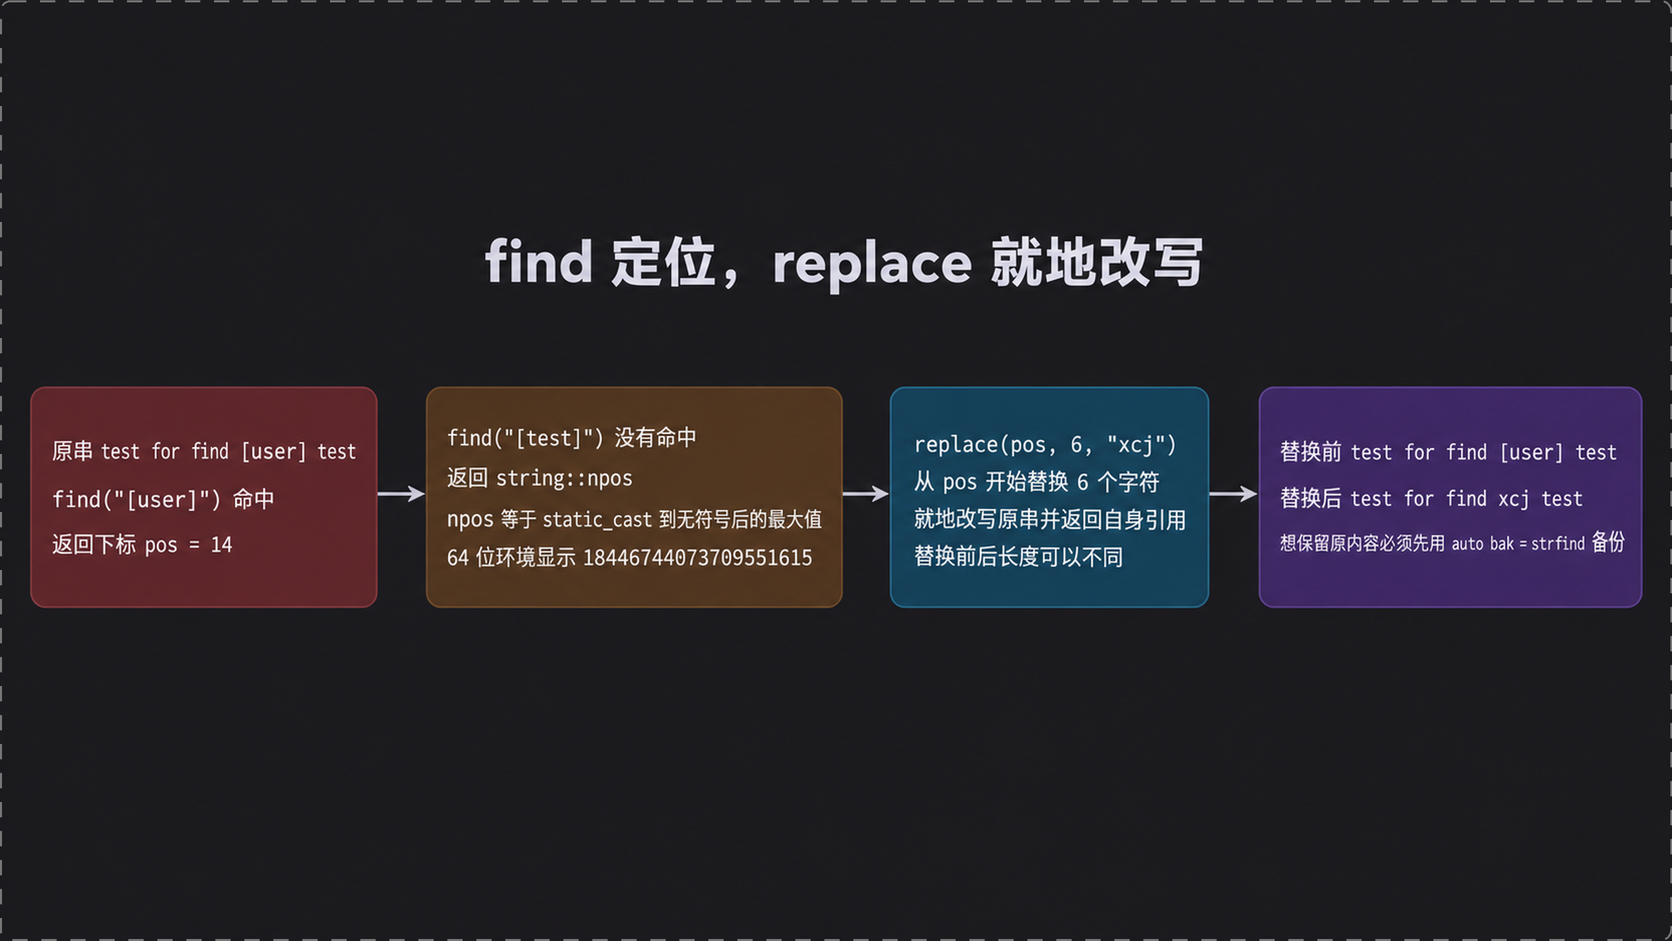
十、枚举:给有限取值命名
10.1 传统 enum 与 enum class
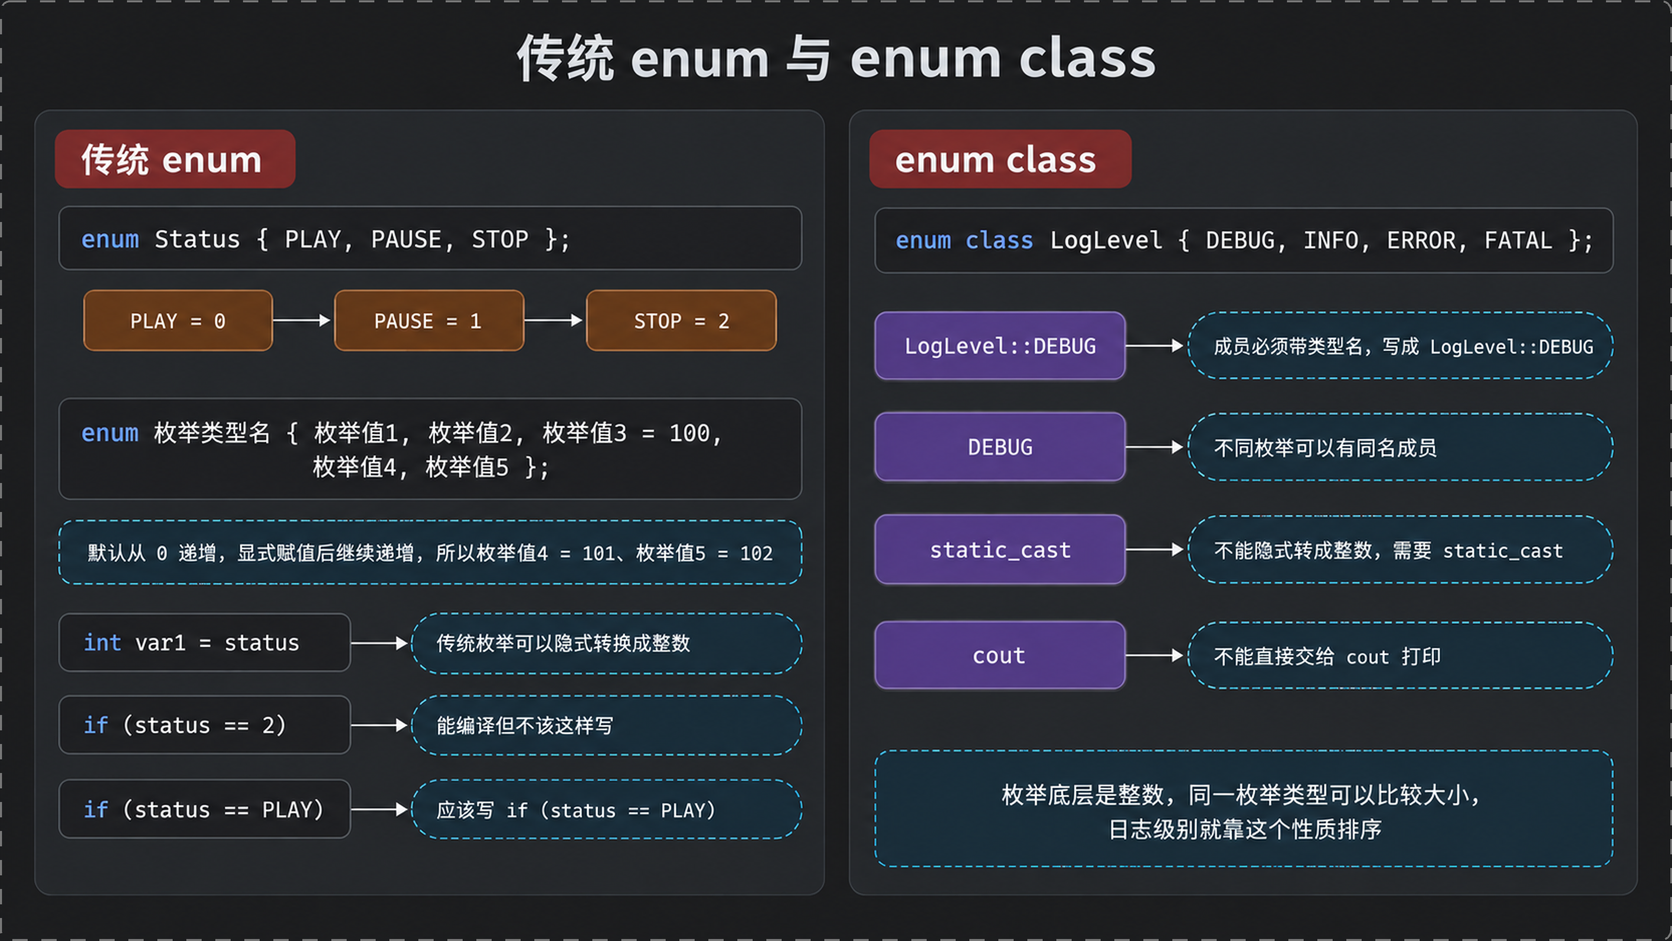
传统 enum 的成员默认从 0 开始递增。某个成员显式赋值后,后续成员从该值继续递增,因此 枚举值3 = 100 后,枚举值4 是 101,枚举值5 是 102。输出枚举时得到的是整数值,不会自动得到成员名称。
传统枚举能隐式转换为整数,写法方便,却可能让接口重载选择和比较失去类型约束。enum class 从 C++11 开始提供作用域枚举:成员要写成 LogLevel::DEBUG,不同枚举可以拥有同名成员;它不能隐式转换为整数,也不能直接交给 cout,需要显式 static_cast<int>。
// 代码位置 3test_enum.cpp 第 12—34 行// 定义传统枚举类型enum 枚举类型名// 开始枚举成员列表{ // 定义默认值为零的成员 枚举值1, // 定义顺序递增的成员 枚举值2, // 显式设置成员值为一百 枚举值3 = 100, // 定义值为一百零一的成员 枚举值4, // 定义值为一百零二的成员 枚举值5,// 结束传统枚举定义};// 定义播放状态枚举enum Status// 开始状态成员列表{ // 定义播放状态 PLAY, // 定义暂停状态 PAUSE, // 定义停止状态 STOP// 结束状态枚举定义};// 定义有作用域的日志级别enum class LogLevel// 开始日志级别列表{ // 定义调试级别 DEBUG, // 定义信息级别 INFO, // 定义错误级别 ERROR, // 定义致命错误级别 FATAL// 结束日志级别定义};示例里的类型名和成员名用了中文,只是为了对照讲授方便;实际项目应使用英文标识符,避免换编译器或换编辑器时的编码问题。
10.2 比较与类型约束
枚举底层具有整数表示,因此同一枚举类型的值可以比较大小。日志级别正是借助这一性质按严重程度排序。传统枚举虽然允许 status == 2,但 status == PLAY 更能表达意图。
// 代码位置 3test_enum.cpp 第 39—62 行 // 初始化日志级别 LogLevel level{ LogLevel::DEBUG }; // 显式转换日志级别为整数 int s = static_cast<int>(level); // 输出转换后的整数 cout << s << endl; // 定义日志阈值 LogLevel log_level = LogLevel::DEBUG; // 比较当前级别与阈值 if (level <= log_level) // 开始记录日志分支 { // 输出记录提示 cout << "记录日志" << endl; // 结束记录日志分支 } // 初始化传统枚举变量 枚举类型名 ev1{ 枚举值5 }; // 输出第一个枚举成员值 cout << "枚举值1 = " << 枚举值1 << endl; // 输出第四个枚举成员值 cout << "枚举值4 = " << 枚举值4 << endl; // 初始化停止状态 Status status{ STOP }; // 隐式转换状态为整数 int var1 = status; // 用整数比较状态 if (status == 2) // 开始整数比较分支 { // 输出停止状态提示 cout << "2 STOP" << endl; // 结束整数比较分支 } // 把状态改为播放 status = PLAY; // 用枚举成员比较状态 if (status == PLAY) // 开始枚举比较分支 { // 输出播放状态值和名称 cout << PLAY<<" PLAY" << endl; // 结束枚举比较分支 }枚举适合日志级别、消息类型等有限分类,类型明确且比较高效。添加新成员需要修改并重新编译代码;字符串分类有时更易扩展,但会付出运行时比较和拼写校验方面的代价。
十一、main 的参数
11.1 argc、argv 与 env
入口函数可以写成 int main() 或 int main(int argc, char* argv[])。一些实现还支持 int main(int argc, char* argv[], char* env[]),用第三个参数接收环境变量数组;这种三参数形式不是标准 C++ 签名。参数名可改,函数名 main 不可改。
argc 表示参数数量,argv 是字符串数组。不传用户参数时,argc 仍为 1,因为 argv[0] 保存可执行文件自身的路径;用户输入从 argv[1] 开始。读取 argv[i] 前必须检查 argc > i。传入值全是字符串,需要数值时再转换。
环境变量数组没有单独的数量参数,末尾用 nullptr 标记。多数程序无需直接接收它。
// 代码位置 4test_main.cpp 第 13—29 行 // 输出参数总数 cout << "argc = " << argc << endl; // 输出程序自身路径 cout << "argv[0] = " << argv[0] << endl; // 检查第一个用户参数是否存在 if (argc > 1) // 输出第一个用户参数 cout << argv[1] << endl; // 检查第二个用户参数是否存在 if (argc > 2) // 输出第二个用户参数 cout << argv[2] << endl; // 检查第三个用户参数是否存在 if (argc > 3) // 输出第三个用户参数 cout << argv[3] << endl; // 输出第一项环境变量 cout << env[0] << endl;命令参数填 DEBUG 16 3.14 时,这段程序打印:
argc = 4DEBUG163.14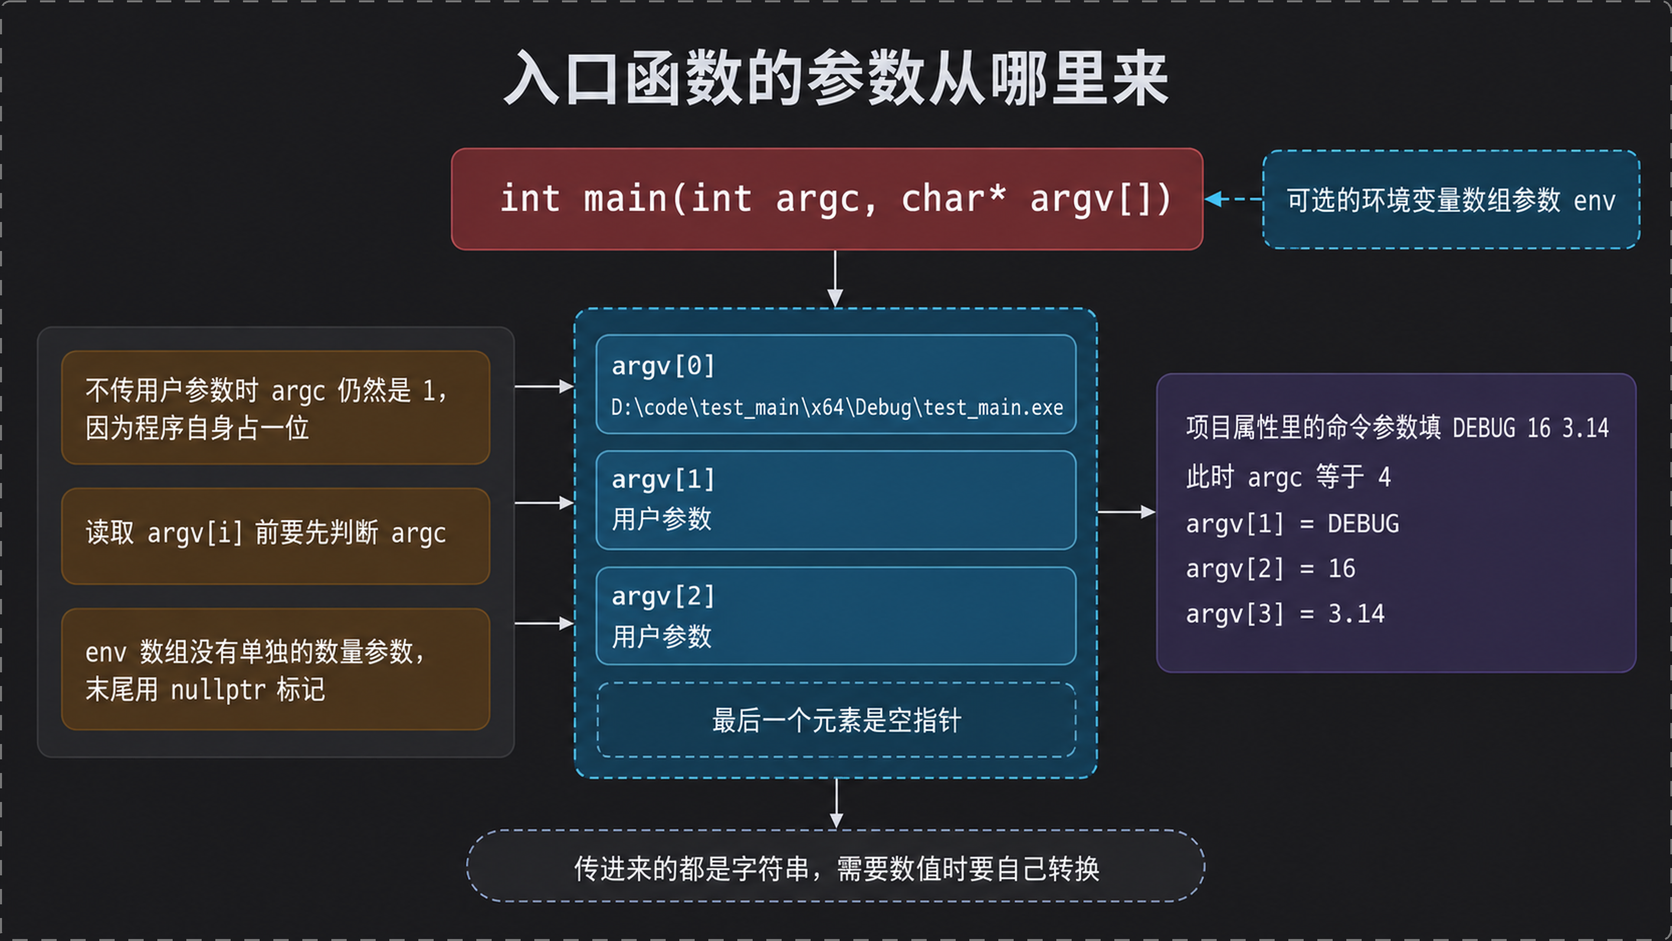
11.2 参数从哪里传入
Visual Studio 可在“项目属性 → 调试 → 命令参数”中填写 DEBUG 16 3.14,此时 argc 为 4。命令行则把参数依次写在程序名后并用空格分隔。PowerShell 执行当前目录中的程序时要写 ./test_main 或 Windows 形式的 .\test_main;若系统提示无法识别命令,通常应检查路径和程序名。
操作系统启动进程时将这些文本传给入口函数,因此命令行参数也是不同语言或不同程序之间传递少量数据的一种简洁方式。
十二、switch:按整数值跳转
12.1 case、break 与作用域
switch 接受整型或能隐式转换为整型的表达式,枚举也符合条件,字符串则不行。case 后必须是常量表达式,编译器可据此把取值映射到代码位置。它体现的是按值跳转,而一长串 if / else if 通常要依次计算条件。
命中某个 case 后,程序从该标签处开始向下执行。break 负责退出整个 switch;缺少它时会穿透到后续分支。所有 case 共用作用域,在某个分支中定义局部变量时,应增加一对花括号,防止跳转绕过初始化却进入变量作用域。
// 代码位置 6test_switch.cpp 第 13—34 行 // 初始化分支选择值 int x{ 0 }; // 读取分支选择值 cin >> x; // 按整数值选择分支 switch (x) // 开始 switch 语句 { // 定义数值零的分支 case 0: // 输出零分支信息 cout << "case 0\n"; // 退出 switch break; // 定义数值一的分支 case 1: // 创建该分支的局部作用域 { // 定义分支内局部变量 int x1{ 100 }; // 输出局部变量 cout << "begin 1 "<< x1 << endl; // 输出一分支信息 cout << "case 1\n"; // 退出 switch break; // 结束局部作用域 } // 定义数值二的分支 case 2: // 输出二分支信息 cout << "case 2\n"; // 退出 switch break; // 定义默认分支 default: // 输出默认分支信息 cout << "default\n"; // 结束 switch 语句 }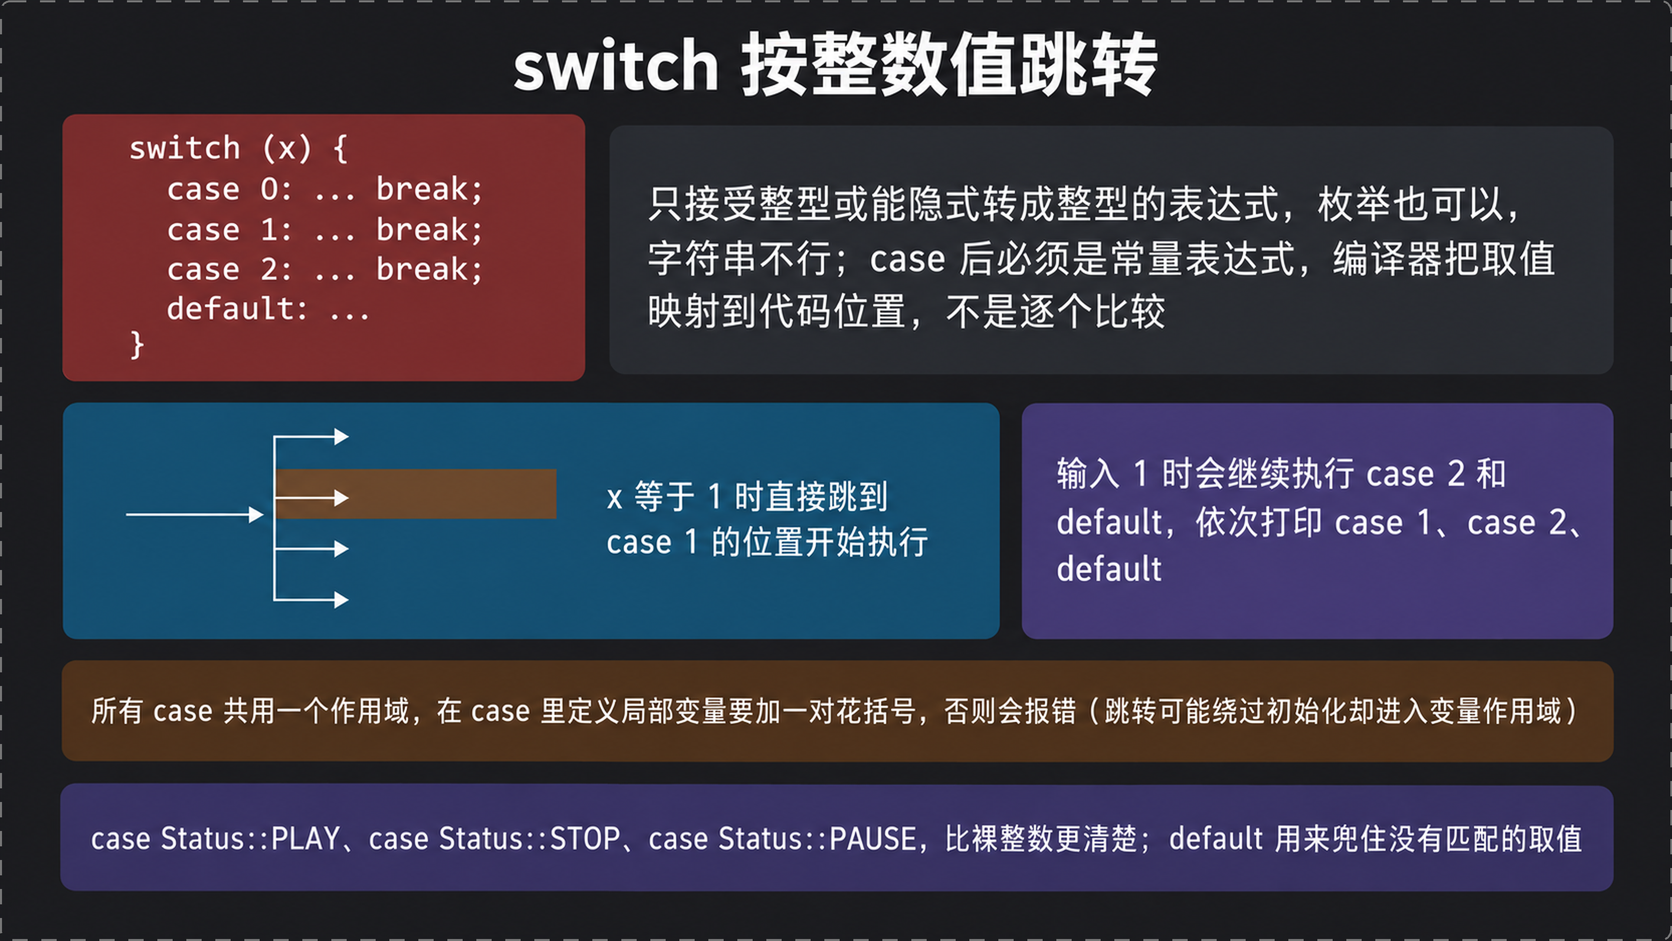
default 在没有任何 case 匹配时执行,保留它有助于记录无法识别的输入。若故意去掉 case 1 的 break,输入 1 会继续执行 case 2 和 default。穿透有特定用途,但必须让意图明确。
12.2 枚举作为 case 标签
枚举成员比裸整数更适合作为标签,名称已经表达状态含义。C++17 允许在 switch 条件处加入初始化语句,但面向 C++11 或 C++14 的项目不能依赖这一语法。
// 代码位置 6test_switch.cpp 第 36—50 行 // 初始化播放状态 Status status{ Status::PLAY }; // 按枚举值选择分支 switch (status) // 开始状态分支 { // 处理播放状态 case Status::PLAY: // 输出播放提示 cout << "Play" << endl; // 退出状态分支 break; // 处理停止状态 case Status::STOP: // 输出停止提示 cout << "STOP" << endl; // 退出状态分支 break; // 处理暂停状态 case Status::PAUSE: // 输出暂停提示 cout << "PAUSE" << endl; // 退出状态分支 break; // 处理未列出的状态 default: // 退出默认分支 break; // 结束状态分支 }switch 适合整数和枚举的离散分派;字符串分类扩展更灵活,却需要字符串比较。两种结构的选择取决于数据表示和兼容性要求。
十三、实战:按级别过滤日志
13.1 从参数得到最低输出级别
日志级别定义为 DEBUG、INFO、ERROR、FATAL,对应 0、1、2、3,数值越大表示问题越严重。最低输出级别由运行参数设置,不传时默认 DEBUG。调试信息量较大,生产环境常提高阈值以减少输出;FATAL 表示可能导致程序终止的严重错误,应保留记录。
参数解析使用 if / else if 比较 argv[1]。命中一个字符串后不再判断其余选项。输出前比较 level >= logLevel:阈值为 DEBUG 时四级都满足,阈值为 ERROR 时仅 ERROR 和 FATAL 满足。若阈值比较方向写反,更严重的日志反而会被过滤。
// 代码位置 old/5test_main_log.cpp 第 27—57 行 // 设置默认日志阈值为调试级别 auto logLevel = LogLevel::DEBUG; // 检查是否传入级别参数 if (argc > 1) // 开始参数解析 { // 读取级别字符串 string levelStr = argv[1]; // 判断信息级别参数 if ("info" == levelStr) // 设置阈值为信息级别 logLevel = LogLevel::INFO; // 判断错误级别参数 else if("error" == levelStr) // 设置阈值为错误级别 logLevel = LogLevel::ERROR; // 判断致命错误级别参数 else if("fatal" == levelStr) // 设置阈值为致命错误级别 logLevel = LogLevel::FATAL; // 结束参数解析 } // 创建单条日志的局部作用域 { // 设置当前日志级别 LogLevel level = LogLevel::DEBUG; // 设置当前日志正文 string context = "test log 1"; // 判断当前级别是否达到阈值 if (level >= logLevel) // 开始日志输出分支 { // 设置默认级别文本 string levelStr = "debug"; // 判断信息级别 if (LogLevel::INFO == level) // 设置文本为信息级别 levelStr = "info"; // 判断错误级别 else if (LogLevel::ERROR == level) // 设置文本为错误级别 levelStr = "error"; // 判断致命错误级别 else if (LogLevel::FATAL == level) // 设置文本为致命错误级别 levelStr = "fatal"; // 拼接并输出日志 cout << levelStr + ":" << context << endl; // 结束日志输出分支 } // 结束单条日志作用域 }四条日志各用一对大括号形成局部作用域,内部可以重复使用 level、levelStr、context。当前阶段尚未引入函数,因此相同结构会复制四份;复制时要包含完整的大括号范围,并保持括号对应和语句分号完整。
13.2 用 switch 映射级别名称
级别到文本的映射也可以改用 switch。levelstr 默认是 "debug",因此分支从 INFO 开始即可。它与前面的 if / else if 语义一致,但枚举标签让映射关系更集中。
// 代码位置 5test_main_log.cpp 第 43—55 行 // 按日志级别选择文本 switch (level) // 开始级别映射 { // 处理信息级别 case LogLevel::INFO: // 设置文本并退出分支 levelstr = "info";break; // 处理错误级别 case LogLevel::ERROR: // 设置文本并退出分支 levelstr = "error";break; // 处理致命错误级别 case LogLevel::FATAL: // 设置文本并退出分支 levelstr = "fatal";break; // 结束级别映射 } // 输出级别和日志正文 cout << levelstr << ":" << context << endl; // 结束日志阈值分支 } // 结束单条日志作用域 }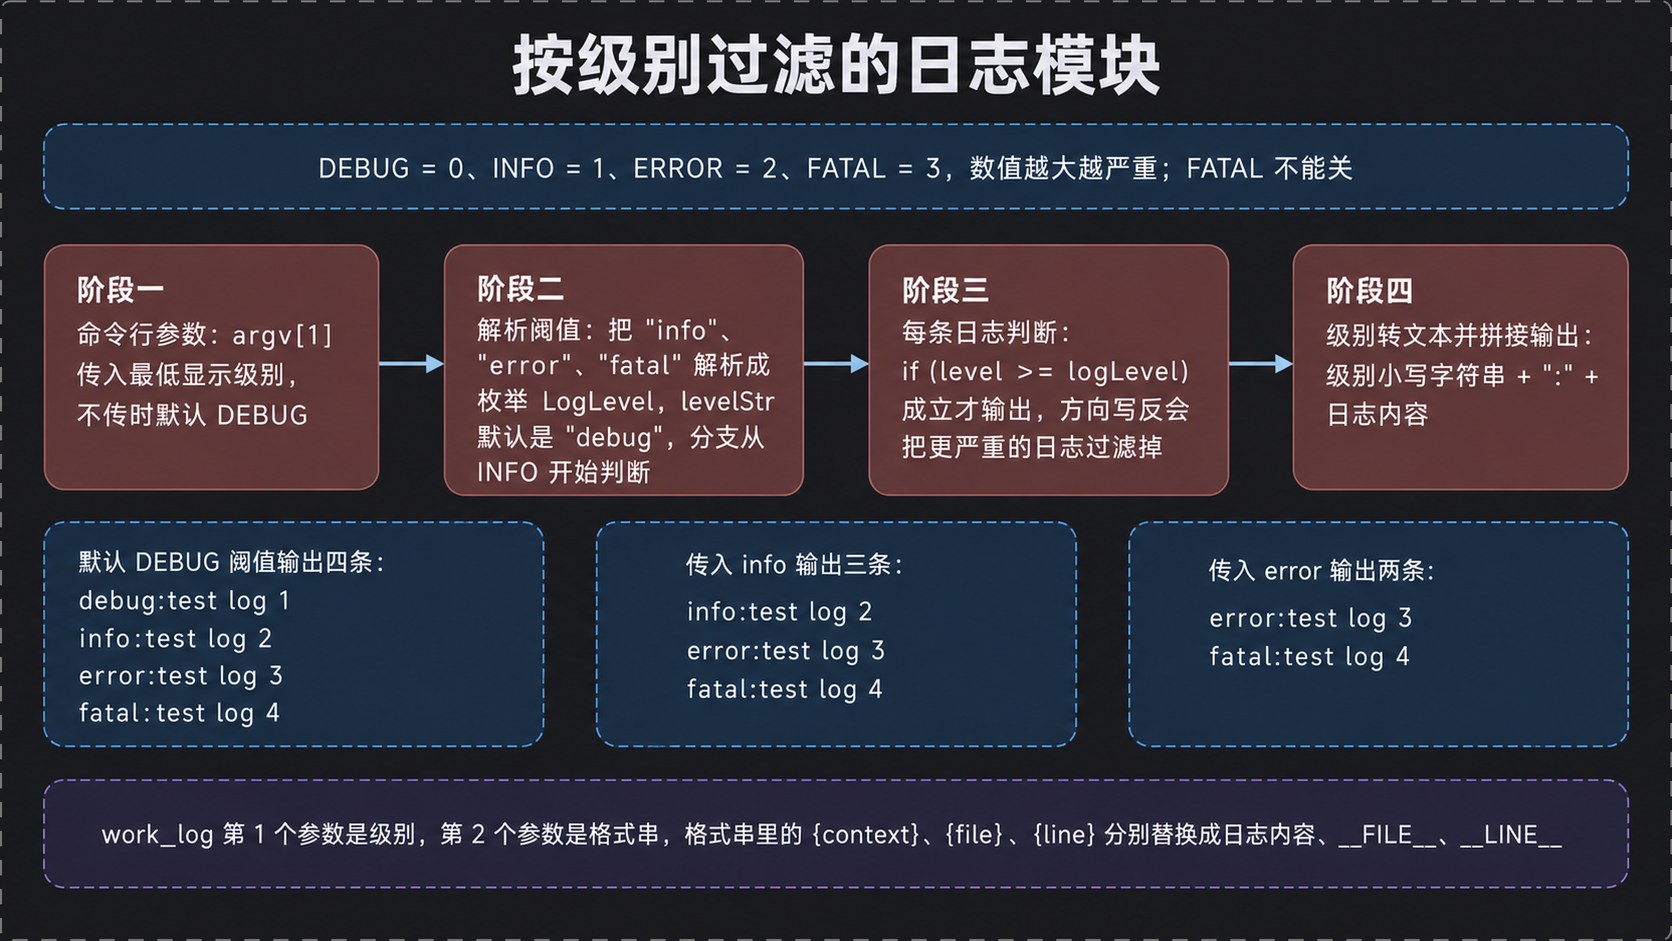
默认 DEBUG 阈值会输出 debug:test log 1、info:test log 2、error:test log 3、fatal:test log 4。传入 info 后保留后三条,传入 error 后保留后两条。这组结果也能用来检查比较方向。
13.3 格式串替换练习
练习 work_log 接收两个参数:第一个是级别,第二个是格式串。程序把格式串中的 {context}、{file}、{line} 分别替换为日志正文、__FILE__ 和 __LINE__。后两个名称是预定义宏,展开为当前文件名和行号。行号要先用 to_string 转为字符串;格式串含空格时,命令行必须用一对双引号把它作为一个参数传入。预期形式为 test log context 001 c:\test.cpp:10。
到这里,判断已经进入工程代码:bool 表示真假,枚举定义级别集合,std::string 存储参数和日志文本,main 接收外部输入,switch 按枚举值完成分派。日志模块把这些数据表示和控制结构汇集在同一条执行路径中。
本文由 AgentWorkFlow 生成