
文章内容
- 1.1 与 Java IO 的设计对比
- 1.2 Demo测试(后续读写分析均围绕当前demo测试代码)
- 2.1 四层结构
- 2.2 UML 类图
- 2.3 核心数据结构:Segment 环形链表
- 2.4 平台适配:File.sink() 与 File.source()
- 3.1 writableSegment
- 3.2 SegmentPool 的无锁 take / recycle
- 3.3 零拷贝:Segment 引用的 push / pop 与 sharedCopy
- 3.4 emitCompleteSegments:什么时候真正写到底层?
- 4.1 写链路总时序图
- 4.2 Okio.sink(file) 与 Okio.buffer(fileSink)
- 4.3 writeUtf8
- 4.4 close 到整段落盘与 Segment 回收
- 5.1 读链路总时序图
- 5.2 FileSystem.SYSTEM.source(path)
- 5.3 readUtf8Line 按行读取
- 5.4 readString 消费与 close
一、Okio 简介
Okio 把Buffer从 BufferedOutputStream ByteArray,换成了「8 KiB 定长块组成的双向环形链表 + 全局无锁块池」,于是缓冲区可以按块移动而不是按字节拷贝,落盘粒度天然对齐到块边界,块用完之后回池复用。
1.1 与 Java IO 的设计对比
java.io 中的 InputStream / OutputStream,数据的载体是 byte[],边界靠 offset 和 length 两个 int 参数在调用链上层层传递,有三个问题:
读和写是两套不对称的 API。
InputStream.read(byte[], int, int)返回读到的字节数,OutputStream.write(byte[], int, int)没有返回值;想把一个流灌到另一个流里,必须自己写循环、自己准备中转数组。缓冲是「私有」的。
BufferedInputStream的buf是它自己的字段,外部拿不到;BufferedOutputStream的buf也是。两个带缓冲的流之间传数据,字节至少要经过:源缓冲 → 中转数组 → 目标缓冲,三段内存、两次拷贝。缓冲区扩容或搬移必然拷贝。定长
byte[]一旦写满,要么落盘要么System.arraycopy挪位置。
Okio 的对应优化:
Source取代InputStream,read(sink: Buffer, byteCount: Long): Long,读取的数据会直接追加到调用方传入的目标Buffer(sink)中。Sink取代OutputStream,方法签名是write(source: Buffer, byteCount: Long),待写数据会直接从调用方传入的源Buffer(source)中消费。Buffer取代byte[],它同时实现BufferedSource和BufferedSink,既是数据容器又是可读可写的流。
注意,Source.read 和 Sink.write 的参数都是 Buffer,而不是 byte[]。这种统一以 Buffer 作为数据源或目标的接口,是后续零拷贝优化的基础。数据在两个 Buffer 之间传输时,如果满足整块转移的条件,Okio 无需逐字节复制,只需将对应的 Segment 节点从源 Buffer 的链表中摘下,再挂到目标 Buffer 的链表上。
| 对比维度 | Java IO | Okio |
|---|---|---|
| 核心抽象 | InputStream / OutputStream |
Source / Sink |
| 数据载体 | 连续的 byte[] |
由 8 KiB Segment 组成的双向环形链表 Buffer |
| 读写接口 | 读写 API 不对称,以 offset、length 描述数组边界 |
两端统一以 Buffer 作为数据源或目标 |
| 缓冲所有权 | 缓冲区由各个包装流私有持有 | Buffer 是可在组件间传递的一级对象 |
| 跨端传输 | 通常需要中转数组和字节拷贝 | 满足条件时可直接转移完整 Segment 节点 |
| 内存复用 | 主要依赖各个流自行持有和复用数组 | 用完的 Segment 可回收到全局块池 |
1.2 Demo测试(后续读写分析均围绕当前demo测试代码)
public class Demo { public static void main(String[] args) throws Exception { // 将当前进程的环境变量写入当前目录下的 env.txt new WriteJavaIoFile().run(); // 逐行读取 README.md,并打印包含 square 的行 readLines(Path.get(new File("README.md"))); }}测试点:
bufferedSink.writeUtf8(...)之后,字节到底躺在哪里?谁决定它什么时候离开进程?- 8 KiB 这个数字从哪来,为什么是链表而不是数组?
readUtf8Line()如何在由多个Segment组成的链表中查找换行符?一行数据跨越多个Segment时又如何读取?- 块用完之后去哪了,下一次分配从哪来?
精简后的全流程总时序图: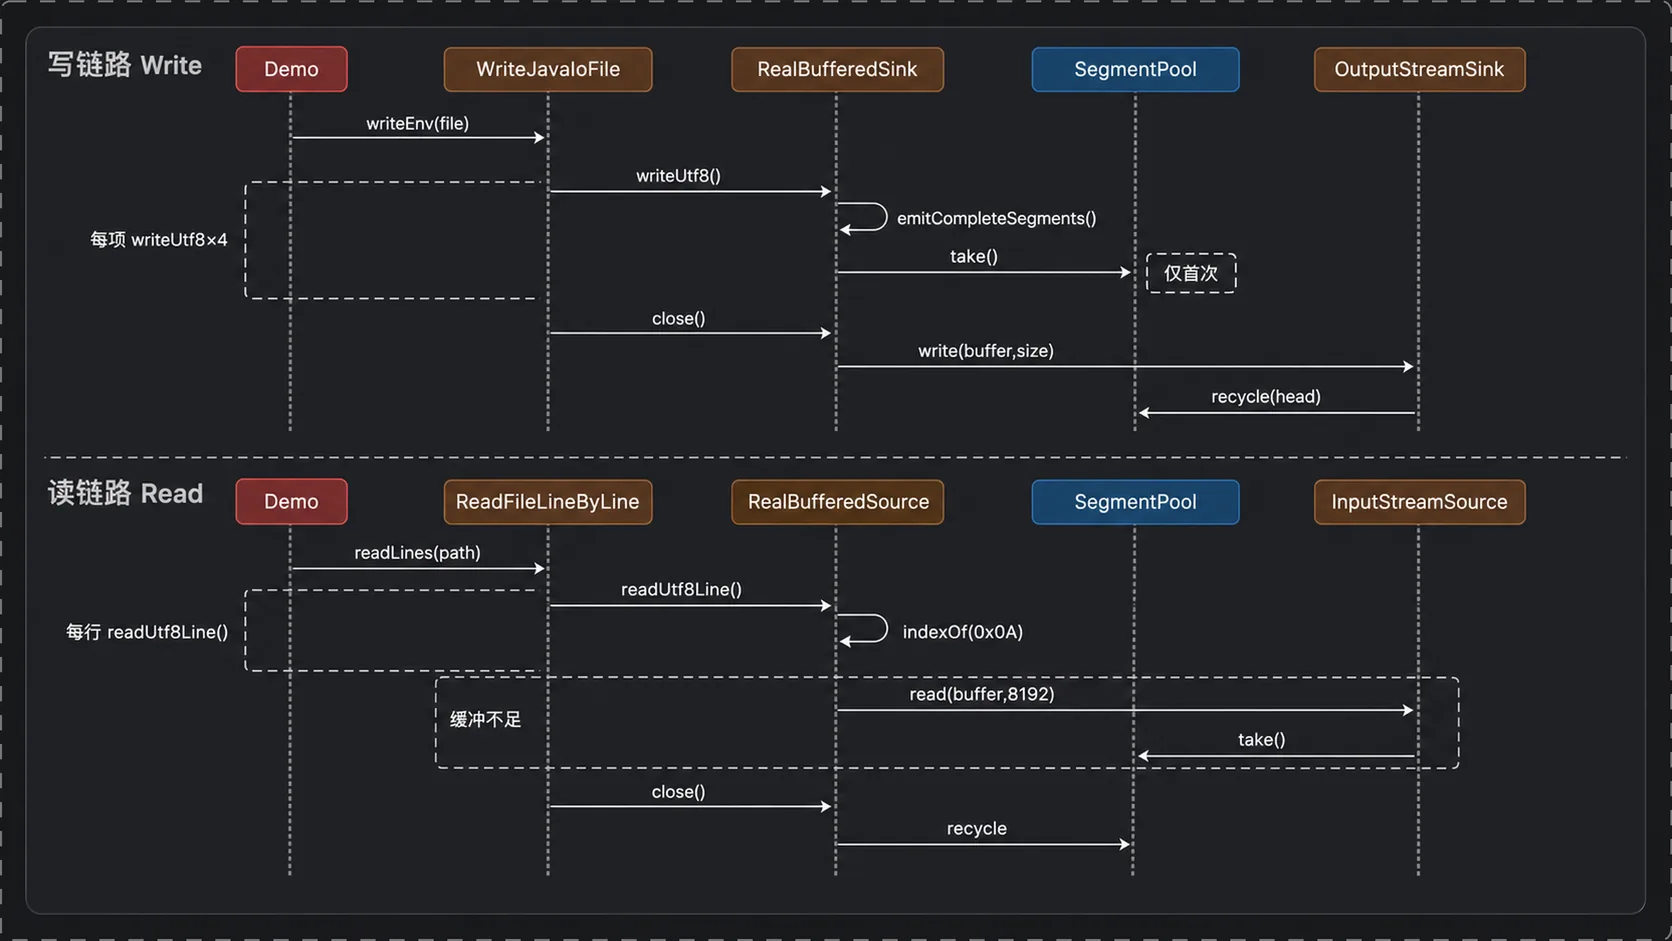
二、框架全景:分层与核心类型
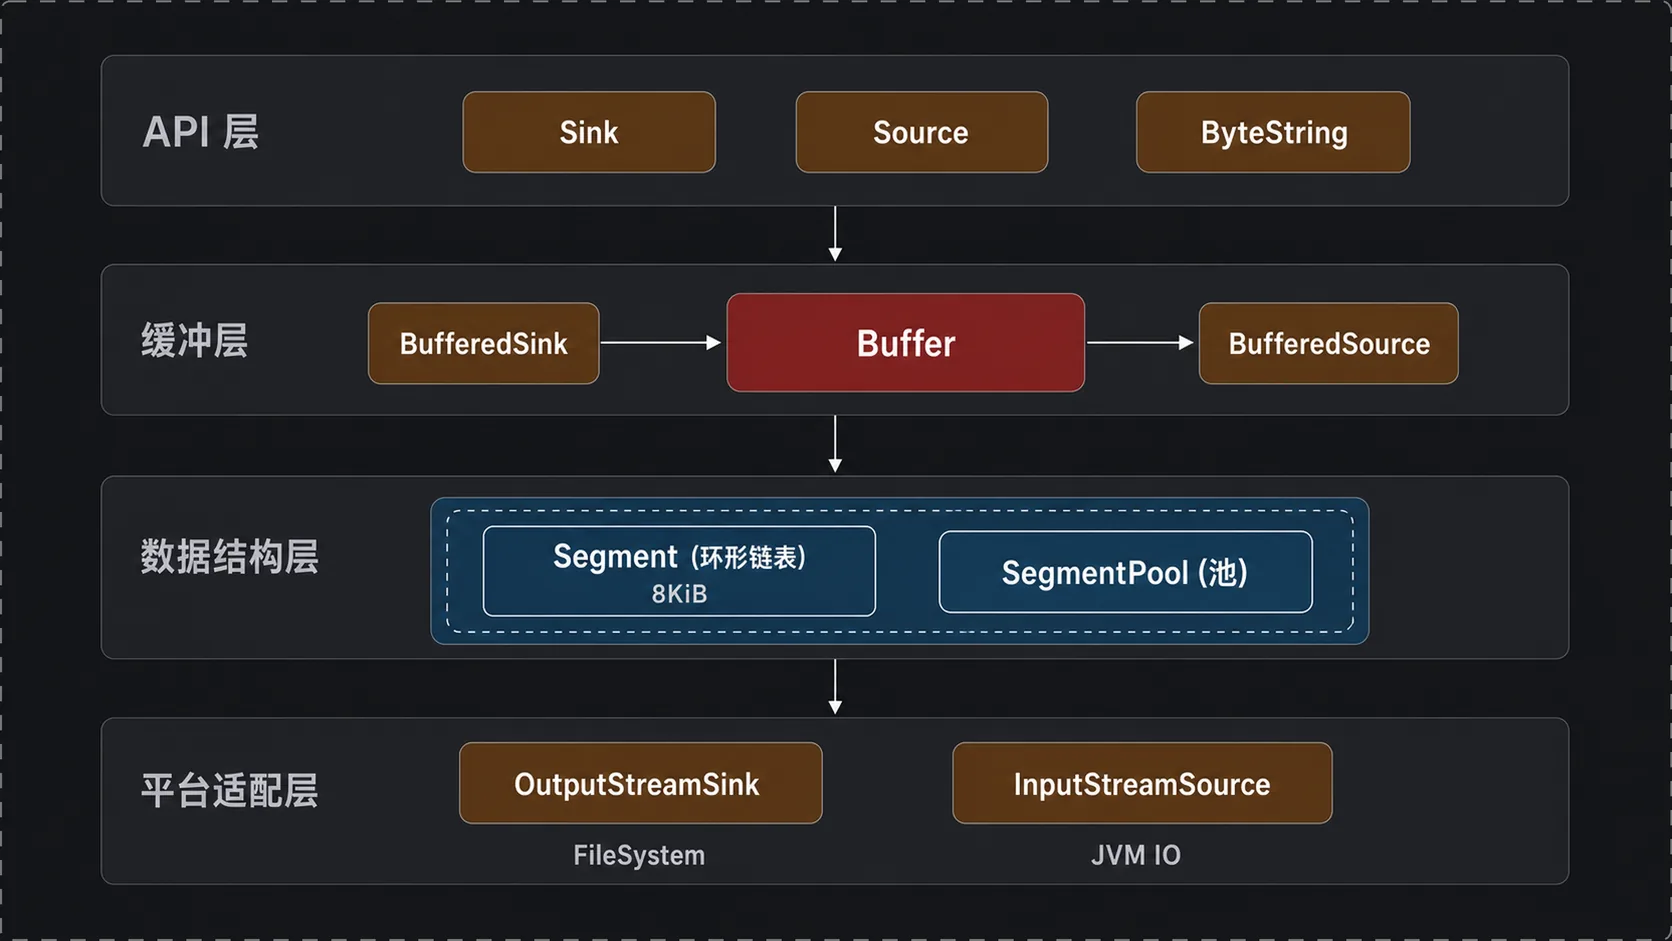
2.1 四层结构
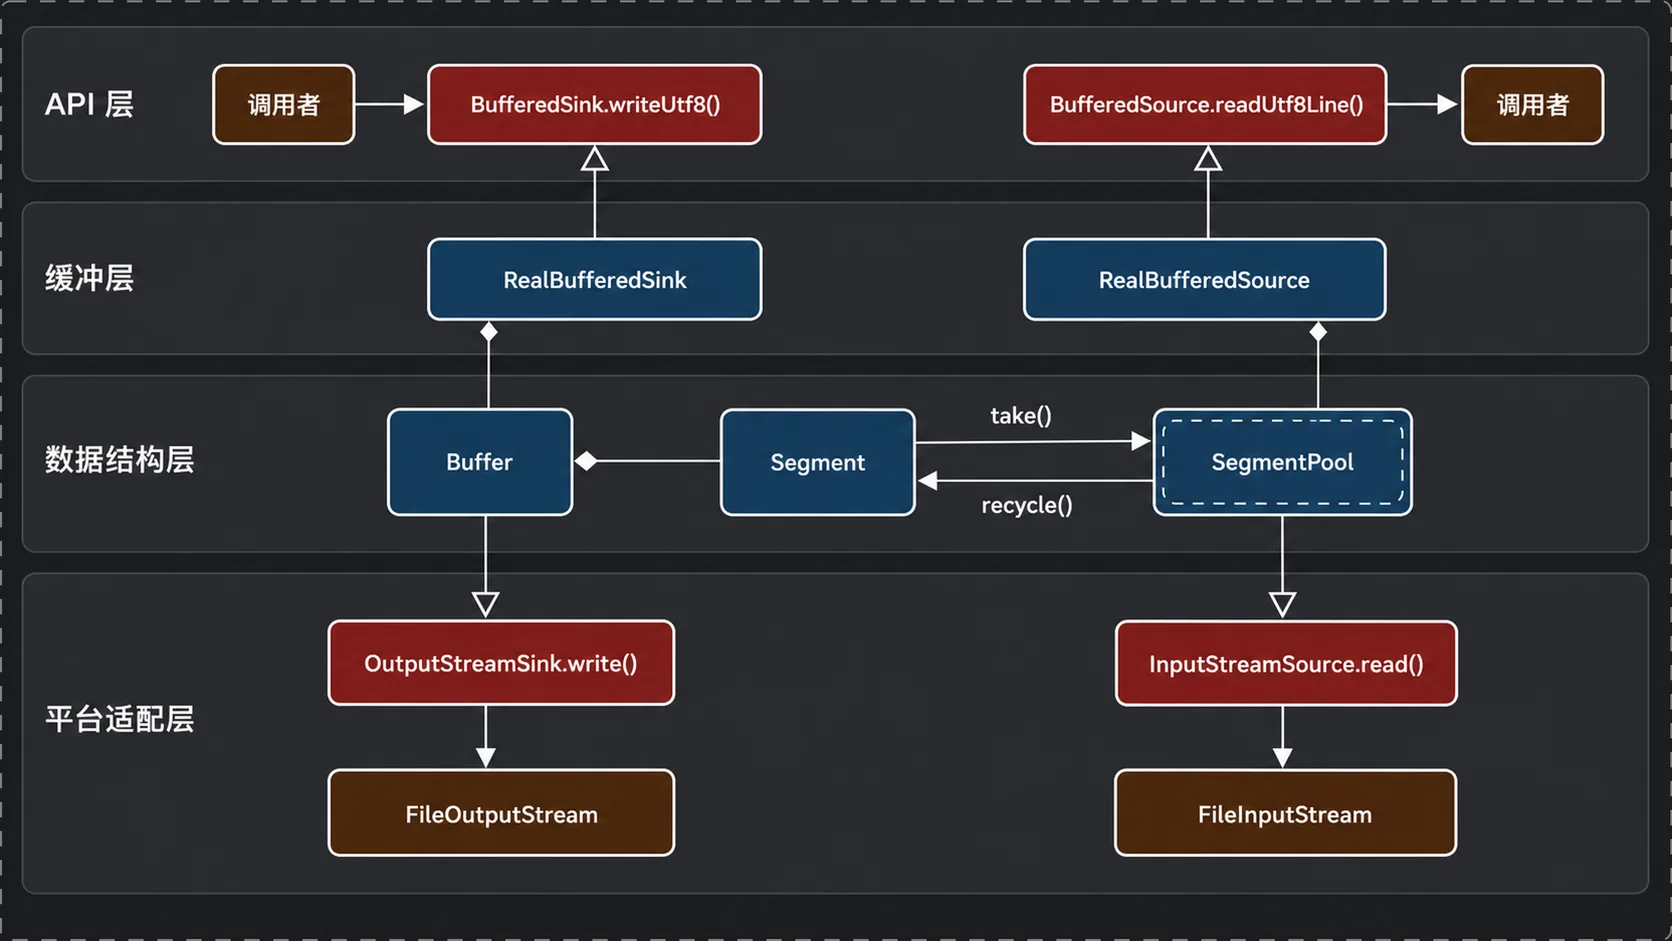
API 层:
Source和Sink定义最小化的读写协议,ByteString表示不可变字节序列。这一层只规定数据如何被读取、写入和表示,不负责缓冲;接入新的 IO 端点时,只需实现对应的Source或Sink接口。缓冲层:
BufferedSource、BufferedSink、Buffer、RealBufferedSource、RealBufferedSink。BufferedSource/BufferedSink是接口,在基础读写协议之上提供readUtf8Line/writeUtf8等通用 API;RealBufferedSource/RealBufferedSink是包装器,内部持有一个Buffer和一个下游Source/Sink;数据结构层:
Segment、SegmentPool。Segment是 8 KiB 块,SegmentPool是块池。平台适配层:
OutputStreamSink、InputStreamSource(都在jvmMain/okio/JvmOkio.kt,都是private class)、JvmSystemFileSystem。它们把 JVM 的InputStream/OutputStream/java.io.File桥接到Source/Sink。
Tips:Buffer 的核心算法几乎全部写在 commonMain/okio/internal/Buffer.kt 的 internal inline fun Buffer.commonXxx(...) 扩展函数里,而 jvmMain/okio/Buffer.kt 里的 actual class Buffer 只做转发,例如:
// jvmMain/okio/Buffer.kt:531,JVM 实现转发到 commonMaininternal actual fun writableSegment(minimumCapacity: Int): Segment = // 具体实现位于 commonMain/okio/internal/Buffer.kt:554 commonWritableSegment(minimumCapacity)2.2 UML 类图
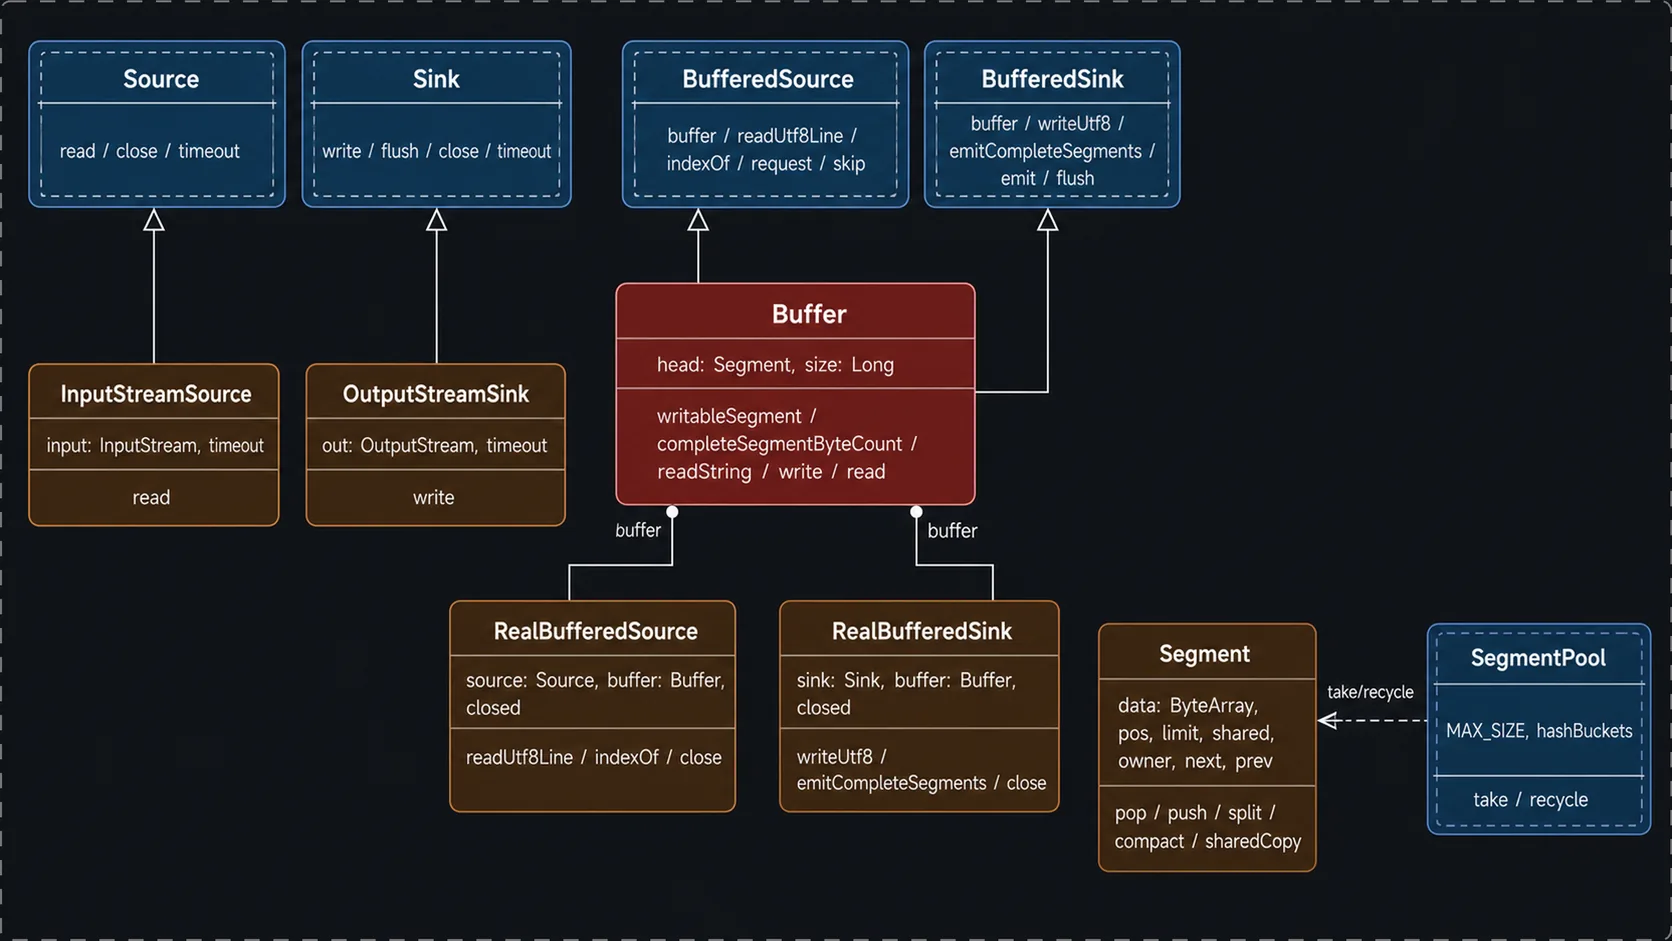
Buffer同时实现BufferedSource和BufferedSink,它既能被读也能被写,所以Buffer可以直接当作管道的两端。RealBufferedSink与它的下游Sink是「关联」而不是「继承」:RealBufferedSink不是OutputStreamSink的子类,它只是持有一个Sink引用。装饰关系在这里是运行时组合,Okio.buffer(fileSink)就是在做这件事。
2.3 核心数据结构:Segment 环形链表
commonMain/okio/Segment.kt 定义了整个框架的内存单元:
// Segment 仅在包内可见,不属于公开 APIinternal class Segment { // 底层字节数组,容量固定为 SIZE(8192)字节 @JvmField val data: ByteArray // 读游标:下一个待读字节在 data 中的下标 @JvmField var pos: Int = 0 // 写游标:下一个可写位置的下标;块在池中时,这个字段被复用为「本块及后继块的总字节数」 @JvmField var limit: Int = 0 // 是否与其他 Segment 或 ByteString 共享 data 数组 @JvmField var shared: Boolean = false // 是否拥有 data 数组;仅拥有者可在 limit 之后追加数据 @JvmField var owner: Boolean = false // 环形双向链表的后继 @JvmField var next: Segment? = null // 环形双向链表的前驱 @JvmField var prev: Segment? = null companion object { // 所有块的固定大小 const val SIZE = 8192 // 当要搬运的字节数不小于这个值时,split 选择共享数组而不是复制 const val SHARE_MINIMUM = 1024 }}pos 和 limit 构成一个滑动窗口:[pos, limit) 是有效数据,[limit, SIZE) 是可写空间,[0, pos) 是已消费的死区。读一个字节只需要 pos++,不需要把后面的数据往前挪。这是 Okio 与 ByteArrayInputStream 之类实现最本质的差别之一。
shared 和 owner 是一对:shared 说「别人也在看这块内存」,owner 说「我有权往后追加」。一个块可以既 shared 又非 owner(只读视图),也可以既非 shared 又 owner(独占,最常见)。SegmentPool.recycle 会检查 shared,共享块永远不回池。
链表操作:
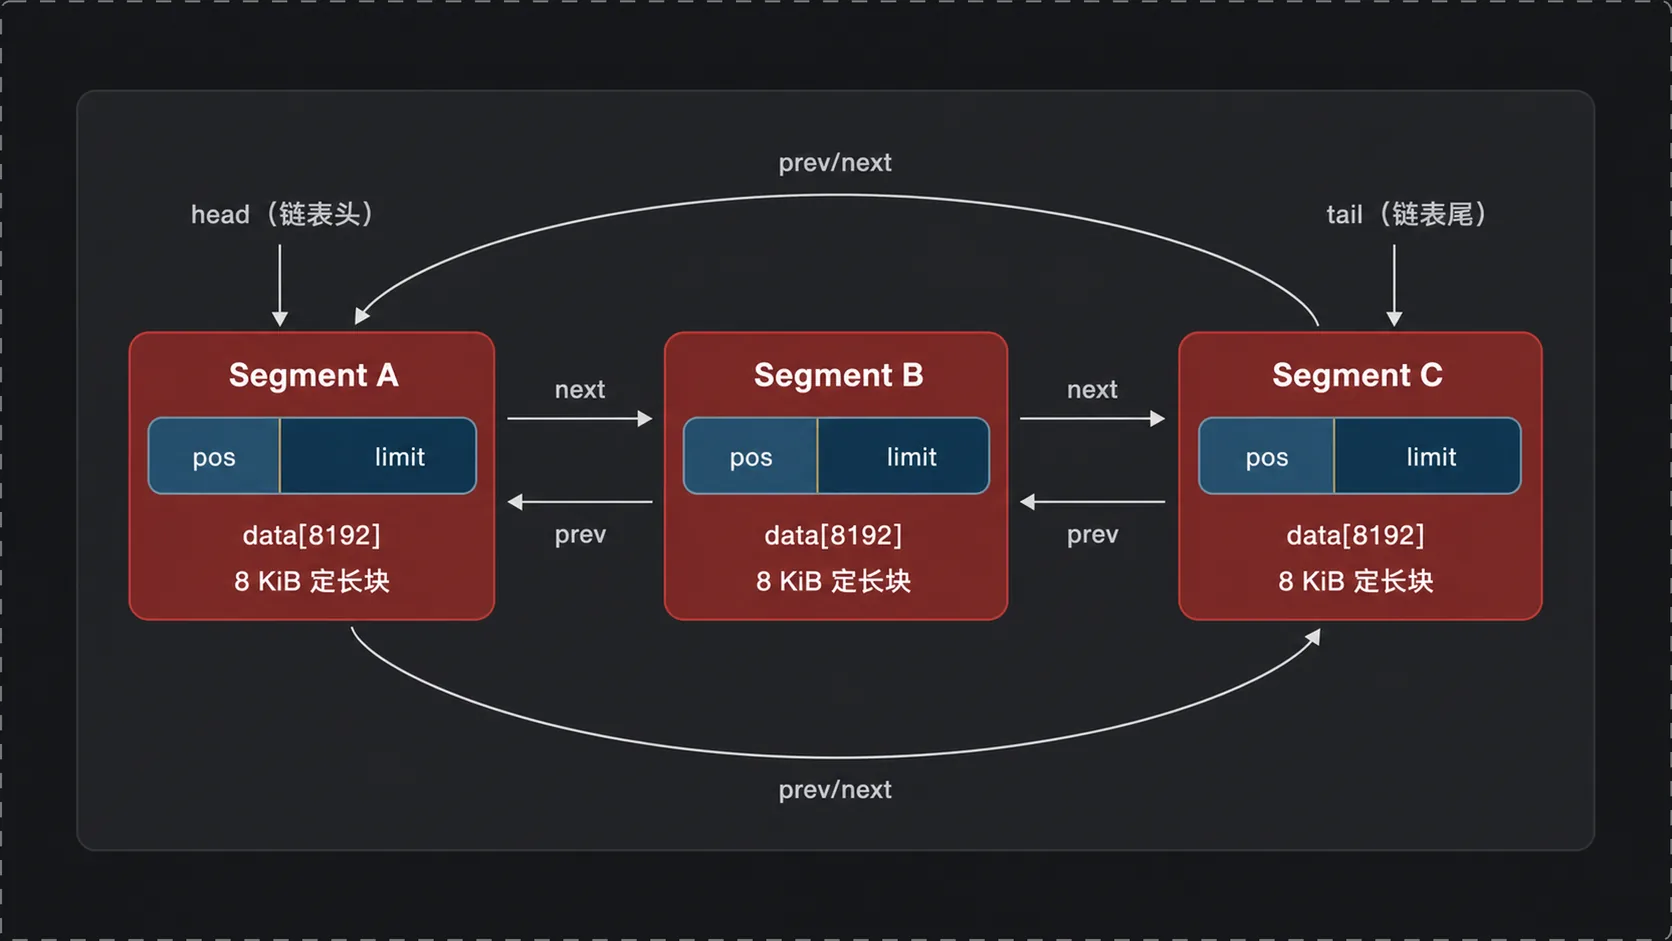
// 从环形链表移除当前节点;移除后为空则返回 nullfun pop(): Segment? { // next 指向自身时,链表仅包含当前节点 val result = if (next !== this) next else null // 前驱跳过当前节点并指向后继 prev!!.next = next // 后继跳过当前节点并指向前驱 next!!.prev = prev // 清除链表引用,满足 recycle 的脱链前置条件 next = null prev = null // 返回移除后的后继节点 return result} // 将 segment 插入当前节点之后并返回该节点fun push(segment: Segment): Segment { // 新节点前驱指向当前节点 segment.prev = this // 新节点后继指向当前节点原有的后继 segment.next = next // 原后继的前驱改为新节点 next!!.prev = segment // 当前节点的后继改为新节点 next = segment // 返回插入节点,供调用方继续操作 return segment}Buffer 只持有一个 head 指针。因为链表是环形的,head!!.prev 就是尾块,因此取尾块是 O(1)。
2.4 平台适配:File.sink() 与 File.source()
// JvmOkio.kt:179,Java API 暴露为 Okio.sink(File) 和 Okio.sink(File, boolean)@JvmOverloads@Throws(FileNotFoundException::class)// 创建 FileOutputStream,并复用 OutputStream.sink()fun File.sink(append: Boolean = false): Sink = FileOutputStream(this, append).sink() // JvmOkio.kt:187,文件读取使用 Timeout.NONE@Throws(FileNotFoundException::class)fun File.source(): Source = InputStreamSource(inputStream(), Timeout.NONE) // JvmOkio.kt:43,将 OutputStream 适配为带可配置 Timeout 的 Sinkfun OutputStream.sink(): Sink = OutputStreamSink(this, Timeout())OutputStreamSink 和 InputStreamSource 都是 private class,外部只能通过这些工厂函数拿到 Sink / Source 接口。适配层的全部工作就是在 Buffer 的块和 InputStream / OutputStream 的 (byte[], off, len) 之间做适配。
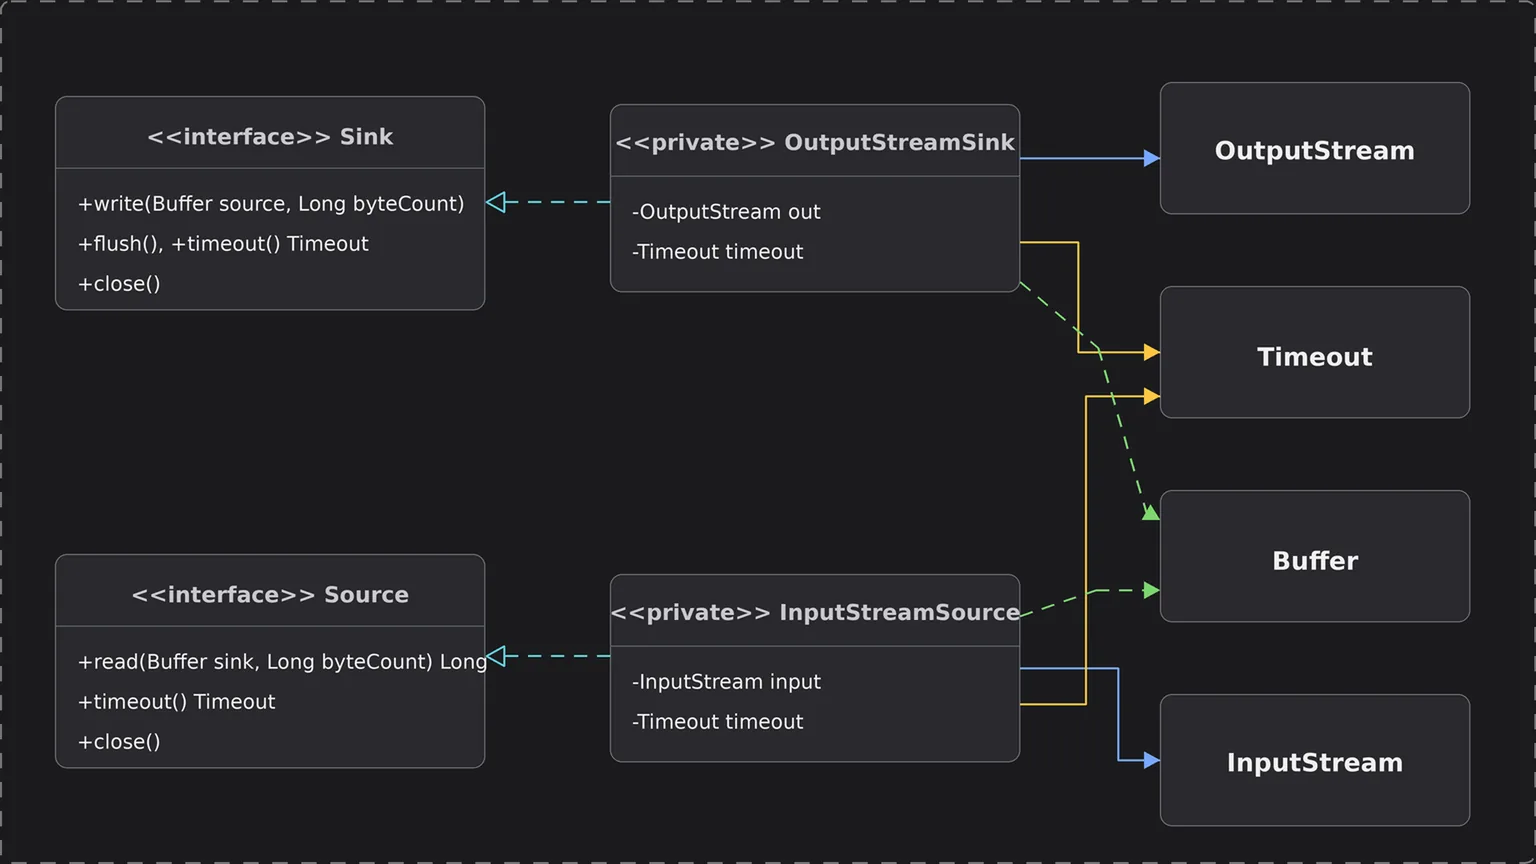
其中,虚线空心三角表示接口实现(OutputStreamSink 实现 Sink、InputStreamSource 实现 Source),虚线箭头表示 Buffer 只作为 write / read 的方法参数被使用。
三、核心实现类:Buffer
3.1 writableSegment
writableSegment 用于获取至少有 minimumCapacity 字节可用空间的尾部 Segment:能复用现有尾块就直接返回,否则追加新块。
相关API:
Buffer.writableSegment(minimumCapacity: Int): Segment:返回至少可写入minimumCapacity字节的尾块。Buffer.commonWritableSegment(minimumCapacity: Int): Segment:writableSegment在commonMain中的具体实现。SegmentPool.take(): Segment:尾块不可用时,从块池获取可写Segment。
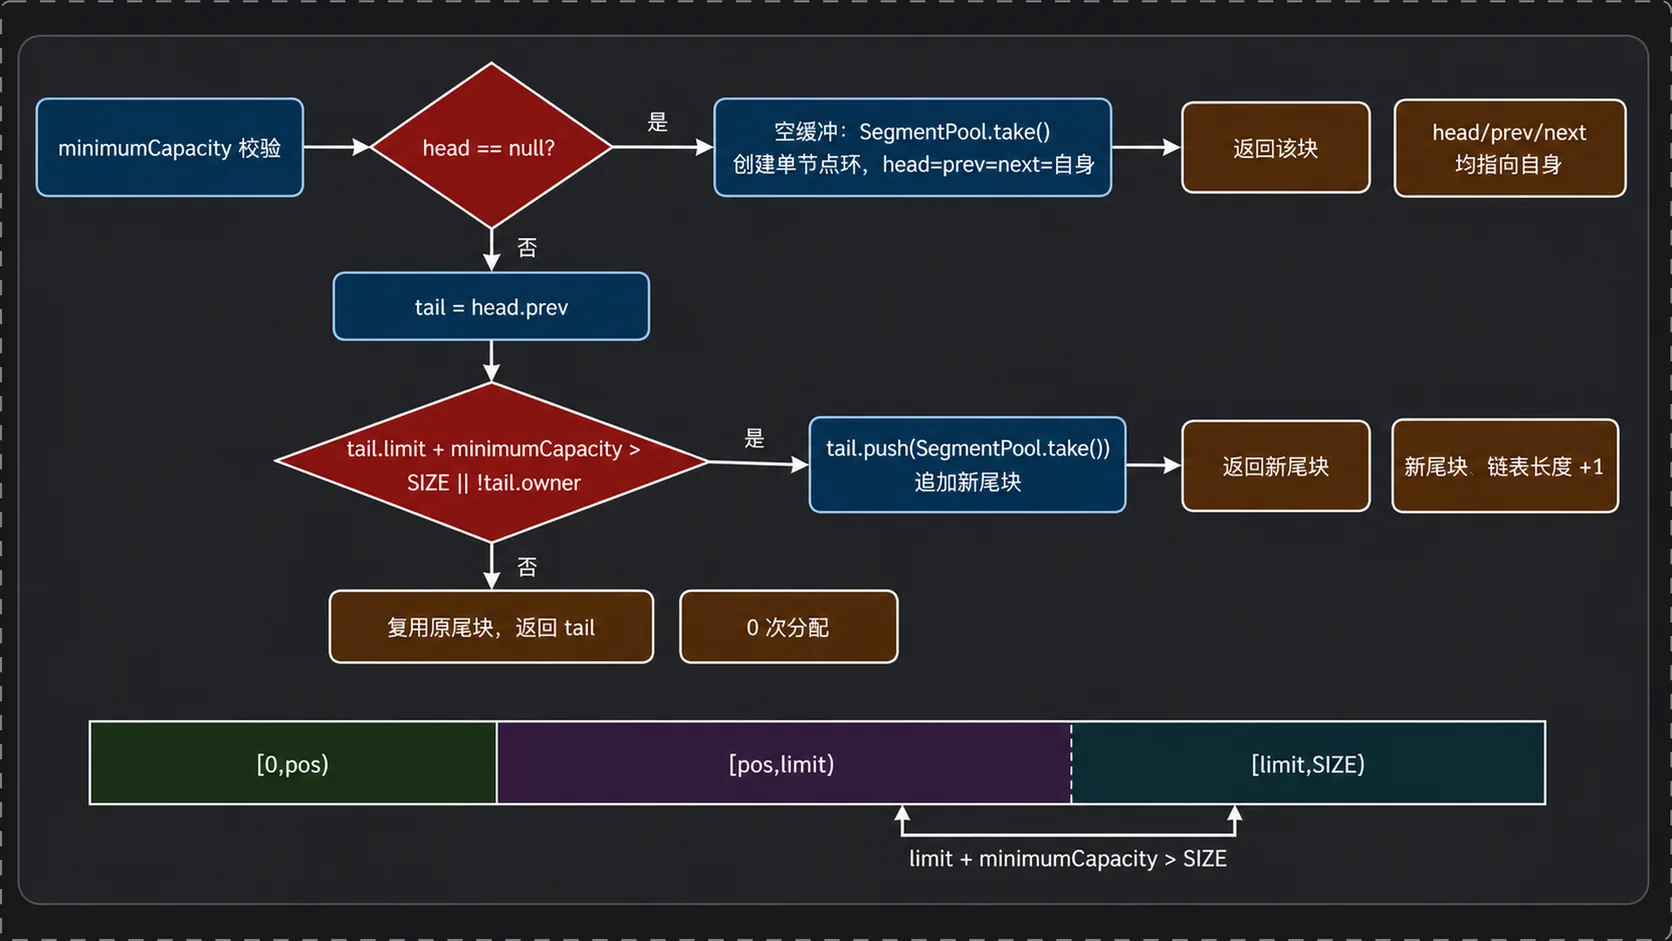
// commonMain/okio/internal/Buffer.kt:554internal inline fun Buffer.commonWritableSegment(minimumCapacity: Int): Segment { // 单次请求必须位于 [1, Segment.SIZE],且不能跨块 require(minimumCapacity >= 1 && minimumCapacity <= Segment.SIZE) { "unexpected capacity" } // 分支一:Buffer 为空 if (head == null) { // 从池中获取块;池未命中时创建新块 val result = SegmentPool.take() // Acquire a first segment. // 将新块设为链表入口 head = result // 首节点的前驱和后继均指向自身 result.prev = result result.next = result // 返回可写块 return result } // 环形链表中 head.prev 为尾块,访问复杂度为 O(1) var tail = head!!.prev // 尾块空间不足或 owner=false 时不能继续追加 if (tail!!.limit + minimumCapacity > Segment.SIZE || !tail.owner) { // 获取新块并追加到链表尾部 tail = tail.push(SegmentPool.take()) // Append a new empty segment to fill up. } // 返回满足容量要求的尾块 return tail}三条分支分别处理三种情况:空缓冲区首次分配块、尾块仍有可写空间,以及尾块空间不足时追加新块。该方法返回的是可写的 Segment,而不是实际写入的字节数。调用方从 data[limit] 开始写入,完成后再更新 limit 和 Buffer.size。这种「借出可写窗口」的设计,使上层可以将 Segment.data 及其写入范围直接交给 InputStream.read,避免额外的中转数组和数据拷贝。
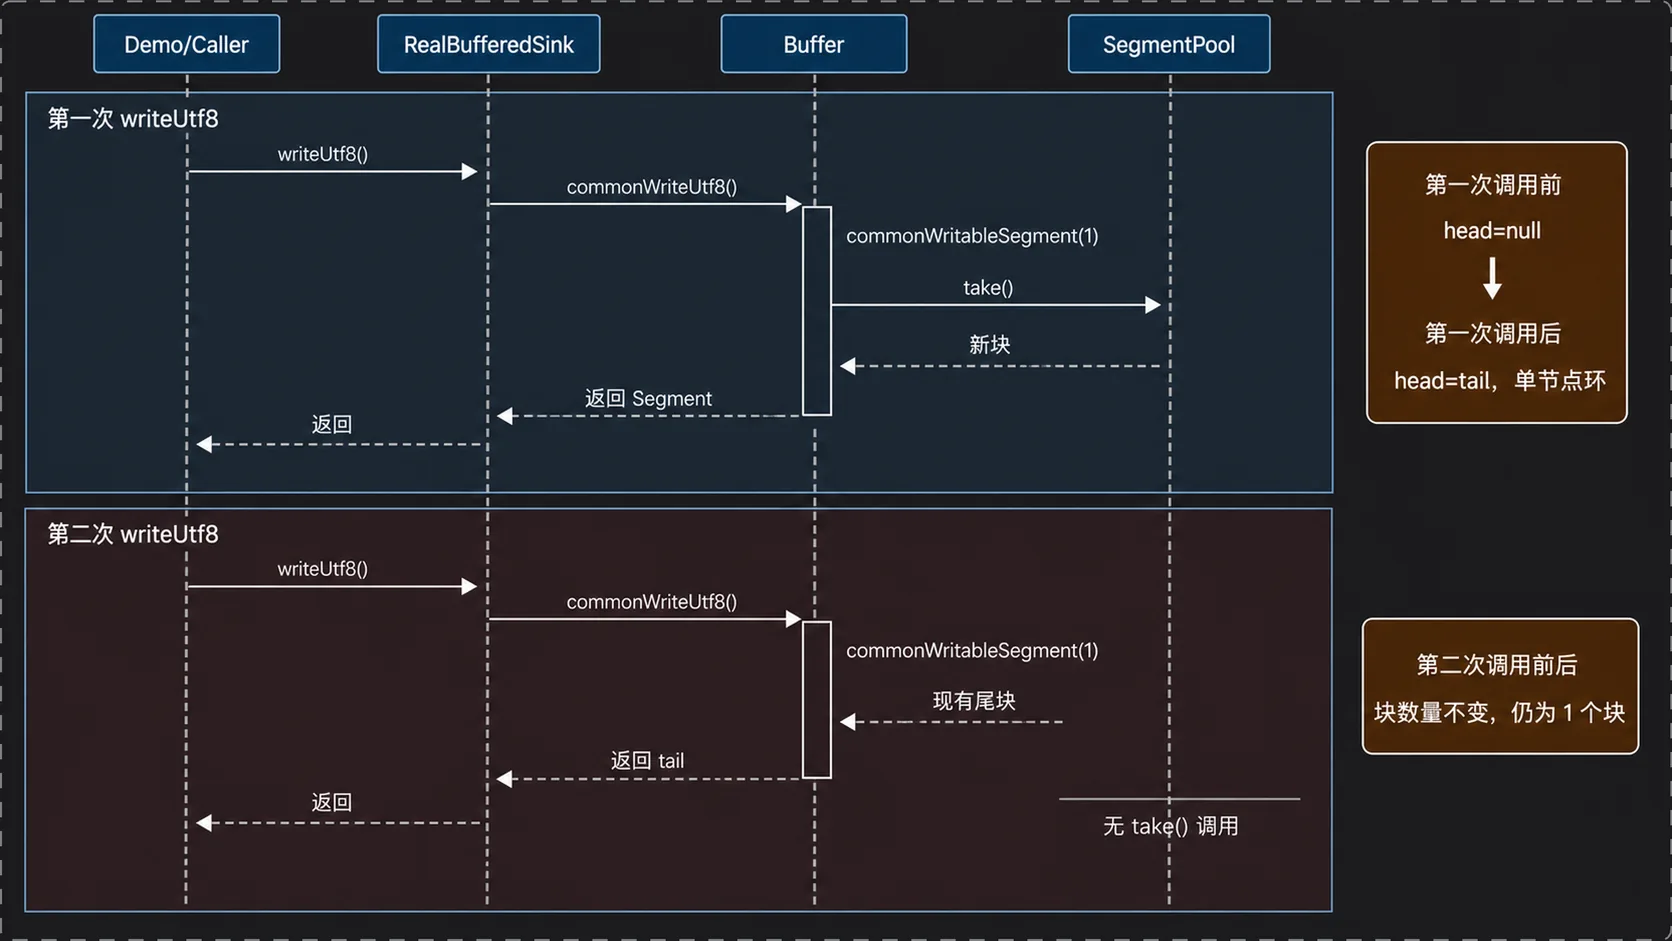
时序图:写链路里第一次 writeUtf8 触发了 commonWritableSegment:554 → SegmentPool#take:77,而第二次 writeUtf8 只有 commonWritableSegment:554,后面没有 take。这正是分支二命中:head 已存在且尾块还写得下,函数一次分配都不做。
3.2 SegmentPool 的无锁 take / recycle
Segment 是 8 KiB 的 ByteArray,如果每次 take 都 new,读一个 100 MB 的文件就要分配一万多个 8 KiB 数组,GC 和数组清零的开销都不可忽略。SegmentPool 的目标是让这些块在线程之间循环使用,同时不引入任何阻塞。
涉及的 API 与实现方法:
SegmentPool.take(): Segment:从当前线程映射到的哈希桶中获取一个块;无法命中时创建新块。SegmentPool.recycle(segment: Segment): Unit:将满足条件的空闲块放回当前线程映射到的哈希桶。
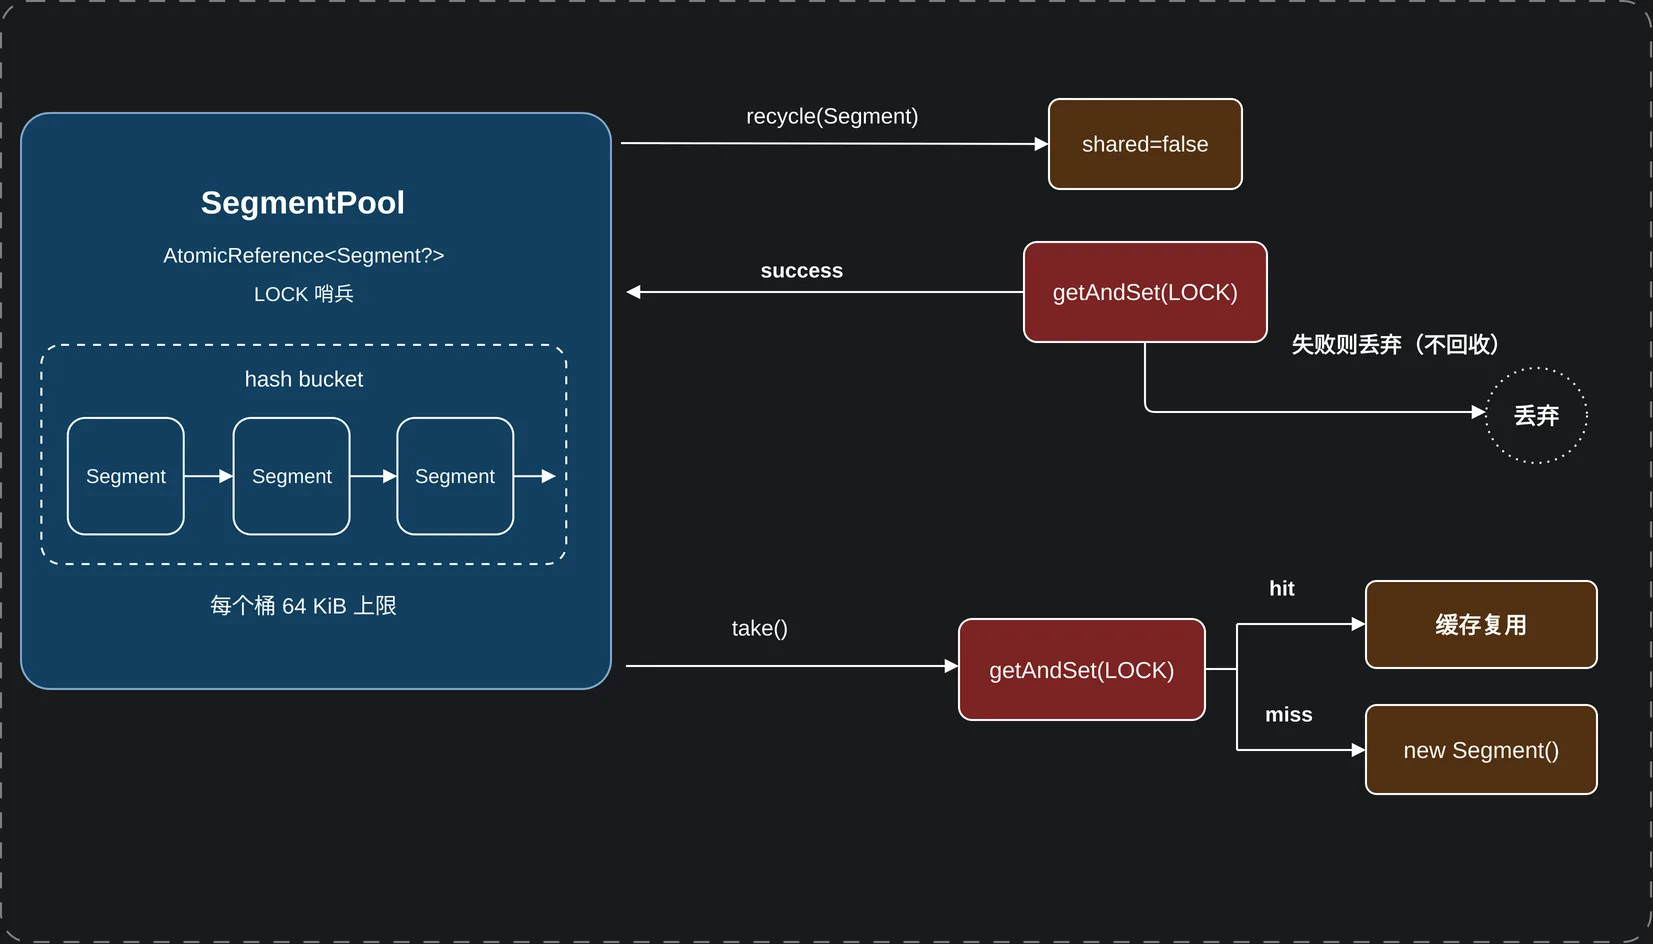
// jvmMain/okio/SegmentPool.kt:44,actual object 表示 JVM 侧的单例实现internal actual object SegmentPool { // 每个哈希桶最多缓存 64 KiB,也就是 8 个块 actual val MAX_SIZE = 64 * 1024 // 64 KiB. // 哨兵块:标记当前哈希桶正在被修改 private val LOCK = Segment(ByteArray(0), pos = 0, limit = 0, shared = false, owner = false) // 桶数量 = 不大于 (CPU 核数 * 2 - 1) 的最大 2 的幂;6 核机器得到 8 private val HASH_BUCKET_COUNT = Integer.highestOneBit(Runtime.getRuntime().availableProcessors() * 2 - 1) // 每个桶是一个 AtomicReference,指向该桶单链表的表头;null 表示空桶 private val hashBuckets: Array<AtomicReference<Segment?>> = Array(HASH_BUCKET_COUNT) { AtomicReference<Segment?>() // null value implies an empty bucket } private fun firstRef(): AtomicReference<Segment?> { // 线程 id 与桶数减一按位与,得到当前线程映射的哈希桶 val hashBucket = (Thread.currentThread().id and (HASH_BUCKET_COUNT - 1L)).toInt() return hashBuckets[hashBucket] }}按线程 id 分桶而不是用 ThreadLocal:宿主进程有多少线程是未知的,ThreadLocal 会让缓存的块随线程存活期一直不释放。分桶只是降低碰撞概率,不保证独占。
取块:
// jvmMain/okio/SegmentPool.kt:78(77 行是 @JvmStatic 注解)@JvmStaticactual fun take(): Segment { // 获取当前线程映射的哈希桶 val firstRef = firstRef() // 原子地写入 LOCK,并返回原桶头 val first = firstRef.getAndSet(LOCK) when { // 原桶头为 LOCK,表示其他线程正在修改该桶 first === LOCK -> { // 冲突时不重试,直接返回新块 return Segment() } // 原桶为空 first == null -> { // 恢复空桶状态并返回新块 firstRef.set(null) return Segment() } else -> { // 将原表头的后继写回桶,完成出栈并解除占用 firstRef.set(first.next) // 清除取出块的后继引用 first.next = null // 池内的 limit 用于容量计数,返回前恢复为 0 first.limit = 0 return first } }}getAndSet(LOCK) 一条 CAS 指令同时完成两件事:读出旧表头、把桶标记为「占用中」。冲突时的处理是这个池最反直觉的地方:不重试,直接新建:Conflicted operations are not retried, so there is no chance of blocking despite the term "lock"。
// jvmMain/okio/SegmentPool.kt:103(102 行是 @JvmStatic 注解)@JvmStaticactual fun recycle(segment: Segment) { // 前置条件:segment 已从所属链表脱离 require(segment.next == null && segment.prev == null) // 共享块仍有外部引用,不进入复用池 if (segment.shared) return // This segment cannot be recycled. val firstRef = firstRef() // 原子地占用当前哈希桶 val first = firstRef.getAndSet(LOCK) // 桶被占用时放弃回收,由 GC 处理该块 if (first === LOCK) return // A take() or recycle() is currently in progress. // 桶头的 limit 记录当前桶已缓存的总字节数 val firstLimit = first?.limit ?: 0 // 当前桶已达到 64 KiB 上限 if (firstLimit >= MAX_SIZE) { // 恢复原桶头,不回收当前块 firstRef.set(first) // Pool is full. return } // 将回收块压入桶头 segment.next = first // 重置读游标 segment.pos = 0 // limit 记录当前块及后继块的累计容量 segment.limit = firstLimit + Segment.SIZE // 写回新桶头并解除占用 firstRef.set(segment)}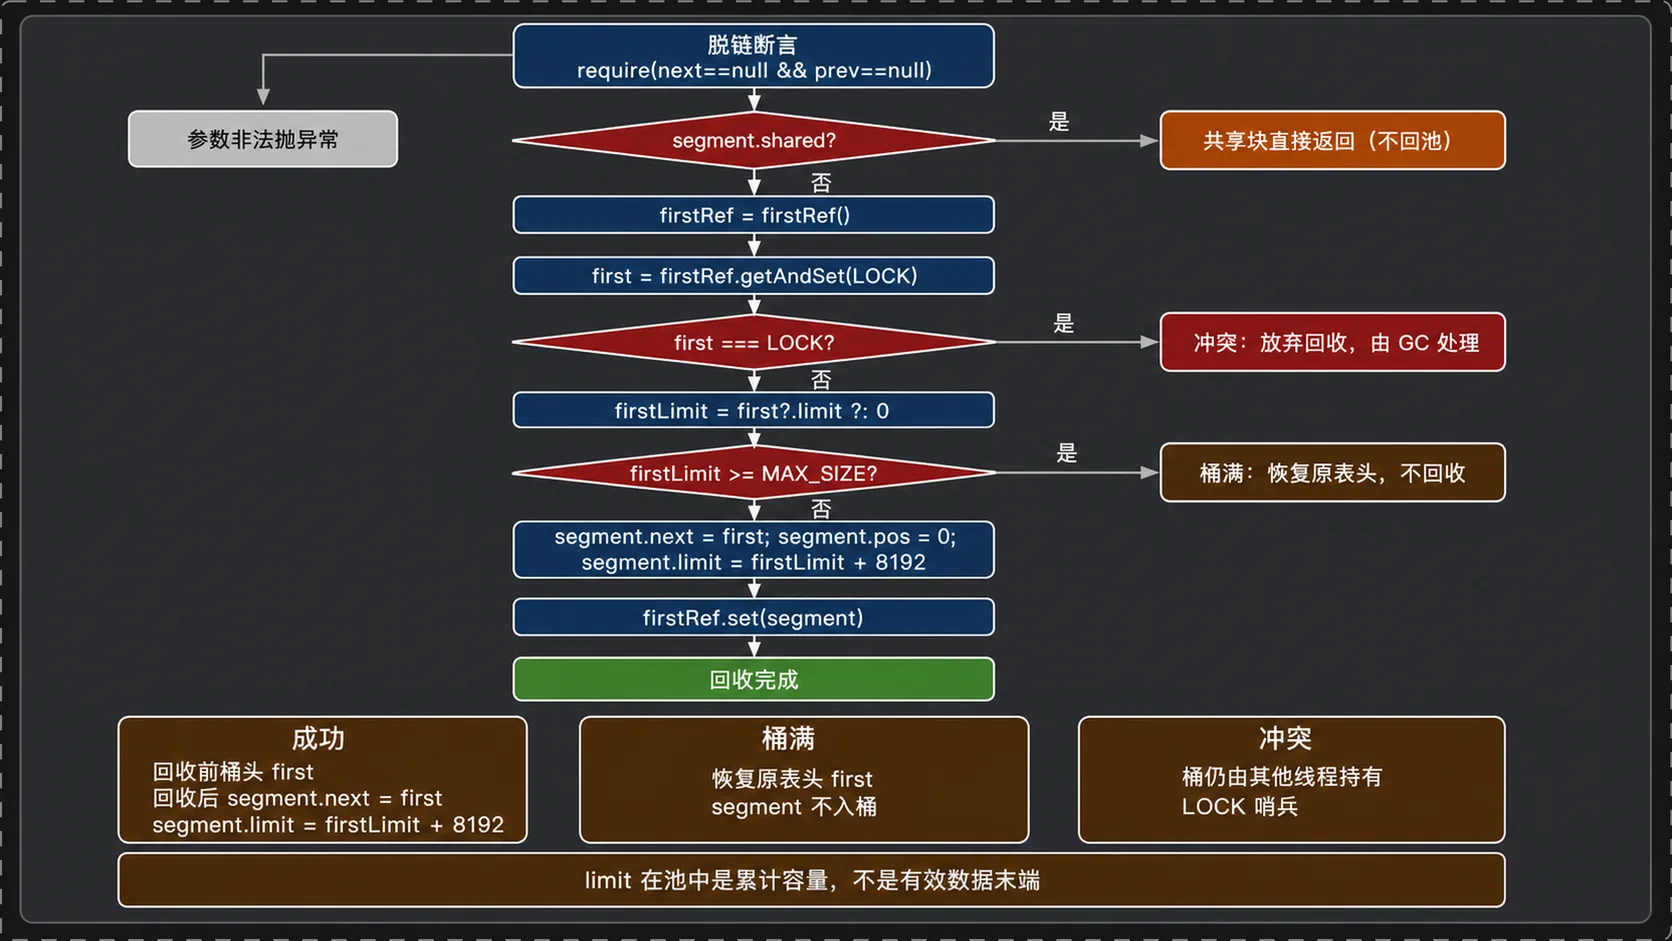
limit 在这里被复用成计数器,是一个典型的空间换指令的取舍:不需要额外的 size 字段,也不需要遍历链表就能知道桶里存了多少字节,take 时再把它清零即可。池的容量上限是 MAX_SIZE * HASH_BUCKET_COUNT,8 核机器上是 64 KiB * 8 = 512 KiB。
注意 recycle 不清零 data。块被取出时 pos = 0、limit = 0,写入方总是从 limit 开始覆盖写,读取方只读 [pos, limit),所以残留数据读不到。省掉这次 Arrays.fill 是池化收益的重要一部分。
3.3 零拷贝:Segment 引用的 push / pop 与 sharedCopy
Buffer.write(Buffer, Long) 是所有 Buffer 到 Buffer 传输的底层,writeAll、Pipe、readAll 全都流转到它。
涉及的 API 与实现方法:
Buffer.write(source: Buffer, byteCount: Long): Unit:从源Buffer向当前Buffer转移指定字节数。Segment.split(byteCount: Int): Segment:从当前块切出指定长度的前缀块。Segment.sharedCopy(): Segment:创建共享同一ByteArray的只读视图。Segment.pop(): Segment?:将当前节点从环形链表中摘除。Segment.push(segment: Segment): Segment:将节点插入当前节点之后。
// commonMain/okio/internal/Buffer.kt:1153internal inline fun Buffer.commonWrite(source: Buffer, byteCount: Long) { var byteCount = byteCount // 禁止 source 与目标 Buffer 为同一对象 require(source !== this) { "source == this" } // 校验 source 的可读范围 checkOffsetAndCount(source.size, 0, byteCount) while (byteCount > 0L) { // byteCount 小于源头块可读量时,仅处理头块前缀 if (byteCount < source.head!!.limit - source.head!!.pos) { // 获取目标 Buffer 的尾块 val tail = if (head != null) head!!.prev else null // 尾块存在、可写且容量足够时,直接复制前缀 if (tail != null && tail.owner && byteCount + tail.limit - (if (tail.shared) 0 else tail.pos) <= Segment.SIZE ) { // 将源头块前缀复制到目标尾块 source.head!!.writeTo(tail, byteCount.toInt()) // 更新源 Buffer 与目标 Buffer 的字节数 source.size -= byteCount size += byteCount return } else { // 目标尾块容量不足时,按 byteCount 切分源头块 source.head = source.head!!.split(byteCount.toInt()) } } // 以下分支移动完整的源头块 val segmentToMove = source.head // 记录待移动块的可读字节数 val movedByteCount = (segmentToMove!!.limit - segmentToMove.pos).toLong() // 从源链表移除该块 source.head = segmentToMove.pop() if (head == null) { // 目标为空时,将该块设为单节点环的 head head = segmentToMove segmentToMove.prev = segmentToMove segmentToMove.next = segmentToMove.prev } else { // 目标非空时,将该块追加到尾部 var tail = head!!.prev tail = tail!!.push(segmentToMove) // 尝试与前一块合并,减少未充分利用的块 tail.compact() } // 更新两端字节数并继续处理剩余数据 source.size -= movedByteCount size += movedByteCount byteCount -= movedByteCount }}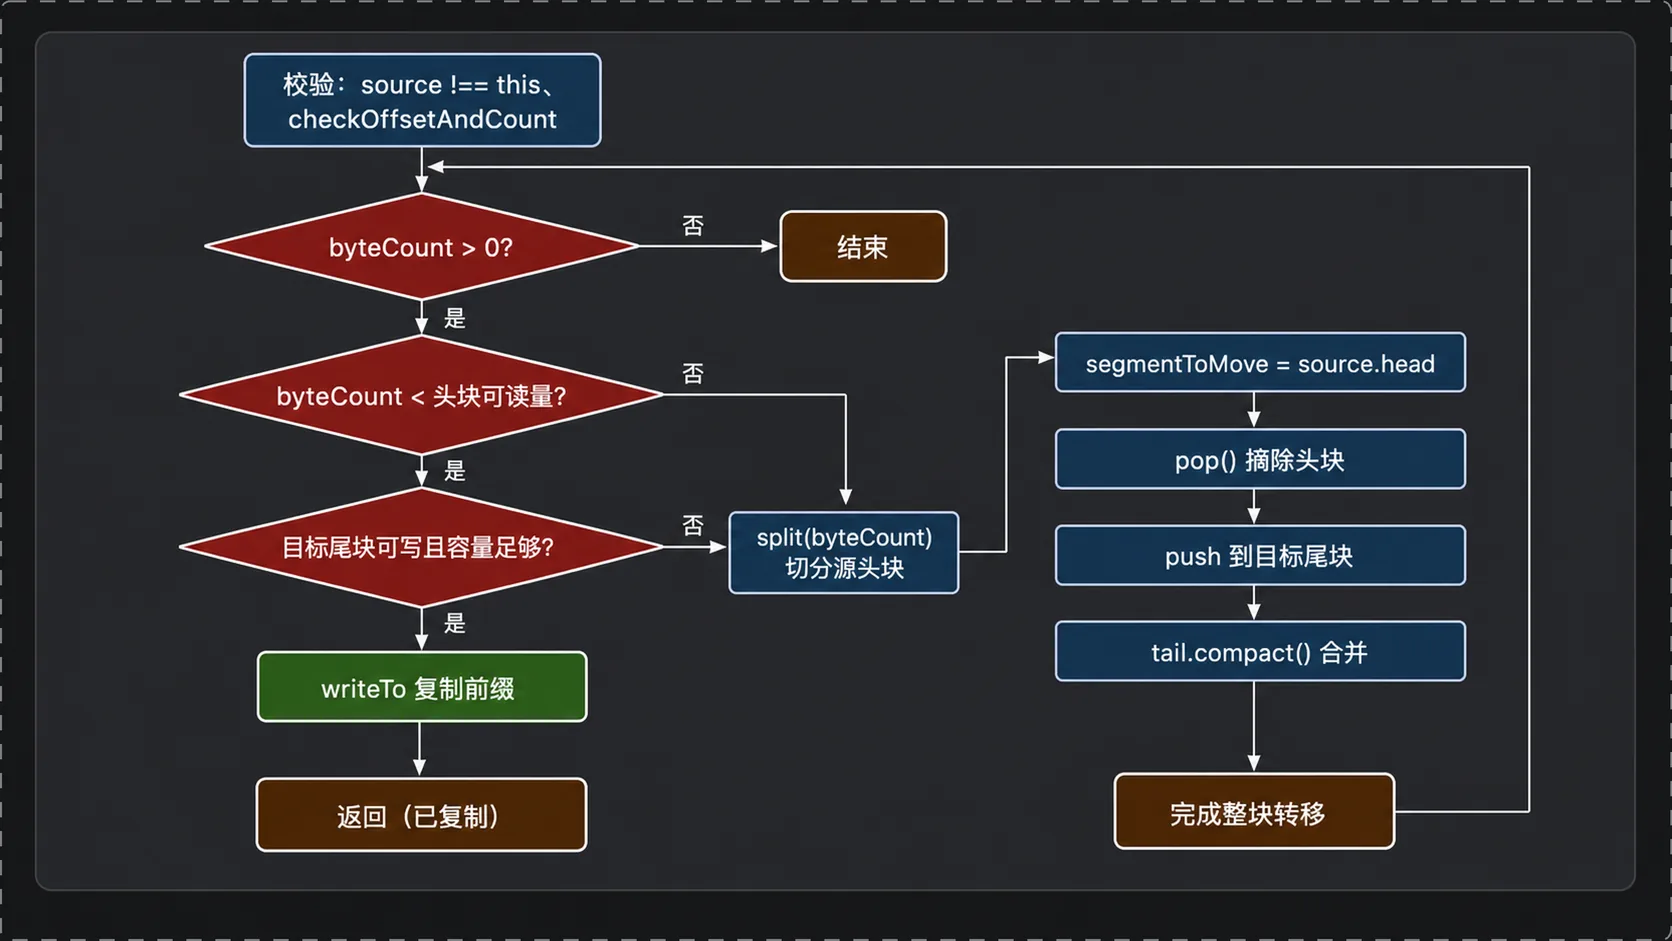
关键的两行是 source.head = segmentToMove.pop() 和 tail!!.push(segmentToMove):8 KiB segment 数据的转移:Segment 对象连同它的 data 数组引用一起从 source 的环形链表中脱链,并插入到 this 的环形链表尾部,data 数组本身没有发生任何 arraycopy。
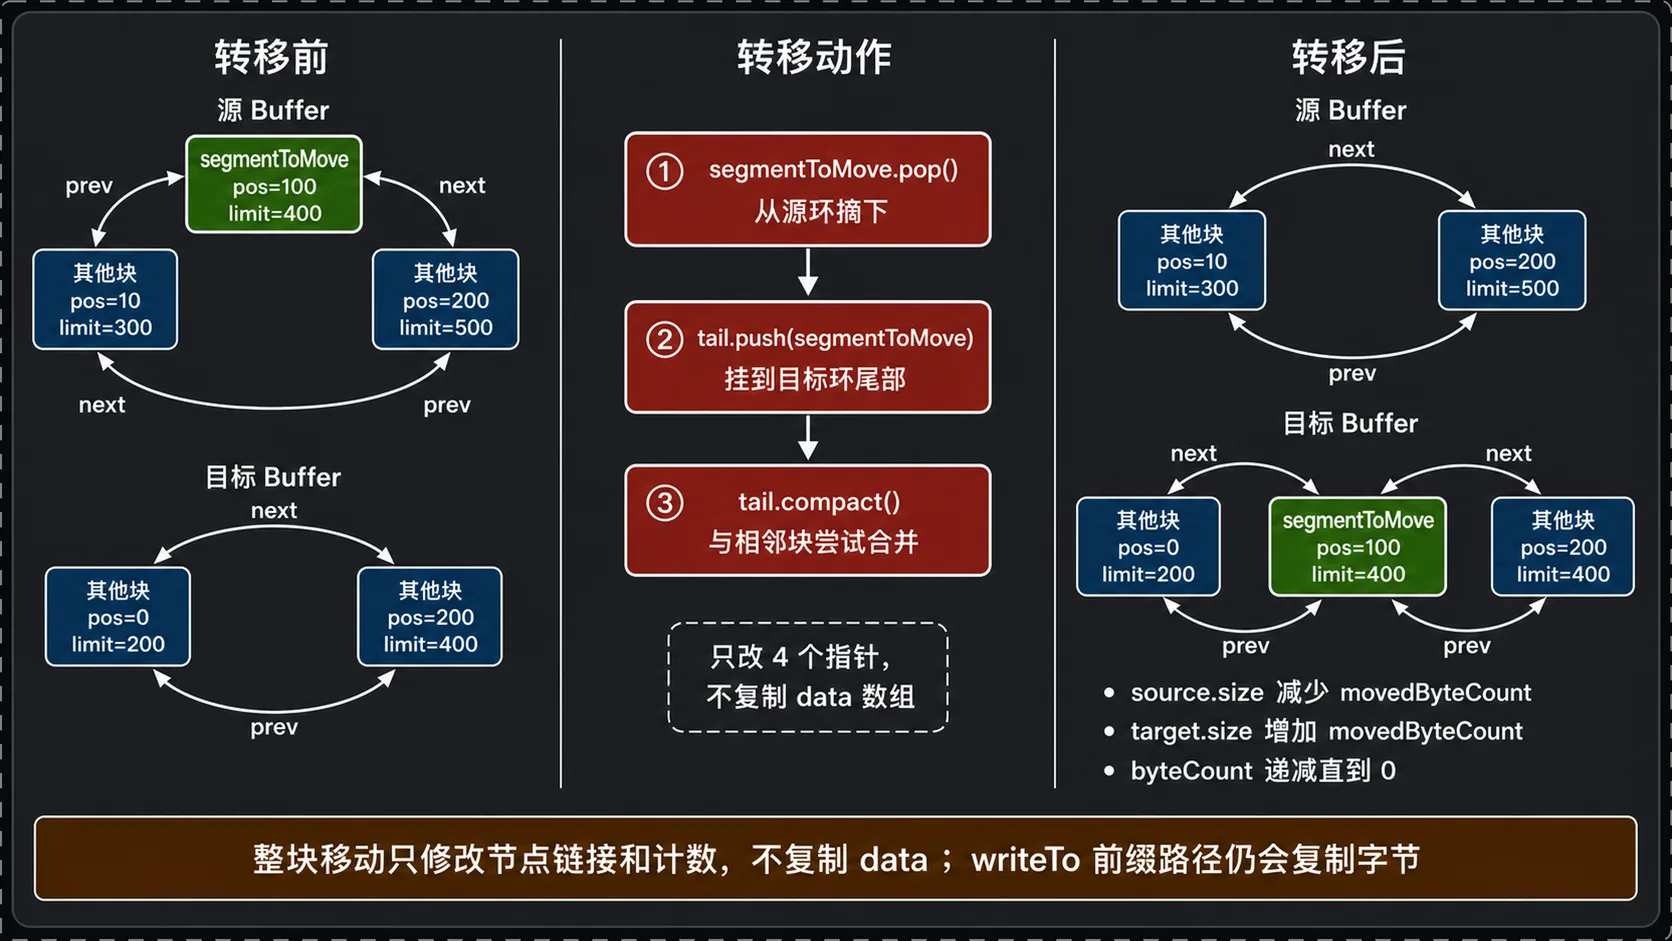
只有两种情况会真正拷贝字节:
- 一是要搬的字节数很少且尾块塞得下(
writeTo,走data.copyInto) - 二是
split出来的前缀短于SHARE_MINIMUM(1024)。
// commonMain/okio/Segment.kt:120fun split(byteCount: Int): Segment { // byteCount 必须位于当前块的有效数据范围内 require(byteCount > 0 && byteCount <= limit - pos) { "byteCount out of range" } val prefix: Segment // 前缀达到阈值时共享底层数组 if (byteCount >= SHARE_MINIMUM) { // 创建共享 data 的只读视图,并将原块标记为 shared prefix = sharedCopy() } else { // 前缀低于阈值时分配新块并复制数据 prefix = SegmentPool.take() data.copyInto(prefix.data, startIndex = pos, endIndex = pos + byteCount) } // 设置前缀块的有效区间 prefix.limit = prefix.pos + byteCount // 推进原块读游标,保留后缀数据 pos += byteCount // 将前缀块插入原块之前 prev!!.push(prefix) return prefix} // commonMain/okio/Segment.kt:80fun sharedCopy(): Segment { // 将原块标记为共享,使其不再满足回收条件 shared = true // 新块共享 data;shared=true 且 owner=false,禁止追加写入 return Segment(data, pos, limit, true, false)}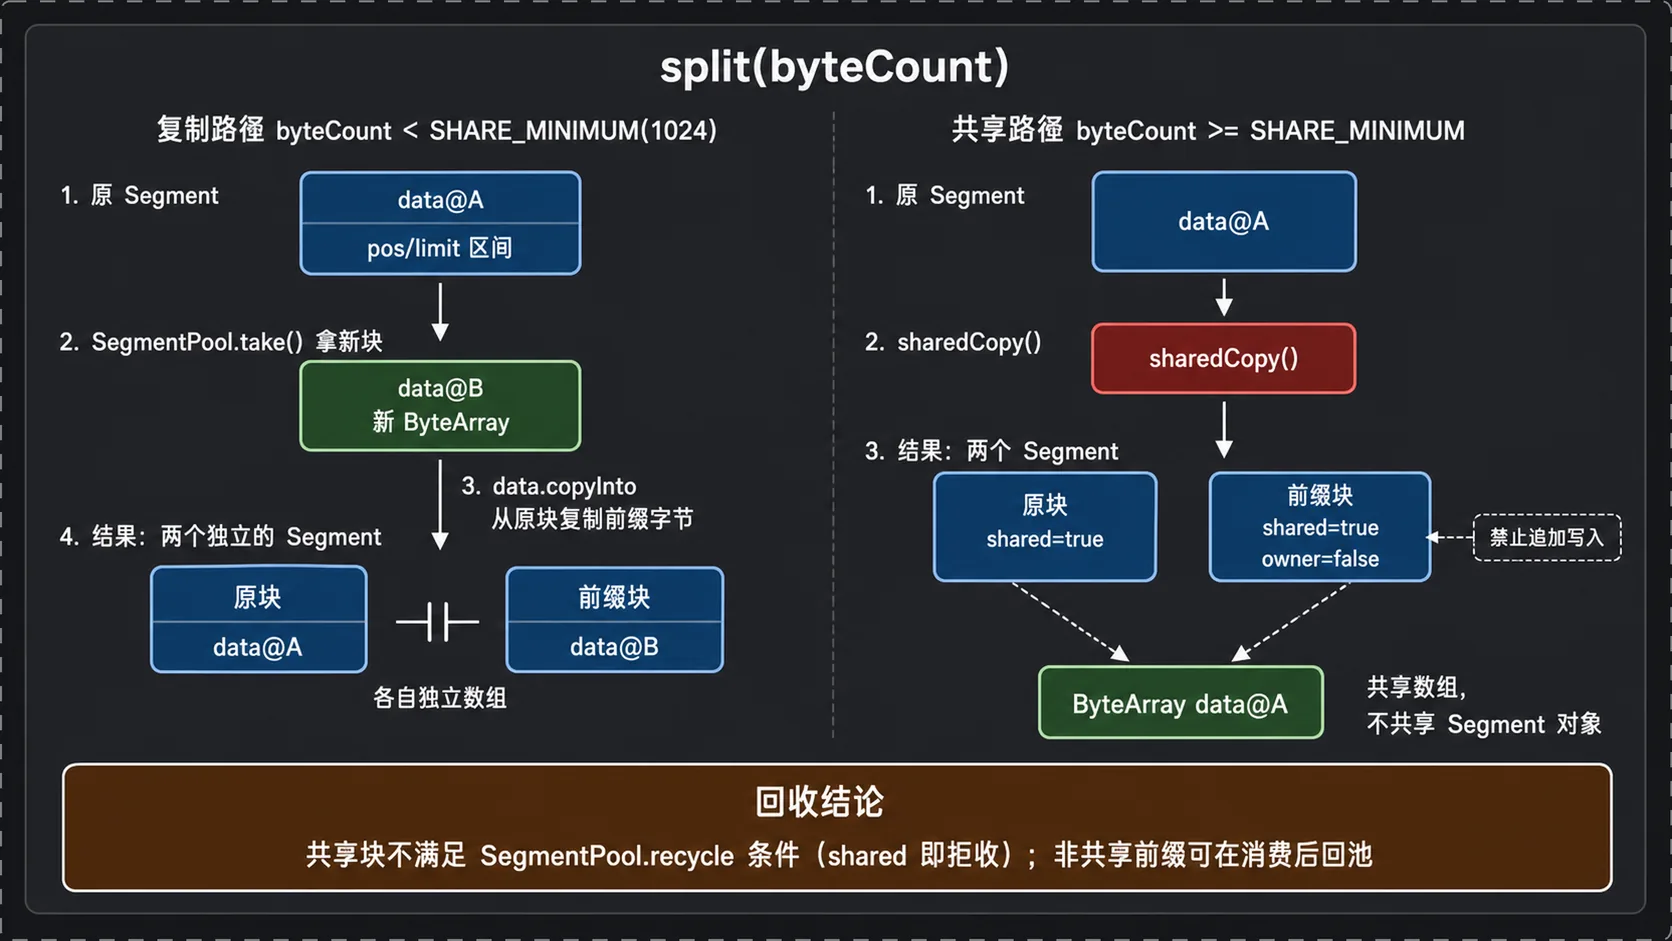
sharedCopy 的副作用是把原块也标成 shared,因此原块无法回到回收池。
3.4 emitCompleteSegments:什么时候真正写到底层?
涉及的 API:
BufferedSink.emitCompleteSegments(): BufferedSink:仅将完整的Segment写入下游,并保留未写满的尾块。BufferedSink.emit(): BufferedSink:将当前缓冲区中的全部字节写入下游。BufferedSink.flush(): Unit:先写出全部缓冲数据,再调用下游的flush()。
对应的内部实现:
RealBufferedSink.commonEmitCompleteSegments(): BufferedSink:执行完整块下推。Buffer.commonCompleteSegmentByteCount(): Long:计算可下推的完整块字节数。
// commonMain/okio/internal/RealBufferedSink.kt:169internal inline fun RealBufferedSink.commonEmitCompleteSegments(): BufferedSink { // 已关闭时拒绝写入 check(!closed) { "closed" } // 计算完整块包含的字节数 val byteCount = buffer.completeSegmentByteCount() // 仅在存在完整块时写入下游 if (byteCount > 0L) sink.write(buffer, byteCount) return this} // commonMain/okio/internal/Buffer.kt:275internal inline fun Buffer.commonCompleteSegmentByteCount(): Long { // 初始值包含缓冲区全部字节 var result = size // 空缓冲直接返回 0 if (result == 0L) return 0L // 取尾块 val tail = head!!.prev!! // 可继续写入的未满尾块不计入本次下推 if (tail.limit < Segment.SIZE && tail.owner) { // 从结果中扣除尾块的可读字节数 result -= (tail.limit - tail.pos).toLong() } return result}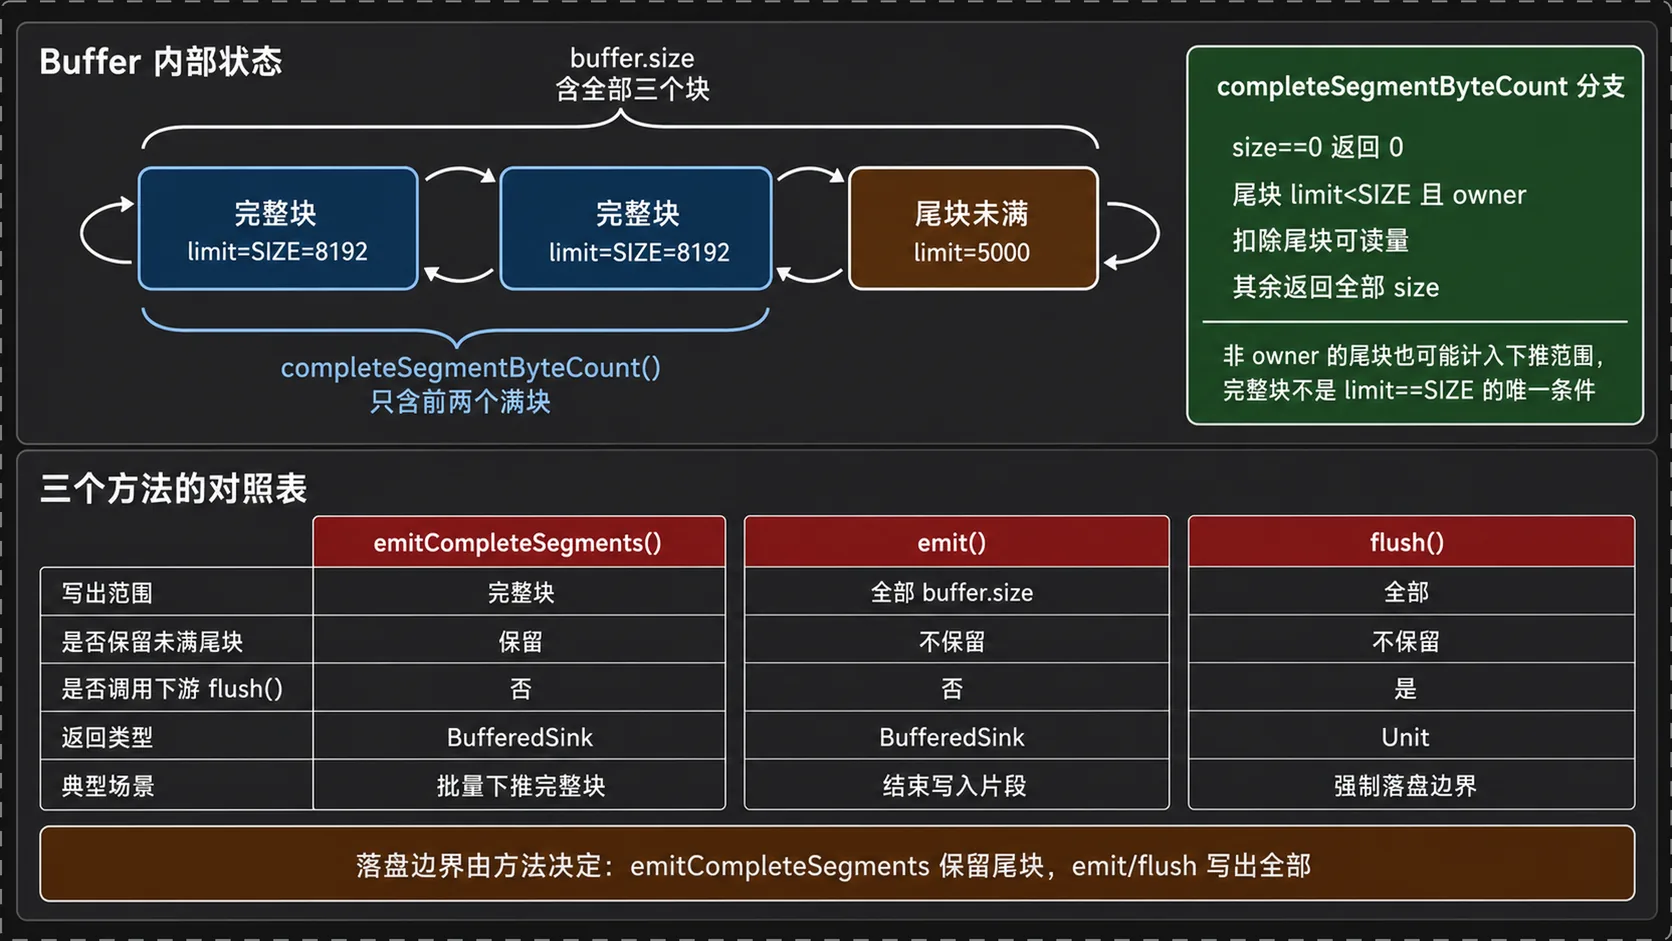
这两个函数合起来定义了 Okio 的落盘粒度:只把完整的 8 KiB 块推给下游,尾巴上那个没写满的块留在缓冲里继续攒。这个策略同时满足了三个目标:下游拿到的 byteCount 一定是块边界的整数倍,于是 OutputStreamSink.write 里的 head.pop() 一定会命中;每次系统调用都是满 8 KiB,写入效率最高;尾块不被下推,也就不会被 recycle,下次 writableSegment 直接复用它,不需要再 take。
// commonMain/okio/internal/RealBufferedSink.kt:55internal inline fun RealBufferedSink.commonWriteUtf8(string: String): BufferedSink { check(!closed) { "closed" } // 将字符串编码到内部 Buffer buffer.writeUtf8(string) // 将完整块写入下游 return emitCompleteSegments()}每次 writeUtf8 都会问一次「攒够整块了吗」,攒够就推,没攒够就返回。emit() 是更激进的版本(sink.write(buffer, buffer.size),连尾块也推),flush() 在 emit 之后还会调用下游的 flush()。三个方法的开销递增,语义递强。
四、写链路追踪:从 WriteJavaIoFile.writeEnv 入口
4.1 写链路总时序图
下图对应 demo-write.puml(233 行调用记录)。重复的 writeUtf8 循环折叠为 loop,SegmentPool.take 的条件分支折叠为 opt:
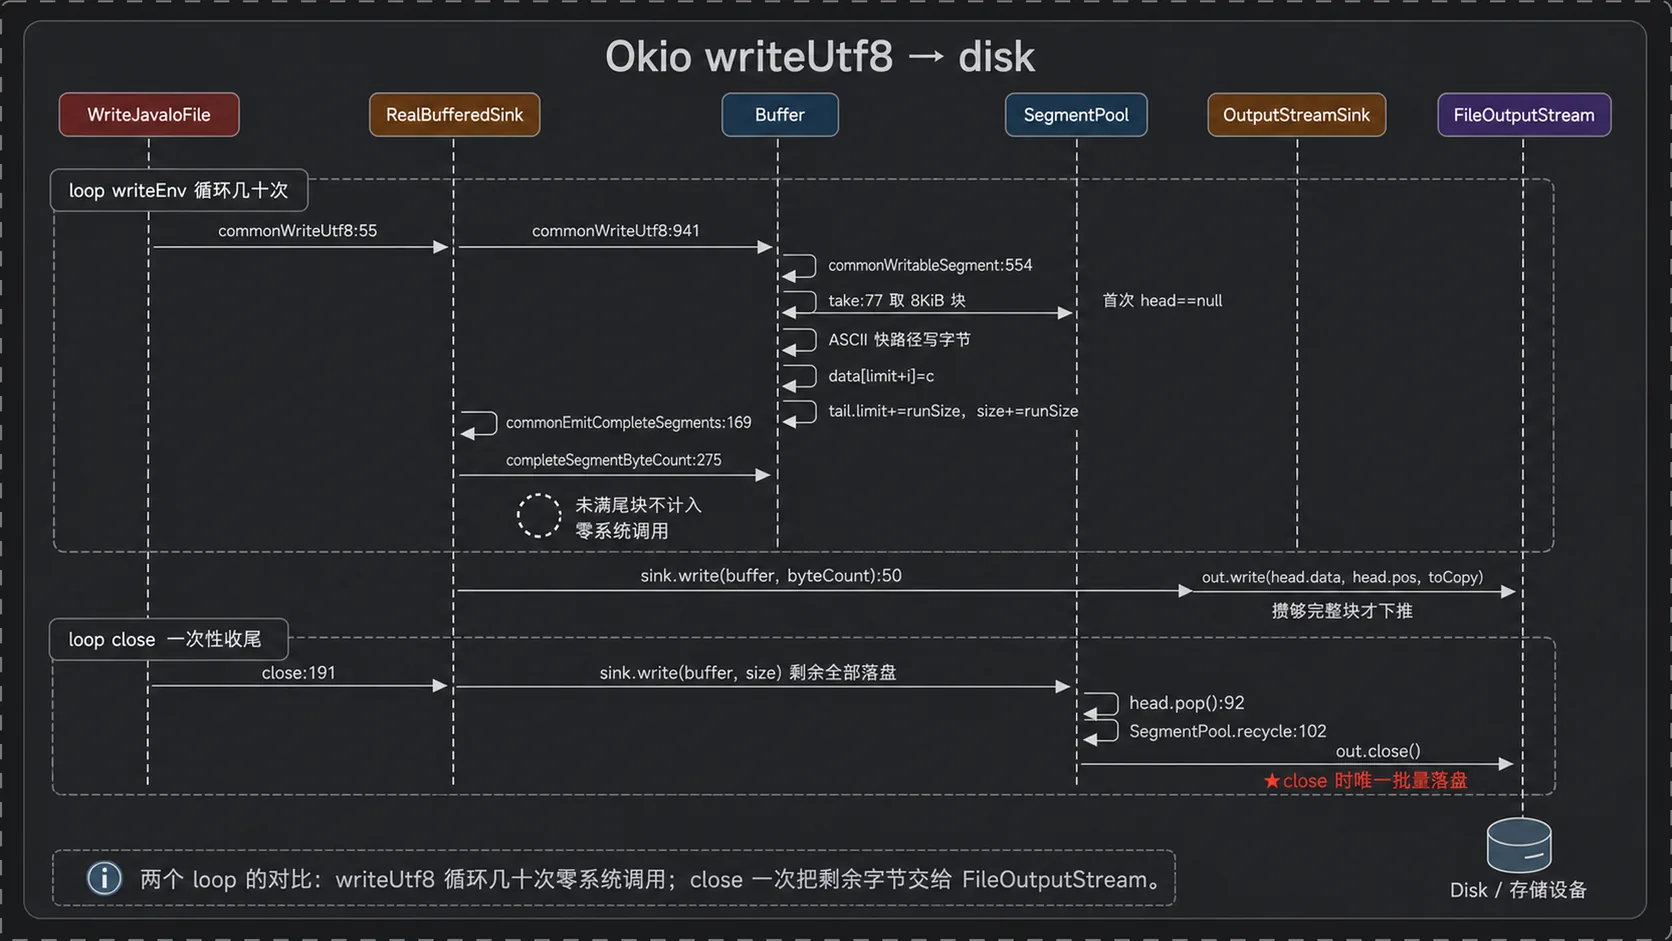
图里两个 loop 的落差是:上面那个循环执行了几十次,一次系统调用都没有;下面那个循环执行了一次,把所有字节一次性交给 FileOutputStream。
4.2 Okio.sink(file) 与 Okio.buffer(fileSink)
为什么看它:writeEnv 的第一行就是这两个工厂调用,它们决定了后面整条链路上有哪些对象。
涉及的 API:
File.sink(append: Boolean = false): Sink:创建写入文件的裸Sink。Sink.buffer(): BufferedSink:用RealBufferedSink为下游Sink增加缓冲。
// samples/src/jvmMain/java/okio/samples/WriteJavaIoFile.java:30public void writeEnv(File file) throws IOException { // try-with-resources 按声明的逆序关闭资源 try (Sink fileSink = Okio.sink(file); // 为裸 Sink 增加缓冲层 BufferedSink bufferedSink = Okio.buffer(fileSink)) { // 遍历当前进程的环境变量 for (Map.Entry<String, String> entry : System.getenv().entrySet()) { // 写入变量名 bufferedSink.writeUtf8(entry.getKey()); // 写入分隔符 bufferedSink.writeUtf8("="); // 写入变量值 bufferedSink.writeUtf8(entry.getValue()); // 写入换行符 bufferedSink.writeUtf8("\n"); } }}Okio.sink(file) 走的是 2.4 里那条 File.sink(append = false) → FileOutputStream(this, false).sink() → OutputStreamSink(out, Timeout()) 的路径,得到一个不带任何缓冲的 Sink:它的 write 每次调用都会直接命中 FileOutputStream.write。
Okio.buffer(fileSink) 对应 commonMain/okio/Okio.kt 里的扩展函数:
// commonMain/okio/Okio.kt,Java 侧暴露为 Okio.buffer(Sink)fun Sink.buffer(): BufferedSink = RealBufferedSink(this)构造 RealBufferedSink 时只会保存下游 sink,并创建一个空的 Buffer。此时 head == null,尚未分配任何 Segment;磁盘访问和块分配都会推迟到第一次写入。
try-with-resources 会按声明的逆序关闭资源,因此先关闭 bufferedSink,再关闭 fileSink。RealBufferedSink.close() 已经会关闭下游 Sink,随后再次关闭 fileSink;由于 FileOutputStream.close() 支持重复调用。
缓冲层是可组合的装饰器,Okio.sink 与 Okio.buffer 之间没有继承关系,只有持有关系。想换一个下游(socket、cipher、gzip),只要它实现 Sink,RealBufferedSink 的代码一行都不用改。
4.3 writeUtf8
writeUtf8 展示了 writableSegment 借出的写窗口怎么被使用。
涉及的 API 与实现方法:
BufferedSink.writeUtf8(string: String): BufferedSink:将字符串编码为 UTF-8 并写入缓冲区。Buffer.writeUtf8(string: String): Buffer:直接将 UTF-8 字节写入Buffer。Buffer.writableSegment(minimumCapacity: Int): Segment:为编码过程提供连续可写空间。
Buffer.writeUtf8(string) 转发到 writeUtf8(string, 0, string.length),再转发到 commonWriteUtf8。
ASCII 字符写入:
// commonMain/okio/internal/Buffer.kt:941 中 c < 0x80 的分支c < 0x80 -> { // ASCII 字符需要 1 字节写入空间 val tail = writableSegment(1) // 缓存字节数组引用,减少循环中的字段访问 val data = tail.data // segmentOffset 将字符串下标映射到块内写入位置 val segmentOffset = tail.limit - i // 连续写入上限由字符串结尾和块剩余空间共同决定 val runLimit = minOf(endIndex, Segment.SIZE - segmentOffset) // 写入当前字符并推进字符串下标 data[segmentOffset + i++] = c.toByte() // 0xxxxxxx // 连续处理后续 ASCII 字符 while (i < runLimit) { c = string[i].code // 遇到非 ASCII 字符时返回外层分支处理 if (c >= 0x80) break data[segmentOffset + i++] = c.toByte() // 0xxxxxxx } // 计算本轮写入字节数 val runSize = i + segmentOffset - tail.limit // Equivalent to i - (previous i). // 推进块写游标 tail.limit += runSize // 更新 Buffer 总字节数 size += runSize.toLong()}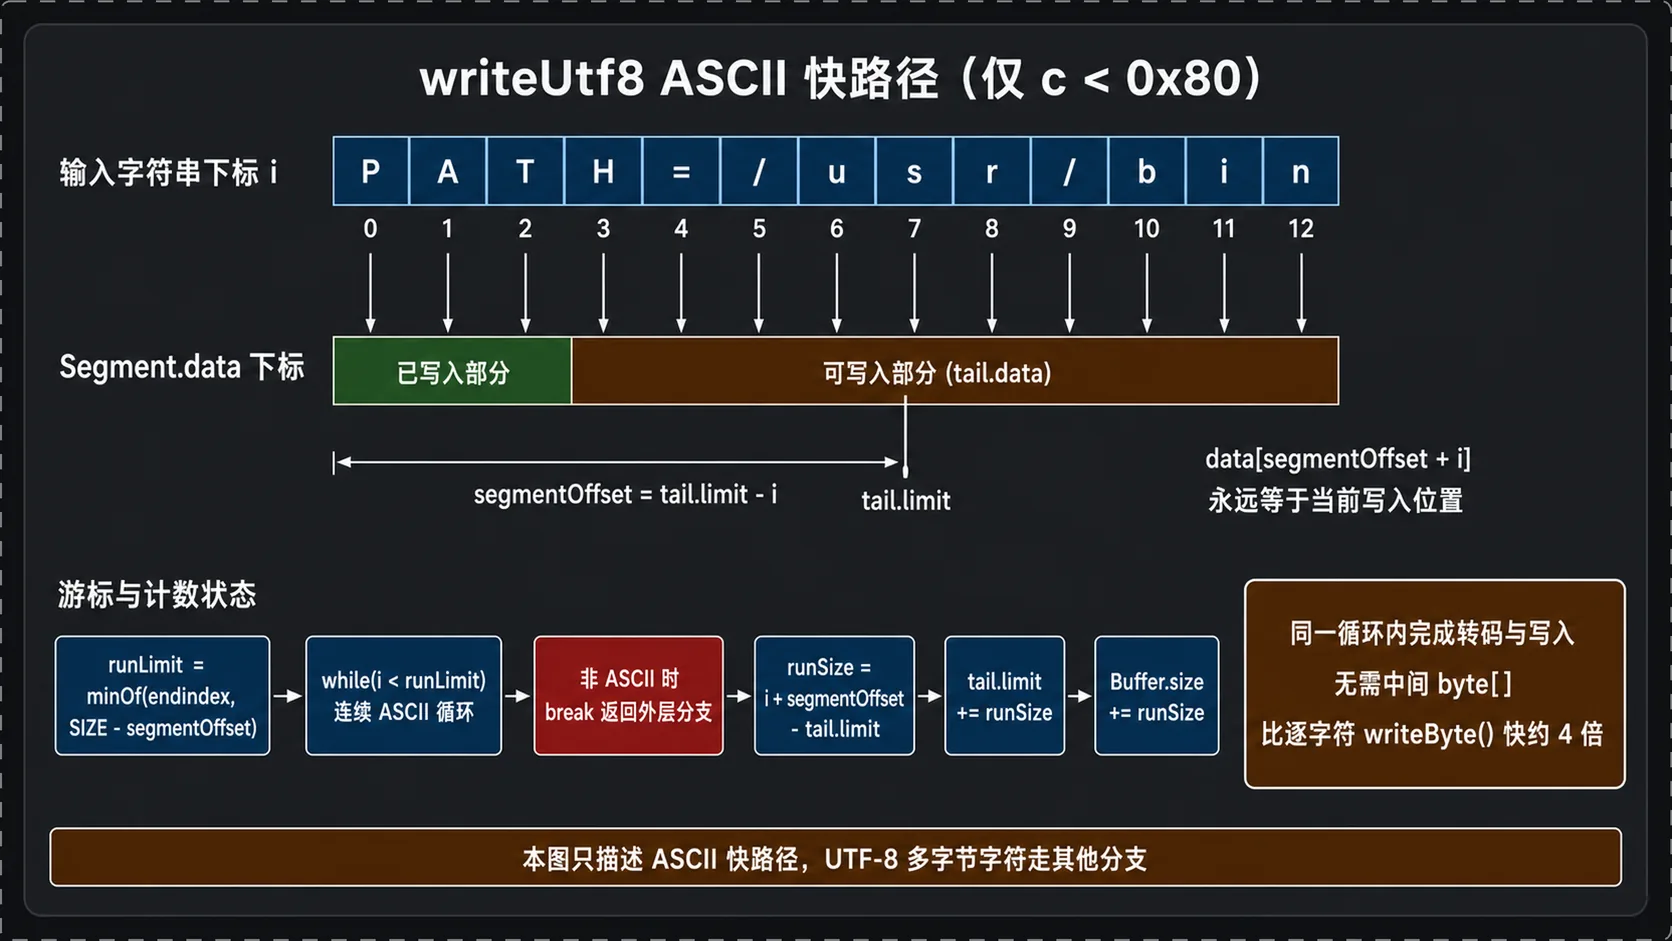
segmentOffset 把「字符串下标 i」和「块内写位置」绑成一个固定差值,于是内层循环里只需要维护 i 一个变量,data[segmentOffset + i] 就是写入位置。源码注释直言这段写法难看,但相比逐字符调用 writeByte() 有约 4 倍的性能提升,原因是 writeByte 每次都要重新调 writableSegment、重新读写 limit 和 size 字段。
输入输出与状态变化:输入是一个 Java String(UTF-16),输出是写进 tail.data 的 UTF-8 字节;tail.limit 增加 runSize,Buffer.size 增加 runSize,tail.pos 不变。String 对象本身没有被复制成中间 byte[],转码和写入是同一次遍历完成的。这与 String.getBytes(UTF_8) 再 write(byte[]) 的两段式写法相比,少一次数组分配和一次数组拷贝。
回到 writeEnv 的四连调用。以 PATH=/usr/bin\n 为例,四次 writeUtf8 依次进入同一个 Buffer,第一次触发 head == null 分支从池里取块,后三次 writableSegment(1) 都命中「尾块还写得下」,直接返回同一个块。四次调用之后每次都跟一次 emitCompleteSegments,completeSegmentByteCount() 因为尾块未满返回 0,sink.write 不被调用。
trace 证据:demo-write.puml 中与 RealBufferedSink 相关的调用行一共只有 10 条,结构是 commonWriteUtf8:55 → commonWriteUtf8:941 → commonEmitCompleteSegments:169 → commonCompleteSegmentByteCount:275,重复两轮之后直接进入 commonClose:191。SegmentPool#take:77 只在第一轮出现。
4.4 close 到整段落盘与 Segment 回收
涉及的 API 与实现方法:
RealBufferedSink.close(): Unit:写出缓冲区剩余数据并关闭下游。Sink.write(source: Buffer, byteCount: Long): Unit:从源Buffer消费字节并写入下游。SegmentPool.recycle(segment: Segment): Unit:回收已经消费完且满足回收条件的块。
RealBufferedSink.close() 并不是「先 flush 再 close」,它直接调用下游的 write:
// commonMain/okio/internal/RealBufferedSink.kt:191internal inline fun RealBufferedSink.commonClose() { // 已关闭时直接返回 if (closed) return // 写出剩余缓冲数据;写入失败后仍继续关闭下游 var thrown: Throwable? = null try { // 使用 buffer.size,确保未满尾块也被写出 if (buffer.size > 0) { sink.write(buffer, buffer.size) } } catch (e: Throwable) { // 暂存写入异常 thrown = e } try { // 关闭下游;OutputStreamSink.close() 调用 out.close() sink.close() } catch (e: Throwable) { // 优先保留首次异常 if (thrown == null) thrown = e } // 更新关闭状态 closed = true // 资源关闭后重新抛出异常 if (thrown != null) throw thrown}sink.write(buffer, buffer.size) 与 emitCompleteSegments 的差别就在参数:前者是 buffer.size(全部字节,含未满的尾块),后者是 completeSegmentByteCount()(只含完整块)。这是「关闭时必须把所有东西写出去」与「运行时只推整块」两种语义的分工。
下游收到之后:
// jvmMain/okio/JvmOkio.kt:50override fun write(source: Buffer, byteCount: Long) { // 校验 source 的可读范围 checkOffsetAndCount(source.size, 0, byteCount) // 记录剩余待写字节数 var remaining = byteCount while (remaining > 0) { // 每轮写入前检查超时状态 timeout.throwIfReached() // 从源 Buffer 的头块开始消费 val head = source.head!! // 本轮写入量取剩余量与头块可读量的较小值 val toCopy = minOf(remaining, head.limit - head.pos).toInt() // 将头块的有效区间直接交给 OutputStream out.write(head.data, head.pos, toCopy) // 推进头块读游标 head.pos += toCopy // 更新剩余待写字节数 remaining -= toCopy // 更新源 Buffer 总字节数 source.size -= toCopy // 头块已全部消费 if (head.pos == head.limit) { // 移除头块并更新 head source.head = head.pop() // 回收空块 SegmentPool.recycle(head) } }}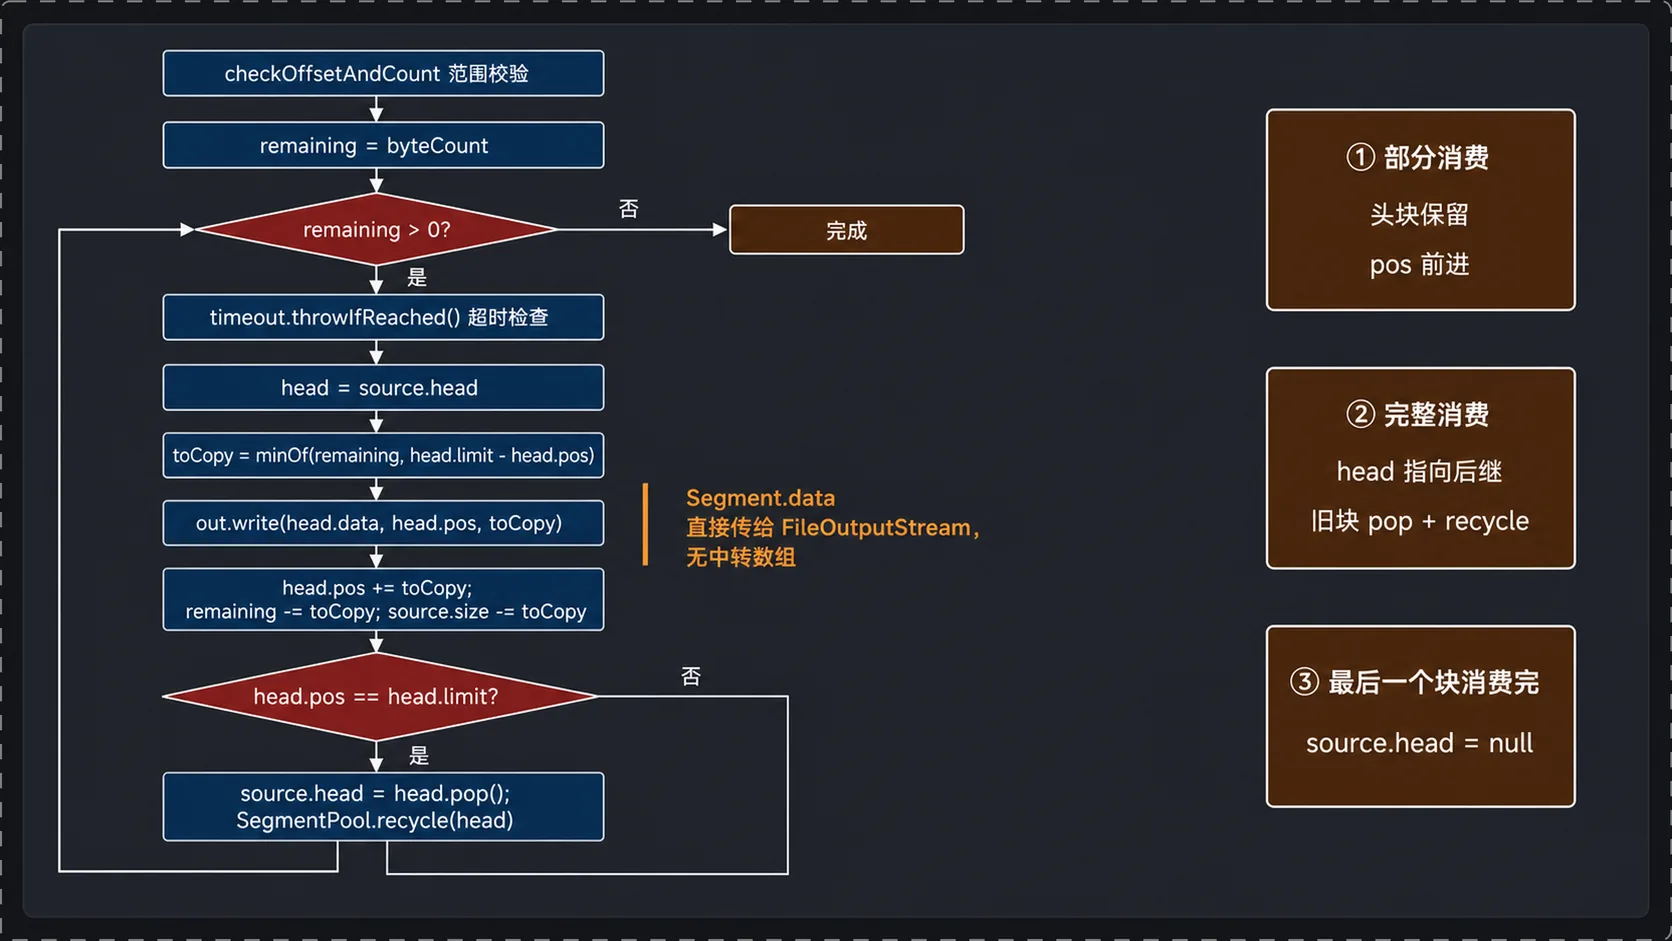
out.write(head.data, head.pos, toCopy) 是写链路进入 JVM IO 的位置。FileOutputStream 直接读取 Segment.data 中 [head.pos, head.pos + toCopy) 这段数据,不需要额外的中转数组。
相比之下,BufferedOutputStream.flushBuffer() 写出的是其私有缓冲区 buf,应用数据此前已经通过 System.arraycopy 复制到该缓冲区。Okio 在字符串编码阶段就把字节写入 Segment.data,之后一直复用这段存储,直到调用 FileOutputStream.write。
状态变化:head.pos 推进到 limit,source.size 归零,source.head 变成 null,被消费完的块经 pop() 脱链后进入 SegmentPool。下一次任何线程(更准确地说,是哈希到同一个桶的线程)调用 take(),很可能拿到的就是这一块。
五、读链路追踪:从 readLines 入口
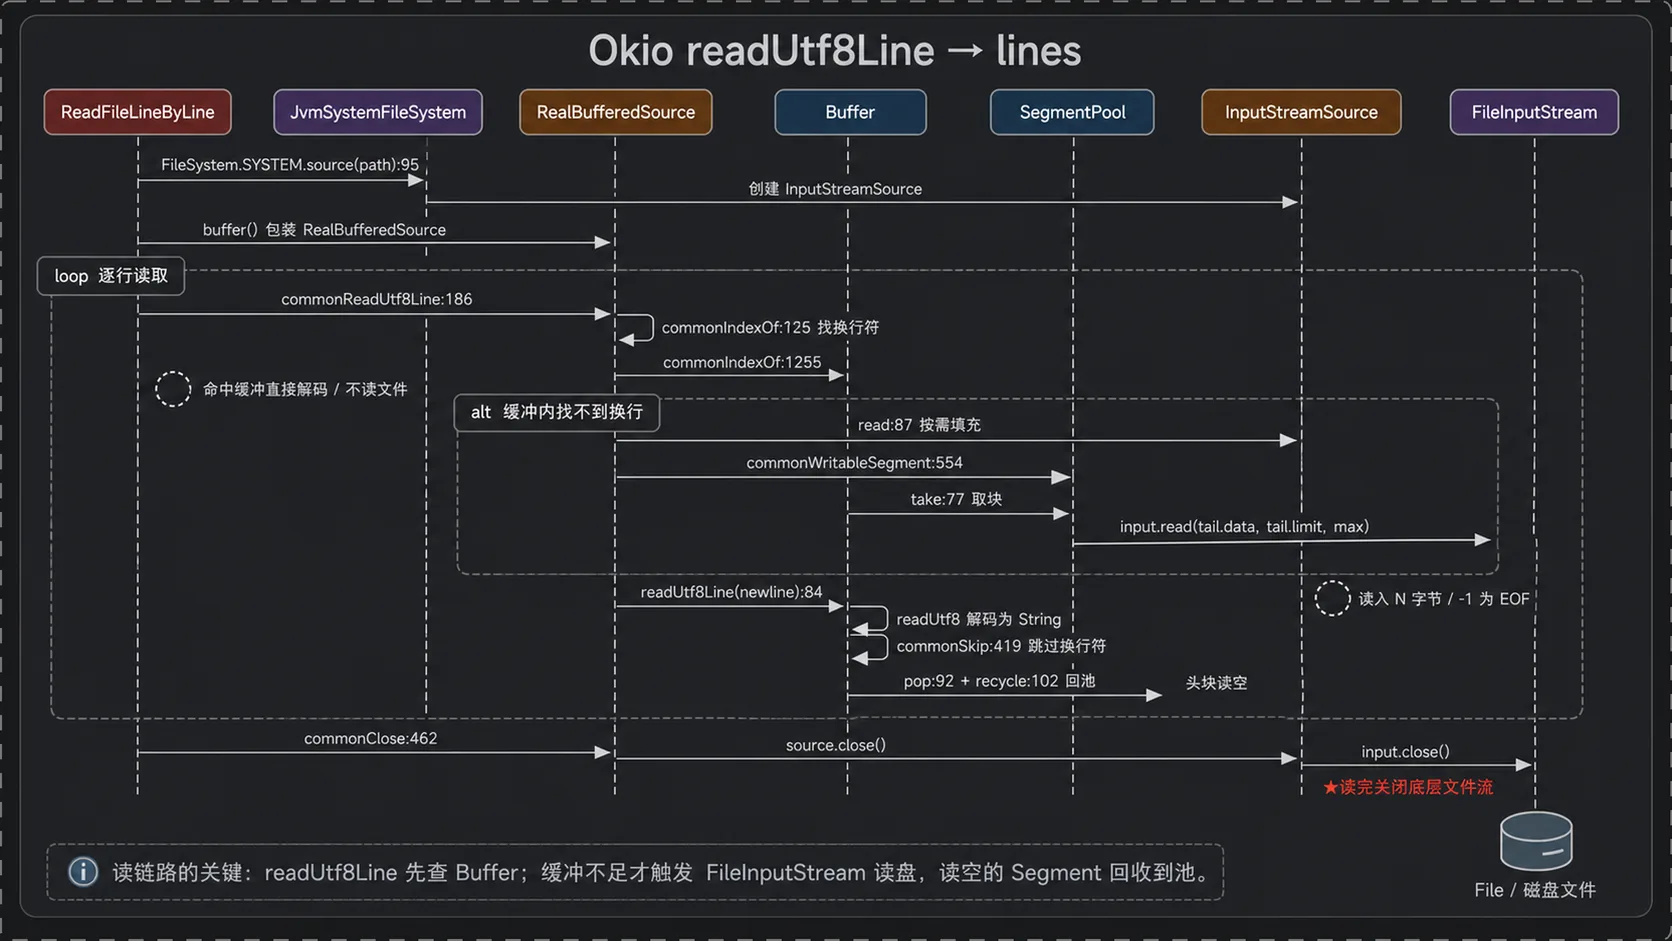
5.1 读链路总时序图
下图对应 demo-read.puml(329 行调用记录)。逐行读的循环折叠为 loop,缓冲不足时的补数据折叠为 alt:
5.2 FileSystem.SYSTEM.source(path)
涉及的 API:
FileSystem.source(file: Path): Source:为指定路径创建读取端点。Source.buffer(): BufferedSource:用RealBufferedSource为下游Source增加缓冲。BufferedSource.readUtf8Line(): String?:从缓冲读取一行文本。
// samples/src/jvmMain/java/okio/samples/ReadFileLineByLine.kt:25@Throws(IOException::class)fun readLines(path: Path) { // 创建裸 Source,并由 use 负责关闭 FileSystem.SYSTEM.source(path).use { fileSource -> // 增加缓冲层,并由 use 负责关闭 fileSource.buffer().use { bufferedFileSource -> while (true) { // 读取一行;null 表示流结束 val line = bufferedFileSource.readUtf8Line() ?: break // 输出包含 square 的行 if ("square" in line) { println(line) } } } }}5.3 readUtf8Line 按行读取
读链路的核心循环,也是 RealBufferedSource 与 InputStreamSource 唯一的交互点。按行读也是最能体现「块链表 + 按需拉取」协作方式的场景:行的长度事先未知,数据可能跨块,也可能根本还没从磁盘读进来。
涉及的 API 与实现方法:
BufferedSource.readUtf8Line(): String?:读取一行文本;流结束且没有剩余数据时返回null。RealBufferedSource.commonIndexOf(b: Byte, fromIndex: Long, toIndex: Long): Long:在缓冲区中查找目标字节,并在数据不足时向下游继续读取。Buffer.seek(fromIndex: Long, lambda: (Segment?, Long) -> T): T:从距离目标位置更近的一端定位起始Segment。Buffer.readUtf8Line(newline: Long): String:根据换行符位置读取行内容并消费行尾符。Source.read(sink: Buffer, byteCount: Long): Long:将数据直接读入目标Buffer。Buffer.writableSegment(minimumCapacity: Int): Segment:为本次读取提供可写尾块。
入口:
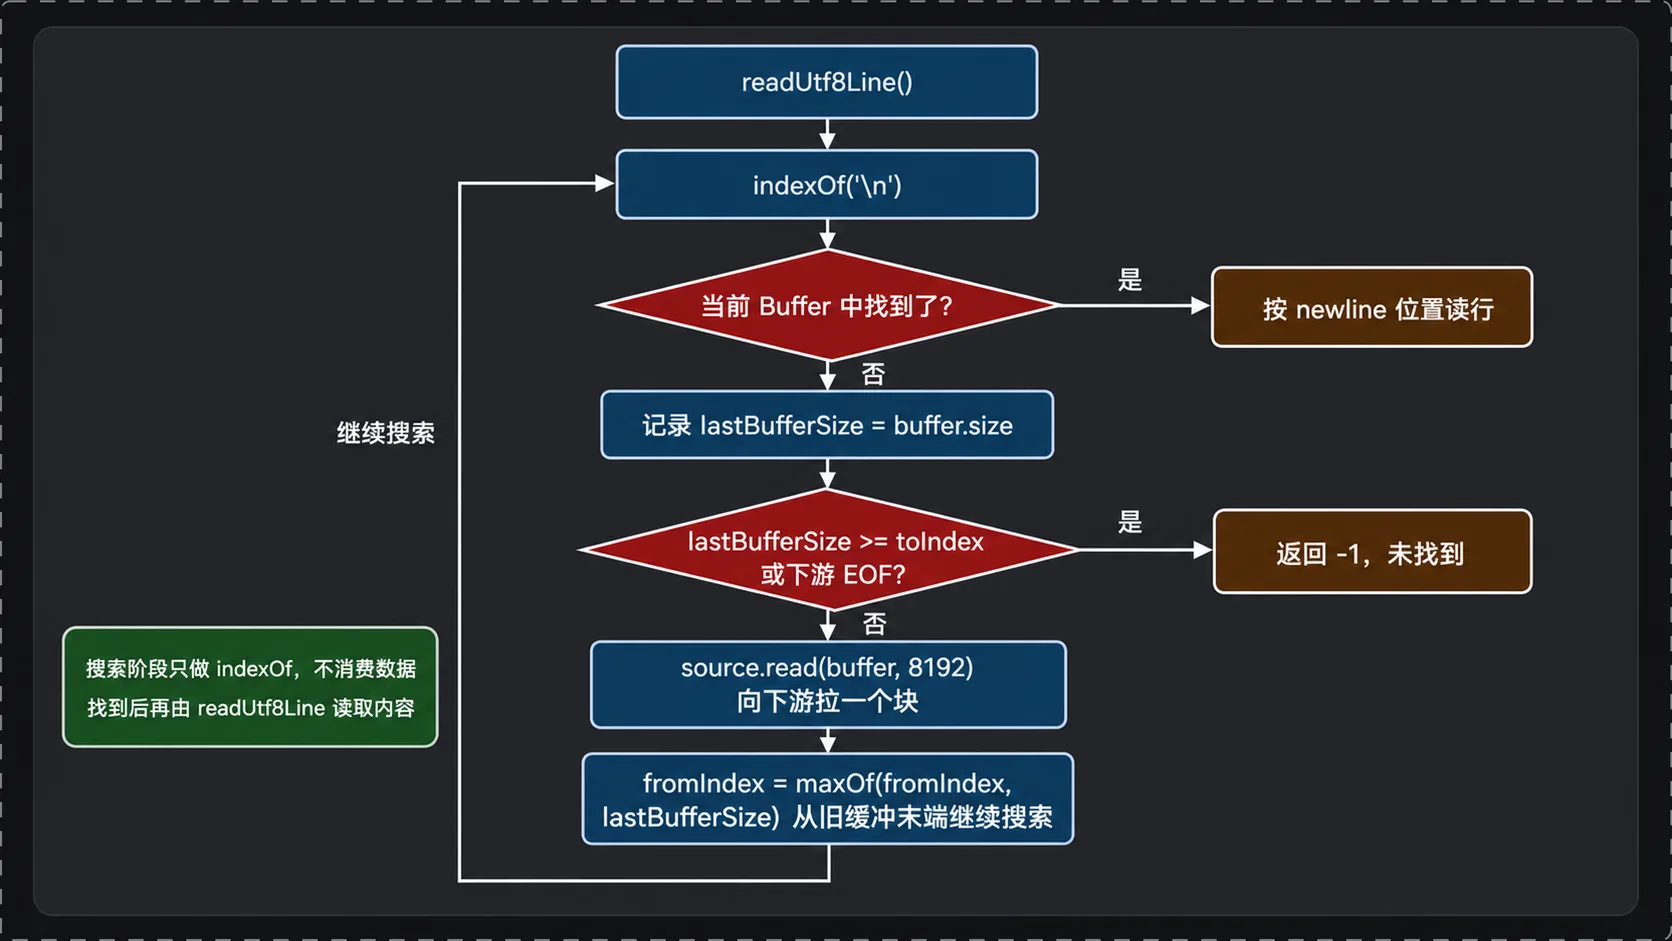
// commonMain/okio/internal/RealBufferedSource.kt:186internal inline fun RealBufferedSource.commonReadUtf8Line(): String? { // 查找第一个换行符的绝对下标,必要时从下游补充数据 val newline = indexOf('\n'.code.toByte()) return if (newline == -1L) { // 未找到换行符时,将剩余缓冲数据作为最后一行 if (buffer.size != 0L) { readUtf8(buffer.size) } else { // 缓冲为空,返回流结束标记 null } } else { // 按换行符位置读取一行 buffer.readUtf8Line(newline) }}真正的循环在 indexOf 里,「找不到就拉更多数据」:
// commonMain/okio/internal/RealBufferedSource.kt:316internal inline fun RealBufferedSource.commonIndexOf(b: Byte, fromIndex: Long, toIndex: Long): Long { var fromIndex = fromIndex check(!closed) { "closed" } require(fromIndex in 0L..toIndex) { "fromIndex=$fromIndex toIndex=$toIndex" } while (fromIndex < toIndex) { // 在当前缓冲区间内查找目标字节 val result = buffer.indexOf(b, fromIndex, toIndex) // 返回目标字节的绝对下标 if (result != -1L) return result // 记录当前缓冲大小,作为下一轮搜索起点 val lastBufferSize = buffer.size // 达到搜索上限或下游结束时返回未找到 if (lastBufferSize >= toIndex || source.read(buffer, Segment.SIZE.toLong()) == -1L) return -1L // 从上次扫描终点继续,避免重复扫描 fromIndex = maxOf(fromIndex, lastBufferSize) } return -1L}- 每次向下游要数据都是
Segment.SIZE(8192)字节,正好一个块,配合下面InputStreamSource.read里的minOf(byteCount, Segment.SIZE - tail.limit),一次read最多填满一个块。 fromIndex = maxOf(fromIndex, lastBufferSize)保证已扫描区间不重复扫描,整个「找换行符」的过程对每个字节只看一次,总复杂度线性。
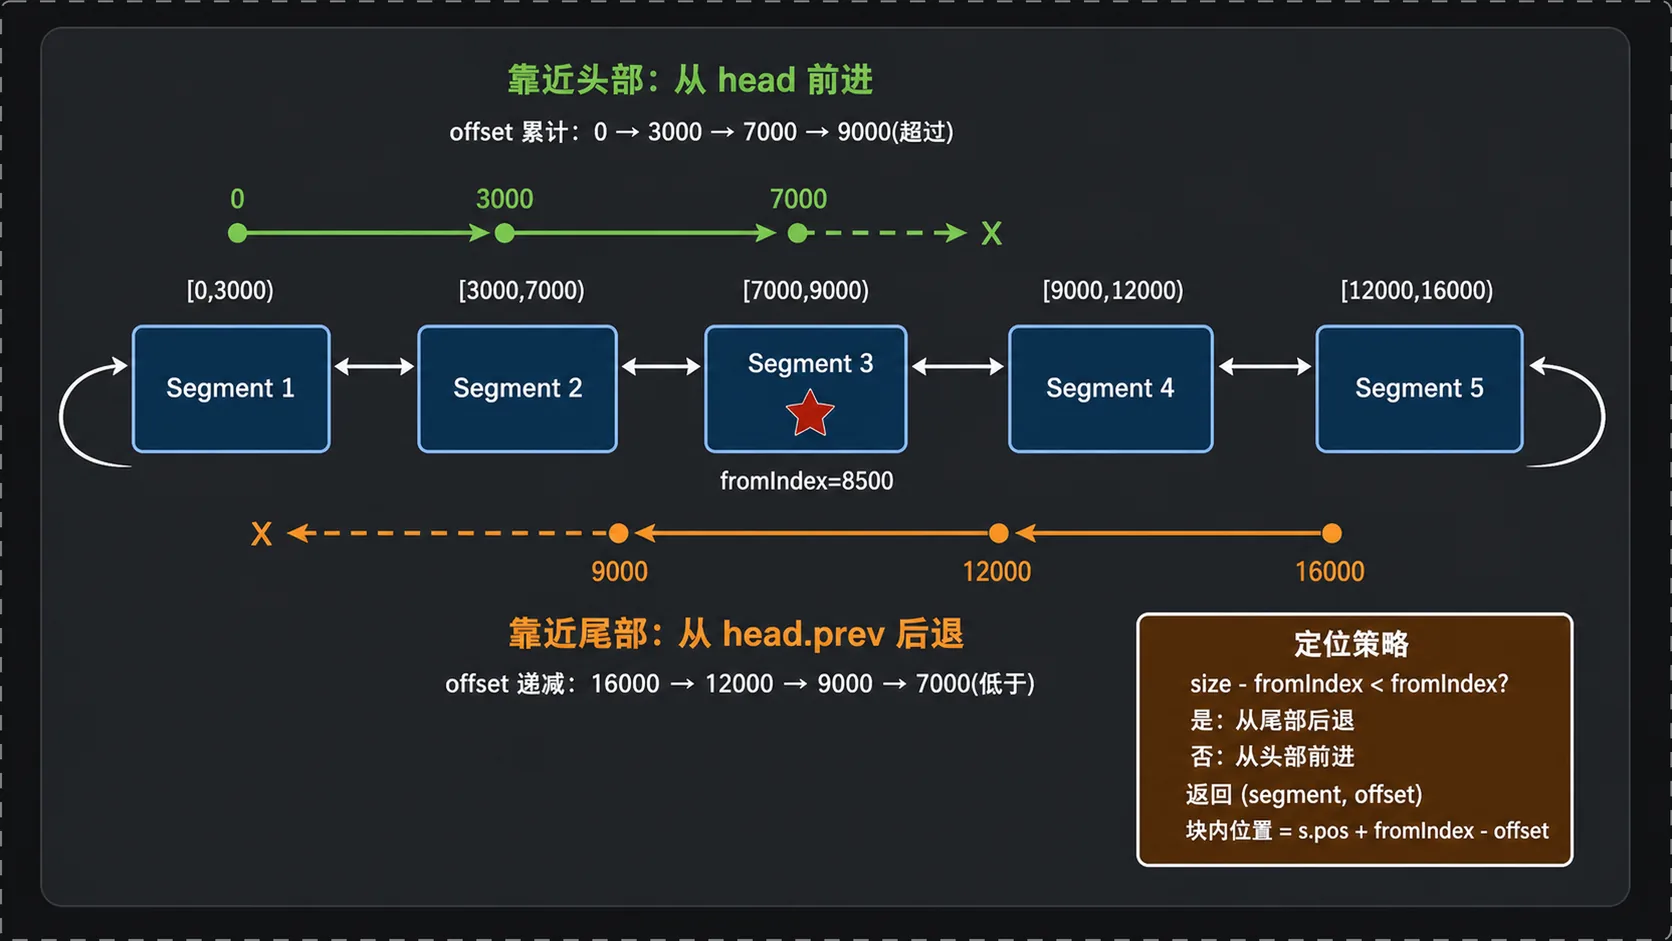
Buffer.indexOf 本身要处理跨块扫描,它依赖一个叫 seek 的辅助函数来定位起始块:
// commonMain/okio/internal/Buffer.kt:105internal inline fun <T> Buffer.seek( fromIndex: Long, lambda: (Segment?, Long) -> T,): T { // 缓冲为空时,以 null 调用回调 var s: Segment = head ?: return lambda(null, -1L) // 目标更靠近尾部时,从尾向前定位 if (size - fromIndex < fromIndex) { var offset = size while (offset > fromIndex) { s = s.prev!! offset -= (s.limit - s.pos).toLong() } return lambda(s, offset) } else { // 否则从头向后定位 var offset = 0L while (true) { val nextOffset = offset + (s.limit - s.pos) if (nextOffset > fromIndex) break s = s.next!! offset = nextOffset } return lambda(s, offset) }}seek 利用环形链表可以双向遍历的特性,比较 fromIndex 与 size - fromIndex 决定从哪头开始找,把定位代价减半。回调拿到的 (segment, offset) 里,offset 是这个块第一个字节在整个 Buffer 中的绝对下标,块内相对位置由 s.pos + fromIndex - offset 算出。
找到换行符之后的切割:
// commonMain/okio/internal/Buffer.kt:84internal fun Buffer.readUtf8Line(newline: Long): String { return when { // 前一字节为 \r 时按 \r\n 行尾处理 newline > 0 && this[newline - 1] == '\r'.code.toByte() -> { // 读取 \r 之前的内容 val result = readUtf8(newline - 1L) // 消费 \r 和 \n skip(2L) result } else -> { // 按 \n 行尾读取内容 val result = readUtf8(newline) // 消费 \n skip(1L) result } }}this[newline - 1] 走的是 commonGet,内部又是一次 seek;trace 里可以清楚看到 readUtf8Line:84 → commonGet:410 → seek:105 这条链,出现 commonGet 的那些行就是以 \r\n 结尾的行。
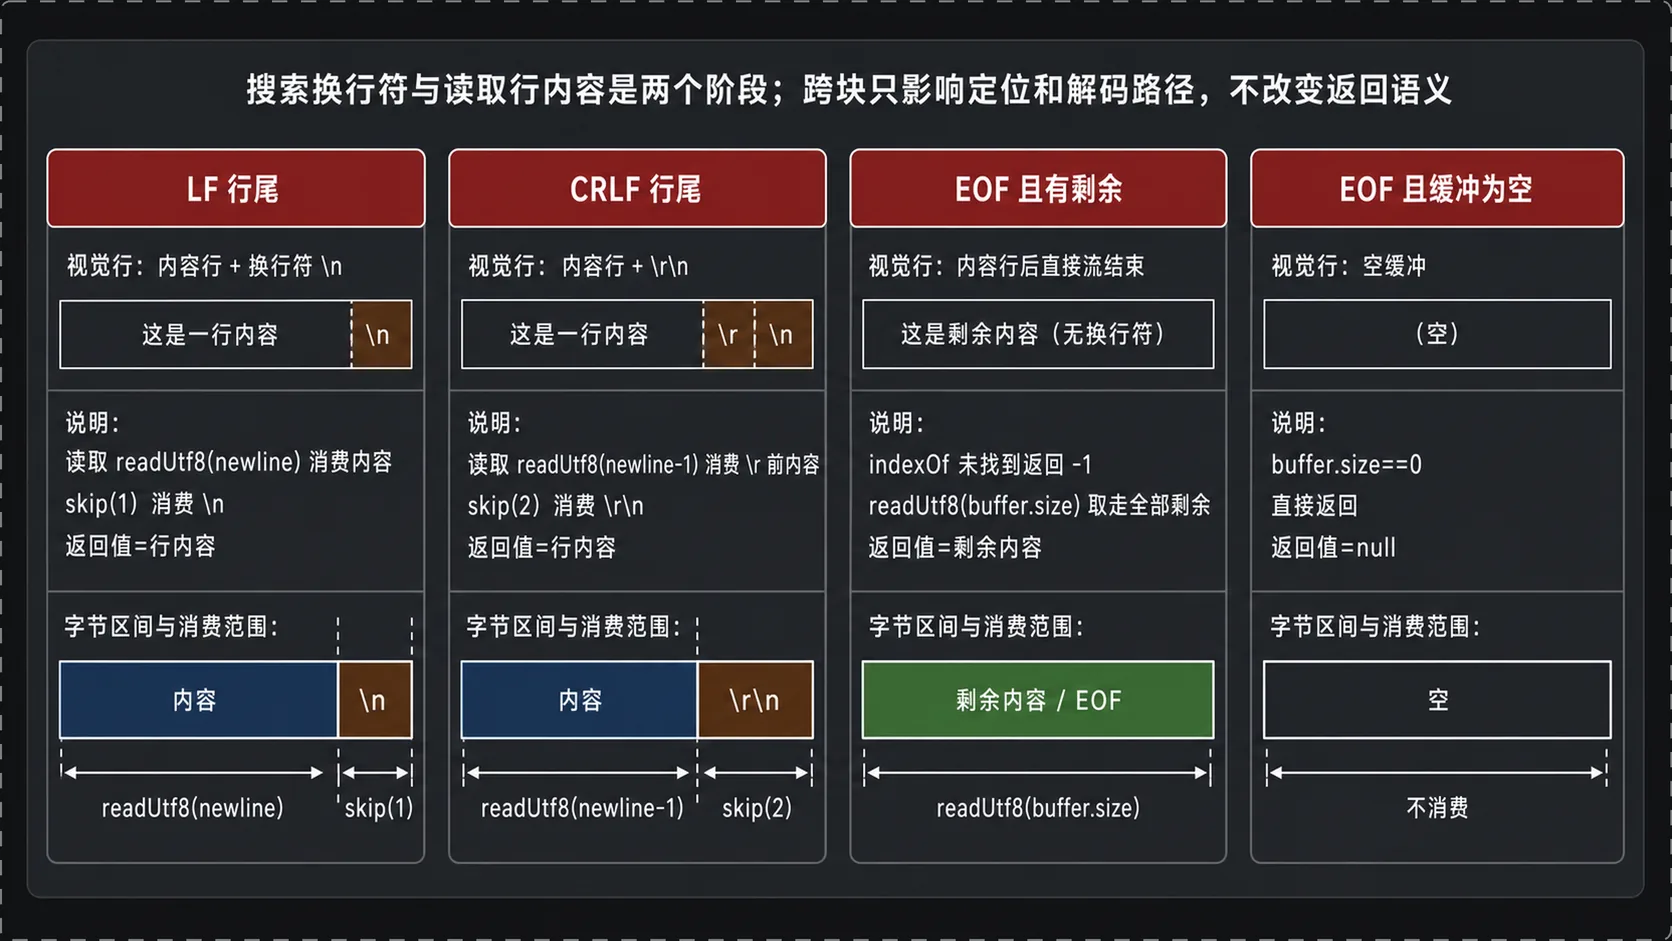
最后补上 commonIndexOf 中 source.read(buffer, ...) :
// jvmMain/okio/JvmOkio.kt:87override fun read(sink: Buffer, byteCount: Long): Long { // byteCount 为 0 时直接返回 if (byteCount == 0L) return 0L // byteCount 不得为负数 require(byteCount >= 0L) { "byteCount < 0: $byteCount" } try { // 文件 Source 使用 Timeout.NONE;Socket Source 可能在此抛出超时异常 timeout.throwIfReached() // 获取至少可写入 1 字节的目标尾块 val tail = sink.writableSegment(1) // 本轮读取量取请求量与尾块剩余空间的较小值 val maxToCopy = minOf(byteCount, Segment.SIZE - tail.limit).toInt() // 将尾块可写区间直接交给 InputStream val bytesRead = input.read(tail.data, tail.limit, maxToCopy) // bytesRead 为 -1 表示底层流结束 if (bytesRead == -1) { // 尾块未接收任何数据时将其回收 if (tail.pos == tail.limit) { // 移除并回收未使用的尾块 sink.head = tail.pop() SegmentPool.recycle(tail) } // 向上层返回流结束标记 return -1 } // 推进尾块写游标 tail.limit += bytesRead // 更新目标 Buffer 总字节数 sink.size += bytesRead return bytesRead.toLong() } catch (e: AssertionError) { // 将 Android getsockname 相关的 AssertionError 转换为 IOException if (e.isAndroidGetsocknameError) throw IOException(e) throw e }}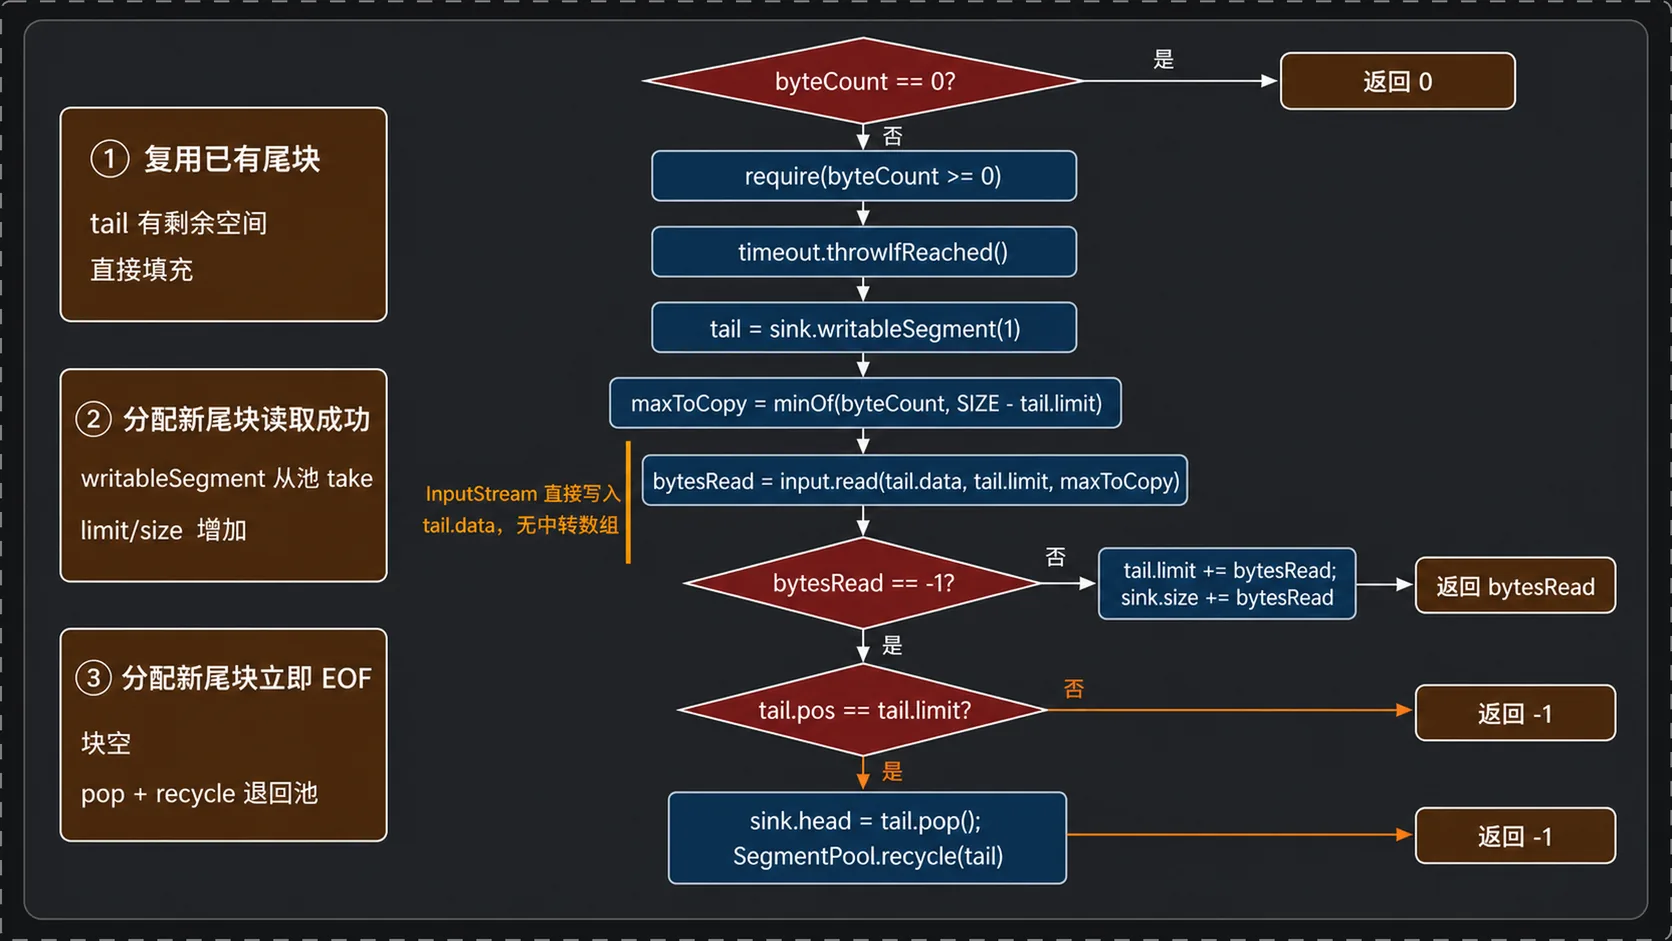
input.read(tail.data, tail.limit, maxToCopy) 与写侧的 out.write(head.data, head.pos, toCopy) 完全对称:磁盘数据被 JVM 直接写进 Segment 的数组,之后无论是 indexOf 扫描还是 readString 解码,操作的都是这块内存,不再复制。
EOF 分支里的 pop + recycle :writableSegment(1) 有可能刚刚从池里取了一块新的(当 Buffer 已经被读空、head == null 时),如果紧接着 input.read 返回 -1,这块就白拿了,必须马上还回去,否则每个流结束时都会漏一块。
两次 read 之间没有第三次,说明这次运行里 README.md 的全部内容被第一次 8192 字节的读取一次装完。整个读文件过程只经历了一次真正的磁盘读、一次 take、一次多余的 take 加 recycle。
5.4 readString 消费与 close
readUtf8Line 找到换行符之后的实际取值,走的是 readUtf8(byteCount) → readString(byteCount, Charsets.UTF_8)。这个函数里藏着一个针对「行不跨块」的快路径。
涉及的 API 与实现方法:
Buffer.readString(byteCount: Long, charset: Charset): String:消费指定字节数并按字符集解码。Buffer.skip(byteCount: Long): Unit:仅推进读游标并消费指定字节数。RealBufferedSource.close(): Unit:关闭下游并清空缓冲区中的剩余数据。
// jvmMain/okio/Buffer.kt:373@Throws(EOFException::class)override fun readString(byteCount: Long, charset: Charset): String { // String 构造器要求长度可表示为 Int require(byteCount >= 0 && byteCount <= Integer.MAX_VALUE) { "byteCount: $byteCount" } // 缓冲数据不足时抛出 EOFException if (size < byteCount) throw EOFException() // 空字符串直接返回 if (byteCount == 0L) return "" val s = head!! // 读取范围跨越头块 if (s.pos + byteCount > s.limit) { // 跨块时先读取为连续字节数组,再执行解码 return String(readByteArray(byteCount), charset) } // 数据位于单个头块时,直接按数组区间构造 String val result = String(s.data, s.pos, byteCount.toInt(), charset) // 推进头块读游标 s.pos += byteCount.toInt() // 更新 Buffer 总字节数 size -= byteCount // 头块已全部消费 if (s.pos == s.limit) { // 移除并回收头块 head = s.pop() SegmentPool.recycle(s) } return result}快路径把「块内偏移」直接喂给 String(byte[], int, int, Charset),省掉一次 Arrays.copyOfRange。慢路径 readByteArray(byteCount) 会走 commonReadByteArray → commonReadFully → commonRead(sink, offset, byteCount),每次从头块拷一段、块读空就 pop + recycle,循环到填满目标数组。这解释了 trace 里为什么有些 readUtf8Line 下面挂着 commonReadByteArray:604 → commonReadFully:615 → commonRead:624,有些没有:挂着的那些就是跨块的长行。
取完内容之后还要丢掉行尾符,走 commonSkip:
// commonMain/okio/internal/Buffer.kt:419internal inline fun Buffer.commonSkip(byteCount: Long) { var byteCount = byteCount while (byteCount > 0) { // 缓冲数据不足时抛出 EOFException val head = this.head ?: throw EOFException() // 本轮消费量取剩余需求与头块可读量的较小值 val toSkip = minOf(byteCount, head.limit - head.pos).toInt() // 更新 Buffer 总字节数 size -= toSkip.toLong() // 更新剩余待消费字节数 byteCount -= toSkip.toLong() // 推进头块读游标 head.pos += toSkip // 头块全部消费后移除并回收 if (head.pos == head.limit) { this.head = head.pop() SegmentPool.recycle(head) } }}「跳过 N 个字节」在 Okio 里是纯指针运算,head.pos += toSkip,代价与 N 无关(除非跨越多个块,那也只是 O(块数))。
收尾:
// commonMain/okio/internal/RealBufferedSource.kt:462internal inline fun RealBufferedSource.commonClose() { // 已关闭时直接返回 if (closed) return // 先更新关闭状态,避免重入 closed = true // 关闭下游;InputStreamSource.close() 调用 input.close() source.close() // 清空缓冲;commonClear() 通过 skip(size) 回收剩余块 buffer.clear()}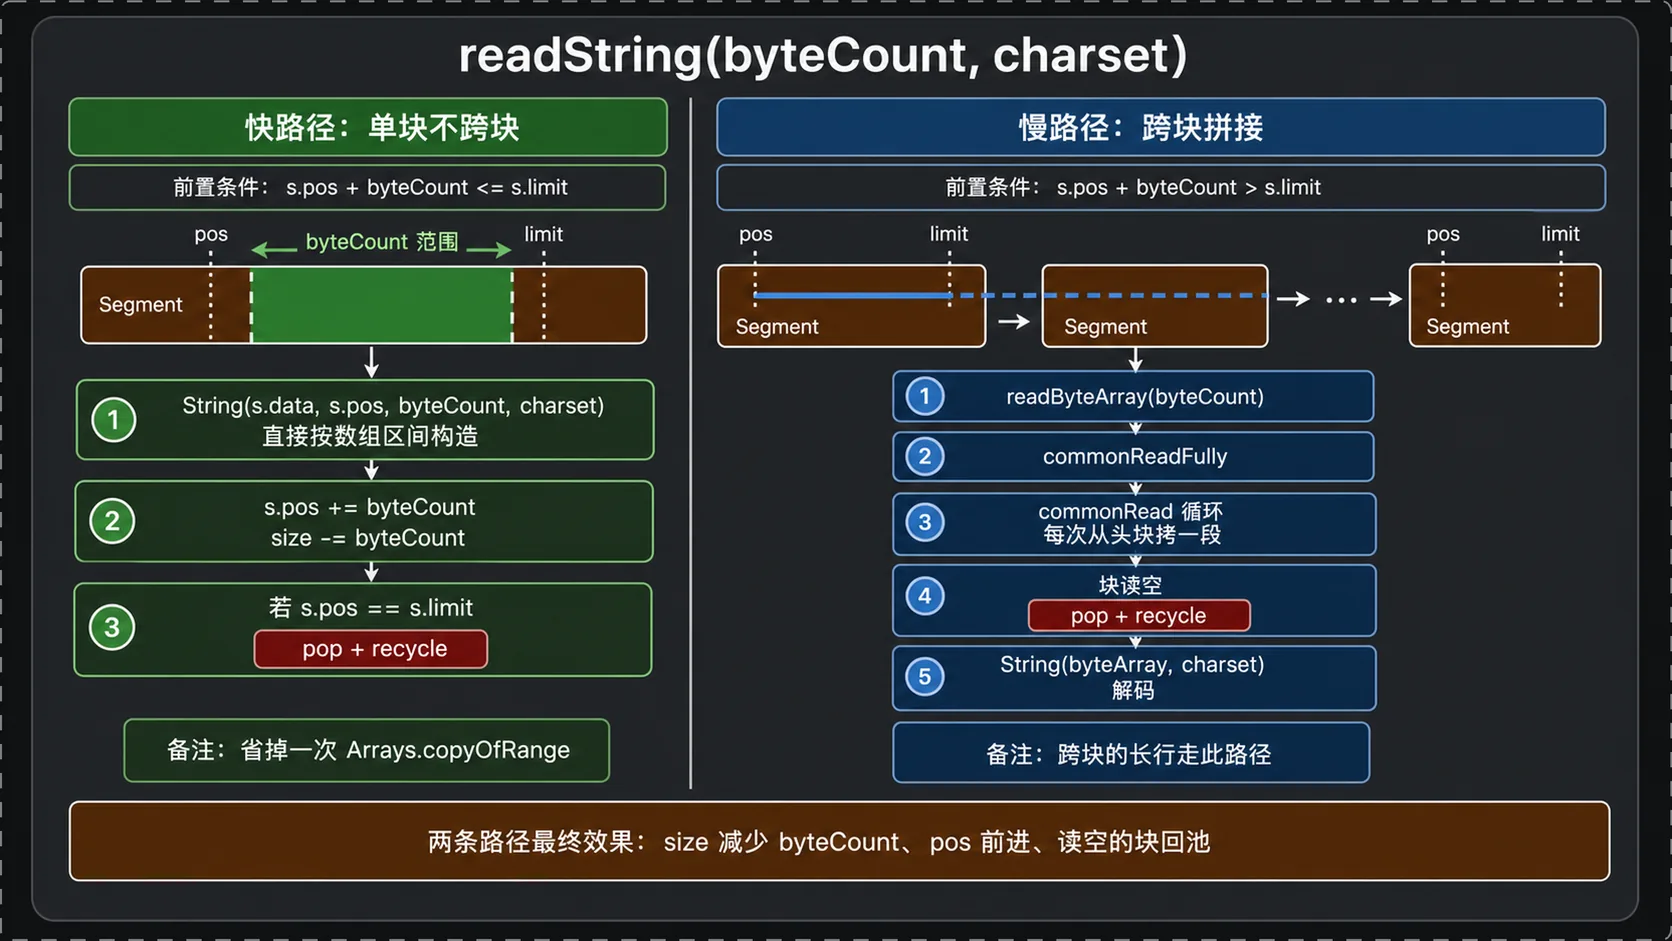
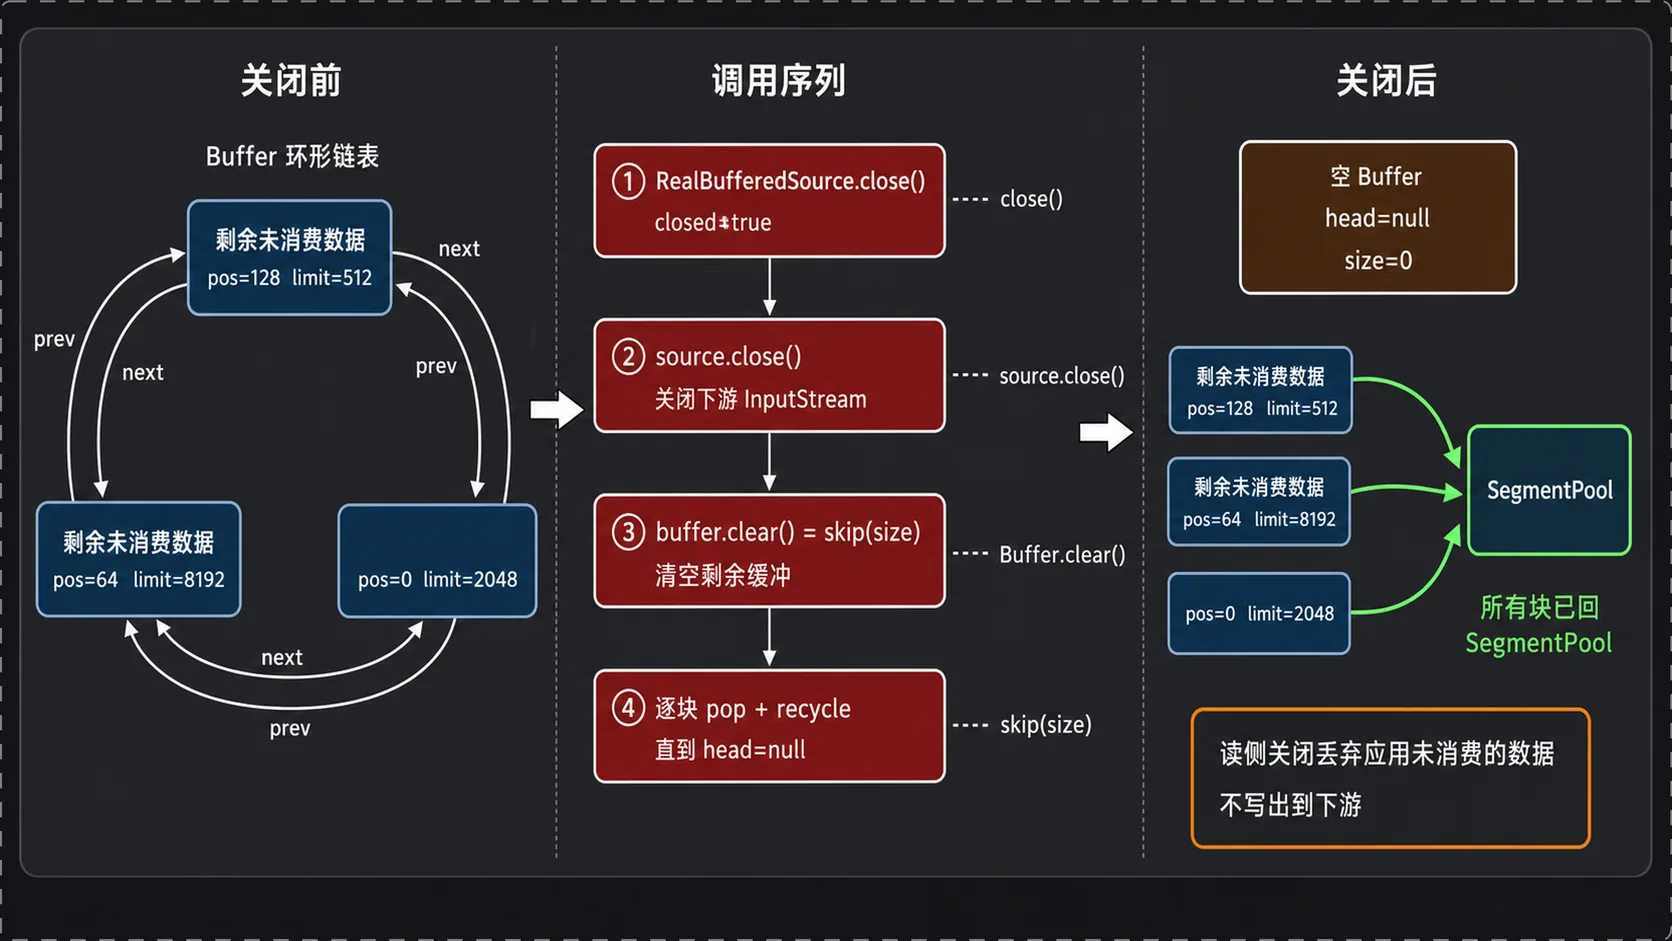
buffer.clear() 定义为 commonClear() = skip(size),所以关闭时缓冲里剩下的块全部被 recycle。
六、总结:Okio 为什么快
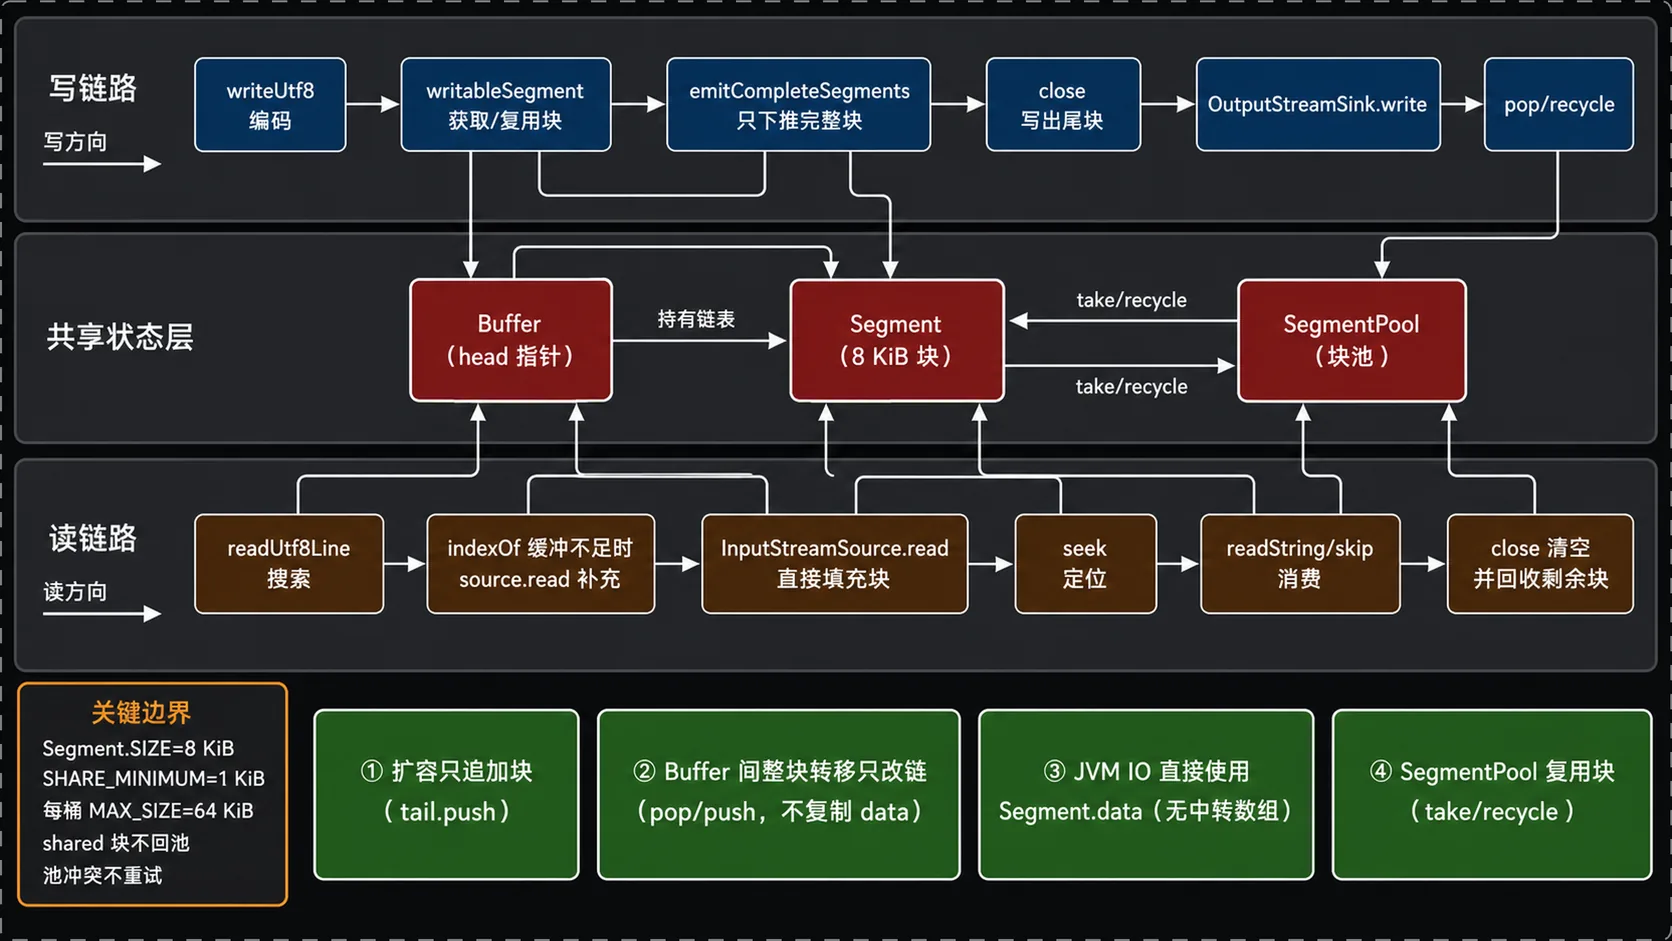
回到开头那个现象:几十次 writeUtf8 没有产生一次系统调用,一次 close 完成了全部落盘。现在可以把原因拆成四条,每条都对应前面的具体代码:
一、缓冲扩容不拷贝。 定长 byte[] 写满要么落盘要么搬家,Buffer 写满只是 tail.push(SegmentPool.take()),四个指针赋值(commonWritableSegment:554)。链表的代价是访问某个绝对下标要遍历,Okio 用 seek 的双向选择(Buffer.kt:105)把这个代价压到最多半条链。
二、跨缓冲传输不拷贝。 Buffer 到 Buffer 的传输走 commonWrite(source, byteCount)(Buffer.kt:1153),整块转移只改指针;只有当零头小于一个块、或者切出来的前缀小于 SHARE_MINIMUM(1024 字节)时才退化为 copyInto。ByteString 侧的 sharedCopy / unsharedCopy 是同一思路在不可变字节串上的体现。
三、与内核的交界面不拷贝。 out.write(head.data, head.pos, toCopy)(JvmOkio.kt:57)和 input.read(tail.data, tail.limit, maxToCopy)(JvmOkio.kt:94)都直接把 Segment 的数组交给 JVM IO,没有私有中转缓冲。BufferedOutputStream 在这里多一次 arraycopy。
四、块的生命周期被池接管。 SegmentPool 用「线程 id 哈希分桶 + getAndSet(LOCK) 哨兵 + 冲突不重试」换来了完全无阻塞的 take / recycle(SegmentPool.kt:78 与 :103),同时把回收上限卡在每桶 64 KiB。稳态下读写一个大文件几乎不产生新的 8 KiB 数组,也不需要清零。
本文由 AgentPlanFlow 生成