
文章内容
预训练结束时,手上的基座大模型只会做一件事:接着前面的内容往下续写。用户输入「我应不应该好好学习」,它回一句「天天向上」。距离一个能用的 AI 助手,还差最后一个阶段。
一、回顾:从接龙大师说起
1.1 前两个阶段做了什么
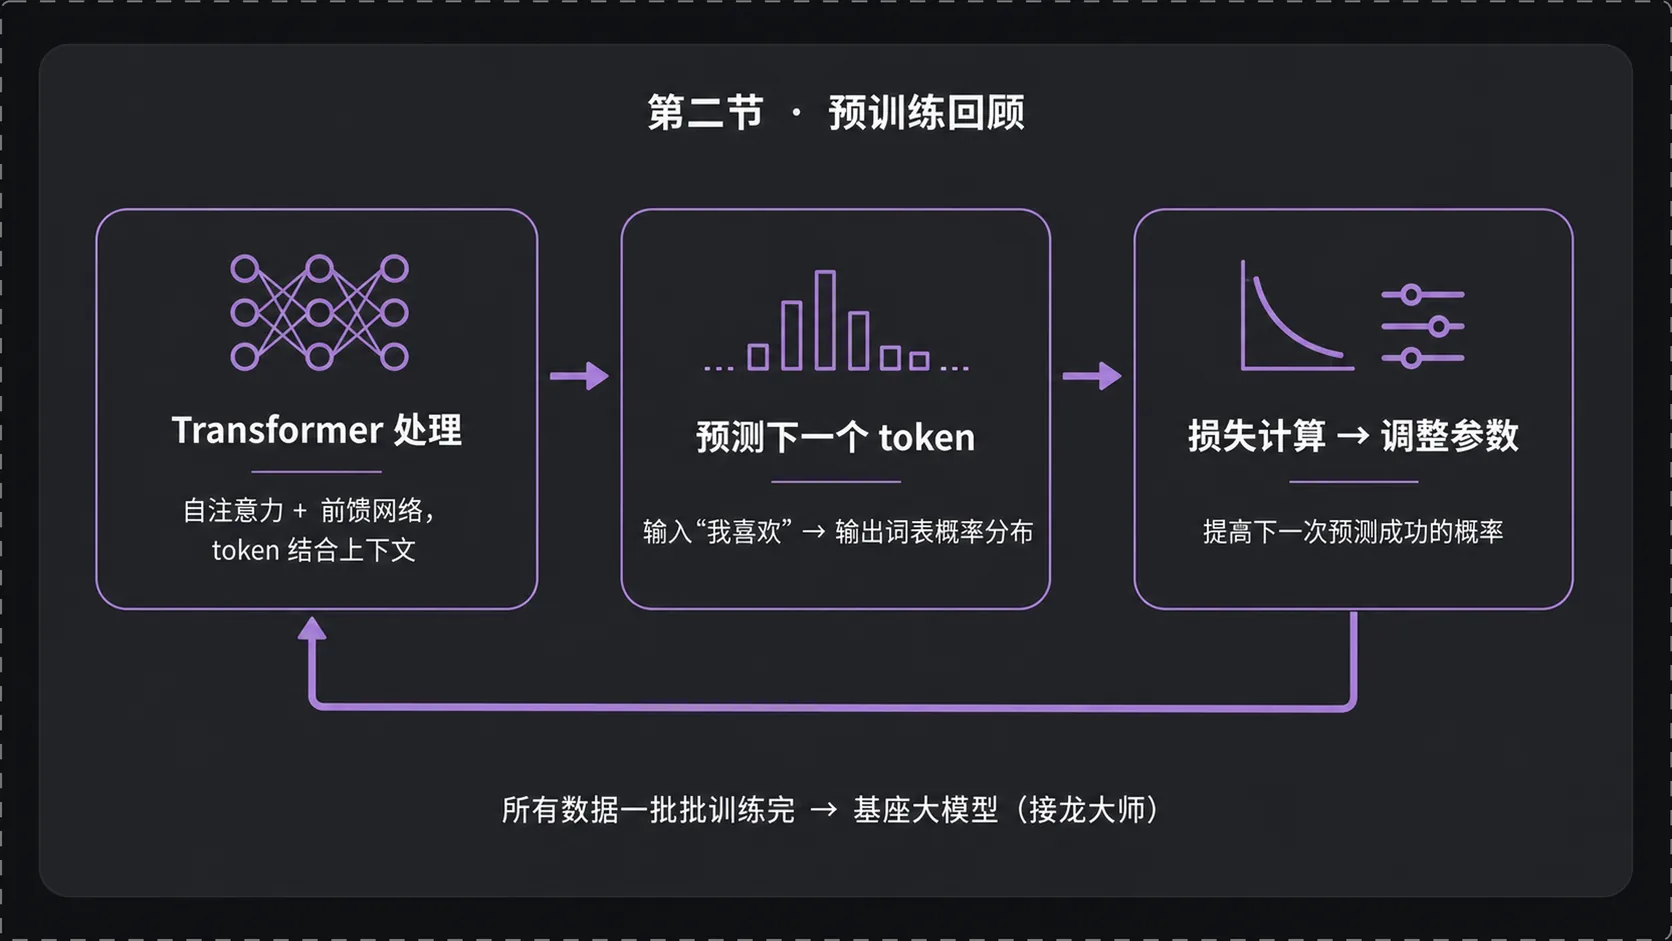
第一节讲数据准备:资料收集与清洗得到干净文本,文本切分成 token,每个 token 转换成高维向量,完成从文本到数字的转换。
第二节讲预训练:高维向量输入 Transformer,经过自注意力机制和前馈神经网络处理,每个 token 结合上下文信息得到更丰富的表示,向量里的数字到这时才有了含义;随后模型不断预测下一个 token,根据预测结果调整参数,提高下一次预测成功的概率。所有数据一批批训练完,产出基座大模型。
1.2 基座大模型的局限
「我应不应该好好学习」得到「天天向上」,原因在模型看来很朴素:「好好学习天天向上」是一个非常常见的文本组合。
模型没有理解用户想咨询什么,它只是根据前面的内容做接续。指令、提问、任务这些概念,对它都不存在。
预训练给它的能力是语言规律和知识储备,接龙做得越准,说明这两样掌握得越好。缺的那部分能力与知识量无关:它不知道对面坐着一个提问的人,也不知道自己扮演的是回答者。
二、后训练:让回答与人类对齐
2.1 第三个阶段
第三个阶段叫后训练,也叫对齐训练,名字来自它的目的:让模型的回答逐渐与人类的要求和偏好对齐。
对齐要处理的问题有两层。第一层是听懂,模型得知道用户抛过来的是一个需要回答的问题,而不是一段等待续写的文本。第二层是答好,同样能回答的情况下,哪种回答更符合人的期待。
2.2 两个内容
后训练主要包括两件事:监督微调(SFT)和偏好对齐。前者解决听懂,后者解决答好。
两件事的顺序不能颠倒。模型连指令都识别不了时,讨论回答质量没有意义;监督微调把对话的基本形态建立起来之后,偏好对齐才有可比较的答案可用。
三、监督微调(SFT)
3.1 给示范,学回答
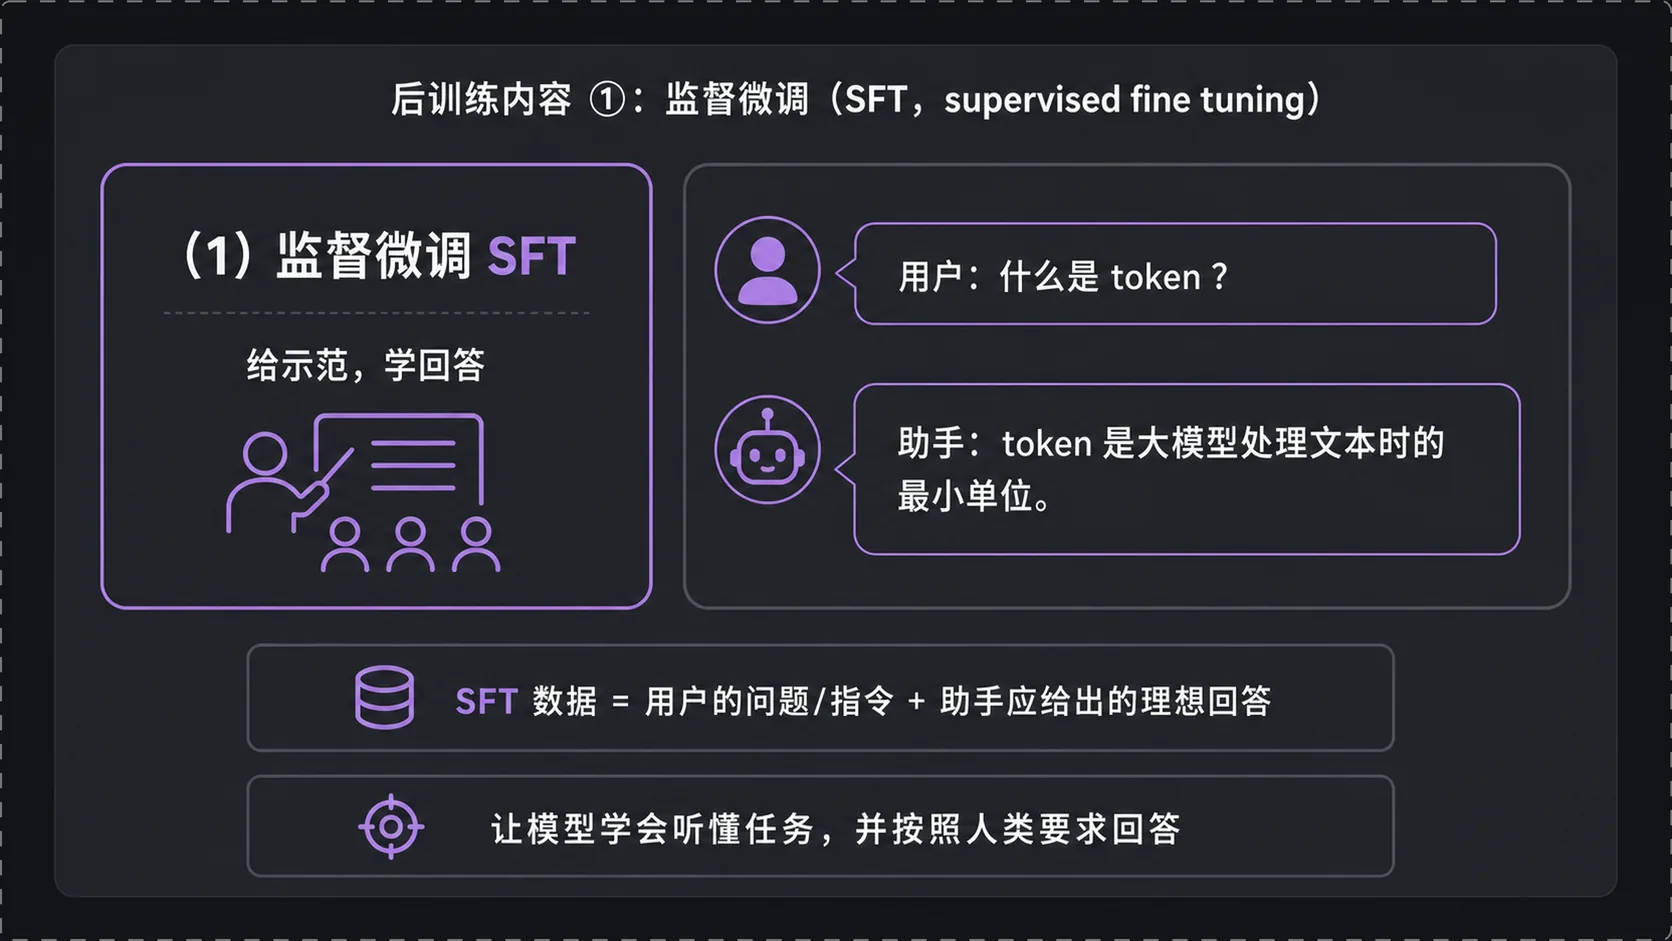
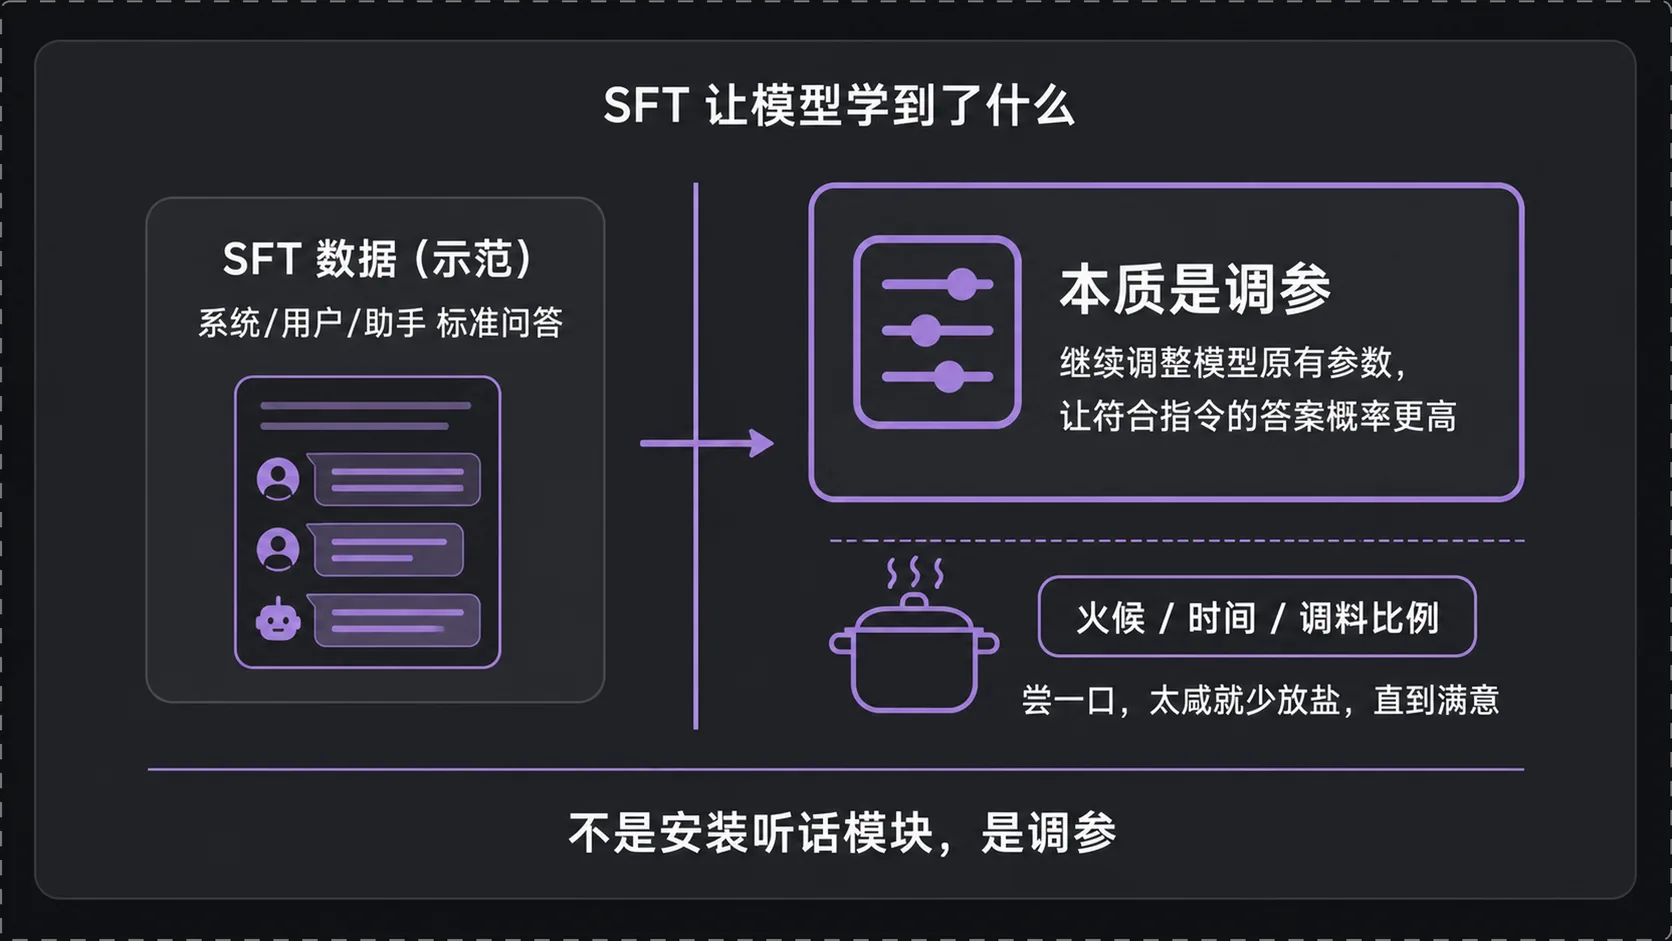
监督微调的英文是 supervised fine tuning,简称 SFT,六个字概括它的做法:给示范,学回答。
给模型大量标准的问答示范,让它学会听懂任务、按照人类的要求来回答。示范数据里,用户说的话和助手该说的话被明确区分开,模型从中学到的是这套对话格式本身。
这批训练数据叫 SFT 数据,最基础的一条由用户提出的问题或指令,加上助手应该给出的理想回答组成:
- 用户:什么是 token?
- 助手:token 是大模型处理文本时的最小单位。
3.2 三种数据形式
SFT 数据的形式不止一种,常见的有三类:基础问答、带系统指令的对话、多轮对话。
带系统指令的对话里多出一个「系统」角色,例如「系统:你是一名专业的人工智能教师」。系统角色存在的理由是同一个问题可以有完全不同的回答方式:系统规定「你是一名小学教师」,那么用户问什么是 token 时,模型就该用小学生能听懂的语言来解释。
系统可以设定模型的角色、回答风格、输出格式、可以调用的工具,让模型学会根据不同情景和要求做出回答。日常使用中那些「你是一个……」的提示词,对应的就是这个位置。
多轮对话则是用户和助手交替出现,一问一答连续若干轮。这类数据训练的是模型对上文的依赖能力:第二个问题里的「它」指什么,得从前面几轮里找。
# 简化示意,非真实实现 # 形式一:基础问答,只有用户与助手两个角色basic = [ {"role": "user", "content": "什么是 token?"}, # 用户提出的问题 {"role": "assistant", "content": "token 是大模型处理文本时的最小单位。"}, # 期望的理想回答] # 形式二:带系统指令,多出一个 system 角色来设定身份与风格with_system = [ {"role": "system", "content": "你是一名专业的人工智能教师"}, # 设定角色、风格、输出格式等 {"role": "user", "content": "什么是 token?"}, {"role": "assistant", "content": "token 是大模型处理文本时的最小单位。"},] # 形式三:多轮对话,用户与助手交替出现multi_turn = with_system + [ {"role": "user", "content": "那一个 token 等于几个字?"}, # 用户追问,依赖上文 {"role": "assistant", "content": "可能是一个字,也可能是好几个字。"}, # 助手结合上下文继续回答]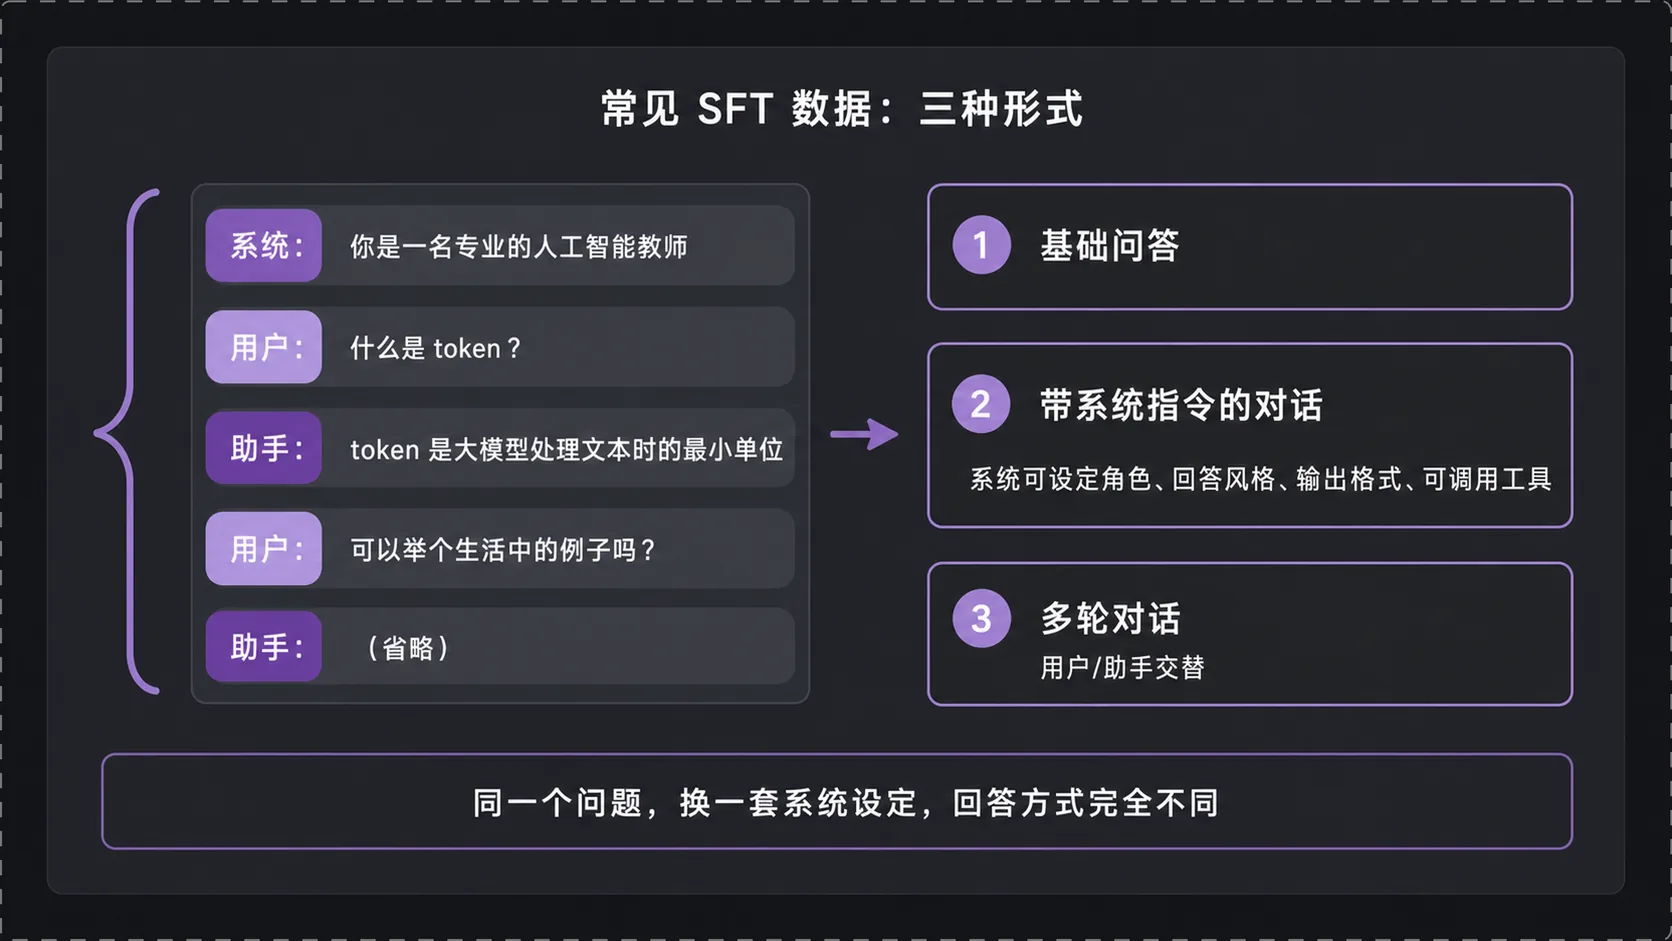
3.3 本质是调参
SFT 并没有在模型内部安装一个新的「听话模块」。训练做的仍然是调整模型原有的参数,让模型生成符合指令的答案的概率变得更高。
炒菜可以对上这个过程:做一道菜要把握火候大小、炖煮时间、油盐等调料的比例;做完尝一口发现太咸,下次就少放一点盐;再尝味道还不对,就继续调整做法,直到满意为止。不断调整这些细节,就是调参。
理解这一点,对使用模型也有帮助。模型听指令的能力来自参数的分布,而不是某个可以单独开关的功能,指令跟随的效果因此会随着提问方式变化,与训练数据里见过的形式越接近,表现越稳定。
3.4 两类微调方法
监督微调里的调参方法分两大类。
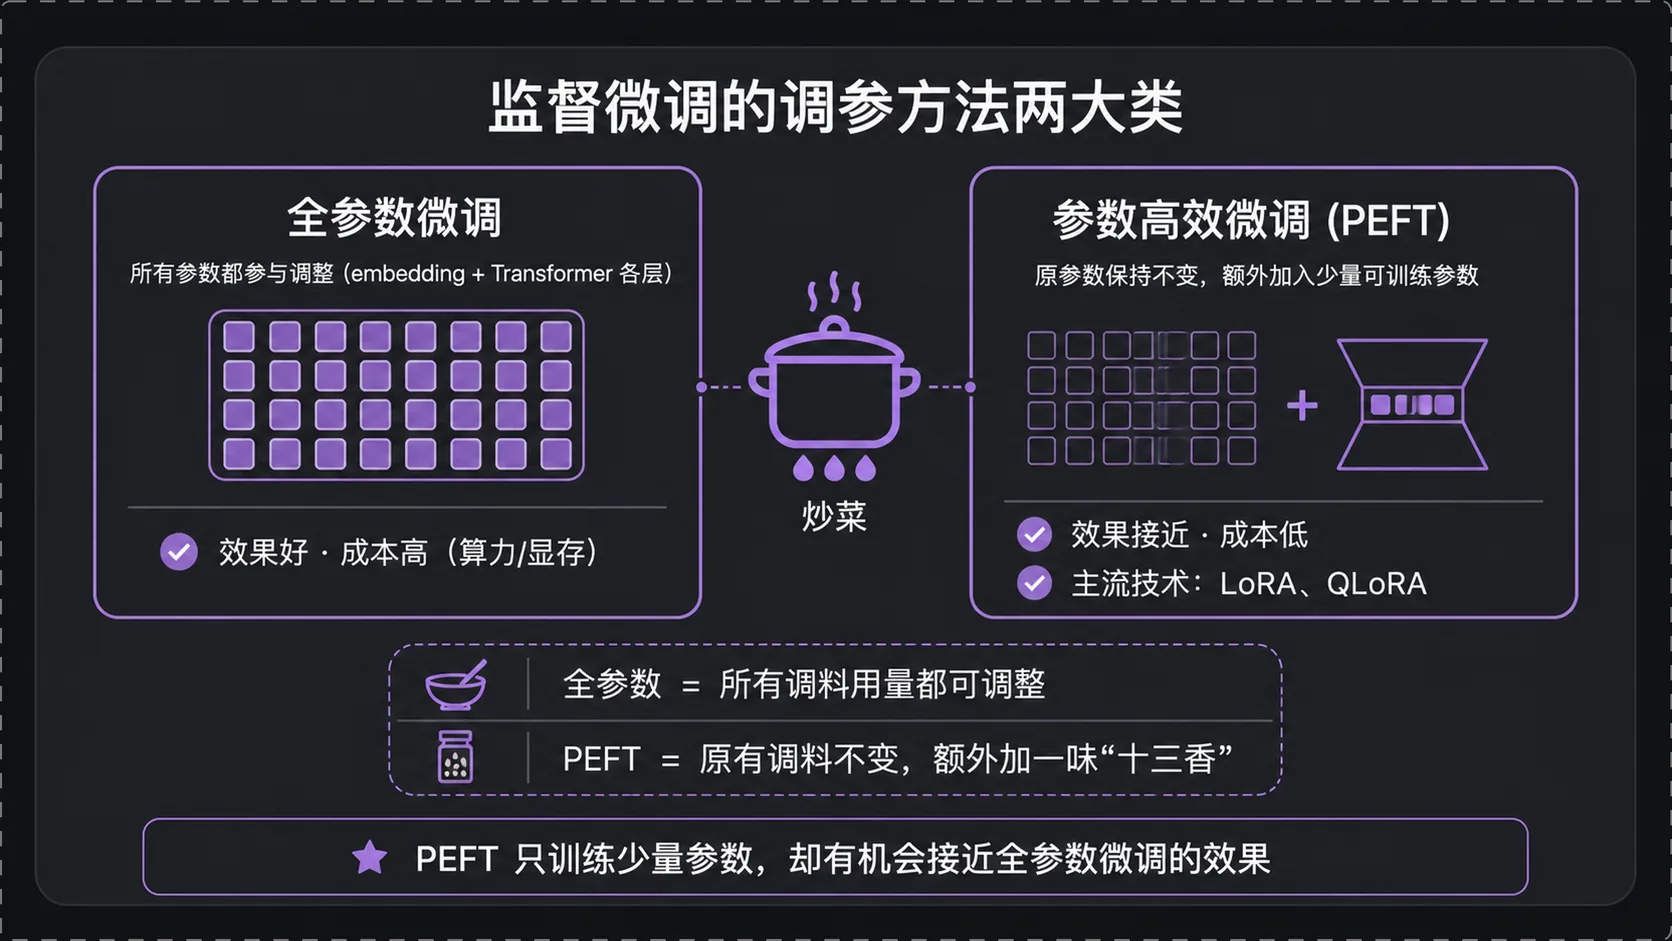
全参数微调允许模型中的所有参数参与调整,包括 embedding 里的参数和 Transformer 各个网络层的大量参数。它的效果通常较好,代价是成本高,需要大量算力和显存。
参数高效微调(PEFT)走另一条路:原模型的大多数参数保持不变,不直接修改,在模型中额外加入少量可训练、可调整的参数。回到炒菜的说法,全参数微调像是油、盐、生抽、料酒所有配料的用量都能重新调整;PEFT 则保持原有调料比例不动,额外加入一种新配料(比如十三香),靠调整这种新配料的用量让菜更接近想要的味道。
PEFT 只需要训练少量参数,有机会达到接近全参数微调的效果,训练成本更低。目前主流的 PEFT 技术包括 LoRA、QLoRA 等。
四、偏好对齐
4.1 两个痛点
经过监督微调,模型已经在一定程度上学会了对话,但还有两个问题没解决。
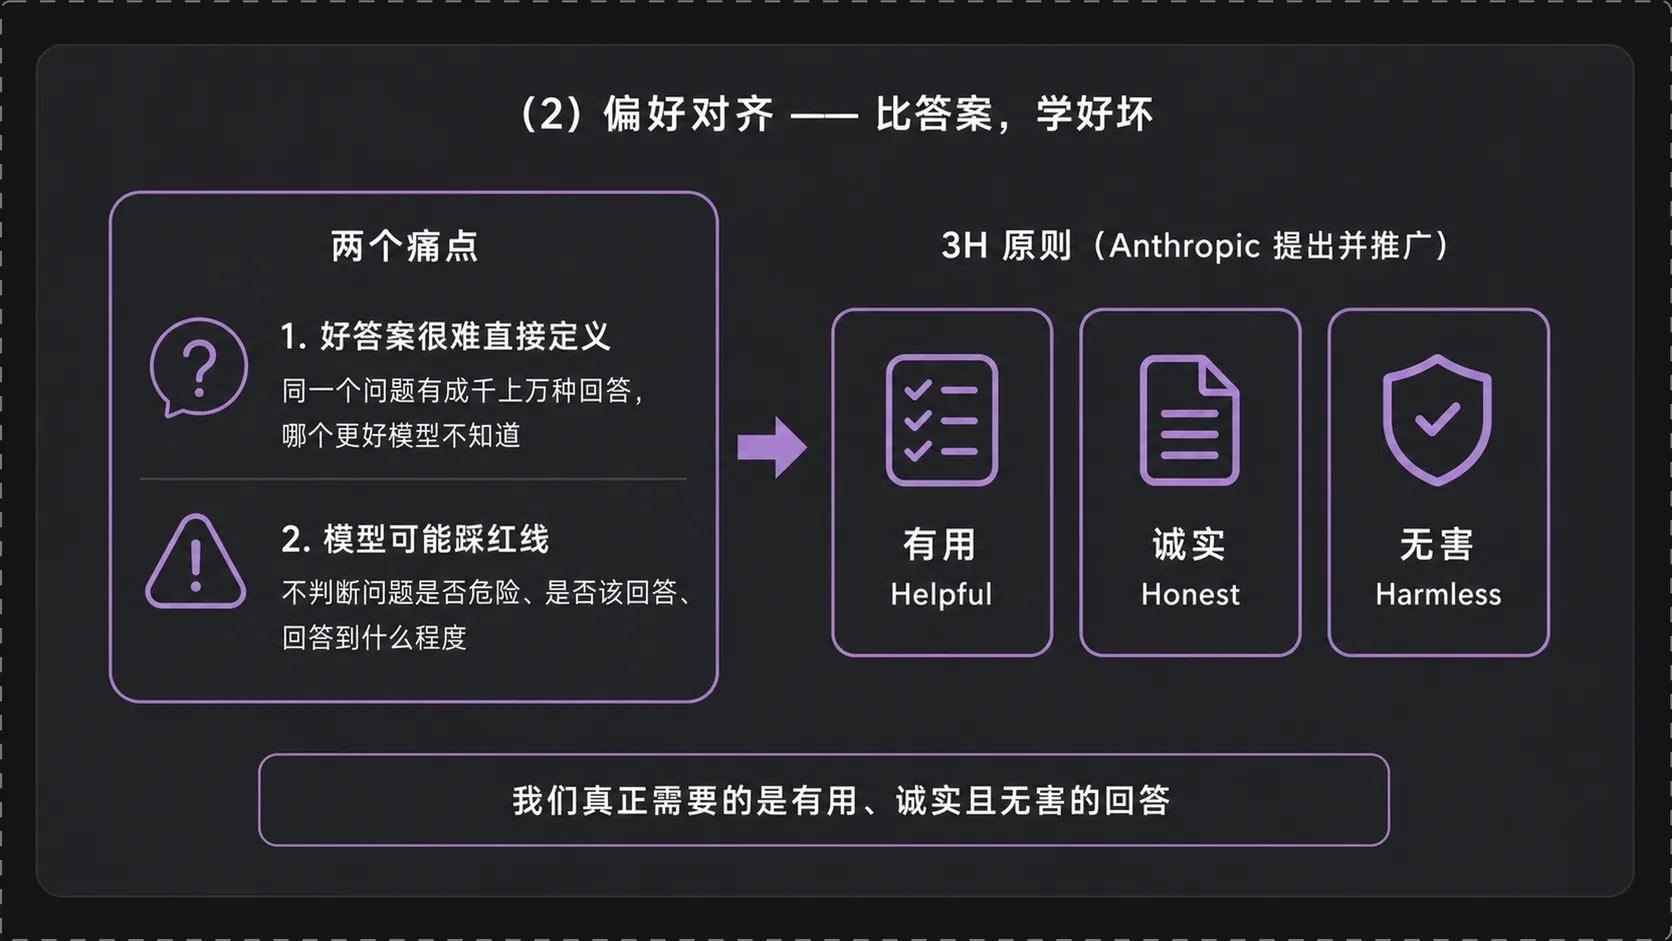
好答案很难直接定义。同一个问题可能存在成千上万种不同回答,哪个更好、哪个更符合人类需求,模型自己并不知道。监督微调只提供了一份标准示范,示范之外的大量表述,好坏没有被标注过。
模型可能会踩红线。只做监督微调的话,模型可能不管用户问什么都直接回答,不会主动判断这个问题是否危险、是否应该回答、应该回答到什么程度。
4.2 3H 原则
真正需要的是有用、诚实且无害的回答,对应 Anthropic 公司提出并推广的 3H 原则(画面里写作 HHH 原则):Helpful、Honest、Harmless。
三个词各自约束一个方向:Helpful 要求回答对用户有实际帮助,Honest 要求内容真实,Harmless 要求不产生有害后果。偏好对齐要做的,就是把这套标准变成模型能学习的信号。
标准本身没法写成一条规则塞进模型,人对回答好坏的判断分散在无数具体场景里。可行的做法是让人来比较,把比较的结果转换成训练信号。
4.3 RLHF:先训练一位老师
基于人类反馈的强化学习(RLHF)分几步走。
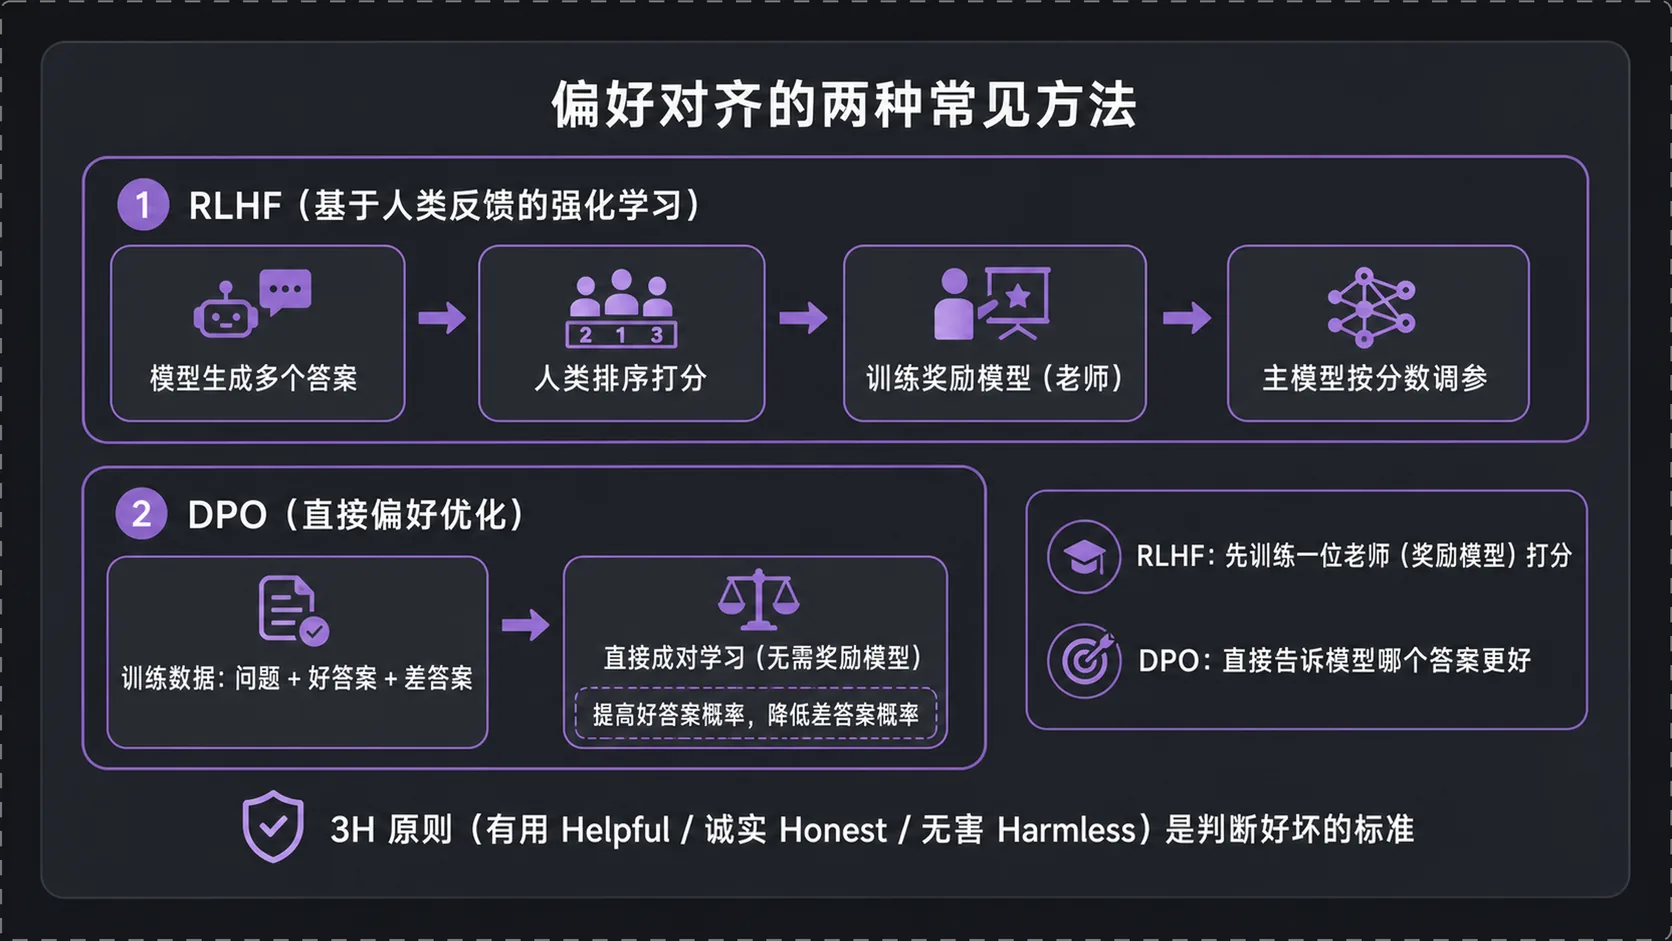
针对同一个问题,让模型生成多个不同的答案,由人类对这些答案进行比较和排序。研究人员用排序好的数据训练出一个奖励模型,它相当于一位老师,专门给模型生成的答案打分。
之后主模型不断生成新的答案,奖励模型根据人类偏好给出分数,主模型再根据分数继续调整参数,好答案出现的概率逐渐提高,差答案出现的概率逐渐降低。
# 简化示意,非真实实现 question = "我应不应该好好学习?"answers = ["天天向上", "取决于你的目标,如果……"] # 主模型对同一个问题生成的多个答案 # 人类对这批答案做比较和排序,排在前面的更符合偏好human_ranking = [1, 0] # 下标 1 的答案更好,下标 0 的更差 # 奖励模型:用排序数据训练出来的打分器,输入一个答案,输出一个分数def reward_model(question, answer): return score_by_human_preference(question, answer) # 分数越高表示越贴近人类偏好 for answer in main_model.generate(question, n=4): # 主模型继续生成新答案 score = reward_model(question, answer) # 奖励模型给这个答案打分 main_model.update_params(answer, score) # 按分数调参:高分答案概率升,低分答案概率降4.4 DPO:直接告诉它哪个更好
直接偏好优化(DPO)省掉了奖励模型这一环。训练数据里直接给出一个问题、一个更好的答案、一个相对较差的答案,模型通过成对答案学习,提高好答案的生成概率,降低差答案的生成概率。
4.5 两者的区别
RLHF 先训练出一位老师(奖励模型),再由这位老师给模型的答案打分;DPO 直接告诉模型两个答案中哪一个更好。
两条路线的目标一致:提高好答案的生成概率,降低差答案的生成概率,让模型在遇到危险问题时懂得判断该不该回答、回答到什么程度。
五、总结
- 数据准备把人类的文本资料转换成模型能处理的数字:收集清洗、切分成 token、映射成高维向量。
- 预训练让模型通过预测下一个 token,学习语言的规律和大量知识,产出只会接龙的基座大模型。
- 后训练通过监督微调和偏好对齐,让模型学会听懂人的命令、按照人类要求回答,并生成更加有用、诚实且无害的内容。
三个阶段走完,一个最初只会预测下一个 token 的模型,才变成现在这个可以正常交流、回答问题、完成任务的大语言模型。
本文由 AgentPlanFlow 生成