
文章内容
- 一、回顾:注意力机制算到了哪
- 二、多头注意力:一个头看不全面
- 2.1 一句话里的多种联系
- 2.2 多组参数矩阵并行算多个 head
- 2.3 Concat 拼接 + WO 投影回原维度
- 2.4 多头注意力公式
- 三、残差连接:新信息叠加在旧信息上
- 3.1 X' = X + MultiHead(X)
- 3.2 为什么不是覆盖
- 四、层归一化:把数值拉回稳定区间
- 4.1 残差之后数值分布失衡
- 4.2 三步手算:均值、方差与标准差、归一化
- 4.3 γ 与 β:归一化之后的线性变换
- 4.4 维度为 2 时结果必为 ±1
- 五、前馈神经网络:每个 token 独立思考
- 5.1 注意力是开会,FFN 是回到工位
- 5.2 公式:两次线性变换 + ReLU
- 5.3 计算整合
- 六、第二次残差与归一化:一层的收尾
- 6.1 两次残差保护不同阶段的信息
- 6.2 一个完整 Transformer 层的结构
- 七、最小实现Demo
上一篇把「女生撩刘海」这三个 token 算到了注意力的输出 Z。但 Z 还不是这一层的结果。从 Z 到真正送给下一层的东西,中间还隔着多头拼接、两次残差、两次层归一化和一个前馈网络。这几步各自解决一个具体问题,去掉任何一个,模型要么学不到足够丰富的关系,要么深度一堆上去就训不动。
这一篇把它们逐个计算完,例子和维度都沿用上一篇:三个 token,d = 2。
一、回顾:注意力机制算到了哪
输入矩阵 X 是词嵌入加位置编码的结果:
X = [[3.0000, 2.0000] ← 女生 [2.8415, 2.5403] ← 撩 [2.9093, 3.5839]] ← 刘海X 乘三个参数矩阵得到 Q、K、V,然后走缩放点积注意力:
三个角色可以套一个检索的比方:Q 是搜索框里敲进去的关键词,K 是每篇文档的标题,V 是文档正文。Q·Kᵀ 算出关键词和每个标题的匹配度,除 √d_k 压住量级,softmax 换算成占比,再拿这组占比去加权正文,得到的 Z 就是每个 token 融合上下文之后的新表示。
上一篇算出来的 Z 是:
Z = [[1.5636, 2.5717] [1.6144, 2.4205] [1.6969, 2.1815]]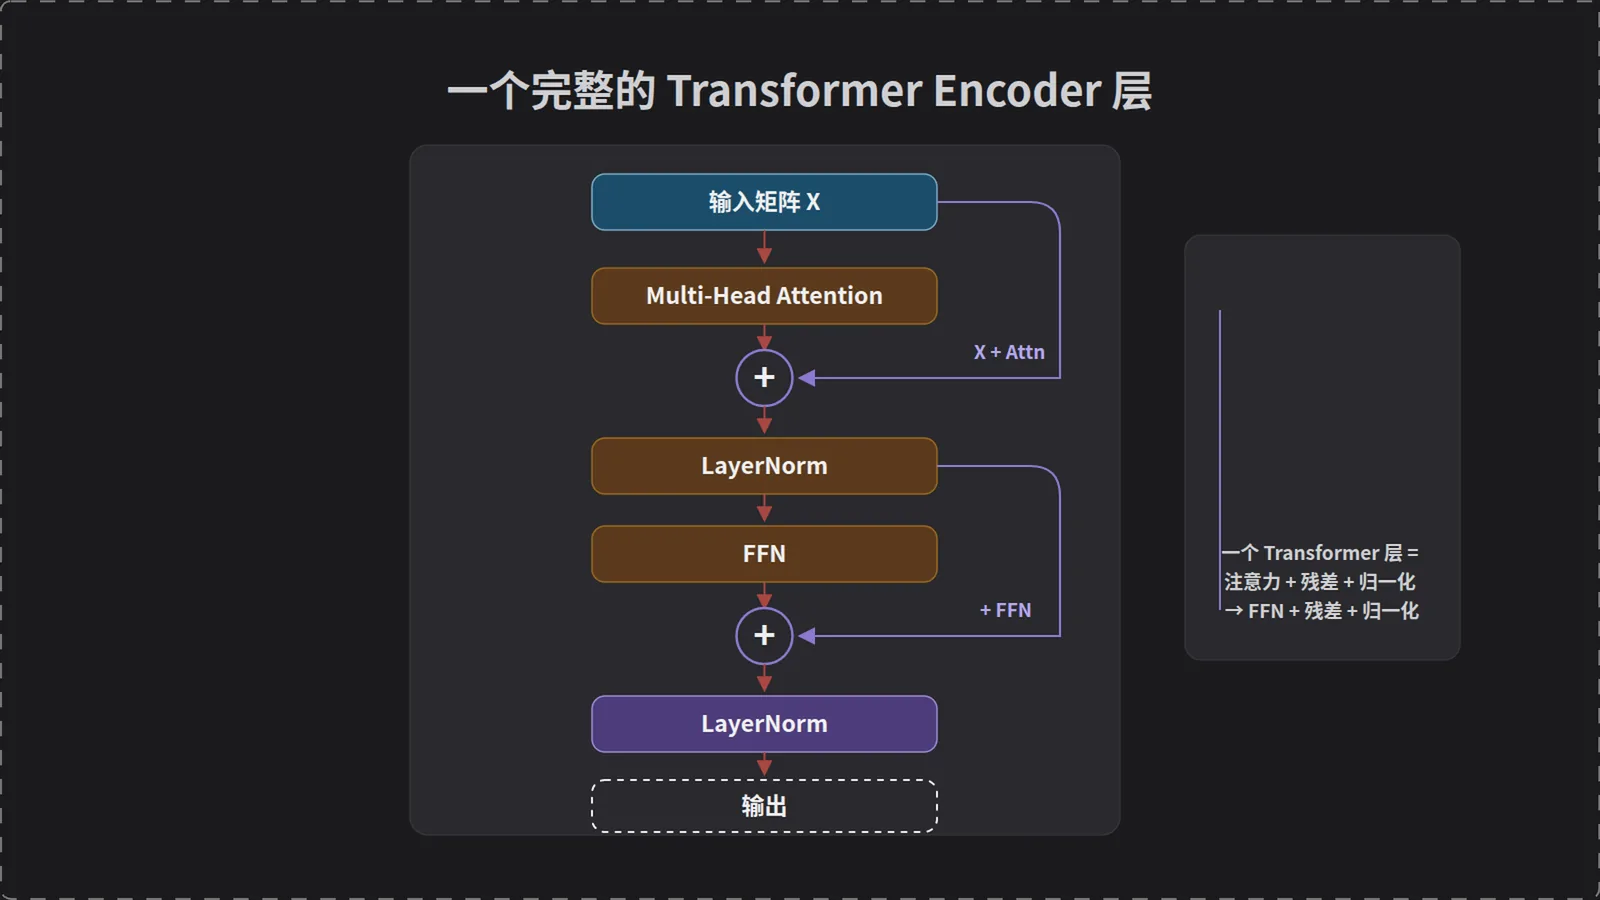
二、多头注意力:一个头看不全面
2.1 一句话里的多种联系
「女生撩刘海」这五个字里同时存在好几层关系。女生做出了一个动作,这是主谓;动作作用在刘海上,这是动宾;刘海是女生头发的一部分,这是从属;再退一步,如果「刘海」是个人名,「撩」的含义就完全变了。
一次注意力计算只有一组 W_Q、W_K、W_V,它学到的检索规则是固定的一套,只能沿着一个方向去找相关性。上一篇算出的那个头把 80.8% 的权重压在「刘海」上,捕到的是动宾关系,其他几层关系它看不见。
Transformer 的应对方式直接:一个头不够就多摆几个,各看各的角度,最后合起来。
2.2 多组参数矩阵并行算多个 head
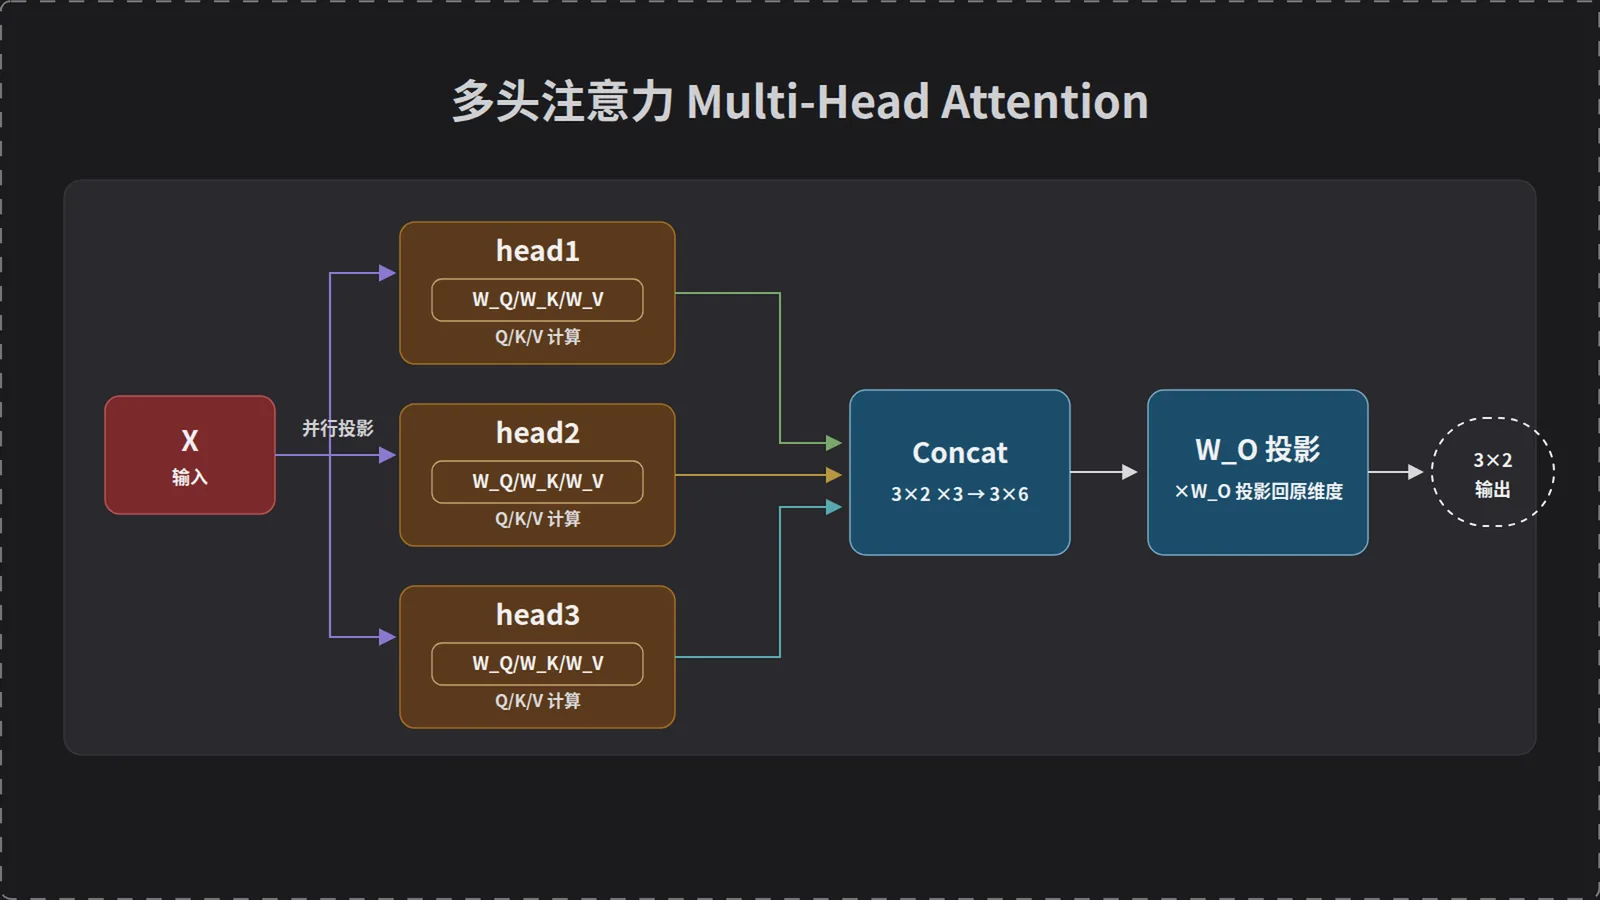
准备 h 组互相独立的 W_Q、W_K、W_V,每组各自跑一遍完整的缩放点积注意力,互不干扰。本例取 h = 3。
第一个头沿用上一篇的参数,权重矩阵和输出已经算过。另外两个头换一组随机初始化的参数,跑出来的注意力权重是这样:
head1 的 A:[[0.0551, 0.1371, 0.8078] 女生 → 80.8% 给「刘海」 [0.1000, 0.1896, 0.7105] [0.1838, 0.2518, 0.5644]] head2 的 A:[[0.3486, 0.3916, 0.2598] 女生 → 分布最平,略偏「撩」 [0.2707, 0.3464, 0.3829] [0.1593, 0.2523, 0.5884]] head3 的 A:[[0.6500, 0.2768, 0.0732] 女生 → 65% 留给自己 [0.6873, 0.2512, 0.0615] [0.7611, 0.2009, 0.0380]]同一句话,同一个 X,三个头给出三种完全不同的关注分布:一个盯住动作的对象,一个在三个 token 之间大致均摊,一个把注意力收回到词自身。这正是多头想要的效果。
三个头各自的输出:
head1 = [[1.5636, 2.5717] head2 = [[3.2351, 2.6812] head3 = [[1.2439, 2.9709] [1.6144, 2.4205] [3.3874, 2.6427] [1.2024, 2.9615] [1.6969, 2.1815]] [3.6335, 2.5836]] [1.1201, 2.9428]]2.3 Concat 拼接 + W_O 投影回原维度
三个头各是 3×2,横向拼接成 3×6:
Concat = [[1.5636, 2.5717, 3.2351, 2.6812, 1.2439, 2.9709] [1.6144, 2.4205, 3.3874, 2.6427, 1.2024, 2.9615] [1.6969, 2.1815, 3.6335, 2.5836, 1.1201, 2.9428]]维度涨到了 6,而下一层要的还是 2。补一个 6×2 的输出投影矩阵 W_O 把它压回去:
[ 0.10, 0.30] [-0.20, 0.20] [ 0.30, 0.05] [ 0.10, -0.20] [ 0.15, 0.25]]手算「女生」那一行的第 0 维:
1.5636×0.20 + 2.5717×0.10 + 3.2351×(-0.20)+ 2.6812×0.30 + 1.2439×0.10 + 2.9709×0.15 = 0.3127 + 0.2572 - 0.6470 + 0.8044 + 0.1244 + 0.4456 = 1.2973三行两列算完:
MultiHead = [[1.2973, 1.8902] [1.2447, 1.8742] [1.1594, 1.8523]]W_O 不是一个凑维度的补丁。拼接之后各头的输出还是彼此独立的六个数,W_O 让它们线性混合起来,模型才能学到「哪个角度在什么场景下更重要」。它和三组 QKV 参数一样,是训练中要更新的权重。
2.4 多头注意力公式
实际实现里每个头的维度是 d_model / h,h 个头拼起来刚好还是 d_model,总计算量和单头基本持平。多头换来的是表达能力,不是算力开销。
三、残差连接:新信息叠加在旧信息上
3.1 X' = X + MultiHead(X)
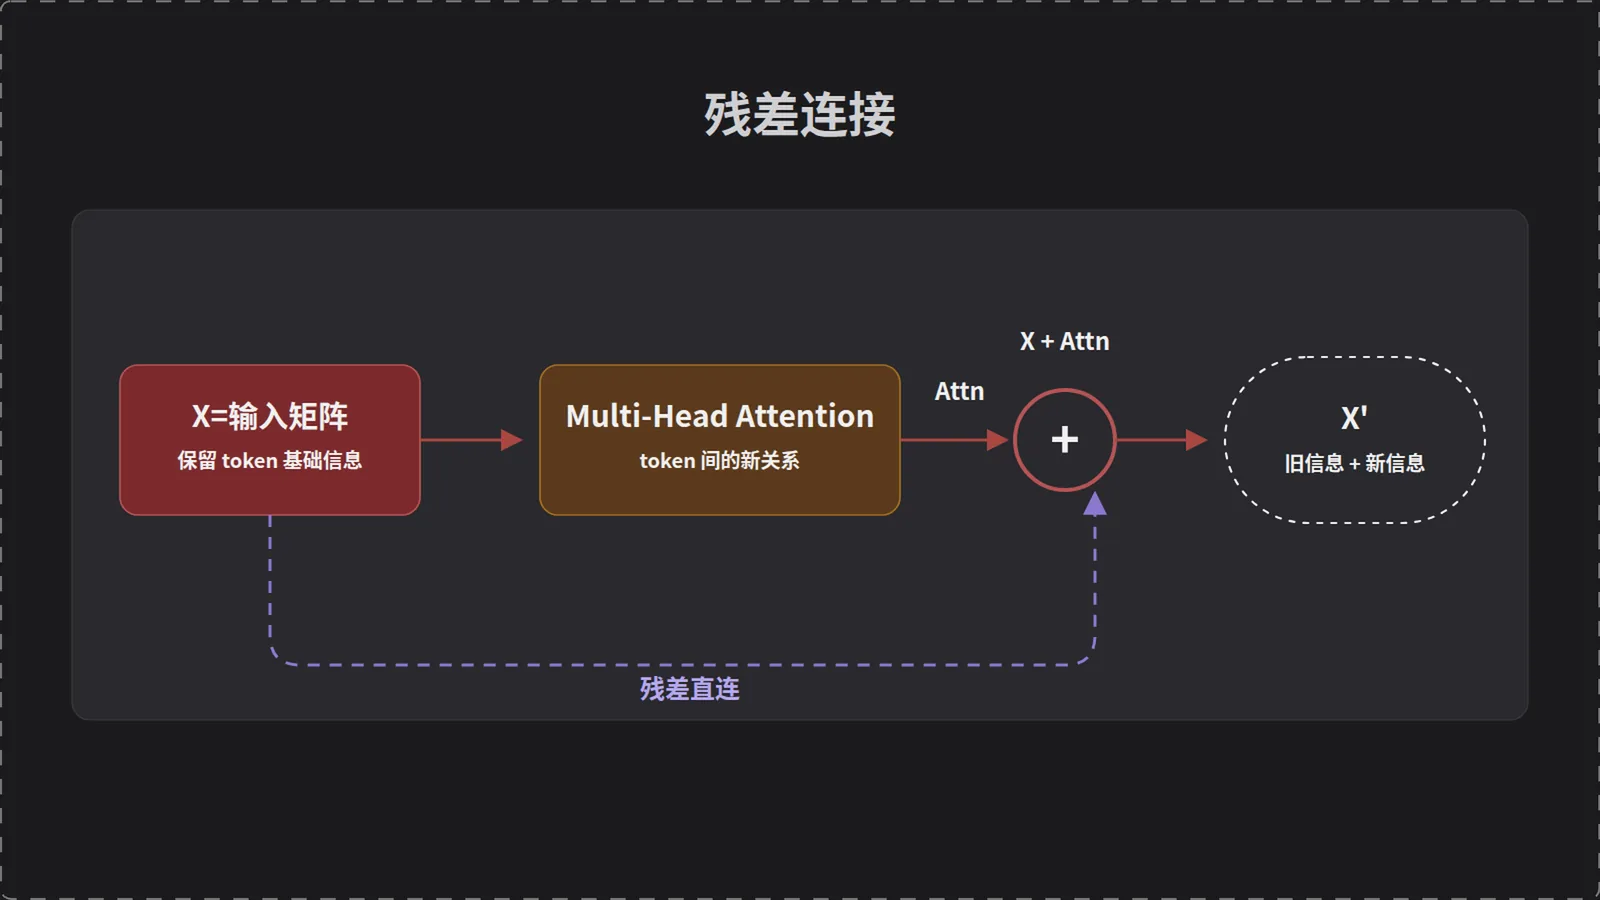
把多头的输出直接加回输入:
女生 [3.0000, 2.0000] + [1.2973, 1.8902] = [4.2973, 3.8902]撩 [2.8415, 2.5403] + [1.2447, 1.8742] = [4.0862, 4.4145]刘海 [2.9093, 3.5839] + [1.1594, 1.8523] = [4.0687, 5.4362]形状不变,仍是 3×2。
3.2 为什么不是覆盖
注意力输出携带的是 token 之间的关系,原始的 X 携带的是 token 自身的词义和位置。如果直接用注意力输出替换 X,词本身是什么就被冲掉了——「女生」这一行会变成一堆关于「它和刘海很相关」的信息,却丢了「它是一个人」。相加保住两头:底子还在,新的上下文叠上去。
学新方法不必把旧方法擦掉,这是同一个道理。
更关键的作用在训练。残差给梯度开了一条直通的路:反向传播时,梯度可以绕过注意力子层原样传回去,不必逐层穿过一串矩阵乘法被反复缩放。没有这条路,几十层叠上去梯度就消失了,Transformer 也就堆不深。
四、层归一化:把数值拉回稳定区间
4.1 残差之后数值分布失衡
看残差之后的三行:第一行两个数都在 4 附近,第三行一个 4.07 一个 5.44。不同 token、不同维度上的数值量级已经开始散开,再往上叠十几层,有的通道会持续放大,有的持续缩小。后面的激活函数和 softmax 都对输入量级敏感,量级失控直接拖垮训练。
层归一化把每个 token 向量单独拉回标准区间:均值 0,方差 1。它只在一行内部做统计,和别的 token 无关,也和 batch 无关——这是它比 BatchNorm 更适合变长序列的原因。
4.2 三步手算:均值、方差与标准差、归一化
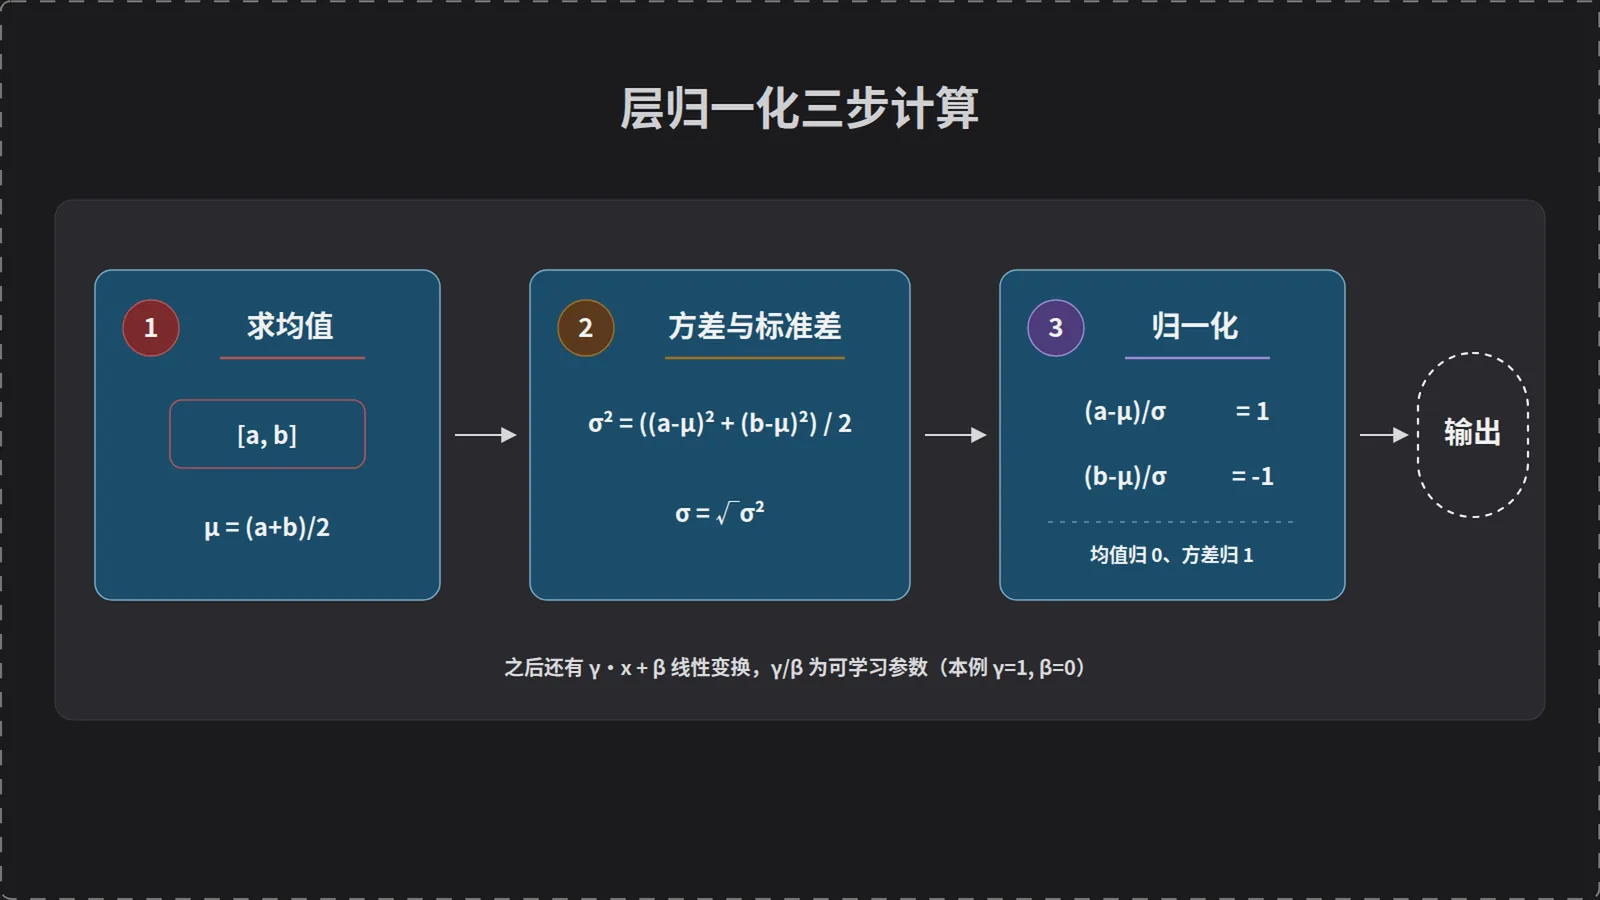
拿残差后的第一行 [4.2973, 3.8902]。
第一步,均值:
μ = (4.2973 + 3.8902) / 2 = 4.0937第二步,方差与标准差。方差是每个数减均值再平方,求和后除以个数:
偏差:4.2973 - 4.0937 = 0.2035 3.8902 - 4.0937 = -0.2035σ² = (0.2035² + (-0.2035)²) / 2 = 0.0414σ = √0.0414 = 0.2035第三步,每个数减均值除以标准差:
(4.2973 - 4.0937) / 0.2035 = 1(3.8902 - 4.0937) / 0.2035 = -1三行都做一遍:
X' = [[ 1, -1] μ=4.0937 σ=0.2035 [-1, 1] μ=4.2504 σ=0.1641 [-1, 1]] μ=4.7524 σ=0.6838三行的原始量级差了三倍多,归一化之后回到同一个尺度,只剩下方向信息。
4.3 γ 与 β:归一化之后的线性变换
标准化不是最后一步。LayerNorm 完整的公式是:
LayerNorm(x) = γ · (x - μ) / √(σ² + ε) + βγ 和 β 是与向量维度等长的可学参数,训练中和其他权重一起更新。强行把每一层的输出都摁成均值 0、方差 1,会剥夺模型调整分布的自由;γ 和 β 把这份自由还回去——需要的话,模型可以学着把分布重新拉宽或者平移,极端情况下甚至学回原样。ε 是一个很小的常数(通常 1e-5),防止方差为零时除零。
本例取 γ = 1、β = 0,上面的结果不变。
4.4 维度为 2 时结果必为 ±1
上面三行归一化后全是 1 和 -1,这不是巧合。d = 2 时设两个数为 a 和 b:
μ = (a+b)/2偏差 = ±(a-b)/2σ² = ((a-b)/2)² , σ = |a-b|/2归一化 = ±(a-b)/2 ÷ |a-b|/2 = ±1只要 a ≠ b,结果一定是一个 +1 一个 -1,跟具体数值无关。真实模型里 d 是几百上千,归一化后是一组分布在 0 附近的小数,信息不会像这样被压没。这里出现整齐的 ±1,纯粹是把维度砍到 2 的副作用。
五、前馈神经网络:每个 token 独立思考
5.1 注意力是开会,FFN 是回到工位
注意力做的是 token 之间的信息交换,每个 token 从别人那里取信息,但取回来之后并没有对这些信息做什么加工——A·V 是一次加权平均,是线性的。
FFN 补的就是这一步:会开完了,各自回到工位,把刚才收集到的东西在自己的向量里做一次非线性变换。它对每一行独立作用,不跨 token,参数在所有位置上共享。
Transformer 的参数量大头也在这里。注意力负责路由信息,FFN 负责存储和加工知识。
5.2 公式:两次线性变换 + ReLU
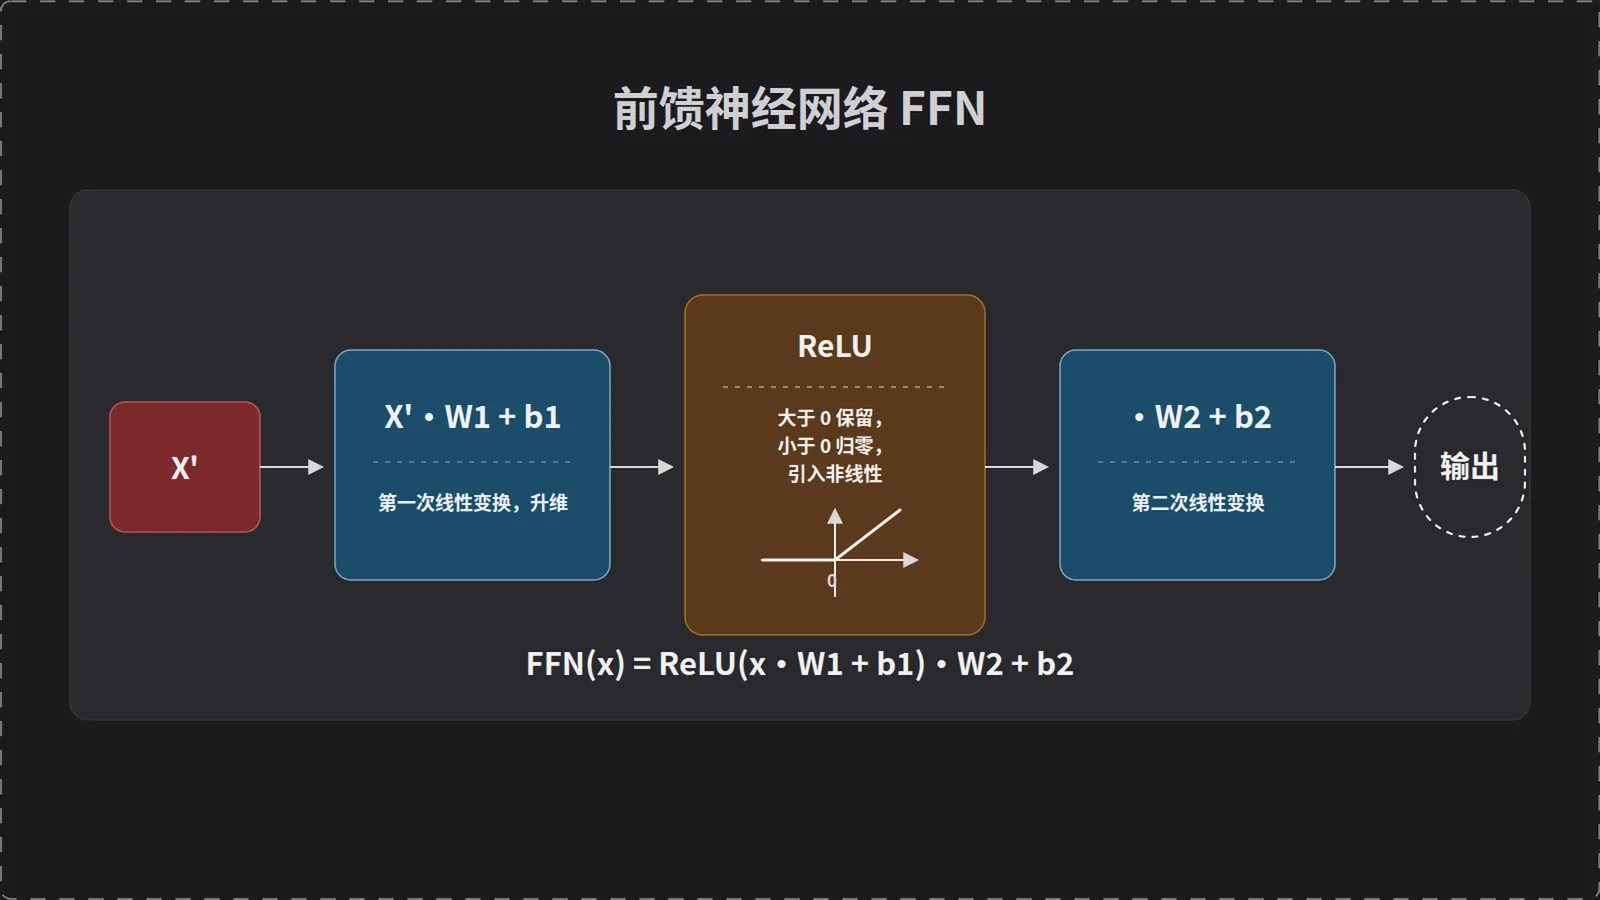
FFN(x) = ReLU(x·W₁ + b₁)·W₂ + b₂W₁ 把维度升上去,W₂ 再降回来。原论文里 d_model = 512、中间层 2048,四倍放大;本例把中间层取成 4:
W₁ = [[0.9, -0.7, 0.4, 1.2] b₁ = [0.1, 0.2, -0.3, 0.0] [0.5, 0.8, -1.1, 0.3]] W₂ = [[ 0.6, -0.4] b₂ = [0.05, -0.10] [ 0.2, 0.9] [-0.5, 0.3] [ 0.7, 0.5]]5.3 计算整合
拿归一化后的第一行 x = [1, -1]。
第一次线性变换:
x·W₁ = [1×0.9 + (-1)×0.5, 1×(-0.7) + (-1)×0.8, 1×0.4 + (-1)×(-1.1), 1×1.2 + (-1)×0.3] = [0.4, -1.5, 1.5, 0.9] 加 b₁ → [0.5, -1.3, 1.2, 0.9]过 ReLU,大于 0 的原样保留,小于 0 的直接归零:
ReLU([0.5, -1.3, 1.2, 0.9]) = [0.5, 0, 1.2, 0.9]-1.3 被切掉了。这个截断就是非线性的来源:没有它,两次矩阵乘法可以合并成一次,四维中间层白升,整个 FFN 退化成一个 2×2 的线性变换,加不加没区别。
第二次线性变换:
第 0 维:0.5×0.6 + 0×0.2 + 1.2×(-0.5) + 0.9×0.7 = 0.33第 1 维:0.5×(-0.4) + 0×0.9 + 1.2×0.3 + 0.9×0.5 = 0.61加 b₂ → [0.38, 0.51]三行都算完:
FFN(X') = [[0.38, 0.51] [0.39, 1.43] [0.39, 1.43]]后两行完全一样,因为归一化把它们都压成了 [-1, 1]。这依然是 d = 2 的后遗症。
六、第二次残差与归一化:一层的收尾
6.1 两次残差保护不同阶段的信息
FFN 的输出同样不覆盖,而是加回它的输入:
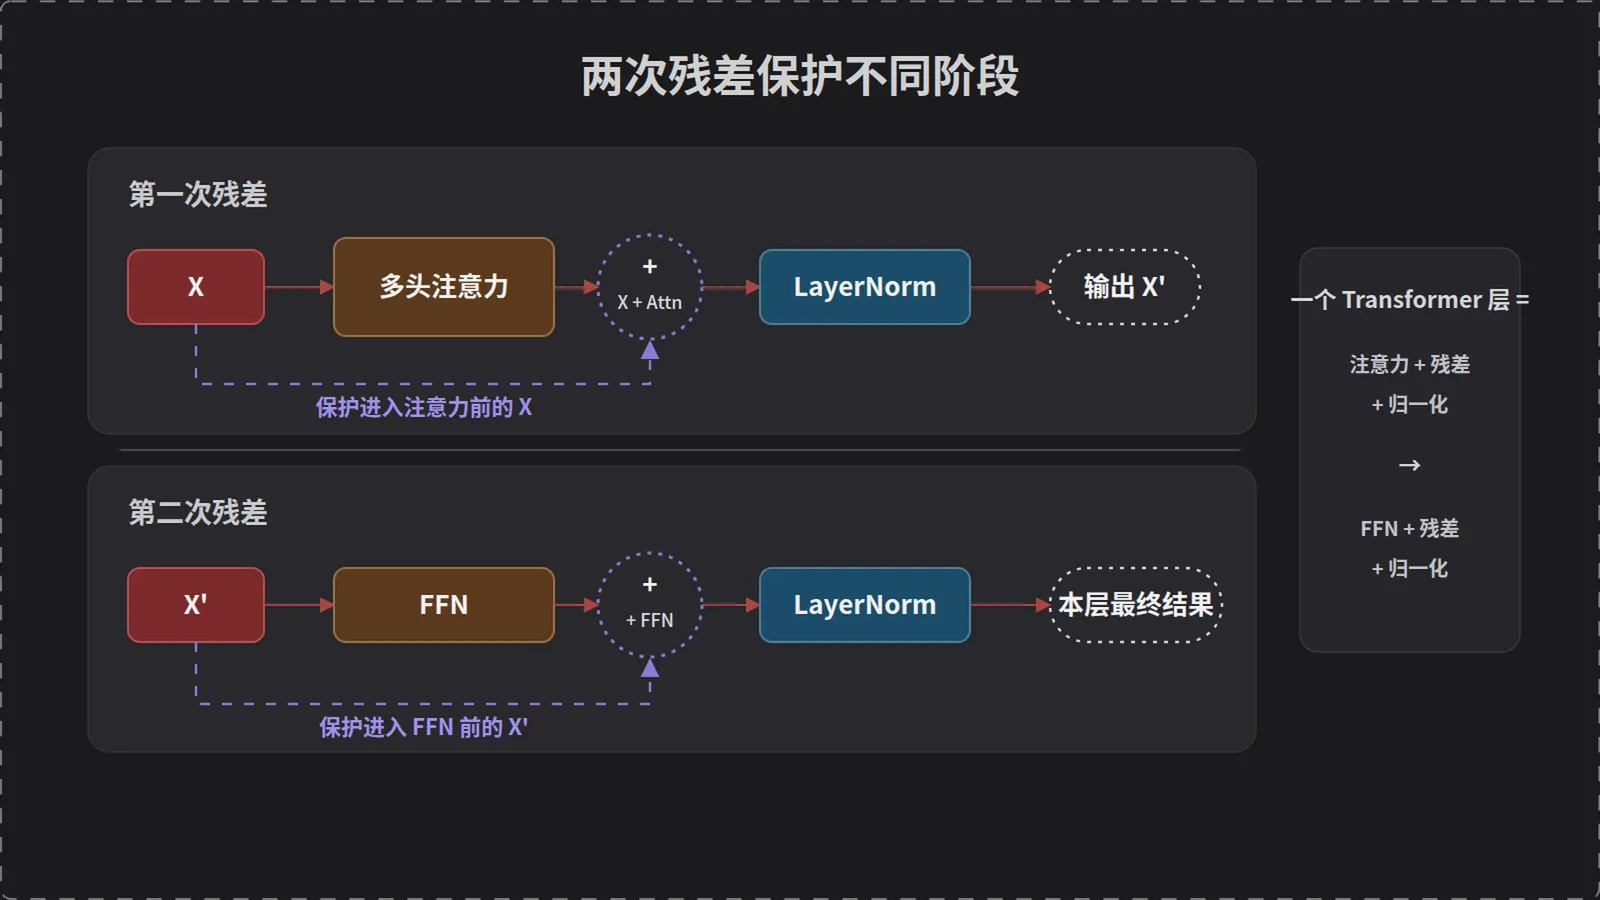
女生 [ 1, -1] + [0.38, 0.51] = [ 1.38, -0.49]撩 [-1, 1] + [0.39, 1.43] = [-0.61, 2.43]刘海 [-1, 1] + [0.39, 1.43] = [-0.61, 2.43]两次残差保护的不是同一份东西。第一次接在注意力后面,护住的是进注意力之前的 X,也就是纯粹的词义加位置;第二次接在 FFN 后面,护住的是进 FFN 之前的 X',也就是已经完成上下文交换的表示。每个子层都被包成「原样通过 + 增量修正」的形式,子层学到的是修正量,不是全新的表示。
再做一次层归一化:
第一行:μ = (1.38 - 0.49)/2 = 0.445,σ = 0.935 → [ 1, -1]第二行:μ = (-0.61 + 2.43)/2 = 0.910,σ = 1.520 → [-1, 1]第三行:同上 → [-1, 1]这一层的最终输出:
Output = [[ 1, -1] [-1, 1] [-1, 1]]形状还是 3×2,和输入 X 完全一致。所以这一层可以原样再叠一遍,叠 12 层、48 层都行。
6.2 一个完整 Transformer 层的结构
X ├──────────────────────────┐ ↓ │多头注意力 │ ↓ │ (+) ←──────────────────────┘ 残差 ↓LayerNorm ↓ X' ├──────────────────────────┐ ↓ │前馈网络 FFN │ ↓ │ (+) ←──────────────────────┘ 第二次残差 ↓LayerNorm ↓Output四个组件,各管一件事:多头注意力负责 token 之间交换信息,残差负责保住旧信息并让梯度通得到底,LayerNorm 负责把数值分布摁在稳定区间,FFN 负责每个 token 独立做非线性加工。
七、最小实现Demo
下面这段代码把前六节的数字完整跑一遍
import numpy as np # 只依赖 numpy,不用任何深度学习框架 # ========== 上一篇算出来的输入矩阵:词嵌入 + 位置编码 ==========X = np.array([[3.0000, 2.0000], # 女生 [2.8415, 2.5403], # 撩 [2.9093, 3.5839]]) # 刘海d_model = X.shape[1] # 模型维度,本例为 2n_heads = 3 # 注意力头的个数 # ========== 基础算子 ==========def softmax(scores): # 按行做 softmax m = scores.max(axis=1, keepdims=True) # 取每行最大值 e = np.exp(scores - m) # 减最大值再取指数,防止 e^x 溢出,结果不变 return e / e.sum(axis=1, keepdims=True) # 除以行和,每行归一化成和为 1 的权重 def relu(x): # ReLU 激活函数 return np.maximum(x, 0.0) # 大于 0 的保留,小于 0 的置零,引入非线性 def layer_norm(x, gamma, beta, eps=1e-9): # 层归一化,逐行独立计算 mu = x.mean(axis=1, keepdims=True) # 每行的均值 μ var = x.var(axis=1, keepdims=True) # 每行的方差 σ² x_hat = (x - mu) / np.sqrt(var + eps) # 标准化:均值拉到 0,方差拉到 1 return gamma * x_hat + beta # 再做可学的缩放 γ 与平移 β # ========== 缩放点积注意力:单个头 ==========def attention(X, W_Q, W_K, W_V): # 一个注意力头的完整计算 Q = X @ W_Q # Q:每个 token 想找什么信息 K = X @ W_K # K:每个 token 自己带着什么信息 V = X @ W_V # V:每个 token 实际要传出去的内容 d_k = K.shape[1] # 键向量的维度 S = (Q @ K.T) / np.sqrt(d_k) # 点积打分再除以 √d_k,避免 softmax 饱和 A = softmax(S) # 分数转成每行和为 1 的注意力权重 return A, A @ V # 返回权重矩阵和加权求和的结果 # ========== 三个头各自的参数矩阵(训练前随机初始化) ==========head_params = [ (np.array([[-0.6, 0.9], [0.8, -0.5]]), # head1 的 W_Q np.array([[0.6, 0.1], [-0.1, 1.4]]), # head1 的 W_K np.array([[1.0, -0.5], [-0.4, 1.2]])), # head1 的 W_V,与上一篇一致 (np.array([[0.8, 1.0], [-1.2, -0.5]]), # head2 的 W_Q np.array([[-0.6, -1.2], [-0.7, -0.2]]), # head2 的 W_K np.array([[0.3, 1.1], [0.9, -0.2]])), # head2 的 W_V (np.array([[-0.9, 0.3], [1.1, -1.3]]), # head3 的 W_Q np.array([[0.3, -0.8], [0.7, 0.9]]), # head3 的 W_K np.array([[-0.5, 0.7], [1.2, 0.4]])), # head3 的 W_V] W_O = np.array([[0.20, -0.10], # 输出投影矩阵 W_O,把拼接后的 6 维压回 2 维 [0.10, 0.30], [-0.20, 0.20], [0.30, 0.05], [0.10, -0.20], [0.15, 0.25]]) def multi_head_attention(X, head_params, W_O): # 多头注意力 heads, weights = [], [] # 分别收集每个头的输出和注意力权重 for W_Q, W_K, W_V in head_params: # 逐个头计算,各头之间互不干扰 A, head = attention(X, W_Q, W_K, W_V) # 该头的注意力权重与输出 weights.append(A) # 记下权重,便于观察各头关注点 heads.append(head) # 记下输出,稍后拼接 concat = np.concatenate(heads, axis=1) # 沿维度方向横向拼接,3×2 × 3 → 3×6 return weights, concat, concat @ W_O # 乘 W_O 混合各头信息并投影回 3×2 # ========== 前馈网络的参数 ==========W1 = np.array([[0.9, -0.7, 0.4, 1.2], # 第一次线性变换,把 2 维升到 4 维 [0.5, 0.8, -1.1, 0.3]])b1 = np.array([0.1, 0.2, -0.3, 0.0]) # 第一次线性变换的偏置W2 = np.array([[0.6, -0.4], # 第二次线性变换,把 4 维降回 2 维 [0.2, 0.9], [-0.5, 0.3], [0.7, 0.5]])b2 = np.array([0.05, -0.10]) # 第二次线性变换的偏置 def feed_forward(x, W1, b1, W2, b2): # 前馈网络,对每一行独立作用 return relu(x @ W1 + b1) @ W2 + b2 # 升维 → ReLU → 降维 # ========== 一个完整的 Transformer Encoder 层 ==========gamma = np.ones(d_model) # LayerNorm 的缩放参数,本例取全 1beta = np.zeros(d_model) # LayerNorm 的平移参数,本例取全 0 def encoder_layer(X): # 完整一层:注意力 → 残差 → 归一化 → FFN → 残差 → 归一化 weights, concat, mha = multi_head_attention(X, head_params, W_O) # 多头注意力输出 residual1 = X + mha # 第一次残差:保住进注意力之前的 X X1 = layer_norm(residual1, gamma, beta) # 第一次层归一化,逐行拉成均值 0 方差 1 ffn = feed_forward(X1, W1, b1, W2, b2) # 每个 token 独立过前馈网络 residual2 = X1 + ffn # 第二次残差:保住进 FFN 之前的 X1 out = layer_norm(residual2, gamma, beta) # 第二次层归一化,得到这一层的最终输出 return weights, concat, mha, residual1, X1, ffn, residual2, out weights, concat, mha, r1, X1, ffn, r2, out = encoder_layer(X) # 跑一遍完整的一层 np.set_printoptions(precision=4, suppress=True) # 打印保留 4 位小数,关掉科学计数法for i, A in enumerate(weights): # 逐个打印每个头的注意力权重 print(f"head{i + 1} 的注意力权重 A =\n{A}\n")for name, mat in [("Concat", concat), ("MultiHead", mha), # 依次打印每一步的中间矩阵 ("X + MultiHead", r1), ("LayerNorm1", X1), ("FFN", ffn), ("X1 + FFN", r2), ("Output", out)]: print(f"{name} =\n{mat}\n") # 输出与正文里手算的数字一致代码里 LayerNorm 的 ε 取了 1e-9,为的是让打印结果和正文计算相匹配;真实实现通常用 1e-5 或 1e-6。
一层跑完,「女生」这个 token 从最初的 [3, 2] 变成了 [1, -1]:它先在三个角度上和另外两个 token 交换了信息,又保留了自己的底子,做过一次非线性加工,最后被拉回标准分布。堆到第二层,它会带着这份表示继续和上下文交互。编码器就是这样一层一层把上下文卷进每个 token 里的。
本文由 AgentPlanFlow 生成