
文章内容
- 一、大模型是一台「预测下一个词」的机器
- 二、输入端:文字怎样变成数字
- 2.1 Token 与向量
- 2.2 从 word2vec 到端到端嵌入
- 三、骨架:FFN 前馈神经网络
- 3.1 从每个位置到下一个 Token
- 四、注意力机制
- 4.1 加权汇集上下文
- 4.2 多头注意力
- 五、Transformer 全流程
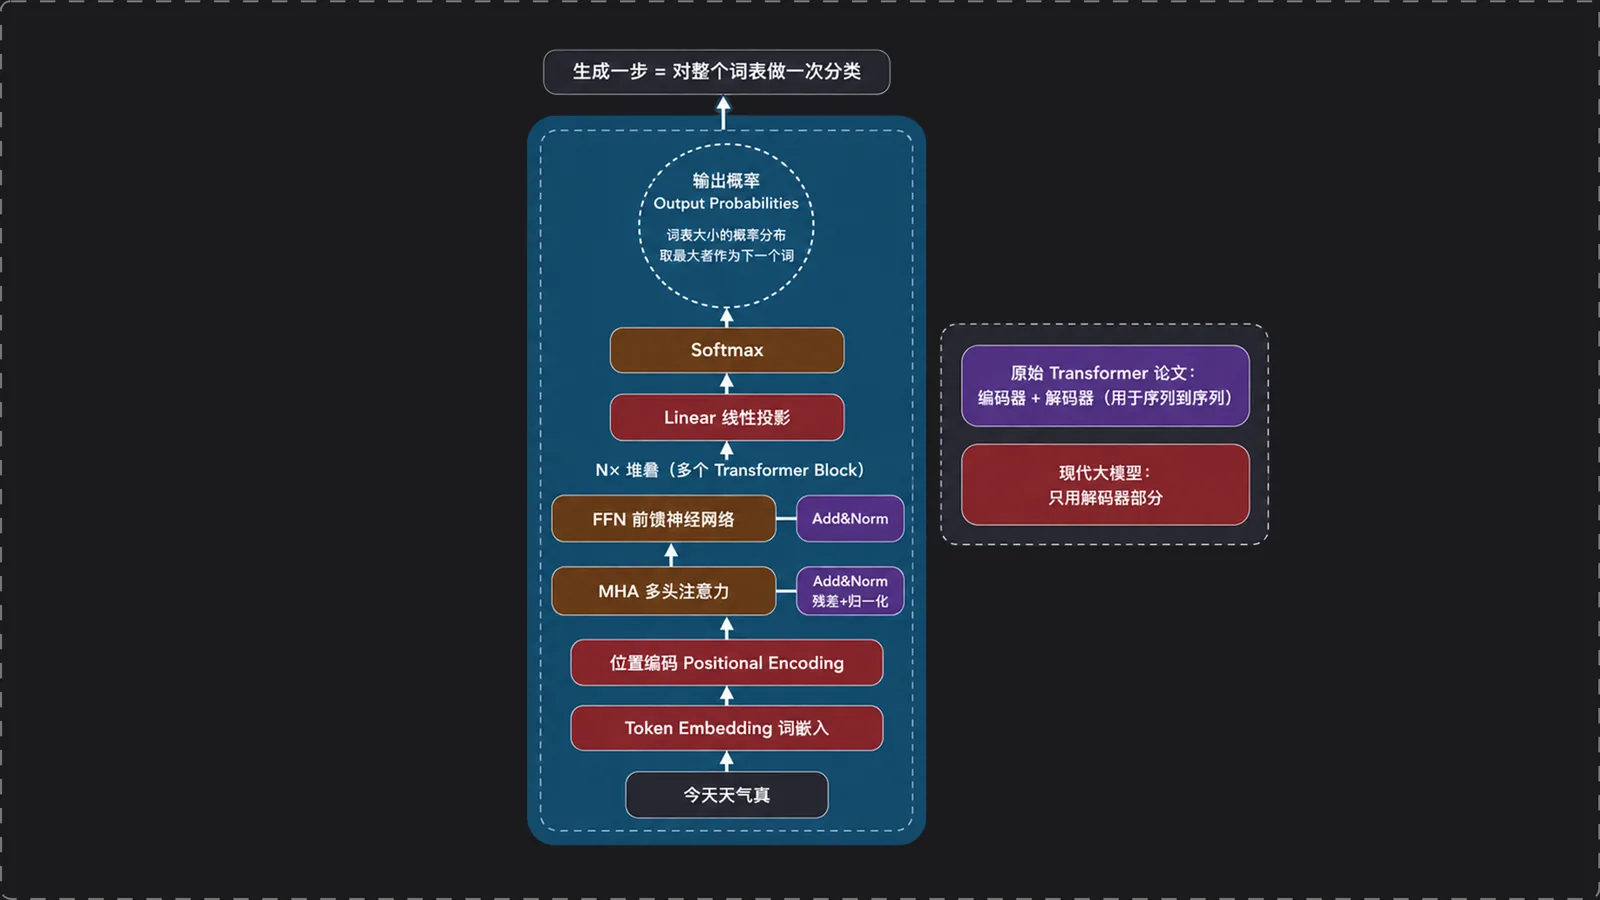
- 5.1 Block 里有什么
- 5.2 生成路径示例
- 六、大模型是怎么训练出来的
- 6.1 自监督预训练
- 6.2 后训练与推理过程
- 七、从 LLM 到 Agent:让接龙进入软件系统
- 7.1 Context、Memory 与检索
- 7.2 Function Calling 与 MCP
- 八、架构演进
- 8.1 位置、归一化与残差
- 8.2 FFN 变成 MoE
- 8.3 Attention 的三条改造路线
- 九、三个定律与未完成的方向
- 十、小结
视频素材:[【闪客】一小时从 Transformer 到大模型!]
一、大模型是一台「预测下一个词」的机器
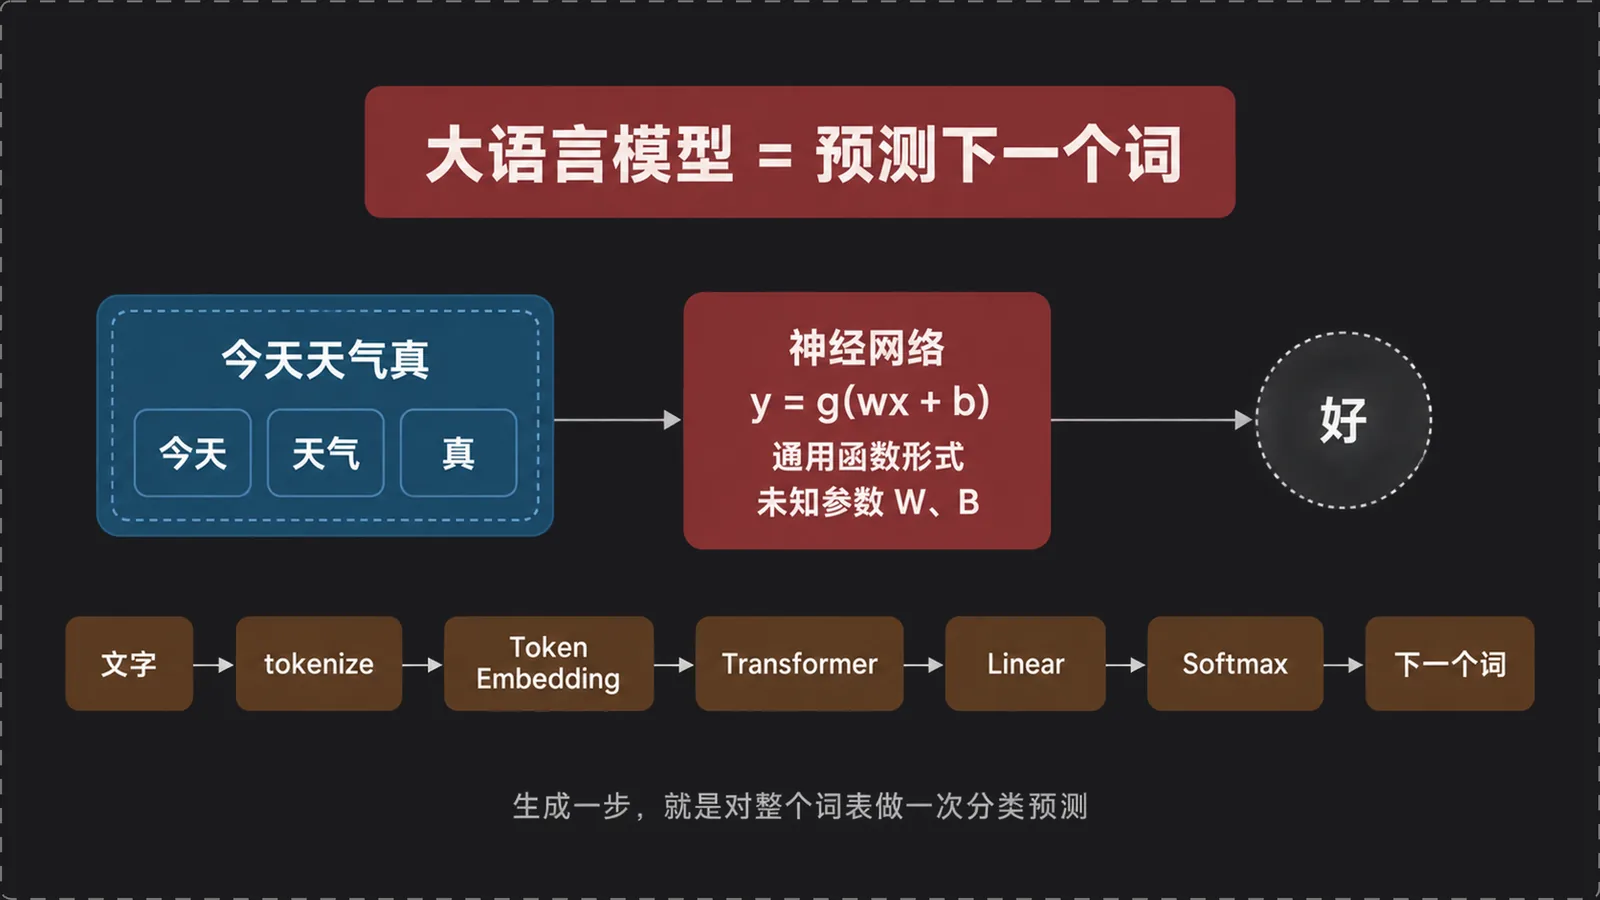
给定一串文字,求下一个词,可以写成一个函数:f(多个词) → 下一个词。输入“飞天闪”,期望输出“客”;输入“今天天气真”,候选答案可能是“好”。大语言模型反复执行的就是这个计算。对话、翻译和写代码的形式看起来差别明显,但模型生成时都会从词表中选择下一个 Token,然后把新 Token 接回输入,继续预测。
神经网络为这个未知函数提供了可训练的表示。单个神经元可以记作 y = g(wx + b):输入 x 经过权重 w 和偏置 b 的线性变换,再通过非线性函数 g。足够多的神经元和层在给定范围内可以逼近复杂函数。训练数据提供已知的 (X, Y),训练过程调整参数 W、B,让模型的输出逐渐接近 Y。大模型没有改变这个计算框架,只把参数、数据和计算量推到了巨大规模。
输出的文本不能直接参与矩阵运算,因此模型在输入端和输出端各做一次转换。输入时,分词器把文本切成 Token,嵌入层再把 Token 映射为向量;输出时,线性层产生一个与词表等长的数值向量。若编号 98 对应“好”,而第 98 个位置的分数最高,输出端就把它还原成“好”。从这个接口看,每步生成都会对整个词表做一次分类预测。
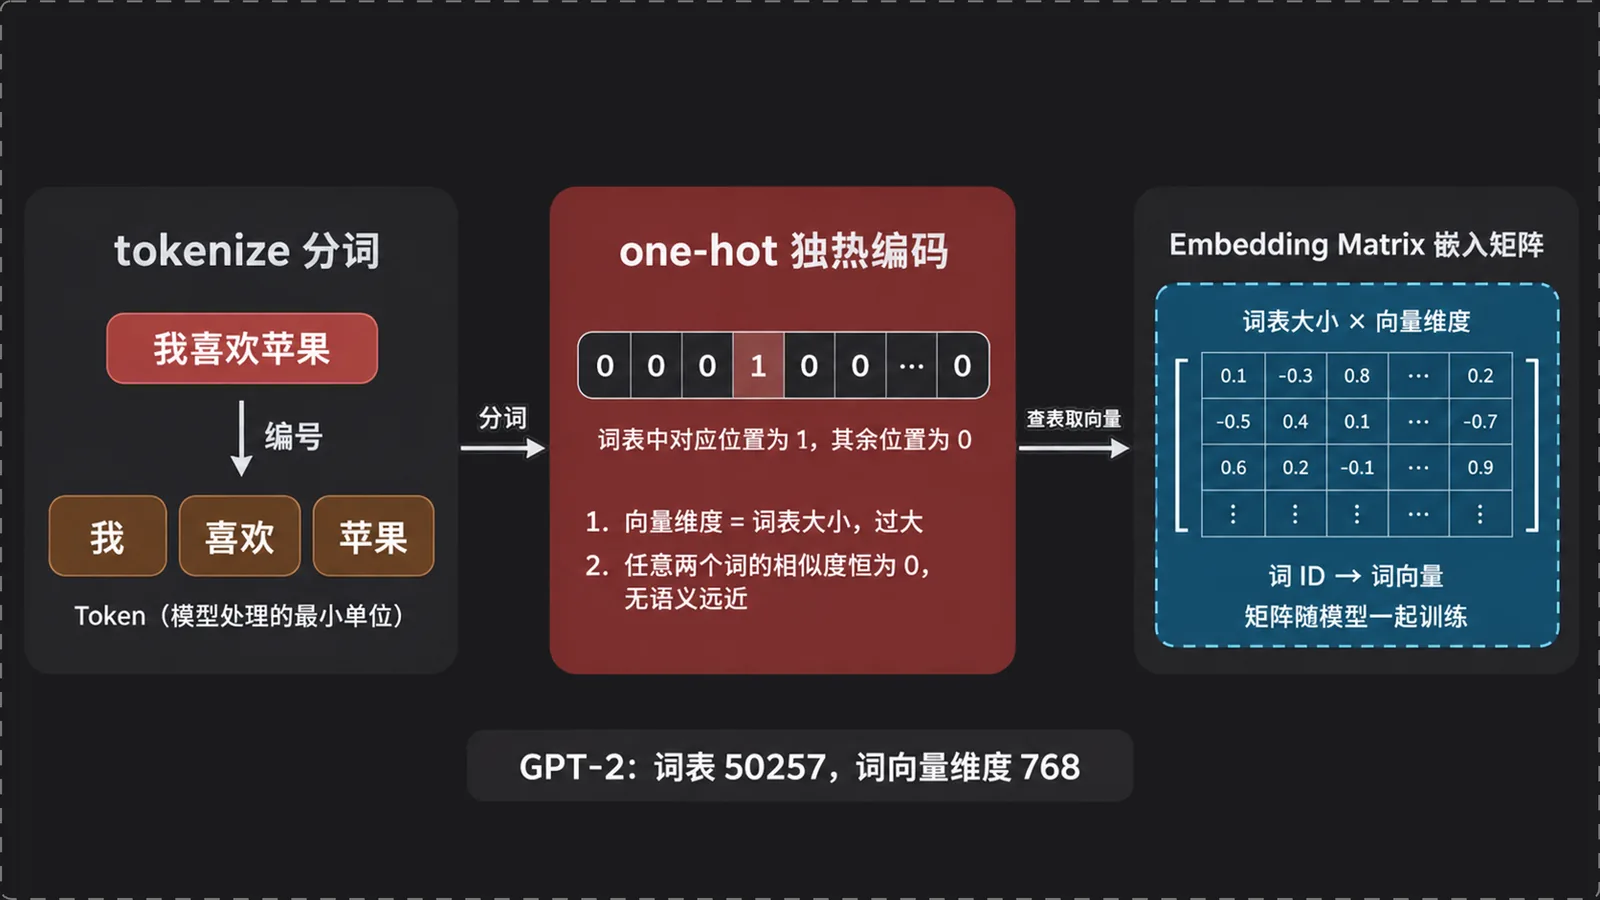
GPT-2 参数:词向量维度是 768,FFN 的隐藏层宽度是 3072,最终线性层输出 50257 个分数,对应 50257 个词表项。后来的模型继续放大了这些数字,也替换了若干部件,但目标函数仍然是预测下一个 Token。
二、输入端:文字怎样变成数字
2.1 Token 与向量
给每个词分配一个整数编号,只解决了存储问题。编号 10 和编号 11 在数轴上相邻,不代表两个词的语义相近;一维空间也难以把多种语义关系分开。数据映射到更高维空间后,分类边界可以沿更多维度划分。二维平面上用一条直线就能分开的点,在一维数轴上可能交错,这就是升维带来表达能力的直观来源。模型内部还会反复升维和降维,用空间换取计算能力,再把结果压回规定宽度。
升维之外还要解决“每一维具体表示什么”的问题。一种直觉做法是给向量的每个维度人为指定语义,比如某一维表示“食物属性”:“苹果”在这一维取值高,“喜欢”接近零,“我”也不高。词表很小时这种做法勉强可行,但词义包含的维度太多、太抽象,没有人能给几万个词逐一设计并填好每一维的数值,人工特征工程的路走不通。one-hot 编码正是在放弃“人工定义每一维含义”之后的一种极端简化:不再设计任何语义维度,直接让向量维度等于词表大小,每个词只在自己的编号位置取 1。
Token 是模型处理的文字单元,tokenize 是切分过程。“我喜欢苹果”可能被切成“我 / 喜欢 / 苹果”,也可能按更细的子词切分,具体边界由分词器和词表决定。Token 取得编号后,最朴素的表示是 one-hot:词表中对应位置为 1,其余位置为 0。它有两个明显限制。向量维度等于词表大小,绝大多数位置为空;任意两个不同 Token 的点积都为 0,无法表示语义的远近。
2.2 从 word2vec 到端到端嵌入
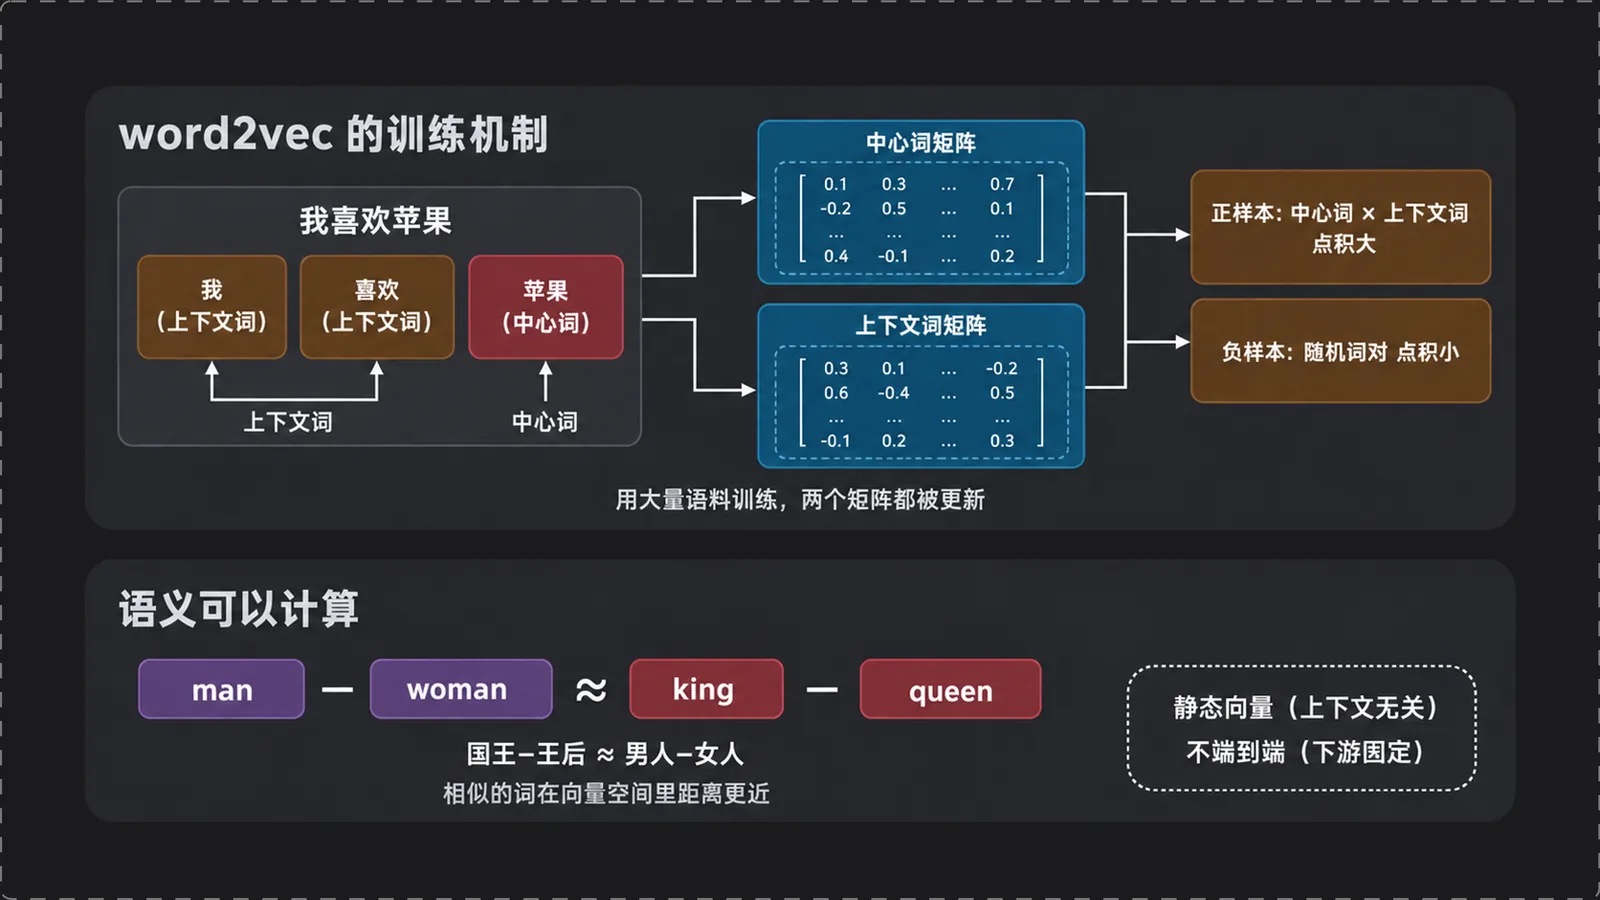
word2vec 让向量从文本共现关系中学习。训练时维护中心词矩阵和上下文词矩阵,希望中心词与真实上下文词的点积较大,与负样本的点积较小。训练后的空间会出现可计算的语义方向,例如 man − woman ≈ king − queen。词义通过周围词的使用方式映射为数值表示。
这套方法仍有边界。同一个词通常对应一份静态向量,在不同语境下保持不变;词向量训练与下游模型训练彼此分开,不能针对最终任务共同调整。现代大模型把嵌入矩阵放进整个网络,先随机初始化,再与注意力、FFN 等参数一起更新。初始向量没有预设含义,训练数据逐步塑造它们。
PyTorch 的 Embedding 层把 Token 编号映射到可训练向量。下面的矩阵形状是 50257 × 768,正好对应 GPT-2 的词表和词向量宽度;这段代码说明嵌入层就是模型参数的一部分。
# 导入 PyTorch 的神经网络模块并命名为 nnimport torch.nn as nn # 设置词表大小,GPT-2 使用 50257 个词表项vocab_size = 50257# 设置词向量维度,GPT-2 使用 768 维向量embedding_dim = 768# 创建可训练的嵌入矩阵embedding_matrix = nn.Embedding( # 传入词表大小 vocab_size, # 传入词向量维度 embedding_dim# 完成嵌入层初始化)三、骨架:FFN 前馈神经网络
3.1 从每个位置到下一个 Token
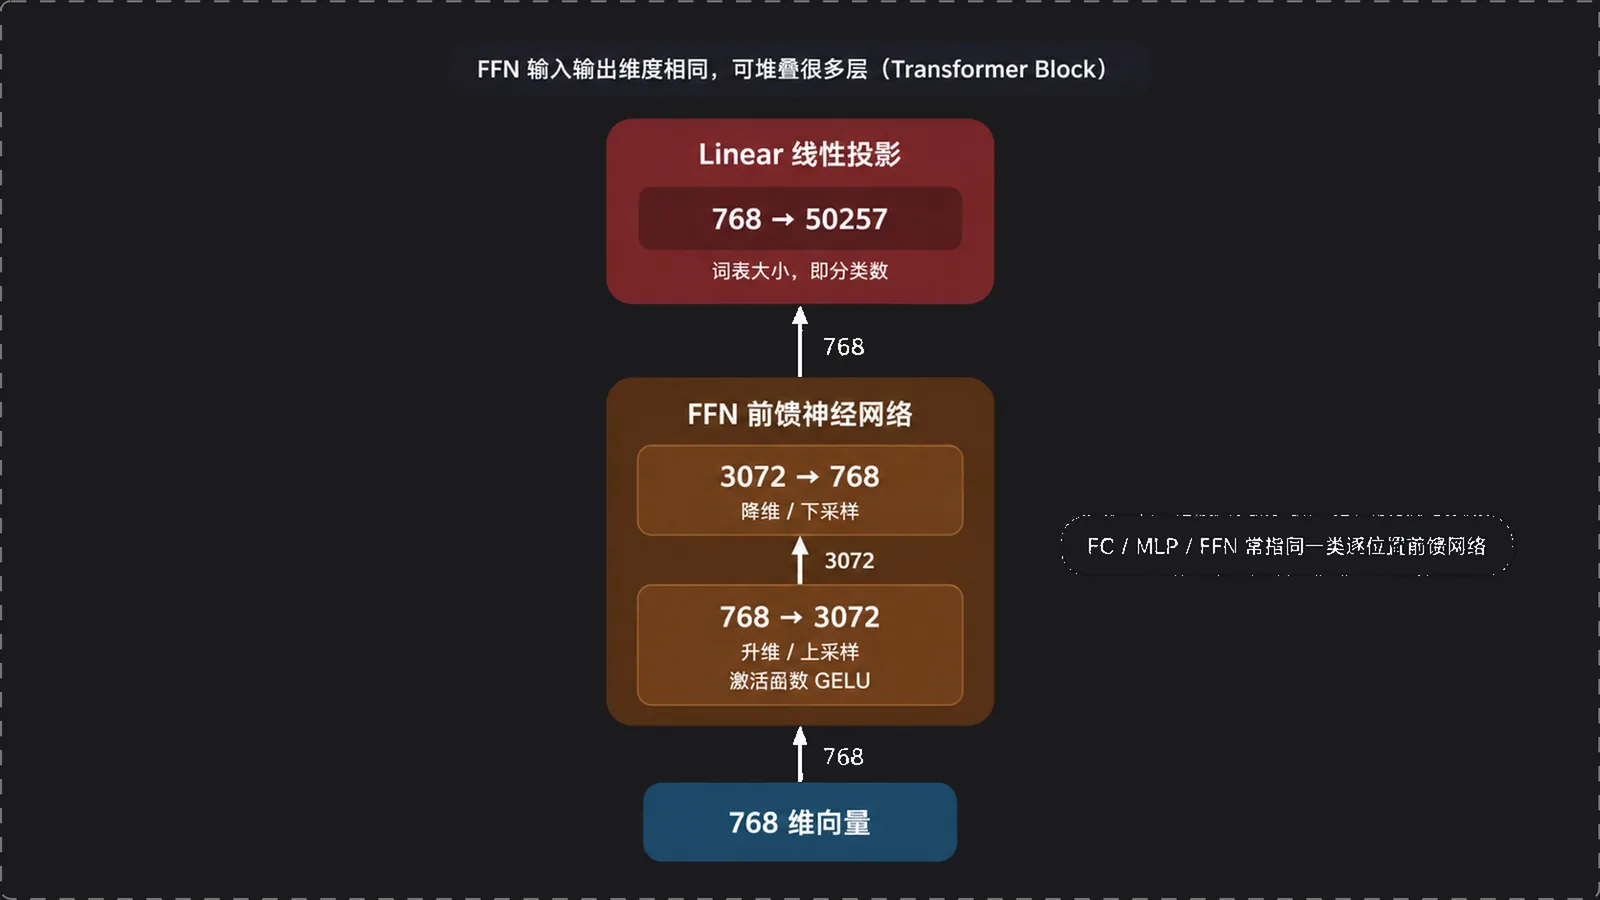
序列进入模型后,每个位置都可以产生一个词表大小的输出向量。训练阶段,每个位置预测紧随其后的 Token,各位置的损失可以并行计算;生成阶段则读取最后一个位置的结果。GPT-2 的最终线性层把 768 维隐藏状态投影成 50257 维 logits,这一层通常称为 Linear 或线性投影(Projection)。输出神经元数量等于分类数量,更换词表时需同步调整该层的输出维度。
Transformer Block 内部的 FFN 处理每个位置上的向量。以 GPT-2 为例,它先用 FC 把 768 维输入升到 3072 维,经过 GELU 激活,再由另一个 FC 降回 768 维。整个模块常称为 MLP 或 FFN,具体结构可能不同。升维给非线性变换提供更多中间特征,降维让输入输出宽度保持一致,多个 Block 因而能够继续堆叠。
FFN 的计算在各位置独立进行。无论堆叠多少层,某个位置若始终无法取得其他位置的信息,它就不能结合“今天天气真”里的“天气”来调整后续候选词。生成候选词之前,网络需要先取得与当前预测有关的上下文。
四、注意力机制
4.1 加权汇集上下文
最粗略的上下文汇集方法,是把前面所有词向量相加。这样能把其他位置的信息送到当前位置,却把各词视为同等重要。更合理的计算是加权求和,例如 0.1 × 今天 + 0.2 × 天气 + 0.7 × 真。权重随当前查询和上下文内容变化,模型才能在不同句子里关注不同位置。
向量点积可以衡量两个方向的相似程度。注意力没有直接拿同一份词向量既查询又匹配,而是通过三个可训练矩阵 Wq、Wk、Wv 生成 Query、Key 和 Value。Q 表示当前位置要寻找什么,K 表示各位置能与哪些查询匹配,Q 与 K 的点积形成相关性分数;Softmax 把分数变成权重,再对 V 加权求和。三个投影都是不带激活函数的线性层,但训练会让它们承担不同职责。
因果语言模型需要使用 mask,遮蔽当前位置之后的 Token。若不加 mask,训练时模型会看到需要预测的后续答案,生成阶段却没有这些信息,训练目标便失去了意义。
4.2 多头注意力
一组 QKV 在一套投影空间中计算相关性。Multi-Head Attention(MHA)把 Q、K、V 分成多组,每组独立计算注意力,再拼接各组结果并做一次输出投影。不同头可以学习不同关系,这种分工由训练形成,没有人工规定某个头必须处理语法或指代。
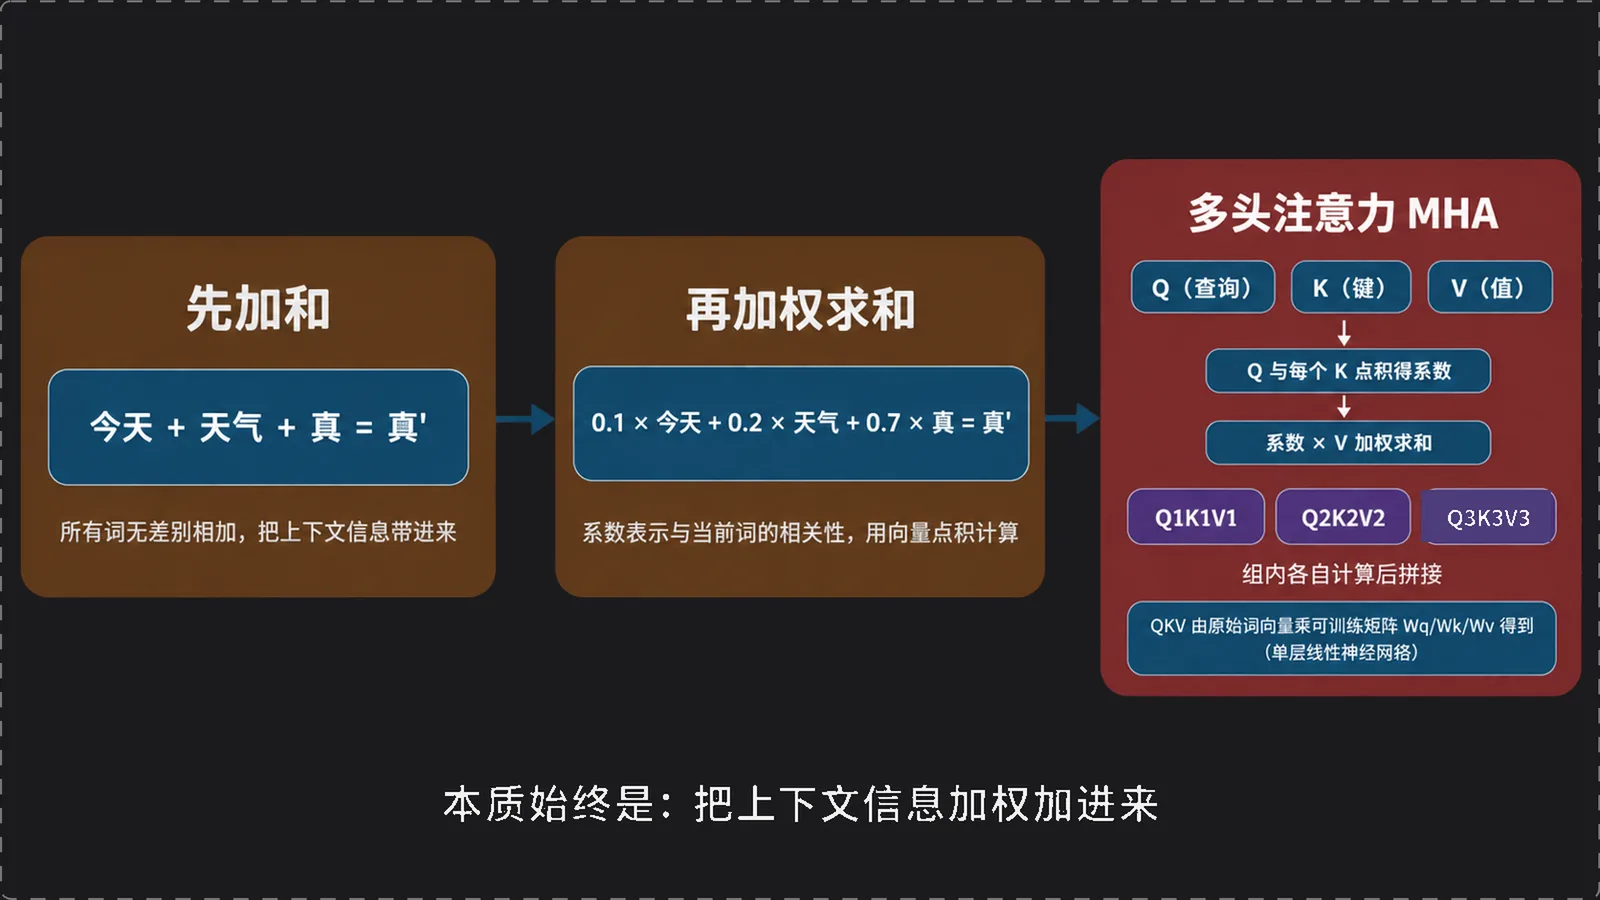
多头注意力可以同时处理 batch、序列位置和注意力头三个维度。这里保留视频所引 JAX/Flax 官方教程「Multi-head attention (Batched)」示例的写法,用 einsum 显式标出各维度,读者可以逐个下标核对张量形状;
# 维度约定:b 批量,n 查询序列长度,m 键值序列长度,h 头数,q/k/v 各向量维度# 定义批量多头注意力函数;X 是查询序列,Mk 是键值序列,P 系列是可训练投影矩阵def MultiHeadAttentionBatched(X, Mk, Pq, Pk, Pv, Po, mask): # Q 由查询序列 X 经查询投影矩阵得到 Q = tf.einsum('bnd,hdk->bnhk', X, Pq) # K 由键值序列 Mk 经键投影矩阵得到,序列长度 m 与 X 的 n 可以不同 K = tf.einsum('bmd,hdk->bhmk', Mk, Pk) # V 同样来自 Mk,经值投影矩阵得到 V = tf.einsum('bmd,hdv->bhmv', Mk, Pv) # Q 与 K 点积得到每个位置对的注意力分数,两侧都保留 k 维才能收缩 logits = tf.einsum('bnhk,bhmk->bhnm', Q, K) # 加上 mask 屏蔽未来位置,再用 Softmax 归一化成权重 weights = tf.softmax(logits + mask) # 权重对 V 加权求和,得到每个注意力头的输出 O = tf.einsum('bhnm,bhmv->bhnv', weights, V) # 拼接各头结果后乘输出投影矩阵,恢复模型维度 Y = tf.einsum('bhnv,hdv->bnd', O, Po) # 返回批量多头注意力的结果 return Y五、Transformer 全流程
5.1 Block 里有什么
2017 年 Transformer 论文的架构同时包含编码器和解码器,用于序列到序列任务。现代大语言模型通常采用仅解码器架构:Token Embedding 对应输入嵌入,Masked Multi-Head Attention 汇集已出现的上下文,Feed Forward 逐位置变换,Linear 产生词表 logits,Softmax 给出概率分布。
注意力加权求和得到的结果自身不包含顺序。只按内容相关性计算时,模型无法稳定区分两个输入向量谁在前、谁在后。位置编码给每个位置附加不同向量。论文采用固定的正弦、余弦函数:
其中 pos 表示序列位置,i 表示维度索引,d 表示向量维度。不同频率使各位置得到可以互相区分的模式。
残差连接(Add)把子层输入 x 加到输出上,可写作 y = g(wx + b) + x。梯度有更短的传播路径,深层网络更容易稳定训练。归一化(Norm)把激活值调整到可控尺度;以 LayerNorm 的直观形式看,归一化后的数值均值为 0、方差为 1,同时保留各维度的相对差异。实际模型还会改变归一化的位置和计算方式。原论文在架构图之外还使用了 Dropout 等训练稳定性技巧,因为不影响对整体流程的理解,这里不再展开。
5.2 生成路径示例
一段文字经 tokenize 得到 Token 编号;编号从嵌入矩阵取出向量,并加入位置信息。向量通过带因果 mask 的 MHA 汇集前文,再经过 FFN 变换。若干 Transformer Block 重复这一结构,最后一层状态通过 Linear 变成词表 logits。Softmax 将 logits 映射到 0 到 1 且总和为 1 的概率,解码策略据此选出下一个 Token。新 Token 接到序列末尾,同一流程再次运行。
六、大模型是怎么训练出来的
6.1 自监督预训练
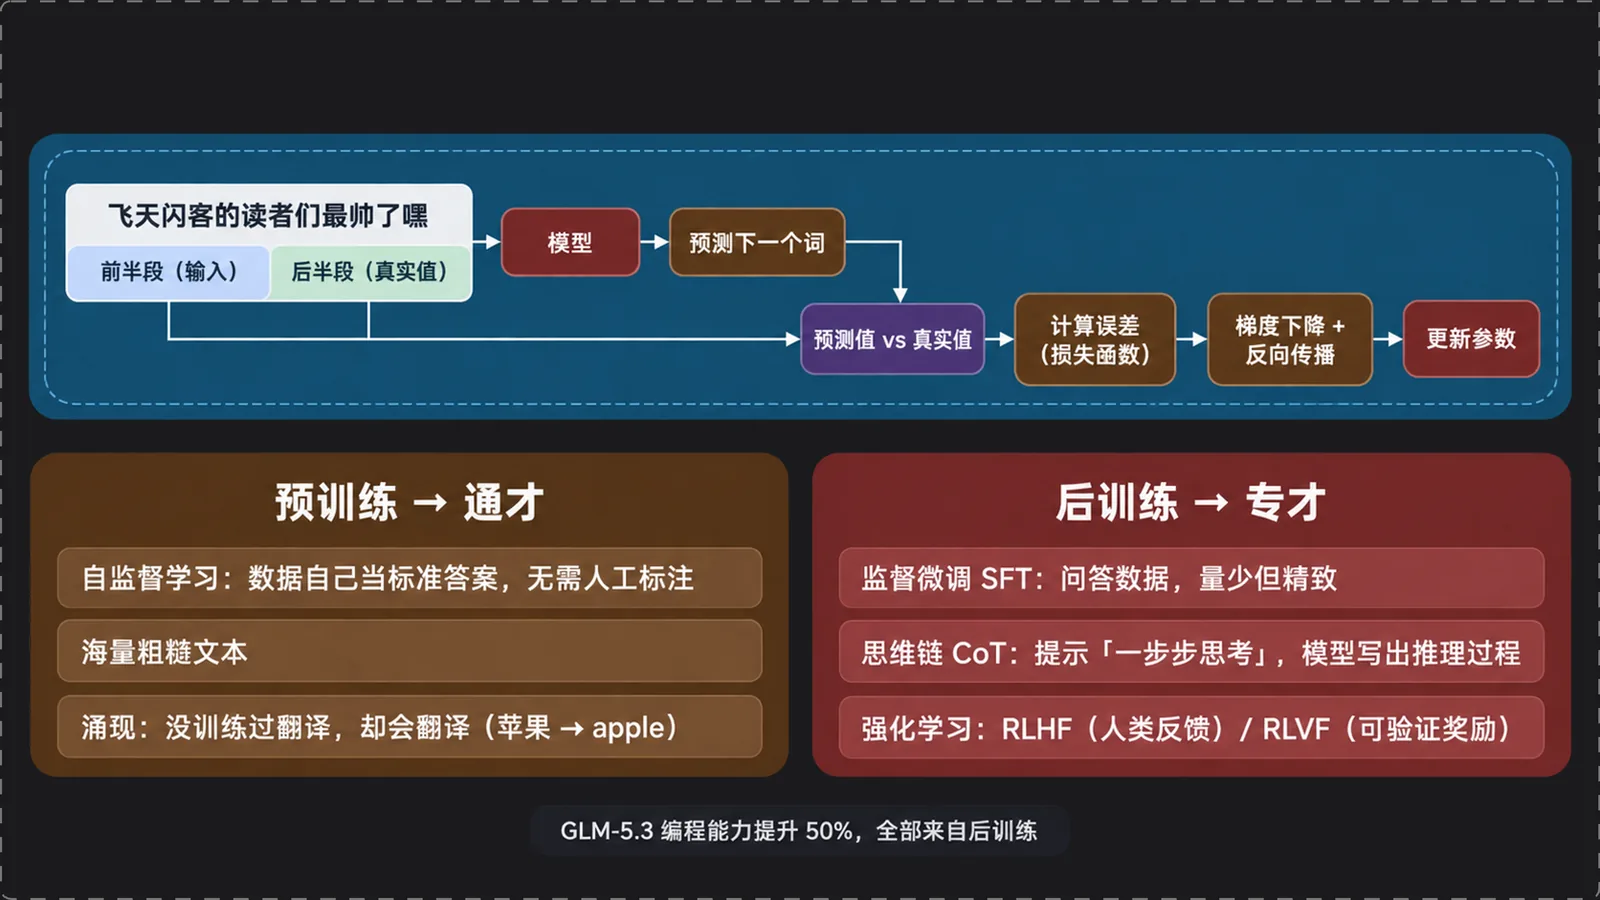
训练可以理解为大规模文字接龙。文本的前半段作为输入,紧随其后的真实 Token 作为目标;模型输出与目标之间的差异形成损失,反向传播计算各参数的梯度,优化器再更新参数。标签来自文本自身,无需人工逐条标注,因此称为自监督学习。
预训练把海量文本中的语言形式和知识压入参数,使模型成为覆盖多类任务的通才。GPT 的全称 Generative Pre-trained Transformer 也对应这条路径:生成式、预训练、Transformer。模型规模和数据跨过某些区间后,会出现训练目标没有逐项指定的能力,例如在双语语料的统计关系中学会翻译。给出少量输入输出示例后,模型还能在参数不变的情况下延续模式,这称为 few-shot learning。
6.2 后训练与推理过程
预训练数据规模大、质量参差,目标始终是续写;产品需要模型遵循指令、保持问答格式并完成特定任务。监督微调(Supervised Fine-Tuning,SFT)使用数量较少但质量较高的问答数据继续训练,把通才调整成适合目标行为的模型。素材给出的 GLM-5.3 案例中,编程能力提升 50%,提升全部来自后训练,这说明底座不变时,训练方法和数据仍能显著改变可用能力。
Chain of Thought(CoT)让模型在答案前生成中间推理文本。提示词要求“一步步思考”时,参数和网络结构都没有改变,改变的是模型在上下文中延续的 Token 序列。强化学习则发生在训练阶段。RLHF 使用人类反馈构造奖励,RLVF 使用可验证结果作为奖励;模型根据奖励调整生成策略,复杂推理行为由此得到强化。
七、从 LLM 到 Agent:让接龙进入软件系统
7.1 Context、Memory 与检索
单独的 LLM 接收输入并返回输出,可以把这种一问一答的角色记作“小 L”。系统把角色说明、任务要求和背景资料组成 Prompt,其中承载背景的信息属于 Context。对话历史继续放入 Context,就形成短期 Memory;历史太长时,可以压缩或选择相关片段,以控制上下文长度。
模型参数保存的是训练阶段学到的信息,不能自行访问网页或本地系统。Agent 程序负责在模型与外部工具之间传递请求和结果,并执行模型无权执行的动作。RAG(Retrieval-Augmented Generation,检索增强生成)会用语义向量从数据库找到相关材料,再把材料加入 Context;Web Search 也在生成前引入参数之外的信息,只是检索目标和索引方式不同。
7.2 Function Calling 与 MCP
Function Calling 通过接口约定降低自然语言的不确定性。程序把可用工具及参数结构传给模型,模型依照格式输出工具名和 JSON 参数;随后,程序解析 JSON、执行对应函数,再把结果传回模型。模型负责选择工具并生成调用描述,具体函数由 Agent 程序执行。
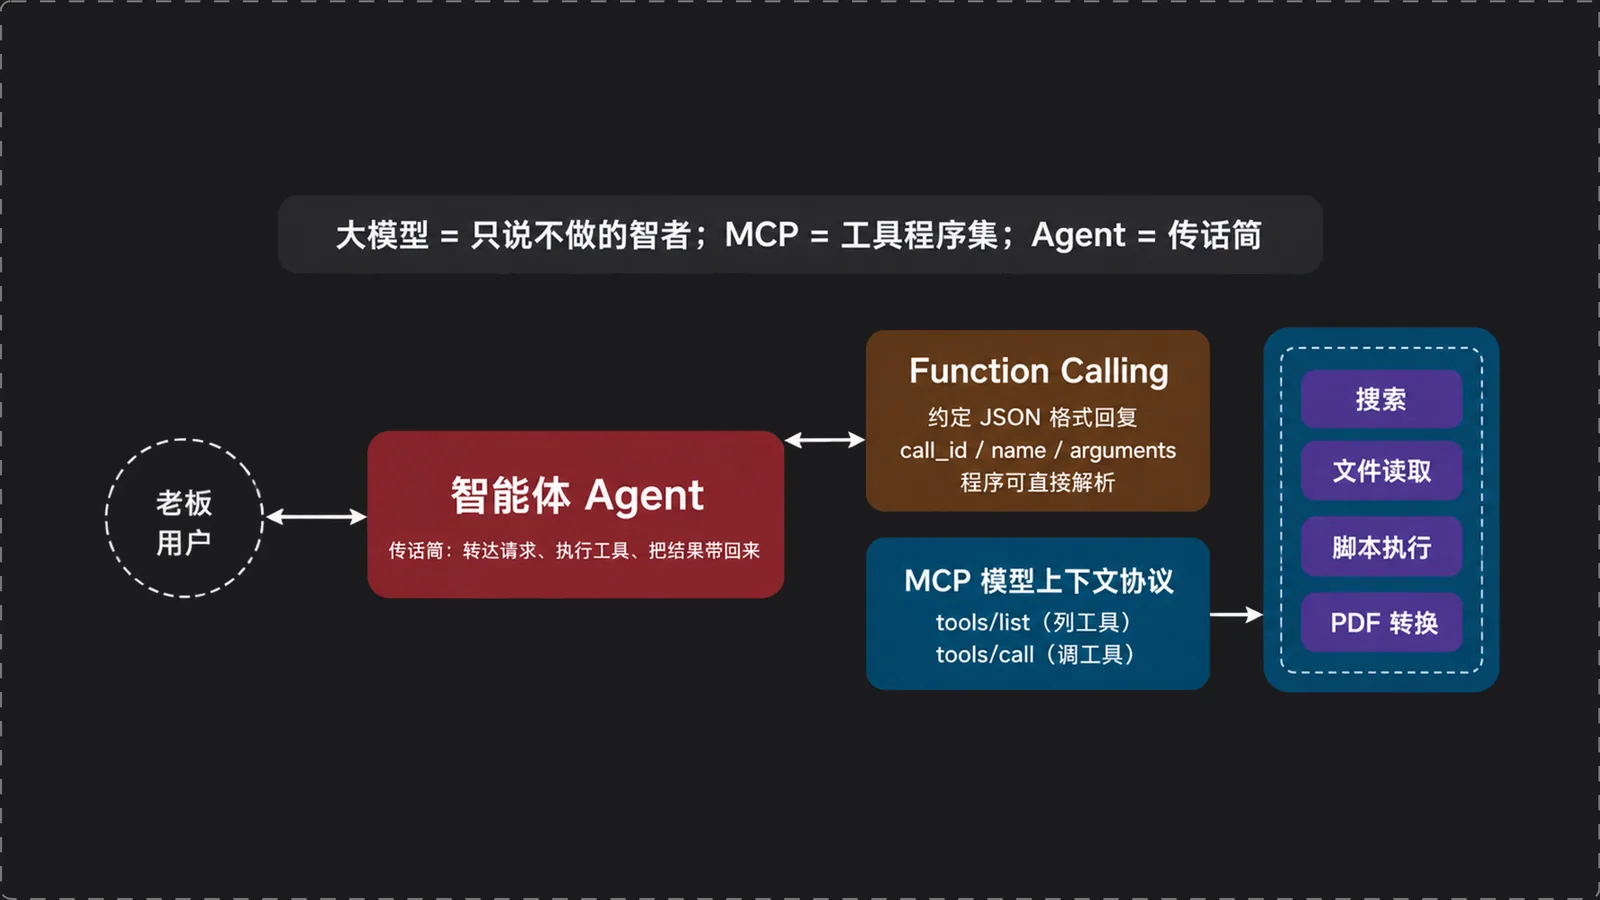
这段代码把分工落实为三个对象:工具列表定义可用能力,JSON 携带机器可解析的调用信息,最后一行由 Agent 执行函数。
# 把可用工具以列表形式提供给大模型tools = [ # 声明网页搜索工具及参数结构 {"name": "search", "description": "web search", "parameters": {}}, # 声明本地文件读取工具及参数结构 {"name": "read_file", "description": "读取本地文件", "parameters": {}}, # 其余工具可按同一结构继续加入列表 # 搜索、文件读取、脚本执行、PDF 转换……# 结束工具列表] # 让模型用 JSON 描述目标工具与调用参数{"call_id": "call_12345xyz", "name": "search", "arguments": {"words": "劲爆新闻"}} # 由 Agent 解析 JSON 并执行实际函数search(words="劲爆新闻")Model Context Protocol(MCP,模型上下文协议)把工具发现和调用进一步标准化。tools/list 用于列出工具,tools/call 用于发起调用。聊天界面、IDE 与代码编辑器、其他 AI 应用、数据与文件系统、开发工具、效率工具等六类系统遵守同一协议后,Agent 无需为每一种组合单独设计私有接口。可以把大模型看作负责判断但不能亲自操作的智者,MCP Server 是按统一规格提供能力的工具集,Agent 则传递请求、执行动作并管理循环。
Agent 的外形可以是 Codex、Claude Code 这类 CLI,也可以嵌入 Trae、Cursor 等 IDE,或成为 OpenClaw、Clawbot 一类桌面助手。它们共同面对两个成本:模型自由生成带来行为波动,多轮工具交互消耗较多 Token。工程系统会把高频路径固化下来。LangChain 用代码组织调用,Workflow 用低代码节点约束流程;Skill 把 SKILL.md、脚本和资源放在一个目录,Agent 执行任务前读取规则;SubAgent 把子任务放进相对隔离的上下文,减少不同任务之间的信息干扰。
八、架构演进
8.1 位置、归一化与残差
把输入输出编码看作边界,Transformer 中承担主要计算的部分可以归为位置编码、归一化、残差连接、FFN 和 Attention。对 2019 年 GPT-2 到 2026 年 DeepSeek V4-Pro 1.6T、V4-Flash 284B 在内的 67 个核心开源模型进行梳理,会看到同一底座上的零件持续被替换。厂商和模型之间的架构差异缩小,改进越来越集中在这些已知部位。
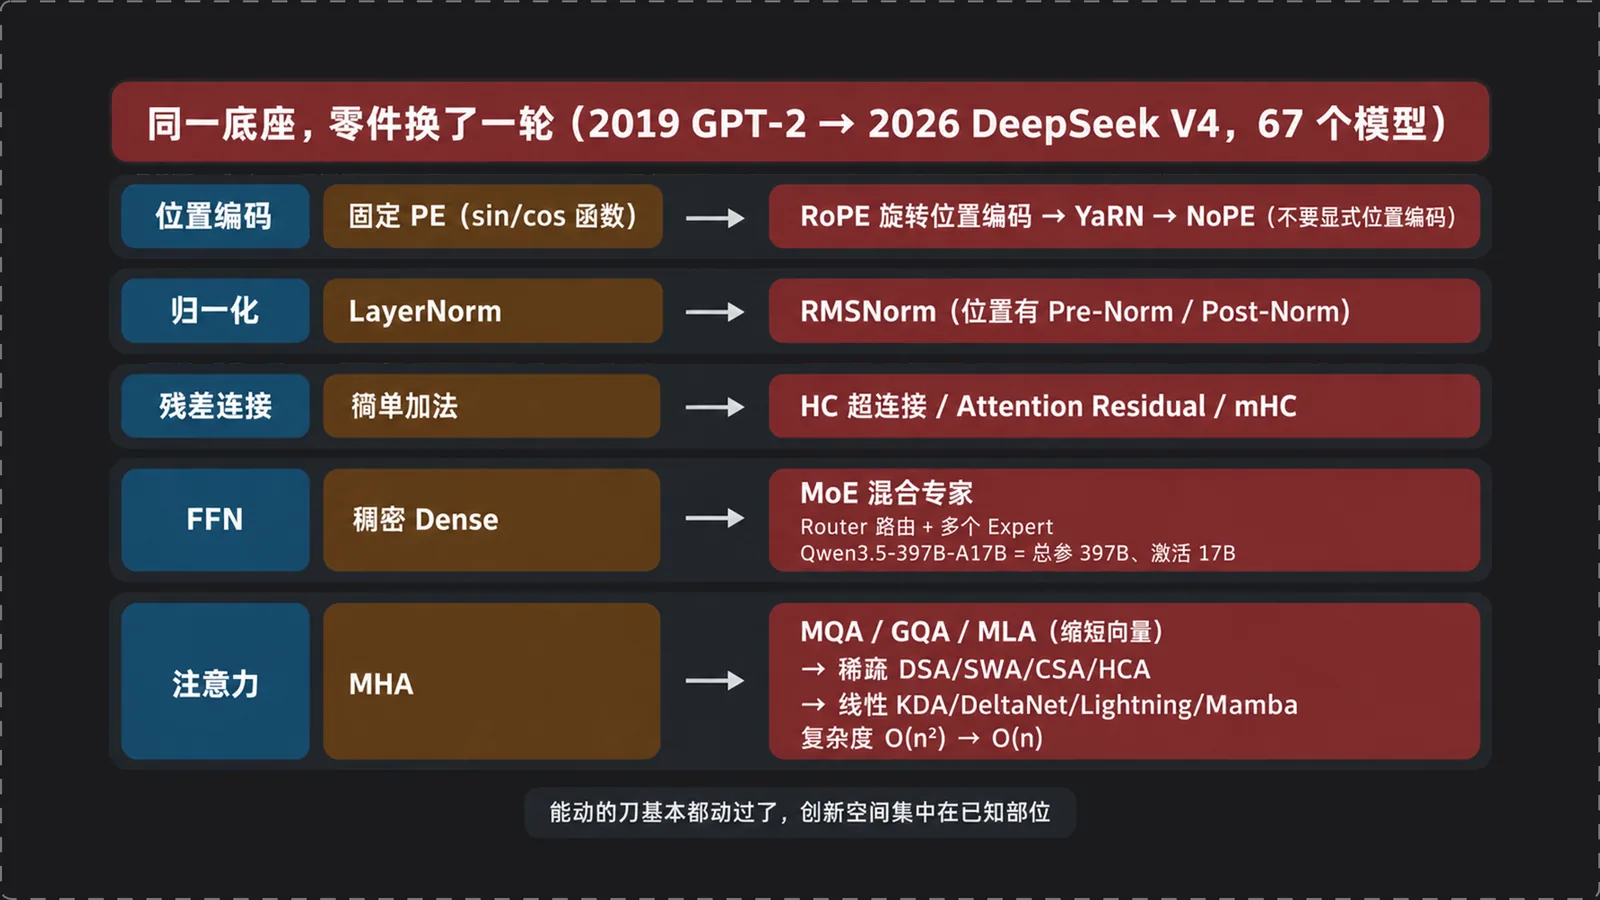
固定 PE 用正弦和余弦把绝对位置加进向量。RoPE(Rotary Position Embedding,旋转位置编码)在 Q、K 上施加与位置有关的旋转,使点积自然带上相对位置信息。YaRN 通过缩放策略扩展长上下文;NoPE 则尝试取消显式位置编码,让网络从因果结构和数据中学习顺序关系。它们处理的是同一需求:在内容相似度之外表示先后与距离。
归一化从 LayerNorm 逐渐转向计算更简洁的 RMSNorm。Norm 放在子层前还是子层后,形成 Pre-Norm 与 Post-Norm;模型还在 Q、K、V 的不同组合上加入 Norm,Q-Norm、K-Norm、V-Norm、QK-Norm 和 KV-Norm 都出现过。位置和对象不同,会改变激活尺度与训练稳定性,不能把这些名字理解成互不相关的新架构。
残差连接也从简单加法扩展到更复杂的信息通道。字节、DeepSeek、Kimi 等模型尝试过 HC(Hyper-Connection,超连接)、Attention Residual 和 mHC 等结构。改动目标仍是让深层网络保留输入信息,并让梯度穿过大量层时保持可训练。
8.2 FFN 变成 MoE
稠密(Dense)模型每次计算都会使用 FFN 的全部参数。Mixture of Experts(MoE)把大 FFN 分成多个较小的 Expert,再由 Router 为每个 Token 选择部分专家。模型可以拥有巨大的总参数量,单次推理只激活其中一部分,因此稀疏(Sparse)模型的存储规模与计算规模可以分开增长。
DeepSeek MoE 使用细粒度专家分割,把专家划分得更小,提高路由组合的灵活性;共享专家与路由专家分开,承接多个 Token 都需要的通用能力,减少路由专家重复学习公共知识。Qwen3.5-397B-A17B 的名称给出了这种差别:总参数 397B,每次激活 17B。397B 决定模型需要容纳多少参数,17B 更接近一次前向计算实际动用的规模。
8.3 Attention 的三条改造路线
标准 MHA 为每个头保存独立的 K、V,长序列推理需要庞大的 KV Cache。MQA 让多个查询头共享一组 K、V,GQA 让若干查询头共享一组,MLA 把键值信息压到较短的潜在向量中。三种方法都在减少缓存和带宽,同时尽量保留多头查询的表达能力。
另一类方法减少需要两两比较的位置。DSA、SWA、CSA、HCA 采用不同的稀疏选择或局部结构,让每个 Token 关注序列中的一部分位置。KDA、Gated DeltaNet、Lightning Attention、Mamba 等方法则沿线性注意力或状态空间路线,把标准注意力随序列长度增长的 O(n²) 计算降到接近 O(n)。压缩、稀疏和线性化各有精度、硬件效率及长程记忆方面的取舍。
不少现代模型采用混合注意力(Hybrid Attention),在不同层交替使用全注意力、滑动窗口或线性模块。全注意力保留全局检索能力,低复杂度模块处理大部分长序列计算。五类部件都经历了多轮替换,新的模型设计更多是在已知空间里寻找更好的组合。
九、三个定律与未完成的方向
斯坦福报告所呈现的一个现象是,开源与闭源模型、不同厂商模型之间的能力差距正在缩小。若各方保持线性进步,差距通常不变;若头部保持指数增长,差距会扩大。差距收窄可以作为整体发展速度放缓的一项观察,近年的架构演进也越来越集中于局部改造;但是单凭差距变化仍不能确定放缓的全部原因。
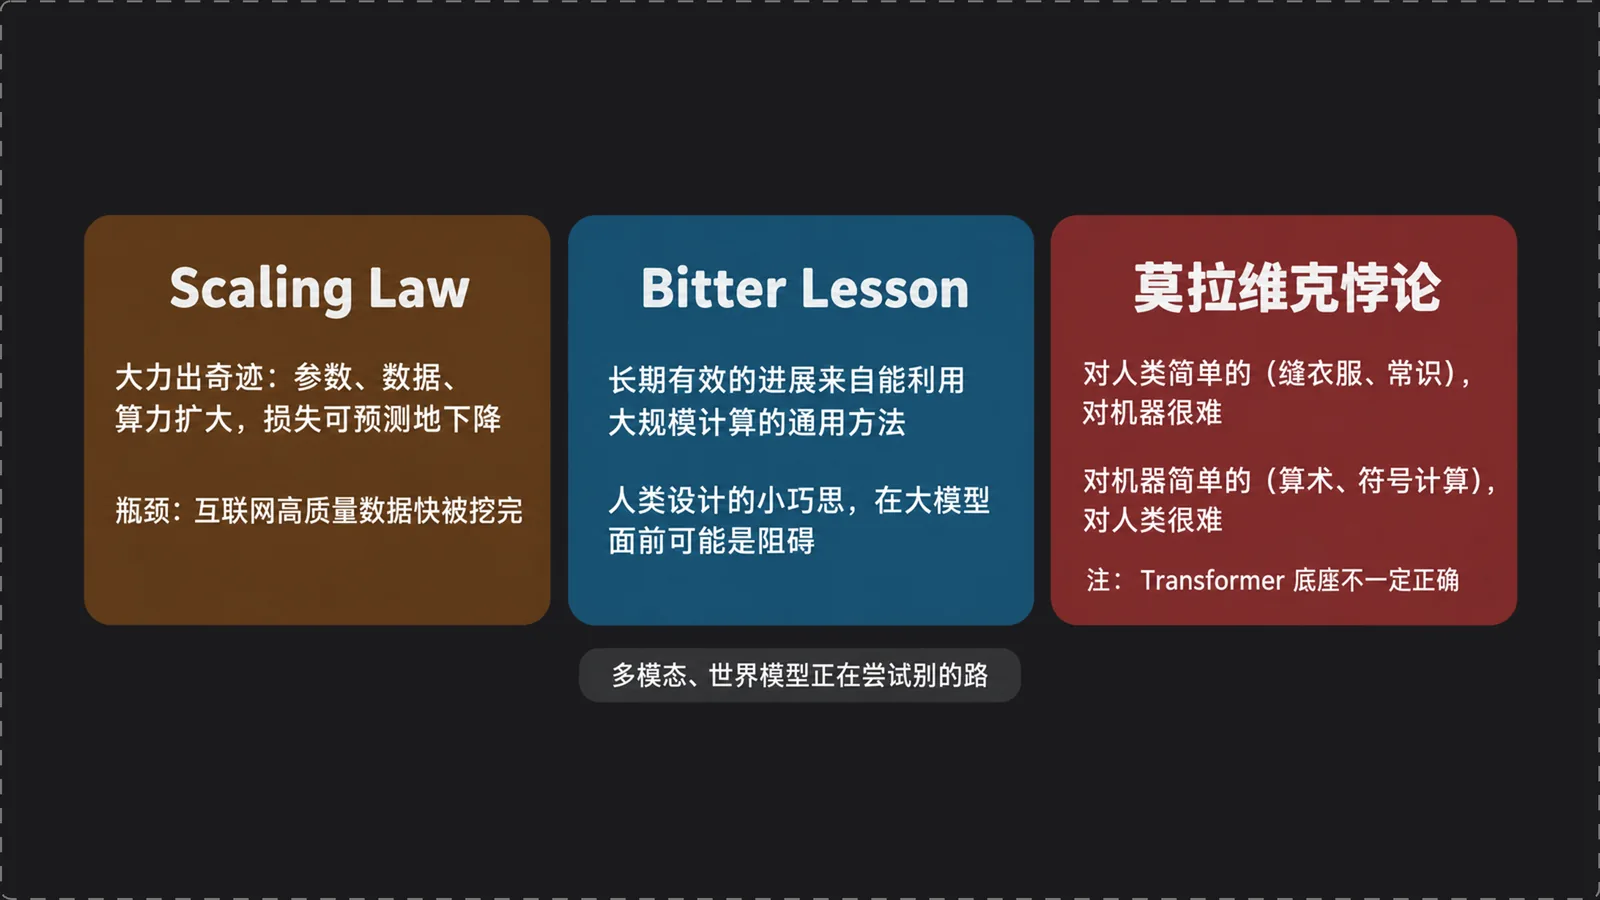
Scaling Law 描述了参数、数据和计算量扩大时,模型损失按可预测趋势下降。它支撑了“大力出奇迹”的训练路线,也暴露出数据约束:高质量文本不是无限资源,公开数据逐步用尽后,继续放大训练集会变得更难。
Bitter Lesson 指出,长期有效的进展往往来自能够利用大规模计算的通用方法;人为设计的小巧规则在规模扩大后可能成为限制。Transformer 的成功符合这条经验,但经验并不保证当前结构是终点。
莫拉维克悖论揭示了一种能力错位:人类觉得困难的符号计算,机器可能容易处理;人类可以轻松完成的感知、运动和常识活动,机器反而需要大量计算。LLM 擅长在符号序列中延续模式,离稳定理解和作用于物理世界仍有距离。多模态模型把图像、声音等信号纳入统一表示,世界模型尝试学习环境状态及其变化,它们都在补足纯文本预测的边界。
十、小结
大模型就是一个经过反复训练的「预测下一个词」神经网络。嵌入负责数值表示,注意力引入上下文,FFN 提供逐位置的非线性变换,归一化和位置编码分别改善训练尺度与顺序表达。现代模型沿用同一个问题定义,再逐件更换实现。
本文由 AgentWorkFlow 生成