
文章内容
- 一、问题:摘要没错,执行却跑偏
- 1.1 现象:上下文摘要准确无误,Agent 却越执行越偏
- 1.2 答案:操作约束要脱离纯自然语言摘要
- 二、第一层:摘要的语义保真与执行约束的错位
- 2.1 摘要模型的任务是保留语义
- 2.2 执行标准下这笔账亏大了
- 2.3 后果:Agent 只看到目标,最终生成全量查询
- 三、第二层:声明性/操作性信息的结构化分离
- 3.1 任务上下文先拆两类
- 3.2 一个订单报表任务的拆法
- 3.3 约束字段挂载到任务上下文
- 四、第三层:约束注入的触发时机
- 4.1 注意力衰减会让约束失效
- 4.2 关键决策节点主动注入
- 4.3 注入示例
- 五、面试回答模板与加分点
- 5.1 四步模板
- 5.2 加分点一:约束优先级分级
- 5.3 加分点二:坏路径
- 六、总结
- 6.1 核心结论:操作约束丢失会导致执行跑偏
- 6.2 可验证的实践方式
一、问题:摘要没错,执行却跑偏
1.1 现象:上下文摘要准确无误,Agent 却越执行越偏
面试里经常会问一个看似矛盾的问题:上下文摘要明明没有丢事实,Agent 为什么越执行越偏?
用一个数据任务举例:从订单表查出本月已支付订单并生成汇总报表。原始上下文里还有几条执行要求:分页查询,每页 1000 条;逐批处理,直到没有下一页;只能访问只读副本库;SQL 超时 30 秒;失败重试不超过三次。
经过摘要后,模型可能只保留:查询本月已支付订单并生成汇总报表。这个摘要看起来没错,目标也没有变。问题出在执行阶段。Agent 进入“生成 SQL”这一步时,只看到“查询订单表”,没有看到分页、批大小、只读库、超时和重试边界。它很自然地写出全量查询,甚至把所有行一次性拉到内存里做汇总。
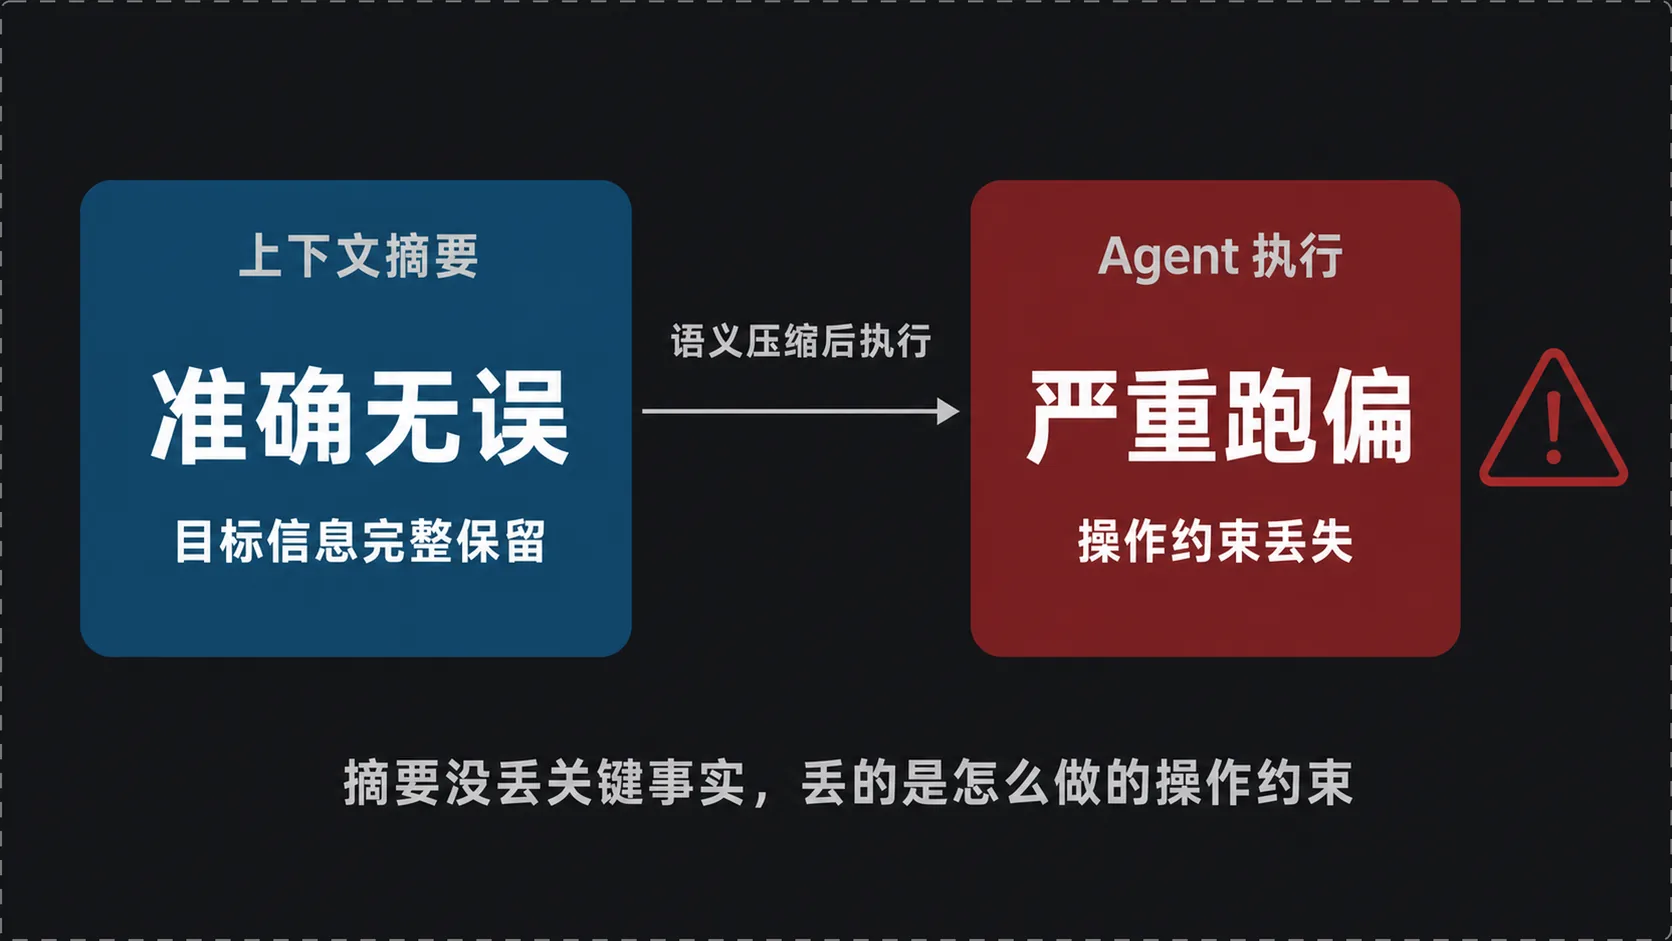
这类跑偏很隐蔽。摘要没有编造事实,也没有漏掉业务目标;丢掉的是任务该怎么执行。对自然语言摘要来说,“分页查询”和“查询数据”语义相近;对执行系统来说,两者对应完全不同的 SQL、循环结构和资源风险。
1.2 答案:操作约束要脱离纯自然语言摘要
操作指令型上下文不能直接交给纯自然语言摘要压缩。安全做法是把任务上下文拆成两类:声明性信息和操作性信息。声明性信息回答“要做什么、为什么做”,可以摘要;操作性信息回答“怎么做、有什么限制”,需要结构化提取,作为独立约束元数据保留。
后续每一轮决策都不能只依赖摘要文本。Agent 进入关键步骤时,系统应按步骤类型主动匹配约束字段,把相关约束注入当前 prompt,并在输出后做硬性校验。这样上下文压缩不会把执行边界抹掉,Agent 也不用在长摘要里猜哪些词是软描述、哪些词是硬规则。
二、第一层:摘要的语义保真与执行约束的错位
2.1 摘要模型的任务是保留语义
摘要模型通常按语义保真工作。它会判断哪些内容支撑任务目标,哪些内容可以压缩成更短的表达。“分页查询、逐批处理、每批不超过 1000 条”在语义层面都围绕同一件事:查询数据。于是摘要里可能只剩“查询数据”。
从自然语言理解角度看,这个处理很合理。摘要保留了目标对象:订单表;保留了筛选条件:本月、已支付;保留了产出:汇总报表。读者如果只是理解需求,确实能知道要做什么。
问题在于 Agent 不只理解文本,它还要把文本变成动作。动作系统关心的是是否加 limit、是否维护 offset、是否循环取完、是否在每批之后落盘、是否能在超时后重试。摘要越短,越容易把这些执行动作压平。
2.2 执行标准下这笔账亏大了
“分页”“逐批”“每批 1000 条”承载的是执行约束。分页意味着每次查询都要带 limit 和 offset,逐批意味着应用层要循环推进游标,每批不超过 1000 条意味着代码里必须有 batchSize=1000 这类参数。
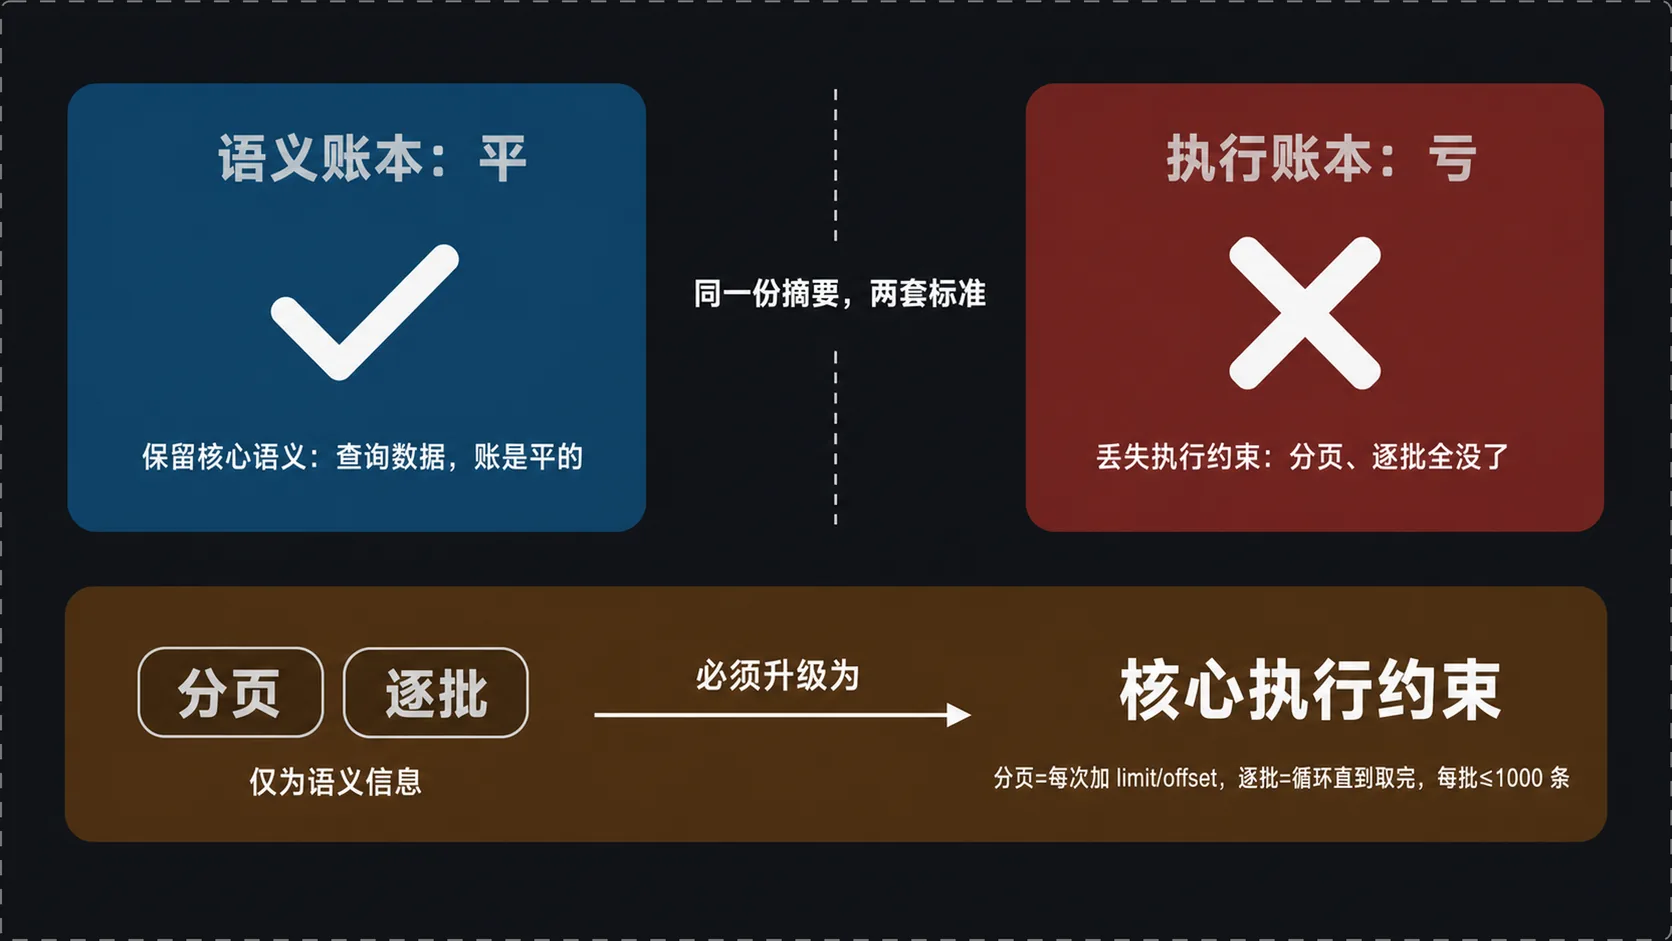
语义账本可以平,执行账本会亏。摘要模型把几条操作要求合并成“查询数据”时,语义目标没有变;Agent 执行时,资源边界已经消失。数据库压力、内存占用、锁等待、慢查询风险都会被放大。
面试回答时要把这层错位说清楚:摘要质量和执行正确性不是同一个评价维度。摘要是否保留目标,不能证明它保留了执行约束。Agent 任务越偏工程执行,这个差异越明显。
2.3 后果:Agent 只看到目标,最终生成全量查询
被压缩后的上下文只剩“查询本月已支付订单”。Agent 进入 SQL 生成步骤时,会把它翻译成直接查询。一个典型坏输出如下:
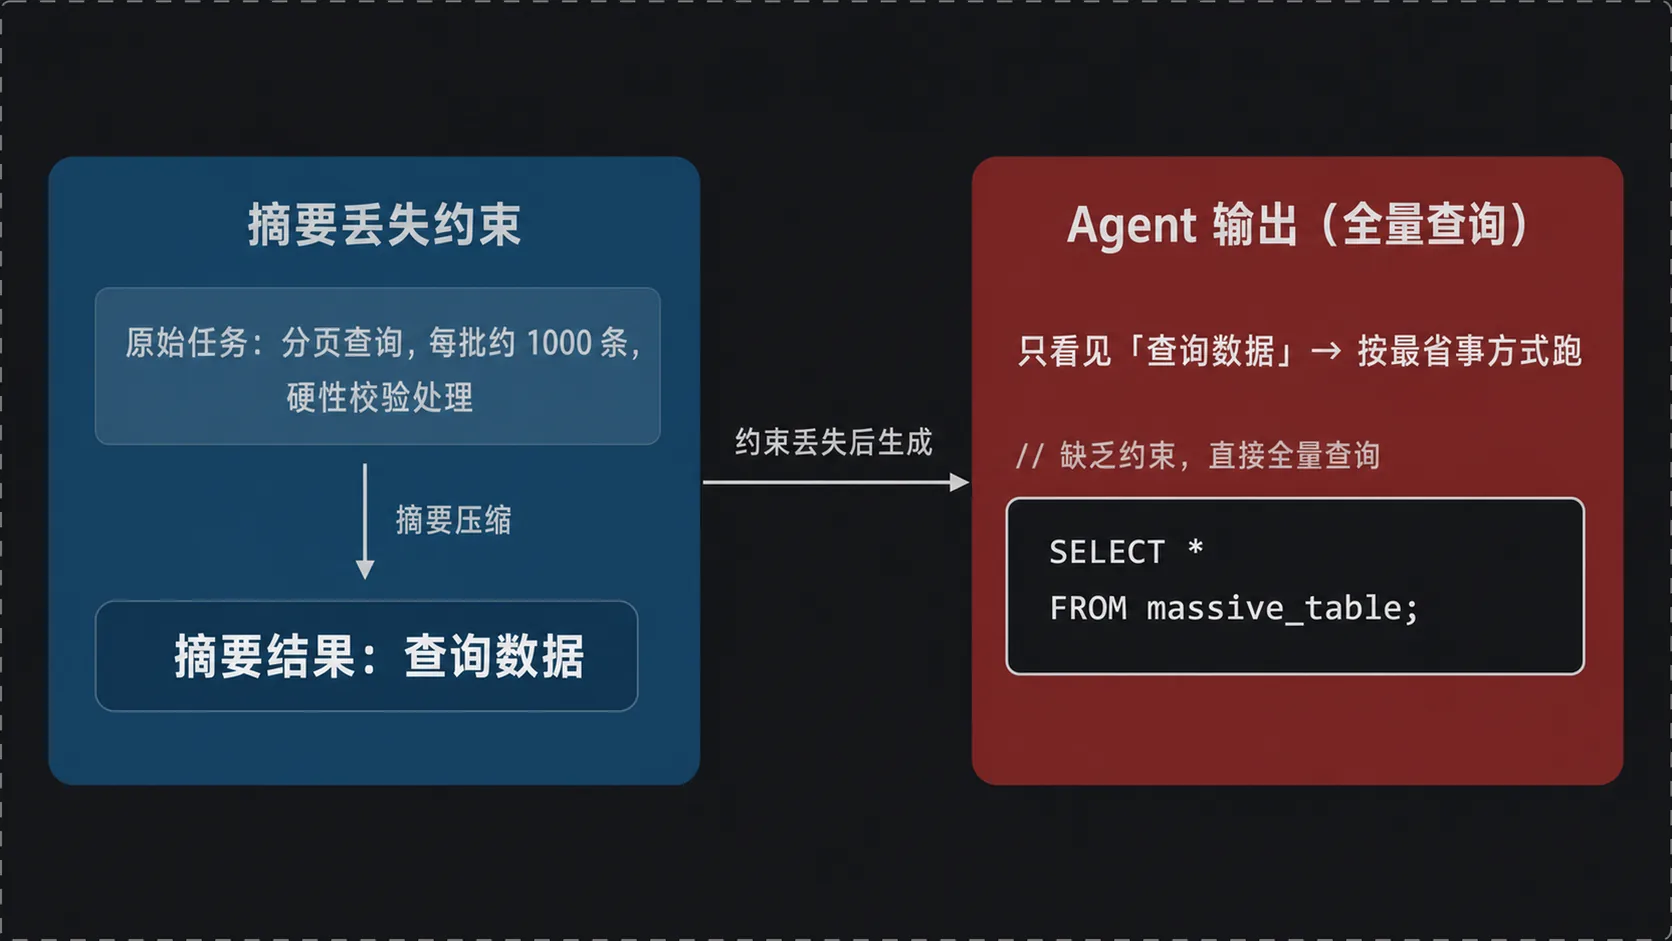
下面看一个最小反例,问题不在 SQL 语法,而在缺少执行边界。
# 目标表SELECT * FROM orders# 业务筛选条件WHERE status = 'paid'# 时间范围条件这段输出证明:事实型条件还在,但分页约束没进入执行计划。真实系统里,这类 SQL 可能扫完整个月的订单数据,再把压力转移到数据库、网络和 Agent 运行环境。
三、第二层:声明性/操作性信息的结构化分离
3.1 任务上下文先拆两类
进入摘要前,任务上下文应先分类。声明性信息包括目标、对象、原因、输出形态,比如“查本月已支付订单”“生成汇总报表”“给运营做月报”。这些信息可以摘要,因为压缩后仍然能表达任务意图。
操作性信息包括执行路径、资源限制、安全边界和失败策略,比如“分页查询”“每页 1000 条”“只读副本库”“超时 30 秒”“最多重试三次”。这些信息不能只作为自然语言留在摘要里。它们应该被抽取成机器可读字段,挂在任务上下文旁边。
3.2 一个订单报表任务的拆法
声明性信息可以写成:从订单表查出本月已支付订单并生成汇总报表。它回答的是“要做什么”。
操作性信息要更细:用分页方式查询,每页 1000 条;必须使用只读副本库;SQL 超时 30 秒;失败重试不超过三次;每批处理完后再拉下一批。它回答的是“怎样做才算合格”。
拆分后,摘要模型只处理声明性部分。操作性部分可以保留原文,也可以映射成标准字段。关键是不要让它在压缩过程中和普通描述混在一起。
3.3 约束字段挂载到任务上下文
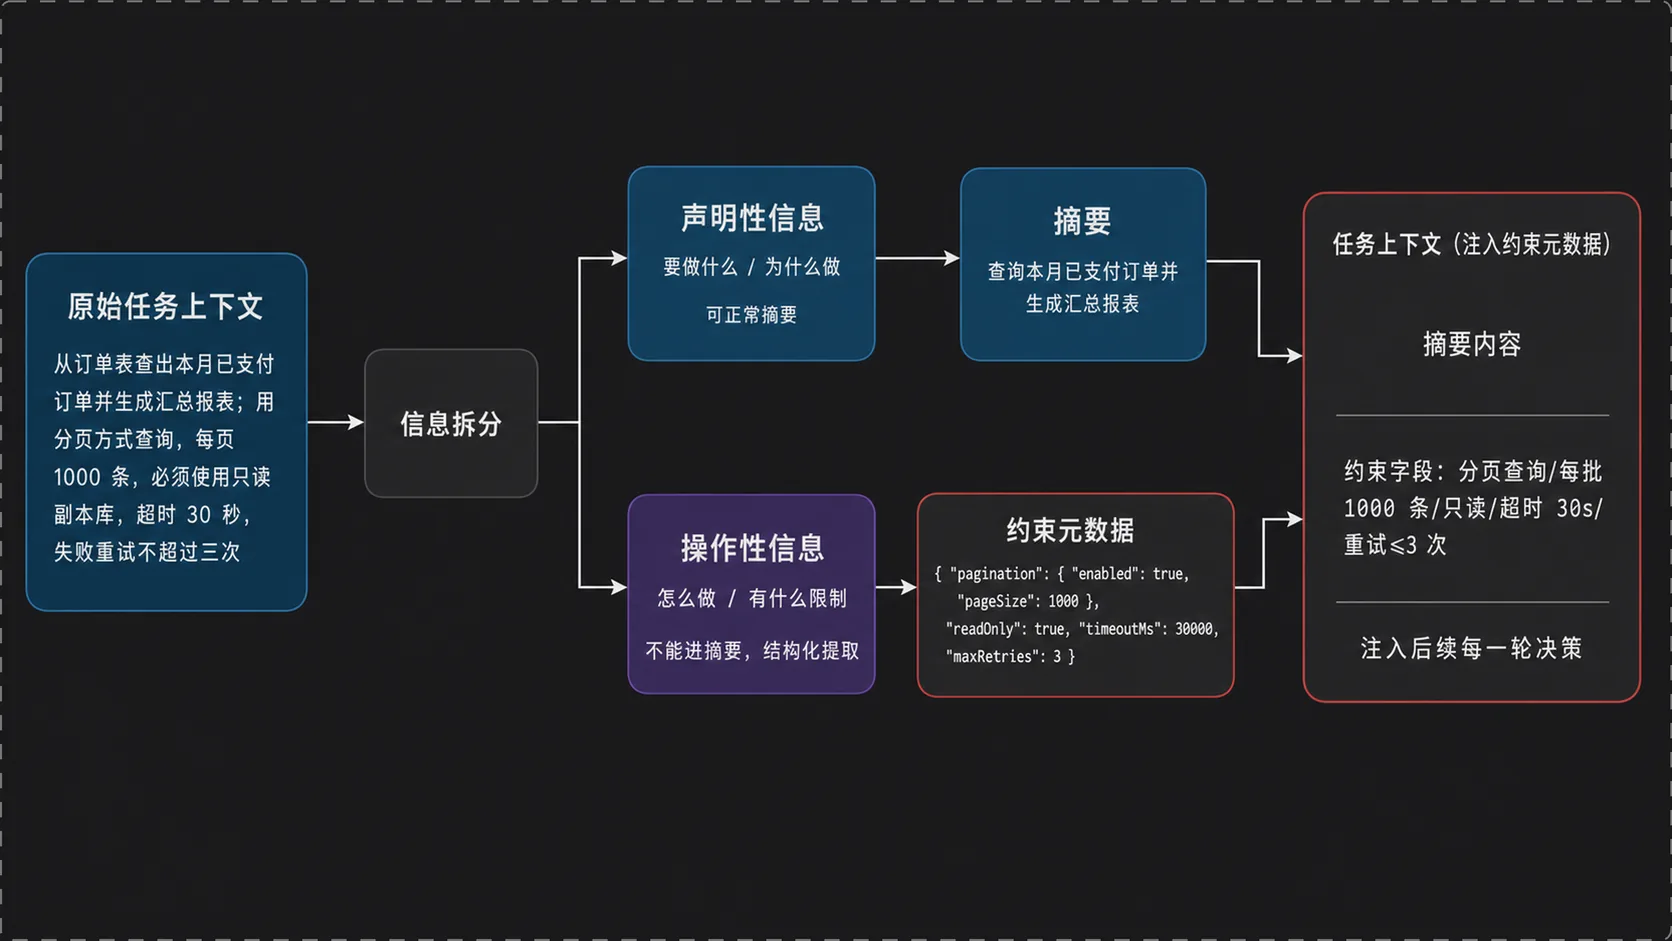
下面这个结构展示操作性信息如何从自然语言变成约束元数据。
// 任务级约束根对象{// 分页约束对象 "pagination": {// 启用分页 "enabled": true,// 每页最多 1000 条 "pageSize": 1000// 结束分页约束对象 },// 只允许访问只读库 "readOnly": true,// 单次 SQL 超时时间 "timeoutMs": 30000,// 失败最多重试三次 "maxRetries": 3// 结束任务级约束根对象}这段结构证明,操作约束可以脱离摘要文本独立存在。后续步骤不需要从一句自然语言里重新理解“分页”的含义,系统可以直接读字段并生成注入内容。
四、第三层:约束注入的触发时机
4.1 注意力衰减会让约束失效
把约束字段挂在上下文里还不够。多轮执行中,Agent 会经历计划、查询、代码生成、工具调用、结果检查等步骤。约束如果只出现在最早的系统提示或任务说明里,越到后面越容易被忽略。
这就是注意力衰减在工程任务里的表现:信息没有丢,模型当前步骤没有使用它。尤其当 prompt 里同时出现需求背景、表结构、历史推理、工具返回、错误日志时,几条短约束很容易淹没在上下文里。
4.2 关键决策节点主动注入
正确做法是在 Agent 进入每个关键决策节点时,由系统主动触发约束注入。当前步骤要生成 SQL,就注入分页、只读库、超时;当前步骤要调用外部 API,就注入重试、速率限制、鉴权边界;当前步骤要写文件,就注入路径、覆盖策略和大小限制。
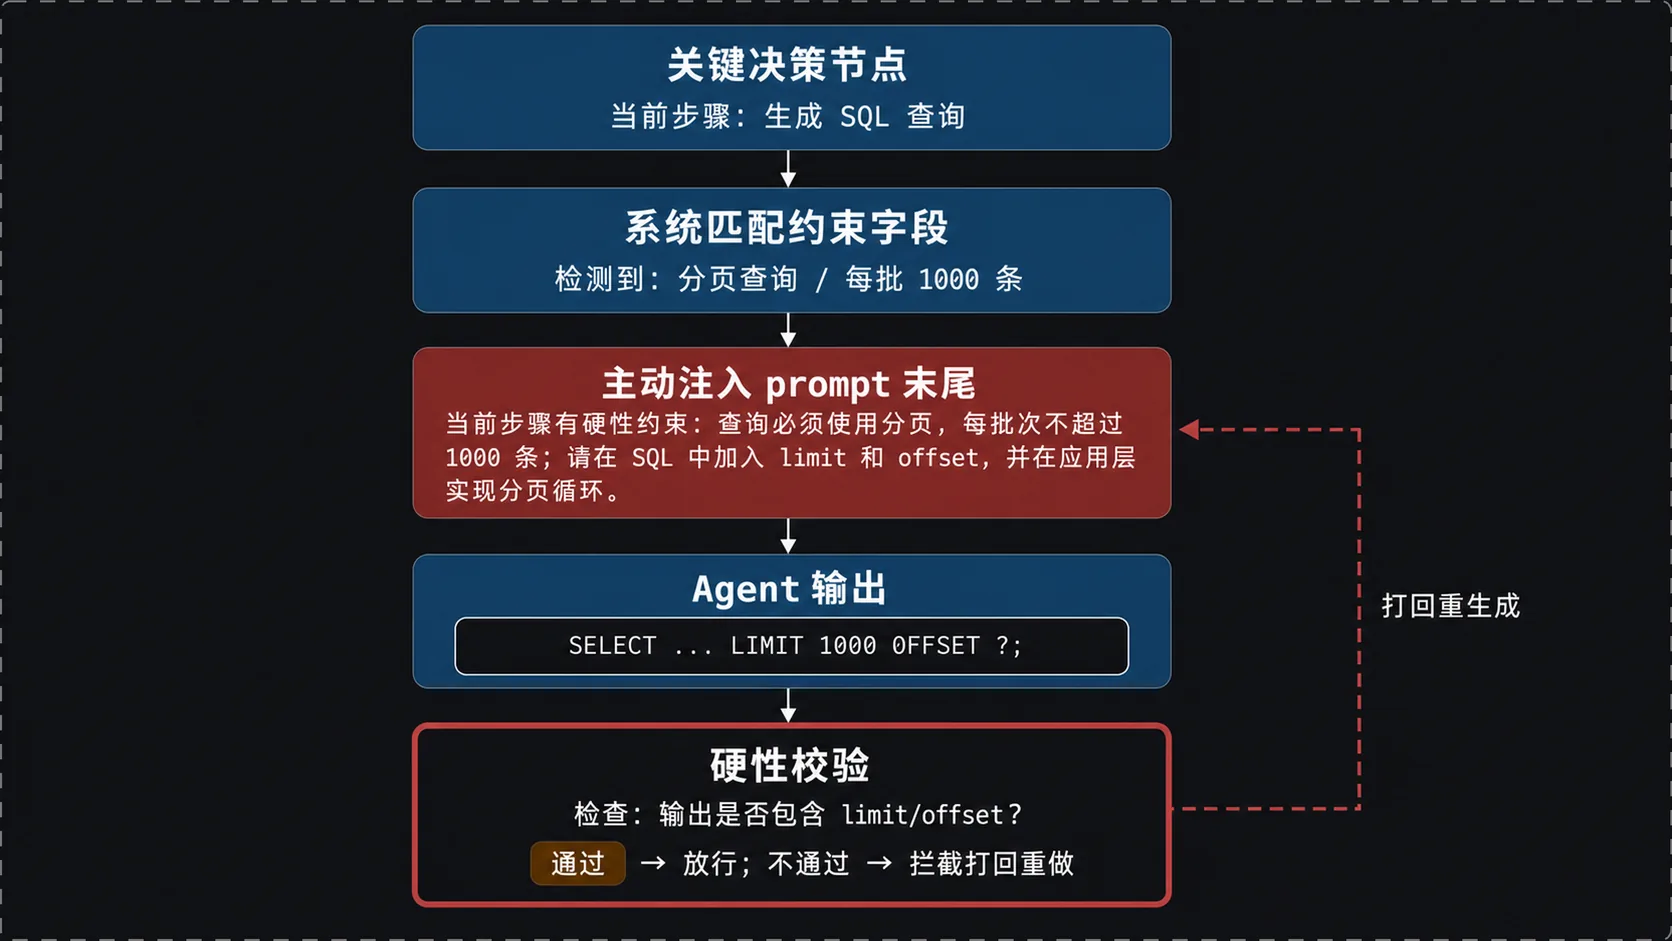
这套机制的重点是“推到当前步骤面前”。Agent 不需要从摘要里搜索约束,调度层根据步骤类型和约束字段做匹配,把最相关的三到五条放到 prompt 末尾,并声明这些约束高于普通建议。
4.3 注入示例
当前步骤是生成 SQL 查询时,可以追加这样的片段。
# 约束标题本步骤必须满足以下执行约束:# 分页要求查询必须使用分页。# 批大小要求每批次不超过 1000 条。# SQL 结构要求SQL 中必须包含 limit 和 offset。# 应用层循环要求应用层必须循环推进 offset,直到没有下一页。# 失败处理要求单次查询超时 30 秒,失败重试不超过 3 次。生成 SQL 时只给 SQL 相关约束,不把所有安全、合规、格式和交互规则一次性塞进去。
五、面试回答模板与加分点
5.1 四步模板
回答这道题可以按四步组织。
第一步,在摘要生成前对任务上下文做声明性/操作性分离。声明性信息进入摘要,操作性信息进入约束抽取流程。
第二步,摘要只压缩声明性信息,操作约束原样保留或结构化为字段。不要让“分页查询”在摘要里退化成“查询数据”。
第三步,Agent 每进入新步骤,系统自动匹配步骤类型和约束字段,做关联注入。SQL 步骤拿分页、只读库、超时;工具调用步骤拿重试、幂等、速率限制;文件步骤拿路径和覆盖策略。
第四步,关键约束做硬性校验。Agent 输出的 SQL 没有 limit/offset,但约束字段要求分页,系统直接拦截打回,要求重写。
拦截逻辑伪代码:
# 定义 SQL 校验函数def validate_sql(sql, constraints):# 读取分页约束 pagination = constraints.get("pagination", {})# 判断当前任务是否要求分页 if pagination.get("enabled"):# 检查 SQL 是否包含 limit has_limit = "limit" in sql.lower()# 检查 SQL 是否包含 offset has_offset = "offset" in sql.lower()# 缺少任一字段就拦截 if not has_limit or not has_offset:# 返回失败原因 return False, "SQL 必须包含 limit 和 offset"# 通过校验 return True, "ok"这段伪代码证明,硬约束不能只靠模型自觉遵守。系统要能在输出后检查,并把不合格结果退回到生成步骤。
5.2 加分点一:约束优先级分级
约束不宜全部升级为拦截规则。硬约束建议只保留三类:数据安全、资源安全、合规。数据安全包括只读库、禁止删除、禁止更新生产表;资源安全包括分页、限流、超时、批大小;合规包括隐私字段脱敏、权限边界、审计记录。
其他要求可以作为软建议,比如输出格式偏好、命名风格、解释详细程度。软建议允许 Agent 根据实际执行情况调整,硬约束必须由系统校验。分级之后,约束数量会降下来,执行遵从率也更稳定。
5.3 加分点二:坏路径
常见坏路径是在 prompt 开头写“请严格遵循以下约束”,然后列几十条规则。对模型来说,这类长列表很快会变成背景噪声。约束条目超过五条后,越靠后的条目越容易被忽略;多轮工具调用之后,早期规则的约束力会继续下降。
更稳的做法是按步骤注入。每个步骤只注入当前动作相关的约束,并把硬约束放在 prompt 末尾或工具调用前的近邻位置。约束少、位置近、可校验,执行质量才会提升。
六、总结
6.1 核心结论:操作约束丢失会导致执行跑偏
上下文摘要明明没丢事实,Agent 仍然越执行越跑偏,根因在于操作约束被语义摘要抹平了。摘要保留“做什么”,却可能丢掉“怎么做”。修复路径很明确:分离声明性和操作性信息,结构化保存操作约束,在关键决策节点主动注入,并对硬约束做输出校验。
6.2 可验证的实践方式
可以做一个最小实验。准备同一个任务:从订单表查出本月已支付订单并生成汇总报表,要求分页查询、每页 1000 条、只读库、超时 30 秒。A 组只给 Agent 摘要后的上下文:“查询本月已支付订单并生成汇总报表”。B 组给同样摘要,再附加结构化约束字段,并在 SQL 生成步骤注入分页要求。
对比两组输出:A 组是否容易生成全量查询;B 组是否稳定包含 limit、offset 和应用层分页循环。这个实验能直接验证本文的核心问题:跑偏不一定来自事实丢失,更常见的原因是执行约束没有被结构化保留下来,也没有在关键步骤被主动推回到 Agent 面前。
本文由 AgentPlanFlow 生成