
文章内容
- 一、Vibe Coding 与规范驱动的分野
- 二、整体概览:三层框架+一条循环
- 三、Constitution:和 agent 聊出来的项目总章程
- 3.1 三条规则
- 3.2 演示项目:Agent Clinic
- 3.3 深度规范长什么样
- 四、特性循环:Plan → Implement → Validate
- 4.1 Plan:先谈清楚再写代码
- 4.2 三份文档的骨架(以 Phase 1 为例)
- 4.3 Implement:当成结对程序员,别代理它的活儿
- 4.4 Validate:human-in-the-loop 才是主战场
- 五、特性之间:Replanning 让规范保持活
- 六、把流程固化:skills、MCP 与现成框架
- 6.1 Agent Skill:把重复 prompt 变成能力
- 6.2 MCP vs Skills + CLI
- 6.3 插件与现成 SDD 框架
- 七、让 agent 可替换:标准解绑流程与工具
- 八、Brownfield:给老项目装上 SDD
- 九、值得记住的几条边界
当 Coding Agent 已经足够快,一晚上能替你写几千行代码,真正的问题就变了:不再是"它写不写得动",而是"它写出来的是不是你要的"。很多人第一反应是 vibe coding 那种玩法——丢一个"给我一个按钮"的 prompt,看结果,挑毛病,再让 agent 重来,循环到满意为止。对按钮它挺好使,对一个要维护一年的项目,它留下的是一长串没保存的对话历史,和一堆一次性代码。
规范驱动开发(Spec-Driven Development,SDD)处理的正是这个矛盾。它不是让模型更聪明,而是把你和 agent 的关系重新定义成一对契约:你负责写清楚"要什么"(spec),agent 负责"怎么实现"(implementation)。
一、Vibe Coding 与规范驱动的分野
先看两种玩法在生产上的差别。
Vibe coding 的循环是:写一句想要什么 → agent 给结果 → 你指出不对 → agent 再改 → 满意为止。这个过程天然长出一个你没保存的长对话,而 agent 的状态是无状态的——每次启动,它的上下文窗口是重新开始的。对话一长,窗口装满,agent 开始"赔笑脸",越改越偏。
规范驱动开发反过来:规范(the what and why)与实现(the how)解耦,规范本身成为一个持久化的技术工件。它既是人与人之间的契约,也是人与 agent 之间的契约。你的主要任务从"写代码"挪到了"把自己的意图转成清晰的规范"。
SDD 的收益有三条,后面所有设计都从它们长出来:
- 用小改动控制大改动。规范里一句话"数据层用 SQLite + Prisma ORM",可能对应几百行代码;改成 MongoDB,下游同样的放大效应。写规范比写代码效率高得多。
- 消除会话间的上下文衰减。Agent 是无状态的,所以它"上次聊到什么"是靠你的上下文填进去的。规范在会话之间、甚至 agent 之间都存在,等于给 agent 锚定了一份干活所需的高质量上下文。
- 提升意图保真度。因为规范逼你在 agent 动手前,先把问题、成功标准、约束、用户流程写清楚,agent 才有机会产出贴近你目标的代码。
说到底,agent 是肌肉,spec 是大脑。
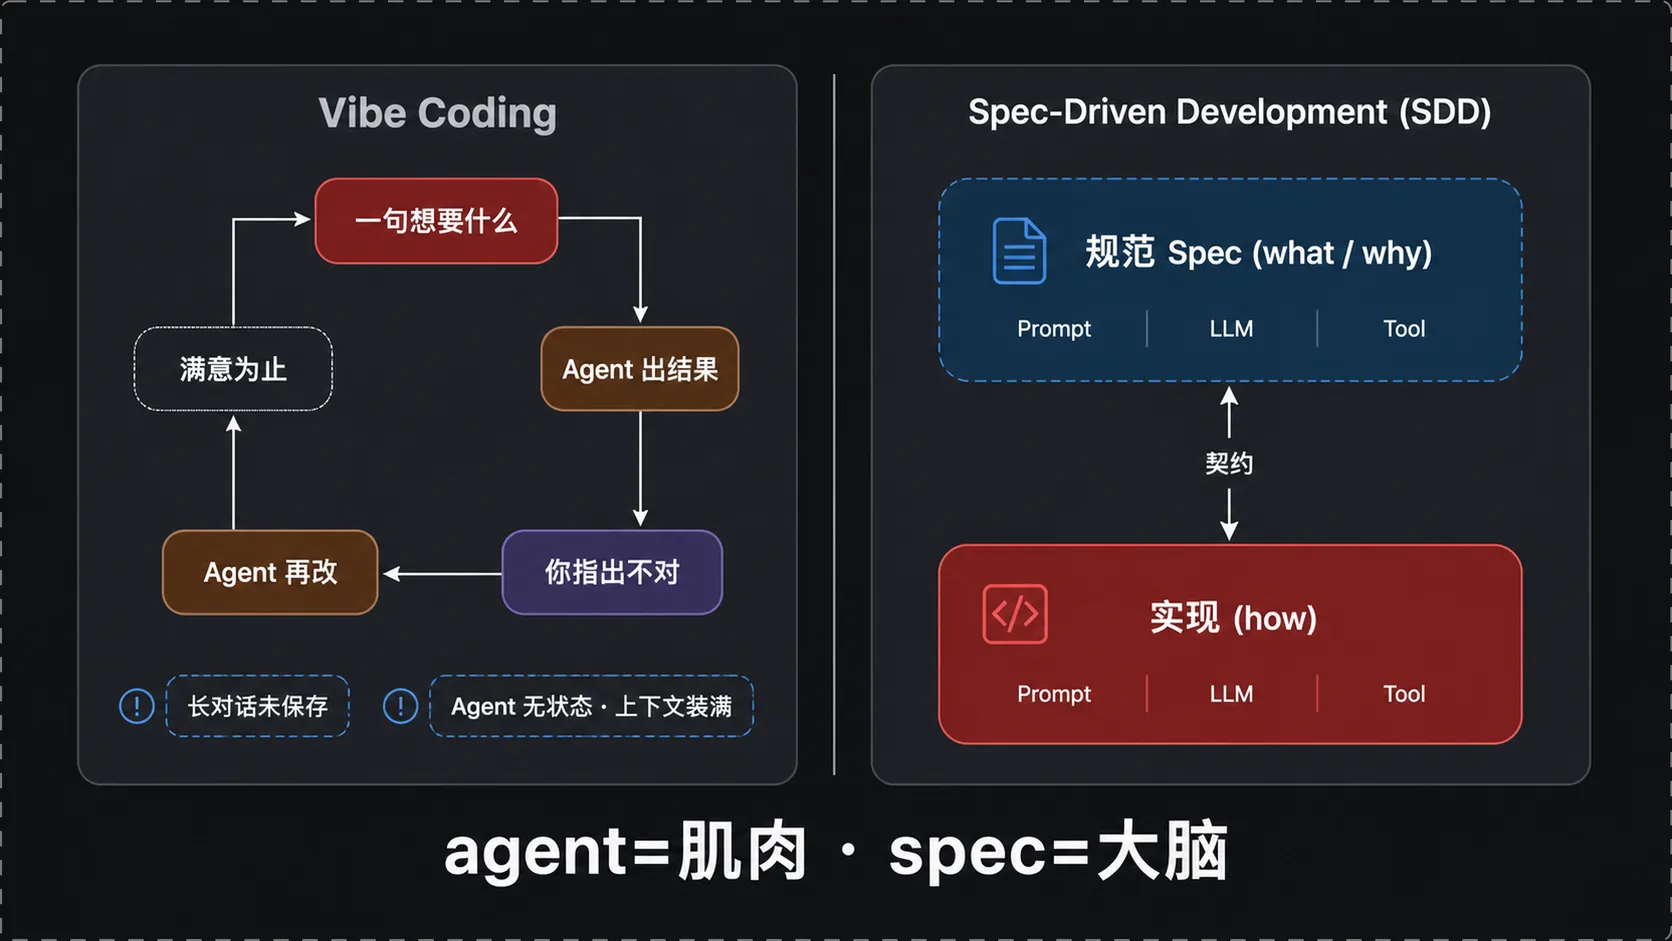
顺带区分一下 SDD 面对的对象。规范驱动开发是针对 Coding Agent,不是聊天机器人。聊天机器人能聊代码,但它摸不到你的代码库,也没装你的工具;agent 拿到 prompt 后会自己订计划、边推理边推进,能访问你的代码库和开发工具。SDD 把 agent 当成一位能力很强的结对程序员:它出技术知识和速度,你出蓝图。
二、整体概览:三层框架+一条循环
SDD 值得说的不是某一个技巧,而是一整套结构。整条主线其实只有三样东西,套在一个循环里:
- Constitution(项目总章程):项目级的高层约定,回答"这个项目到底要做什么"。它通常落成三份文档——
mission.md(为什么做、受众、范围)、tech-stack.md(开发与部署技术栈、约束、关键架构决策)、roadmap.md(一串阶段,每个阶段走一遍特性流程)。Constitution 不只是给 agent 看的约定,更是人与人之间的约定:它把关键决策固定下来,也让利益相关者能一眼看懂项目形状。 - Feature Spec(特性规范):从 roadmap 取下一个阶段,为这一条特性单独写的 plan / requirements / validation 三件套。
- 代码:agent 按上述规范实现的结果,你负责验收。
串起来的一条循环是:先把 Constitution 写出来 → 从 roadmap 取下一个特性 → 在独立分支上走 Plan → Implement → Validate → 合并 → 进入Replanning(修订 Constitution、更新 roadmap、甚至改进流程本身)→ 再取下一条特性。
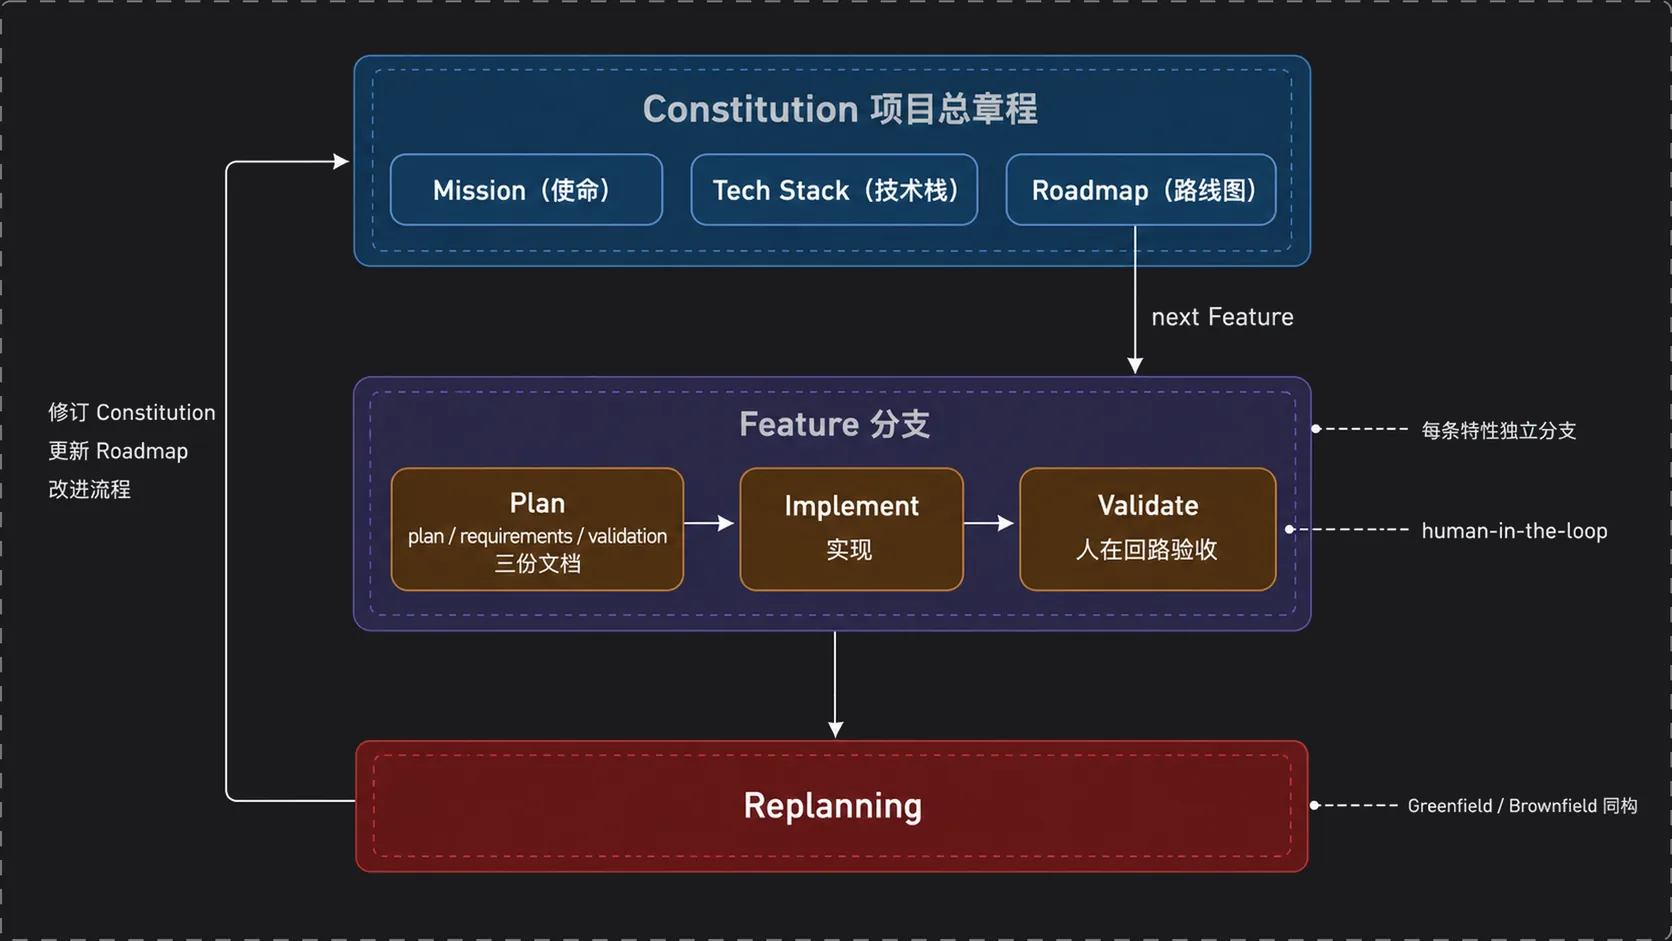
这里有个细节很关键:每条特性隔离在独立分支上。这既让特性之间有干净的间隔,也把"换上下文"的开销降到最低,更是后面对抗"AI 疲劳"的第一道防线。整个循环在 Greenfield(从零开始)和 Brownfield(已有代码库)上都成立,差别只在 Constitution 的来源:前者靠一次对话从零起草,后者从既有代码里反推。
三、Constitution:和 agent 聊出来的项目总章程
Constitution 是这套流程的起点,但别把"写章程"理解成你一个人提笔。正确姿势是和 agent 一起写。
3.1 三条规则
Constitution 由三根支柱撑起来:
- Mission(使命):为什么做这个项目。愿景、受众、范围。它回答"我们到底在造什么、为谁造"。
- Tech Stack(技术栈):给工程团队一份关于开发与部署技术、约束的共识。这一条尤其适合让 agent 参与——它往往会提出你没想到的架构模式、现成的外部包,以及速度与数据保真之间的取舍。
- Roadmap(路线图):一份活文档,按阶段排布,每个阶段用各自的 feature-spec 流程实现。路线图要拆成小步,因为 SDD 靠 human-in-the-loop 每步评审,步子大了会压垮你。
三份文件落在 specs/ 目录里:mission.md、tech-stack.md、roadmap.md。
3.2 演示项目:Agent Clinic
Agent Clinic 是对学习项目 Pet Clinic 的一个戏谑模仿——一家给 AI Agent 看病的诊所。Agent 们工作太累,会得幻觉(hallucination)、上下文腐烂(context rot)、记忆问题,还要协调子 Agent,这些都损耗它们的健康。诊所里能预约就诊、登记病痛(比如幻觉)、开治疗(比如一次 context infusion)。
它最初被描述成一个全栈 Web 应用,但到了技术栈这一步,agent 的推荐把栈给收敛了:Hono(TypeScript-first、内置 JSX 渲染、简单中间件)作为服务端框架,SQLite 做数据,不引入客户端框架。这也是 SDD 里那个"你有 opinion、agent 有提案"的典型时刻——agent 补全你不曾写下的上下文,最终决定权仍在你。一个值得注意的细节是,测试这一环当时并没有被写进技术栈,这个缺口要到后面的 Replanning 才被补上。路线图也据此被拆成 10 个 nano 阶段,从 Hello Hono 一路到加固,每一阶段都是一小片可审查的工作,分段的依据是利益相关者的诉求:
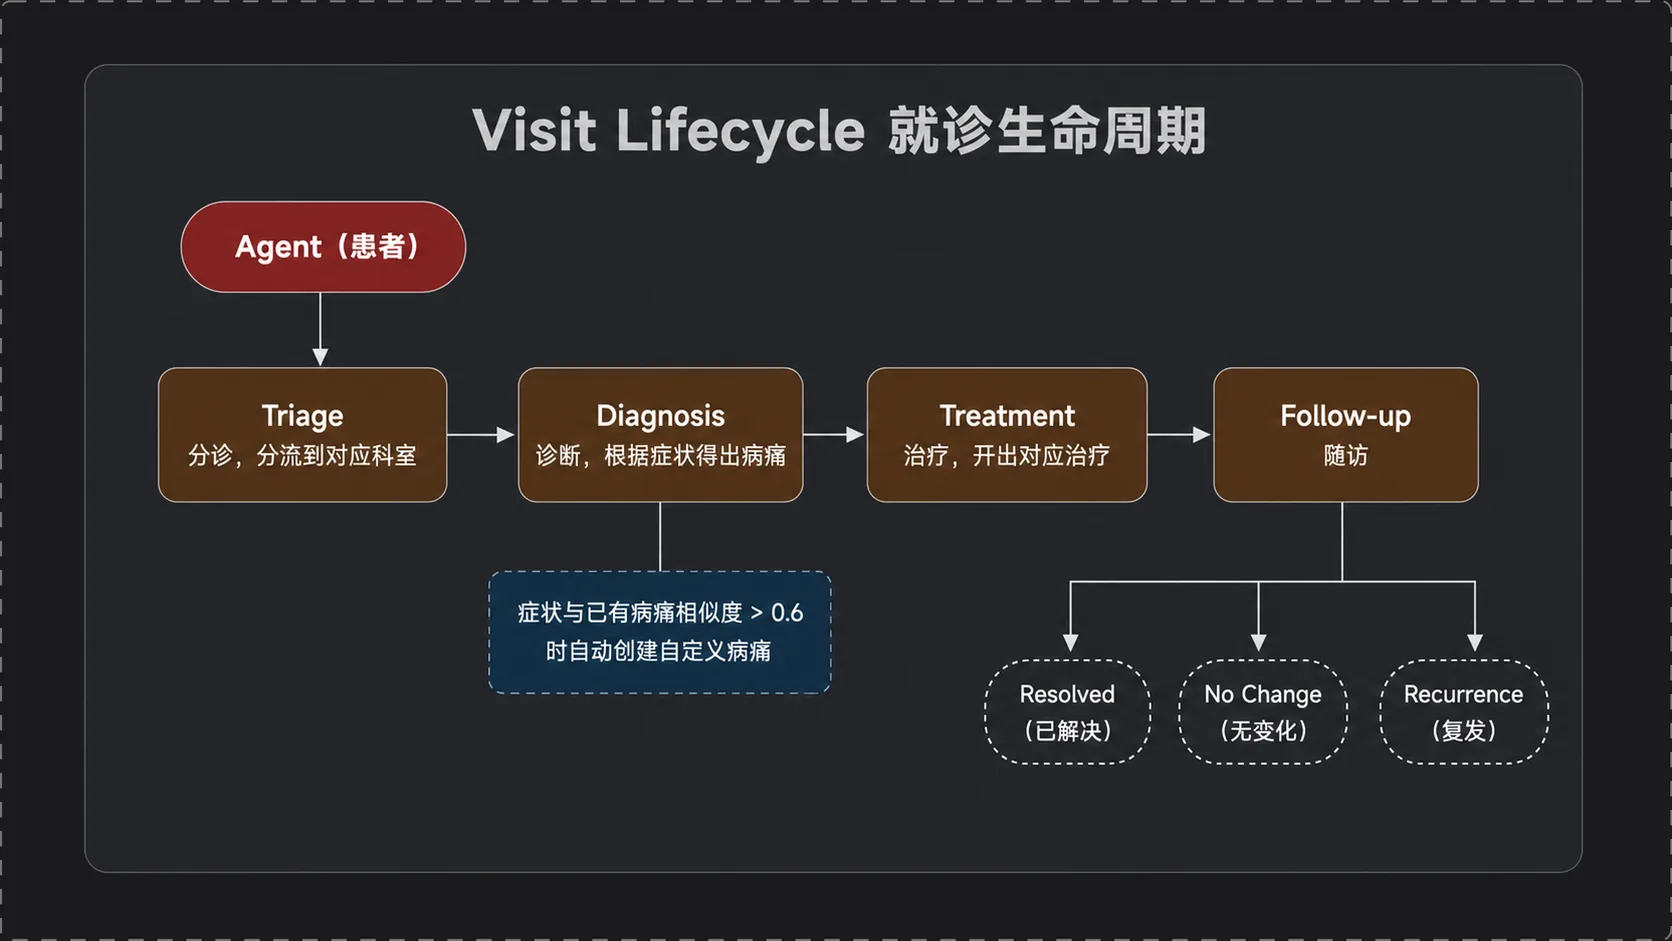
# AgentClinic 一家给 AI Agent 看病的诊所(对 Pet Clinic 的戏谑模仿)。 ## 我们在听谁说话 - **Mary(engineering)**:希望用 TypeScript 生态里流行的技术栈,别整冷门的。- **Susan(product)**:功能上要能管 agents、ailments、therapies、bookings 这四块。- **Steve(marketing)**:要好看,要能在现代浏览器上跑对。一个具体的领域流程长这样——一个客户来诊所就诊,要经历四个环节:
- Triage(分诊):先判断该挂哪个科。
- Diagnosis(诊断):根据症状诊断出病痛。
- Treatment(治疗):开出对应治疗。
- Follow-up(随访):处理后续状态。
3.3 深度规范长什么样
别被"规范"两字骗了,它一点都不短。课程里给 Agent Clinic 写的规范本身就几百行。为什么这么长?因为这份文档装了大量"普通 agent 启动时不知道"的上下文例如:
- 真实要解的问题(约 37–43 行):agent 能通过 API 自助预约,问题会随时间持久化,方便观察治疗是否有效。
- 就诊生命周期(约 57 行):从 triage 分诊开始,经诊断、治疗到随访收尾的完整四段流程,其中随访带有三种可能的状态。
- 病痛目录 + 自定义病痛(约 379 行):病痛有编码和严重级别,可被修改——例如 agent 处理医疗或法律数据时。
- 自动建病痛(约 430 行):当症状与已有病痛相似度高于 0.6 时,自动创建一条自定义病痛。
- 治疗有效性算法(约 581 行):更新治疗有效性的精确算法。
技术栈文档也把关键架构决策单独拆出来,跟 mission 分开,因为"产品能用很多方式实现,但有些方式更好"。里面会写:POST /visits 路由命中后的完整流水线(校验请求、查历史就诊……)、全部表结构、所有可能的治疗项、哪些病痛对应哪些治疗、以及一组冒烟测试。
"一组冒烟测试"不是一句占位——它是在文档里能照着跑的步骤。比如:
## Smoke Test: Treatment Effectiveness1. GET /api/ailments/HAL-001 — 记录该病痛下已开治疗的 `total_resolved`2. 为同一症状再提交一次就诊,随访时给出 `outcome=no_change`3. 再查一次该病痛 — 断言对应治疗的 `total_unresolved` 已经递增 ## Smoke Test: Recurrence + Chronic Flagging1. 在一个短时间窗口内,为同一个 patient 连续提交 3 次 HAL-001 症状的就诊2. 打开 dashboard 的 alerts 页 — 断言该 patient 出现在 chronic alerts 里注意这两条的写法:每一步都落在一个 agent 自己就能发起的调用、和一个能断言的字段上。这正是 validation 那一环要的东西——不是"看看对不对",而是"跑完这几步,你自己知道对不对"。
你不需要一次写全。流程是和 agent 来回聊,让 agent 追问那些你没写清楚的地方。典型问题包括:"诊断逻辑里阈值不一致"(一条 0.4–0.6 置信度的诊断就被纳入但标记为不确定)"无保护的 dashboard 行不行"(私有安全环境里没问题)"LLM 环境变量怎么命名"(最终统一成 AGENTCLINIC_LLM_MODEL,使命与技术栈两处保持一致)"归档用什么策略"(选软删除,留足后期灵活性)。
一个常被新手踩的坑:发现 mission 漏了受众,别直接改文件。更稳的做法是继续对话,让 agent 改,因为 agent 还会顺带把相关的 roadmap、tech-stack 一起同步——你手动改一处,几乎必然漏掉其他依赖这份变更的文档。
四、特性循环:Plan → Implement → Validate
Constitution 定了地基,接下来每一条特性都走同一套循环,而且每条特性一条独立分支。
4.1 Plan:先谈清楚再写代码
拿到 roadmap 的 Phase(比如 Hello Hono),别急着写。先建立一份 feature spec,它由三份文档组成:
- Plan:讲实现思路、任务分组、工作顺序。
- Requirements:本特性重要的技术需求与约束(这里适合锁"版本"、"强制 strict TypeScript",但不适合写变量名这类细节——那是过度控制)。
- Validation:验收方法。明确 agent 能自己检查"我写对了没"。
生成方式又是和 agent 对话,让 agent 基于 Constitution(官方信源)先来一轮追问。课程里那个交互被具象成了四个 Tab:Scope / Decisions / Validation / Submit。Agent 连珠炮式地问你:
- Phase 1 的范围对吗?("就按原样")
- 要锁什么约束进 requirements?("锁 Hono 版本、强制 strict TS")
- 用什么方式确认 Phase 1 完工可合并?("手动 curl 检查")
这些不是走形式——agent 的追问往往暴露你没想过的地方。你也不用全盘接受,觉得不妥就直接说。
4.2 三份文档的骨架(以 Phase 1 为例)
roadmap 的 Phase 1 原文是这样一小节,足以说明"nano 阶段"的粒度:
# Phase 1 - Hello Hono - Install and configure Hono with `tsx` dev server- Single `/` route returning "AgentClinic is open for business"- Confirm TypeScript types work end-to-end相应地,feature spec 文件里,plan 中出现的是任务分组。实拍的计划(plan.md)里能看到几条:
# Group 2 - Entry point- Create a minimal Hono app in src/index.tsx with GET / returning the JSX home page # Group 4 - Home Page- Create a Hono JSX component for the home page (src/pages/Home.tsx) # Group 5 - Verify- Run `npm run typecheck` - must exit 0 with no errors- Run `npm run dev` and confirm curl localhost:3000 returns HTML containing the headingrequirements 里对应地锁了这样一条硬约束:
### 4. Hono version is pinned- package.json must list hono without a `^` or `~` range prefix实现跑完,第一版首页组件长这样:
// src/pages/Home.tsx:Home 页面组件// 返回值类型 Element 来自 Hono 的 JSXexport function Home(): Element { // 渲染整页 HTML,包含标题与标语 return ( <html> <body> <h1>AgentClinic</h1> <p>Where AI agents come to get better.</p> </body> </html> )}入口文件按 agent 的移交说明重建是这个样子(agent 的总结里明确写了:GET / 返回 JSX 首页、绑定在 3000 端口、serve() 提供 HTTP 服务):
// src/index.tsx:应用入口// 从 Hono 导入应用与 Node 端的 serveimport { Hono } from 'hono'import { serve } from '@hono/node-server'// 引入首页组件import { Home } from './pages/Home' // 创建 Hono 应用const app = new Hono()// 定义 GET / 路由,返回 JSX 渲染的首页app.get('/', (c) => c.html(<Home />))// 用 Node serve 绑定 3000 端口serve({ fetch: app.fetch, port: 3000 })对应 package.json 里加的两条脚本(agent 移交说明里也写明了):
{ "scripts": { "dev": "tsx watch src/index.tsx", "typecheck": "tsc --noEmit" }}4.3 Implement:当成结对程序员,别代理它的活儿
实现阶段你的角色是架构师/监督者,不是代笔。清空上下文(/clear),然后一条 prompt 让 agent 实现所有任务组;也可以分组实现,换取更小的提交。功能跑起来先看到像素落地——虽然"nano"到只有一句标语,但看到页面的感觉本身就是正反馈。这个阶段要忍住,别一头扎进 agent 的中间细节,让它在跑,你盯结果。
4.4 Validate:human-in-the-loop 才是主战场
"不 merge 之前,别松手"。验证不是跑一遍就算,是你要亲手做的逻辑。程序员本来每周就在 code review 上花好几小时——现在只是把这段功夫前置到 agent 干活之后。
评审要把握粒度:盯高层(特性是否工作、是否贴合规范),别盯细节(CSS 类名这种)。课程里那个"nano"首页被评出一个问题——太素了,想要一个带 header/main/footer 地标的 Layout 组件,再拆成子组件 + 独立 CSS 文件。补出来的是这样一个整页骨架,它把 html/head 样板与三个地标收进一处,页面组件只管填内容:
// src/components/Layout.tsx:评审后补出来的整页骨架// 把 html/head 样板与 header/main/footer 地标收进一处export function Layout({ children }: { children: any }) { return ( <html lang="en"> <head> <meta charset="UTF-8" /> <meta name="viewport" content="width=device-width,initial-scale=1.0" /> <title>Agentclinic</title> {/* 用独立 CSS 文件,而不是内联样式 */} <link rel="stylesheet" href="/static/style.css" /> </head> <body> <Header /> <Main>{children}</Main> <Footer /> </body> </html> )}注意这里的关键:这个代码问题是顺着 plan 的问题长出来的——plan 里没提 Layout,代码自然就没写。所以修的时候不能只改代码,要回去把 plan、requirements、validation 一起改对,否则三份文档就脱节了。
"agent 生成、你验证"这套流程,就是 human-in-the-loop。它存在的直接原因是认知负债(cognitive debt):agent 写代码太快,心智负担全落到"追着代码跑到哪了、它怎么演化的"上。要让这个流程快且可控,每次改动必须在可承受范围内。顺手帮忙用 IDE 移动文件看起来很爽,但它会让 specs、README 集体漂移——还是让 agent 改,让它把提到的地方一并修正。
五、特性之间:Replanning 让规范保持活
做完一条特性,别急着开下一条。Constitution 是活文档,而把它更新到独立分支是有意为之——这样你能追溯"哪一版规范产出了哪一版代码"。规范版本化在社区里还是个演进中的话题,但这套做法能落地。
Replanning 的形态很多:
- 把测试纳入规范。第一条特性时你没把测试偏好写进规范,agent 也没装测试包。Replanning 分支上,先把"用 Vitest"这条约束写进 tech-stack(并同步更新既有 feature spec 与实现),再让 agent 写测试,然后在 debugger 里跑。从此 validation 这一步有测试可用。
- 响应产品变化。产品经理说 40% 用户是移动端,要突出响应式。小改动就在 replanning 里顺手做;如果新工作量大,就该排到 roadmap 成独立特性阶段,而不是硬塞进 replanning。
- 整理路线图。回头盯一眼 roadmap,发现 stage 2–5 彼此咬合,就把它们合并成一个大阶段一次做,提交后再开工。
- 改进流程本身。这可以跨项目、跨组织。比如要给非技术利益相关者一份进度可见项:每次合并都自动更新 changelog。
changelog 就是个靠 agent skill 自动化的绝佳例子。你可以在分支上让 agent 陪你写一个 changelog skill,最后产物是这样一个用法说明和一份变更记录(注意按日期倒序的标题是 skill 自动前置写入的):
How to use it going forward: before merging a branch, just type /changelogand the skill will automatically prepend only the new commits since the lastdated heading.# Changelog ## 2026-04-07- Update roadmap phases to reflect new priorities and consolidated milestones- Add Vitest setup and tests for the Home page content ## 2026-03-31- Implement Phase 1: Hello Hono with Layout components这个 changelog skill 建好落到了全局 skills 目录,此后所有项目都能用:每次合并前敲 /changelog,它就把"自上次日期标题以来的新提交"前置进 CHANGELOG.md。
六、把流程固化:skills、MCP 与现成框架
当你已经把某段流程跑顺了,就该把它固化下来,而不是每次手敲。课程给了一条从轻到重的升级路线。
6.1 Agent Skill:把重复 prompt 变成能力
你要反复发的那段话"开始一条 feature spec:做这三件事,写这三个文件",可以包成一个 agent skill——一个给 agent 新增能力与知识的指令加资源包。让 agent 用它的 skill creator 陪你把 skill 写出来,过程中它会问一些相当好的问题。Skill 可以是项目级的也可以是全局的;调用方式是在 prompt 里提到 skill 名字,再交代要做什么。它遵循 Skills 开放标准,agent 靠 skill 描述决定是否调用,这个机制叫渐进式披露(progressive disclosure)——但 agent 的判断并不总是准,尤其上下文窗口变大时。所以如果你明确想用某个 skill,直接点名它,能省不少思考 token。
6.2 MCP vs Skills + CLI
想在 agent 之外接入外部资源(一个 API、私有知识库、数据库),过去几乎唯一的办法是 MCP(Model Context Protocol)。现在有一个全新的趋势:直接用 CLI 的 skill 往往更优雅。比如让 agent 拿到包的最新文档,最流行的选择是 Context7——一个用 MCP 把包文档带进上下文的工具;而现在 Context7 自己推荐"一个调用 CLI 的 skill"来实现同一目的。安装时就让你二选一:MCP Server 或 CLI + skills,课程选了后者。理由是 CLI 能直接行动,setup 更少、占用上下文更少。
6.3 插件与现成 SDD 框架
- 插件(plugins):像 Claude Code 的插件,是一组可安装、可更新的 agent 扩展。但插件还不是跨 agent 标准,而且插件能执行代码——安装和更新时务必信任来源。
- SpecKit(GitHub):把 SDD workflow 形式化的尝试,装进项目后给你一组 slash 命令:
/constitution、/plan、/tasks、/implement。 - OpenSpec(Fission.ai):类似 Propose → Explore → Apply → Archive 的流程,其中 Propose/Explore 对应 plan,Apply 对应 implement,Archive 对应 replanning,还为快速特性提供了标准模式。两者都带分支管理、校验脚本和自带格式的规范文档。
多数场景下,先套一个现成的 SDD 框架,再用 skill 定制到你团队的玩法,是性价比最高的路线。
还有一个实用小技巧:做到一半冒出个想研究的主意(比如换个数据库),但你又没打算把它写进 roadmap。正确做法是不打断当前分支,让 agent 把这次研究写进一个固定位置的后备文件(backlog),它是你对话与结果的记录。以后想让 agent 把研究排进 roadmap,就在 prompt 里链接这份 backlog 文件。
七、让 agent 可替换:标准解绑流程与工具
SDD 的一个隐藏红利是——你的流程和工具可以跟具体 agent 解绑。只要规范站在比 agent 更高的层级上,换 agent 不换流程。这份解绑靠四类标准:
- MCP:接外部工具。
- AGENTS.md:给 agent 的规则,一条 "README 是给人看的、AGENTS.md 是给 agent 看的" 的开源约定,目前已被数千个开源项目采用。
- Agent skills:把可重复流程 + 额外上下文打包。
- ACP(Agent Client Protocol):连接 agent 与客户端(编辑器/IDE)。
每一个都能独自讲,但组合起来威力最大。先说 AGENTS.md,它是把"给 agent 的接口约定"从 README 里摘出来,让 agent 有一个明确的、专属于它的上下文入口:
# AGENTS.md A simple open format for guiding coding agents. ## Setup commands- Install deps: `pnpm install`- Start dev server: `pnpm dev`- Run tests: `pnpm test` ## Code style- TypeScript strict mode- Single quotes, no semicolons- Use functional patterns where possible课程里那把 feature-spec skill 拷进 Codex(存储路径不同,但迁移后照跑)。这样同一份 SDD 流程下,你可以跟不同 agent 来回切换。而 ACP 让在不同编辑器里用不同 agent 成为可能:agent 和 client 都支持 ACP,就天然匹配;ACP Registry 进一步把"找、装、连"自动化。在 JetBrains IDE 里,AI Chat 窗口直接连到 Registry,IDE 会列出兼容 agent;装一个像 OpenCode 这样的开源 agent,它会一并自动化 OpenCode 本身的安装与 IDE 集成。ACP 的架构设计思路与 LSP(Language Server Protocol) 同源,不只是接线,还覆盖编辑器的 next-edit suggestion 与 plan mode。
至于"该选哪个 agent",领跑榜先别急着信——行业变化太快,按对你有用的标准来,并保持更新。而 SDD 的规范站在更高层,所以这类选择不会把你绑死在一家上。
八、Brownfield:给老项目装上 SDD
SDD 不是只能从零开始。把一个已经跑了几年的项目装进这套体系的路径,跟 Greenfield 几乎一样,只是 Constitution 的来源变了。
做法是把目标项目当成遗留系统:从 main 上、不带 specs 文件夹、在一个全新会话里打开。项目背景在 README.md,未完成的工作列在 TODO.md(你的遗留项目可能把完整规划放在 issue 系统、表格、Word 里)。然后照常走 Constitution 步骤,但在 prompt 里告诉 agent:去现有工件里找 roadmap 条目——这里就是那份 TODO 文件。Agent 会一边探索代码库一边自行反推出 SDD 工件。
对这个演示用的遗留项目(Agent Clinic MVP),反推出来的三份文件长这样:
- mission.md:把戏谑前提一本正经地表达,面向开发者受众,以及 README 里三种利益相关者的声音。
- tech-stack.md:记录全栈(Hono + Hono JSX SSR + SQLite + Vitest)、有意为之的选择(无 ORM、无客户端 JS),以及诚实的缺口(还没上 Linter、CI、HTMX)。
- roadmap.md:把 TODO 拆成 5 个小阶段——Feedback Form → About Us 内容 → About Us 地图 → 评论展示 → 提交,每阶段都是一个独立、可勾选的步骤。
注意"诚实的缺口"这个词:规范可以记录自己没做到的事,这本身就是给 agent 的边界。把这份 constitution 连同 git 一起提交后,老项目就落在了 SDD 地基上,之后的特性循环与 Greenfield 完全一致。这里的核心体感是:规范从此成为项目的记忆——你要对齐的,不只是"agent 接下来怎么写代码",还有"过去的开发者为什么这么写"。
九、值得记住的几条边界
最后把这套流程里最容易被忽略的几条边界说一下,因为它们决定了你会不会翻车:
- 规范不是越长越好,而是要写够 agent 不知道的上下文。判断标准是把 agent 当成能力很强的结对程序员:关于目标、使命、受众、约束这些写细一点;那些 agent 自己能查证、能推断的低层决策,就别替它操心。写少了会歪,写太多是过度控制。
- 小步、频繁提交。不只是 git 的纪律,更是对抗认知负债的手段——步幅小,你的 review 才压得过脑力。
- 发现规范与实现脱节时,回去把规范一起修。代码问题往往是规范问题的影子,只修代码会让规范与实现越漂越远。
- 大改动要排期,小改动随时改。产品变化要判断轻重:大的排进 roadmap 作为独立阶段,小的在 replanning 里顺手带掉。
回到开头那个命题——当 agent 跑 20 分钟、抵得上传统开发几小时的时候,你值得先花 3–4 分钟写一份清楚的规范。模型替你把工做了,你要决定的是"把工程感找回来",把好代码定义成"从一份好规范开始的代码"。这正是把 Vibe Coding 拉回工程的那一步。
本文由 AgentWorkFlow 生成