
文章内容
- 一、为什么要给 RAG 一张图
- 1.1 纯向量检索的两个短板
- 1.2 知识图谱:节点和关系都是一等数据
- 1.3 从 JOIN 爆炸到模式匹配
- 二、Cypher:跟图对话的基本功
- 2.1 从数数开始的模式匹配
- 2.2 关系模式:人的角色由关系决定
- 2.3 改数据:DELETE、CREATE 和幂等的 MERGE
- 三、给图装上语义:向量嵌入
- 四、从文档到图:把 SEC 10-K 切成 Chunk 节点
- 4.1 数据与清洗
- 4.2 切块入库:每块一个 Chunk 节点
- 4.3 Neo4j 兼任向量库
- 五、把文档结构编码进图:NEXT、PARTOF 与上下文窗口
- 5.1 Form 节点与三种关系
- 5.2 路径与窗口:图的语法在这里显出威力
- 5.3 retrievalquery:把邻居拼进 RAG 上下文
- 六、图谱生长:从文档图到实体图
- 6.1 Form 13:把公司和管理人接进图
- 6.2 全文索引:另一把检索的刀
- 6.3 多跳探索:从一块文本走到 561 个投资者
- 6.4 图扩展上下文:只在问题相关时生效
- 七、和图对话:Text2Cypher
- 7.1 从 MVG 起步的建图方法论
- 7.2 地理查询:point.distance 就是「空间的向量搜索」
- 7.3 few-shot:教一句,会一类
- 八、让建图自动化:Agent 与多智能体架构
- 8.1 Agent 是一种新的控制流操作符
- 8.2 Google ADK:把 agent 写出来的最小闭环
- 8.3 委派:agent 之间的控制权移交
- 8.4 session state:跨 agent 的共享记忆
- 九、五个专用智能体:把决策环节逐个交给 agent
- 9.1 User Intent Agent:用工具守住「人批准」这一关
- 9.2 File Suggestion Agent:从 memory 取上下文,给文件访问加护栏
- 9.3 Schema Proposal:批评者模式与「循环封装成工具」
- 9.4 Entity & Fact Type Proposal:非结构化分支的姊妹篇
- 十、执行与装配:从计划到三层图
- 10.1 构建领域图:确定性的代码,不需要 LLM
- 10.2 SimpleKGPipeline:Markdown 进词汇图和主题图
- 10.3 实体解析:把两套图对齐
- 十一、总结
一、为什么要给 RAG 一张图
1.1 纯向量检索的两个短板
向量 RAG 的标准流程大家都熟:文档切块(chunk)、每块算嵌入(embedding)、问题也算嵌入、按余弦相似度捞回最相近的几块,塞进 prompt 让 LLM 作答。这套流程在课程里先跑了一遍:NetApp 的 10-K 文件,Item 1 章节切成 254 块,全部写入 Neo4j 并建好向量索引,套上 LangChain 的 RetrievalQAWithSourcesChain。问「NetApp 的主营业务是什么」,回答正确——企业存储与数据管理、云存储和云运维;问总部在哪,San Jose, California,也没问题。
问题出在下一个提问。问「告诉我 Apple 的情况」,模型给出的描述和 NetApp 几乎一样:云优先、以数据为中心的软件公司。库里没有任何 Apple 的文本,LLM 拿着「NetApp 的业务描述」当模板,硬套给了 Apple。这是向量检索的第一个短板:它只负责「找到相似的文本」,找到什么就给 LLM 什么,而 LLM 倾向于把检索结果当事实,没有就编。课程里的修复办法是在 prompt 里加一句「不确定就回答不知道」,之后同样的提问只得到 I don't know about Apple.——诚实了,但也说明这套系统回答不了它没见过的东西。
第二个短板更根本。有些问题的答案不在任何一段文本里,而在文本之间的连接处:「哪个州的投资公司最多」「Santa Clara 十公里内有哪些公司」「某家公司的投资者都有谁」。这些答案没法靠相似度匹配文本得到,因为它们是实体之间的关系。两个短板指向同一个方向:检索系统需要一种能表达「关系」的数据组织方式。
1.2 知识图谱:节点和关系都是一等数据
知识图谱的形态不复杂。信息被组织成节点(node)和关系(relationship):节点代表事物,比如一个人、一家公司;关系代表事物之间的连接,比如雇佣、购买、持有股份。关键是两者地位对等——在 Neo4j 这类图数据库里,关系不是像关系型数据库那样靠两张表共享外键来「暗示」的,它本身就是一条数据记录:有方向、有类型、可以挂属性。Person 节点存姓名、邮箱;Company 节点存员工数、年收入;两者之间的「雇主-雇员」关系上可以存职位和入职日期。节点用标签(label)分组,属性是节点或关系内部的键值对。
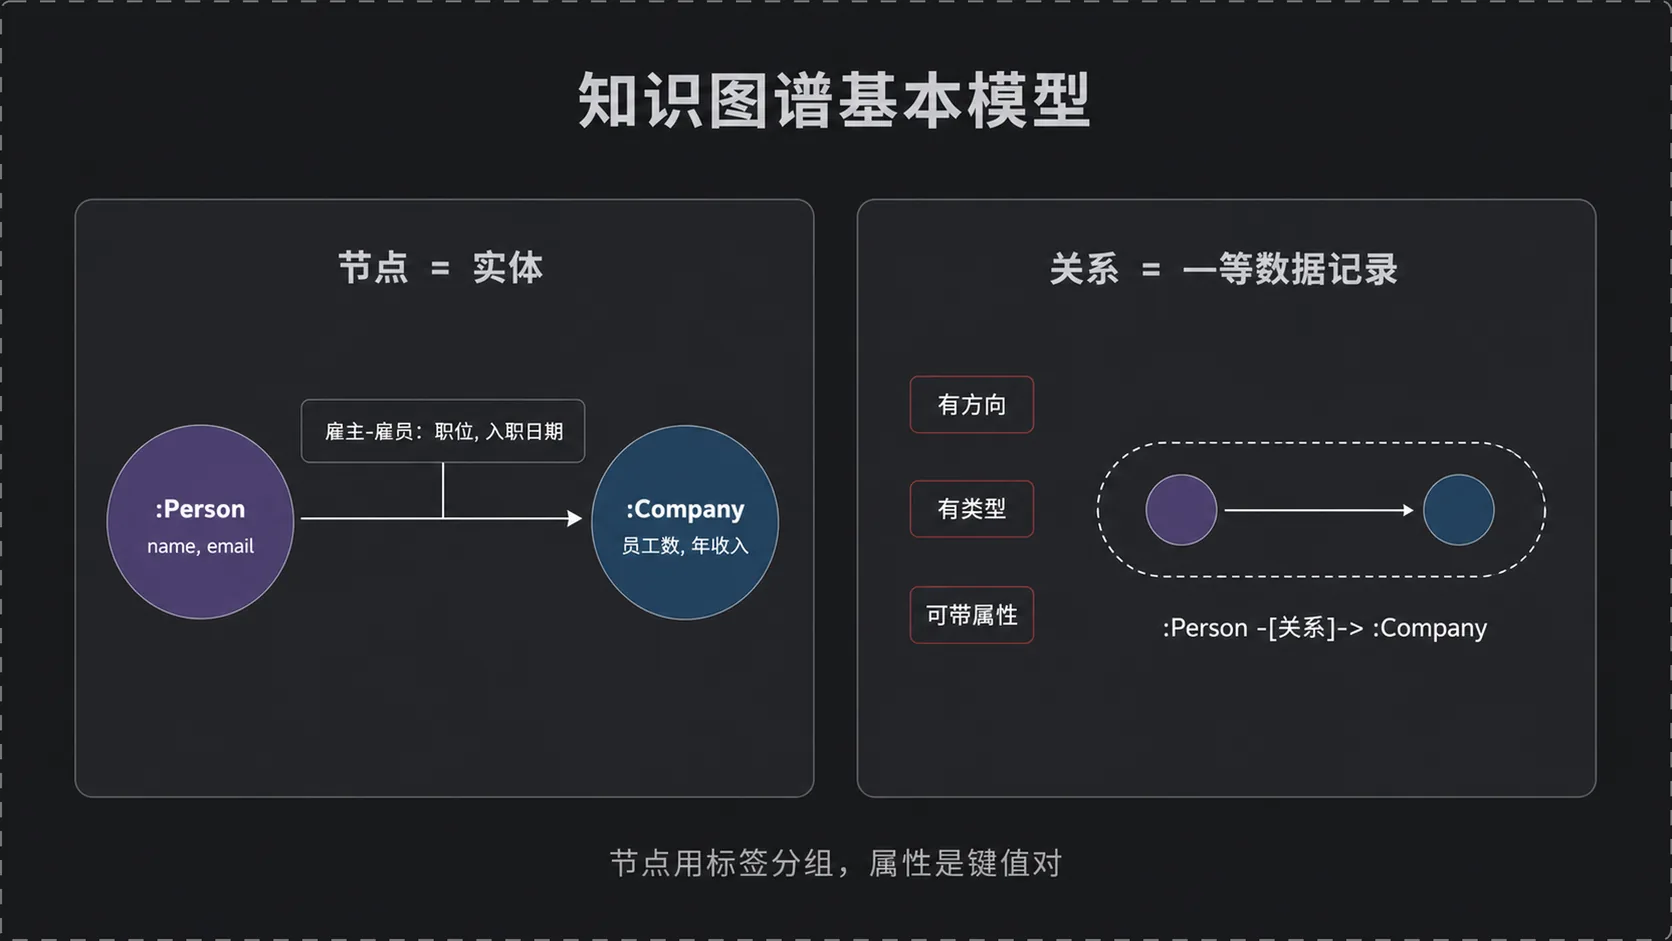
这套模型并不小众。课程里给了一个日常佐证:在搜索引擎搜一个名人,右侧那张信息卡片——出生年份、代表作品、关联人物——背后的数据就是知识图谱,电商搜索同理。关系在图里是一等公民,直接带来的好处是深层关系查询快:数据库沿着关系指针走,不用做表连接(JOIN)。
1.3 从 JOIN 爆炸到模式匹配
课程用一组购物数据演示了从关系表到图的转换。关系型建模是三张表:Person、Product、连接表 Person_Product。问「ABK 买了哪些产品」只需一次 JOIN。但「谁还买了 ABK 买过的产品」要把 Person_Product 和自己再连接一次,「该给 ABK 推荐什么」还得排除他自己买过的——问题每深一层,JOIN 多一圈,SQL 的可读性断崖式下降。
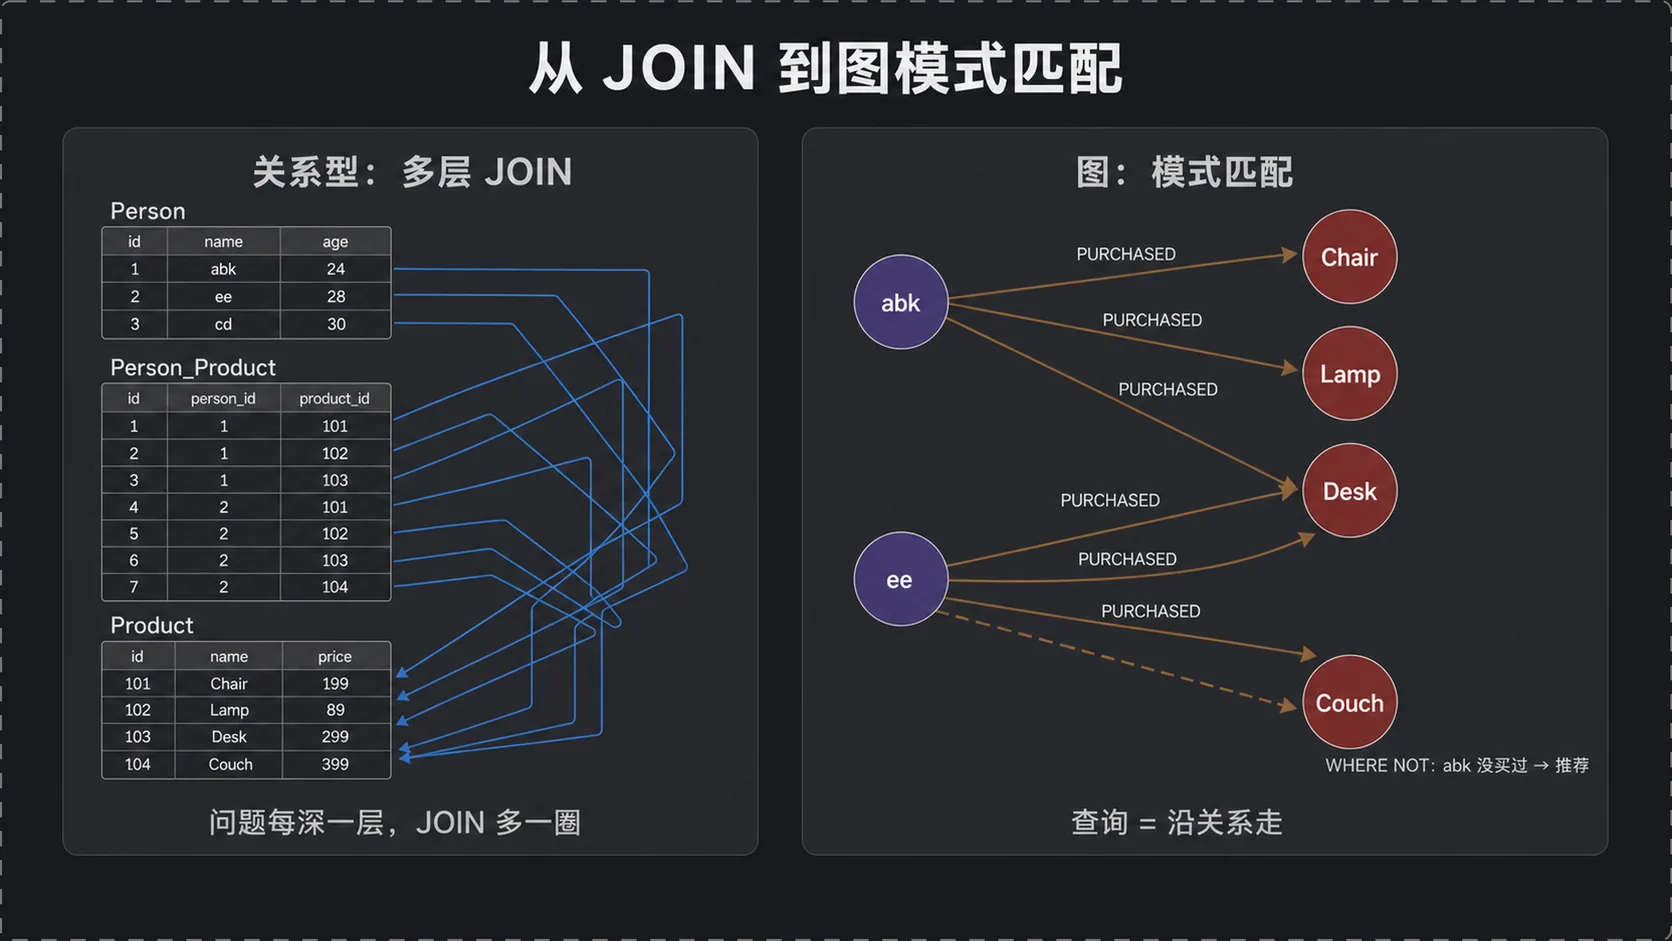
同样的数据放进图里:每个购买记录变成一条 PURCHASED 关系,查询变成模式匹配。推荐这个场景可以写成一条 Cypher(Neo4j 的图查询语言):
// ABK 买过的商品,反向再找同样买过这些商品的其他人MATCH (abk:Person {name:"ABK"})-[:PURCHASED]->(abkProducts)// 反向沿 PURCHASED 找到同样买过这些商品的其他人 <-[:PURCHASED]-(otherPeople)// 其他人买过的其他商品MATCH (otherPeople)-[:PURCHASED]->(otherProducts)// 负模式:把 ABK 自己买过的商品排除,剩下的就是推荐WHERE NOT (abk)-[:PURCHASED]->(otherProducts)// 返回推荐商品RETURN otherProductsWHERE NOT (...) 是负模式匹配:要求图上不存在这样一条关系。这条查询在数据里能直接推出「给 ABK 推荐 Couch」——另一个人 ee 买过 ABK 买的所有东西,还多买了一台 Couch。SQL 里这要好几层 NOT IN 子查询,图里就是「沿着关系走,别走到这里」的一句话。
Cypher 还有个对生成式 AI 友好的特性:查询语句几乎可以照着读出来——「匹配一个叫 ABK 的人,他买过什么东西……」。自然语言和查询语言距离很近,这让后面第 7 章的「让 LLM 直接写 Cypher」成为可能。
二、Cypher:跟图对话的基本功
课程的电影数据集有 171 个节点:38 部电影(:Movie)和 133 个人(:Person)。所有实验通过 LangChain 的 Neo4jGraph 封装执行,连接信息放在环境变量里。复现前先准备一份 .env,全文用到的变量就这些:
# --- Neo4j 连接(第 2~7 章)---# Aura 实例的连接串NEO4J_URI=neo4j+s://xxxxxxxx.databases.neo4j.io# 数据库用户名NEO4J_USERNAME=neo4j# 数据库密码NEO4J_PASSWORD=你的密码# 数据库名NEO4J_DATABASE=neo4j # --- OpenAI(第 3~7 章的嵌入、对话与 Text2Cypher)---# OpenAI 的 API keyOPENAI_API_KEY=sk-xxxx # --- Google ADK(第 8~10 章的多智能体部分,走 OpenAI 时可省略)---# Google AI Studio 的 API keyGOOGLE_API_KEY=xxxx用 Aura 时 NEO4J_URI 以 neo4j+s:// 开头,自建 Docker 通常是 bolt://localhost:7687。依赖分三组,对应文章的三个阶段:
# 第 2~7 章:LangChain + Neo4j + OpenAI# 一次装齐第 2~7 章的依赖pip install langchain langchain-community langchain-openai neo4j python-dotenv # 第 10 章非结构化管线:Neo4j 官方 GraphRAG 库# GraphRAG 库加键名模糊匹配库pip install neo4j-graphrag rapidfuzz # 第 8~10 章多智能体:Google ADK# 安装 ADKpip install google-adk三套库的 API 都在快速演进(尤其 LangChain 的 Neo4j 集成包路径),建议按课程仓库的 requirements.txt 锁版本再跑。
# 标准库:读环境变量import os# 从 .env 文件加载环境变量from dotenv import load_dotenv# LangChain 对 Neo4j 的图封装from langchain_community.graphs import Neo4jGraph# 读取 .env(文件名取自课程笔记本,换成自己的 .env 路径即可)load_dotenv('../.env.studiomac', override=True)# 从环境变量读出四项连接配置NEO4J_URI = os.getenv('NEO4J_URI')# 数据库用户名NEO4J_USERNAME = os.getenv('NEO4J_USERNAME')# 数据库密码NEO4J_PASSWORD = os.getenv('NEO4J_PASSWORD')# 数据库名NEO4J_DATABASE = os.getenv('NEO4J_DATABASE') # 建立 kg 连接对象,后续用 kg.query(cypher) 执行查询kg = Neo4jGraph(url=NEO4J_URI, username=NEO4J_USERNAME, # 传入密码与库名 password=NEO4J_PASSWORD, database=NEO4J_DATABASE)包路径提示:课程录制时 Neo4jGraph、Neo4jVector 都在 langchain_community 下,后来 LangChain 把 Neo4j 集成拆到了独立的 langchain-neo4j 包,对应写法是 from langchain_neo4j import Neo4jGraph, Neo4jVector。两种写法参数一致,本文沿用课程里的旧路径;如果你的环境报弃用警告或 ImportError,换新包名即可。
2.1 从数数开始的模式匹配
探索一张陌生的图,第一步是数节点:
# 定义 Cypher:匹配所有节点并计数cypher = """ // 匹配图中的节点 MATCH (n) // 返回结果 RETURN count(n) AS numberOfNodes // 查询字符串结束 """# 执行查询,结果是一个列表包字典result = kg.query(cypher)# 结果形如 [{'numberOfNodes': 171}]print(f"There are {result[0]['numberOfNodes']} nodes in this graph.")把 (n) 换成 (m:Movie) 就只统计带 Movie 标签的节点(38 部),(p:Person) 统计人(133 个)。精确匹配一个已知实体,用花括号写属性:
# 定义 Cypher:匹配 name 属性精确等于 Tom Hanks 的 Person 节点cypher = """ // 匹配图中的节点 MATCH (tom:Person {name:"Tom Hanks"}) // 返回结果 RETURN tom // 查询字符串结束 """# 执行后返回 [{'tom': {'born': 1956, 'name': 'Tom Hanks'}}]kg.query(cypher)不知道精确值时用 WHERE 做范围条件,比如 90 年代的电影:WHERE nineties.released >= 1990 AND nineties.released < 2000。
2.2 关系模式:人的角色由关系决定
电影图里的 Person 和 Movie 之间有五种关系:ACTED_IN、DIRECTED、WROTE、PRODUCED、REVIEWED,另外还有 Person 指向 Person 的 FOLLOWS。同一个人可以同时挂好几种关系——Tom Hanks 既出演又制片。这意味着「演员」不是一个存储在节点上的字段,而是由关系动态决定的角色。用箭头写出关系模式就能查:
# 定义 Cypher:匹配演员-出演-电影的二元组,限制返回 10 条cypher = """ // 匹配图中的节点 MATCH (actor:Person)-[:ACTED_IN]->(movie:Movie) // 返回结果 RETURN actor.name, movie.title LIMIT 10 // 查询字符串结束 """# 执行,结果以黑客帝国系列演员为主kg.query(cypher)反向箭头 <-[:ACTED_IN]- 让查询沿关系往回走。把两个方向接起来,就是「Tom Hanks 的合作演员」:先从 Tom Hanks 走到他演的电影,再从电影反向走回所有演过这些电影的人。
# 定义 Cypher:Tom Hanks 出演的电影 m,再匹配同样出演 m 的合作演员cypher = """ // 匹配图中的节点 MATCH (tom:Person {name:"Tom Hanks"})-[:ACTED_IN]->(m) // 反向沿关系匹配 <-[:ACTED_IN]-(coActors) // 返回结果 RETURN coActors.name, m.title // 查询字符串结束 """# 返回合作演员与电影名kg.query(cypher)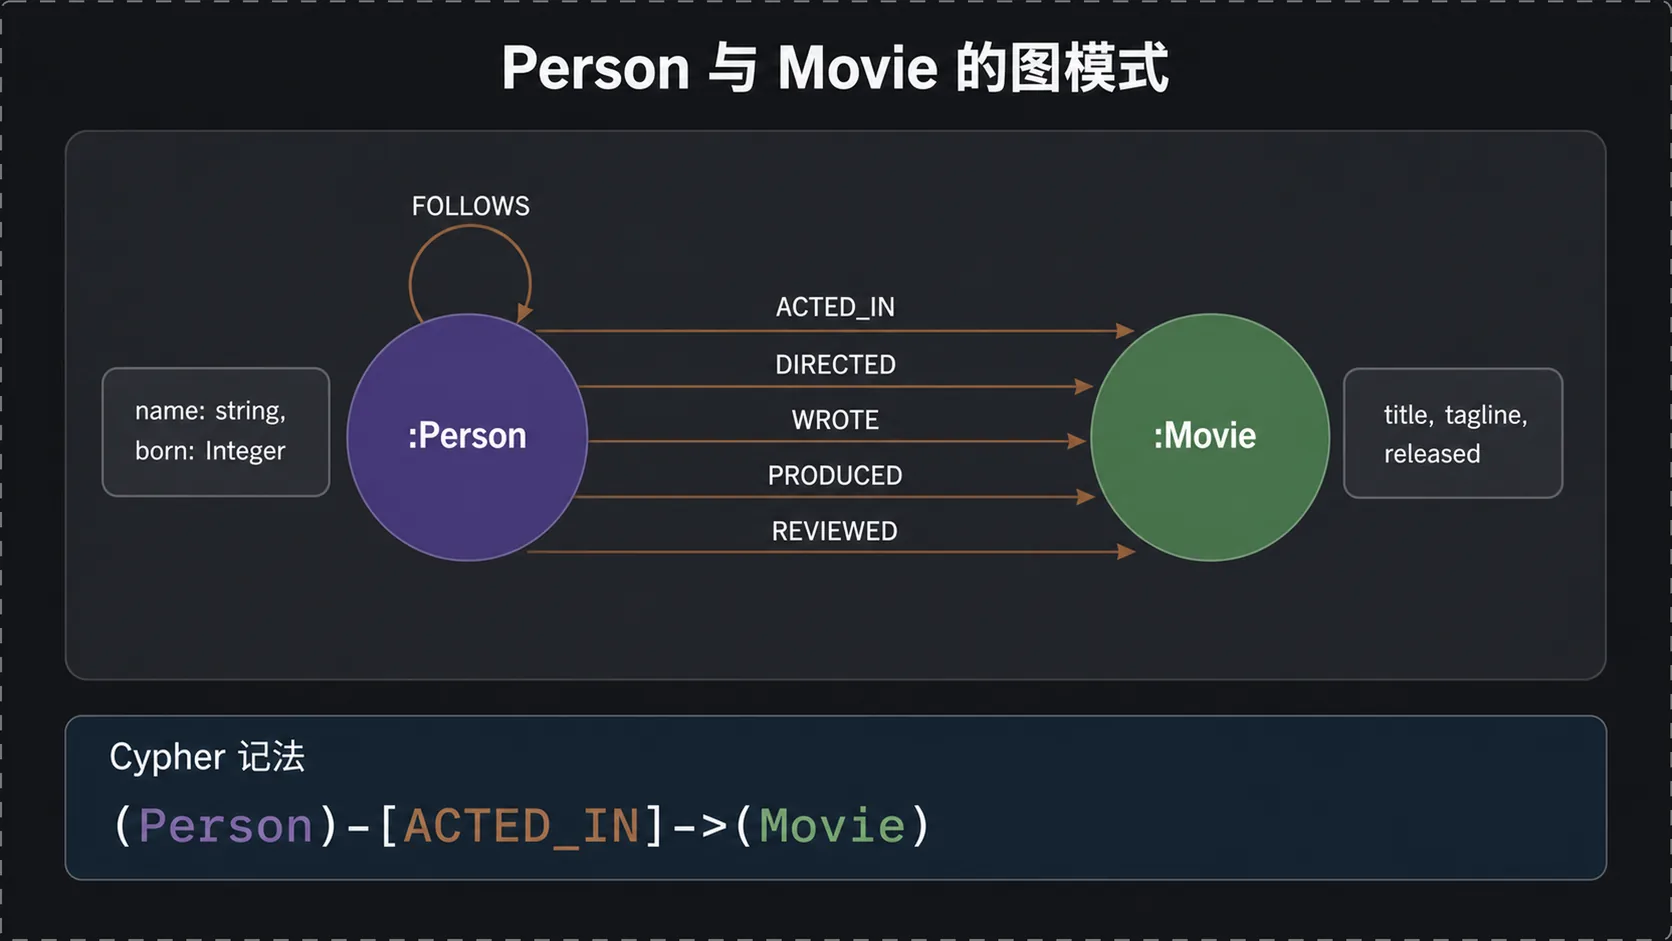
2.3 改数据:DELETE、CREATE 和幂等的 MERGE
Cypher 不只是查询语言,MATCH 模式换掉 RETURN 就变成写操作。课程里有个顺手的演示:先查出 Neo4j 创始人 Emil Eifrem 唯一一条 ACTED_IN 关系,把 RETURN actedIn 换成 DELETE actedIn 删除,再跑原查询验证结果为空。
创建数据有两个原语。CREATE 无条件创建;MERGE 等价于「匹配到就复用,匹配不到才创建」,天然幂等,是往图里写数据的主力(第 4 章起所有导入都靠它):
# 定义 Cypher:无条件创建一个 Person 节点cypher = """// 无条件创建CREATE (andreas:Person {name:"Andreas"})// 返回结果RETURN andreas // 查询字符串结束 """# 执行后返回新建节点kg.query(cypher) # 定义 Cypher:匹配 Andreas 与 Emil 两个节点,幂等地创建 WORKS_WITH 关系cypher = """// 匹配图中的节点MATCH (andreas:Person {name:"Andreas"}), (emil:Person {name:"Emil Eifrem"})// 幂等创建:存在则复用,不存在才建MERGE (andreas)-[hasRelationship:WORKS_WITH]->(emil)// 返回结果RETURN andreas, hasRelationship, emil // 查询字符串结束 """# 重复执行不会产生重复关系kg.query(cypher)三、给图装上语义:向量嵌入
第 2 章的图只能按结构和属性查。要让「What movies are about love?」这种语义问题也能问,需要给图里的文本字段补上向量。课程拿 Movie 节点的 tagline(标语)字段做实验,分三步。
本章两个代码块都会用到 OPENAI_API_KEY 这个 Python 变量,它和 Neo4j 连接信息一样来自 .env:
# 从环境变量取出 OpenAI 的 API key,供后续以查询参数的形式传给数据库OPENAI_API_KEY = os.getenv('OPENAI_API_KEY')第一步,建向量索引。维度 1536、余弦相似度,这两个参数对应 OpenAI 嵌入模型的默认配置:
# 执行建索引语句:在 Movie 节点的 taglineEmbedding 属性上建向量索引kg.query("""# 执行查询CREATE VECTOR INDEX movie_tagline_embeddings IF NOT EXISTS// 索引作用的目标节点FOR (m:Movie) ON (m.taglineEmbedding)// 索引配置项OPTIONS { indexConfig: { // 向量维度 `vector.dimensions`: 1536, // 相似度函数 `vector.similarity_function`: 'cosine'// 子查询结束}}// 查询字符串结束""")IF NOT EXISTS 保证脚本重跑不报错。跑完 SHOW VECTOR INDEXES 能看到索引状态 ONLINE、填充比例 100%。
第二步,为每部电影算嵌入并写回节点。这是三段式查询:过滤出有标语的电影,在图内直接调用 OpenAI API 算向量,把向量写进专用属性:
# 执行填充查询:三步依次是过滤、编码、写入kg.query(""" # 执行查询 MATCH (movie:Movie) WHERE movie.tagline IS NOT NULL // 中间投影:把当前结果传给下一步 WITH movie, genai.vector.encode( # 待编码的文本字段 movie.tagline, // 指定嵌入供应商 "OpenAI", // 以字典形式传入 API token {token: $openAiApiKey} # 把编码结果命名为 vector ) AS vector // 调用内置过程 CALL db.create.setNodeVectorProperty(movie, "taglineEmbedding", vector) // 查询字符串结束 """, # 以字典传入查询参数 params={"openAiApiKey":OPENAI_API_KEY})genai.vector.encode 是 Neo4j 的 GenAI 插件函数,在数据库内部调 OpenAI 生成嵌入;db.create.setNodeVectorProperty 把结果写入节点——向量必须写进这种专用属性才能被索引收录。两个前置条件值得点明:实例要装了 GenAI 插件(Aura 默认可用,自建 Docker 需显式加载);更重要的是,发起 OpenAI 请求的是数据库进程而不是你的笔记本,数据库所在网络必须能出网访问 OpenAI,否则这条查询直接失败。环境不允许数据库出网时,等价做法是在 Python 侧算好向量,再作为参数传给 db.create.setNodeVectorProperty。参数用 $openAiApiKey 占位、Python 侧以 params 字典传入,API key 不会硬编码进查询文本。
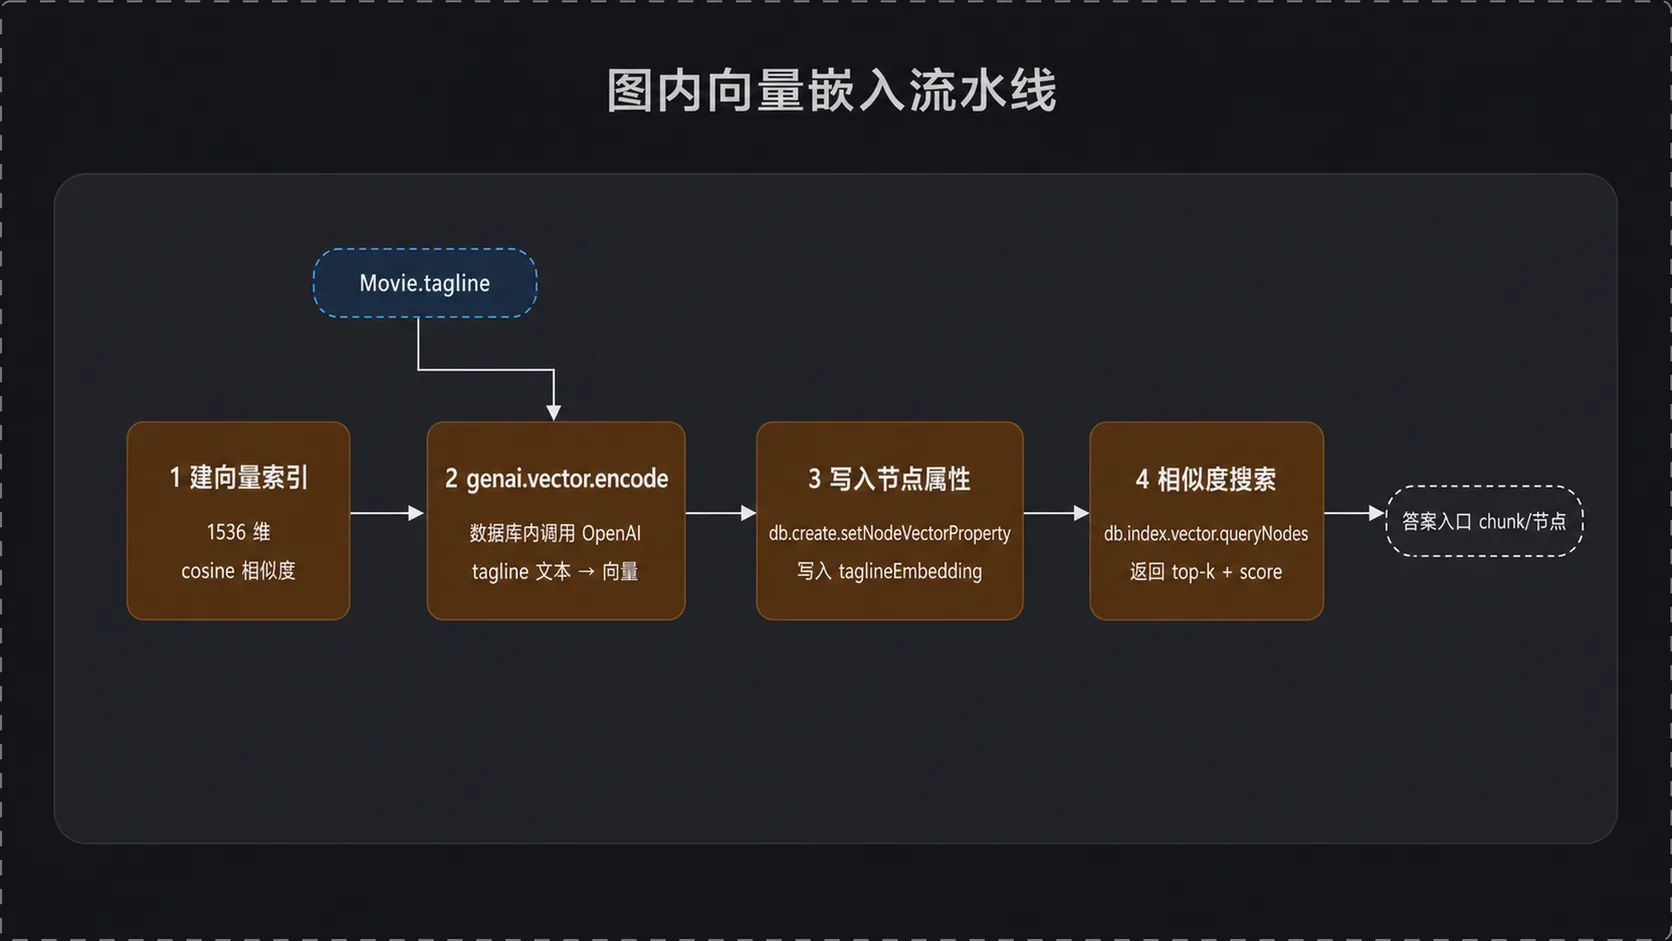
第三步,相似度搜索。问题文本同样在图内编码成向量,交给向量索引返回 top-k:
# 定义问题文本question = "What movies are about love?" # 执行相似度搜索:编码问题、查向量索引、返回标题标语与得分kg.query(""" # 执行查询 WITH genai.vector.encode( # 待编码的问题文本 $question, // 指定嵌入供应商 "OpenAI", // 以字典形式传入 API token {token: $openAiApiKey}) AS question_embedding // 调用内置过程 CALL db.index.vector.queryNodes( // 索引名 'movie_tagline_embeddings', // 返回条数上限 $top_k, // 问题向量 question_embedding # 从索引返回节点与相似度得分 ) YIELD node AS movie, score // 返回结果 RETURN movie.title, movie.tagline, score // 查询字符串结束 """, # 以字典传入查询参数 params={"openAiApiKey":OPENAI_API_KEY, # 问题文本 "question": question, # 返回前 5 条 "top_k": 5 // 参数字典结束 })问「关于爱情的电影」返回前五名:Joe Versus the Volcano(得分 0.9067)、As Good as It Gets(0.9028)、Snow Falling on Cedars(0.9017)、When Harry Met Sally(0.8949)、Sleepless in Seattle(0.8947)。同一个数据集换成「关于冒险的电影」,Joe Versus the Volcano 再次上榜——一部讲火山与爱情故事的电影同时命中两个主题,相似度检索的这种「语义模糊性」后面还会再见到。
验证嵌入有个小链条:取回一条节点的 tagline('Welcome to the Real World',《The Matrix》),打印向量前 10 个浮点分量,最后 len(embedding) 确认维度恰好 1536。到这里,图已经同时支持结构查询和语义查询——但两套能力还没有真正组装在一起,这是第 4 章的事。
四、从文档到图:把 SEC 10-K 切成 Chunk 节点
4.1 数据与清洗
SEC(美国证券交易委员会)要求上市公司提交年报,其中最核心的是 Form 10-K——一份年度活动报告,公开记录,任何人都能从 EDGAR 数据库下载。课程以 Qualcomm 的 10-K 演示了检索过程:EDGAR 全文搜索界面按公司名筛选 Annual reports,打开文档,能浏览到 Part I~IV 的完整目录,Item 1(Business)、Item 1A(Risk Factors)、Item 7(MD&A)、Item 7A(市场风险量化披露)是四个最主要的文本章节。
下载的 10-K 是含 XML 组件的文本文件,需要四步清洗:正则清理、Beautiful Soup 把 XML 解析成 Python 数据结构、提取 CIK(SEC 的公司唯一索引键)、提取四个 Item 章节,最后转成 JSON。课程已提供处理好的 NetApp 10-K JSON(文件名 0000950170-23-027948.json,即 EDGAR 存取号),笔记本里直接验证字段:
# 加载 10-K 的 JSON 文件first_file_as_object = json.load(open(first_file_name))# 遍历打印每个字段的类型for k, v in first_file_as_object.items(): print(k, type(v))# 取出 Item 1 正文item1_text = first_file_as_object['item1']输出显示 item1/item1a/item7/item7a 是长文本字符串,cik/cusip6/source 是标识字段,names 是公司名列表。
4.2 切块入库:每块一个 Chunk 节点
「Plan of attack」五步:文本分块 → 每块作为节点写入图 → 建向量索引 → 算嵌入填索引 → 相似度检索。分块用 LangChain 的 RecursiveCharacterTextSplitter(块大小 2000 字符、重叠 200):
# 定义切分器:块大小 2000、重叠 200,按普通字符串分隔符处理text_splitter = RecursiveCharacterTextSplitter( # 构造参数逐行传入 chunk_size = 2000, # 构造参数逐行传入 chunk_overlap = 200, # 构造参数逐行传入 length_function = len, # 构造参数逐行传入 is_separator_regex = False,# 构造参数逐行传入)# 对 Item 1 正文切块item1_text_chunks = text_splitter.split_text(item1_text)# item1 全文共切成 254 块len(item1_text_chunks)核心的 split_form10k_data_from_file 函数遍历四个章节,每块包装成带元数据的记录:
# 定义切分函数:读取 10-K JSON,按章节切块并组装元数据def split_form10k_data_from_file(file): # 用这个列表累计所有 chunk 记录 chunks_with_metadata = [] # 读取 JSON 文件 file_as_object = json.load(open(file)) # 遍历四个主要章节 for item in ['item1','item1a','item7','item7a']: # 打印当前处理的章节 print(f'Processing {item} from {file}') # 取出该章节正文 item_text = file_as_object[item] # 切块 item_text_chunks = text_splitter.split_text(item_text) # 块序号从 0 开始 chunk_seq_id = 0 # 演示只取每章前 20 块 for chunk in item_text_chunks[:20]: # 从文件路径提取表单 ID(去掉目录与扩展名) form_id = file[file.rindex('/') + 1:file.rindex('.')] # 组装一条带完整元数据的 chunk 记录 chunks_with_metadata.append({ # 块正文 'text': chunk, # 所属章节 'f10kItem': item, # 块序号 'chunkSeqId': chunk_seq_id, # 表单 ID,取自文件名 'formId': f'{form_id}', # 全局唯一块 ID:表单ID-章节-序号(item 变量本身已含 item 前缀,不要重复拼) 'chunkId': f'{form_id}-{item}-chunk{chunk_seq_id:04d}', # 以下元数据直接来自 JSON 文件 'names': file_as_object['names'], # SEC 公司索引键 'cik': file_as_object['cik'], # 证券识别码前 6 位 'cusip6': file_as_object['cusip6'], # 原始文件来源链接 'source': file_as_object['source'], // 参数字典结束 }) # 序号递增 chunk_seq_id += 1 # 返回全部 chunk 记录 return chunks_with_metadatachunkId 是关键设计:0000950170-23-027948-item1-chunk0000 这样的字符串同时编码了「哪份文件、哪个章节、第几块」,后面所有关系都靠它定位。写入用 MERGE,配合唯一性约束保证重复导入不产生重复数据:
# 先建唯一性约束:Chunk 节点的 chunkId 必须全局唯一kg.query("""# 执行查询CREATE CONSTRAINT unique_chunk IF NOT EXISTS // 索引作用的目标节点 FOR (c:Chunk) REQUIRE c.chunkId IS UNIQUE// 查询字符串结束""") # 定义 MERGE 查询:按 chunkId 匹配,不存在才创建并写入全部属性merge_chunk_node_query = """// 幂等创建:存在则复用,不存在才建MERGE (mergedChunk:Chunk {chunkId: $chunkParam.chunkId}) // 仅在首次创建时执行 ON CREATE SET # 写入对应属性 mergedChunk.names = $chunkParam.names, # 写入对应属性 mergedChunk.formId = $chunkParam.formId, # 写入对应属性 mergedChunk.cik = $chunkParam.cik, # 写入对应属性 mergedChunk.cusip6 = $chunkParam.cusip6, # 写入对应属性 mergedChunk.source = $chunkParam.source, # 写入对应属性 mergedChunk.f10kItem = $chunkParam.f10kItem, # 写入对应属性 mergedChunk.chunkSeqId = $chunkParam.chunkSeqId, # 写入对应属性 mergedChunk.text = $chunkParam.text// 返回结果RETURN mergedChunk// 查询字符串结束""" # 循环把每条 chunk 记录写成图节点node_count = 0# 逐条写入 chunk 节点for chunk in first_file_chunks: # 打印正在创建的块 ID print(f"Creating `:Chunk` node for chunk ID {chunk['chunkId']}") # 执行 MERGE,整条记录作为参数传入 kg.query(merge_chunk_node_query, # 执行查询 params={ # 整条 chunk 记录作为参数 'chunkParam': chunk // 参数字典结束 }) # 计数 node_count += 1# 演示数据集共写入 23 个节点print(f"Created {node_count} nodes")这里有个容易算错的地方:[:20] 是每章上限而不是每章实际值。演示用的这份 JSON 只有 item1 是完整长文(切满 20 块),item1a、item7、item7a 三章都很短,各只切出 1 块,20 + 1 + 1 + 1 = 23,正好对上输出。换成完整的 10-K 文件,这个数字会大得多。
4.3 Neo4j 兼任向量库
先把这一节要用的常量和依赖集中定义好——后面第 5、6 章的检索链都复用它们:
# LangChain 的 Neo4j 向量存储封装from langchain_community.vectorstores import Neo4jVector# OpenAI 的嵌入模型与对话模型from langchain_openai import OpenAIEmbeddings, ChatOpenAI# 带来源标注的问答链from langchain.chains import RetrievalQAWithSourcesChain # 向量索引名VECTOR_INDEX_NAME = 'form_10k_chunks'# 建索引的节点标签VECTOR_NODE_LABEL = 'Chunk'# 参与嵌入的文本属性VECTOR_SOURCE_PROPERTY = 'text'# 存放向量的专用属性VECTOR_EMBEDDING_PROPERTY = 'textEmbedding'向量索引建在 Chunk 节点上(仍然 1536 维 + cosine),填充逻辑与第 3 章相同,只换了标签和属性名:
# 建向量索引:在 Chunk 节点的 textEmbedding 属性上kg.query("""# 执行查询CREATE VECTOR INDEX `form_10k_chunks` IF NOT EXISTS// 索引作用的目标节点FOR (c:Chunk) ON (c.textEmbedding)// 索引配置项OPTIONS { indexConfig: { // 向量维度 `vector.dimensions`: 1536, // 相似度函数 `vector.similarity_function`: 'cosine'// 子查询结束}}// 查询字符串结束""") # 填充嵌入:只处理还没算过的块,避免重复调用付费 APIkg.query(""" # 执行查询 MATCH (chunk:Chunk) WHERE chunk.textEmbedding IS NULL // 中间投影:把当前结果传给下一步 WITH chunk, genai.vector.encode( # 待编码的块正文 chunk.text, // 指定嵌入供应商 "OpenAI", // 以字典形式传入 API token {token: $openAiApiKey} # 把编码结果命名为 vector ) AS vector // 调用内置过程 CALL db.create.setNodeVectorProperty(chunk, "textEmbedding", vector) // 查询字符串结束 """, # 以字典传入查询参数 params={"openAiApiKey":OPENAI_API_KEY})WHERE chunk.textEmbedding IS NULL 让这段查询可以反复重跑:已经算过嵌入的块直接跳过,只为新增的块付费。然后把 Neo4j 包装成 LangChain 向量存储,接一个 RAG 问答链:
# 定义向量搜索函数:编码问题后在向量索引上查 top-kdef neo4j_vector_search(question): # 搜索用 Cypher:编码问题向量,查索引,返回得分与原文 vector_search_query = """ // 中间投影:把当前结果传给下一步 WITH genai.vector.encode($question, "OpenAI", {token: $openAiApiKey}) AS question_embedding // 调用内置过程 CALL db.index.vector.queryNodes($index_name, $top_k, question_embedding) YIELD score, node // 返回结果 RETURN score, node.text AS text // 查询字符串结束 """ # 执行查询并返回结果 similar = kg.query(vector_search_query, # 以字典传入查询参数 params={ # 问题文本 'question': question, # API key 'openAiApiKey': OPENAI_API_KEY, # 指定向量索引 'index_name': VECTOR_INDEX_NAME, # 返回前 10 条 'top_k': 10}) # 返回相似块列表 return similar # 把已有索引和嵌入包装成 LangChain 向量存储neo4j_vector_store = Neo4jVector.from_existing_graph( # 构造参数逐行传入 embedding=OpenAIEmbeddings(), # 构造参数逐行传入 url=NEO4J_URI, # 构造参数逐行传入 username=NEO4J_USERNAME, # 构造参数逐行传入 password=NEO4J_PASSWORD, # 构造参数逐行传入 index_name=VECTOR_INDEX_NAME, # 构造参数逐行传入 node_label=VECTOR_NODE_LABEL, # 构造参数逐行传入 text_node_properties=[VECTOR_SOURCE_PROPERTY], # 构造参数逐行传入 embedding_node_property=VECTOR_EMBEDDING_PROPERTY,# 构造参数逐行传入)# 转成 retrieverretriever = neo4j_vector_store.as_retriever()# 组装问答链:stuff 模式把检索文本合并进一个 promptchain = RetrievalQAWithSourcesChain.from_chain_type( # 对话模型:温度 0 保证稳定 ChatOpenAI(temperature=0), # 构造参数逐行传入 chain_type="stuff", # 挂上检索器 retriever=retriever# 构造参数逐行传入)RetrievalQAWithSourcesChain 的答案带来源标注,方便对回 EDGAR 原文件。
补一句 from_existing_graph 与第 5 章要用的 from_existing_index 的差别:前者会检查节点上是否已有 embedding_node_property,缺了就调用 embedding 模型补算并写回图;后者只挂到现成的索引上,不补算。所以嵌入填充这步哪怕跳过,from_existing_graph 也能跑通(代价是一次真实的 API 调用);而换成 from_existing_index 之后,嵌入就必须事先备齐。这一层的组合验证了向量检索在图上照常工作——问「NetApp 的主营业务」,答案正确。但注意此时 Neo4j 只被当成一个「看起来像向量存储的数据库」,图的真正武器(关系)一个都还没用上。第 1 章那个 Apple 幻觉在这里出现,也在这里被 prompt 修复——但真正解决幻觉和关系盲区的路径,要先给图补上结构。
提问用的 prettychain 是课程里的一个打印辅助函数(官方笔记本原样):
# 文本换行工具import textwrap # 定义辅助函数:向问答链提问并把答案按 60 列折行打印def prettychain(question: str) -> str: // 查询字符串结束 """Pretty print the chain's response to a question""" # 只取输出,不带中间过程 response = chain({"question": question}, return_only_outputs=True) # 折行打印答案正文 print(textwrap.fill(response["answer"], 60))# 向问答链提问 Apple 的情况,并附上不确定性指令prettychain(""" # 提问正文 Tell me about Apple. # 限制一句话回答 Limit your answer to a single sentence. # 不确定就承认不知道 If you are unsure about the answer, say you don't know.// 查询字符串结束""")# 输出: I don't know about Apple.五、把文档结构编码进图:NEXT、PART_OF 与上下文窗口
5.1 Form 节点与三种关系
23 个孤立的 Chunk 节点还只是「带属性的文本堆」。第 5 课开始往图里加关系,目标是还原 10-K 文件的原始结构。先建 :Form 节点——它的属性可以直接从任意一个 Chunk 节点上投影出来(所有块共享同一份文件元数据):
# 定义 Cypher:任取一个 Chunk 节点,投影出文件级元数据cypher = """ // 匹配图中的节点 MATCH (anyChunk:Chunk) // 中间投影:把当前结果传给下一步 WITH anyChunk LIMIT 1 // 返回结果 RETURN anyChunk { .names, .source, .formId, .cik, .cusip6 } as formInfo// 查询字符串结束"""# 执行后取第一条作为 form_info 字典form_info = kg.query(cypher)[0] # 定义 Cypher:按 formId 幂等创建 Form 节点并写入属性cypher = """ // 幂等创建:存在则复用,不存在才建 MERGE (f:Form {formId: $formInfoParam.formId }) // 仅在首次创建时执行 ON CREATE // 写入属性 SET f.names = $formInfoParam.names // 写入属性 SET f.source = $formInfoParam.source // 写入属性 SET f.cik = $formInfoParam.cik // 写入属性 SET f.cusip6 = $formInfoParam.cusip6// 查询字符串结束"""# 执行创建kg.query(cypher, params={'formInfoParam': form_info})然后在 Chunk 与 Form 之间补两种关系。PART_OF 表达「块属于哪份文件」;SECTION 从 Form 指向每章第一块,属性里带上章节名,方便人从文件导航到章节入口:
# 定义 Cypher:为同一 formId 的所有 Chunk 与 Form 之间建立 PART_OF 关系cypher = """ // 匹配图中的节点 MATCH (c:Chunk), (f:Form) // 过滤条件 WHERE c.formId = f.formId // 幂等创建:存在则复用,不存在才建 MERGE (c)-[newRelationship:PART_OF]->(f) // 返回结果 RETURN count(newRelationship)// 查询字符串结束"""# 执行,返回 23 条 PART_OFkg.query(cypher) # 定义 Cypher:把 Form 连到每章第一块(chunkSeqId 为 0 的块)cypher = """ // 匹配图中的节点 MATCH (first:Chunk), (f:Form) // 过滤条件 WHERE first.formId = f.formId // 附加条件 AND first.chunkSeqId = 0 // 中间投影:把当前结果传给下一步 WITH first, f // 幂等创建:存在则复用,不存在才建 MERGE (f)-[r:SECTION {f10kItem: first.f10kItem}]->(first) // 返回结果 RETURN count(r)// 查询字符串结束"""# 执行,四个章节对应 4 条 SECTIONkg.query(cypher)最关键的是第三种关系:NEXT,把同一章节里的块按原始顺序串成链表。课程先演示了查询要「逐步迭代」:只按 formId 过滤时会发现 chunkSeqId 出现两个 0——一个来自 item7、一个来自 item7a,不同章节的序号会撞车;加上 f10kItem 条件并按序号排序,才拿到正确的一节。然后 collect() 把逐行结果折叠成一个列表,交给 APOC 的 apoc.nodes.link 过程建链:
# 定义建链查询:同表单同章节的块按序号排序、聚合成列表后两两连成 NEXTcypher = """ // 匹配图中的节点 MATCH (from_same_section:Chunk) // 过滤条件 WHERE from_same_section.formId = $formIdParam // 附加条件 AND from_same_section.f10kItem = $f10kItemParam // 中间投影:把当前结果传给下一步 WITH from_same_section // 排序 ORDER BY from_same_section.chunkSeqId ASC // 中间投影:把当前结果传给下一步 WITH collect(from_same_section) as section_chunk_list // 调用内置过程 CALL apoc.nodes.link( // 传入排好序的块列表 section_chunk_list, // 关系类型:NEXT "NEXT", // 重复执行不产生重复边 {avoidDuplicates: true} # 构造参数逐行传入 ) // 返回结果 RETURN size(section_chunk_list)// 查询字符串结束"""# 对四个章节循环执行建链for form10kItemName in ['item1', 'item1a', 'item7', 'item7a']: # 每章调用一次,avoidDuplicates 保证重复执行不产生重复边 kg.query(cypher, params={'formIdParam': form_info['formId'], # 执行查询 'f10kItemParam': form10kItemName})从这一节起,图操作会陆续用到 APOC 库。本文涉及四个:apoc.nodes.link(本章建链)、apoc.text.join 与 apoc.number.format(第 5、6 章拼上下文)、apoc.text.jaroWinklerDistance(第 10 章实体解析)。这四个都属于 APOC Core,Aura 实例默认可用;自建 Docker 需要把 APOC 插件放进 plugins 目录。
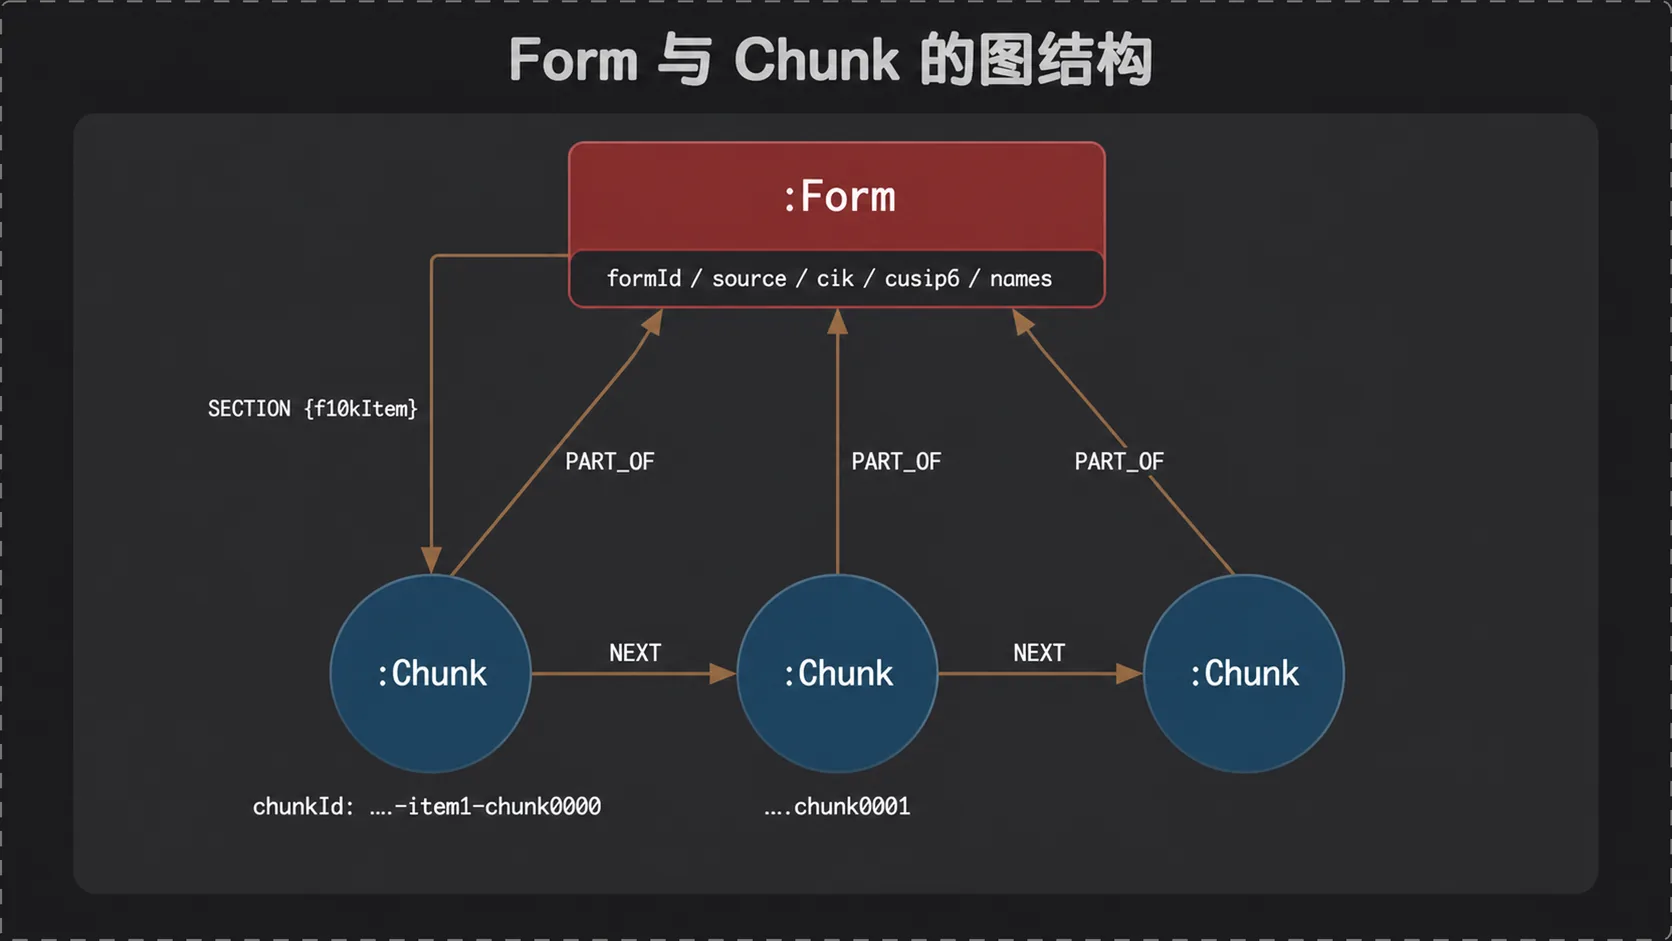
建完验证:kg.refresh_schema() 后打印 schema,能看到新的 NEXT 关系类型;取 item1 第一块的 chunkId,沿 NEXT 走一步拿到 chunk0001——两块的 ID 尾号连续,链表确实建起来了。
5.2 路径与窗口:图的语法在这里显出威力
有 NEXT 链之后,可以做一件纯向量检索做不了的事:取「命中块的邻居」。Cypher 的可变长度路径是关键语法。以某块为中心,[:NEXT*0..1] 表示「向前或向后走 0 到 1 步」:
# 定义 Cypher:以指定块为中心,用可变长度路径取前后的邻居窗口cypher = """ # 匹配一条窗口路径 MATCH window = (c1:Chunk)-[:NEXT*0..1]->(c2:Chunk) // 过滤条件 WHERE c2.chunkId = $chunkIdParam // 返回结果 RETURN length(window) as windowPathLength// 查询字符串结束"""# 对链首的块执行,返回 0 和 1 两个窗口——链首没有前驱,0 跳窗口兜底kg.query(cypher, params={'chunkIdParam': first_chunk_info['chunkId']})固定两跳的模式 (:Chunk)-[:NEXT]->(:Chunk)-[:NEXT]->(:Chunk) 在链首会匹配为空(第一个块前面没有邻居),可变长度路径用 0 跳补上了这种边界情况。把窗口按长度排序取最长,就得到「中心块周围最长的连续上下文」:
# 定义 Cypher:匹配中心块前后各 0~1 跳的窗口,取最长的一条cypher = """ # 匹配一条窗口路径 MATCH window= # 前后各允许 0~1 跳的 NEXT 邻居 (:Chunk)-[:NEXT*0..1]->(c:Chunk)-[:NEXT*0..1]->(:Chunk) // 过滤条件 WHERE c.chunkId = $chunkIdParam // 中间投影:把当前结果传给下一步 WITH window as longestChunkWindow // 排序 ORDER BY length(window) DESC LIMIT 1 // 返回结果 RETURN length(longestChunkWindow)// 查询字符串结束"""# 执行,返回窗口长度(以关系数计)kg.query(cypher, params={'chunkIdParam': first_chunk_info['chunkId']})5.3 retrieval_query:把邻居拼进 RAG 上下文
LangChain 的 Neo4jVector 有个标准扩展点 retrieval_query:只要返回 text、score、metadata 三列,向量检索命中节点之后可以接任意 Cypher。课程先用一个教学版直观展示这等于「给 LLM 注入额外上下文」——在每个命中结果前硬拼一句「Andreas knows Cypher.」,然后问模型「Andreas 懂什么」,它真把这句当事实答了。实战版把硬拼文本换成窗口内所有块的正文:
# 定义窗口检索查询:命中节点后,把前后邻居的文本拼接为完整上下文retrieval_query_window = """# 匹配一条窗口路径MATCH window= # 前后各允许 0~1 跳的 NEXT 邻居 (:Chunk)-[:NEXT*0..1]->(node)-[:NEXT*0..1]->(:Chunk)// 中间投影:把当前结果传给下一步WITH node, score, window as longestWindow// 排序ORDER BY length(window) DESC LIMIT 1// 中间投影:把当前结果传给下一步WITH nodes(longestWindow) as chunkList, node, score// 把列表展开成行UNWIND chunkList as chunkRows// 中间投影:把当前结果传给下一步WITH collect(chunkRows.text) as textList, node, score// 返回结果RETURN apoc.text.join(textList, " \n ") as text, # 相似度得分 score, # 来源元数据 node {.source} AS metadata// 查询字符串结束"""有个容易被当成笔误的细节:上面的 WITH node, score, window as longestWindow 已经把路径重命名成 longestWindow,下一行 ORDER BY length(window) 引用的却还是旧名。这是官方笔记本原样写法,合法——在不带聚合和 DISTINCT 的 WITH 之后,ORDER BY 仍能看到投影前的变量。照抄即可,不必改。
# 用自定义检索查询再次包装向量存储vector_store_window = Neo4jVector.from_existing_index( # 嵌入模型 embedding=OpenAIEmbeddings(), # 连接串 url=NEO4J_URI, # 用户名 username=NEO4J_USERNAME, # 密码 password=NEO4J_PASSWORD, # 库名 database="neo4j", # 挂到现成索引上 index_name=VECTOR_INDEX_NAME, # 文本属性 text_node_property=VECTOR_SOURCE_PROPERTY, # 注入窗口检索查询 retrieval_query=retrieval_query_window, # 构造结束)# 组装带窗口的问答链retriever_window = vector_store_window.as_retriever()# 组装带窗口的问答链chain_window = RetrievalQAWithSourcesChain.from_chain_type( # 对话模型温度 0 ChatOpenAI(temperature=0), # stuff 模式合并检索文本 chain_type="stuff", # 挂上带窗口的检索器 retriever=retriever_window # 构造结束)顺带一个容易「顺手统一」的坑:第 4 章的 from_existing_graph 收的参数叫 text_node_properties(复数、列表),这里的 from_existing_index 收的是 text_node_property(单数、字符串)。两个参数名确实不同,不是笔误,混用会直接 TypeError。
对比实验:同一个问题「用一句话介绍 NetApp 的业务」,不带窗口的链给出泛化的「云优先、以数据为中心的软件公司」描述;带窗口的链额外提到 Keystone(存储即服务产品)、全球支持和多渠道分销——这些细节写在相邻块里,纯向量检索根本捞不到。向量相似度负责「找到入口」,图遍历负责「把入口周围的上下文补全」,两种检索在第 5 章正式合流。
六、图谱生长:从文档图到实体图
6.1 Form 13:把公司和管理人接进图
第 6 课引入第二类 SEC 表单 Form 13——机构投资经理的持仓申报,每行记录「哪家机构、在哪个季度、持有哪家公司多少股、市值多少」。课程提供了预处理的 form13.csv,561 行,全部指向同一家公司 NetApp(演示数据集)。导图逻辑与前面一致:MERGE 建 :Company(以 cusip6 证券代码前 6 位唯一)和 :Manager(以 managerCik 唯一)节点,再把关系接起来。值得看的是「节点对齐」这一步——10-K 文件图的 Form 节点上有 cusip6,Form 13 的 Company 节点也有 cusip6,相等即可配对:
# 定义 Cypher:用 cusip6 相等把 Company 与既有 Form 配对,检查公司名是否一致cypher = """ // 匹配图中的节点 MATCH (com:Company), (form:Form) // 过滤条件 WHERE com.cusip6 = form.cusip6 // 返回结果 RETURN com.companyName, form.names// 查询字符串结束"""# 返回 [{'com.companyName': 'NETAPP INC', 'form.names': ['Netapp Inc', 'NETAPP INC']}]kg.query(cypher)对上之后建两条关系:(Company)-[:FILED]->(Form)(公司提交了这份年报)和 (Manager)-[:OWNS_STOCK_IN]->(Company)(机构持股)。持股关系用 MERGE 幂等创建,关系属性上写市值和股数:
# 定义持股关系创建查询:匹配经理与公司,按季度幂等建边cypher = """// 匹配图中的节点MATCH (mgr:Manager {managerCik: $ownsParam.managerCik}), # 匹配目标公司节点 (com:Company {cusip6: $ownsParam.cusip6})// 幂等创建:存在则复用,不存在才建MERGE (mgr)-[owns:OWNS_STOCK_IN { # 以季度为幂等键 reportCalendarOrQuarter: $ownsParam.reportCalendarOrQuarter # 关系指向公司节点 }]->(com) // 仅在首次创建时执行 ON CREATE // 写入属性 SET owns.value = toFloat($ownsParam.value), # 股数转整数 owns.shares = toInteger($ownsParam.shares)// 返回结果RETURN mgr.managerName, owns.reportCalendarOrQuarter, com.companyName// 查询字符串结束"""# 逐行导入 561 条持仓记录for form13 in all_form13s: # 每行一个字典,作为参数传入 kg.query(cypher, params={'ownsParam': form13})此时图里已经有五类节点(Chunk、Form、Company、Manager,加上后面第 7 章的 Address)和一组跨数据源的关系。用 print(kg.schema) 打印全景:节点属性清单加五种关系方向。
6.2 全文索引:另一把检索的刀
图里有了公司名,就要支持「按名字找公司」。全文索引与向量索引的分工在课程里讲得很清楚:全文索引按「相似字符串」匹配( typo 也能命中,得分范围与向量不同),向量索引按「相似概念」匹配。建索引、试查询:
# 建全文索引:对 Manager 节点的名称属性kg.query("""# 执行查询CREATE FULLTEXT INDEX fullTextManagerNames IF NOT EXISTS // 索引作用的目标节点 FOR (mgr:Manager) ON EACH [mgr.managerName]// 查询字符串结束""") # 建全文索引:对 Company 节点的名称属性kg.query("""# 执行查询CREATE FULLTEXT INDEX fullTextCompanyNames IF NOT EXISTS // 索引作用的目标节点 FOR (com:Company) ON EACH [com.companyName]// 查询字符串结束""") # 用全文索引按机构名搜索,"royal bank" 能命中 Royal Bank of Canadakg.query(""" # 执行查询 CALL db.index.fulltext.queryNodes("fullTextManagerNames", # 取回命中节点与得分 "royal bank") YIELD node, score // 返回结果 RETURN node.managerName, score// 查询字符串结束""")全文索引有个实用特性:把公司名故意拼错成「Palo Aalto Networks」照样命中——字符串近似匹配容错。
6.3 多跳探索:从一块文本走到 561 个投资者
现在可以验证「关系检索」的真正能力。从任取一块文本出发,沿关系一路走到投资者:
# 定义 Cypher:从指定 chunk 出发,经 Form、Company 走到持股的 Manager,统计数量cypher = """ // 匹配图中的节点 MATCH (:Chunk {chunkId: $chunkIdParam})-[:PART_OF]->(f:Form), # 公司提交了该表单 (com:Company)-[:FILED]->(f), # 机构持有该公司股份 (mgr:Manager)-[owns:OWNS_STOCK_IN]->(com) // 返回结果 RETURN count(mgr) as numberOfInvestors// 查询字符串结束"""# 返回 561——561 家机构在同一季度持有 NetAppkg.query(cypher, params={'chunkIdParam': chunkId_toExplore})这条五跳查询是纯向量检索永远做不到的。把同样的模式改成 RETURN 字符串拼接,还能直接生成自然语言句子:「CSS LLC/IL owns 12500 shares of NETAPP INC at a value of $955,000,000」,用 apoc.number.format 加千分位。
6.4 图扩展上下文:只在问题相关时生效
把投资信息注入检索上下文的方法与第 5 章完全一致——Neo4jVector.from_existing_index 加自定义 retrieval_query,这次在命中块的文本前面拼上按持股数排序的前 10 条投资语句:
# 定义投资检索查询:命中块后追加该公司的前 10 大投资者信息investment_retrieval_query = """// 匹配图中的节点MATCH (node)-[:PART_OF]->(f:Form), // 反向匹配:公司提交了该表单 (f)<-[:FILED]-(com:Company), // 反向匹配:经理持有该公司股份 (com)<-[owns:OWNS_STOCK_IN]-(mgr:Manager)// 中间投影:把当前结果传给下一步WITH node, score, mgr, owns, com // 排序 ORDER BY owns.shares DESC LIMIT 10// 中间投影:把当前结果传给下一步WITH collect (mgr.managerName + " owns " + owns.shares + " of " + # 拼接公司名与市值 com.companyName + " at a value of $" + # 市值加千分位格式化 apoc.number.format(owns.value) + ".") AS investment_statements, # 保留命中节点与得分 node, score// 返回结果RETURN apoc.text.join(investment_statements, "\n") + "\n" + node.text AS text, # 相似度得分 score, # 来源元数据 {source: node.source} as metadata// 查询字符串结束"""把这段检索查询挂上向量存储,就得到用于对比的第二条链(plain_chain 就是第 4 章那条不带扩展的链):
# 用投资检索查询包装向量存储vector_store_with_investments = Neo4jVector.from_existing_index( # 嵌入模型 embedding=OpenAIEmbeddings(), # 连接串 url=NEO4J_URI, # 用户名 username=NEO4J_USERNAME, # 密码 password=NEO4J_PASSWORD, # 库名 database="neo4j", # 挂到现成索引上 index_name=VECTOR_INDEX_NAME, # 文本属性 text_node_property=VECTOR_SOURCE_PROPERTY, # 注入投资检索查询 retrieval_query=investment_retrieval_query, # 构造结束)# 转成 retrieverretriever_with_investments = vector_store_with_investments.as_retriever()# 组装带投资上下文的问答链investment_chain = RetrievalQAWithSourcesChain.from_chain_type( # 对话模型:温度 0 保证稳定 ChatOpenAI(temperature=0), # 构造参数逐行传入 chain_type="stuff", # 挂上检索器 retriever=retriever_with_investments# 构造参数逐行传入)对比两个链的行为很有意思。问「用一句话介绍 NetApp」,investment_chain 的答案和 plain_chain 几乎一样——LLM 自动忽略了与问题无关的投资信息,扩展上下文没有污染回答。问「介绍一下 NetApp 的投资者」,plain_chain 答非所问(它只能从 10-K 正文里找出「多元化的客户基础」之类的模糊表述),investment_chain 准确列出皇家银行、北卡州财政部长等具体机构名。结论:图扩展不是无脑堆上下文,问题指向关系信息时,图扩展才是决定性的。
七、和图对话:Text2Cypher
7.1 从 MVG 起步的建图方法论
第 7 课开头复盘了一个贯穿全程的方法论:知识图谱不必一次建完美,从一个最小可行图(Minimum Viable Graph,MVG)起步——先让数据确实进图,再迭代生长。每类数据源都走同样的三步循环:
- Extract:把数据提取成节点(10-K 的块与表单、Form 13 的公司与机构、地址字符串的 Address);
- Enhance:给节点增强检索能力(文本块加向量嵌入、机构名加全文索引、地址加地理空间索引);
- Expand:把节点连接起来(NEXT/PART_OF/FILED/OWNS_STOCK_IN/LOCATED_AT)。
Enhance 里每个节点的增强手段各不相同,但「提取-增强-扩展-重复」的骨架一致。课程数据集还预置了一步扩展:把 Company 和 Manager 的地址字符串地理编码成 :Address 节点(带 city/state/country 和 POINT 经纬度),挂上 LOCATED_AT 关系和地理空间索引。
7.2 地理查询:point.distance 就是「空间的向量搜索」
Address 节点让「什么在我附近」这类问题变成图遍历加距离函数:
// 定义查询:以 Santa Clara 的地址为圆心,找 10 公里内的公司MATCH (sc:Address) WHERE sc.city = "Santa Clara"// 匹配图中的节点MATCH (com:Company)-[:LOCATED_AT]->(comAddr:Address) // 过滤条件 WHERE point.distance(sc.location, comAddr.location) < 10000// 返回公司名与地址RETURN com.companyName, com.companyAddresspoint.distance 返回米。课程讲师把这个查询类比成「二维空间里的向量搜索」——只不过用的是笛卡尔距离而不是余弦相似度。结果里除了 Santa Clara 本地的 Palo Alto Networks、Seagate、Atlassian,还捞出了十公里外 Cupertino 的 Apple 和 Sunnyvale 的 GSI Technology。换一个问题形态——「Palo Alto Networks 附近有哪些投资机构」——把全文索引、LOCATED_AT 和距离函数串起来,还能返回按公里数排序的近邻列表。
7.3 few-shot:教一句,会一类
第 7 章的高潮是让 LLM 直接生成 Cypher。LangChain 的 GraphCypherQAChain 接收一个 prompt 模板(任务说明 + 数据库 schema + few-shot 示例 + 用户问题),把自然语言翻译成 Cypher,在图上执行,再把结果交给 LLM 组织成回答。模板长这样:
# 定义 Text2Cypher 提示模板:任务、约束、schema、示例与问题CYPHER_GENERATION_TEMPLATE = ( # 任务说明:生成查询图数据库的 Cypher 语句 """Task:Generate Cypher statement to query a graph database.""" # 约束:只能使用 schema 里提供的关系类型与属性 """# 任务约束段Instructions:# 只能用 schema 提供的关系与属性Use only the provided relationship types and properties in the schema.# 禁止发明 schema 之外的结构Do not use any other relationship types or properties that are not provided.""" # 图结构占位符,由 LangChain 注入 """# 图结构占位段Schema:// 模式占位符{schema}""" # 输出纪律:只输出 Cypher,不解释、不跑题 """# 输出纪律段Note: Do not include any explanations or apologies in your responses.# 不回答与写 Cypher 无关的问题Do not respond to any questions that might ask anything else than for you to# 只构造语句construct a Cypher statement.# 只输出 Cypher 本身Do not include any text except the generated Cypher statement.""" # few-shot 示例区:先给城市过滤示例 """# few-shot 示例区Examples: Here are a few examples of generated Cypher statements for particular# 示例标题questions:# What investment firms are in San Francisco?MATCH (mgr:Manager)-[:LOCATED_AT]->(mgrAddress:Address) // 过滤条件 WHERE mgrAddress.city = 'San Francisco'// 返回结果RETURN mgr.managerName""" # 距离查询示例:教模型用 point.distance """# What investment firms are near Santa Clara?MATCH (address:Address) WHERE address.city = 'Santa Clara'// 匹配图中的节点MATCH (mgr:Manager)-[:LOCATED_AT]->(managerAddress:Address) // 过滤条件 WHERE point.distance(address.location, managerAddress.location) < 10000// 返回结果RETURN mgr.managerName, mgr.managerAddress# 用户问题由此注入The question is:// 问题占位符{question}""")# 提示模板from langchain.prompts import PromptTemplate# 自然语言转 Cypher 的问答链from langchain.chains import GraphCypherQAChain # 让模板里的 {schema} 拿到最新的图结构kg.refresh_schema()# 组装 PromptTemplateCYPHER_GENERATION_PROMPT = PromptTemplate( # 声明两个占位变量并绑定模板 input_variables=["schema", "question"], template=CYPHER_GENERATION_TEMPLATE) # 组装 Text2Cypher 链# allow_dangerous_requests=True 是新版 LangChain 的强制确认:# 这条链会把 LLM 生成的 Cypher 直接送进数据库执行,生产环境建议配只读账号cypherChain = GraphCypherQAChain.from_llm( # 模型温度 0、绑定图并打开详细日志 ChatOpenAI(temperature=0), graph=kg, verbose=True, # 构造参数逐行传入 cypher_prompt=CYPHER_GENERATION_PROMPT, # 新版 LangChain 的强制安全确认 allow_dangerous_requests=True)教学过程是个「教一句、会一类」的实验序列。第一次问「旧金山有哪些投资机构」,GPT-3.5 生成的 Cypher 与模板里示例几乎一致,答对;把城市换成 Menlo Park,WHERE 子句自动换字符串,答对——这是照葫芦画瓢。第三次问「Santa Clara 有哪些公司」,这个问题没有任何示例,模型自己把 MATCH 模式从 Manager 换成 Company,答对了——它开始举一反三。第四次问「Santa Clara 附近有哪些投资机构」,模型不会 point.distance,答错;往模板里加一条带距离函数的示例,重建链,再问就答对了。
verbose=True 能看到完整四步:Generated Cypher(模型写的查询)→ Full Context(数据库返回的原始行)→ 最终自然语言答案。调试 Text2Cypher 时,先看生成的 Cypher 对不对,再看查回了什么,最后才看回答——错误通常出在第一步。整套链的纪律写在模板 Note 段里:只能用 schema 里存在的关系和属性、不解释不道歉、只输出 Cypher——这些约束把 LLM 幻觉出不存在的节点类型的概率压到最低。
顺带一提,「某家公司是做什么的」这类问题也有对应套路:全文索引找公司 → 沿 FILED 到 Form → 沿 SECTION 取 item1 的第一个 Chunk → 把 Item 1 开头文本交给 LLM 摘要。这条路径后来也被写进了 few-shot 示例。
八、让建图自动化:Agent 与多智能体架构
前七章有一条隐含的负担:每一步——挑文件、设计 schema、写导入脚本、验证结果——都是人在做决策。《Agentic Knowledge Graph Construction》这门课的任务就是把这些决策交给 agent。第 2 课先搭理论框架。
8.1 Agent 是一种新的控制流操作符
课程把 agent 定义为一种新的控制流操作符:一个外层执行循环,循环体里调用 LLM——LLM 读对话历史和 prompt,决定「回复」还是「行动」,行动通过 switch 分发给具体函数(工具)执行,执行结果连同共享 memory 回流进循环。智能来自 LLM 调用,行为执行仍然是普通代码。
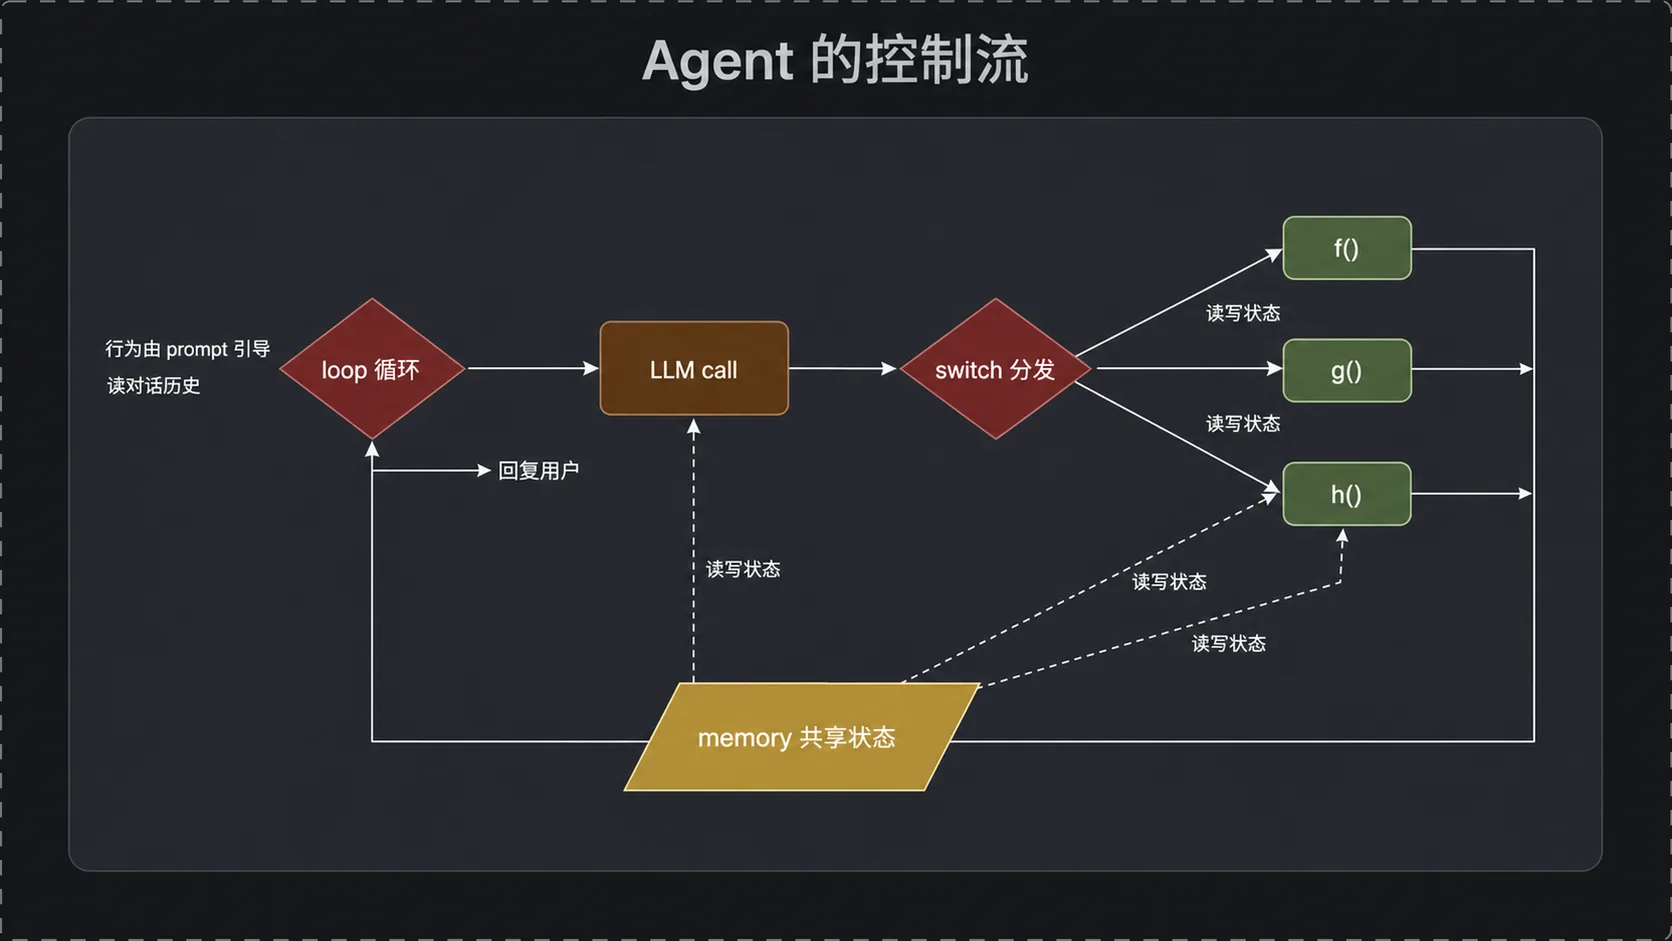
单 agent 的优缺点在课程里被摆得很直白:强大(推理加工具调用)、自适应(带 memory)、易用(自然语言写 prompt 就能改行为);但是慢(每次行动都要远程调 LLM)、非确定(LLM 本性,同一输入不同输出)、贵(生产环境成千上万次调用,token 成本累积)。这三条缺点是多智能体系统的直接动机:把「必须智能决策」的环节和「机械执行」的环节拆开,让贵的那部分只出现在该出现的地方。
多智能体系统的形态特征:agent 和 sub-agent 形成层级;每个 agent 专门化一类任务;agent 之间可以「delegate」(委派);部分 agent 干脆被当作工具调用;关键节点设有人工检查点。课程把这种组织方式类比成数据工程团队:每个子 agent 对应一种角色——先澄清需求、再挑数据源、再设计 schema、最后施工。
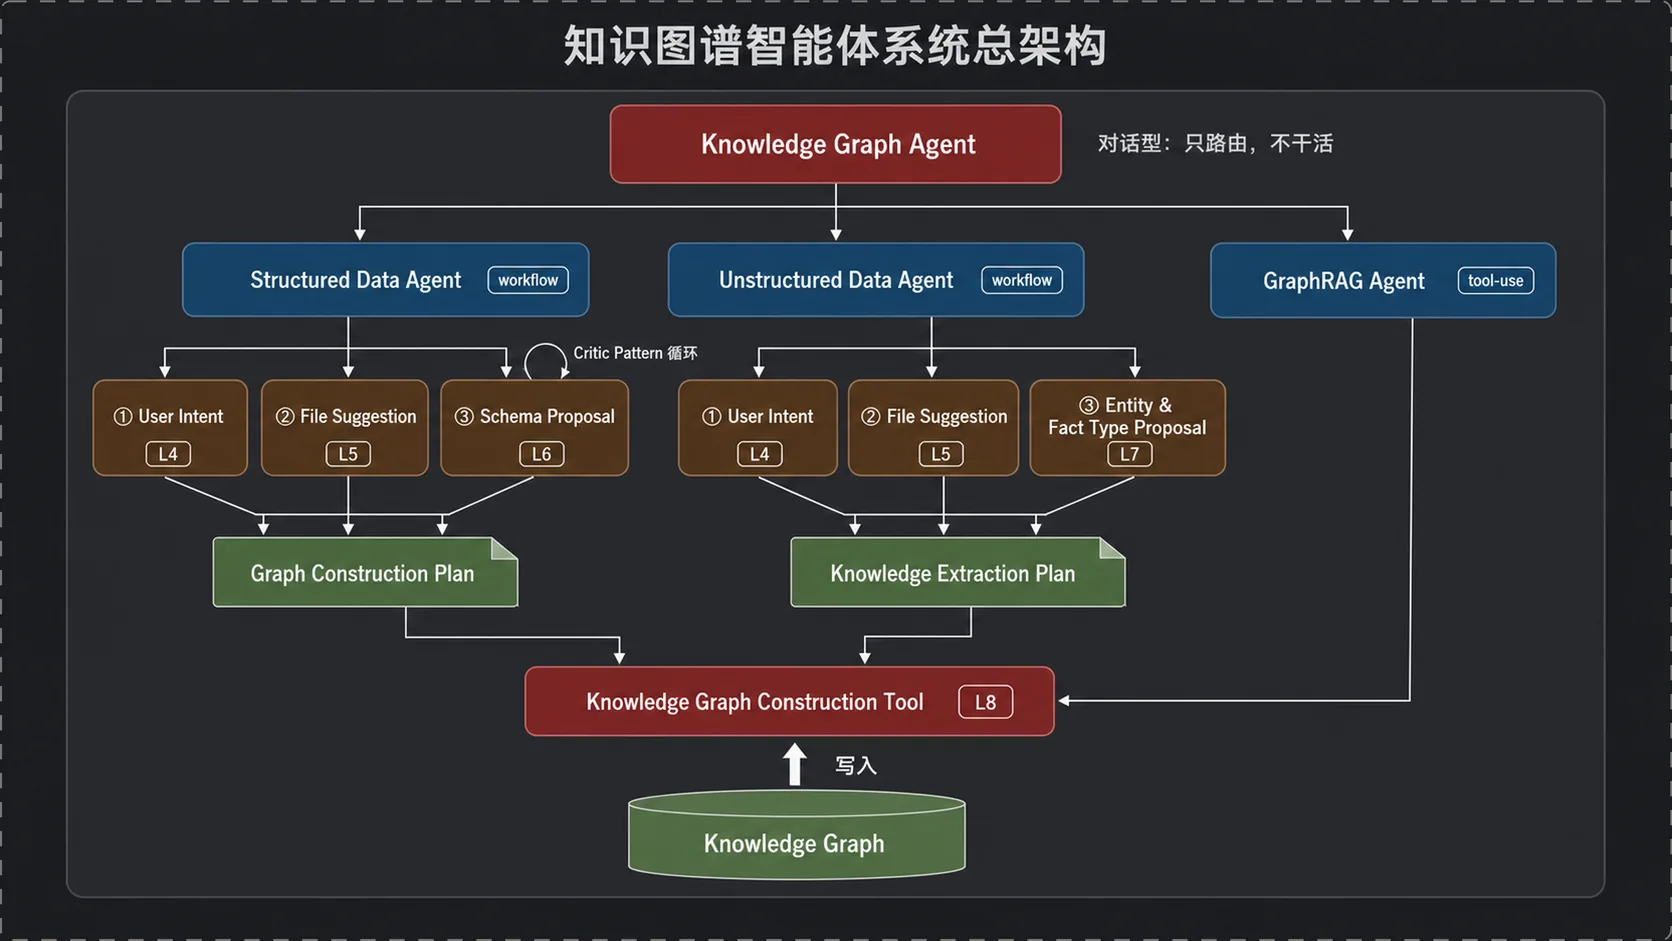
顶层的 Knowledge Graph Agent 是纯对话型 agent,自己不做任何具体工作,只负责介绍系统能力和路由请求。它下面分三个工作流分支:
- Structured Data Agent(workflow agent):接 CSV 导入,下面挂 User Intent Agent(会话型,与用户一起确定建图目标)、File Suggestion Agent(工具型,推荐相关文件)、Schema Proposal Agent(一对「批评者模式」agent,迭代打磨 schema),产出一份 Graph Construction Plan——批准的「把 CSV 转成图」的构建规则;
- Unstructured Data Agent(workflow agent):接 Markdown 导入,前两步与结构化分支相同,第三步换成 Entity & Fact Type Proposal Agent(确定能从文本抽出的实体类型和事实类型),产出 Knowledge Extraction Plan——批准的抽取计划;
- GraphRAG Agent(工具型):负责回答问题,选择检索策略。
两条计划最终都汇入红色的 Knowledge Graph Construction Tool(一个内含多工具的单一构建工具),由它执行构建并把结果写进绿色的 Knowledge Graph。课程给这个架构标了 L4–L8 的路线徽标:L4 用户意图、L5 文件建议、L6 schema 提案、L7 实体与事实类型提案、L8 构建工具。整个架构的核心设计是「推理与执行分离」:agent 只产出计划(描述性文本),执行交给确定性工具——这是后面所有章节的基调。
8.2 Google ADK:把 agent 写出来的最小闭环
课程用 Google ADK(Agent Development Kit)实现。定义一个 agent 只需五要素:name(建议带版本号便于调试)、model、description(给其他 agent 看,供委派决策)、instruction(等价于系统提示词,给 agent 自己看)、tools(Python 函数数组)。工具就是普通函数——返回 ADK 喜欢的字典格式,docstring 会被原样转述给 LLM,是工具能否被正确调用的关键:
# ADK 的 agent 基类from google.adk.agents import Agent# 通过 LiteLLM 连 OpenAI 的轻量包装from google.adk.models.lite_llm import LiteLlm# 内存会话服务from google.adk.sessions import InMemorySessionService# 事件循环执行器from google.adk.runners import Runner# 构造消息 Content/Parts 的类型from google.genai import types # 课程用的模型名(LiteLLM 的 provider/model 命名格式)MODEL_GPT = "openai/gpt-4o"# 用 LiteLLM 包装出可用的模型对象llm = LiteLlm(model=MODEL_GPT)# 定义工具:发送参数化 Cypher 查询,返回问候语def say_hello(person_name: str) -> dict: # 工具说明写在 docstring 里,会原样转述给 LLM """Formats a welcome message to a named person. # 参数与返回值说明 Args: # 问候对象的名字 person_name (str): the name of the person saying hello # 返回值说明 Returns: # 含查询结果的字典 dict: A dictionary containing the results of the query. # docstring 结束 """ # 查询里用 $person_name 占位,参数由字典传入,杜绝字符串拼接注入 return graphdb.send_query("RETURN 'Hello to you, ' + $person_name AS reply", # 参数字典开始 { # 名字作为查询参数传入 "person_name": person_name // 参数字典结束 }) # 定义第一个 agent:五要素齐备hello_agent = Agent( # 构造参数逐行传入 name="hello_agent_v1", # 构造参数逐行传入 model=llm, # 构造参数逐行传入 description="Has friendly chats with a user.", # instruction 即系统提示词:约定何时调用工具、如何反馈 instruction="""You are a helpful assistant, chatting with a user. # 约束:提供了名字就用工具问候If the user provides their name, use the 'say_hello' tool to greet them. # 出错与成功两分支的反馈方式If the tool returns an error, inform the user politely. # 成功时转述工具回复 If the tool is successful, present the reply. // 查询字符串结束 """, # 构造参数逐行传入 tools=[say_hello],# 构造参数逐行传入)graphdb 不是 ADK 或 Neo4j 驱动的自带物,而是课程仓库里的一个薄封装(neo4j_for_adk 模块):它把 Neo4j Python 驱动包了一层,send_query(query, params) 返回 ADK 工具约定的字典格式(成功时 {"status": "success", ...}),工具的返回值因此可以直接交给 LLM。自己搭环境时,用官方驱动写一个同样形态的封装即可,本章及后面所有工具都依赖这个约定。
$person_name 是 Cypher 查询参数,不是字符串模板替换。课程专门演示了注入测试:把 "RETURN 'injection attack avoided'" 当作人名传入,返回的是「Hello to you, RETURN 'injection attack avoided'」——攻击字符串被当成普通文本,参数化查询防住了注入。
运行 agent 需要执行环境。ADK Runtime 由三部分组成:Runner 管理事件循环(Event Loop),协调 agent 与工具的执行顺序;Services 提供 State + Memory(可内存、可持久化);用户查询进 Runner,事件以异步流的形式回到用户:
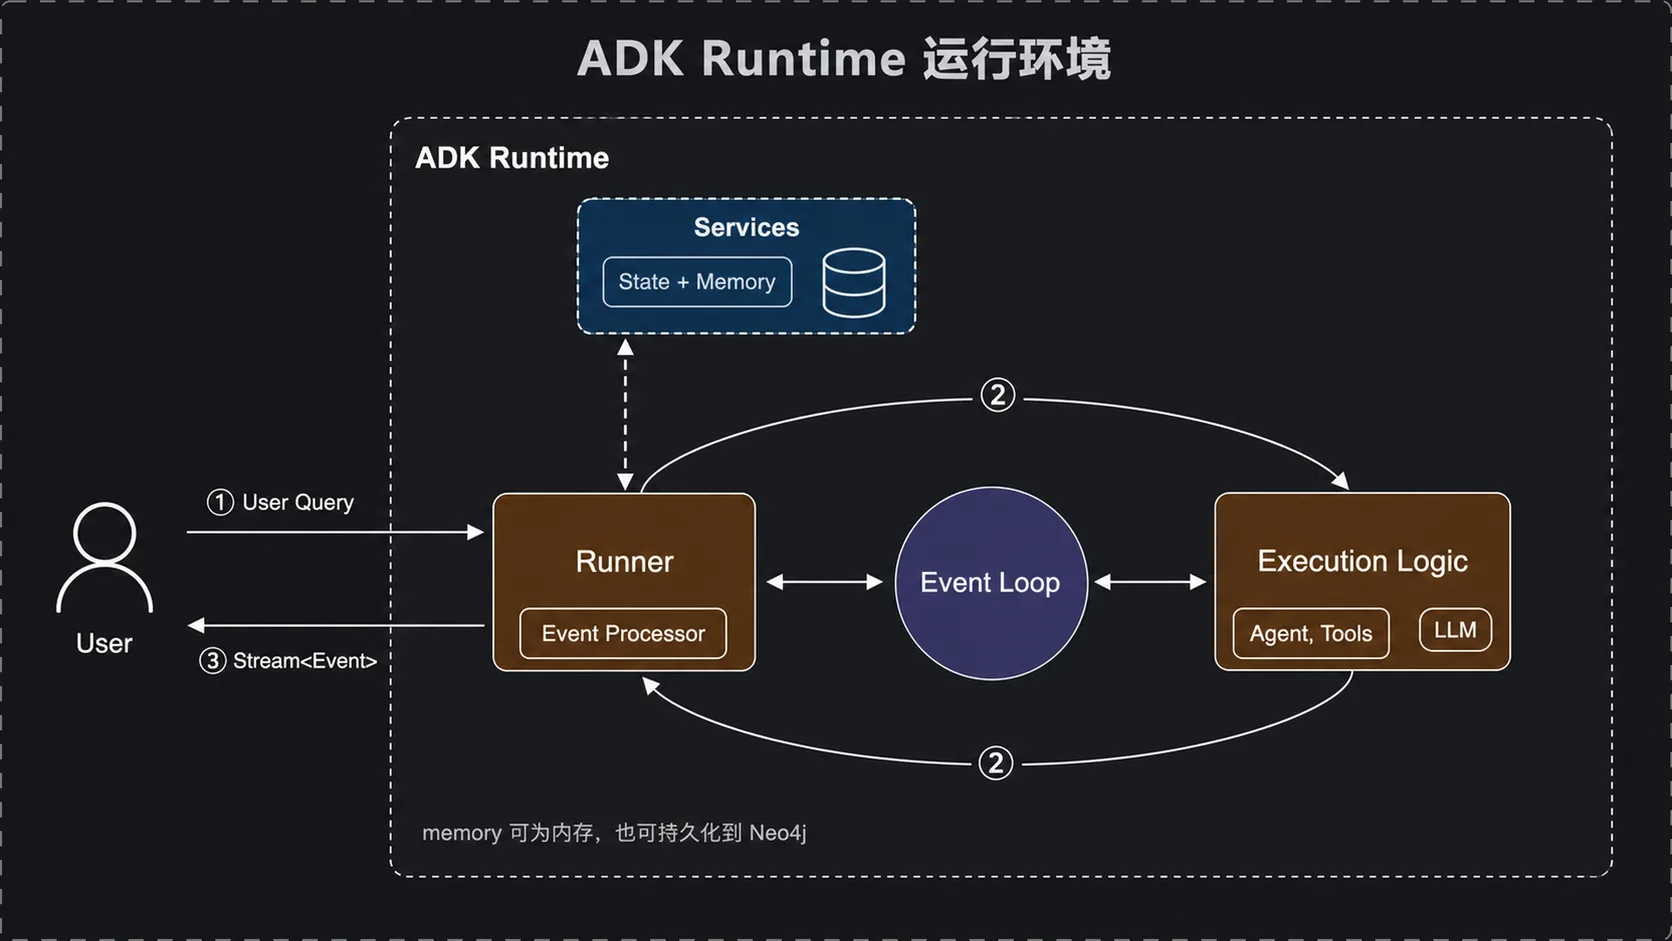
手工跑通一轮对话的代码值得细看,它揭示了 ADK 的事件模型:
# 初始化内存会话服务session_service = InMemorySessionService()# 创建会话:应用名、用户 ID、会话 ID 三元组定位await session_service.create_session( # 应用名 app_name=app_name, # 用户 ID user_id=user_id, # 会话 ID session_id=session_id # 创建结束)# 创建 Runner:绑定 agent 与会话服务runner = Runner( # 绑定要跑的 agent agent=hello_agent, # 应用名 app_name=app_name, # 会话服务挂到 Runner 上 session_service=session_service # 构造结束) # 把用户消息包装成 ADK 的 Content 格式content = types.Content(role='user', parts=[types.Part(text=user_message)])# 逐个消费事件流async for event in runner.run_async(user_id=user_id, session_id=session_id, new_message=content): # is_final_response 标记本轮对话的最终回复 if event.is_final_response(): # 从事件内容中取出文本 final_response_text = event.content.parts[0].text # 拿到最终回复后停止消费事件 break课程把这些样板封装成 make_agent_caller 工厂函数(后续每节课复用),支持多轮对话。第二轮 call("I am excited") 时 agent 记得名字——不过这个「记住」此时靠的是对话历史,等 8.4 节的 session state 登场后,记忆有了更可靠的位置。
8.3 委派:agent 之间的控制权移交
单个 agent 扩展成团队的模式:root agent(顶层协调者)+ 若干专职 sub-agent。课程搭了一个最小团队——greeting_subagent 管问候、farewell_subagent 管告别:
# 定义问候子代理:只负责问候这一件事greeting_subagent = Agent( # 构造参数逐行传入 model=llm, # 构造参数逐行传入 name="greeting_subagent_v1", # instruction:只做问候这一件事 instruction="You are the Greeting Agent. Your ONLY task is to provide a friendly greeting to the user." # 问候必须走工具生成 "Use the 'say_hello' tool to generate the greeting. " # 用户给了名字就传给工具 "If the user provides their name, make sure to pass it to the tool. " # 不做任何其他事 "Do not engage in any other conversation or tasks.", # 构造参数逐行传入 description="Handles simple greetings and hellos using the 'say_hello' tool.", # 构造参数逐行传入 tools=[say_hello],# 构造参数逐行传入) # 定义根代理:没有任何工具,只做意图分析与委派root_agent = Agent( # 构造参数逐行传入 name="friendly_agent_team_v1", # 构造参数逐行传入 model=llm, # 构造参数逐行传入 description="The main coordinator agent. Delegates greetings/farewells to specialists.", # instruction:只做意图分析与委派 instruction="""You are the main Agent coordinating a team. Your primary responsibility is to be friendly. # 子代理清单与各自职责 You have specialized sub-agents: # 两个专职子代理的职责一句话说明 1. 'greeting_agent': Handles simple greetings like 'Hi', 'Hello', 'Hey' # 另一个管告别 2. 'farewell_agent': Handles simple farewells like 'Bye', 'See you', 'Goodbye' # 委派规则:问候与告别各找专人 Analyze the user's query. If it's a greeting, delegate to 'greeting_agent'. # 告别意图则转给告别代理 If it's a farewell, delegate to 'farewell_agent'. # 其他情况自己兜底 For anything else, respond appropriately or state you cannot handle it. // 查询字符串结束 """, # 构造参数逐行传入 tools=[], # 关键差异:挂载子代理 sub_agents=[greeting_subagent, farewell_subagent]# 构造参数逐行传入)root agent 的 tools=[] 是个刻意的设计:它没有任何工具,唯一的能力是聊天和分析意图,问候与告别的实际动作全部由专职子代理完成。这种「协调者不干活」的分层让每个 agent 的 instruction 都很短很聚焦。
verbose=True 的事件日志是理解委派机制的最佳教材。发一句「Hello I'm ABK」,事件流大致是:root agent 发起一次函数调用 transfer_to_agent(agent_name='greeting_subagent_v1') → 框架把控制权移交给问候子代理(整段对话历史随行)→ 子代理调用 say_hello 工具 → FunctionResponse 返回 → 子代理产出最终回复(is_final_response()=True)。
# root 发起委派:移交给问候子代理(Final: False 表示中间事件) # 事件内容是一个函数调用 # 委派目标写进参数 # 框架内置的移交函数# 子代理接管控制权,调用问候工具 # 事件内容是一个函数调用 # 传给工具的用户名参数# 最终回复(Final: True) # 子代理产出最终文本回复Content: parts=[Part(text='Hello to you, ABK! ...')] role='model'Author 字段就是控制权指针:它从 root 换成子代理,说明这一步是子代理在执行;最后一条 Final: True 的事件才是对用户的回复。委派(delegation)和普通工具调用(tool calling)的本质区别在这里浮现:工具调用只是拿回一个结果,agent 的控制权不变;委派则把整段对话历史连同控制权一起移交——子代理接管后,用户看到的所有回复都来自子代理,直到它再把控制权交出去。第二轮「Thanks, bye!」时,控制权还在 greeting 子代理手上,它识别出告别意图,发起第二次 transfer_to_agent 移交给 farewell 子代理——委派链可以在任何 agent 上继续。
8.4 session state:跨 agent 的共享记忆
对话历史随委派移动,但多智能体系统需要一种不属于任何对话的记忆——session state。ADK 里它就是一个字典:session.state。ADK 追踪对它的每次修改(delta)并跨所有 agent(无论并行还是顺序执行)保持一致。工具通过 ToolContext 读写状态——当工具函数的最后一个参数是 tool_context: ToolContext 时,ADK 自动注入,调用方无需传递:
# 导入工具上下文类型from google.adk.tools.tool_context import ToolContext # 定义有状态的问候工具:问候并记住用户名def say_hello_stateful(user_name: str, tool_context: ToolContext) -> dict: // 查询字符串结束 """Says hello to the user, recording their name into state. # 参数说明 Args: # 用户的名字 user_name (str): The name of the user. // 查询字符串结束 """ # 把用户名写入会话状态 tool_context.state["user_name"] = user_name # 照常发送问候查询(查询串不加 f 前缀,$user_name 必须留给数据库做参数绑定) return graphdb.send_query( # 用户名通过参数绑定进查询 "RETURN 'Hello to you, ' + $user_name + '!' AS reply", # 参数字典开始 { # 用户名作为查询参数传入 "user_name": user_name // 参数字典结束 }) # 定义有状态的告别工具:从状态里读出用户名def say_goodbye_stateful(tool_context: ToolContext) -> dict: // 查询字符串结束 """Says goodbye to the user, reading their name from state.""" # 读取用户名,不存在时回退为 stranger user_name = tool_context.state.get("user_name", "stranger") # 用读出的名字生成告别语 return graphdb.send_query("RETURN 'Goodbye, ' + $user_name + ', nice to chat with you!' AS reply", # 参数字典开始 { # 用户名作为查询参数传入 "user_name": user_name // 参数字典结束 })两个工具、一次写入、一次读取,就实现了跨工具的个性化:say_hello_stateful 写 user_name,say_goodbye_stateful 读出来拼进告别语。状态流验证打印出三行:Initial State: {} → 对话过程中 tool_context.state['user_name']: ABK → Final State: {'user_name': 'ABK'}。
课程还藏了一个失败案例的教训:交互式对话里用户不报姓名,LLM 开始「猜」——回复「Hello to you, there.」,state 里留下 user_name: 'there'。模型会编造缺失信息,而显式的状态读写不依赖模型的记忆能力,比「LLM 应该记得」可靠得多。这也是后面所有课程把关键上下文(用户目标、批准的文件、schema 计划)全部放 session state 的原因。
九、五个专用智能体:把决策环节逐个交给 agent
理论框架就位后,课程用四节课把 L4–L7 四个决策环节逐个 agent 化。所有 agent 共享一套模式:工具读写 session state、prompt 分「角色-提示-思维链」三段、关键动作设人工批准。
9.1 User Intent Agent:用工具守住「人批准」这一关
用户意图 agent 的任务:帮用户头脑风暴知识图谱用例,把意图固化成结构化的 user goal——两个字段,kind_of_graph(最多三个词,如 "supply chain")加 description(几句话说明建图意图)。它的提示词用 f-string 拼装四段:角色与目标、对话提示(附五个经典用例做 few-shot:社交网络、物流网络、推荐系统、欺诈检测、流行文化图谱)、输出定义(user goal 的字段规格)、思维链(先理解、再澄清、记录感知目标、请用户确认、批准后保存)。
工具设计是这一节的重点。这个 agent 有两个工具,职责刻意分离:
先看两个贯穿后面所有工具的返回值 helper——它们把工具结果统一成 LLM 好读的字典:
# 工具成功:返回状态与一个具名结果字段def tool_success(key: str, value) -> dict: # 状态 + 以 key 命名的结果字段 return {"status": "success", key: value} # 工具失败:返回状态与一句给 LLM 看的错误说明def tool_error(message: str) -> dict: # 状态 + 一句给 LLM 的修复指引 return {"status": "error", "error_message": message}约定很简单:LLM 读到 status 就知道该继续还是该自纠,读到 error_message 就知道下一步做什么——这个字符串写得像不像一句「修复指南」,直接决定 agent 能不能自己走出错误。
# 常量:感知目标的 state 键名PERCEIVED_USER_GOAL = "perceived_user_goal" # 工具一:记录 agent 感知到的目标def set_perceived_user_goal(kind_of_graph: str, graph_description: str, tool_context: ToolContext): // 查询字符串结束 """Sets the perceived user's goal, including the kind of graph and its description. # 参数说明 Args: # 图类型的取值说明 kind_of_graph: 2-3 word definition of the kind of graph, for example "supply chain" # 图描述的取值说明 graph_description: a single paragraph description of the graph // 查询字符串结束 """ # 组装目标数据 user_goal_data = {"kind_of_graph": kind_of_graph, "graph_description": graph_description} # 写入会话状态 tool_context.state[PERCEIVED_USER_GOAL] = user_goal_data # 返回成功结果 return tool_success(PERCEIVED_USER_GOAL, user_goal_data) # 常量:批准目标的 state 键名APPROVED_USER_GOAL = "approved_user_goal" # 工具二:用户批准后,把感知目标复制为批准目标def approve_perceived_user_goal(tool_context: ToolContext): // 查询字符串结束 """Upon approval from user, will record the perceived user goal as the approved user goal. # 仅在用户明确批准后调用 Only call this tool if the user has explicitly approved the perceived user goal.""" # 信任但要验证:确认感知目标已存在 if PERCEIVED_USER_GOAL not in tool_context.state: # 返回带修复指引的错误,而不是抛异常 return tool_error("perceived_user_goal not set. Set perceived user goal first or ask clarifying questions.") # 用户已批准,把感知目标复制为批准目标 tool_context.state[APPROVED_USER_GOAL] = tool_context.state[PERCEIVED_USER_GOAL] # 返回成功结果 return tool_success(APPROVED_USER_GOAL, tool_context.state[APPROVED_USER_GOAL])set 工具永远无法直接写 approved_user_goal 键——工具集合本身就是守门员,「人批准」这个环节不可能被 LLM 跳过。错误信息也值得学:approve 工具在感知目标不存在时返回的 tool_error 文案是一句「给 LLM 的修复指南」(先去 set 或继续澄清),模型拿到错误能自纠,而不是简单崩溃。后续所有批准类工具(批准文件、批准 schema、批准抽取计划)都是这个模式的复制。
实测用「物料清单图(BOM graph)」用例跑通:用户说想建一张从供应商到成品的 BOM 图、用于根因分析;agent 反问澄清(担心制造还是供应商问题),用户补充后 agent 调 set_perceived_user_goal 记录、复述请求确认、用户回复「Approve that goal.」、agent 调 approve 工具——session state 里从此有了 approved_user_goal,后续所有 agent 从这里取方向。
9.2 File Suggestion Agent:从 memory 取上下文,给文件访问加护栏
文件建议 agent 从导入目录的候选文件里挑出与已批准目标相关的文件。它面对 15 个文件:6 个供应链 CSV(assemblies/components/parts/products/suppliers/part_supplier_mapping)和 9 个产品评论 Markdown。正确答案只选 6 个 CSV——评论属于非结构化数据,走另一条工作流。
这节课的工具设计有两个教学点。第一,取上下文也走工具:get_approved_user_goal 从 session state 读取目标,而不是把目标硬编码进 prompt——「从 memory 而非对话历史取上下文」是多阶段工作流保持方向一致的关键,agent 不会因为对话轮次多了而「忘记方向」。第二,文件访问有硬护栏:
# 路径处理from pathlib import Path# 只读文件前 N 行from itertools import islice# 工具:列出导入目录下的全部文件(相对路径)def list_available_files(tool_context: ToolContext) -> dict: // 查询字符串结束 """Lists files available for knowledge graph construction. # 路径说明:相对导入目录 All files are relative to the import directory.""" # 定位导入目录 import_dir = Path(get_neo4j_import_dir()) # 递归列出所有文件并转为相对路径 file_names = [str(x.relative_to(import_dir)) # 递归遍历目录下所有文件 for x in import_dir.rglob('*') # 只要文件不要目录 if x.is_file()] # 写入会话状态 tool_context.state[ALL_AVAILABLE_FILES] = file_names # 返回成功结果 return tool_success(ALL_AVAILABLE_FILES, file_names) # 工具:采样查看文件前 100 行def sample_file(file_path: str, tool_context: ToolContext) -> dict: // 查询字符串结束 """Samples a file by reading its content as text. Reads up to a maximum of 100 lines.""" # 护栏一:拒绝绝对路径 if Path(file_path).is_absolute(): # 绝对路径直接拒绝 return tool_error(f"file_path must be relative to the import directory: {file_path}") # 定位导入目录(每个工具各自解析,不依赖其他工具的局部变量) import_dir = Path(get_neo4j_import_dir()) # 拼出完整路径 full_path_to_file = import_dir / file_path # 护栏二:文件必须存在 if not full_path_to_file.exists(): # 文件不存在则报错 return tool_error(f"File does not exist in import directory: {file_path}") # 读取前 100 行 with open(full_path_to_file, 'r', encoding='utf-8') as file: # 只读前 100 行 lines = list(islice(file, 100)) # 拼接成字符串 content = ''.join(lines) # 返回内容 return tool_success("content", content)护栏的必要性在于 LLM 会编造路径。工具层的绝对路径拒绝、存在性检查、错误信息里的修复指引,把 LLM 的不可靠性限制在安全边界内。课程也坦诚展示了防御强度的取舍:set_suggested_files 对传入的文件列表不做存在性校验(讲师原话「有点 YOLO」),而 approve_suggested_files 在 suggested 不存在时会报错——哪些入口从严、哪些留白,是每个系统自己的判断。用户确认后,6 个 CSV 进入 approved_files。
9.3 Schema Proposal:批评者模式与「循环封装成工具」
Schema 提案是结构化工作流里决策最重的环节:决定每个 CSV 变成节点还是关系、字段怎么映射。这节课引入两个新的编排思想。
第一个是批评者模式(critic pattern):提案 agent 生成初始 schema,批评 agent 挑毛病,两者循环迭代。第二个更巧:把整个循环封装成一个工具。协调器(Schema Proposal Coordinator)只挂三个工具——refinement_loop_as_tool(一个 LoopAgent 包装成的工具)、获取提案、批准提案——它调用 refinement_loop_as_tool 时,内部其实是提案-批评的多轮迭代,复杂度被完全封装。
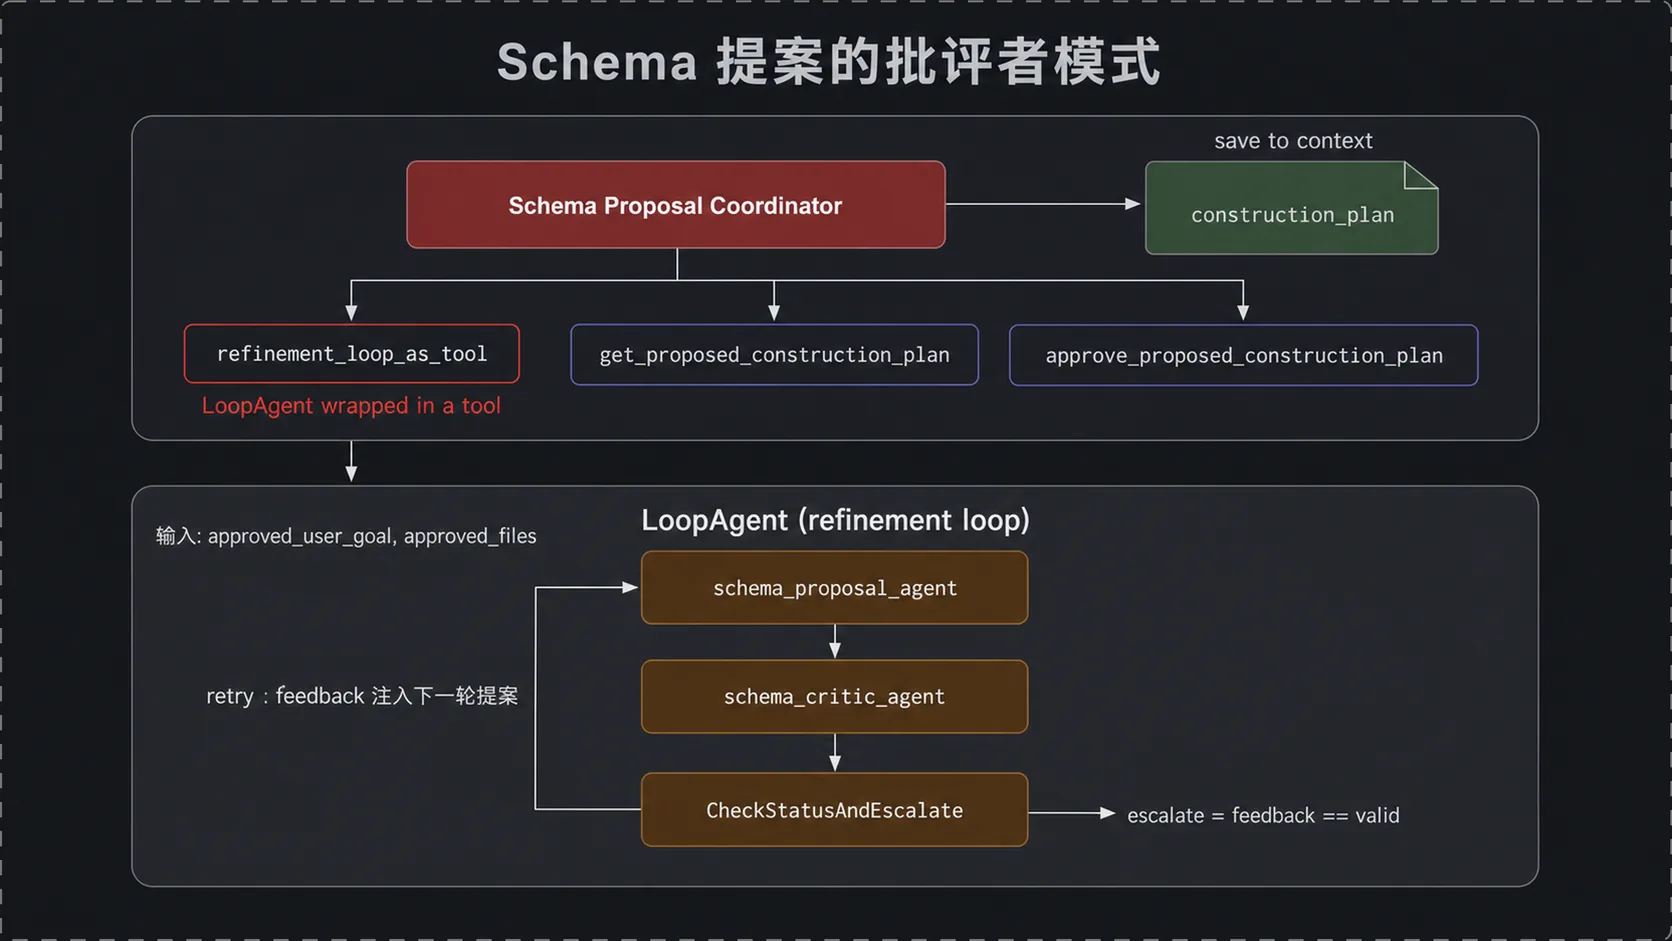
循环内部的三个子代理按序执行:schema_proposal_agent(提案)→ schema_critic_agent(批评,output_key="feedback" 把回复直接写进 state 的 feedback 键)→ CheckStatusAndEscalate(自定义终止判定:feedback 等于 "valid" 就发出 escalate 信号退出循环,否则回到提案代理重来)。终止是双保险——escalate 信号加 max_iterations=2,达不成共识就把控制权交还人类,而不是无限烧 token。
# 类型注解:异步生成器from typing import AsyncGenerator# ADK 的自定义 agent 基类与循环 agentfrom google.adk.agents import BaseAgent, LoopAgent# 调用上下文(能拿到 session.state)from google.adk.agents.invocation_context import InvocationContext# 事件与事件动作(escalate 挂在 EventActions 上)from google.adk.events import Event, EventActions # 调试回调:进入循环内的 agent 时打印一行,方便观察迭代顺序def log_agent(callback_context): # 打印当前 agent 名,返回 None 表示不改变正常流程 print(f"[loop] entering {callback_context.agent_name}") # 返回 None 表示不改变流程 return None# 自定义终止判定代理:检查 feedback 状态,valid 时升级退出循环class CheckStatusAndEscalate(BaseAgent): # 异步实现:读取状态并决定是否退出 async def _run_async_impl(self, ctx: InvocationContext) -> AsyncGenerator[Event, None]: # 读取批评反馈,缺省视为 valid feedback = ctx.session.state.get("feedback", "valid") # feedback 为 valid 时应停止循环 should_stop = (feedback == "valid") # 产出事件:escalate 为真则终止本循环 yield Event(author=self.name, actions=EventActions(escalate=should_stop)) # 组装循环代理:提案、批评、终止判定依次执行,最多迭代 2 轮schema_refinement_loop = LoopAgent( # 构造参数逐行传入 name="schema_refinement_loop", # 构造参数逐行传入 description="Analyzes approved files to propose a schema based on user intent", # 构造参数逐行传入 max_iterations=2, # 构造参数逐行传入 sub_agents=[schema_proposal_agent, schema_critic_agent, CheckStatusAndEscalate(name="check_status")], # 挂上进入日志回调 before_agent_callback=log_agent# 构造参数逐行传入)批评 agent 与提案 agent 之间不直接通话,靠的是 output_key 这一个参数:
# 批评代理:把自己的回复自动写进 session state 的 feedback 键schema_critic_agent = Agent( # 构造参数逐行传入 name="schema_critic_agent_v1", # 构造参数逐行传入 model=llm, # 构造参数逐行传入 description="Critiques a proposed graph schema.", # 构造参数逐行传入 instruction=critic_agent_instruction, # 关键:agent 的最终回复被原样存进 state["feedback"] output_key="feedback", # 挂上进入日志回调 before_agent_callback=log_agent# 构造参数逐行传入)上一轮批评如何传给下一轮提案?ADK 的模板变量:提案 prompt 里写 <feedback>{feedback}</feedback>(XML 分隔符标出边界),ADK 组装 prompt 时用 session state 里的 feedback 值替换——批评与提案两个 agent 通过 state 解耦通信。
提案 agent 的提示词把数据工程师的建模直觉显式编码:文件名单一事物且只有一个唯一标识 → 大概率是节点;文件名是两样东西的组合(如 part_supplier_mapping)→ 大概率是专有关系;节点文件里的外键引用 → 参照关系;join 表 → full relationship。而且每条规则都有工具支撑——search_file(类 grep)验证候选唯一键在源文件里真实存在。批评 agent 的检查清单同样具体:唯一标识真的唯一吗?有节点该改成关系吗?schema 是连通图吗(孤立组件是硬伤)?实测首轮提案给出 4 节点 3 关系的 BOM schema,批评 agent 判 retry 并给出五条结构化反馈(组件节点歧义、层级缺失、语义重叠等),反馈写进 state 等下一轮。
9.4 Entity & Fact Type Proposal:非结构化分支的姊妹篇
非结构化数据(Markdown 产品评论)没有 schema 可提,要提的是「能从文本里抽出什么」。这个环节由两个子 agent 组成:NER schema agent 读评论文件提出实体类型,fact type extraction agent 第二遍扫描提出事实类型。实体类型分两类:well-known(结构化 schema 里已有的节点标签,如 Product)和 discovered(schema 里没有但文本里反复提及的,如 Issue、Customer Experience);规则明确——优先复用已有类型,别把 Age 这类数量概念提为实体(那是属性)。
事实类型是三元组(subject, predicate, object),只提「类型」不提具体事实——提 (Product, has_issue, Issue) 而不是「ABK 的桌子有划痕」。提案逐条经 add_proposed_fact 工具写入,工具内置守卫:主语和宾语标签必须在已批准实体列表里,否则返回 tool_error:
# 工具:逐条添加事实类型提案,带实体标签守卫def add_proposed_fact(subject_label: str, predicate_label: str, # 宾语标签与工具上下文参数 object_label: str, tool_context: ToolContext) -> dict: // 查询字符串结束 """Adds a proposed fact type triplet with guardrails against invalid labels.""" # 读取已批准实体列表 approved_entities = tool_context.state.get(APPROVED_ENTITIES, {}) # 守卫一:主语必须是已批准实体 if subject_label not in approved_entities: # 主语不在批准列表则报错 return tool_error(f"Subject '{subject_label}' is not an approved entity type.") # 守卫二:宾语必须是已批准实体 if object_label not in approved_entities: # 宾语不在批准列表则报错 return tool_error(f"Object '{object_label}' is not an approved entity type.") # 读取现有提案字典 current_facts = tool_context.state.get(PROPOSED_FACTS, {}) # 以谓词为键写入三元组 current_facts[predicate_label] = { # 三元组:主语 "subject_label": subject_label, # 三元组:谓词 "predicate_label": predicate_label, # 三元组:宾语 "object_label": object_label, // 字典结束 } # 写回会话状态 tool_context.state[PROPOSED_FACTS] = current_facts # 返回成功结果 return tool_success(PROPOSED_FACTS, current_facts)逐条提交比整表提交多花 round trips(token 成本),换来的是逐条纠错——课程认为多花的 round trips 换来了纠错能力,值得。这一节还有个朴素的工程提醒:fact agent 第一次运行时只输出了纯文本、忘了调工具,重跑一次成功。LLM 偶尔不遵守「必须调工具」的约定,生产系统要有自动重试。最终产出 approved_entities 与 approved_fact_types,连同结构化分支的 approved_construction_plan,三份计划全部就位。
十、执行与装配:从计划到三层图
10.1 构建领域图:确定性的代码,不需要 LLM
计划都批准了,谁来施工?课程在这一步做了一个重要的收敛:原计划设计一个 Agent Tool,实际重构为单一 Tool——幻灯片上「Agent」被划掉,换成 Tool。理由:按规则把 CSV 转成图是纯机械过程,LLM 参与只会添乱。这个构建工具被戏称为「神经符号 agent」——LLM(神经)出计划,规则代码(符号)执行。
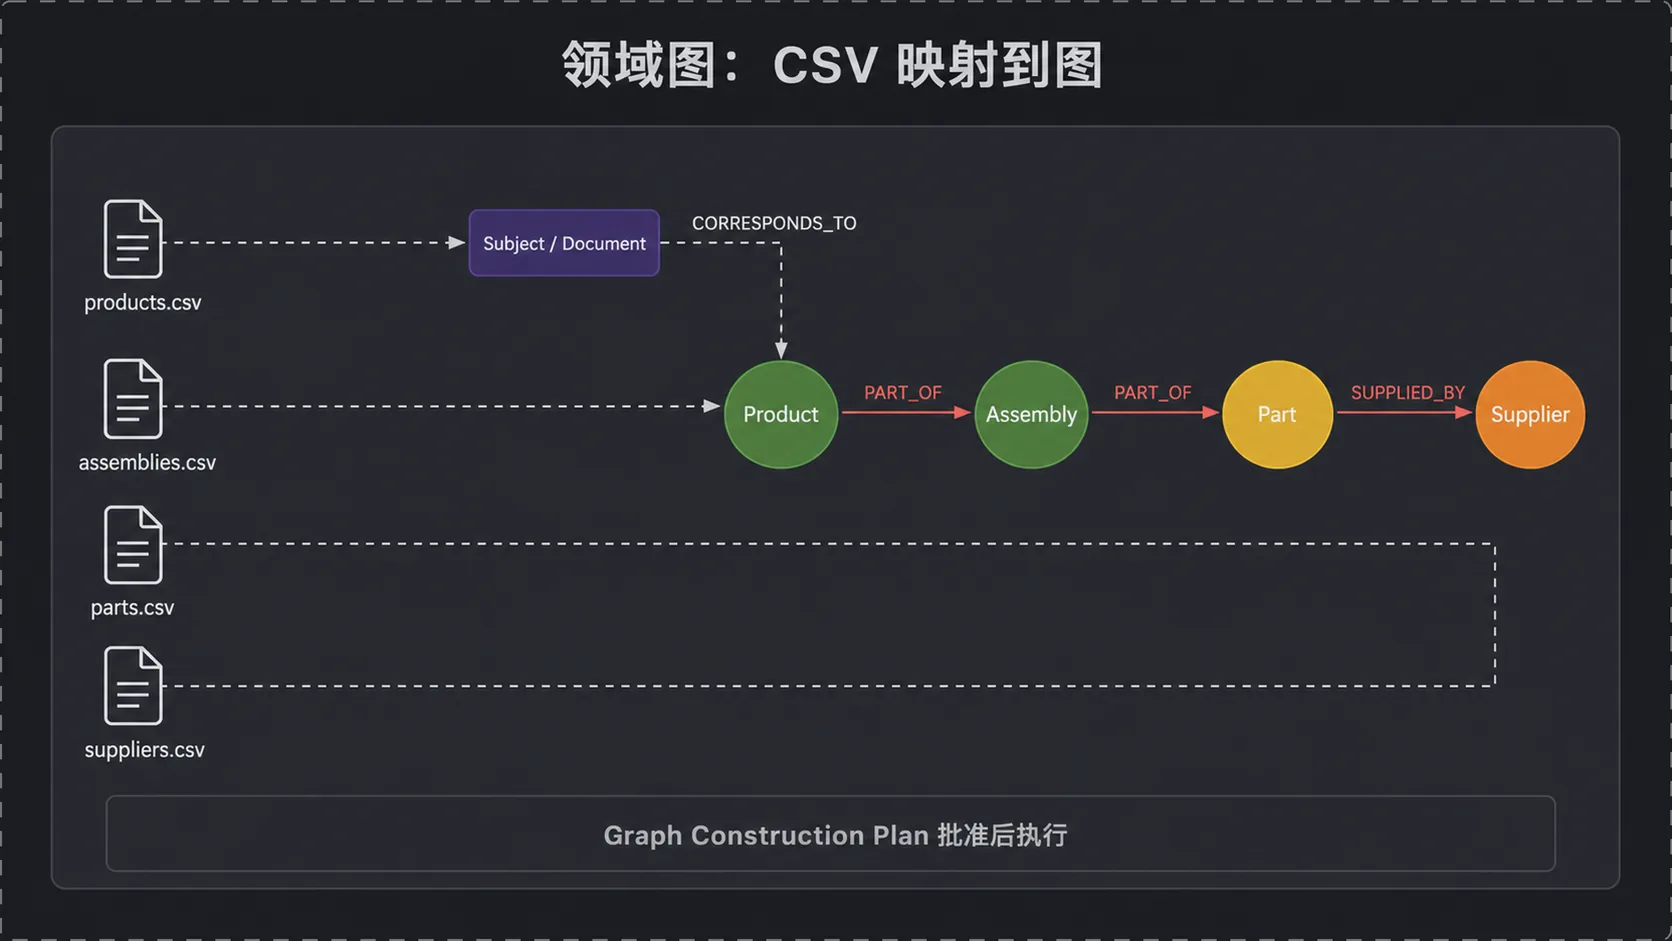
construct_domain_graph 的实现是一条标准的批量导入流水线。节点侧:为每个节点标签的唯一列建唯一性约束(约束名不支持参数化,只能字符串拼接,课程提醒应加 sanitize),然后用 LOAD CSV 批量导入:
# 工具:为节点标签的唯一属性创建唯一性约束def create_uniqueness_constraint(label: str, unique_property_key: str) -> Dict[str, Any]: // 查询字符串结束 """Creates a uniqueness constraint for a node label and property key.""" # 约束名由标签和属性键拼接(Neo4j 不支持参数化,需拼接) constraint_name = f"{label}_{unique_property_key}_constraint" # 拼接约束创建语句 query = f"""CREATE CONSTRAINT `{constraint_name}` IF NOT EXISTS// 索引作用的目标节点FOR (n:`{label}`) REQUIRE n.`{unique_property_key}` IS UNIQUE""" # 发送查询 results = graphdb.send_query(query) # 返回结果 return results # 工具:从 CSV 批量导入节点def load_nodes_from_csv(source_file: str, label: str, # 唯一列名与属性列表参数 unique_column_name: str, properties: list[str]) -> Dict[str, Any]: // 查询字符串结束 """Batch loading of nodes from a CSV file""" # 拼接 LOAD CSV 语句:MERGE 幂等写入,每 1000 行一个事务 query = f"""LOAD CSV WITH HEADERS FROM "file:///" + $source_file AS row// 调用内置过程CALL (row) {{ // 幂等创建:存在则复用,不存在才建 MERGE (n:`{label}` {{ `{unique_column_name}` : row[$unique_column_name] }}) // 对列表逐项执行 FOREACH (k IN $properties | SET n[k] = row[k])# 每 1000 行一个事务}} IN TRANSACTIONS OF 1000 ROWS""" # 发送查询:文件名、唯一列名、属性列都是真正的查询参数 results = graphdb.send_query(query, { # CSV 文件名 "source_file": source_file, # 唯一列名 "unique_column_name": unique_column_name, # 属性列名列表 "properties": properties, // 参数字典结束 }) # 返回结果 return results顺带对比一下两个工具的传参方式:create_uniqueness_constraint 里的标签和属性键是拼进查询字符串的——Neo4j 不支持参数化约束名与标签,所以「加 sanitize」的提醒只针对那一处;而 load_nodes_from_csv 里的文件名、列名、属性列表都是真正的查询参数,走 $param 绑定。两种写法各有边界,别混为一谈。
这段查询用了两个较新的 Cypher 特性,旧版实例上会直接报语法错误:一是作用域式子查询 CALL (row) { ... }(早期写法是 CALL { WITH row ... },现已弃用),二是动态属性写入 SET n[k] = row[k](早期版本只支持动态读取,写入要改用 apoc.create.setProperty)。跑之前确认实例版本,或按旧写法降级。
关系侧先 MATCH 两端节点、再 MERGE 建边——节点已经唯一,关系 MERGE 天然防重:
# 工具:从 CSV 批量导入关系(按构建规则的关系定义)def load_relationships_from_csv(source_file: str, rel_type: str, # 起点节点的标签、键名与列名 from_label: str, from_key: str, from_column: str, # 目标节点标签、键与列名 to_label: str, to_key: str, to_column: str) -> Dict[str, Any]: // 查询字符串结束 """Batch loading of relationships from a CSV file""" # 先 MATCH 两端节点,再 MERGE 建边;两端都有唯一性约束,MERGE 天然防重 query = f"""LOAD CSV WITH HEADERS FROM "file:///" + $source_file AS row// 调用内置过程CALL (row) {{ // 匹配图中的节点 MATCH (from:`{from_label}` {{ `{from_key}` : row[$from_column] }}) // 匹配图中的节点 MATCH (to:`{to_label}` {{ `{to_key}` : row[$to_column] }}) // 幂等创建:存在则复用,不存在才建 MERGE (from)-[:`{rel_type}`]->(to)# 每 1000 行一个事务}} IN TRANSACTIONS OF 1000 ROWS""" # 发送查询:文件名与两端列名作为参数传入 results = graphdb.send_query(query, { # CSV 文件名 "source_file": source_file, # 起点列名 "from_column": from_column, # 终点列名 "to_column": to_column, // 参数字典结束 }) # 返回结果 return results「全部节点导入完再导入全部关系,顺序不能反」的原因在这里一目了然:关系侧用 MATCH 找端点——节点还没导进去,MATCH 匹配为空,整行被静默跳过,最后会得到一张只有节点没有边的图。IN TRANSACTIONS OF 1000 ROWS 分批事务防止大文件撑爆内存。跑完用一段「花式 Cypher」(UNWIND + CALL 子查询 + 动态关系类型匹配)对账:把构建计划里声明的每条关系拿出来抽样验证图里确实存在——(Product)-[Contains]->(Assembly)、(Part)-[Is_Part_Of]->(Assembly)、(Part)-[Supplied_By]->(Supplier),三条全对上,领域图完成。
10.2 SimpleKGPipeline:Markdown 进词汇图和主题图
非结构化侧交给 Neo4j GraphRag 库的现成管线 SimpleKGPipeline,组件流:Data Loader → Text Splitter → Chunk Embedder → Entity & Relation Extractor → Graph Pruner → KG Writer → Entity Resolver。课程需要适配两个接口:管线只吃 PDF loader,于是写一个 MarkdownDataLoader 伪装成 PdfDocument(顺带把 H1 标题抽成元数据);文本按 Markdown 分页符 --- 切块:
# 正则import re# neo4j-graphrag 的切分器基类与数据类型from neo4j_graphrag.experimental.components.text_splitters.base import TextSplitter# 切块数据类型from neo4j_graphrag.experimental.components.types import TextChunk, TextChunks # 自定义文本切分器:按正则匹配的分隔符切块class RegexTextSplitter(TextSplitter): // 查询字符串结束 """Split text using regex matched delimiters.""" # 保存分隔符(参数名避开标准库的 re 模块,免得混淆) def __init__(self, pattern: str): # 保存分隔符 self.pattern = pattern # 异步执行切分 async def run(self, text: str) -> TextChunks: # 按分隔符切分 texts = re.split(self.pattern, text) # 每块包装为 TextChunk 并带序号 chunks = [TextChunk(text=str(t), index=i) for (i, t) in enumerate(texts)] # 返回块集合 return TextChunks(chunks=chunks)关键动作是把第 9 章的计划「编译」进管线参数:approved_entities 直接变成 schema 的 node_types;approved_fact_types 的键转大写变成 relationship_types;三元组组装成 patterns;additional_node_types=False 进入严格模式,抽取器不许发明新类型。抽取提示词做上下文化:注入 schema 和文件前 5 行(含 H1 标题),并规定 JSON 输出格式。每个文件组装一个管线实例,循环异步执行——10 个评论文件全部处理完,词汇图(Document/Chunk)和主题图(抽出的实体与三元组)就位。
10.3 实体解析:把两套图对齐
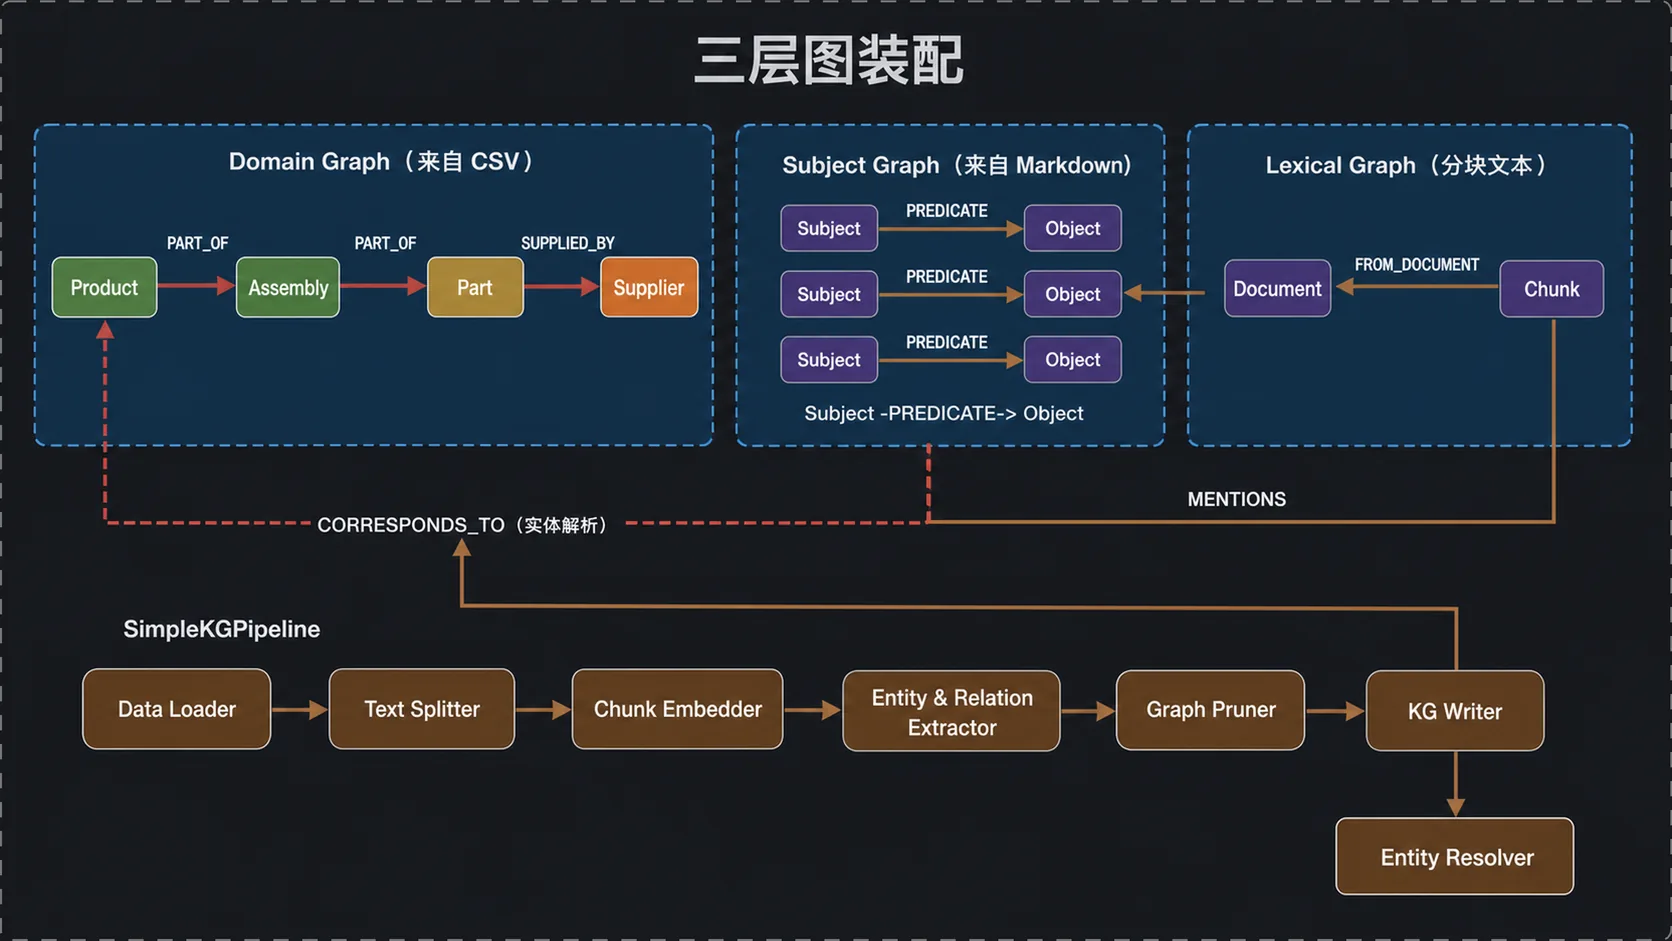
最后一步是把主题图接到领域图:LLM 抽出的 Product 实体和 CSV 导入的 Product 节点说的是同一批东西(都指那 10 件家具),必须连上 CORRESPONDS_TO 关系,否则第 6 章那种「从评论实体走到供应链节点」的查询就断了。难点是「对齐键」:LLM 自由抽取的属性键有 28 个(dimensions、finish、material、shade_material……),领域图里只有 4 个,两边键名对不上。课程用两层启发式:先用 normalize_key 归一化(小写、去标签前缀、空格转下划线),再用 rapidfuzz 对键名模糊匹配——name 与 product_name 相似度 1.0,是最佳对齐键。键配对后进 Cypher,用 APOC 的 Jaro-Winkler 距离做值相似度,阈值卡到 0.4 以内(只留几乎相同的名字),MERGE 建边并打上时间戳:
# 定义 Cypher:按值相似度连接主题图实体与领域图节点results = graphdb.send_query("""// 匹配图中的节点MATCH (entity:`Product`:__Entity__), (domain:`Product`)// 守卫:领域节点必须是 CSV 导入的那批,排除抽出来的实体自身,否则会连出自环WHERE NOT domain:__Entity__// 中间投影:把当前结果传给下一步WITH entity, domain, apoc.text.jaroWinklerDistance(entity[$entityKey], domain[$domainKey]) AS score// 过滤条件WHERE score < 0.4// 幂等创建:存在则复用,不存在才建MERGE (entity)-[r:CORRESPONDS_TO]->(domain) // 仅在首次创建时执行 ON CREATE SET r.created_at = datetime() // 已存在匹配时执行 ON MATCH SET r.updated_at = datetime()// 返回结果RETURN elementId(entity) as entity_id, r, elementId(domain) as domain_id// 查询字符串结束""", {"entityKey": "name", "domainKey": "product_name"})还有个方向必须先确认再动手:同一段里出现了两种打分语义——rapidfuzz 的键名匹配是相似度(name 对 product_name 得 1.0,越大越像),而 apoc.text.jaroWinklerDistance 返回的是距离(相同字符串得 0,完全不同得 1),所以上面查询用 score < 0.4「越小越像」。方向用反不会报错,只会静默连出一图的错误关系。动手前先跑一句自检:
// 自检:相同字符串的得分应接近 0(距离语义);若接近 1 则是相似度语义,阈值方向要反过来RETURN apoc.text.jaroWinklerDistance("Aurora Table", "Aurora Table") AS same, // 相同字符串距离应为 0,完全不同应为 1 apoc.text.jaroWinklerDistance("Aurora Table", "zzzzzz") AS different阈值本身:调到 0.5 会混入假阳性(design、dimensions 之类跟 description 撞上),实践取 0.1~0.4 之间。验证:correlate_subject_and_domain_nodes("Product", "name", "product_name") 返回 10 条关系——每个评论里的产品都连上了领域图里对应的 Product 节点。三层图(domain + lexical + subject)至此装配完成,跨图查询的最后一段路被打通。课程也点出了边界:实体解析是图工程里公认的老大难,这里用「键模糊匹配加值相似度」两层启发式够用,更复杂的数据可以组合更多技术,甚至把它做成独立 agent。
十一、总结
回到开头的两个问题。Apple 幻觉的根源是检索系统只有「相似」这一种世界观——它不知道 NetApp 和 Apple 是两个实体,也没有「这家公司的投资者是谁」这种关系可走。三层图补上了缺失的维度:domain graph 从 CSV 承载实体与关系,lexical graph 从文本承载语义向量,subject graph 把文本里抽出的实体三元组用 CORRESPONDS_TO 锚回领域图。向量相似度负责找入口,模式匹配负责沿关系走,两者在第 5 章的 retrieval_query 里合流,在第 7 章的 Text2Cypher 里完全体——LLM 生成 Cypher 的那一刻,自然语言、关系结构、语义检索三种表达在同一张图上交汇。
两门课的关系也值得说一句。课程 A(Knowledge Graphs for RAG)是手工原型:把一条 RAG 流水线的每个环节亲自跑一遍——建索引、写 MERGE、调 API、试查询。课程 B(Agentic Knowledge Graph Construction)把同样的流程交给多智能体系统,但真正交给 agent 的只有四个决策环节(意图、文件、schema、抽取计划),执行仍然全是确定性代码。这门课对「多智能体系统该管什么」给出的答案相当克制:agent 负责把人的判断结构化成计划,工具负责把计划变成图,LLM 的位置被安排在「写计划、批评计划、把计划翻译成 Cypher」这些真正需要语言能力的地方。
想自己跑一遍:注册 Neo4j 的免费云托管实例(Aura),从 DeepLearning.AI 的课程页面或 GitHub 仓库拉取笔记本,两个数据集(电影图、SEC 文件)都在仓库里。有一处环境差异要先分清:前七章全部通过驱动写入,Aura 免费实例即可;第 10 章的 LOAD CSV ... FROM "file:///" 读的是数据库自己的 import 目录,托管实例上没有这个可写目录,需要本地 Neo4j Desktop 或自建 Docker 实例。两条路径分开跑,不必二选一。最有性价比的复现是第 4 章那条幻觉实验——同一个语料库,问库里有的公司和库里没有的公司,再对比加窗口与不加窗口的回答差异,向量检索的能力边界和图的补法在十分钟内就能亲眼看清。
本文由 AgentWorkFlow 生成