
文章内容
- 一、从一次性单向生成到 Agentic 工作流
- 1.1 一次生成的问题(直接调用裸模型思考)
- 1.2 工作流:思考、研究、修改的循环
- 1.3 示例
- 二、模型的自主性
- 2.1 为什么用 agentic 这个词
- 2.2 低自主:步骤全由人定义
- 2.3 半自主:把选择权交给模型
- 2.4 高自主:连步骤顺序都由 agent 定
- 2.5 两端的取舍
- 三、为什么要用 Agentic
- 3.1 数据支撑
- 3.2 做以前做不到的事,以及提升效率
- 3.3 模块化
- 四、应用场景示例
- 4.1 发票处理
- 4.2 客户订单查询
- 4.3 通用客户服务
- 4.4 浏览器使用
- 4.5 选项目的经验
- 五、任务分解:把任务拆成可执行的步骤
- 5.1 一个判断标准
- 5.2 迭代式拆分
- 5.3 手上的积木
- 六、Evals:不预测,先建立再测量
- 6.1 为什么要 evals
- 6.2 反例
- 七、四大设计模式
- 7.1 反思 Reflection
- 7.2 工具使用 Tool Use
- 7.3 规划 Planning
- 7.4 多智能体协作 Multi-agent
- 八、总结
本文内容整理自吴恩达(Andrew Ng)《Agentic AI》课程模块1(共 8 节)
一、从一次性单向生成到 Agentic 工作流
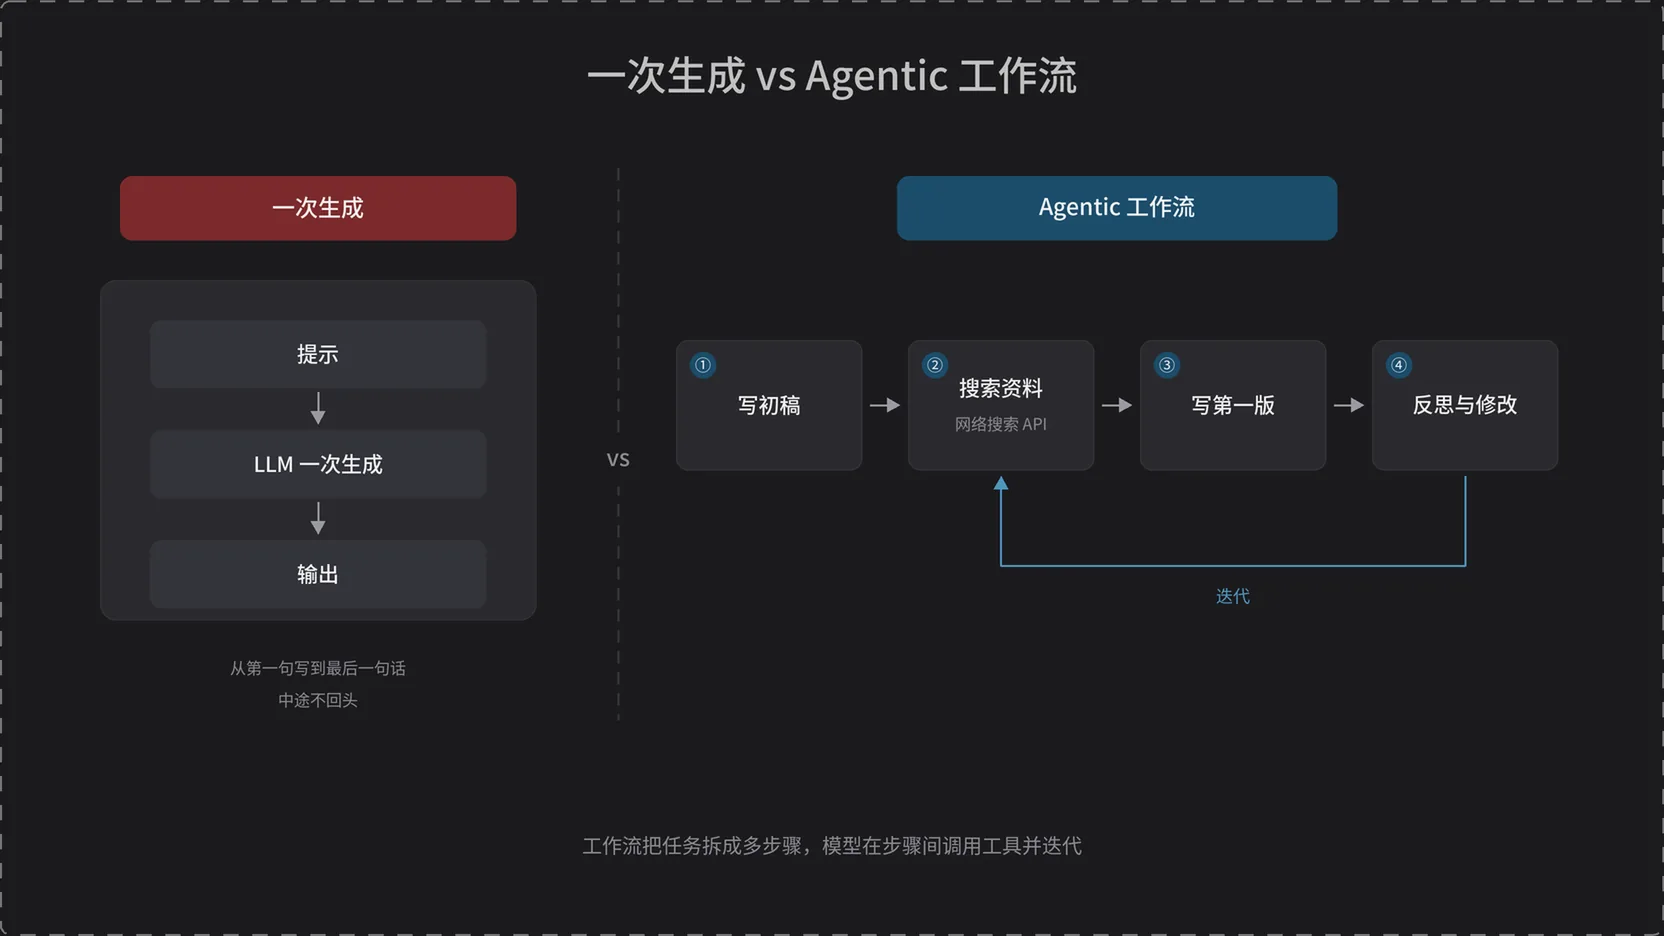
1.1 一次生成的问题(直接调用裸模型思考)
今天大多数人用 LLM(大语言模型,接收提示、逐词生成文本的模型)的方式,相当于要求一个人从第一句写到最后一句,中途不许回头、不许查资料、不许改。人在这种约束下写不出好东西,因为输出顺序必须一次就对。
模型也一样。单次提示能拿到一份看着完整的答案,深入一点就会发现它只覆盖表层。课程里提到,团队做的很多项目都无法靠单次提示通过业务验收。
1.2 工作流:思考、研究、修改的循环
换成人的严谨做法:写初稿,查资料,据此写第一版,回头检查哪里站不住脚、还缺什么,改一遍,再想,再改。这个循环可以持续很久,质量随迭代上升。
Agentic workflow(智能体工作流)把这套循环搬进程序:一个 LLM 写初稿,另一个决定用什么搜索词去调网络搜索 API,拿回的网页交给下一个 LLM 写第一版,再由一个专职挑刺的 LLM 反思哪里要改,步骤之间还可以插入人工审查。Agentic AI 指的就是这类由多步骤组成、模型在步骤间调用工具并迭代的应用。
反复强调的技巧只有一条:把复杂任务拆成小步骤。
1.3 示例
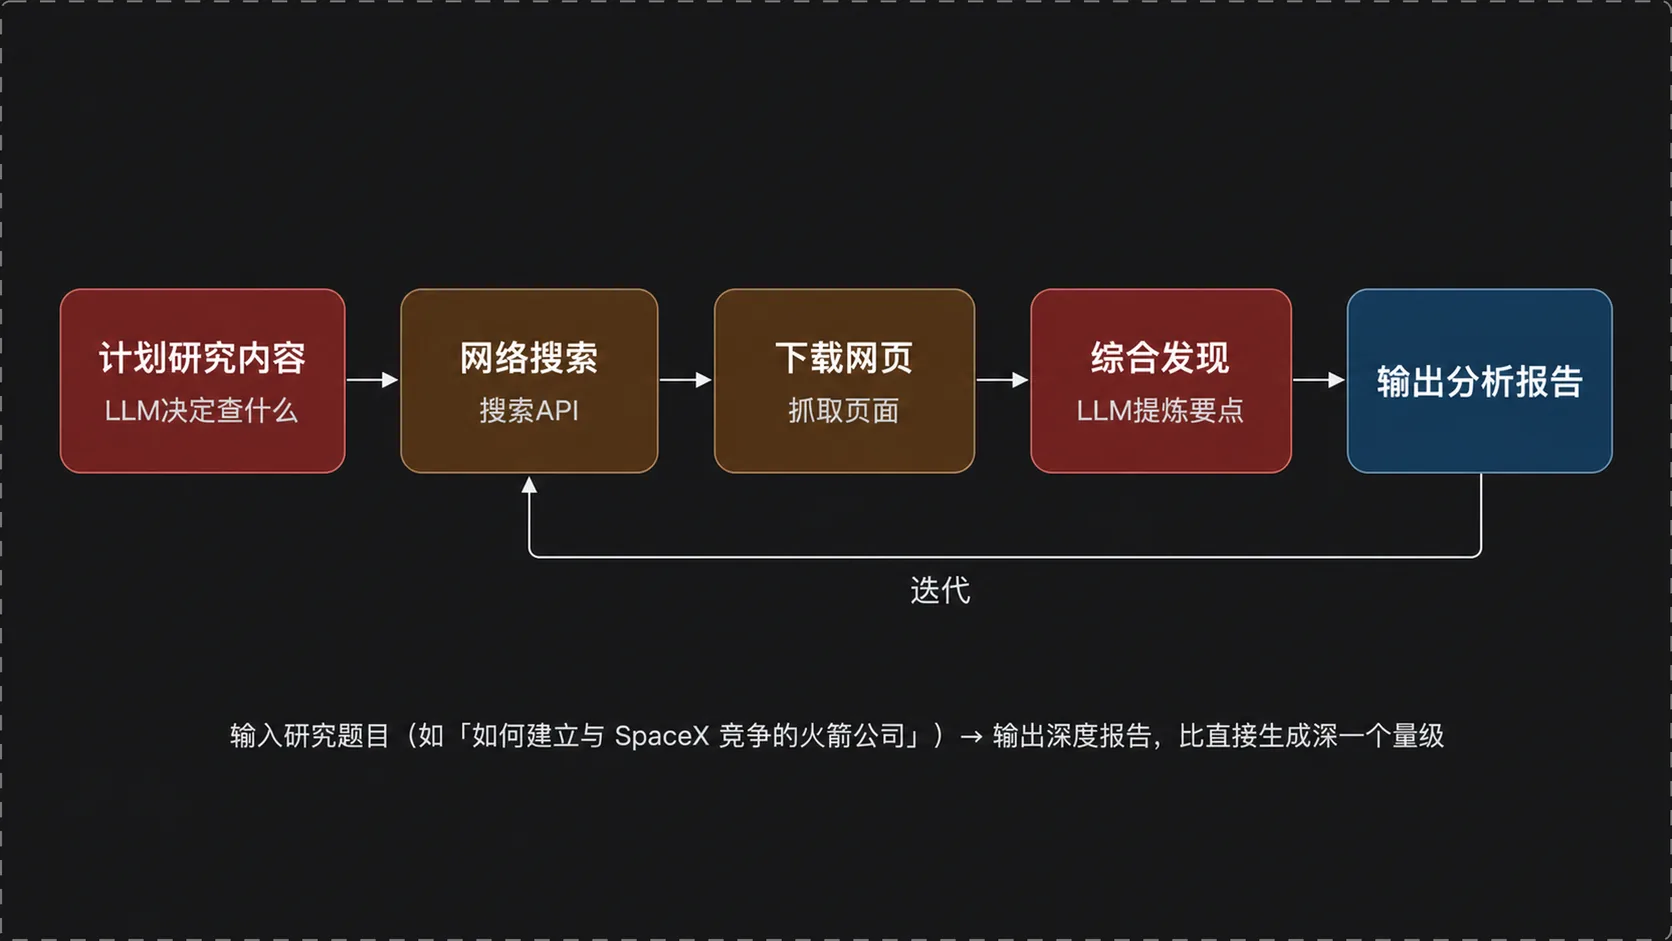
示例:「如何建立一家与 SpaceX 竞争的火箭公司」,它先规划研究方向,用搜索引擎下载网页,综合发现,判断下一步查什么,最后产出一份带背景的分析报告。同一个题目,直接生成和让这套流程跑一遍,深度不在一个量级。
二、模型的自主性
2.1 为什么用 agentic 这个词
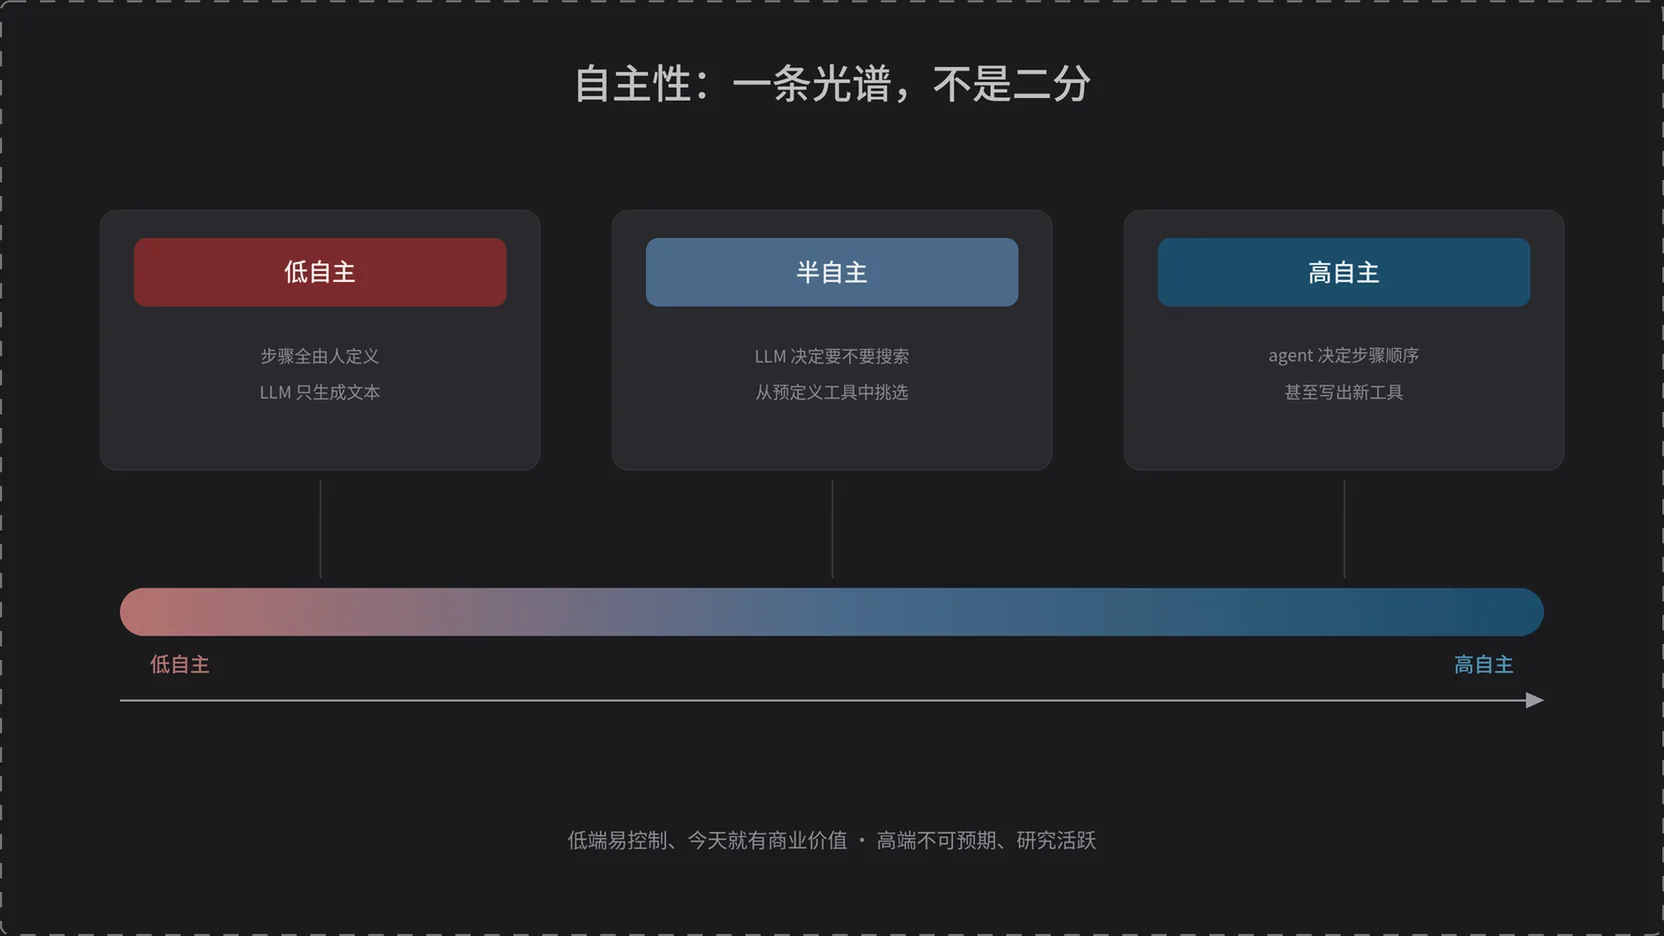
几年前 AI 社区花了大量精力争论「什么才算真正的 agent」,有人说自己建了一个,马上有人反驳那不算。吴恩达认为这种争论没有产出,改用 agentic 这个形容词——承认系统有不同程度的自主性,把精力放回构建上。自主性光谱指的就是从「步骤全由人写死」到「模型自己决定一切」的连续区间。
2.2 低自主:步骤全由人定义
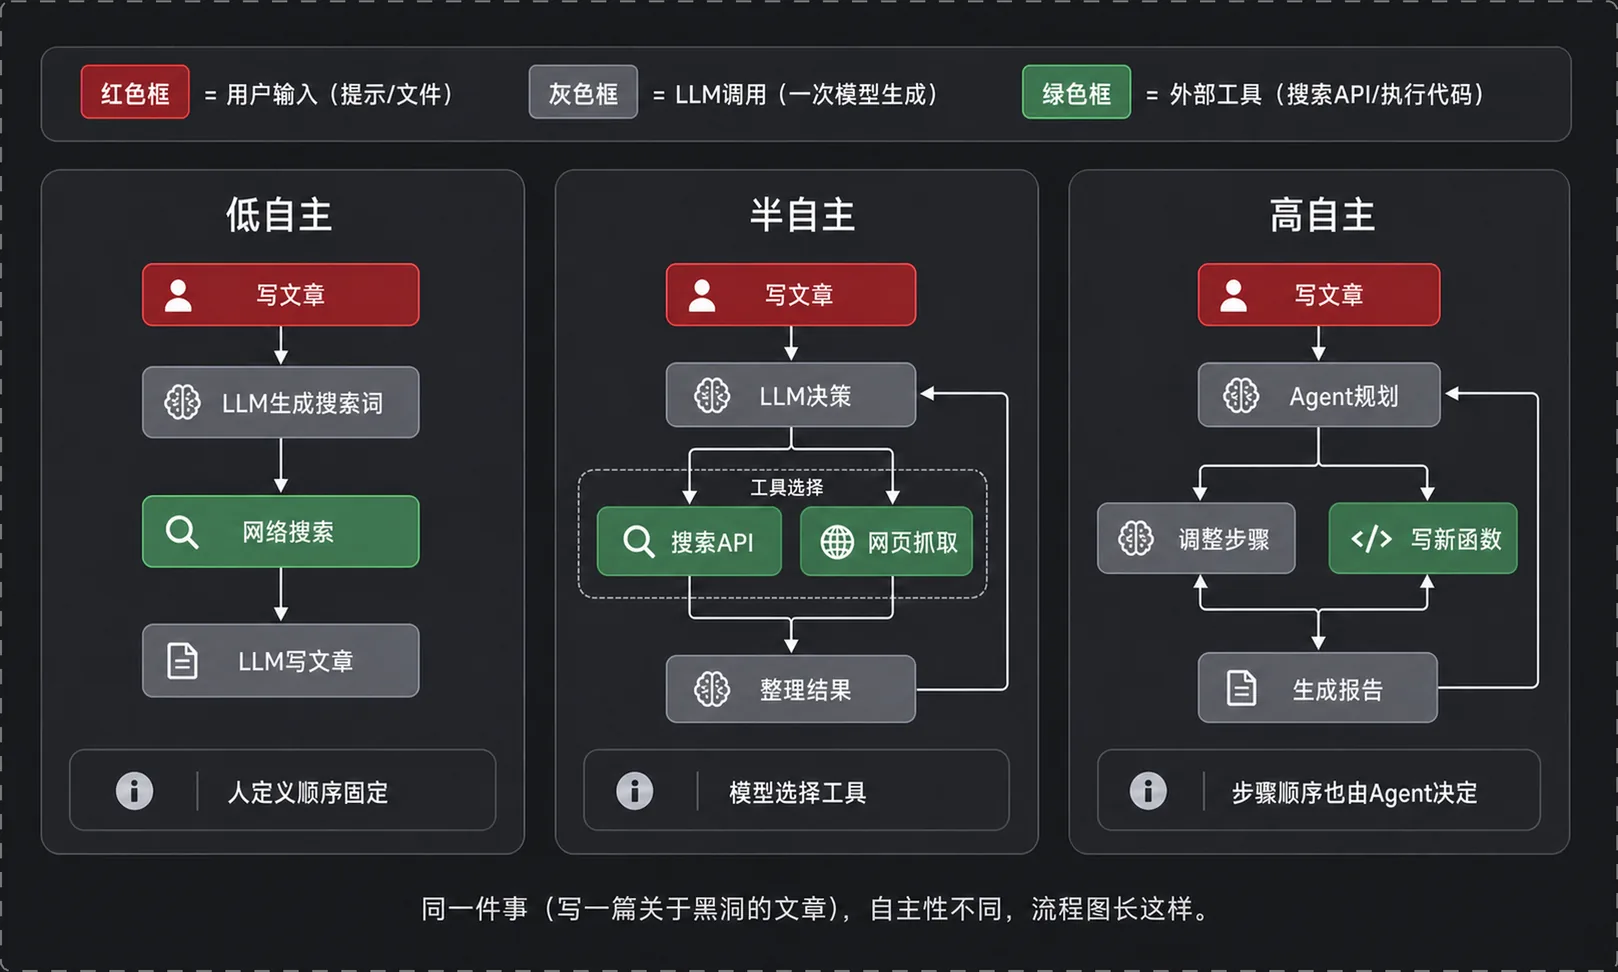
同样是「写一篇关于黑洞的文章」,最低自主的实现是一条固定流水线:接到题目 → 生成搜索查询 → 抓网页 → 用网页内容写文章。步骤顺序由工程师定死,LLM 只在指定环节生成文本。
2.3 半自主:把选择权交给模型
再往上一档,决定权转移给 LLM:要不要搜索、抓几个网页、用哪个工具转换数据、怎么引用证据,甚至写到一半发现资料不够再搜一轮。工具集仍由人预先定义,模型拿到的是挑选和组合的权力。
2.4 高自主:连步骤顺序都由 agent 定
最高一档,agent 自己决定执行哪些步骤、按什么顺序,必要时还能写出新函数当工具用。人给的不再是流程,而是目标和边界。
2.5 两端的取舍
低自主端今天就有商业价值,行为可预测、出问题好定位;
高自主端不可预期,研究活跃,难题是怎么让这种软件足够可靠。
三、为什么要用 Agentic
3.1 数据支撑
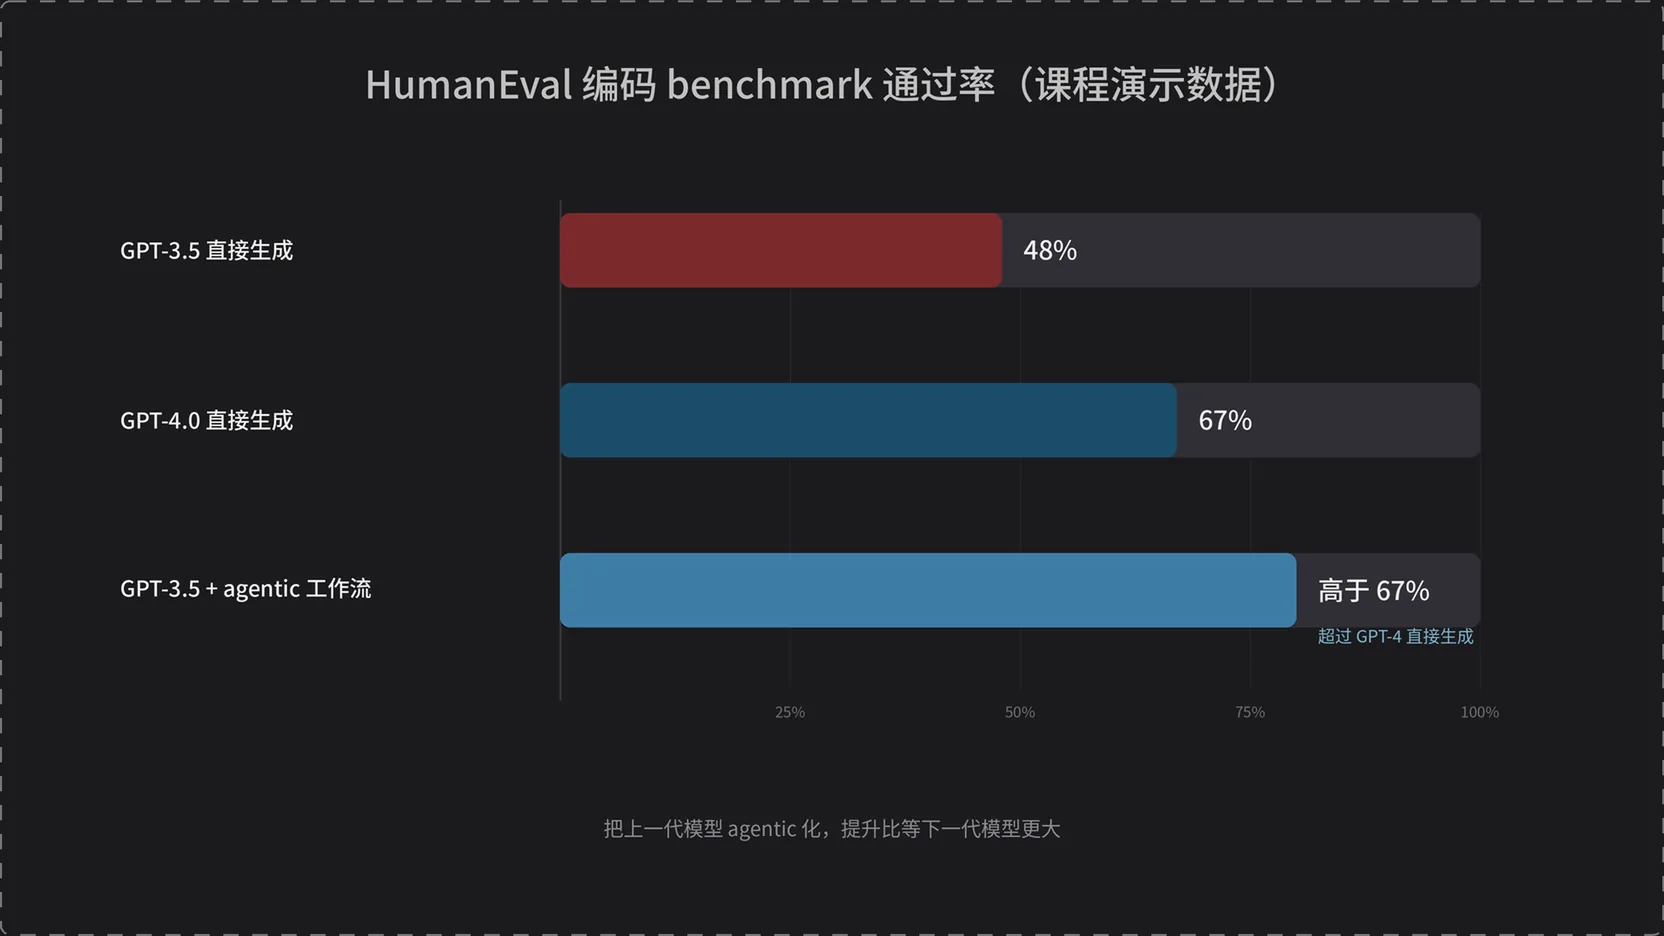
在 HumanEval 这个编码 benchmark(用来横向比较模型能力的标准测试集)上,GPT-3.5 直接生成的通过率是 48%,GPT-4.0 提升到 67%。换代带来的提升可观。
但把 GPT-3.5 包进 agentic workflow——写草稿、反思、改进——表现能超过直接使用 GPT-4.0;GPT-4.0 放进同样流程还会再往上走。
结论:最好的模型放进 agentic 流程仍能更好;把上一代模型 agentic 化的提升,比等下一代模型还要大。
3.2 做以前做不到的事,以及提升效率
最大的好处是可行性:一些任务靠单次生成根本完不成。其次是连续性和并行度,多个步骤能很快串起来,部分还能并行。还是黑洞那篇文章,agent 能做多轮搜索——第一轮取一个搜索词的前 3 条,第二轮换词再取 3 条,累积后串起来写。流程总耗时比一次生成长,但比人读完这批资料快得多。
3.3 模块化
流程一旦拆开,每个环节都可以换:搜索引擎在 Google SERP、Bing、DuckDuckGo、Tavily 之间切换,不同步骤用不同厂商和规格的模型,谁效果好就用谁。模型更新时因此不必重写系统,换掉某个环节再跑一遍评估即可。
四、应用场景示例
4.1 发票处理
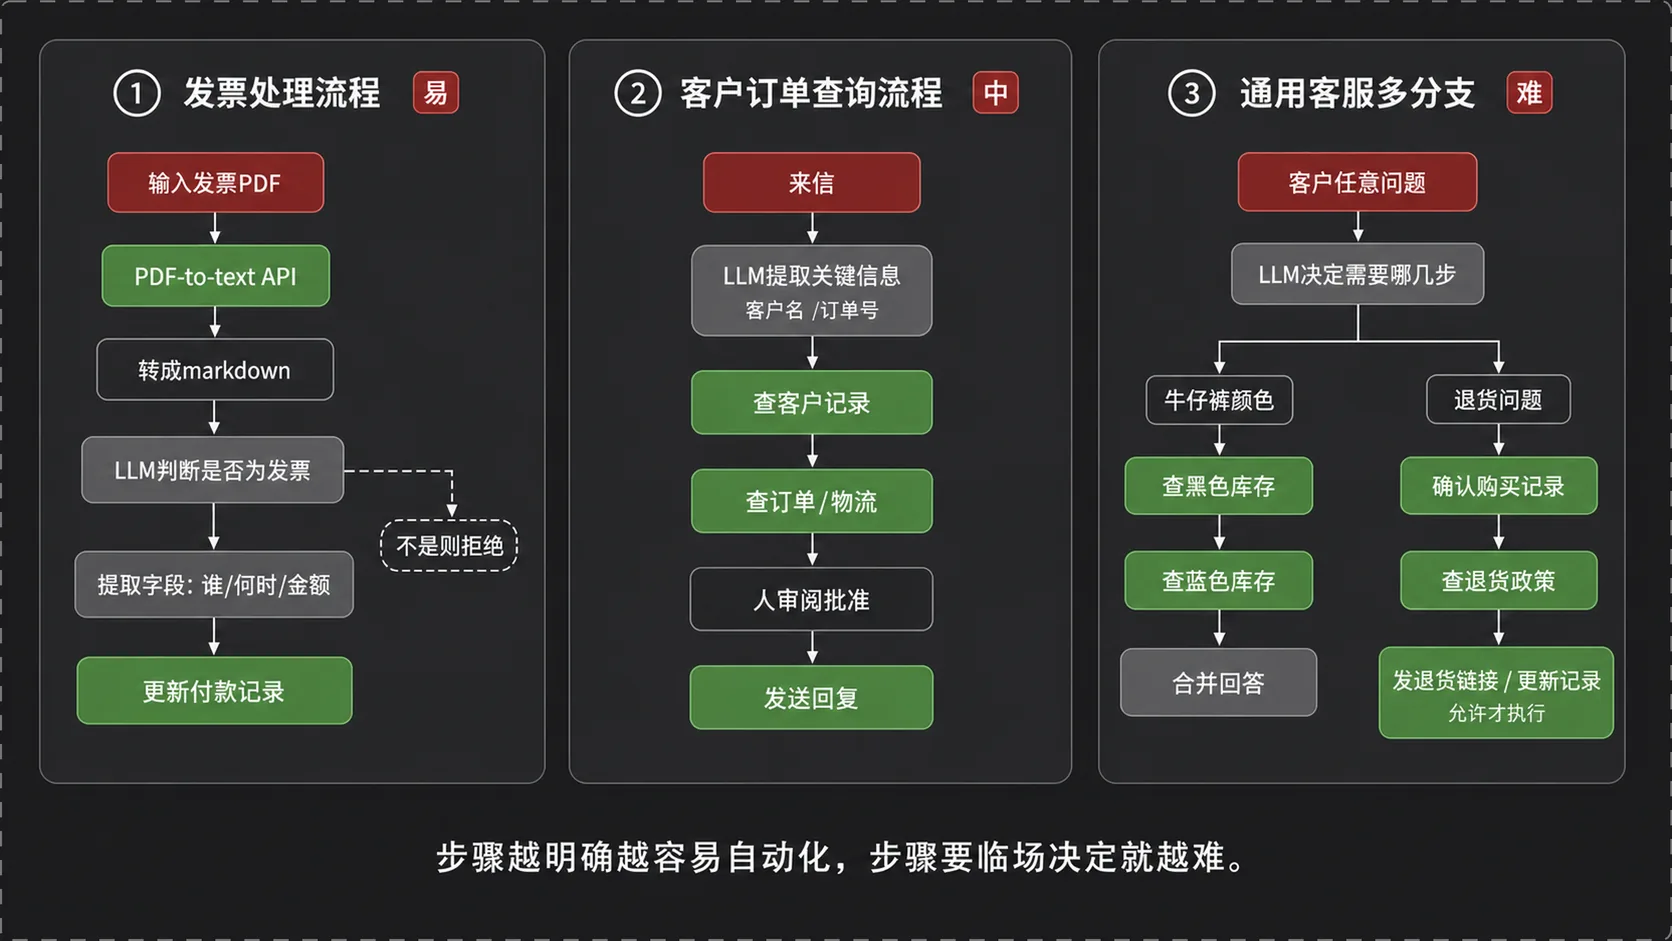
财务岗位上有人每天看发票、找出谁该在什么时候付多少钱,再录进付款计划。改成 agent:输入 PDF → 调转文本 API 得到 markdown → LLM 判断是不是发票(不是就拒绝)→ 提取字段 → 用 API 更新记录。步骤清楚、边界明确,最容易做成可持续运行的一类。
4.2 客户订单查询
流程同样规整:从来信提取关键信息(客户名、订单号)→ 查客户记录 → 查订单和物流 → 交人审阅 → 发送回复。今天已有大量公司在上线这类 agent。
4.3 通用客户服务
难度陡增的是不限定问题范围的客服。问「现在库存有黑色牛仔裤还是有蓝色的?」,要分别调库存 API 查两次再回答;问「我买的海绵能退吗」,要确认此人确实买过、查退货政策(30 天内可退、某些品类除外),可退才生成链接并更新记录。需要哪几步在收到消息前无法预知,只能由 LLM 临场决定——这类系统更难,也更不可预期。
4.4 浏览器使用
最难的一档是让 agent 直接操作浏览器。示例任务是查「新加坡到华盛顿 DCA 的直飞航班」:agent 自己决定用搜索、自己选搜索词、逐个打开结果筛选航班,再去航司网站确认可订。
4.5 选项目的经验
优先挑步骤明确、公司里已有成熟人工流程的任务,这类最容易复制出成功案例;步骤不清晰的(比如通用客服)更难;输入是语音、视频、图像的多模态任务又高一档。不管挑哪个,第一步动作一样:盯住任务,把它隐含的步骤想清楚。
五、任务分解:把任务拆成可执行的步骤
5.1 一个判断标准
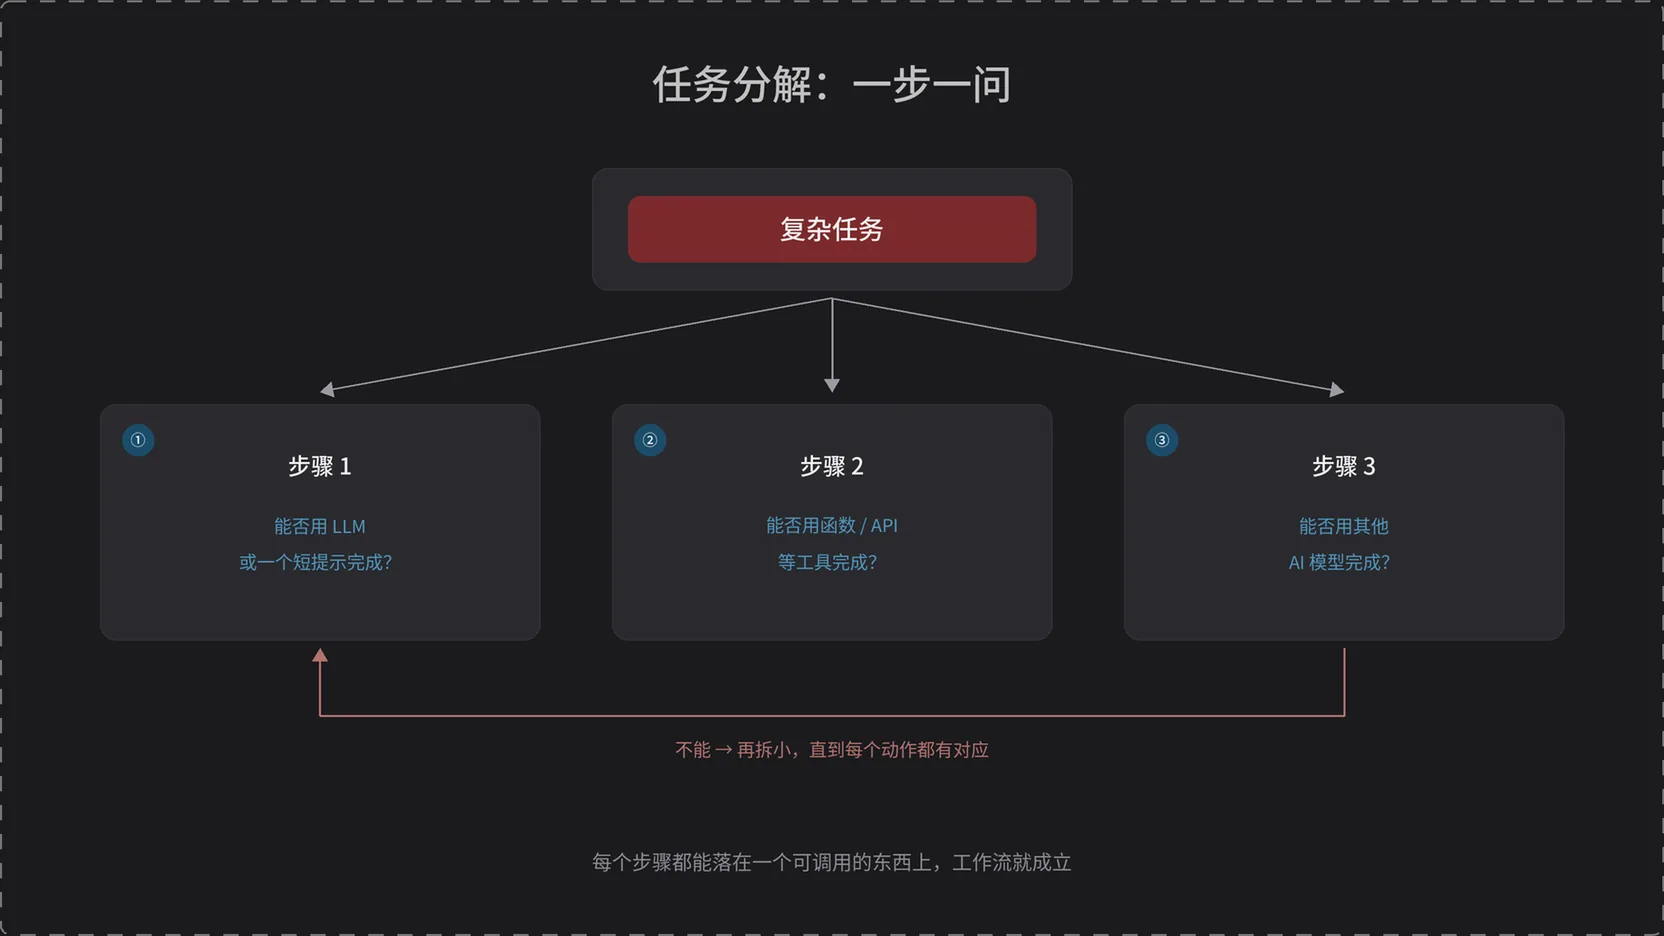
拆分时反复问的只有一个问题:把任务看成步骤 1、2、3,每一步能不能由一个 LLM、一个短提示、一个函数或一个工具完成?某一步答不上来就换个问法——我作为人做这一步时具体在干什么,能不能再拆小?拆到每个动作都对应上一个可调用的东西为止。
5.2 迭代式拆分
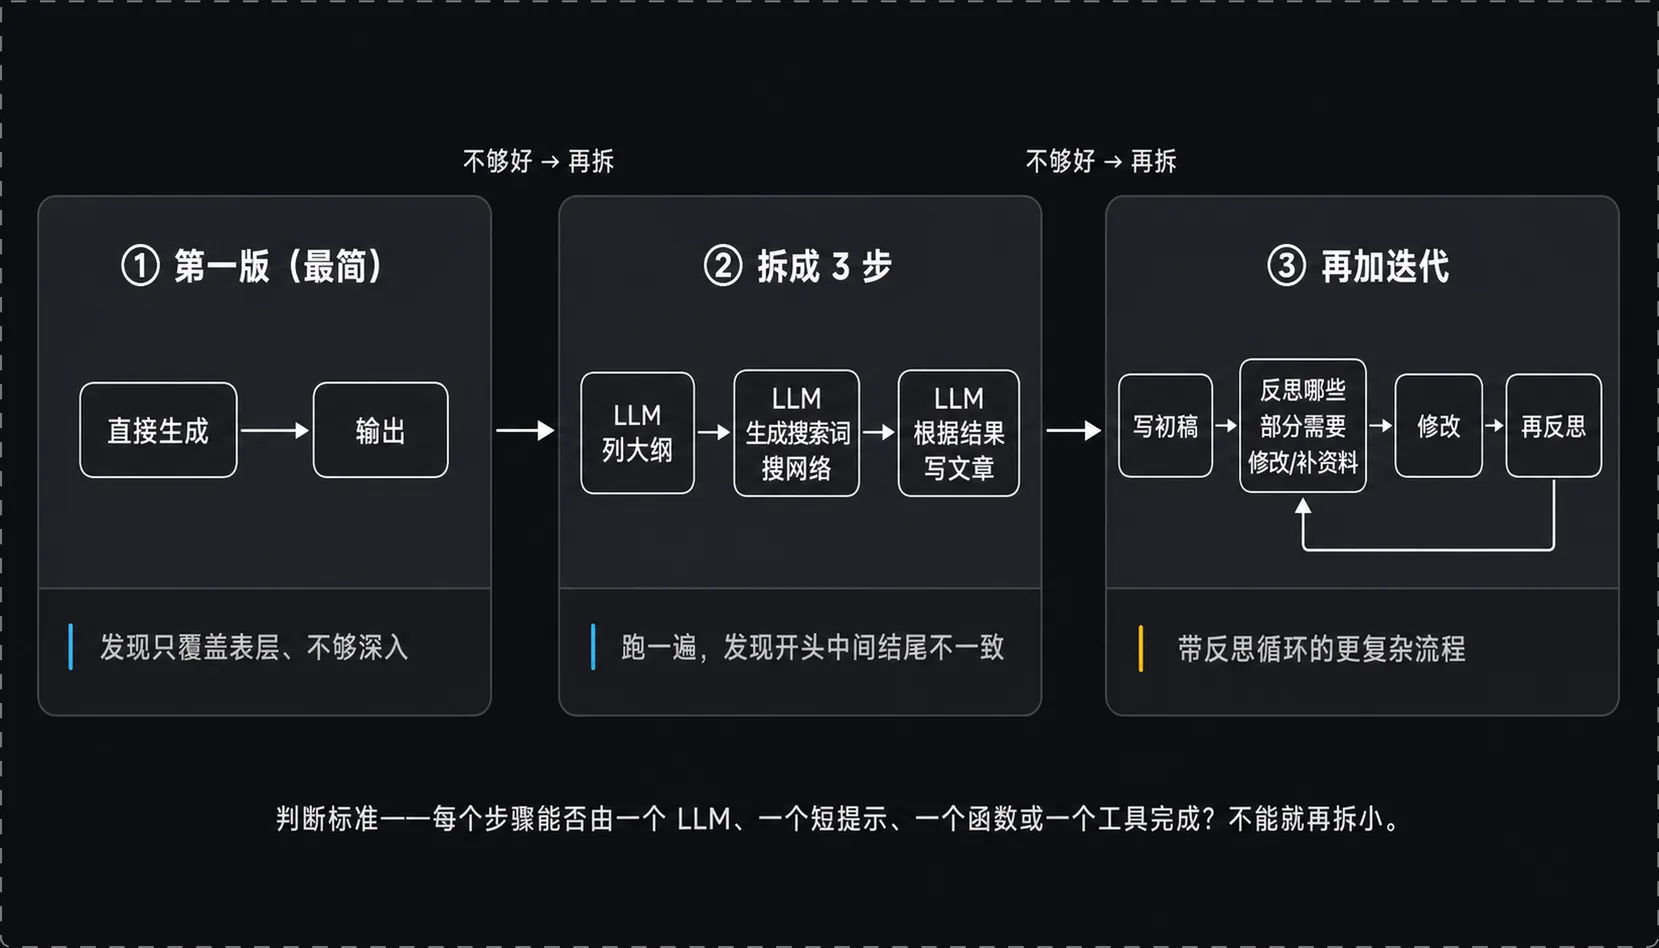
以写文章为例。第一版拆成三步:
- LLM 列大纲
- LLM 生成搜索词去搜网络
- LLM 据结果写文章。
跑一遍,如果开头中间结尾对不上、论据不够,就加步骤:写初稿 → 反思哪里要改或要补资料 → 改 → 再反思。从一步生成到三步流水线再到带反思循环的多步流程,复杂度是随着不满意逐步长出来的,第一版永远只是「初版 agentic workflow」。
5.3 手上的积木
构件分三类:LLM 和多模态大模型,负责写作、推理、信息整理;专项 AI 模型,负责语音转写、图像分析、格式转换;软件和 API,包括网络搜索、发邮件、查日程、数据库读写、RAG(检索增强生成,先从自有文档库检索再交给模型作答),以及让模型写代码并执行。日常工作多半就是观察公司里正在做的事,再想用哪几块积木拼出等价流程。
六、Evals:不预测,先建立再测量
6.1 为什么要 evals
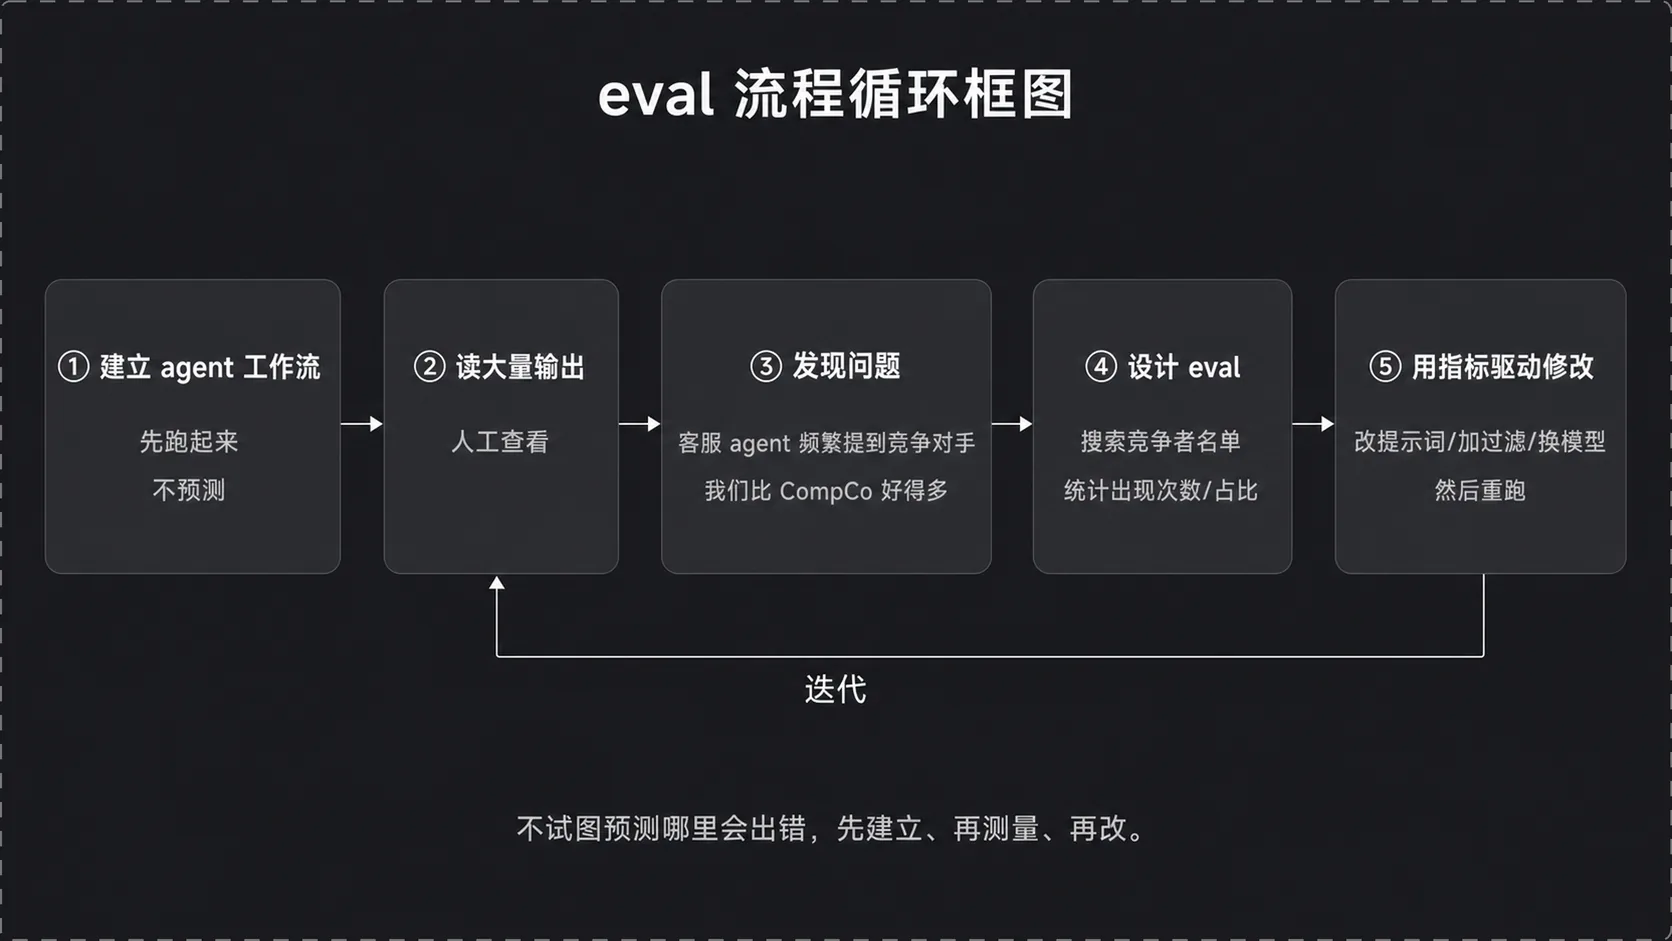
做得好的团队和做不好的团队,区别在于能不能做出丰富的评估。evals(evaluations,对系统输出的自动化评估)不是上线前的最后一道工序,而是迭代的方向盘。与其动手前费劲预测哪里会出错,不如先把流程搭起来读输出,找到不满意的地方再针对它设计测量方法。
6.2 反例
客服回复 agent 上线前读大量输出,会发现一个没人预料到的问题:它频繁提到竞争对手,比如「很高兴您在我们这里购物,我们比 CompCo 好得多」。业务方绝不希望自家 agent 给对手打广告。对应的 eval 很简单:在输出里搜索竞争对手名单,算出多少比例的回复命中了这个坏案例,其最终计算出来的比例就是后续改动的指标。
下面这段把这条抱怨变成可执行的检查,统计的是踩坑回复的占比。
# 示意代码:针对客服 agent 输出的一个关键词类 evalCOMPETITORS = ["CompCo", "RivalCo", "TheOtherCo"] # 业务方给出的竞争对手名单 def mentions_competitor(text: str) -> bool: # 判断单条输出是否提到了竞争对手 lowered = text.lower() # 统一转小写,避免大小写导致漏判 return any(c.lower() in lowered for c in COMPETITORS) # 任意一个名字出现即算命中 def eval_competitor_rate(outputs: list) -> float: # outputs 是一批 agent 的真实回复 if not outputs: # 空输入直接返回 0,防止除零 return 0.0 # 没有样本就没有指标 bad = sum(1 for o in outputs if mentions_competitor(o)) # 统计踩坑的条数 return bad / len(outputs) # 返回占比,这就是可以持续追踪的指标 rate = eval_competitor_rate(collect_agent_replies()) # 每次改完提示或流程都重新跑一遍print(f"提及竞争对手的回复占比:{rate:.1%}") # 用数字对比改动前后的效果这个 eval 很粗糙,但它把说不清的抱怨变成了可对比的数字。改提示词、加过滤、换模型之后,占比是升是降转成了可量化的指标。
七、四大设计模式
7.1 反思 Reflection
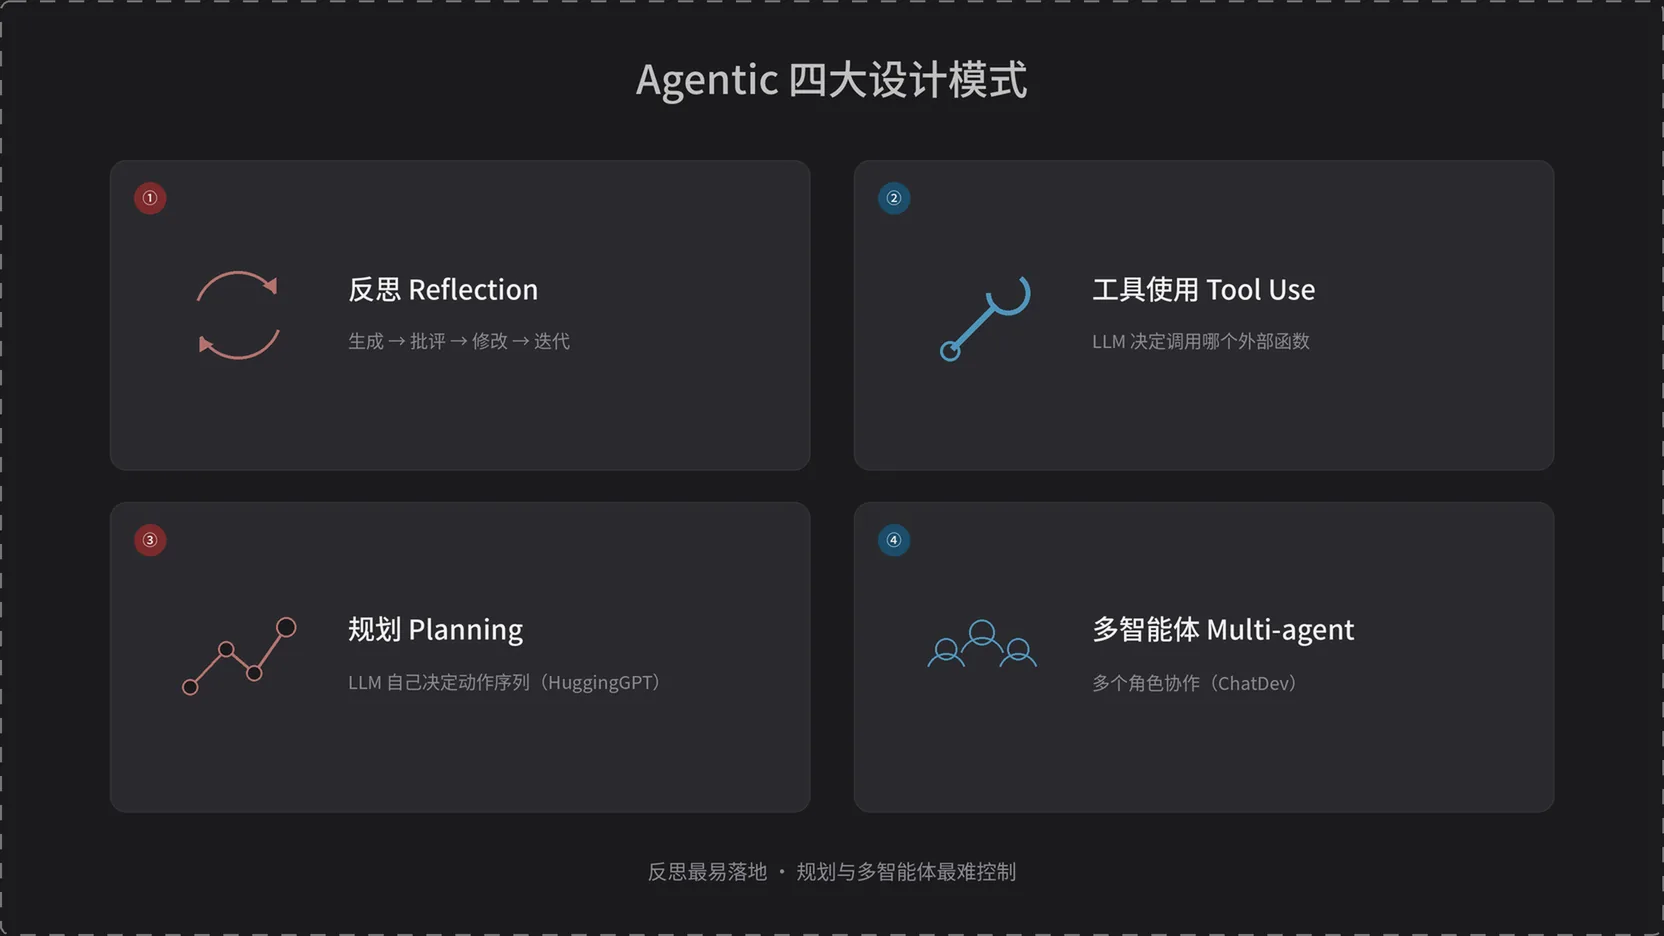
让 LLM 写一段代码或文档,把输出交回给另一个 LLM(或它自己)挑错、提批评,再把批评喂回去让它改,得到 V2、V3。反思的输入不限于模型自己的判断——把代码跑一遍拿到的报错信息,就是最好的反思材料。但也并非每次都灵,不过在不少任务上通常能带来明显的提升;实现上可以一个模型自我批评,也可以拆成生成和批评两个提示轮流工作。
反思Reflection模式是四种模式里最容易落地的,几十行就能把「一次生成」变成「多轮打磨」。下面这段用占位函数代替真实 API,看它是为了确认循环结构有多简单。
# 示意代码:最小的 agentic 工作流——生成、反思、改进的迭代循环def call_llm(prompt: str) -> str: # 占位函数,实际替换成任意 LLM 的 API 调用 ... # 返回模型生成的文本 def run_workflow(topic: str, rounds: int = 3) -> str: # topic 是任务主题,rounds 是迭代轮数 draft = call_llm(f"就以下主题写一篇短文:{topic}") # 第一步:拿到初稿,相当于原来的一次生成 for i in range(rounds): # 进入迭代,每一轮做一次反思加一次修改 critique = call_llm( # 第二步:换一个提示,让模型扮演评审角色 f"逐条指出下面这篇短文的问题," # 批评提示要具体,泛泛的「写得不错」没有价值 f"包括论据缺失、结构断裂、事实存疑:\n{draft}" # 把当前稿件作为输入交给评审 ) # critique 就是这一轮的改进清单 if "没有明显问题" in critique: # 简单的收敛条件,避免无意义的空转 break # 评审认为无需再改就提前结束 draft = call_llm( # 第三步:把原稿和批评一起交回生成角色 f"根据以下修改意见重写短文,保留原有正确内容:\n" # 明确要求增量修改而不是推倒重来 f"意见:{critique}\n原文:{draft}" # 两份输入拼进同一个提示 ) # 得到新一版稿件,进入下一轮 return draft # 返回最后一版结果整段代码没有任何框架,只是同一个模型被赋予不同角色、按固定顺序调用几次。实现成本就这么低,而它带来的差距在第三章已经给出了说明(上一代模型放进 agentic 流程,表现能大幅领先直接使用的新模型)。
7.2 工具使用 Tool Use
Tool use(工具调用)指模型在生成过程中决定调用外部函数。问「哪款咖啡机最好」,给它网络搜索工具,答案从编造变成有据;问「投 100 美元若干年后是多少」,给它计算器或代码执行工具就能算准。现在挂给模型的工具五花八门——数据分析、检索、收发邮件和日历、生成图像,模型的价值有一部分就体现在可以选择正确的工具进行调用。
7.3 规划 Planning
Planning(规划)是让模型自己决定动作序列。课程引用 HuggingGPT 论文的例子:要求系统画一个女孩读书的图,姿势和给定男孩照片一致并配文字描述。系统自动排出顺序——姿态检测模型识别男孩姿态、把姿态用于女孩图像的生成、生成图像、最后写描述。和预先定义步骤相比,规划把「有哪些步骤」也交给了模型,代价是难控制、结果不可预期,偶尔给出惊喜解法,也会给出让人头疼的解法。
7.4 多智能体协作 Multi-agent
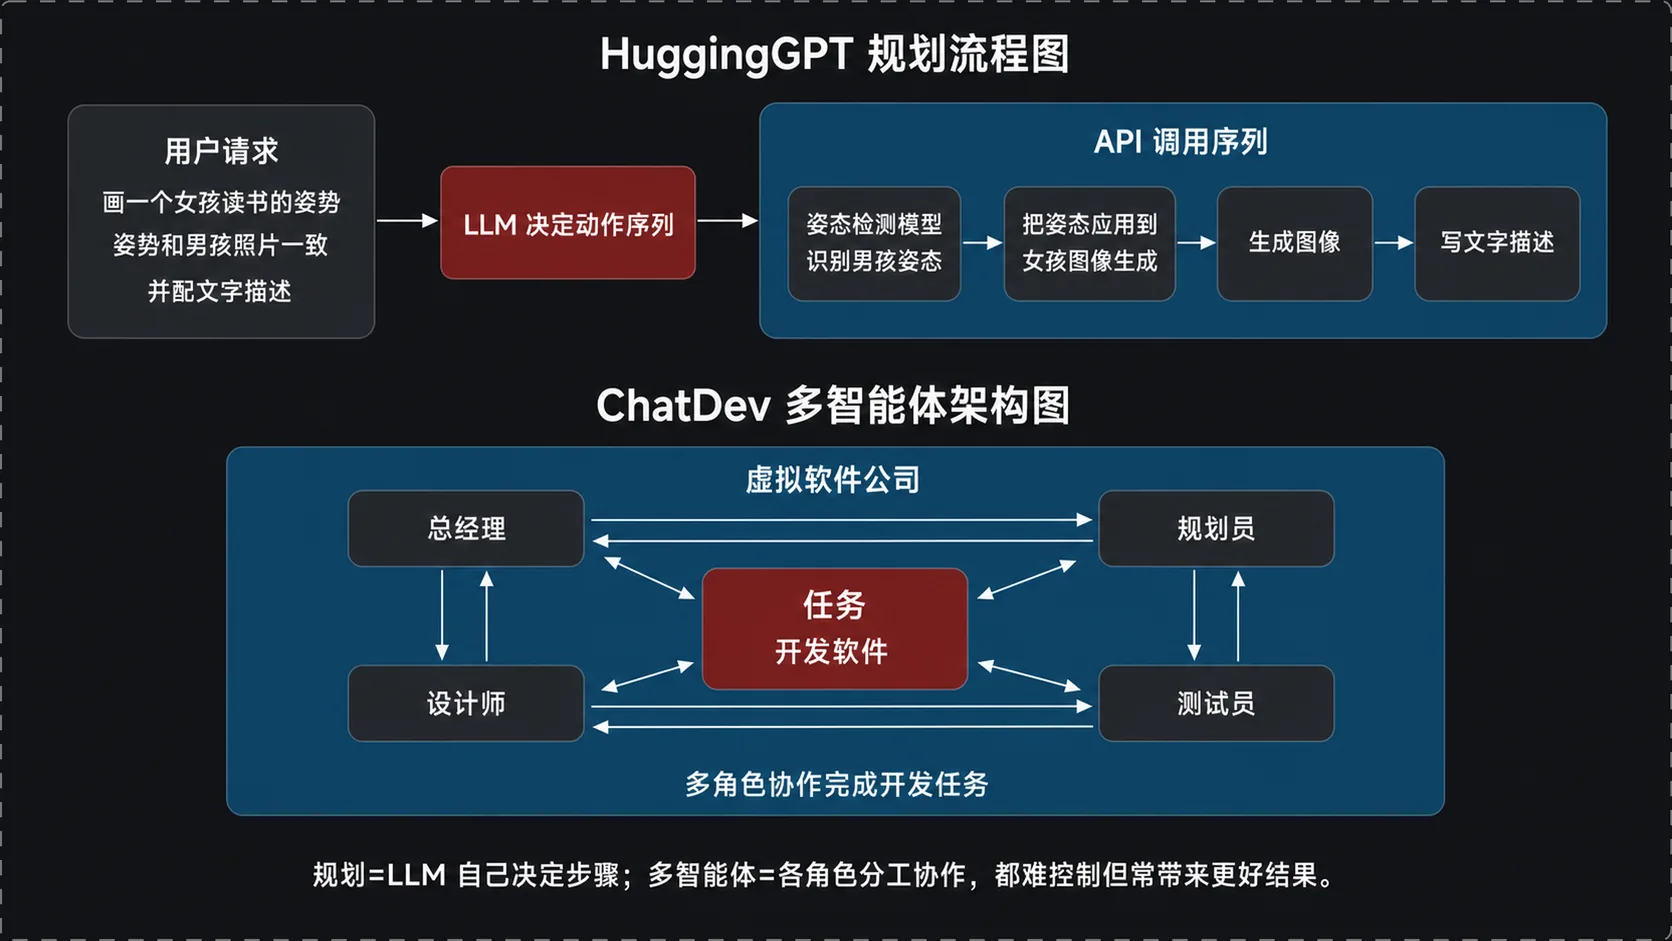
Multi-agent(多智能体)像雇一个团队,各 agent 扮演专门角色协作。ChatDev 是常被引用的例子,它把总经理、规划员、设计师、测试员组织成一家虚拟软件公司完成开发任务;轻量用法是三人小组——一个调研,一个写,一个改。这类系统同样难控制,但研究显示它在写作和复杂决策上能带来更好结果。
八、总结
- 自主性是一条从「步骤写死」到「模型自由发挥」的线性光谱,选位置比争定义重要;
- agentic workflow 把任务拆成步骤并在步骤间调用工具、反复迭代;
- 另外四大设计模式是拆分时可复用流程的成熟模板套路;
- evals 指明改进的方向。
一个Agentic AI的常规设计步骤:识别隐含步骤 → 每一步找到对应的 LLM 或工具 → 运行以及获取输出 → 把不满意的地方变成可测指标 → 优化改进。
本文由 AgentPlanFlow 生成