
文章内容
- 一、反射设计模式:让 Agent 审视自己的输出
- 1.1 从人类反思到 LLM 反思
- 1.2 反射工作流:初稿 → 反思 → 二稿
- 1.3 代码场景:反思检查 bug
- 1.4 外部反馈:反射的下一个台阶
- 二、直接生成 vs 反射:为什么要多一步
- 2.1 直接生成就是 zero-shot prompting
- 2.2 反射普遍优于直接生成
- 2.3 反射能派上用场的场景
- 2.4 反射提示词怎么写
- 三、案例:图表生成工作流
- 3.1 任务与数据
- 3.2 第一次生成:堆叠柱状图
- 3.3 反射:让多模态模型看图
- 3.4 模型分工与反思提示词
- 四、评估反射的影响
- 4.1 为什么要评估
- 4.2 客观评估:数据库查询
- 4.3 用评估驱动提示词迭代
- 4.4 主观评估:LLM 当评委的问题
- 4.5 更稳定的做法:rubric 打分
- 五、外部反馈:反射的放大器
- 5.1 提示工程的收益递减
- 5.2 反射把曲线整体抬升
- 5.3 外部反馈推得更高
- 5.4 落地建议
- 总结
一、反射设计模式:让 Agent 审视自己的输出
1.1 从人类反思到 LLM 反思
人写东西很少一遍到位。草稿写完回头看,会发现日期不明确、用词不准、漏了签名,改完再发。这个「写完 → 审视 → 修改」的过程就是反思(reflection)。
LLM 也能走同样的流程。与其让它一次生成最终答案,不如分两步:先生成初稿,再让它以另一个提示词审视初稿、指出问题、写出改进稿。课程里用邮件举过例子:约朋友吃饭,初稿写的是「下个月某个时间」,反思后变成「5 号到 7 号你有空吗」这种具体表述。
1.2 反射工作流:初稿 → 反思 → 二稿
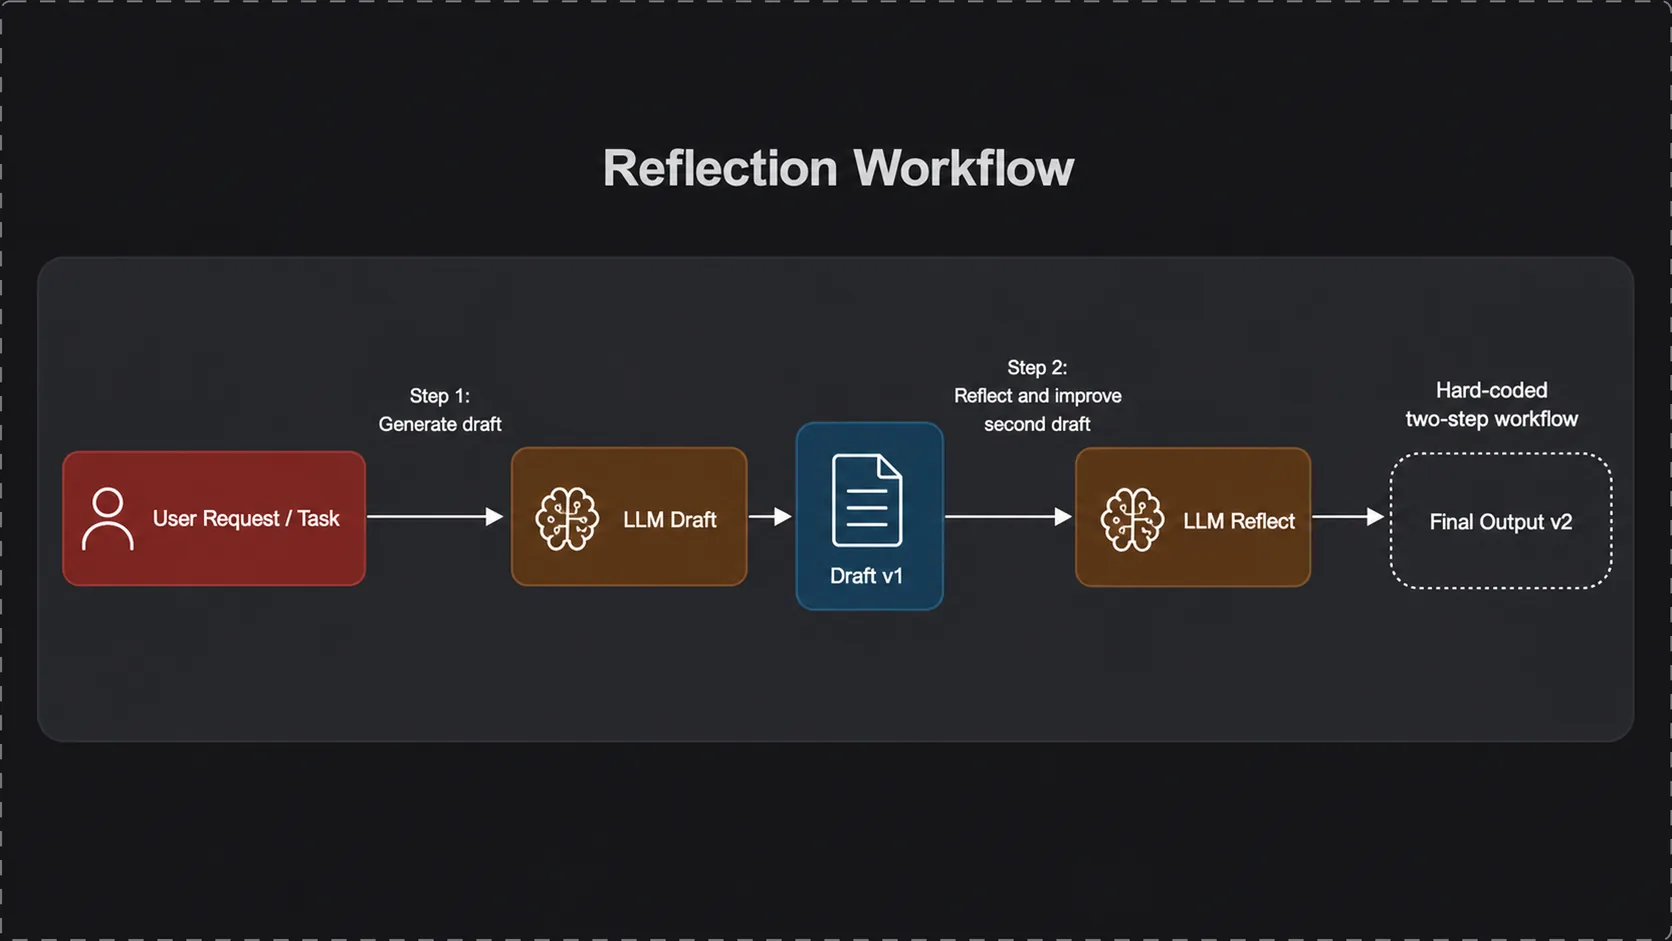
反射工作流可以硬编码成两步,不需要复杂的控制逻辑:
# 第一步:生成初稿draft_v1 = llm.generate(prompt_write_draft, task) # 第二步:让 LLM 反思初稿,输出改进稿draft_v2 = llm.generate(prompt_reflect_and_improve, draft_v1)第一次调用产出 v1,第二次调用把 v1 连同反思指令一起喂回去,产出 v2。两次调用可以用同一个模型,也可以用不同模型。
1.3 代码场景:反思检查 bug
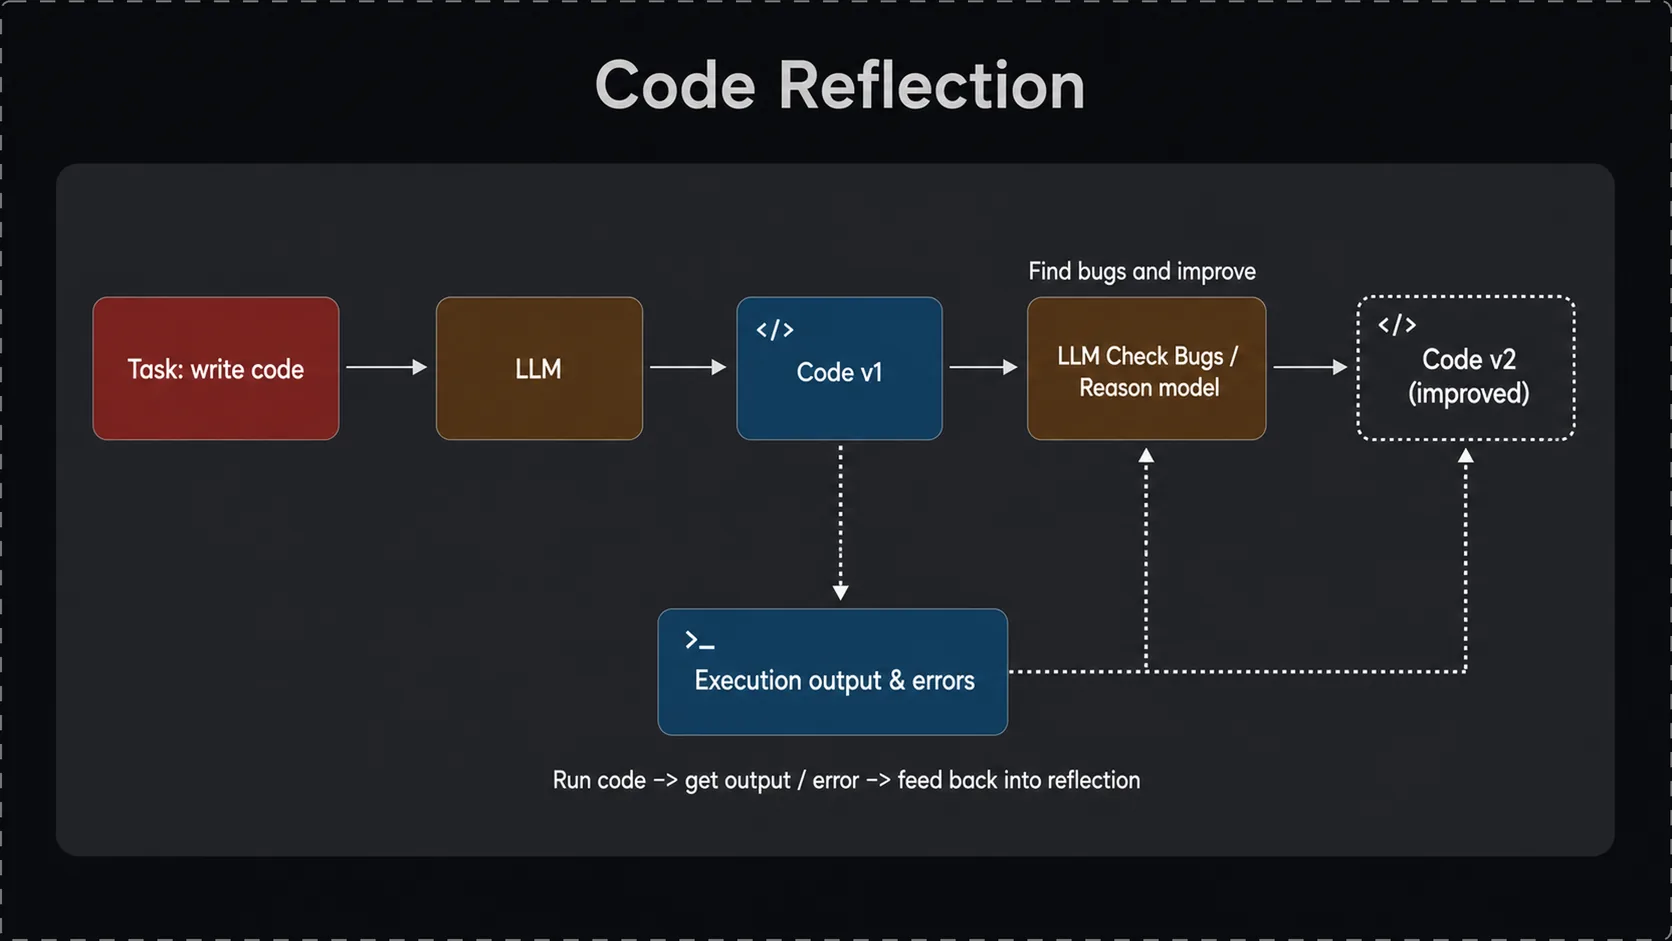
同样的模式适用于代码。让 LLM 写一段完成任务的代码得到 v1,再让它检查 bug、写改进版得到 v2。不同 LLM 各有长处:推理模型(reasoning model,也叫思考模型)擅长找 bug,所以常见的组合是普通模型写初稿、推理模型做反思。
1.4 外部反馈:反射的下一个台阶
只让 LLM 对着自己生成的内容反思,提升有限。如果能把模型之外的新信息喂进反思过程,反射会强得多。代码场景里最直接的做法是执行代码,把运行输出和报错信息一并交给反思步骤。
二、直接生成 vs 反射:为什么要多一步
2.1 直接生成就是 zero-shot prompting
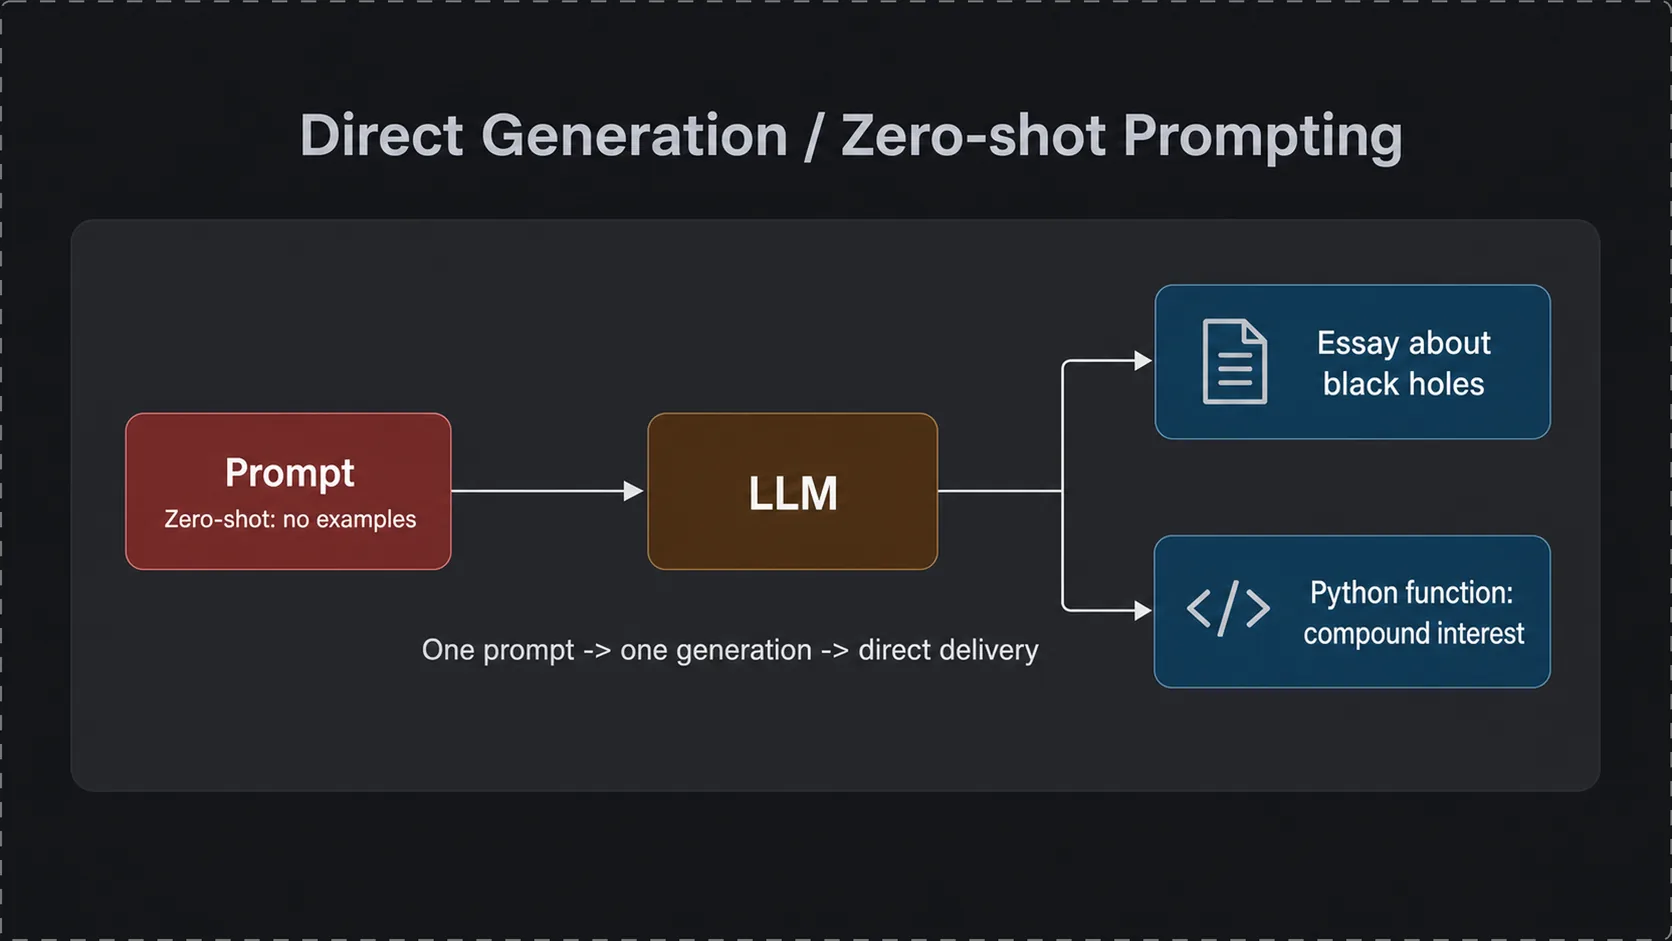
一次提示、一次生成、直接交付,这种用法叫 zero-shot prompting(零样本提示),因为提示里一个示例都没带。往提示里塞一个输入输出对示例,就是 one-shot(一样本),塞多个就是 few-shot(少样本)。
2.2 反射普遍优于直接生成
多项研究对比过反射与直接生成的性能。Madan 等人的论文图表显示,在多种任务、多种模型上,反射(深色柱)大多明显高于同一模型的直接生成(浅色柱),涉及 GPT-3.5、GPT-4 等模型。
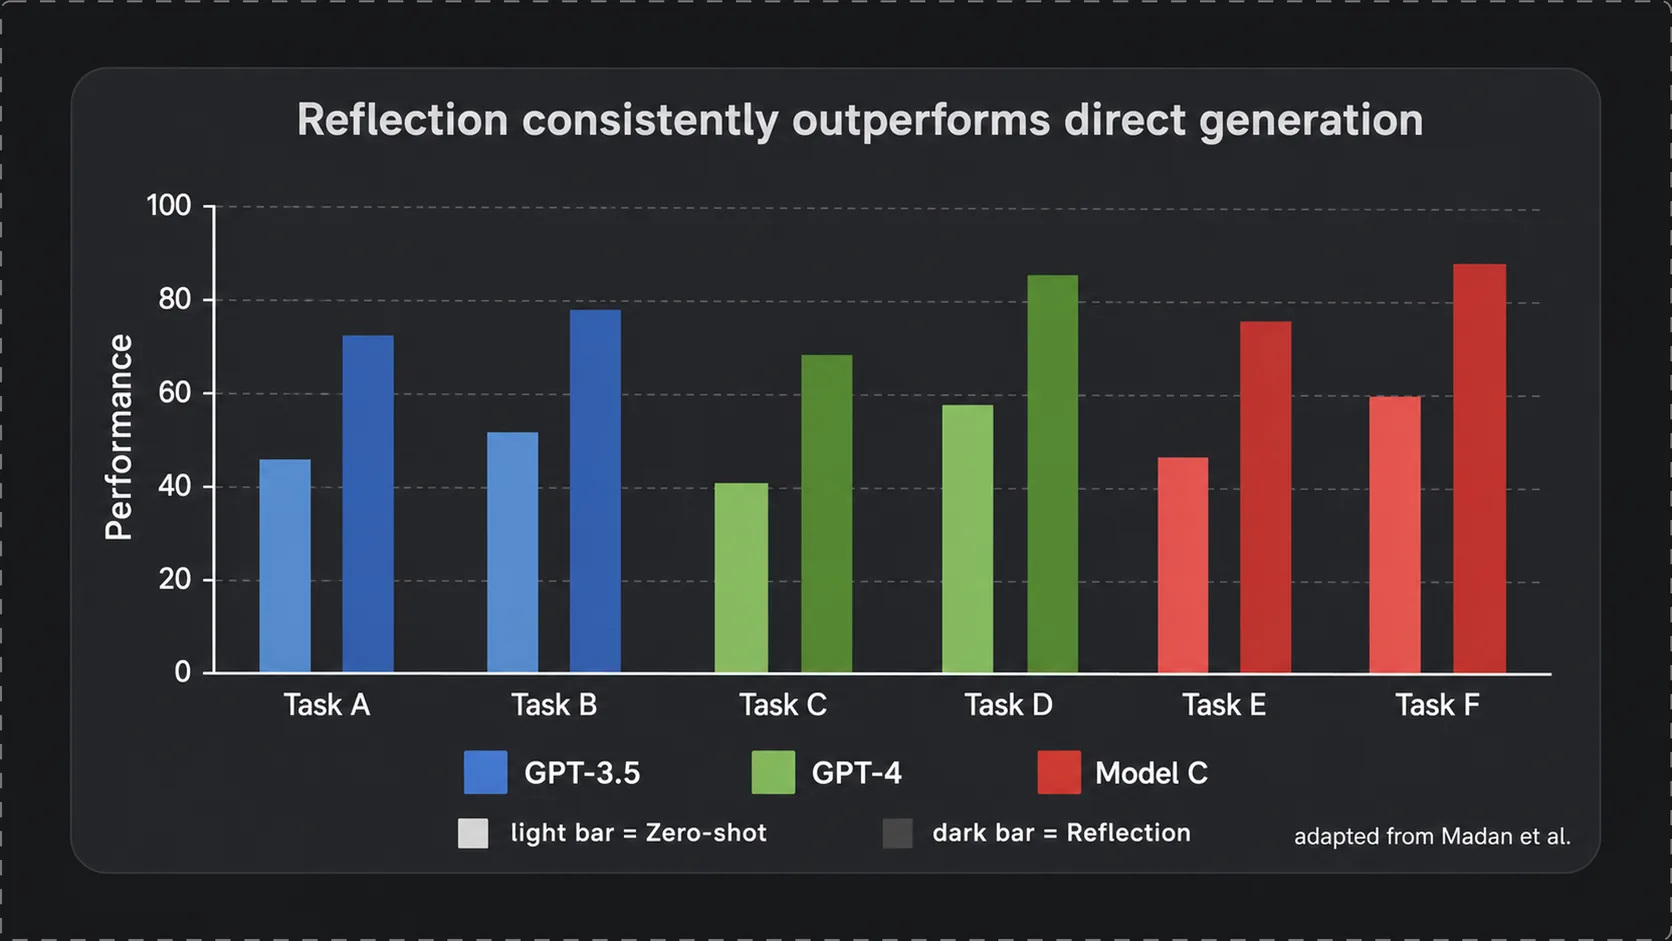
提升幅度因任务而异,自己的应用有没有收益要实测。
2.3 反射能派上用场的场景
结构化输出容易出格式错误。HTML 表格可能标签不闭合,深层嵌套的 JSON 容易漏逗号或多括号,让模型反思检查一遍格式,比直接生成更稳。
步骤序列容易漏步。让 LLM 生成「泡一杯完美红茶」的操作步骤,可能漏掉温杯或计时,反思提示让它检查步骤的连贯性和完整性,根据反馈的结果补上遗漏的步骤。
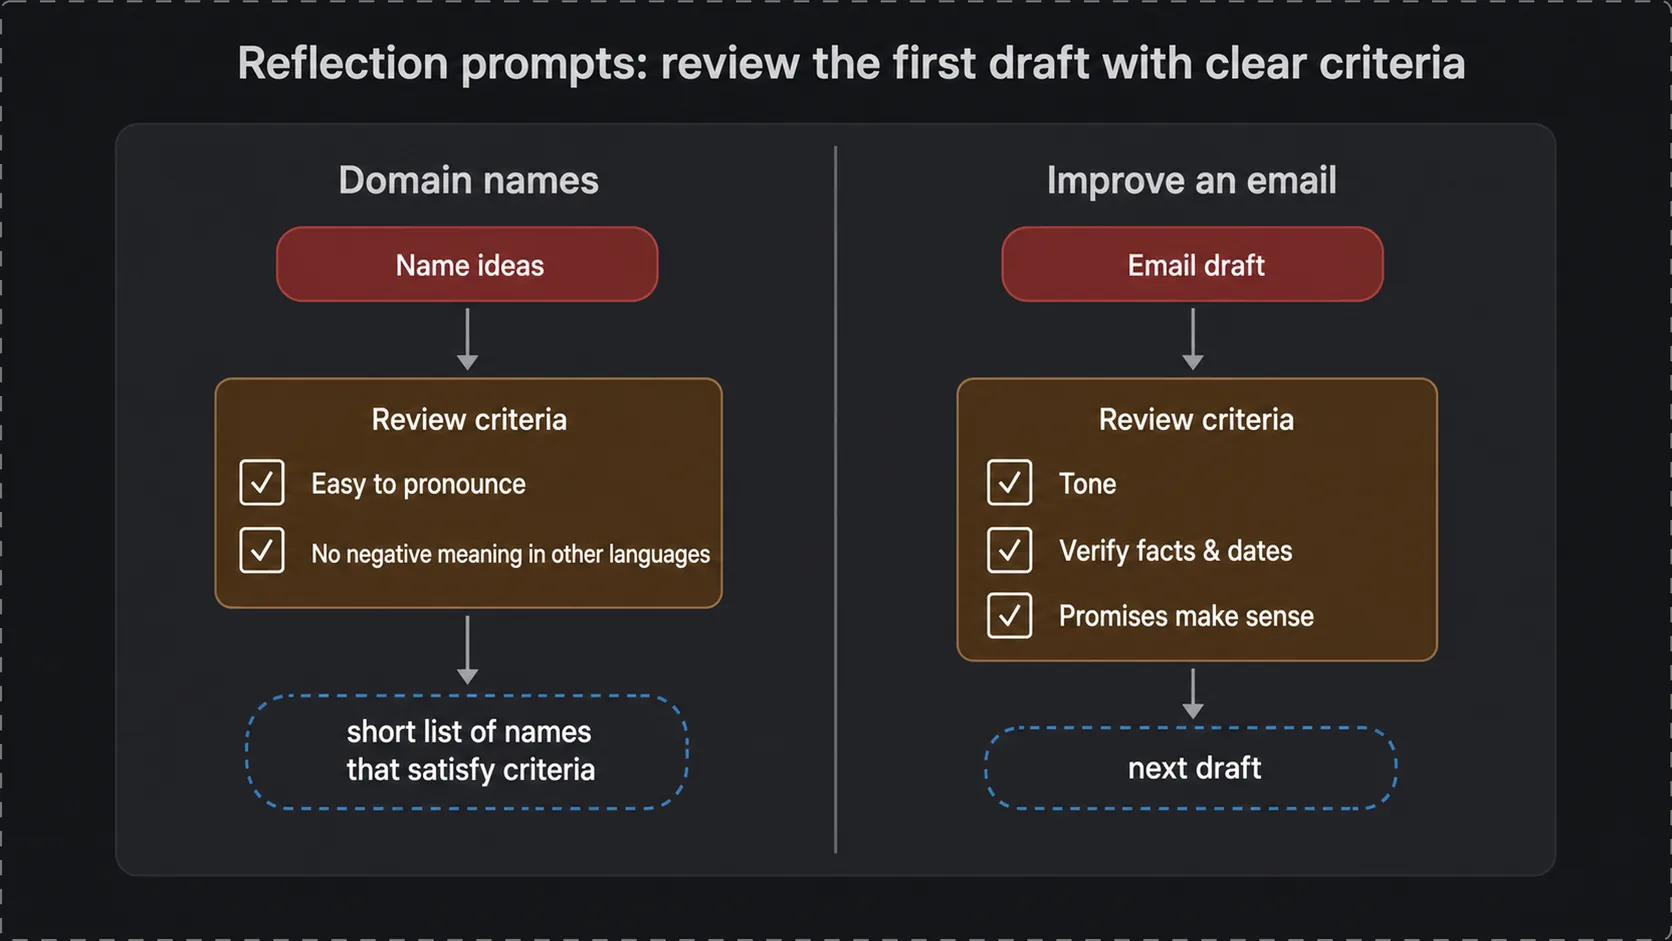
起名字这种需要多重判断的任务也适合。吴恩达在 AI Fund 团队就用反射给创业公司起域名:初稿生成一批域名,反思步骤检查每个名字是否难发音、在其他语言里有没有负面含义,只保留通过检查的。
改进邮件同理:检查语气、核对事实日期和承诺,再写下一稿。
2.4 反射提示词怎么写
写反射提示词有两条原则。
一是明确告诉模型这一步是「回顾并反思初稿」,而不是重新写一份。二是给出可检查的标准。域名场景的标准是「易发音、无负面含义」,邮件场景的标准是「语气合适、事实日期准确」。标准越具体,反思越有据可依。先让模型按标准逐条挑问题,再让它基于问题写下一稿。
三、案例:图表生成工作流
3.1 任务与数据
模块的编码实验是图表生成:有一份咖啡机销售数据,记录拿铁、热巧克力、卡布奇诺等饮品什么时候卖、卖了多少钱,存在 CSV 表格里。任务是用 Agent 生成一张 2024 与 2025 年一季度咖啡销量对比图。
3.2 第一次生成:堆叠柱状图
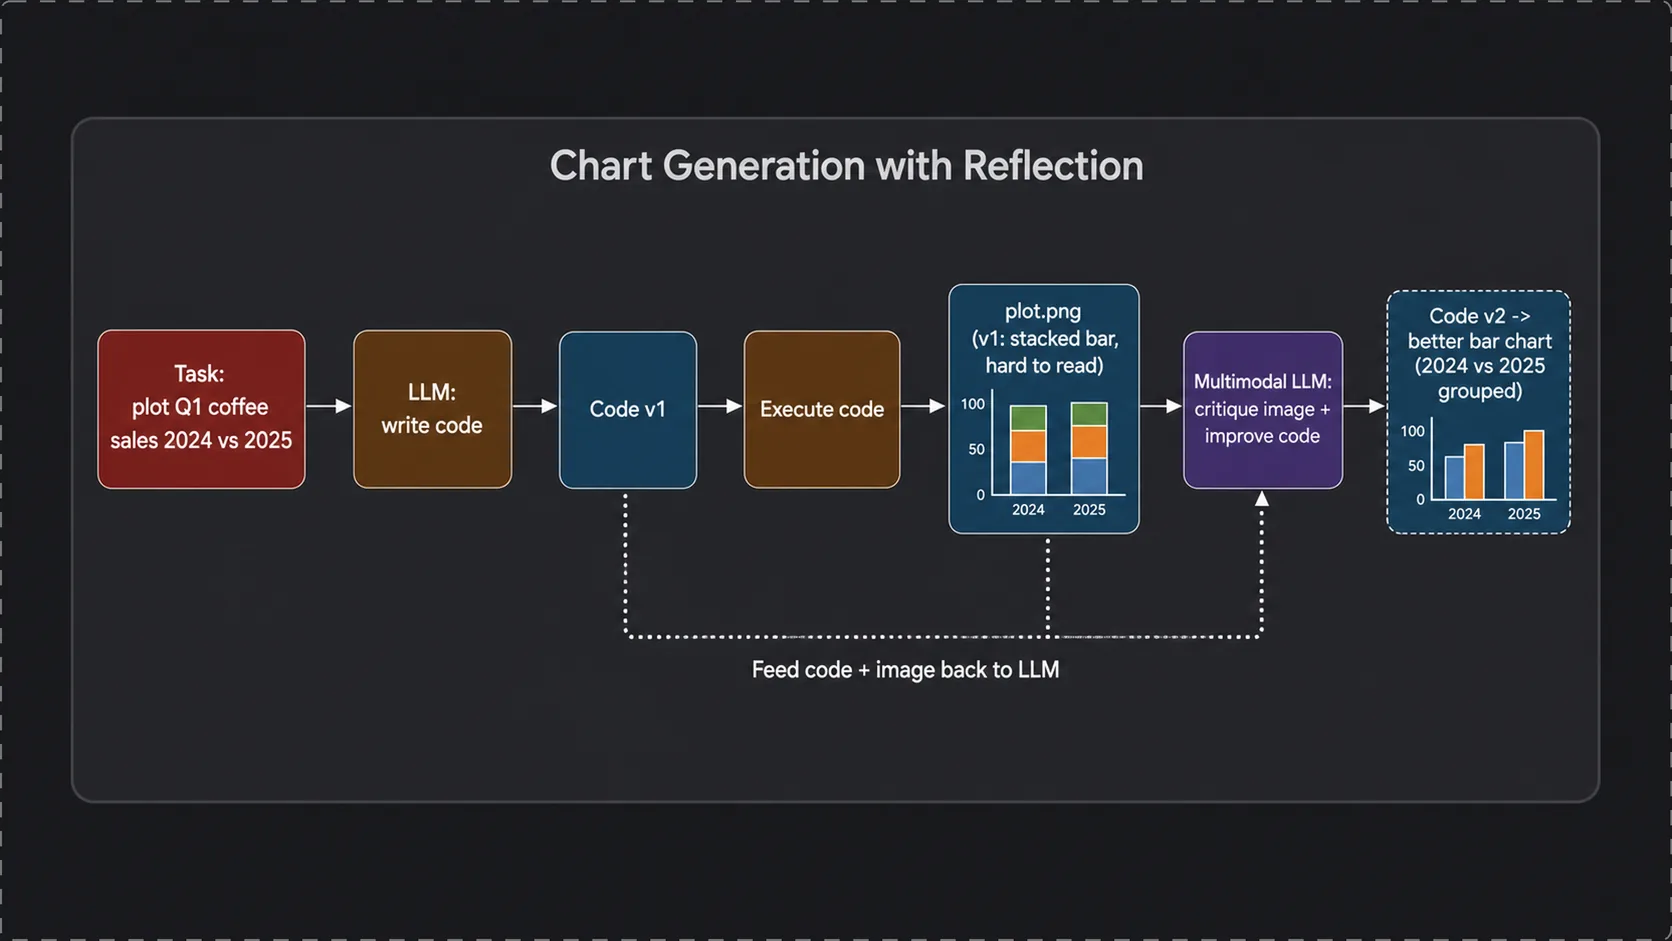
直接让 LLM 为这个任务写 Python 绘图代码,执行后得到一张堆叠柱状图。图能看,但堆叠形式不适合对比,整体观感也一般。
3.3 反射:让多模态模型看图
改进办法是把 v1 代码和它生成的图一起交给多模态模型(能读图的 LLM),让它审视这张图、批评可视化方案、更新代码。多模态模型能做视觉推理,能真正「看」图找问题。课程里这样操作后,v2 代码生成的是普通分组柱状图,2024 和 2025 的数据分开并排,直观得多。
3.4 模型分工与反思提示词
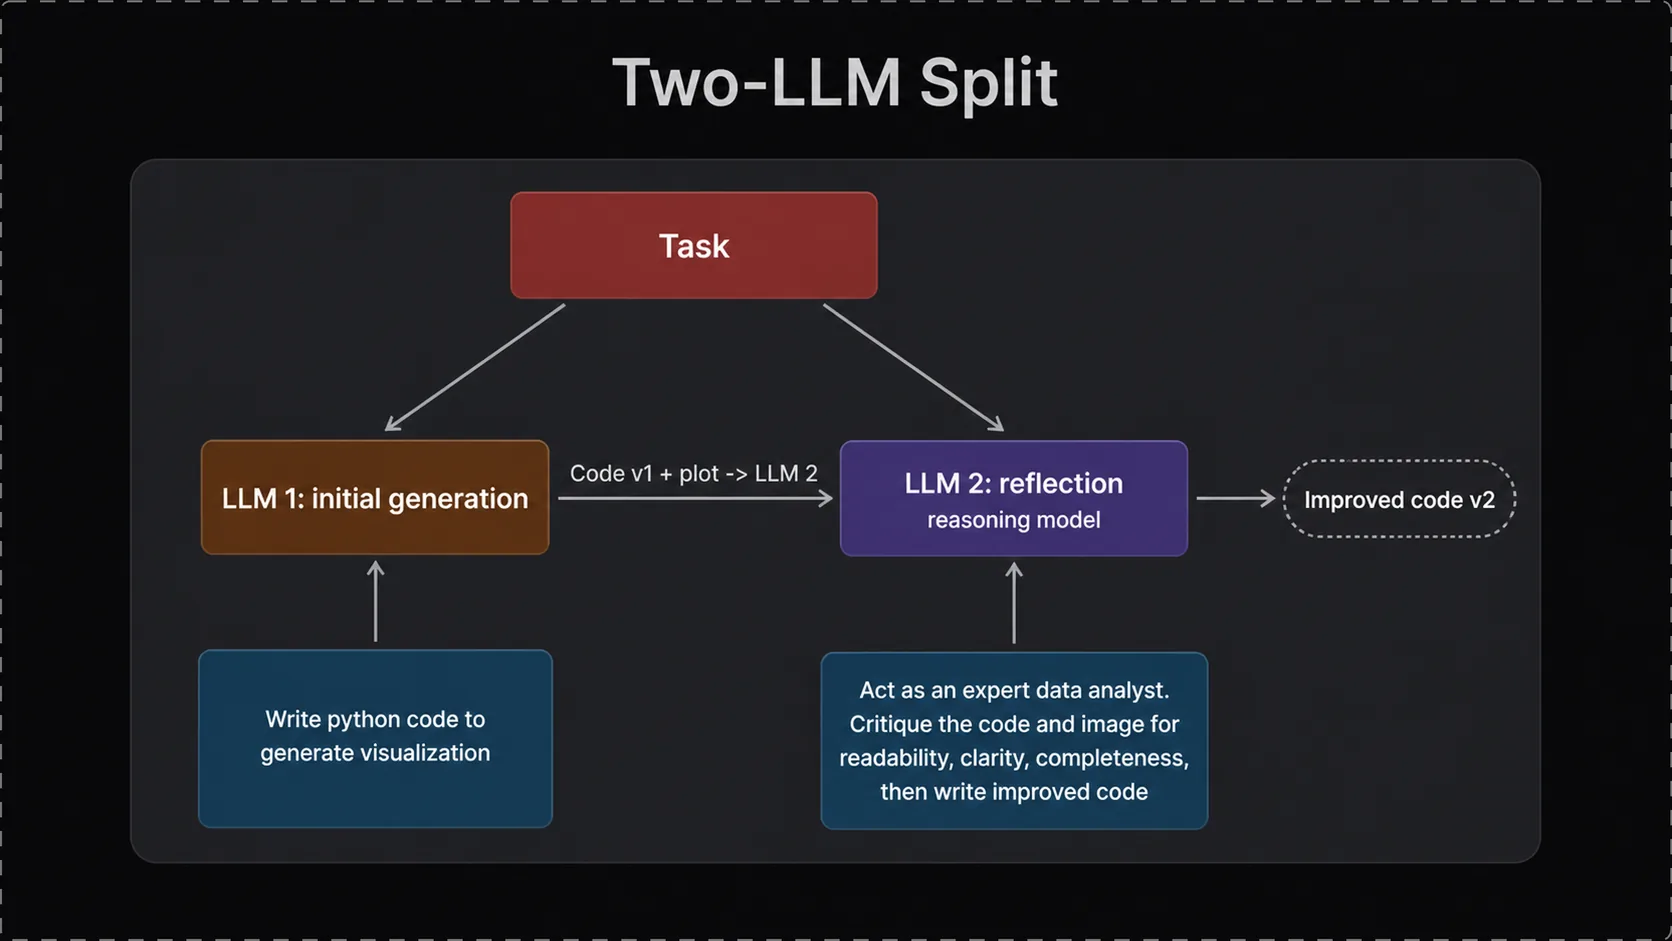
初始生成和反思可以交给不同模型。生成阶段用一个擅长写代码的模型,反思阶段用另一个。反思提示词让模型扮演资深数据分析师,提供建设性反馈,并指定具体标准,比如可读性(readability)、清晰度(clarity)、完整性(completeness)。把 v1 代码、生成的图、以及生成过程的历史对话一起给反思模型,它才知道改哪里、为什么改。推理模型做反思通常比非推理模型效果更好。
四、评估反射的影响
4.1 为什么要评估
反射多了一次模型调用,系统变慢、成本变高。值不值得,得用数据说话。评估(eval)就是回答「反射到底有没有提升性能、提升了多少」。
4.2 客观评估:数据库查询
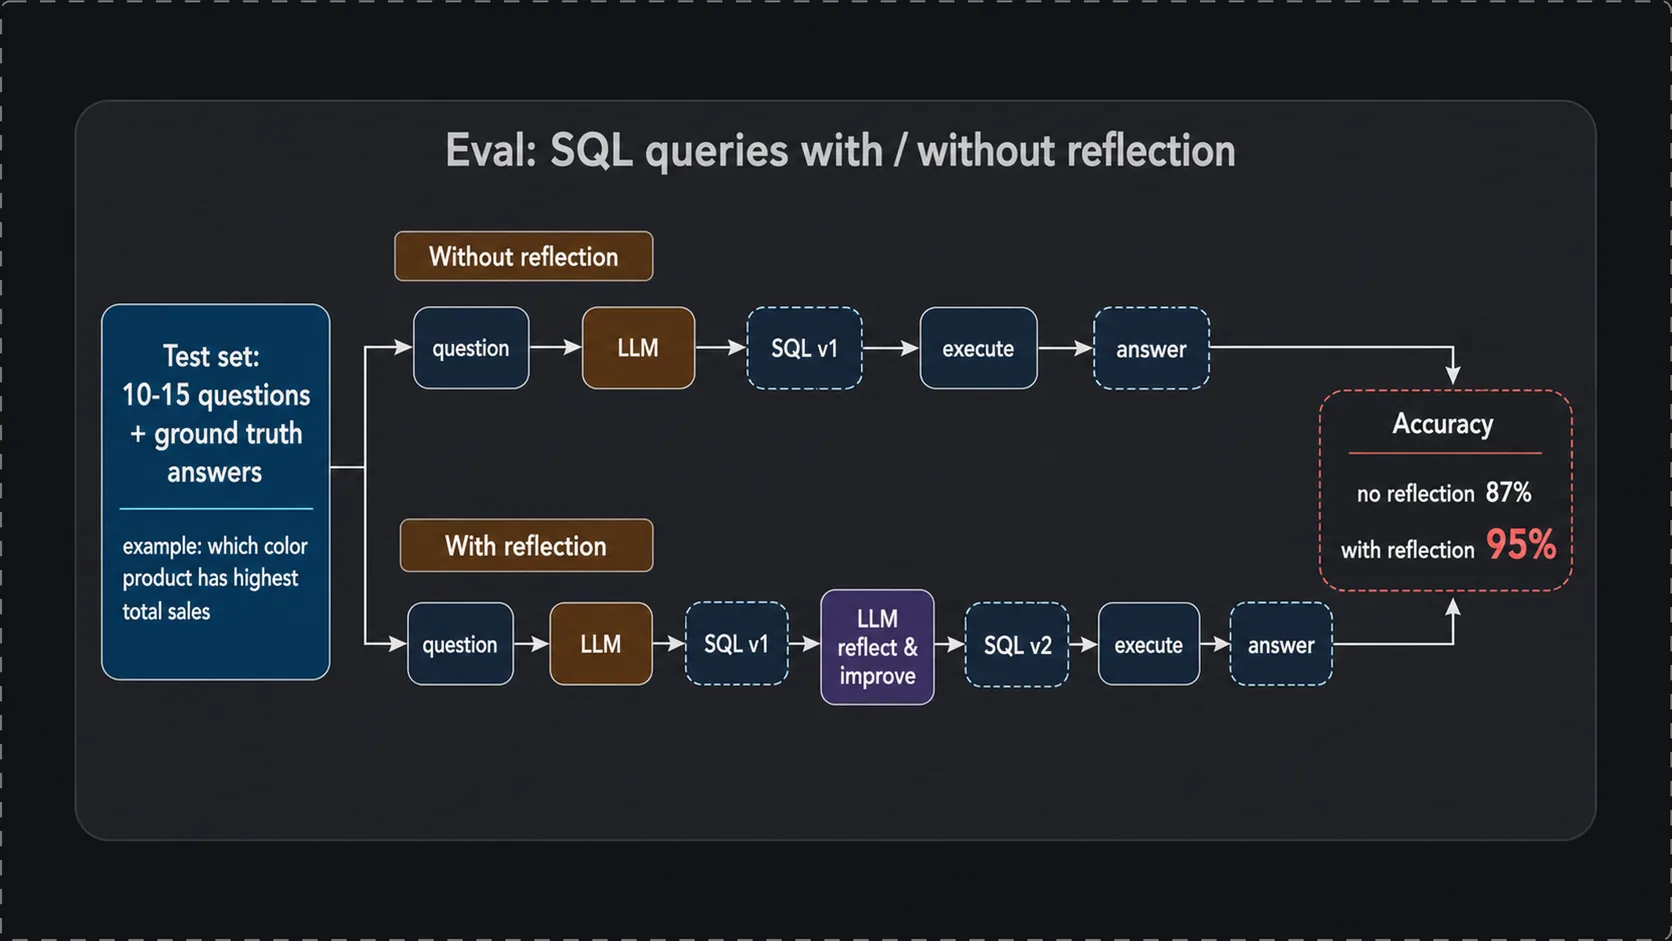
课程例子是让 LLM 写 SQL 查询来回答零售店数据问题,比如「哪种颜色的产品总销量最高」。流程是:问题 → 模型生成 SQL v1 → 第二个模型反思并改进 SQL → 执行查询 → 得到答案。
评估做法:收集 10-15 个问题和标准答案(ground truth),分别跑两套流程。无反射流程直接用第一个模型的 SQL 查询;有反射流程用第二个模型反思后的 SQL 查询。统计两套流程答对的百分比。示例结果:无反射 87% 正确,有反射 95% 正确,反射确实带来了提升。
4.3 用评估驱动提示词迭代
有了评估集,改提示词就不再靠感觉。想试试在反思提示里加一句「让查询跑得更快」或「让 SQL 更清晰」,改完重跑评估,对比正确率。提示词候选多了以后,评估是系统化筛选的依据。
4.4 主观评估:LLM 当评委的问题
数据库查询有标准答案,属于客观评估。图表生成没有唯一正确答案,属于主观评估,怎么比?让多模态 LLM 同时看两张图、直接问哪张更好,效果并不好。已知问题包括:回答质量不稳定、对提示词措辞敏感、排序结果和人类专家判断对不上,而且多数 LLM 有位置偏差(position bias),倾向于选先展示的那个选项。
4.5 更稳定的做法:rubric 打分
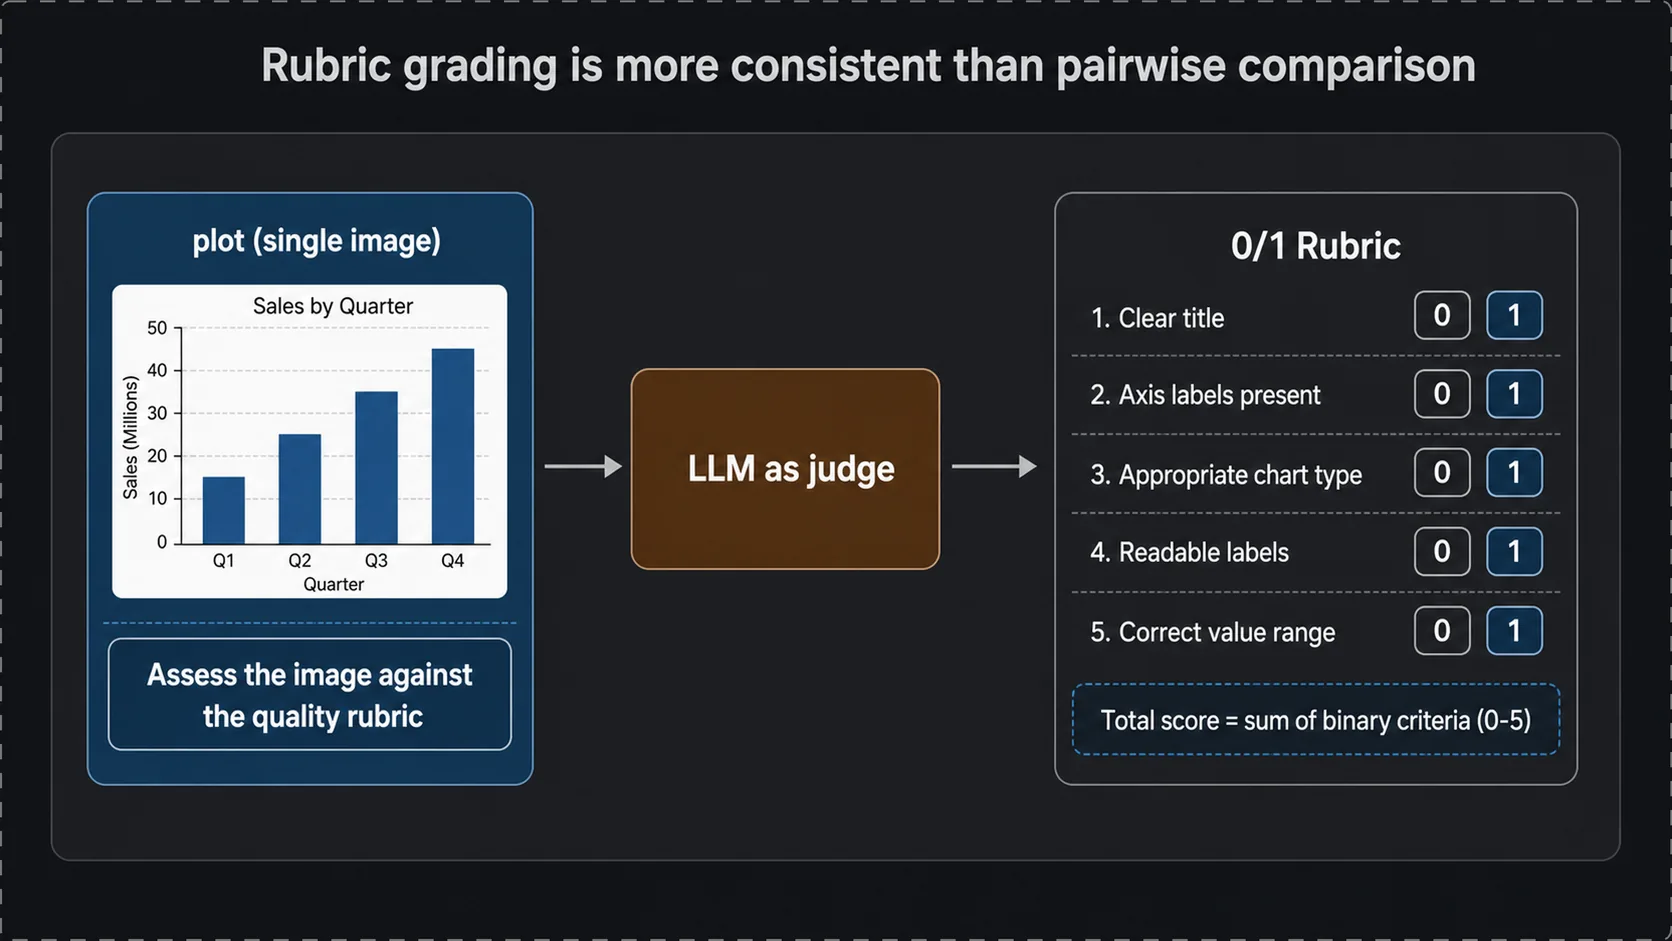
与其让 LLM 对比两张图,不如给单张图打分,这叫 rubric 评分(按标准评分)。给 LLM 一张图和一个评分标准清单,比如「是否有清晰标题」「坐标轴标签是否齐全」「图表类型是否合适」,逐条判定。打分方式上,用 5 个 0/1 二元标准求和(得 0-5 分),比让模型直接打 1-5 分更稳定,因为模型对连续分数的校准很差。对 10-15 个可视化需求分别生成有反射和无反射的图,各自按 rubric 打分汇总,就能量化反射的收益;以后改任何提示词都能重跑这套评估。
五、外部反馈:反射的放大器
5.1 提示工程的收益递减
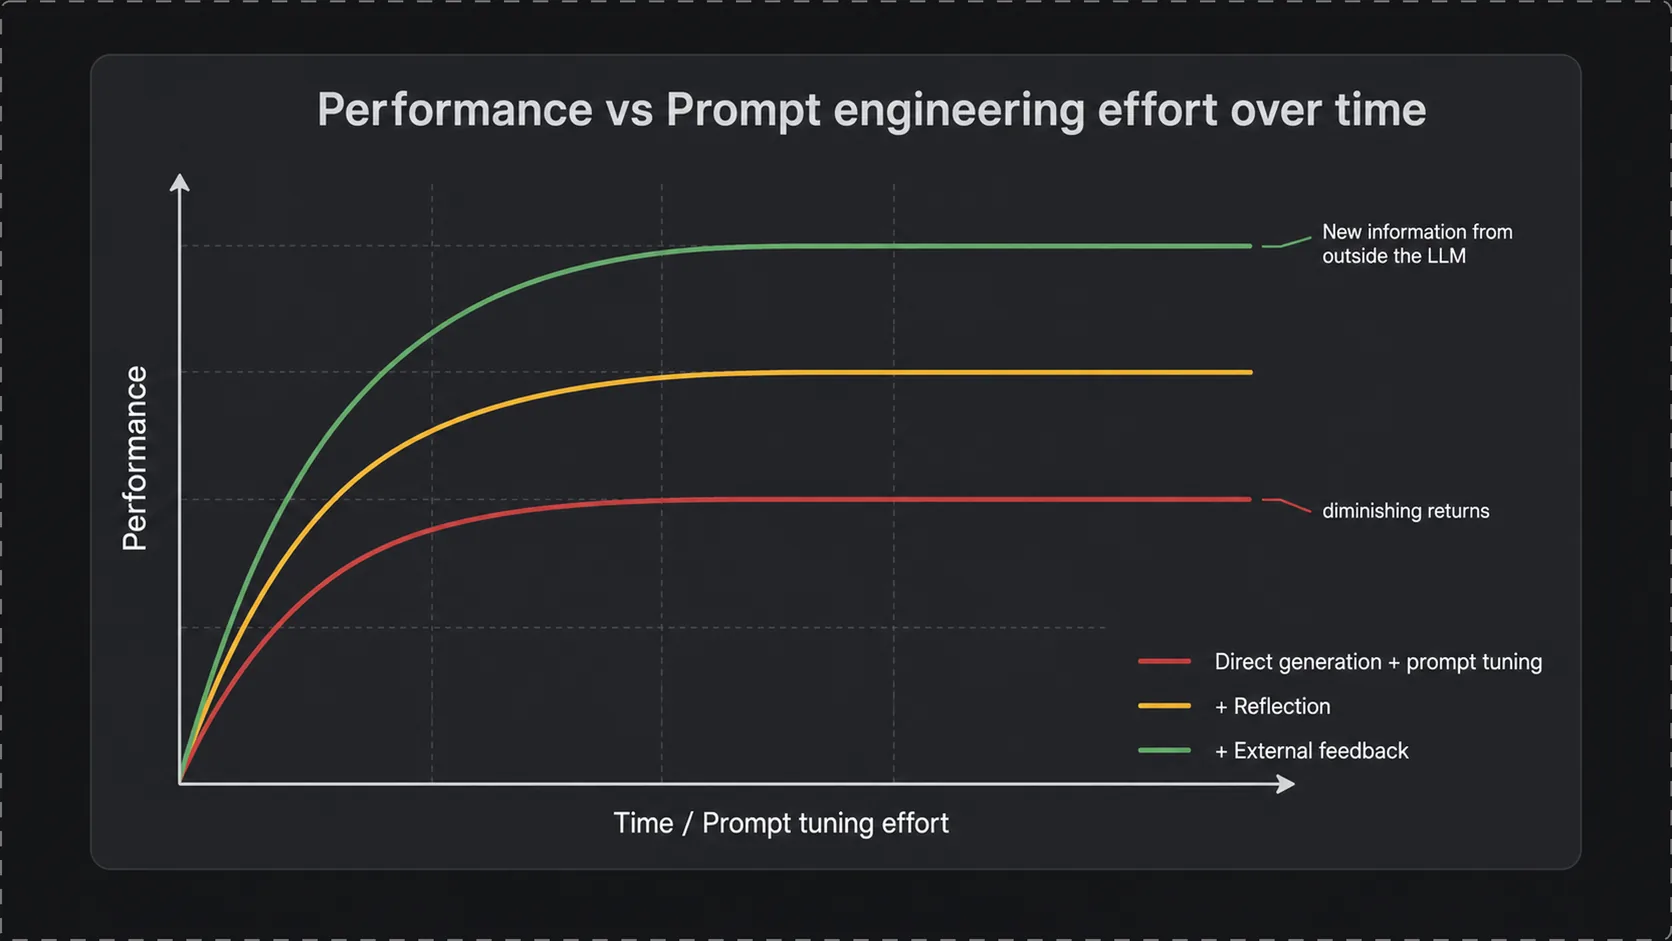
只做直接生成时,性能提升来自反复调提示词。前期每调一次都有收益,调多了曲线进入平台期,再怎么改提示词也涨不动。
5.2 反射把曲线整体抬升
早一点引入反射,再把精力花在调反思提示词上,性能平台会被整体抬高一截。提升幅度有时大有时小,但方向通常是向上的。
5.3 外部反馈推得更高
反射还有一个更有效的变体:引入外部反馈。前面的反射是 LLM 对着同一份信息反复想,外部反馈则是把模型之外的新信息喂进来。代码场景就是执行代码,把运行结果和错误日志交给反思步骤——「这段代码实际跑起来报了什么错」,这是模型凭空想不出来的信息。有了外部反馈,性能曲线能推到更高的平台。
5.4 落地建议
如果调提示词已经陷入收益递减,先考虑加反射;如果应用场景能拿到外部反馈(代码执行结果、工具输出、错误日志),优先把它接进反思流程。反射不是魔法,不会让模型 100% 正确,但在多数任务上能带来稳定的性能提升,而且实现成本只是多一次模型调用。
总结
反射设计模式把「一次生成」拆成「初稿 + 反思 + 二稿」,用第二次模型调用的成本换输出质量。它的收益需要评估来量化:客观任务直接对比正确率,主观任务用 rubric 打分。反射的进阶用法是引入外部反馈,让模型基于执行结果等新信息反思,这是把反射效果放大的关键。这五个视频覆盖了反射模式的原理、对比、案例、评估和外部反馈,是 Agentic AI 工作流里性价比最高的一环。
本文由 AgentPlanFlow 生成