
文章内容
- 一、工具:LLM 能力的扩展
- 1.1 一个问不出来的问题:现在几点
- 1.2 工具使用的完整流程
- 1.3 用不用工具,由 LLM 决定
- 1.4 多工具与连续决策
- 二、创建工具:通过Prompt调用
- 2.1 LLM 不调用函数,只输出请求
- 2.2 用提示词约定调用格式
- 2.3 带参数的工具
- 2.4 五步流程
- 三、现代工具语法:框架自动生成描述
- 3.1 一段调用代码
- 3.2 docstring 自动变成 JSON Schema
- 3.3 maxturns:工具循环的上限
- 3.4 带参数的复杂 Schema
- 3.5 谁执行函数
- 四、代码执行流程
- 4.1 每个计算器按钮都做一个工具?
- 4.2 让 LLM 写代码
- 4.3 执行方式与安全
- 4.4 错误反馈循环
- 五、MCP:工具生态的标准化
- 5.1 集成爆炸:M×N 问题
- 5.2 MCP 的解法:M+N
- 5.3 Client 与 Server
- 5.4 演示:Claude Desktop 接 GitHub MCP Server
本文内容整理自吴恩达(Andrew Ng)《Agentic AI》课程模块3「工具使用」
LLM 只会生成文本 token,它凭什么能查数据库、发日历邀请、跑一段 Python?答案是它压根不执行任何东西。工具使用(tool use)的真实链路是:LLM 按约定格式输出一个调用请求,宿主代码解析这个请求、真正执行函数、把返回值写回对话历史,LLM 再基于这段历史继续生成。「请求—执行—回填」这个三段式一直没变,变的是请求怎么表达——从开发者手写文本协议,到框架读 docstring 自动生成 JSON Schema,再到 MCP 把工具供给标准化成生态级的 client/server。
一、工具:LLM 能力的扩展
1.1 一个问不出来的问题:现在几点
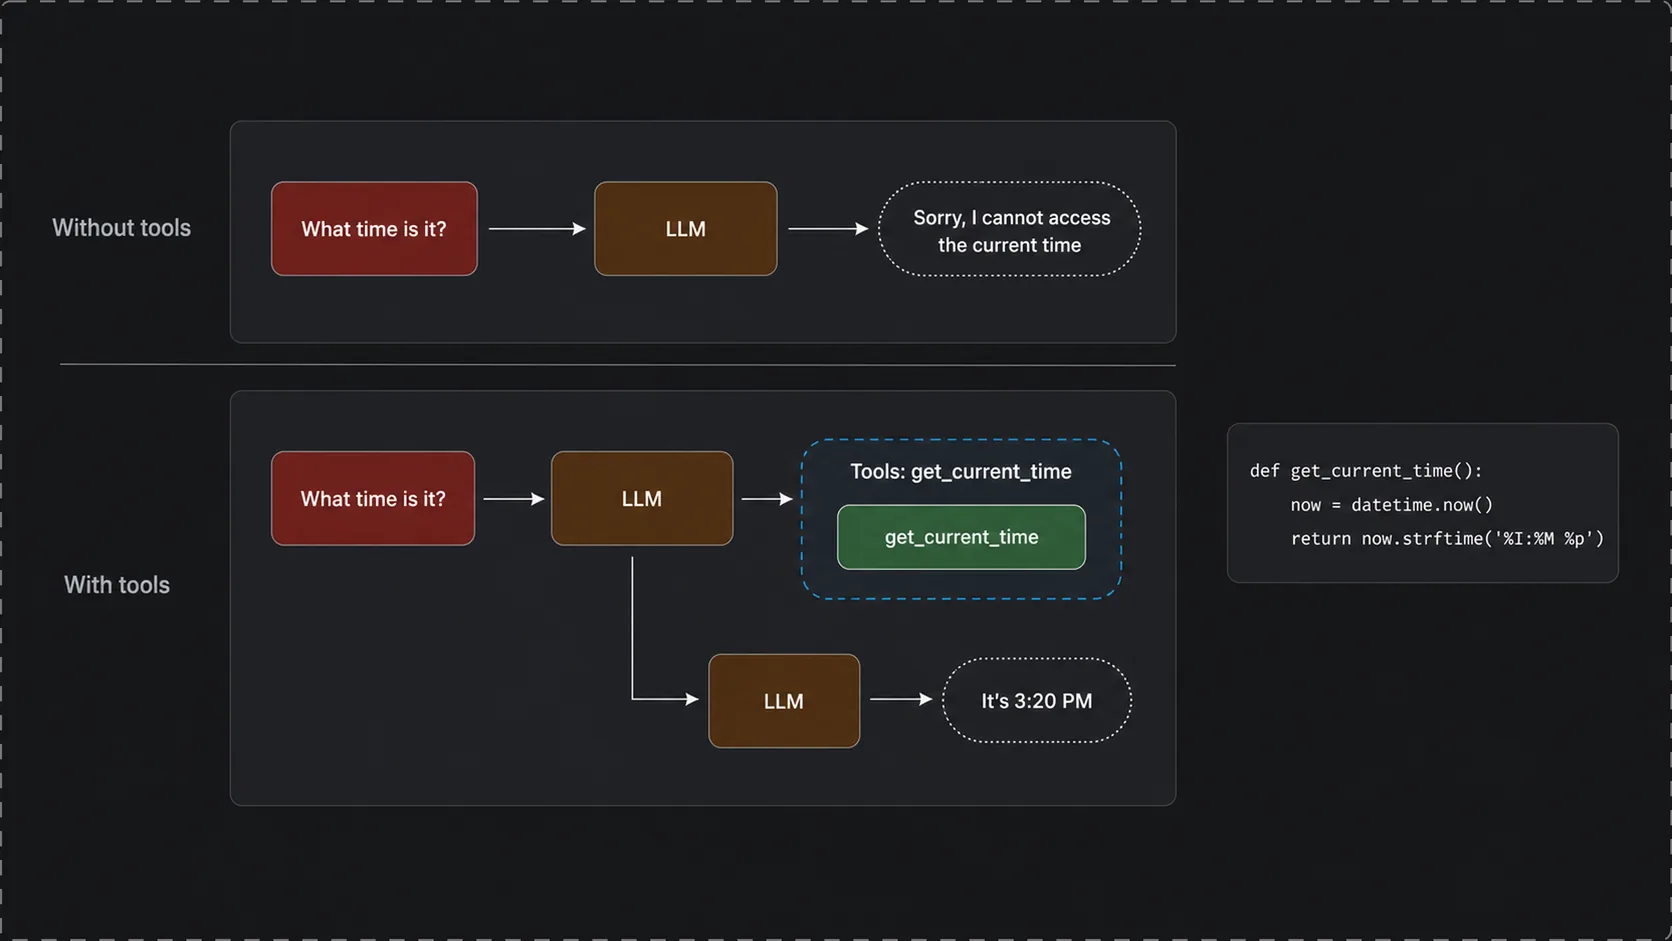
模型是几个月前训练完的,它不知道此刻的时间。直接问「现在几点」,好一点的模型会回答「抱歉,我无法获取当前时间」。
给它一个函数就不一样了:
# 最小可用的工具:返回当前时间from datetime import datetime def get_current_time(): """返回当前时间""" return datetime.now().strftime("%H:%M")同样的问题,LLM 这次会请求调用 get_current_time,拿到返回值后回答「现在是下午 3 点 20」。工具就是这样一些普通函数,由开发者实现并提供给 LLM。
1.2 工具使用的完整流程
一次完整的工具调用包含五个环节:输入 prompt → LLM 查看可用工具集 → 决定请求调用某个工具 → 函数返回值被喂回对话历史 → LLM 生成最终输出。
关键在第四步。函数的返回值不是直接交给用户的,而是作为对话历史的一部分回填给 LLM,LLM 看到「用户问了什么、我请求了什么、函数返回了什么」这一整段上下文,才写出最终回答。
1.3 用不用工具,由 LLM 决定
同样是给了 get_current_time,如果用户问的是「绿茶里有多少咖啡因」,LLM 会直接回答,不会去调用时间函数。这一点和早期硬编码的做法有本质差别:研究型 Agent 里「在这一步一定执行 web search」是开发者写死的分支,而工具调用是把工具集摆出来,由模型自己判断该不该用、用哪个。
课程幻灯片里用 LLM 上方的一个虚线框表示这层含义——这里提供了一组工具,选择权在模型。
1.4 多工具与连续决策
几个典型的「有工具答得更好」的场景:
| Prompt | Tool | Output |
|---|---|---|
| 找找 Mountain View 附近的意大利餐厅 | web search | 基于检索结果给出餐厅列表 |
| 显示买过白色墨镜的顾客 | query database | 查销售表中白色墨镜的成交记录 |
| 存 500 元、年利率 5%、10 年后是多少 | 利率计算 | 调用计算函数得出金额 |
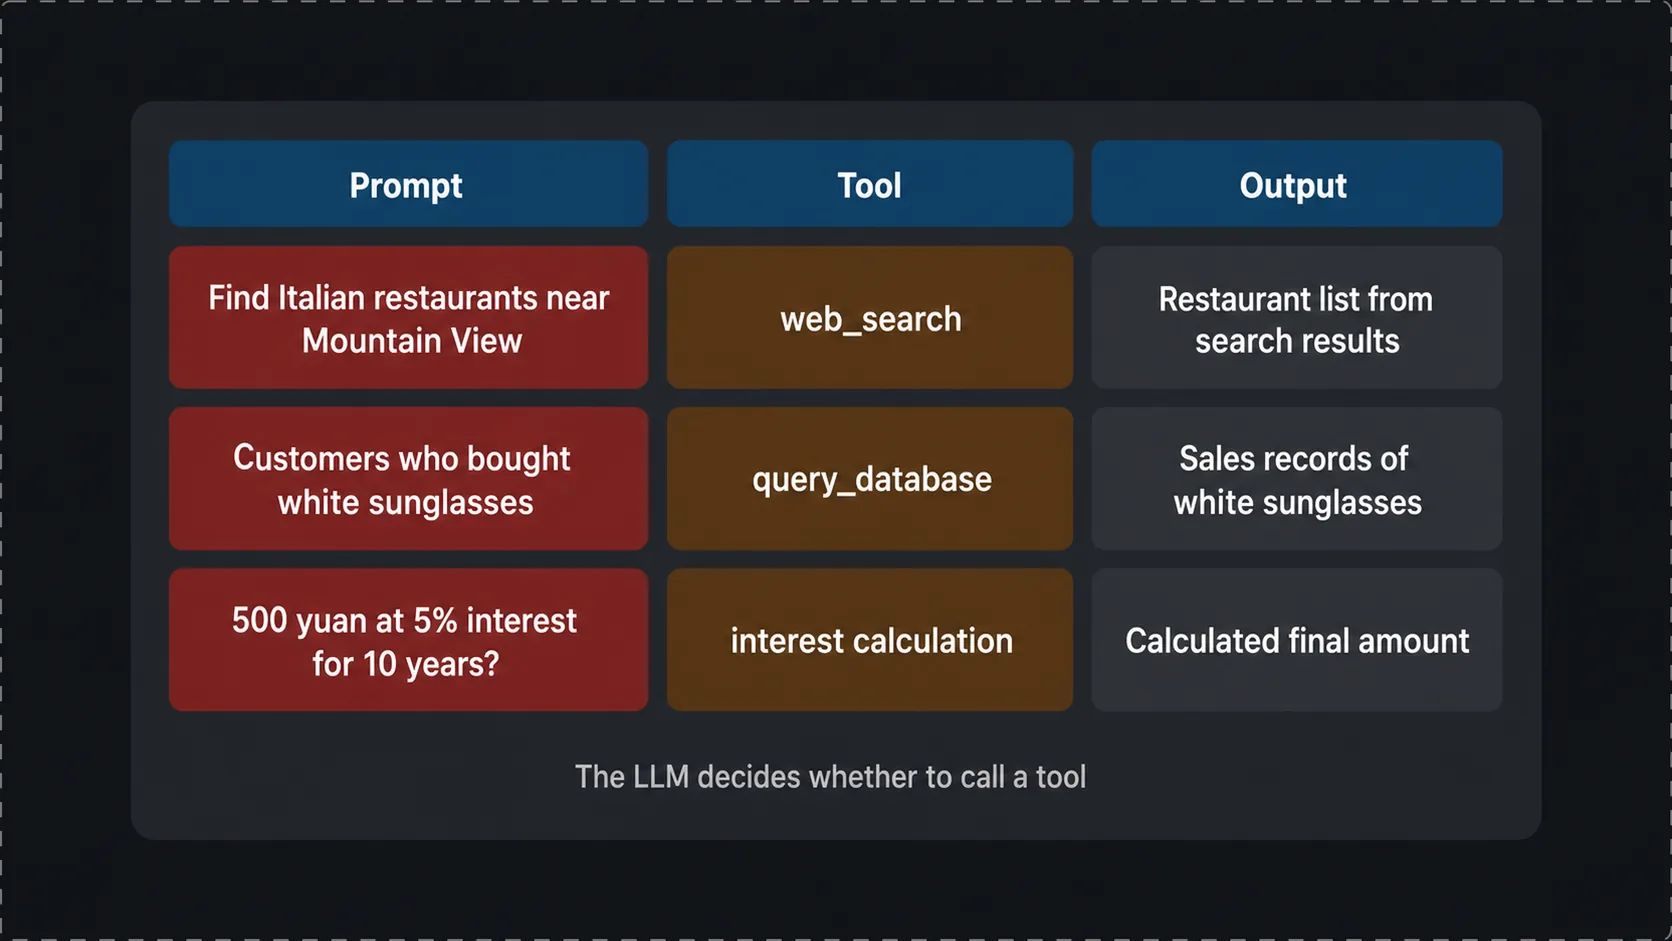
利率那一行还有第二条路:让 LLM 直接写出数学表达式再求值,这就是后面要讲的代码执行。
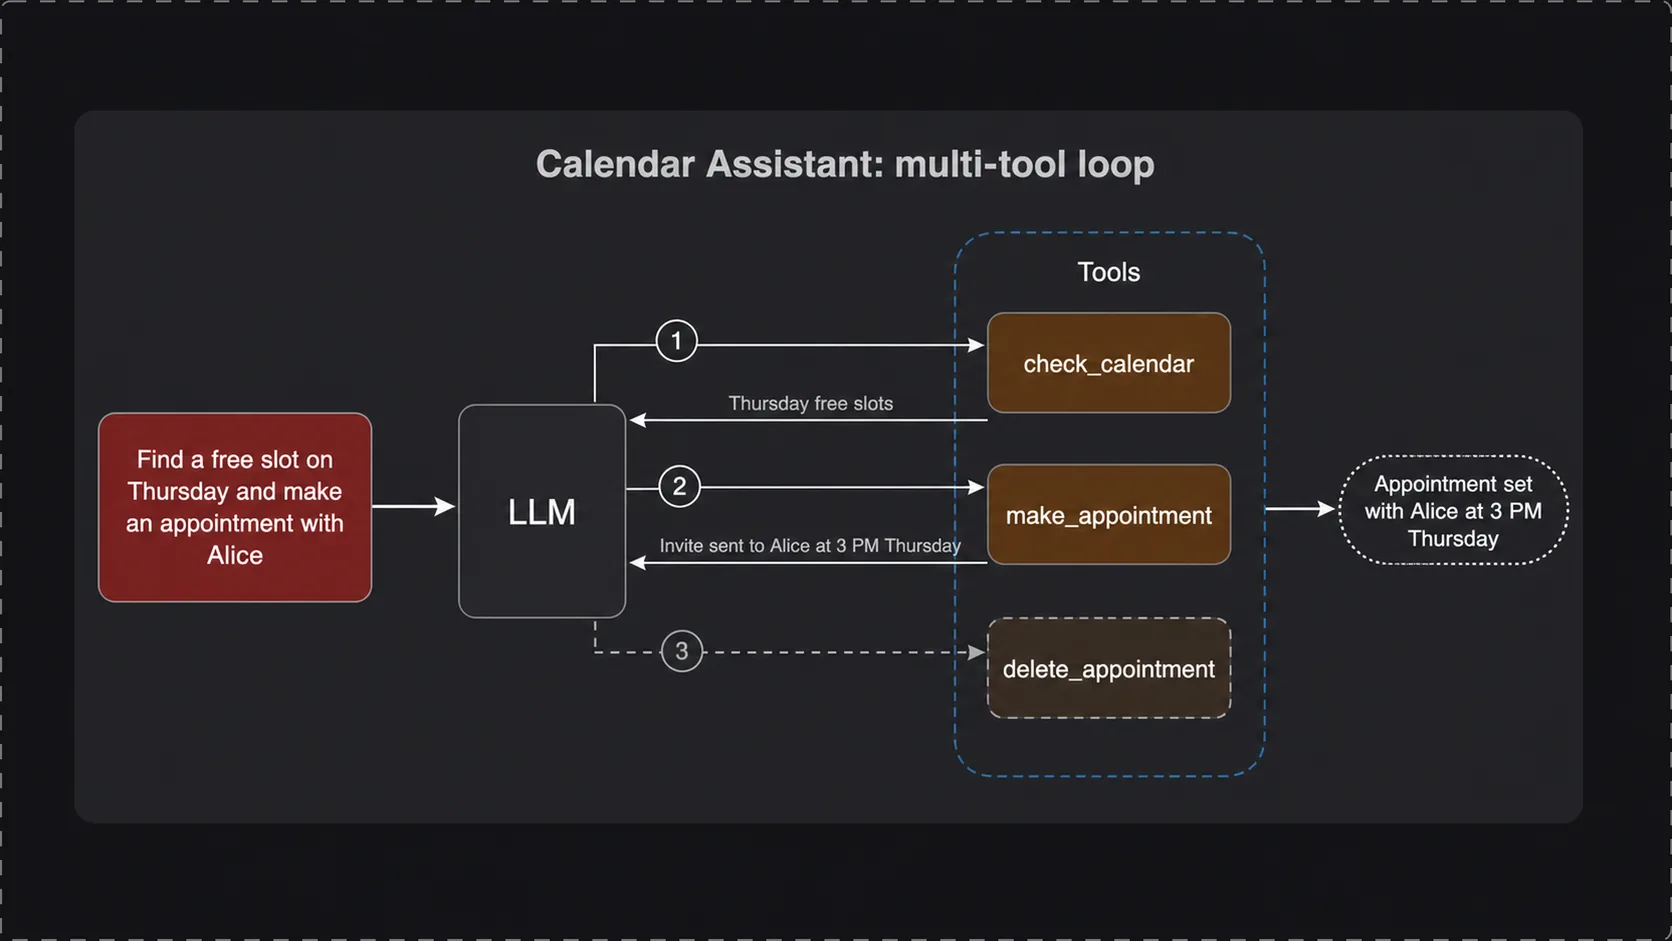
工具多起来以后,一次请求可能触发一串调用。日历助手拿到「在周四找个空档,和 Alice 约个会」,手上有 check calendar、make appointment、delete appointment 三个工具,它会先调 check calendar 拿到周四的空闲时段,把结果回填后挑定下午 3 点,再调 make appointment 发出邀请,拿到发送成功的确认,最后才输出「已和 Alice 约在周四下午 3 点」。每一次调用的输出都要回填,模型才知道下一步该做什么。
二、创建工具:通过Prompt调用
2.1 LLM 不调用函数,只输出请求
今天主流模型都经过原生训练来使用工具,但把时钟拨回原生支持之前,开发者得自己写 prompt 告诉模型什么时候该用工具。
2.2 用提示词约定调用格式
做法是在系统提示里和模型约定一个暗号:
用户问「现在几点」,模型就会输出 FUNCTION: get_current_time。宿主代码扫描模型输出,发现这个全大写标记,从中取出函数名,调用真正的 get_current_time(),得到 8 a.m.,再把这个值连同之前的用户提问、函数请求一起作为对话历史交回模型,模型输出「现在是早上 8 点」。
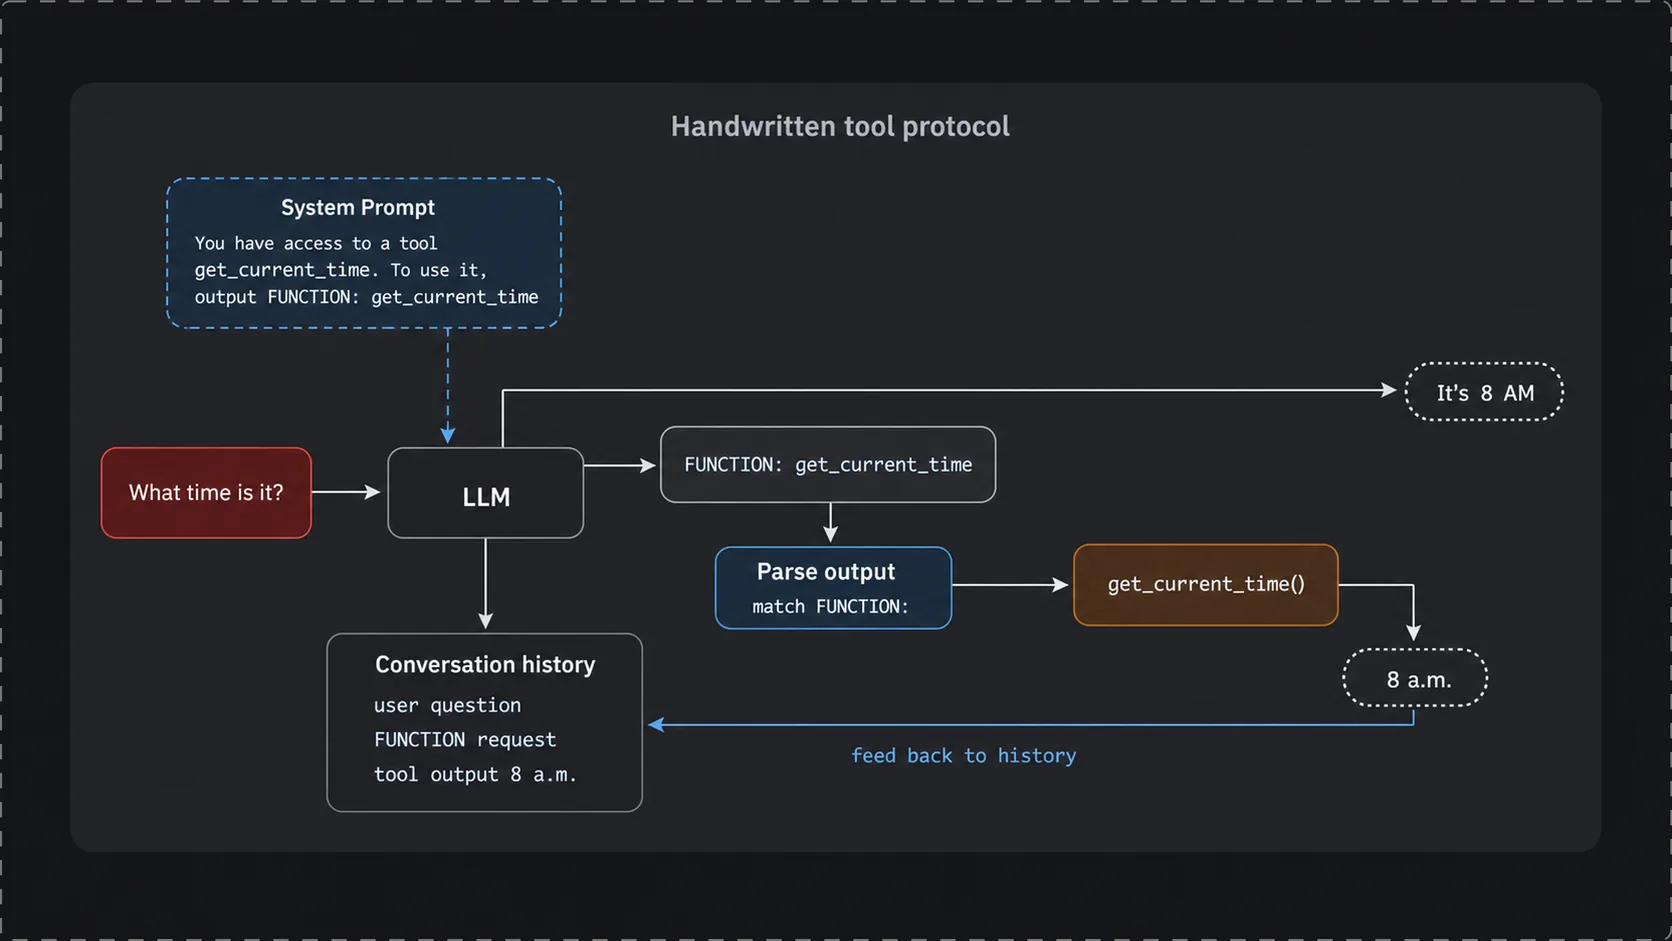
整条链路里,模型自始至终只做了一件事:生成一段特定格式的文本。执行、解析、回填全部由开发者的代码完成。
2.3 带参数的工具
给函数加一个时区参数,协议也跟着扩展:
# 按指定时区返回当前时间from datetime import datetimefrom zoneinfo import ZoneInfo def get_current_time(timezone): """返回指定时区的当前时间""" return datetime.now(ZoneInfo(timezone)).strftime("%H:%M")系统提示改成「使用 get_current_time 时,输出函数名并附上时区」。问「新西兰现在几点」,模型输出 FUNCTION: get_current_time PACIFIC/AUCKLAND——它知道奥克兰是新西兰的主要城市,也知道对应的时区标识符。宿主代码取出参数、调用函数、拿到 4 a.m.,模型最终回答「新西兰现在是凌晨 4 点」。
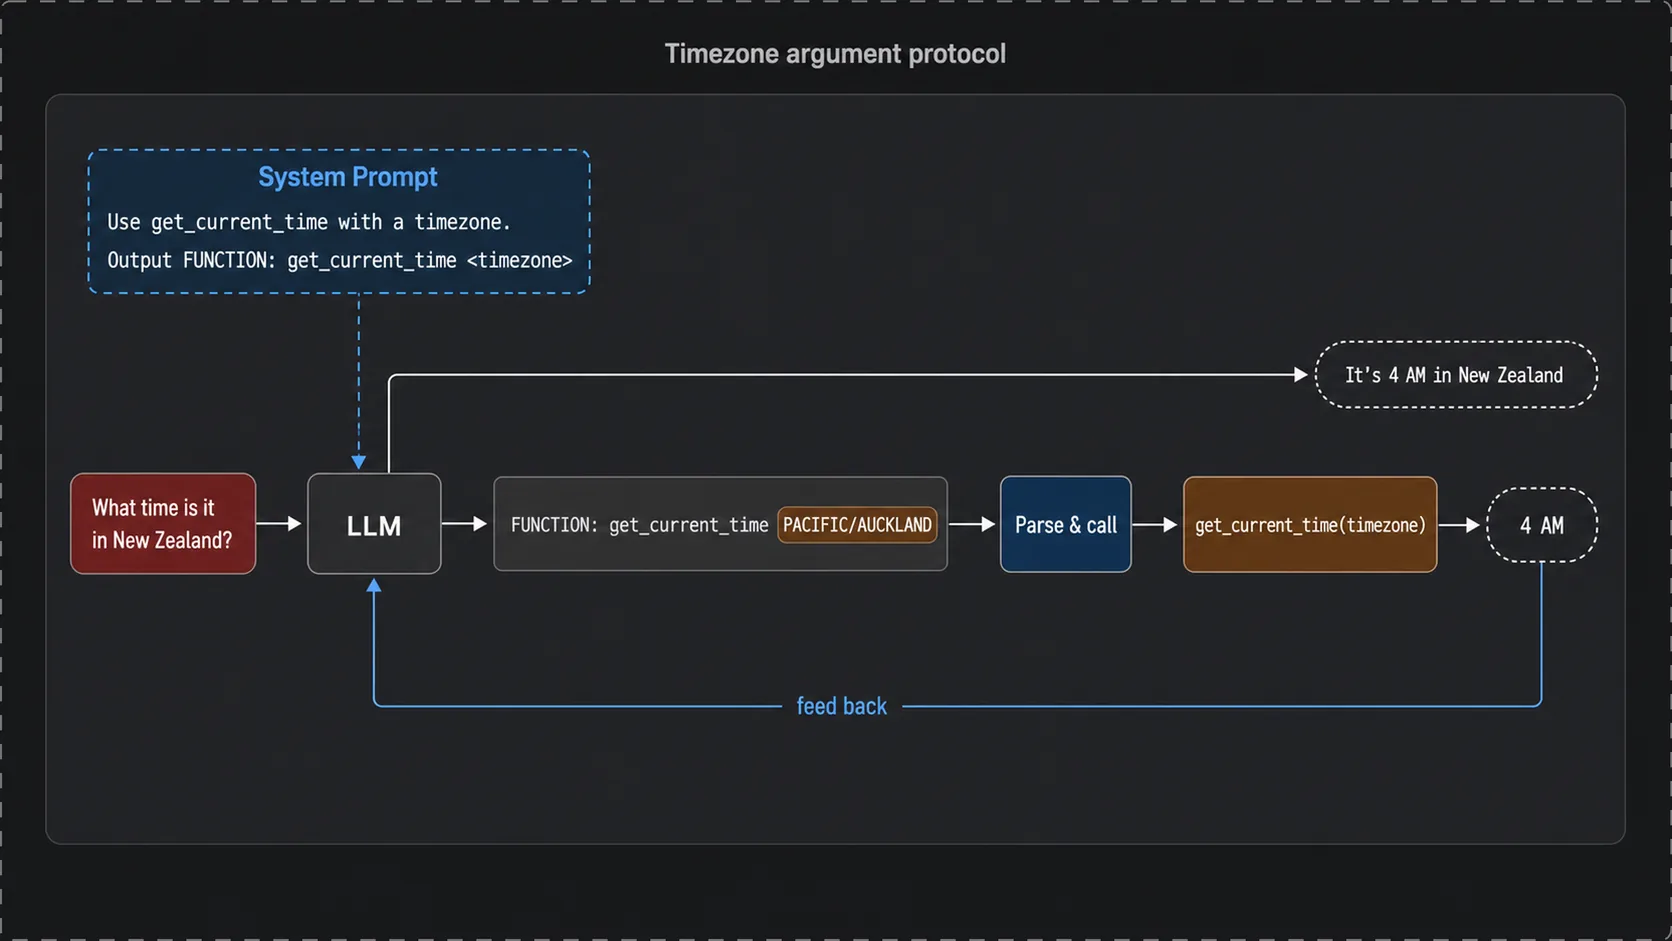
2.4 五步流程
把上面的过程抽象出来,就是工具使用的通用骨架:
- 提供工具:实现函数,并告诉 LLM 它可用;
- LLM 决定调用时,输出一段特定格式的请求;
- 宿主代码解析请求、调用函数、取得返回值;
- 把返回值回填进对话历史;
- LLM 基于新历史继续——生成最终回答,或者请求调用下一个工具。
全大写 FUNCTION 这套语法笨拙,全靠提示词维持,模型稍不听话就解析失败。现代模型被直接训练成用固定语法发出工具调用请求,所以这层手写协议已经退场,但五步骨架完全没变。
三、现代工具语法:框架自动生成描述
3.1 一段调用代码
先看现在的代码长什么样,再看它替你做了什么。下面用的是 aisuite——吴恩达和朋友们开发的开源库,用途是统一多家 LLM provider 的调用方式,语法与 OpenAI 的接口很接近:
# 把 Python 函数本身作为工具传给模型response = client.chat.completions.create( model="openai:gpt-4o", messages=messages, tools=[get_current_time], max_turns=5,)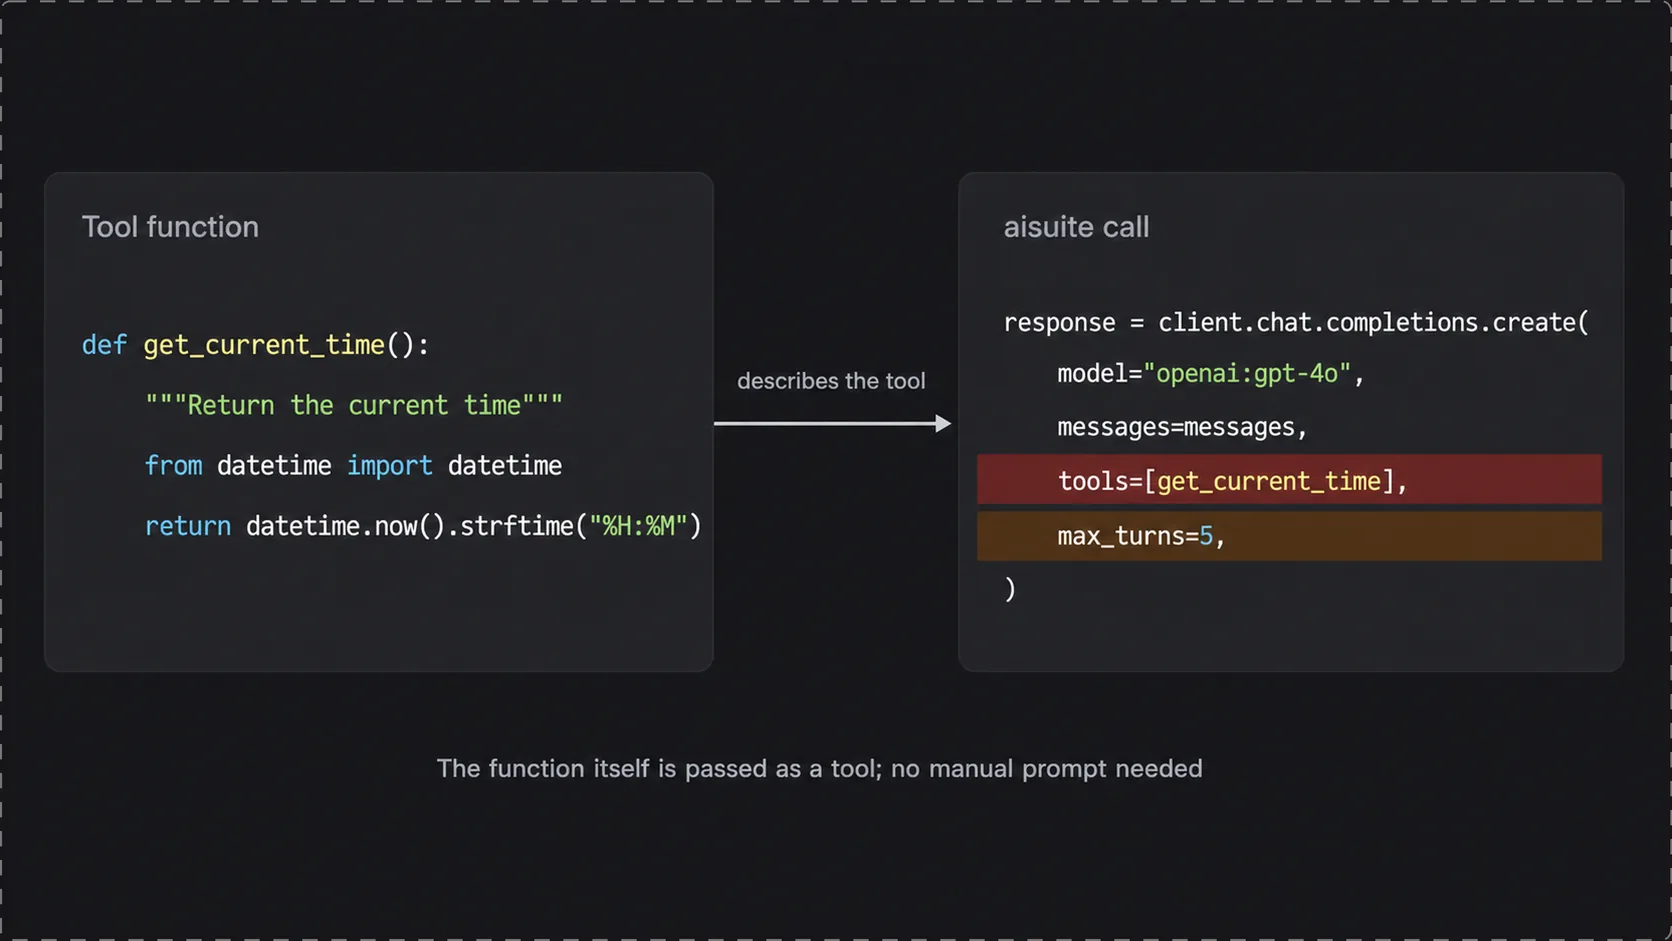
和第二章相比,消失的是那段手写的系统提示、那段正则解析、那段手动调用和回填的代码。
3.2 docstring 自动变成 JSON Schema
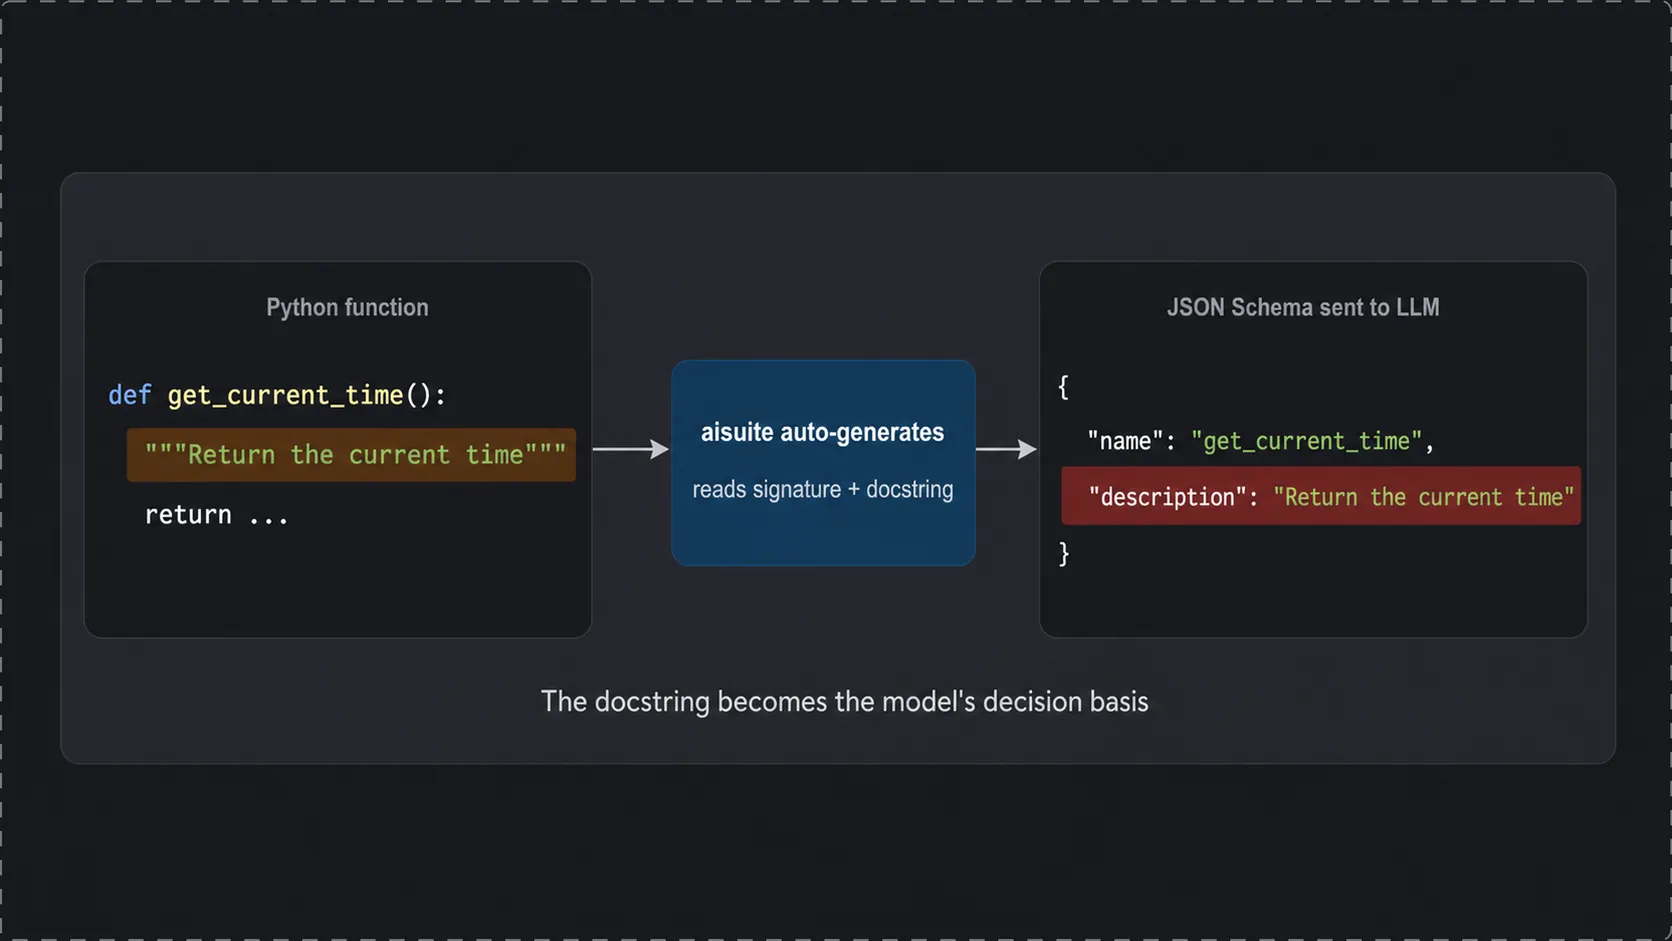
aisuite 会读取函数签名和 docstring,自动生成一份描述这个函数的 JSON Schema,真正传给模型的是这份 Schema。无参数版本很简单,只有函数名和从 docstring 提取的描述:
{ "name": "get_current_time", "description": "返回当前时间"}模型靠 description 判断什么时候该调用它。工具函数的 docstring 因此不再只是给人看的注释,它是模型的判据。
3.3 max_turns:工具循环的上限
工具返回之后,模型可能决定再调一个,再返回后还可能再调。max_turns 就是这串连续调用的次数上限,用来兜住可能的死循环。一般设成 5,实践中除非任务异常复杂,很少真的触顶。
3.4 带参数的复杂 Schema
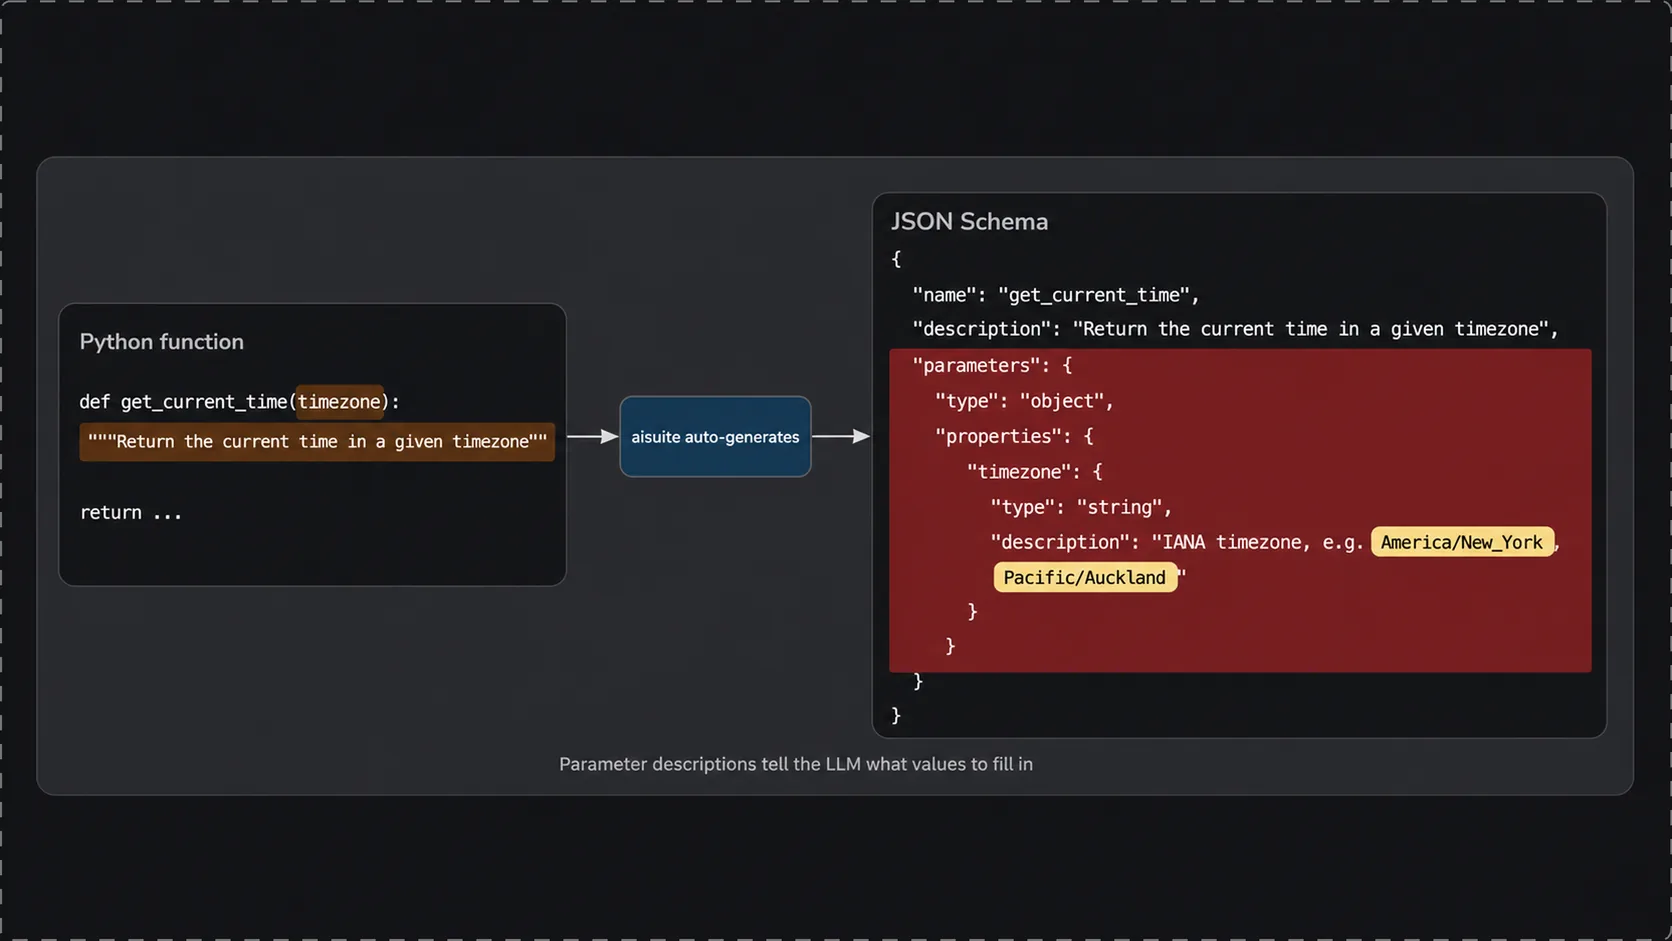
带 timezone 参数的版本,生成的 Schema 会多出参数部分:函数名、来自 docstring 的描述,再加上每个参数的名称、类型和说明。参数说明里会带上 America/New_York、Pacific/Auckland 这类取值示例,模型生成调用参数时才知道该填什么格式的时区标识符。参数描述的质量直接决定模型填对填错。
3.5 谁执行函数
用 aisuite 时,模型请求调用 get_current_time,客户端会替你把函数执行掉、把结果回填,整个循环包在这一次 create 调用里,开发者不需要写额外代码。别的接口未必如此——有些 API 要求你手动构造 JSON Schema 传给模型,也要求你手动执行函数并回填。
四、代码执行流程
4.1 每个计算器按钮都做一个工具?
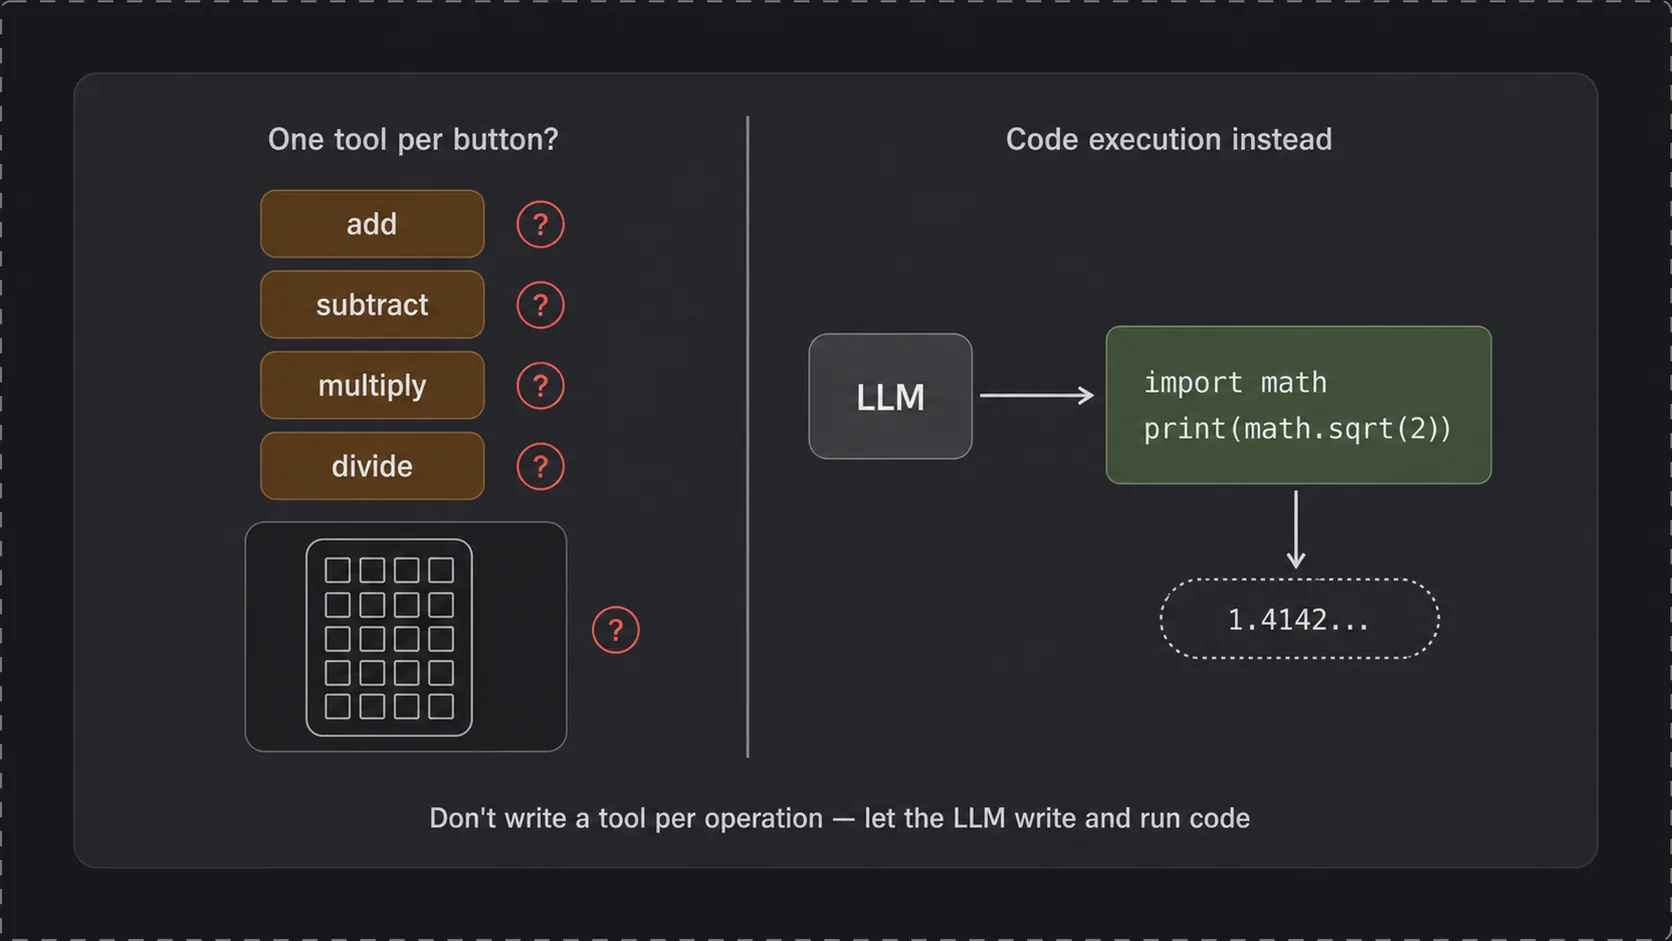
假设要做一个解数学应用题的应用,先写四个工具:add、subtract、multiply、divide。用户输入「13.2 加 18.9」,触发 add,答案正确。
接着用户问「2 的平方根是多少」。加个 sqrt 工具?那指数呢?对数呢?看一眼科学计算器上有多少个按键,就知道这条路走不通。
4.2 让 LLM 写代码
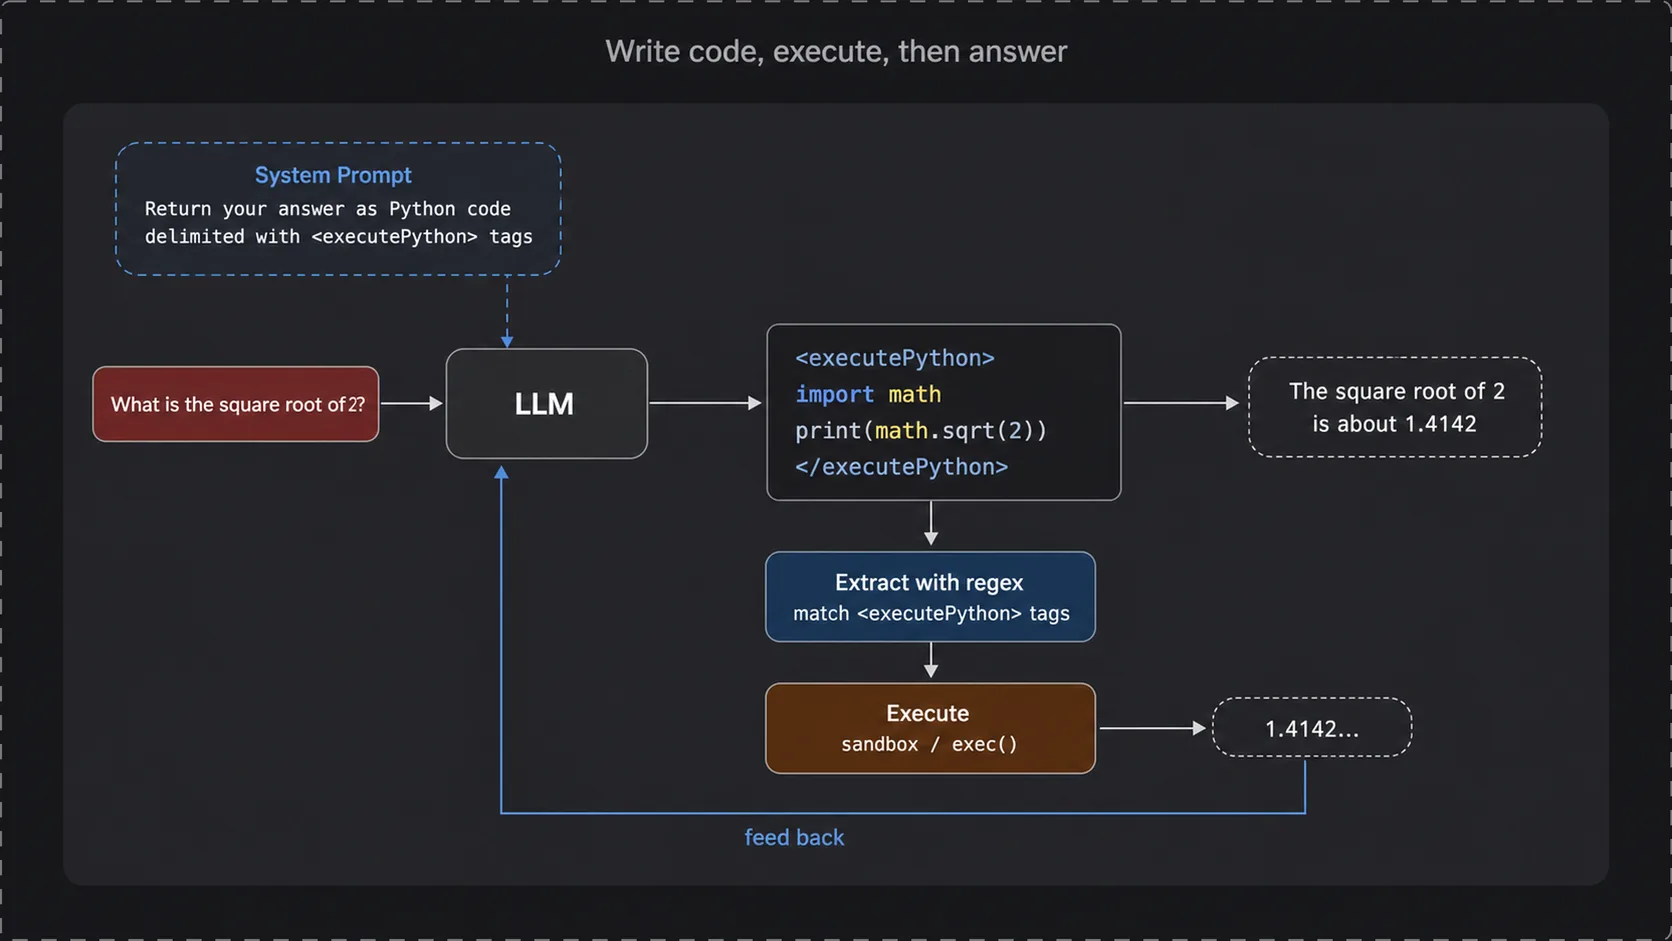
换个思路:不给它算子,给它一个能跑代码的环境。提示词大致是这样:
写代码解决用户的问题。把答案写成 Python 代码,用 <executePython> 和 </executePython> 标签包起来。问「2 的平方根是多少」,模型输出:
# 模型生成、被标签包裹的代码import mathprint(math.sqrt(2))宿主代码用正则匹配起止标签,取出中间的代码执行,得到 1.4142…,把这个数值回填给模型,模型再写成一句格式良好的回答。同一套机制既能算平方根,也能算复利,还能处理复杂得多的数学问题——工具数量从「每个函数一个」压缩成了一个。
4.3 执行方式与安全
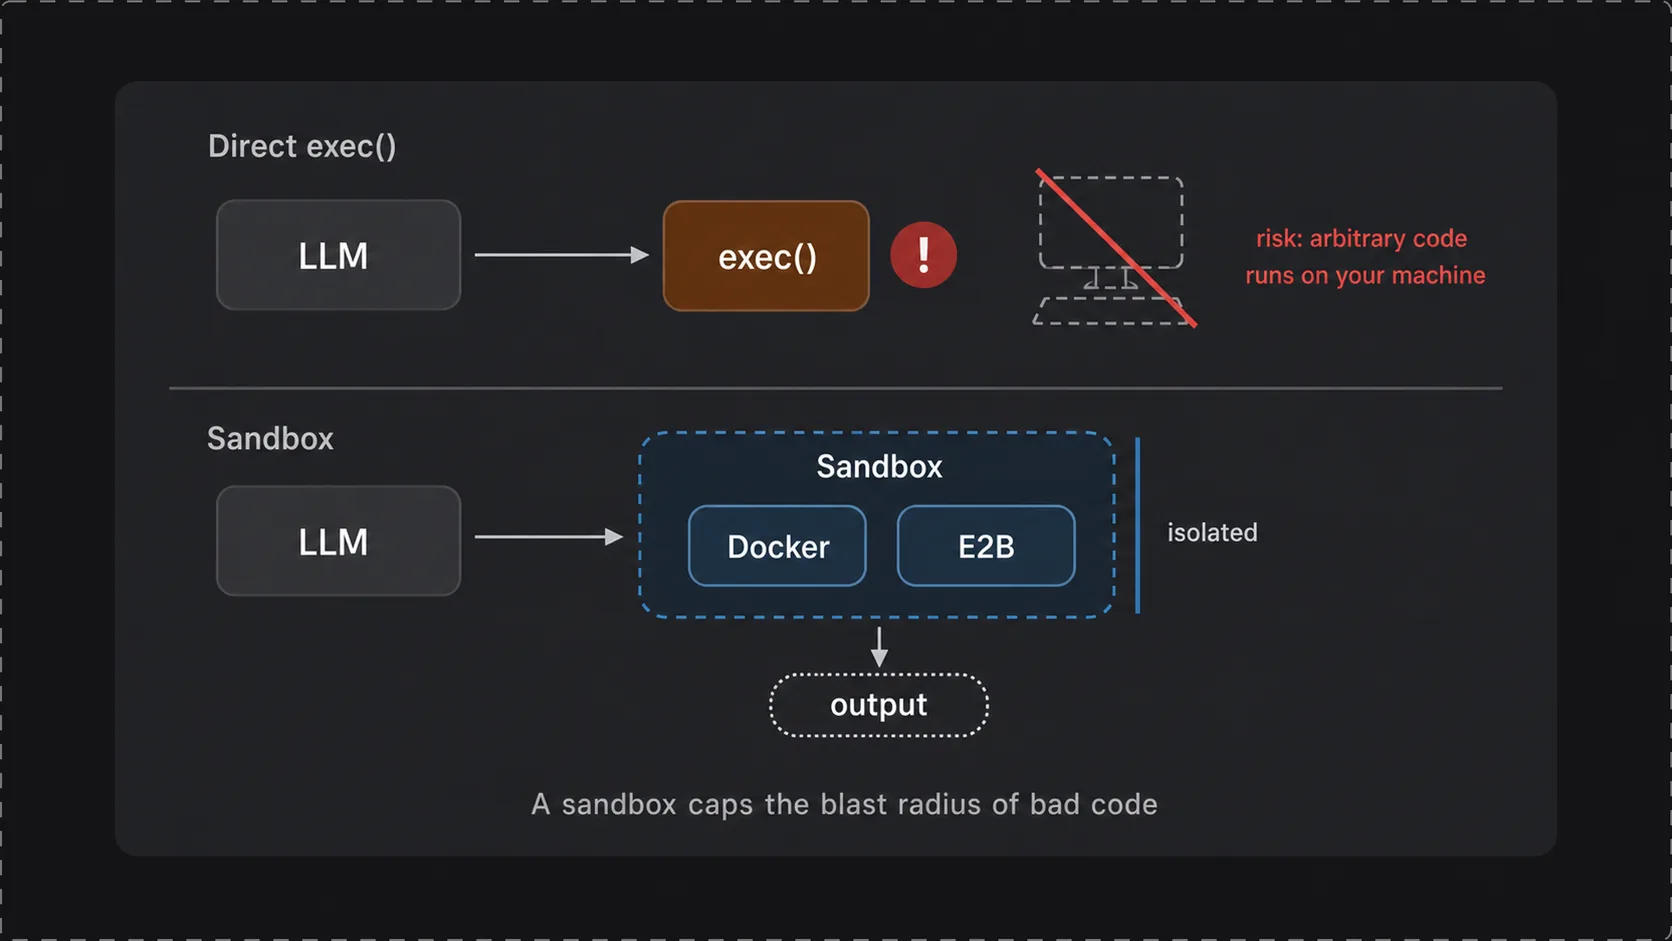
执行环节有两条路。一是 Python 内置的 exec(),传什么执行什么,最省事,也最危险。二是放进沙箱,Docker 或 E2B 这类轻量沙箱环境都可以。
课程里提到一个真实事故:团队成员用一个自主性很高的编码 Agent,它自行决定在项目目录里执行 rm *.py,删掉了一批 Python 文件,事后还诚恳道歉说这是个愚蠢的错误。所幸代码有 GitHub 备份,没造成实际损失。
单行代码出事的概率确实不高,坦率说很多开发者不做多少检查就直接执行模型生成的代码。但最佳实践是沙箱:模型写出坏代码时,数据丢失和敏感信息泄漏的风险被限制在盒子里。
4.4 错误反馈循环
代码执行失败时,把错误信息原样喂回模型,让它据此修改代码再试一两次,往往能拿到正确结果。这正是反射模式在工具场景下的形态——反思的依据不是模型的凭空推测,而是执行器给出的真实报错。代码执行的重要性高到 LLM 训练方会专门优化这项能力。
五、MCP:工具生态的标准化
5.1 集成爆炸:M×N 问题
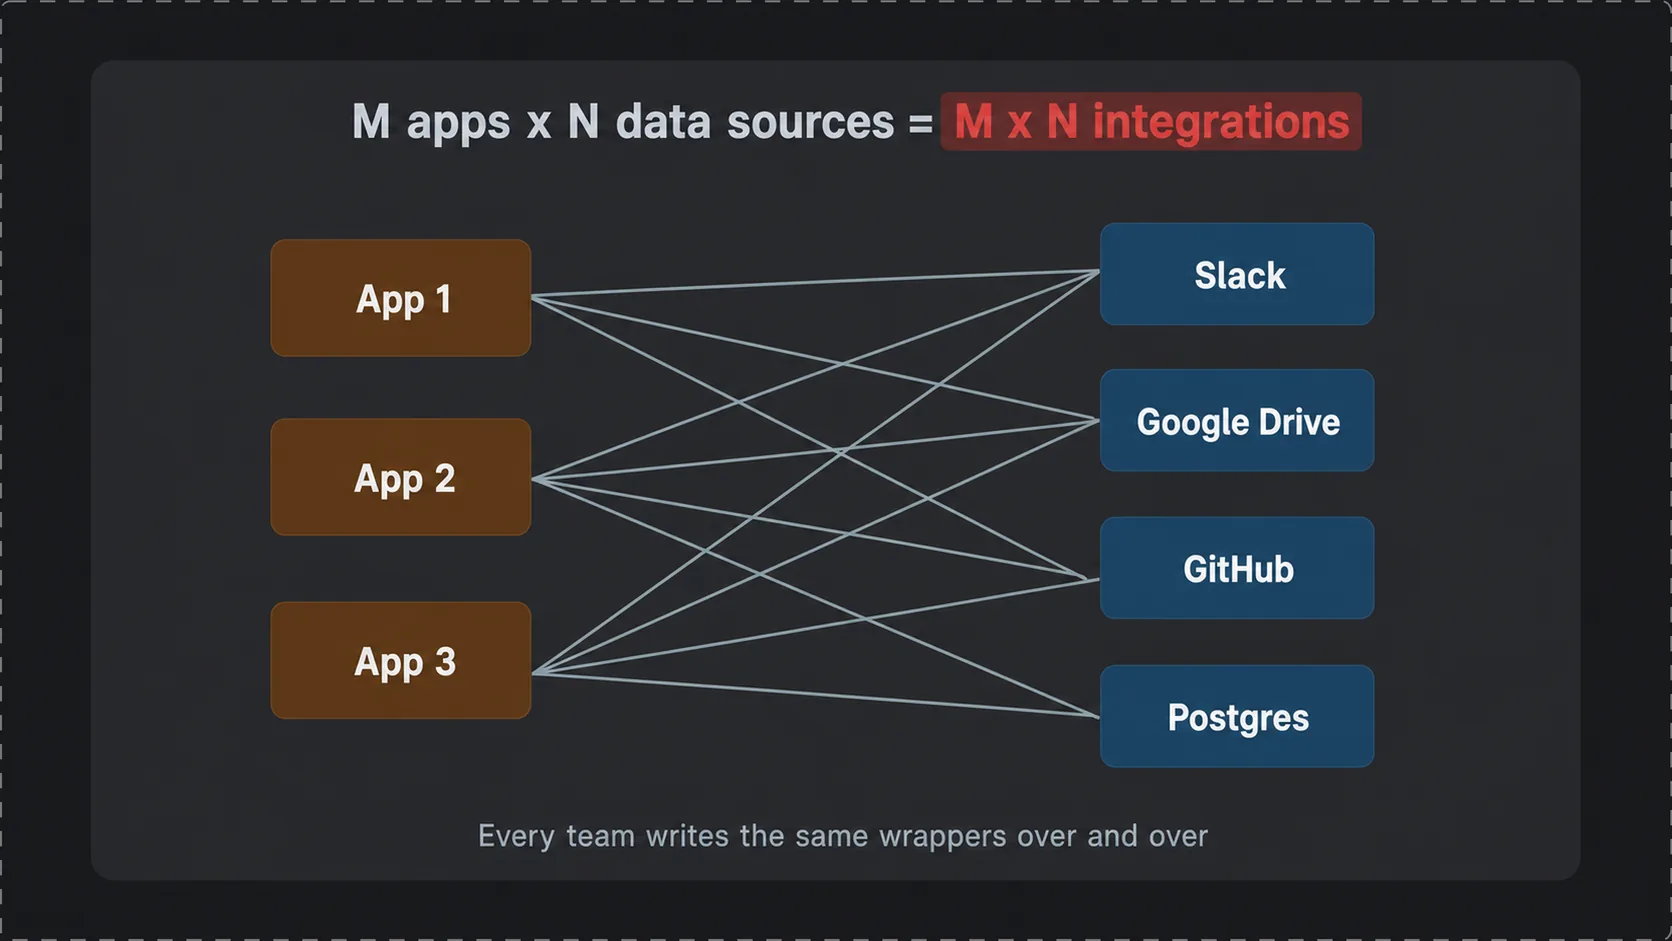
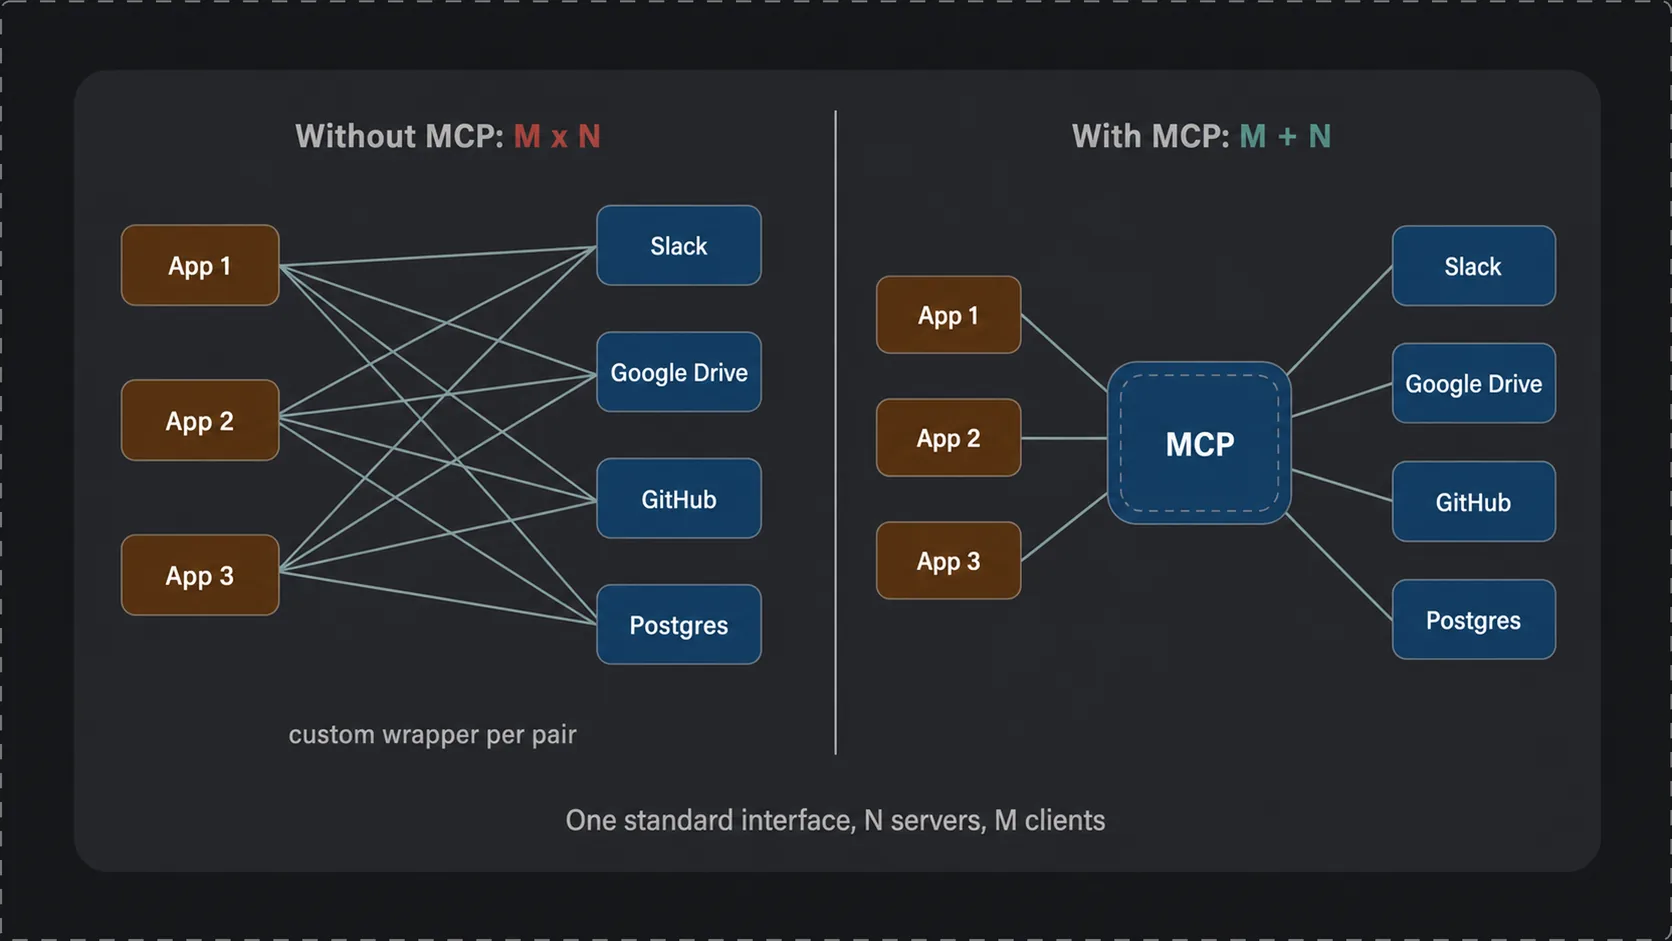
一个应用想接入 Slack、Google Drive、GitHub 和 Postgres,开发者得分别围绕这四家的 API 写包装函数。另一个团队做另一个应用,同样的四份包装再写一遍。M 个应用、N 个数据源,社区总工作量是 M×N,而且绝大部分是重复劳动。
5.2 MCP 的解法:M+N
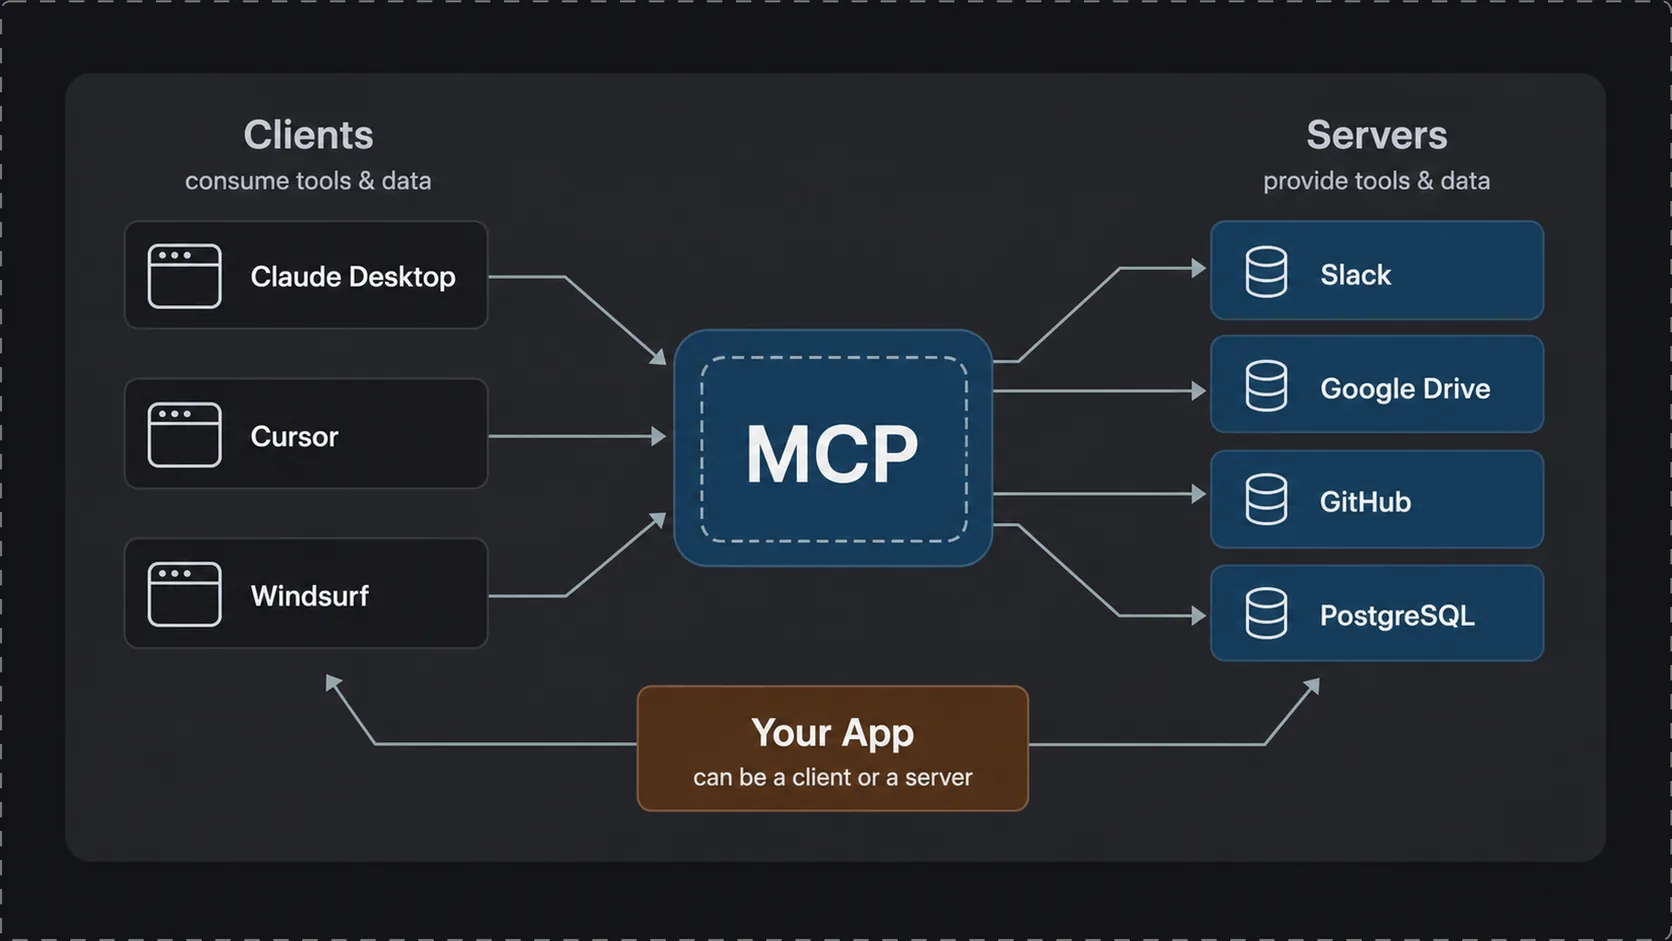
MCP(Model Context Protocol,模型上下文协议)由 Anthropic 提出,现已被许多公司和开发者采用。它定义了应用获取工具和数据源的标准接口,于是社区总工作量从 M×N 降到 M+N:N 个数据源各实现一个 server,M 个应用各实现一次 client 接入。
MCP 的初始设计侧重于「给 LLM 更多上下文」,早期能力多是拉取数据,文档里称之为资源(resources);此外也提供可执行动作的工具(tools)。
5.3 Client 与 Server
client 是想要工具和数据的应用,server 是把数据源或动作包装成标准接口的软件,两边的清单都在快速增长。你自己的应用可以作为 client 去消费别人的 server,也可以反过来做成 server,把资源提供给其他开发者。
5.4 演示:Claude Desktop 接 GitHub MCP Server
课程里的演示用 Claude Desktop 作为 client,连上 GitHub MCP server。
输入「总结这个 GitHub 仓库的 README.markdown」(指向 aisuite 仓库),client 通过 GitHub server 发出请求:从 aisuite 仓库读取 README.markdown。server 返回一大段文件内容,这段内容进入 LLM 的上下文,LLM 据此写出摘要。
接着问「最近的 pull request 有哪些」,同一个 server 换了另一个工具——列出 pull request,请求参数包含仓库名 aisuite、按 updated 排序、取 20 条。返回结果回填后,LLM 写出一段 PR 情况的文字总结。
两次提问的链路完全一样,变的只是 server 端调用了哪个工具。
本文由 AgentPlanFlow 生成