
文章内容
- 一、规划:让智能体自己决定下一步
- 1.1 为什么不能写死每一步
- 1.2 客服智能体:库存表与工具集
- 1.3 三步计划怎么生成
- 1.4 每步怎么执行(回填)
- 二、把计划变成机器可读的 JSON
- 2.1 为什么要 JSON
- 2.2 系统提示怎么改
- 2.3 JSON 计划示例与下游解析
- 三、让计划直接变成代码
- 3.1 为什么代码能表达复杂计划
- 3.2 咖啡机销售表:工具方案 vs 代码方案
- 3.3 两个代码实例
- 3.4 code-as-action 研究结论
- 四、多智能体工作流:单 CPU 与多进程的类比
- 五、多智能体系统的通信模式
- 5.1 组织架构图为什么难
- 5.2 线性计划
- 5.3 经理协调
- 5.4 一对多 vs 多对多
- 六、结论:从规划到多智能体
一张四行的太阳镜库存表,字段是 id / name / description / price / stock。顾客问:「有 100 美元以下、还有货的圆框墨镜吗?」表里没有「圆框」这一列,这个词埋在 description 的自由文本里;有没有货在 stock 列,贵不贵在 price 列。开发者当然可以把「查描述 → 查库存 → 查价格」这三步写死进代码,但下一个顾客问「我上个月退的那副处理好了吗」,写死的流程就接不住了。
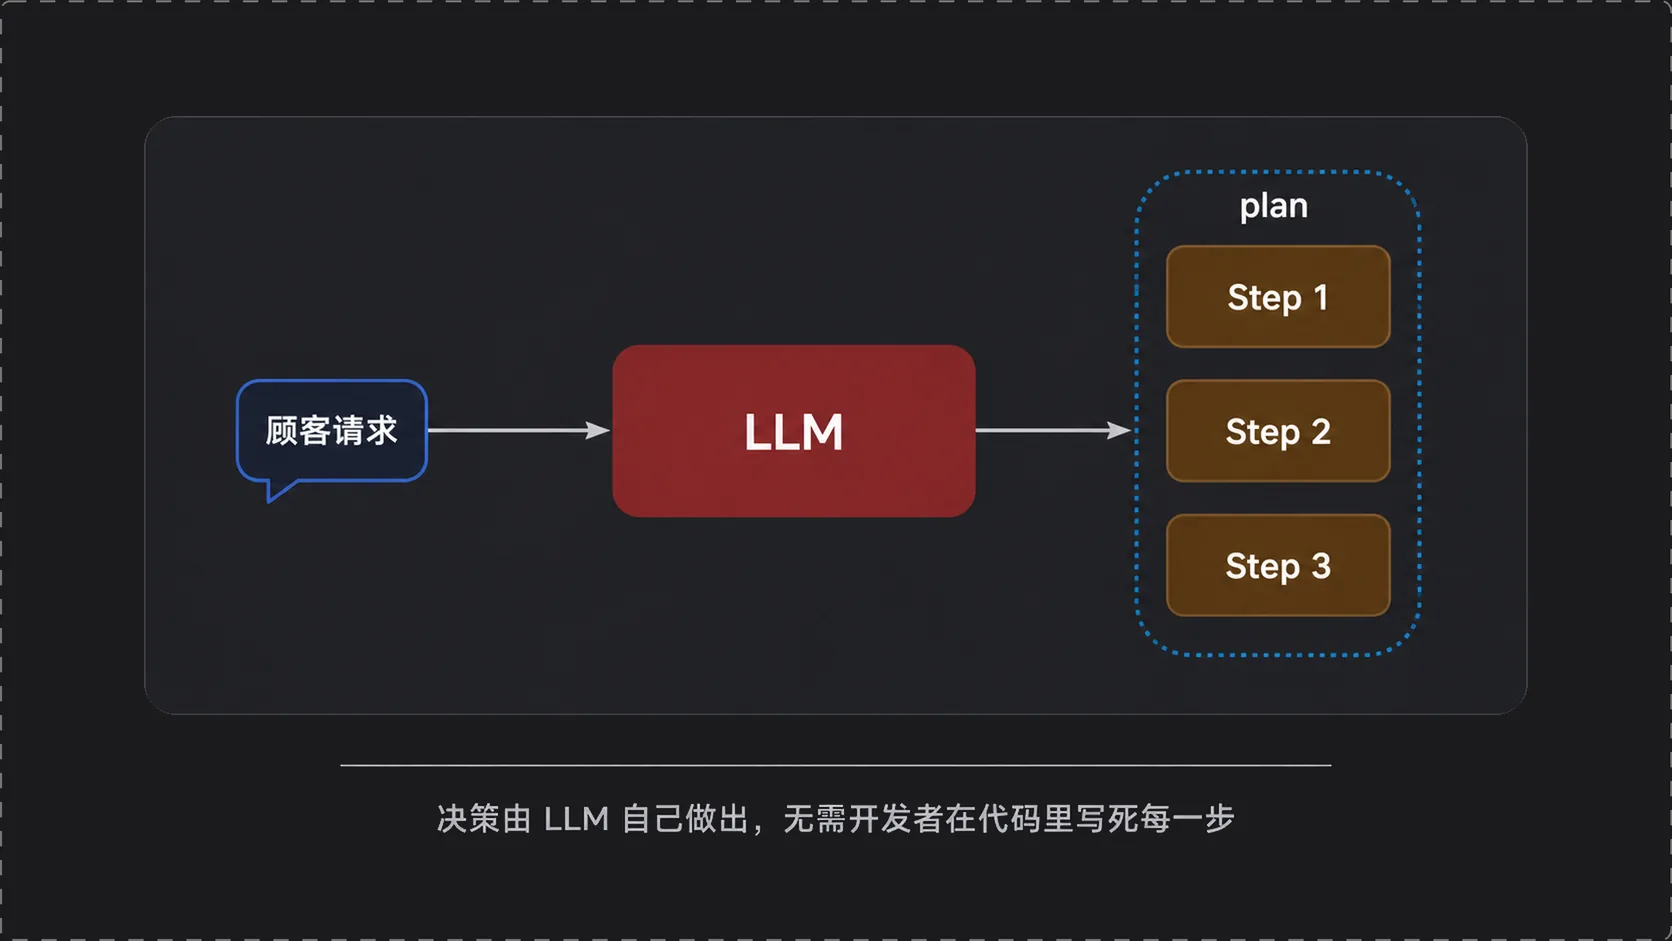
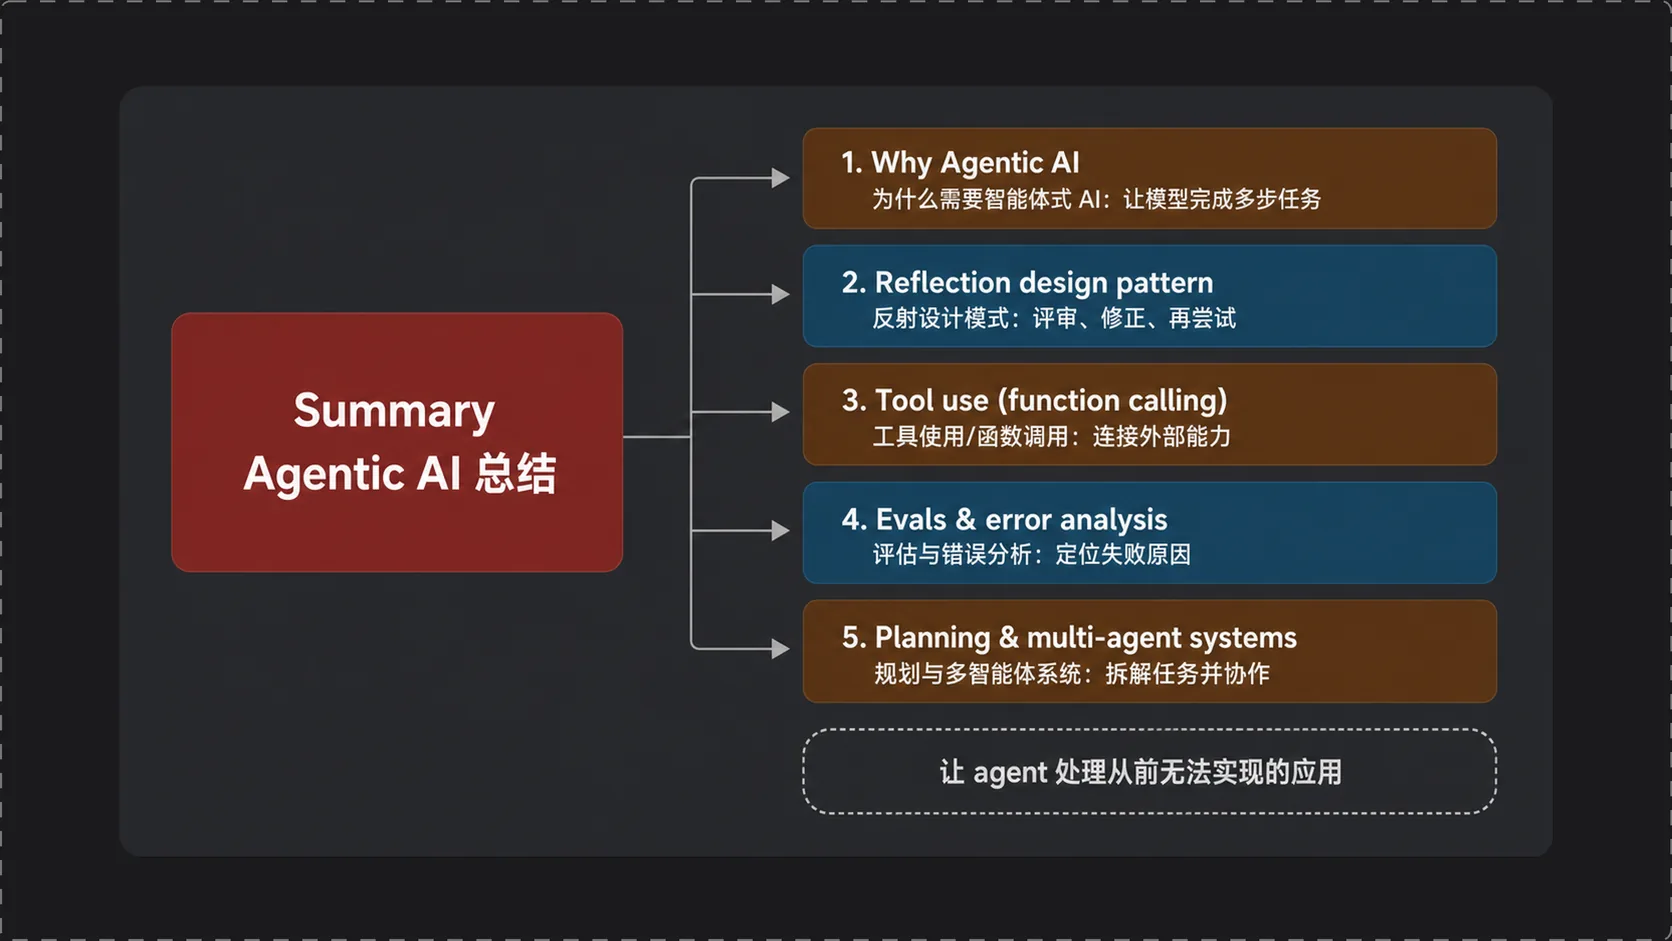
规划工作流换了个做法:把工具清单和用户请求一起交给 LLM,由它输出要走哪几步。这条能力从「LLM 生成一段自然语言的步骤计划」起步,往前走到「计划输出成 JSON 让下游代码解析执行」,再往前是「让 LLM 直接写代码,一段代码装下多步计划」。当单个 agent 的任务单元大到装不下,就拆成多个 agent,这时候要挑的是它们之间的沟通模式。
一、规划:让智能体自己决定下一步
1.1 为什么不能写死每一步
前几个模块里的工作流,形状都是开发者画好的。反射是「生成 → 反思 → 改写」两次调用,工具使用是「判断要不要调工具 → 调 → 把结果喂回去」。步骤序列固定,LLM 负责的是每一步里的内容。
1.2 客服智能体:库存表与工具集
课程用的库存表长这样
| id | name | description | price | stock |
|---|---|---|---|---|
| 1001 | Aviator | Timeless pilot style for any occasion, metal frame | 80 | 12 |
| 1002 | Catseye | Glamorous 1950s profile, plastic frame | 60 | 28 |
| 1003 | Moon | Oversized round style, plastic frame | 120 | 15 |
| 1004 | Classic | Classic round profile, gold frame | 60 | 9 |
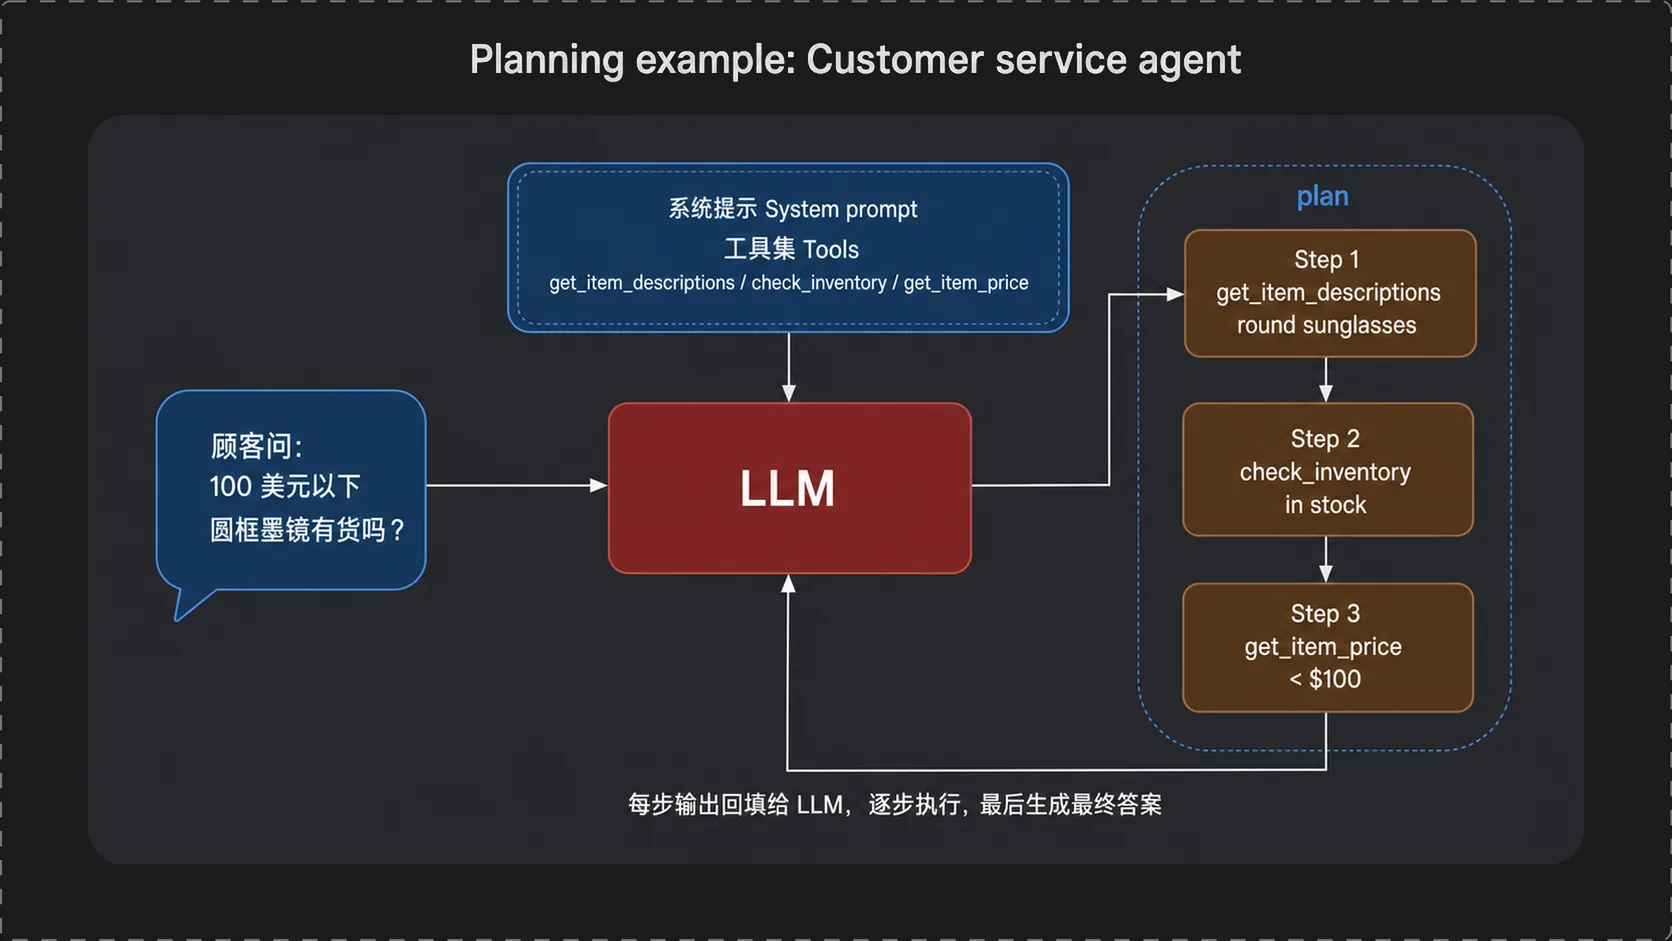
顾客的原话是 Do you have any round sunglasses in stock that are under $100?。「round」这个约束落在 description 的语义上,「in stock」落在 stock 列,「under $100」落在 price 列。三个条件分散在三种不同性质的字段里,没有哪一个工具能一次答完。
agent 手上的六个工具是:get_item_descriptions、check_inventory、get_item_price、check_past_transactions、process_item_return、process_item_sale。前三个是读,后三个是查历史和写操作。
1.3 三步计划怎么生成
系统提示很短:
You have access to the following tools: {description of tools} Return a step-by-step plan to carry out the user's request.工具描述被模板参数 {description of tools} 撑开,用户请求作为一条普通消息接在后面,LLM 的输出是一段带编号的自然语言:
3. Use get_item_price to see if in-stock results are <$100这三步的顺序自带信息量。先按描述筛 round,能把四行缩到 Moon 和 Classic 两行,后面两步只需要处理两条记录;反过来先查价格,就得对全表取价再回头匹配语义。
1.4 每步怎么执行(回填)
计划生成完,执行链路:
Step 1 text→ LLM →get_item_descriptionsStep 1 output, Step 2 text→ LLM →check_inventoryStep 2 output, Step 3 text→ LLM →get_item_price
数一下,这条链路上有 5 次 LLM 调用:1 次生成计划,3 次逐步执行(每次决定这一步该怎么调工具),1 次汇总成给顾客的答复。计划本身是一次性生成的静态文本,执行时按序取用,上一步的输出拼进下一步的输入,上下文单向增长。
放回那张表上走一遍:step 1 返回 Moon 和 Classic,step 2 看到库存 15 和 9(都有货),step 3 拿到价格 120 和 60,最终能给顾客的是 Classic(60 美元,还剩 9 副)。
这里也能看出这套流程的脆弱点:计划在拿到任何真实数据之前就定死了。如果 step 1 一条都没查到,step 2 和 step 3 照样会被执行。
二、把计划变成机器可读的 JSON
2.1 为什么要 JSON
上面那段计划是给人看的英文。下游代码要把「Use check_inventory to see if results are in stock」变成一次真实的函数调用,得从句子里认出函数名、认出参数、认出参数从哪儿来。用正则去抠很快就会碎,再叫一次 LLM 去解析等于多付一次延迟和成本。
课程给的做法是让 LLM 直接吐结构,下游只需要 json.loads 加一次查表分发。
2.2 系统提示怎么改
系统提示在原来那份上加了两句:
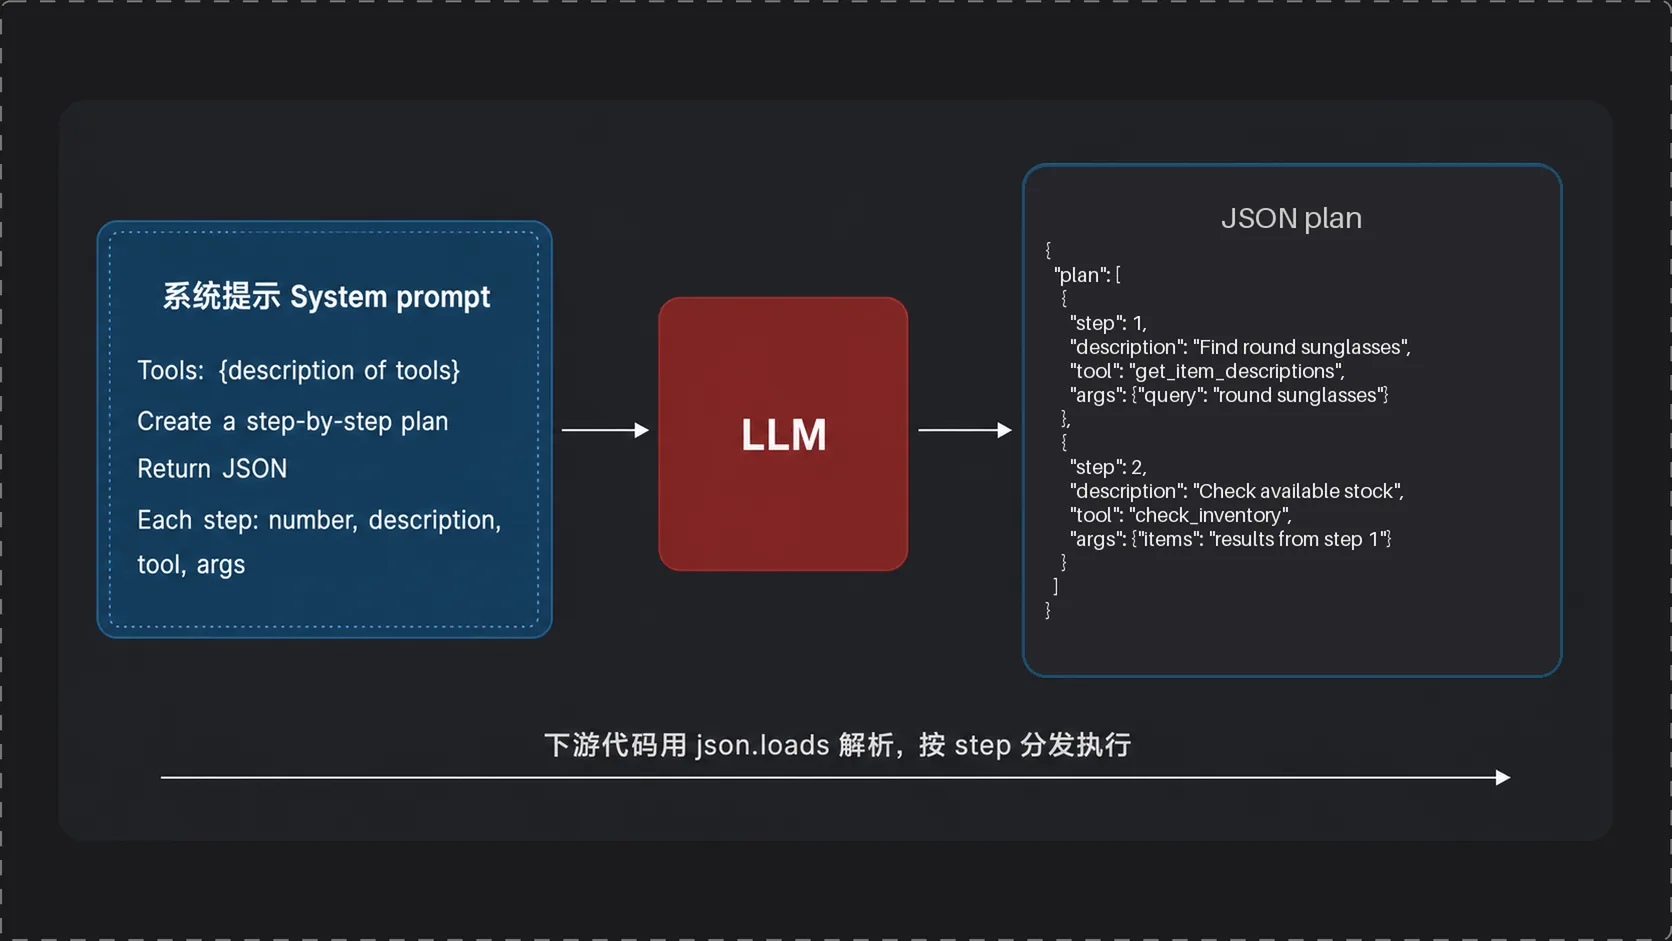
You have access to the following tools: {description of tools} Create a step-by-step plan in JSON format. Each step should have the following items:step number, description, tool name, and args.2.3 JSON 计划示例与下游解析
同一个圆框墨镜请求,输出变成:
{ "plan": [ { "step": 1, "description": "Find round sunglasses", "tool": "get_item_descriptions", "args": {"query": "round sunglasses"} }, { "step": 2, "description": "Check available stock", "tool": "check_inventory", "args": {"items": "results from step 1"} } ]}step 是序号,description 是给人读的意图,tool 是函数名,args 是参数字典。四个字段里,前两个用于日志和排查,后两个是执行器真正执行的东西。
其中 step 2 的 args:{"items": "results from step 1"}。这不是一个值,是一句英文占位符。也就是说,JSON 化解决的是「该调哪个函数」的解析问题,「上一步的输出怎么变成下一步的入参」仍然留在运行时。执行器要么在跑到 step 2 时把 step 1 的返回替换进去,要么像第 1 节那样再叫一次 LLM 来填。
按这个结构,下游分发大致是这个形状:
# 工具名到真实函数的映射表,LLM 只能选到表里有的键TOOLS = {"get_item_descriptions": get_item_descriptions, "check_inventory": check_inventory} # 把模型输出的字符串解析成字典,解析失败就说明这次生成不合格式plan = json.loads(llm_output)["plan"] # 保存每一步的返回值,供后续步骤引用results = {} # 按 step 顺序执行,计划里的顺序就是执行顺序for s in sorted(plan, key=lambda x: x["step"]): # 未知工具名直接判失败,不要让它静默跳过 fn = TOOLS[s["tool"]] # args 里的 "results from step N" 这类占位符在这里被换成真实值 args = resolve_refs(s["args"], results) # 执行并按步号存档,出错时能定位到具体是哪一步 results[s["step"]] = fn(**args)输入是模型输出的字符串,输出是 results 这个按步号索引的字典,状态变化发生在每次 results[s["step"]] = ... 上。这段代码能成立的前提是 tool 字段落在 TOOLS 的键集合里;模型编出一个不存在的函数名时,TOOLS[s["tool"]] 会直接抛 KeyError,这比让它静默跳过好排查。
三、让计划直接变成代码
3.1 为什么代码能表达复杂计划
第 3 节开场就说了:与其让 LLM 一次输出一步 JSON 计划再逐步执行,不如让它写代码,一段代码就装下多步——调这个函数、再调这个函数、再调这个函数。
Python 加上导入的 pandas,内置函数有几百甚至上千个,而这些函数「LLM 见过大量关于何时怎么调用它们的数据」。让它写代码,等于把可选动作从你手写的六七个工具,换成一整个成熟库的函数集合。
3.2 咖啡机销售表:工具方案 vs 代码方案
一个对照例子是一张咖啡机销售表 coffee_sales.csv,列是 date / price / coffee_name / Size(第 3 节关键帧 60759):
| date | price | coffee_name | Size |
|---|---|---|---|
| 2024-01-28 | 3.87 | Hot Chocolate | M |
| 2024-03-01 | 2.89 | Cappuccino | S |
| 2024-03-04 | 3.87 | Latte | M |
| … | … | … | … |
| 2025-03-23 | 4.57 | Latte | L |
配的工具是六个表格算子:get_column_max、get_column_mean、get_column_min、get_column_median、filter_rows、sum_rows。
问「哪个月热巧克力销量最高」,用这套工具能算出来:filter_rows 抽出 1 月的热巧克力交易,做统计,然后 2 月、3 月、4 月、5 月,一路排到 12 月,最后取最大值。
再问「上周有多少笔不重复的交易」,工具就不够用了,于是加一个 get_unique_entries。再问「最近 5 笔交易的金额分别是多少」,可能还得再加两个。
3.3 两个代码实例
换成让 LLM 写代码,系统提示是这样(关键帧 174177 原文):
Write code to solve the user's query.Return your answer as python code delimited with<execute_python> 这对标签的作用是给执行器一个明确的截取边界,模型可以在标签外说话,标签内的内容原样送去执行。
第一个查询是「最近 5 笔交易的金额是多少」:
# 引入 pandas,后面所有表操作都建立在 DataFrame 上import pandas as pd # Load CSV# 把整张交易表读进内存,此时 date 还是字符串df = pd.read_csv("transactions.csv") # Ensure date column is parsed as datetime# 就地把 date 列转成 datetime,否则下一步排序会按字典序而不是时间序df["date"] = pd.to_datetime(df["date"]) # Sort by date to get most recent transactions# 按时间倒序排列,最新的排在最前面df_sorted = df.sort_values(by="date", ascending=False) # Select the last 5 transactions# 倒序之后取前 5 行,也就是时间上最近的 5 笔last_5 = df_sorted.head(5) # Show just the price column (amounts)# 打印一行标题,让输出结果对调用方可读print("Last 5 transaction amounts:")# 把这 5 行的 price 列转成 Python 列表输出print(last_5["price"].to_list())输入是磁盘上的 CSV,输出是标准输出里的一行标题加一个数字列表,中间的状态变化是 df → df(date 列被替换成 datetime)→ df_sorted → last_5。字幕 158s–176s 把这段读成一个五步计划:加载 CSV、确保日期列被正确解析、按日期排序、取最近五笔、只展示价格列。计划以注释的形式写在代码里,执行以函数调用的形式一次完成。
第二个查询是「上周有多少笔不重复的交易」:
# 引入 pandasimport pandas as pd # Read CSV and parse the "date" column as datetime# 读表的同时让 parse_dates 完成日期解析,比读完再转少一步df = pd.read_csv("transactions.csv", parse_dates=["date"]) # Define time window# 取当前时刻作为窗口右端,注意这是运行时的机器时间today = pd.Timestamp.today()# 往前推 7 天作为窗口左端week_ago = today - pd.Timedelta(days=7) # Filter rows where date is within last week# between 默认闭区间,落在两个端点上的记录会被保留last_week = df[df["date"].between(week_ago, today)] # Drop duplicate rows and count# 整行去重后取行数,这就是模型对「不重复交易」的定义print(last_week.drop_duplicates().shape[0])pd.Timestamp.today() 取的是运行时的机器时间,同一段代码在不同日期跑结果不同,做回归测试时要把时间固定住。drop_duplicates() 是整行去重,等于模型把「unique transactions」解释成「四列完全相同即为重复」;如果业务上的定义是按订单号去重,这段代码给出的数字就是错的。语义判断被移到了模型手里,而它写在注释里,可以审查。
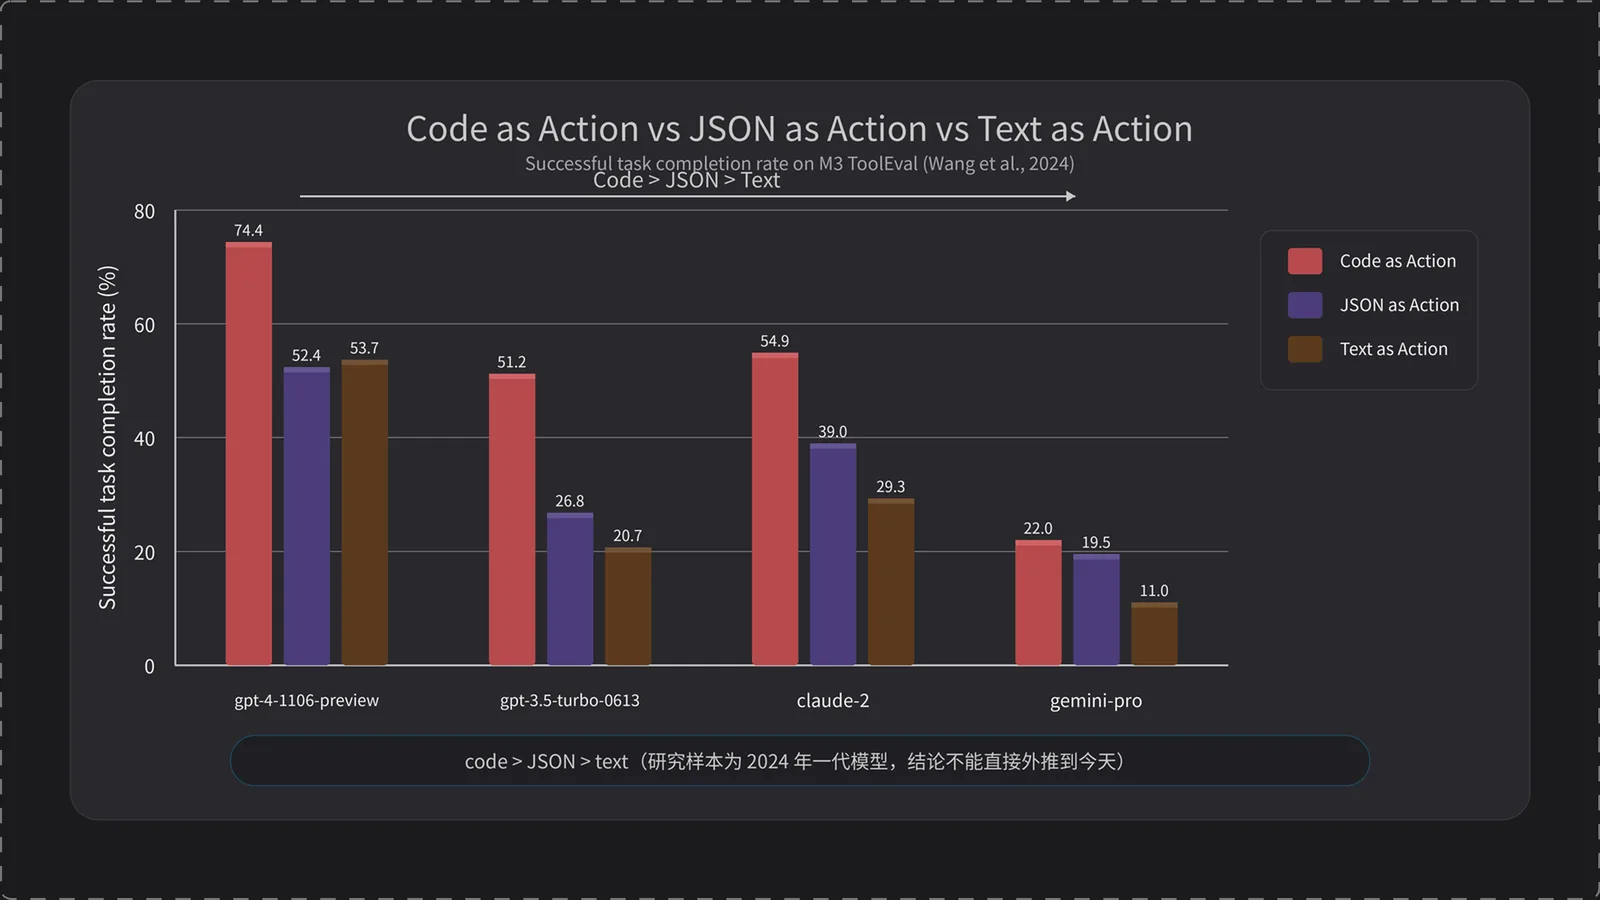
3.4 code-as-action 研究结论
四、多智能体工作流:单 CPU 与多进程的类比
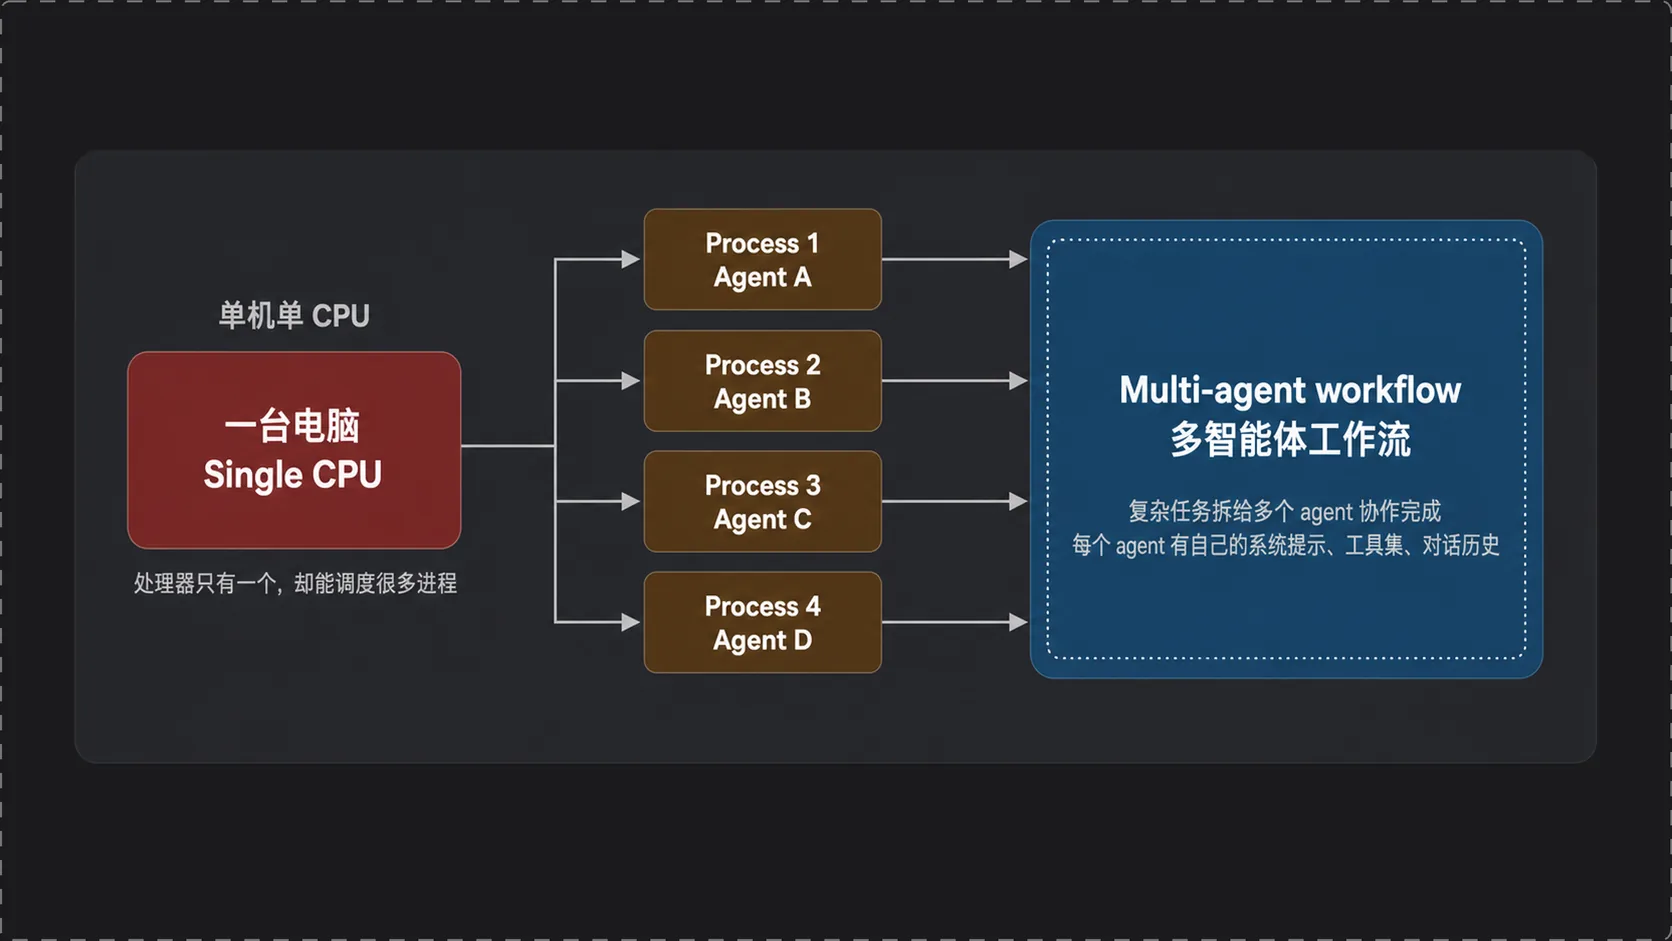
一个 agent 的一次规划扛不下整件事,就把工作拆给多个 agent 协作完成。
假设一台电脑上就一个 CPU,但是可以把工作分解到多个进程上,照样能跑很多进程和很多程序;
多 agent 不会凭空多出算力,模型推理还是那些推理。拆开来的是上下文和职责(每个 agent 有自己的系统提示、自己那份工具集、自己的对话历史)。一个塞了二十个工具、要同时兼顾检索和写作和审校的系统提示,会让模型在每一步都从一堆无关选项里做选择;拆成三个各管一摊的 agent,每个的决策空间都变小了。代价是 agent 之间要传递信息,而传递本身会丢信息。
五、多智能体系统的通信模式
5.1 组织架构图为什么难
难在这里没有单一正确答案:几个 agent、谁向谁汇报、谁能看到谁的输出、信息在哪一层汇总,每一项都是设计参数,组合起来空间很大,而且改动的影响要跑完整条链路才看得出来。
5.2 线性计划
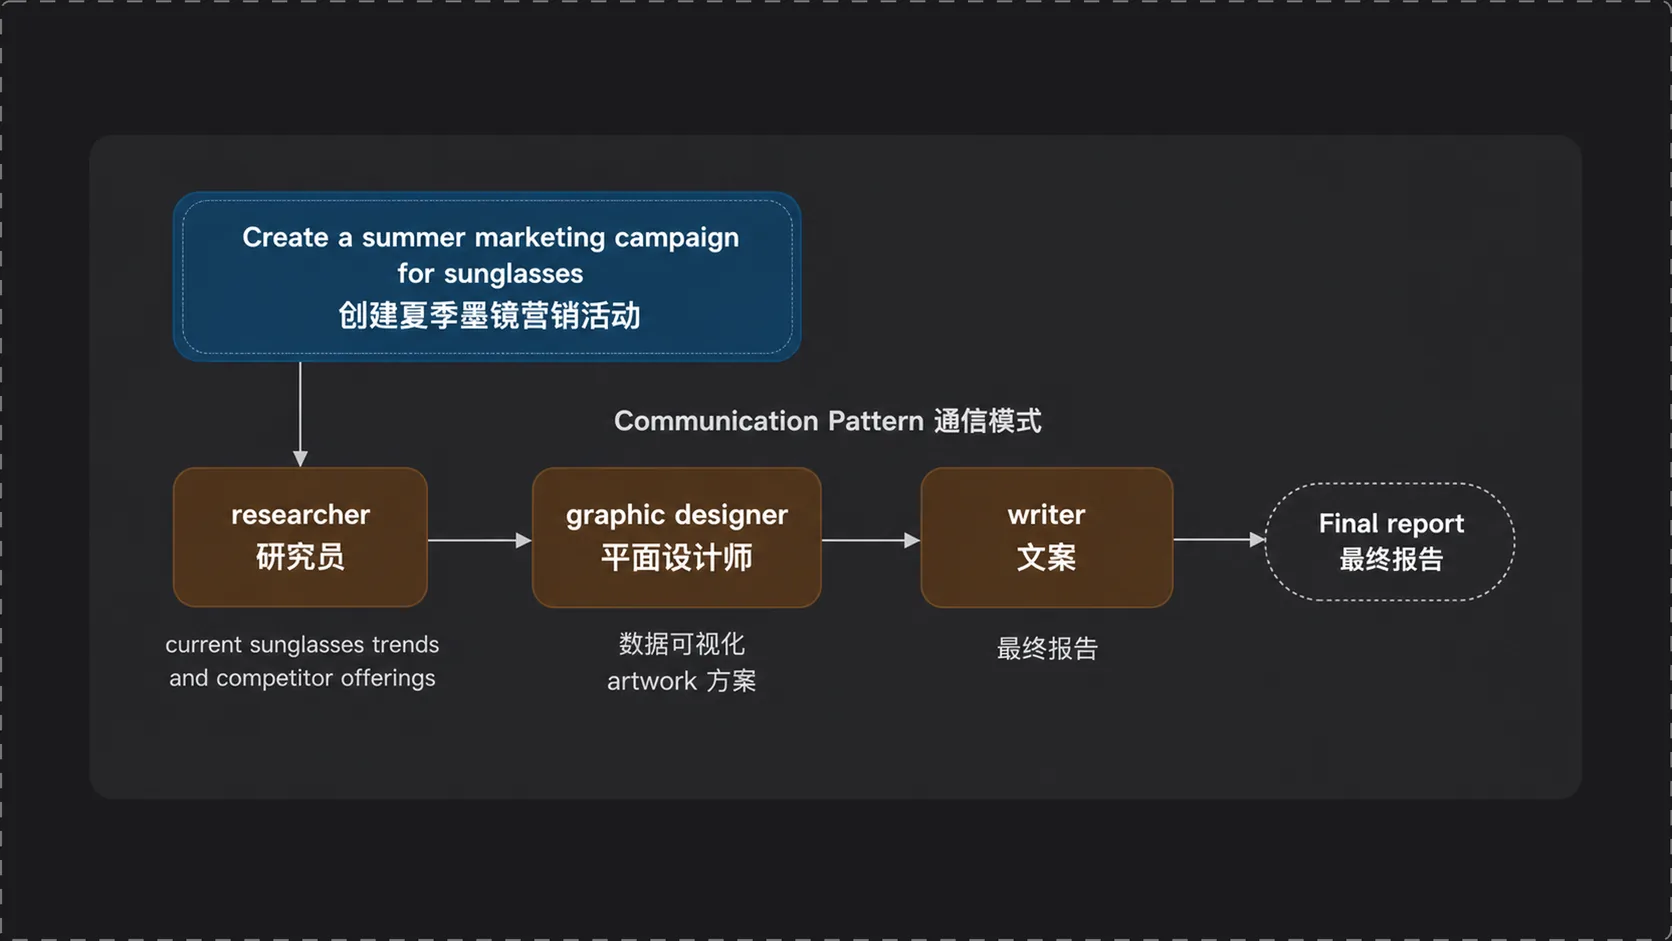
简单示例:「为太阳镜做一场夏季营销活动」
Create a summer marketing campaign for sunglasses ↓ researcher ↓ research │ "Here are current sunglasses trends and competitor offerings…" graphic designer ↓ research, visualizations, artworks │ "Here are 5 data visualizations and 5 artwork options for the report…" writer ↓ Final report每个 agent 只跟下一个说话,中间产物是明确的交付物(一份调研、五张图表加五个视觉方案、一份最终报告)。这种形状的好处是排查方便:报告有问题,倒着看三份交付物就能定位到是哪一环。
5.3 经理协调
第二种形状加了一个 marketing manager角色:
You are a marketing manager and have the following team of agents to work with: {description of agents} Return a step-by-step plan to carry out the user's request.对照第一节那份 You have access to the following tools: {description of tools},改动的位置是把 Tools 换成了 Agents。经理输出的计划也还是那个带编号的形状:
1. Ask researcher to research current sunglasses trends2. Ask graphic designer to ...3. Ask writer to create report4. Review report执行链路同样是 Step 1 text → researcher、Step 1 output, Step 2 text → graphic designer、Step 3 text → writer。
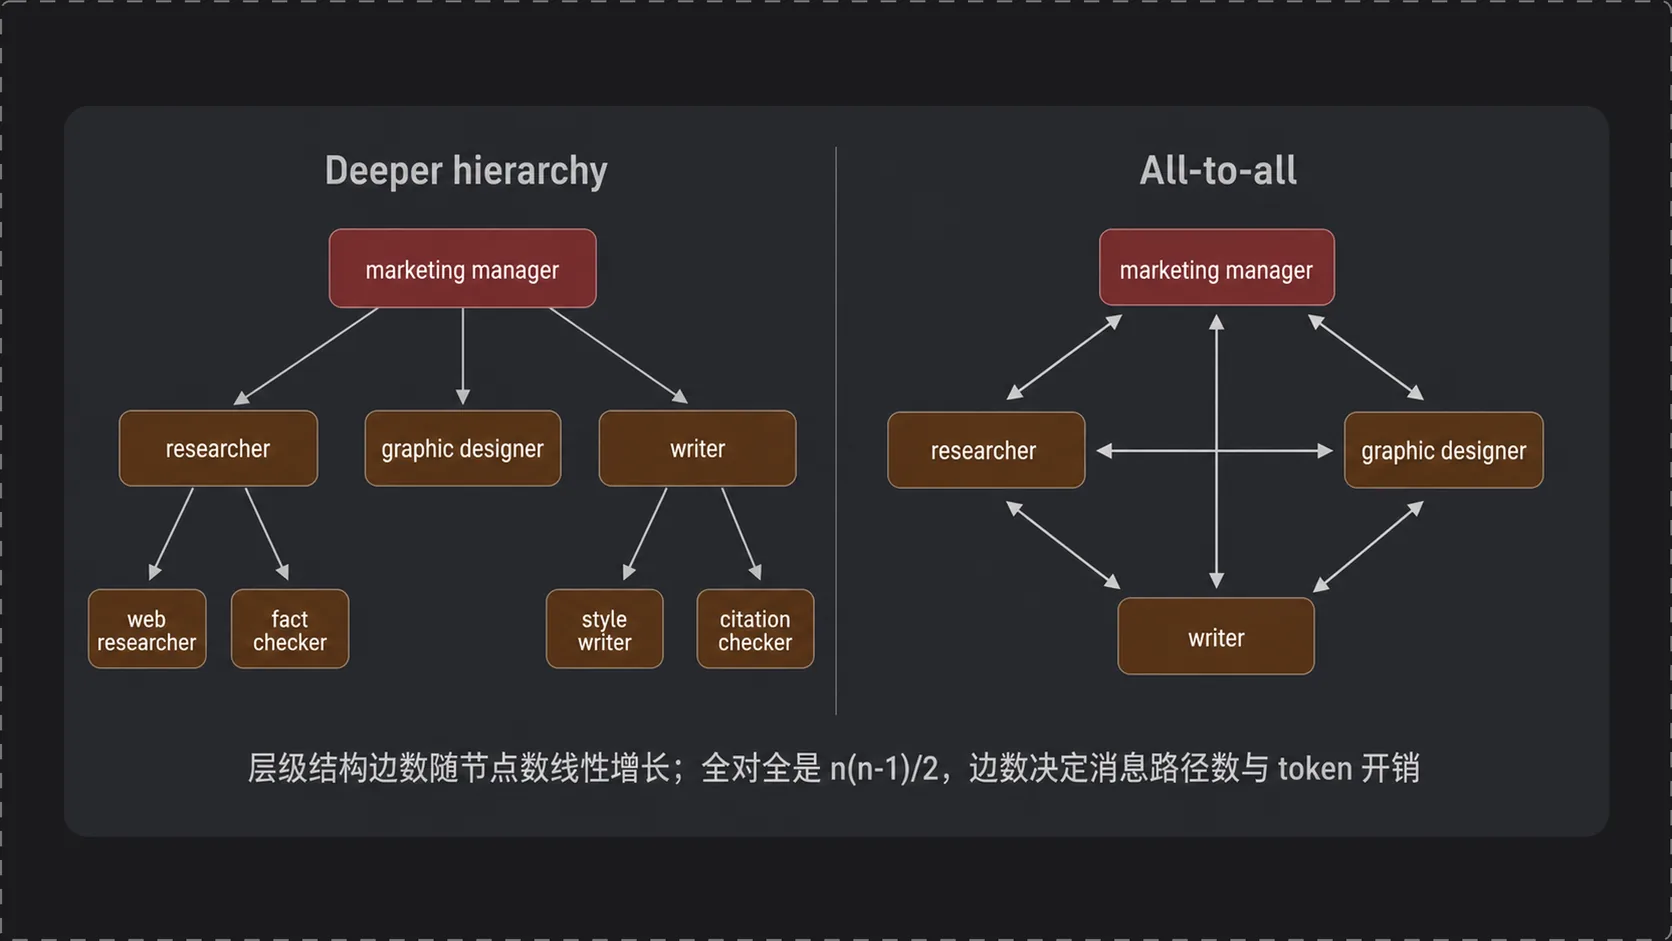
marketing manager 与 researcher、graphic designer、writer 各有一条双向连线,三个下属之间没有连线。所有信息都经过经理中转,这种层级结构是规划通信模式的常见做法。
于是「规划」和「多智能体」在这里合上了:多 agent 系统的经理,做的就是第一节那件事,把工具调用换成了 agent 调用。
5.4 一对多 vs 多对多
Deeper hierarchy:marketing manager 下面还是 researcher、graphic designer、writer 三个,但其中两个再往下带子 agent——researcher 下面挂 web researcher 和 fact checker,writer 下面挂 style writer 和 citation checker,graphic designer 这一支图上没有再分(画面如此)。层级从两层变成三层,每个叶子节点的职责窄到可以用一句话说清。
All-to-all:marketing manager、researcher、graphic designer、writer 四个节点两两之间都有双向箭头,没有中心。
这两种形状的差别在连接数上:层级结构里边数随节点数线性增长,All-to-all是 n(n−1)/2。边数决定了消息路径数,也就决定了 token 开销和你要排查的组合数。这大概也解释了为什么All-to-all「不常用」。
六、结论:从规划到多智能体
回到开头那个问题:一个高度自主的 agent 怎么决定自己下一步做什么?它把工具清单和请求交给 LLM,拿回一份步骤计划,然后按序执行、逐步回填。这份计划可以是自然语言(好读,难解析)、JSON(好解析,参数传递仍要运行时处理)、或者一段代码(表达力最强,需要沙箱)。任务大到一个 agent 的一次规划装不下,就拆成多个 agent,此时要定的是通信图:能用线性就别上全对全,能让一个经理中转就别让四个节点互相喊话。
本文由 AgentWorkFlow 生成