
我第一次接触 LiveData 的时候,觉得它非常惊艳。在那个时代,Android 开发充满了 Callback、生命周期问题、内存泄漏风险。LiveData 让 Android 开发第一次拥有了一个和生命周期结合的数据观察方案。那时候我觉得:LiveData 真的好棒,简单好用。
但是几年之后,我越来越少使用 LiveData。现在的新项目里,我基本不会主动选择 LiveData,而更多使用 Kotlin Flow。这是因为随着 Android 应用复杂度提升,LiveData 本身的一些设计限制越来越明显。
一、刚出道的 LiveData,为什么让我觉得惊艳?
在 LiveData 出现之前,Android 异步开发大量依靠 Callback:
api.getUser(new Callback<User>() { @Override public void onSuccess(User user) { textView.setText(user.name); }});看起来简单,但隐藏大量问题。
1.1 生命周期问题
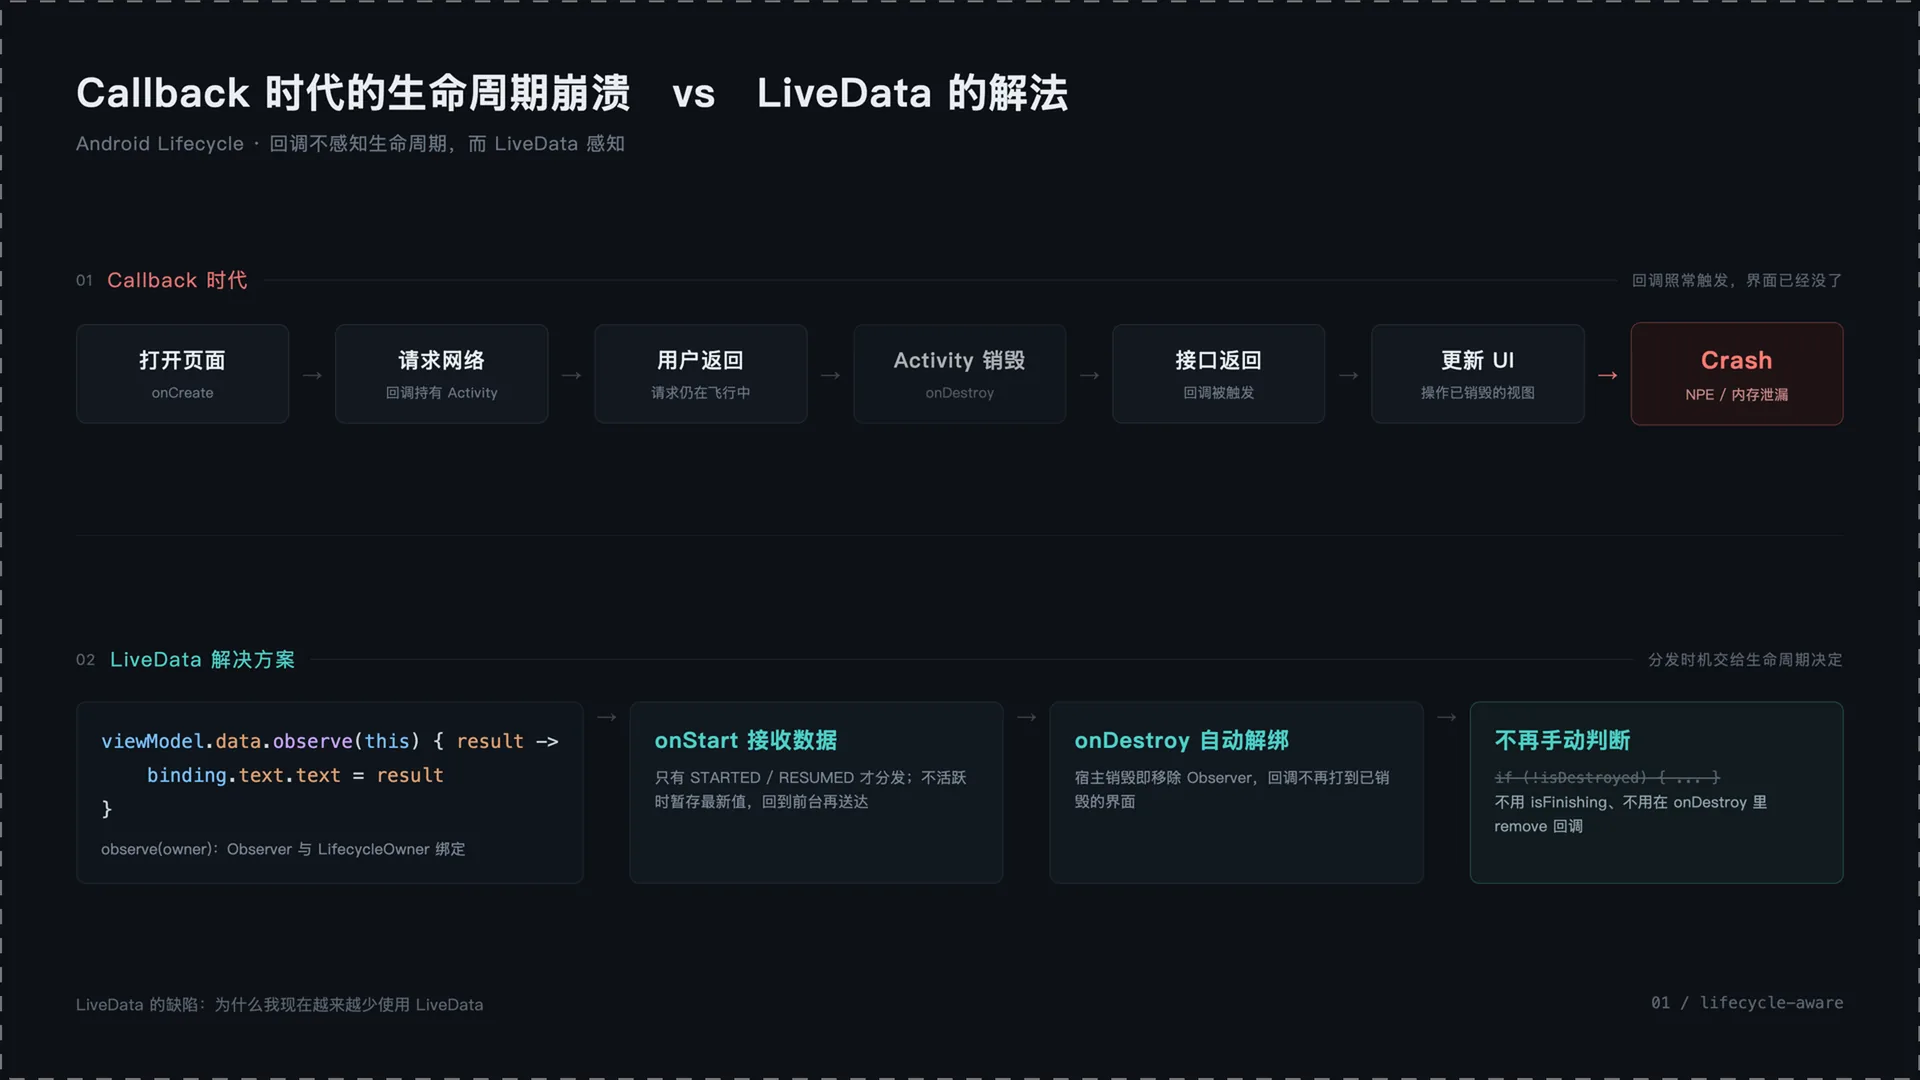
打开页面 → 请求网络 → 用户返回 → Activity 销毁 → 接口返回 → 更新 UI → Crash。开发者需要自己写 if (!activity.isDestroyed()) 判断,代码中充斥着大量生命周期检查。
1.2 数据和 UI 强绑定
请求成功 → Callback → 修改 UI,业务代码和 UI 更新混在一起。
LiveData 出现后:
viewModel.user.observe(this) { name.text = it.name }突然变得非常自然。它解决了生命周期自动管理、自动取消观察、数据变化自动通知 UI 三个问题。在当时,这是非常大的进步。
二、LiveData 最大的价值:生命周期感知的数据观察
LiveData 最大的设计在于 observe(owner)。它知道 Activity 的 STARTED、RESUMED、DESTROYED 状态。onStart 开始接收数据,onDestroy 自动解绑。开发者不用再手动处理取消监听、防止内存泄漏、判断页面状态。
三、LiveData 的第一个限制:它不是一个真正的数据流
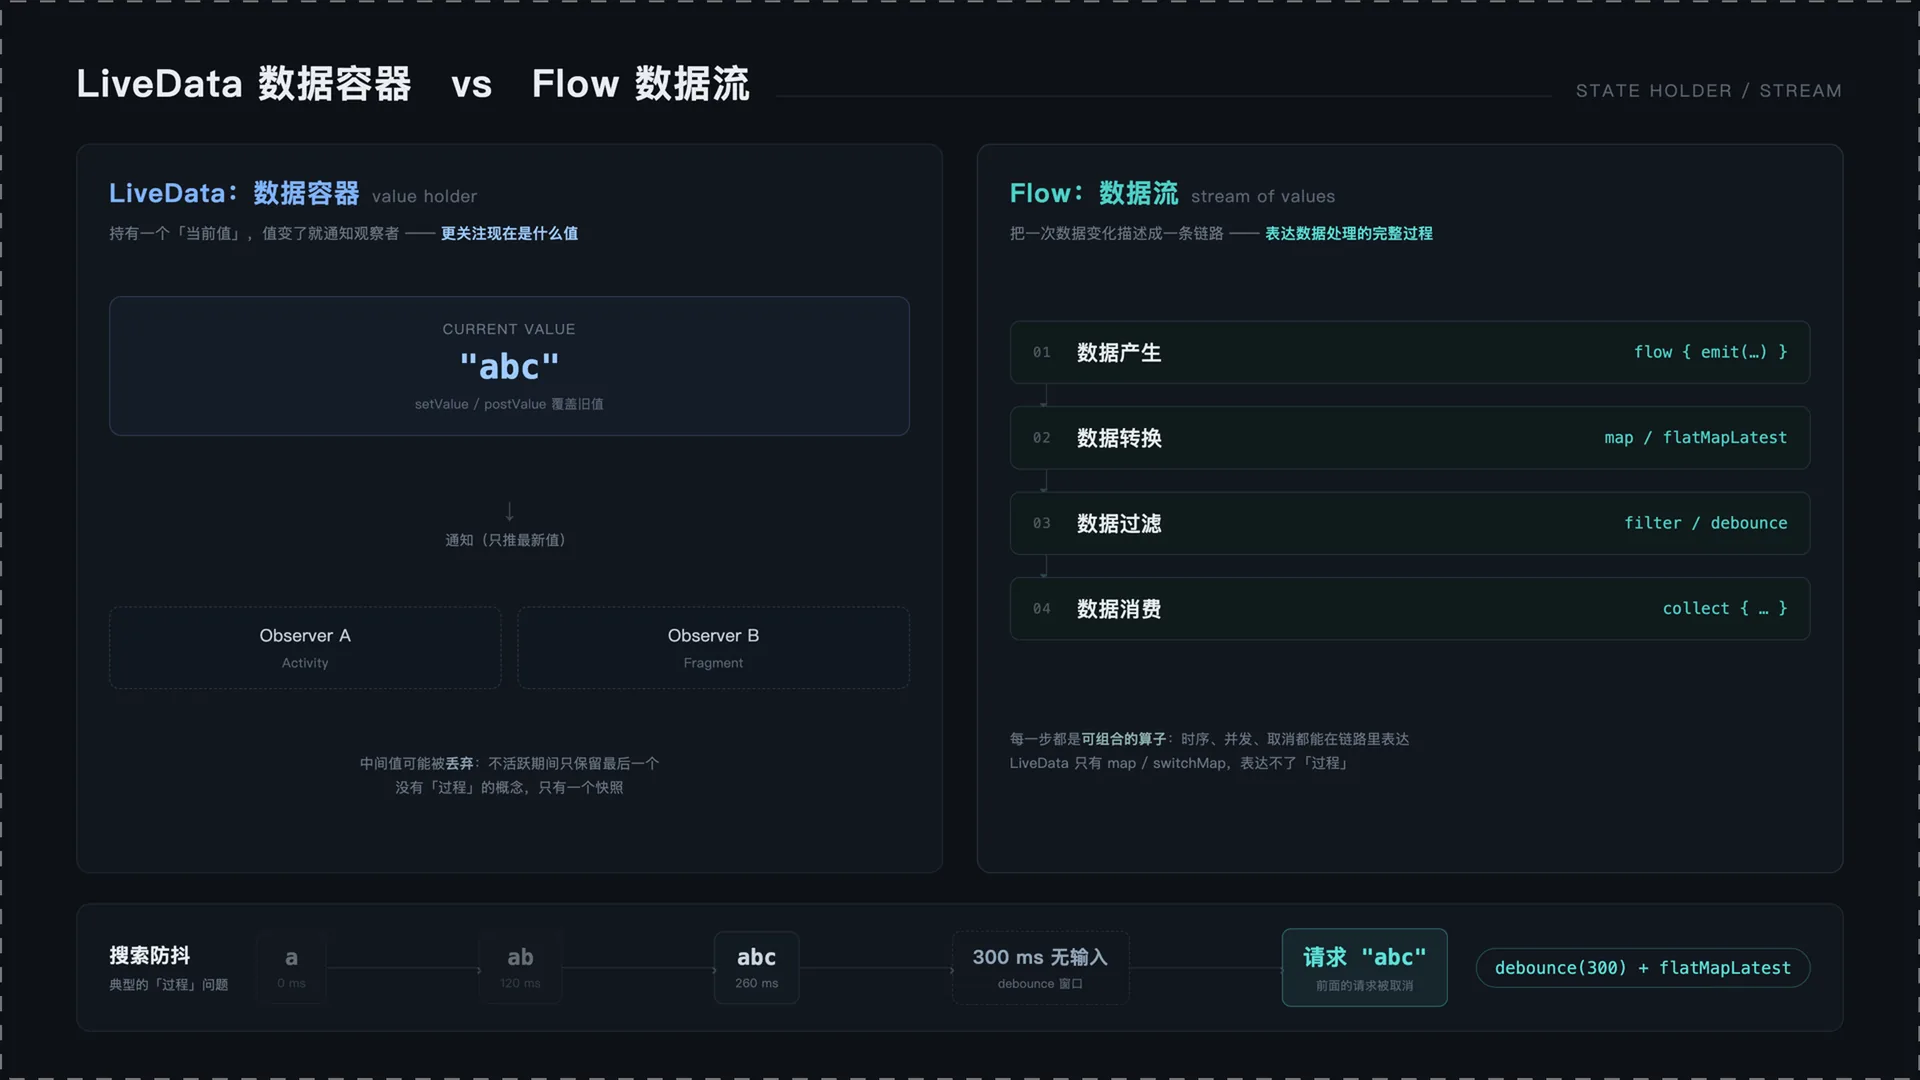
这是 LiveData 最大的问题之一。MutableLiveData<User>() 更像一个可以被观察的数据容器——保存当前值,然后通知观察者。但现代应用的很多场景,本质是数据流。
以搜索为例,用户输入 a → ab → abc,希望 300ms 没有输入就请求:
queryFlow .debounce(300) .flatMapLatest { search(it) }非常自然。因为 Flow 表达的是"数据产生 → 数据转换 → 数据过滤 → 数据消费"的完整链路,而 LiveData 更关注"现在是什么值"。
四、LiveData 缺少完整的数据流处理能力
现代应用大量需要 map、filter、combine、debounce、retry、catch、flatMapLatest。这些都是 Flow 的核心能力。LiveData 虽然有 Transformations.map() 和 Transformations.switchMap(),但能力有限。
当需要组合用户信息 + 配置 + 网络状态 + 权限状态时,LiveData 通常使用 MediatorLiveData 手动管理多个数据源,代码容易越来越复杂。
五、LiveData 的第二个限制:它不适合作为 Data 层的数据类型
早期很多项目在 Repository 中返回 LiveData:fun getUser(): LiveData<User>。当时觉得很方便,但问题在于 LiveData 属于 androidx.lifecycle.LiveData,本质是 Android 生命周期组件。
数据层关注的是数据怎么产生、数据怎么变化,而不是 Activity 有没有显示、Fragment 有没有销毁。但 LiveData 天生关注 LifecycleOwner。这意味着数据层开始知道 Android 生命周期模型。
数据库查询 @Query("select * from user") fun observeUser(): LiveData<User> 看起来很好,但如果后台 Service 需要用户数据,或者 Worker 需要监听数据,它们没有 LifecycleOwner。于是出现各种 asFlow() 转换。如果数据源一开始就是 Flow,这些问题不存在。
六、LiveData 会限制数据的消费方式
Repository 返回 LiveData<Message>,UI 层用 observe() 没问题,但后台 Coroutine 更希望 collect()。LiveData 的设计目标就是 Observer,数据生产者决定了消费者模式。
而 Flow 返回 Flow<Message>,消费者自己决定:UI 用 collectAsState(),后台用 collect(),测试用 first()。同一个数据源,不同消费方式。
七、LiveData 对事件处理一直比较尴尬
经典问题:一次性事件。loginSuccess.value = true,页面 observe 后弹出 Toast。旋转屏幕时 LiveData 会重新发送 true,Toast 又出现一次。
于是出现 SingleLiveEvent 和 EventWrapper 这些 workaround。这正说明 LiveData 更适合"状态"而非"事件流"——事件是点击一次、发送一次、消费一次,状态是"当前是什么",两者语义不同。
八、LiveData 的线程模型比较简单
setValue() 在主线程,postValue() 用于后台。但 postValue(1); postValue(2); postValue(3) 最终可能只收到 3。因为 LiveData 的目标是保存最新状态,不是消息队列。但很多场景需要处理每一个事件——下载进度、消息通知、操作事件——LiveData 并不适合。
九、LiveData 和 Kotlin 协程结合,不如 Flow 自然
现在 Android 主流是 Coroutine + Flow。但 LiveData 通常这样用:
viewModelScope.launch { val result = repository.getUser() liveData.value = result}中间是 Coroutine → LiveData → Observer,多了一层。而 Flow 天然连接:
viewModelScope.launch { repository.user().collect {}}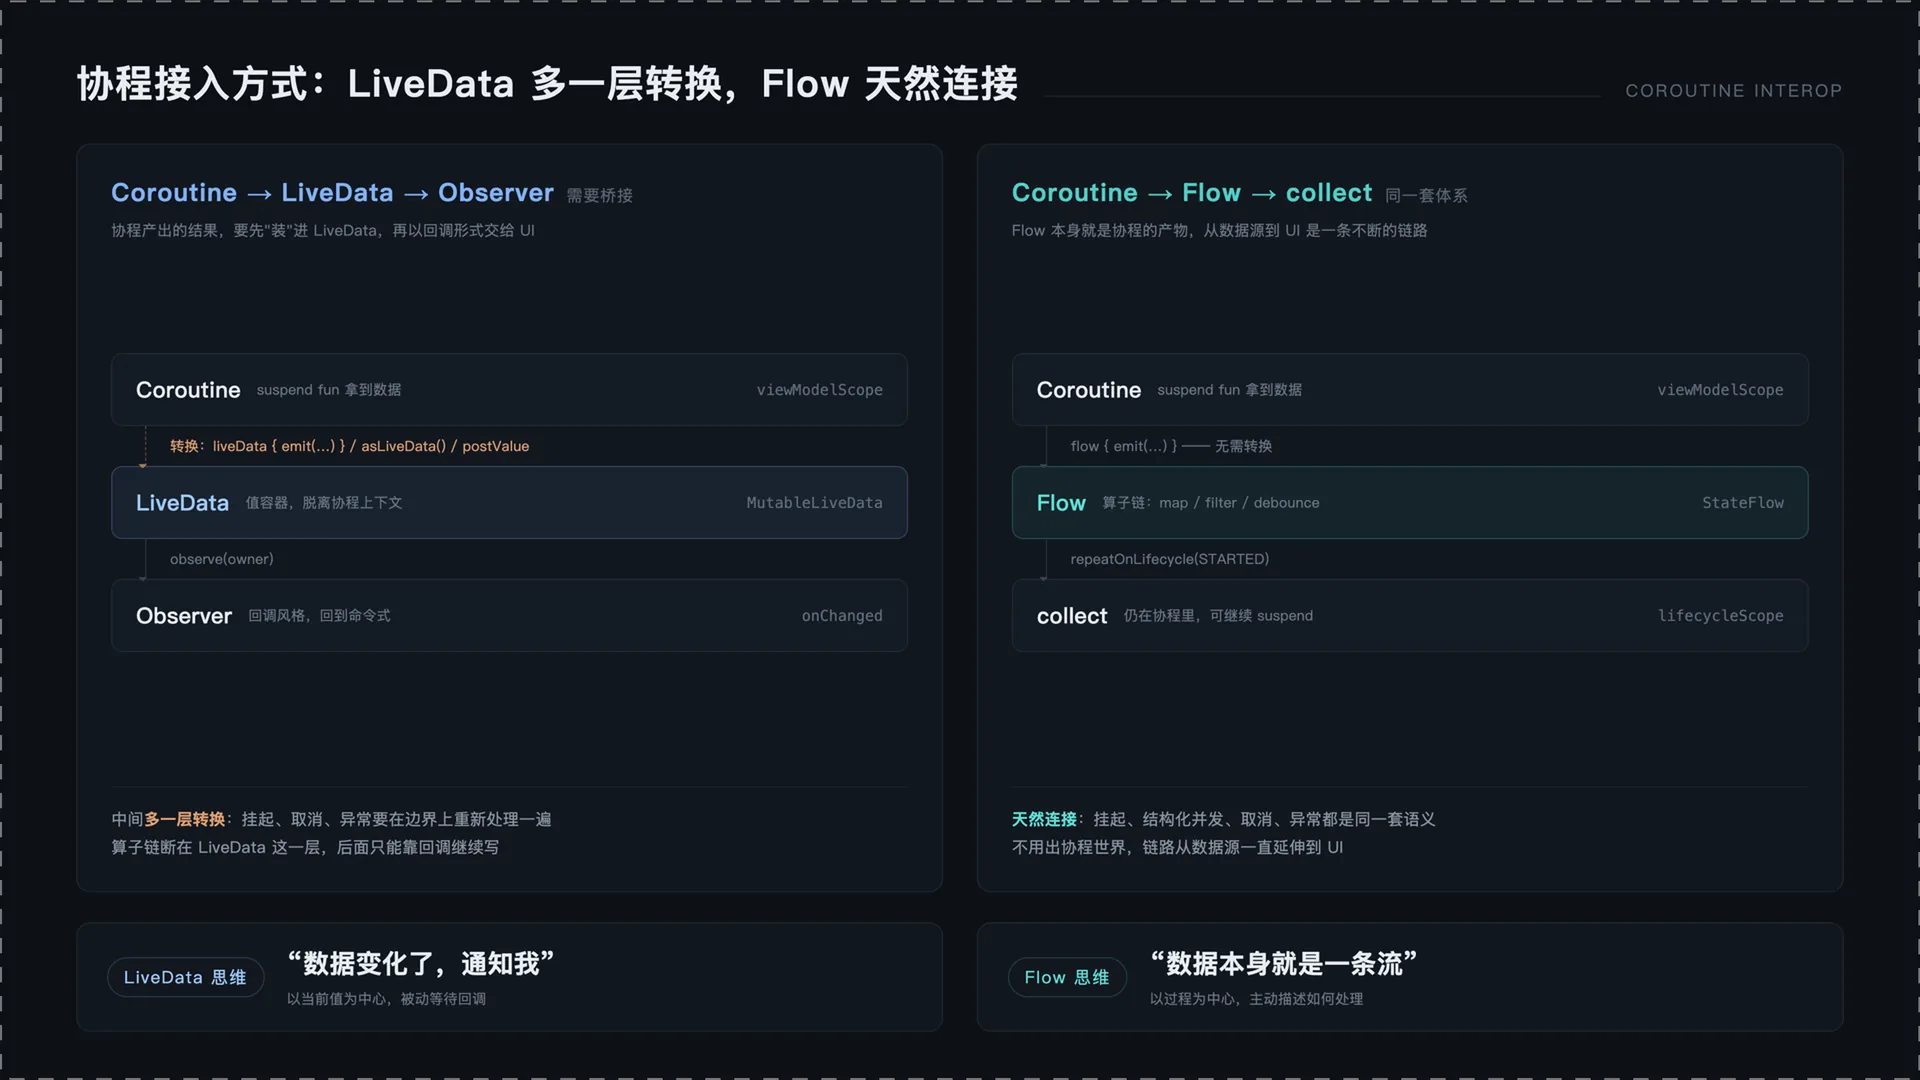
十、LiveData 最大的问题:简单很好,复杂容易失控
简单页面中 val loading = MutableLiveData<Boolean>() 非常舒服。但复杂页面中 UserLiveData + ConfigLiveData + NetworkLiveData + PermissionLiveData,最后变成 MediatorLiveData + Transformations + Event 包装 + 各种工具类,越来越像自己实现一个数据流框架。
十一、LiveData 和 Flow,本质区别是什么?
LiveData 是一个生命周期感知的数据容器——"数据变化了,通知我"。Flow 是一个可以被组合、转换、取消的数据流——"数据本身就是流,我要处理这个流"。
总结
LiveData 没有错,它是 Android 架构发展过程中非常重要的一环,解决了生命周期安全的数据观察。但它也有明显限制:不是完整的数据流模型、数据组合能力有限、不适合作为 Data 层的数据类型、和协程结合不够自然、对事件处理存在天然缺陷。
最终结论:LiveData 适合 UI 层,但不应该成为整个应用的数据传递模型。
转载:https://mp.weixin.qq.com/s/JfAV7TrBCNFfyaHers_iXA
本文由 AgentPlanFlow 生成