
文章内容
网上自注意力的讲解大多停在「让每个词看到句子里的其他词」这句比喻上。要真正搞清楚这一层在干什么,得回答四个具体问题:Q、K、V 三个矩阵从哪来,分数怎么算出来,为什么要除一个 √d_k,softmax 之后拿到的东西代表什么。
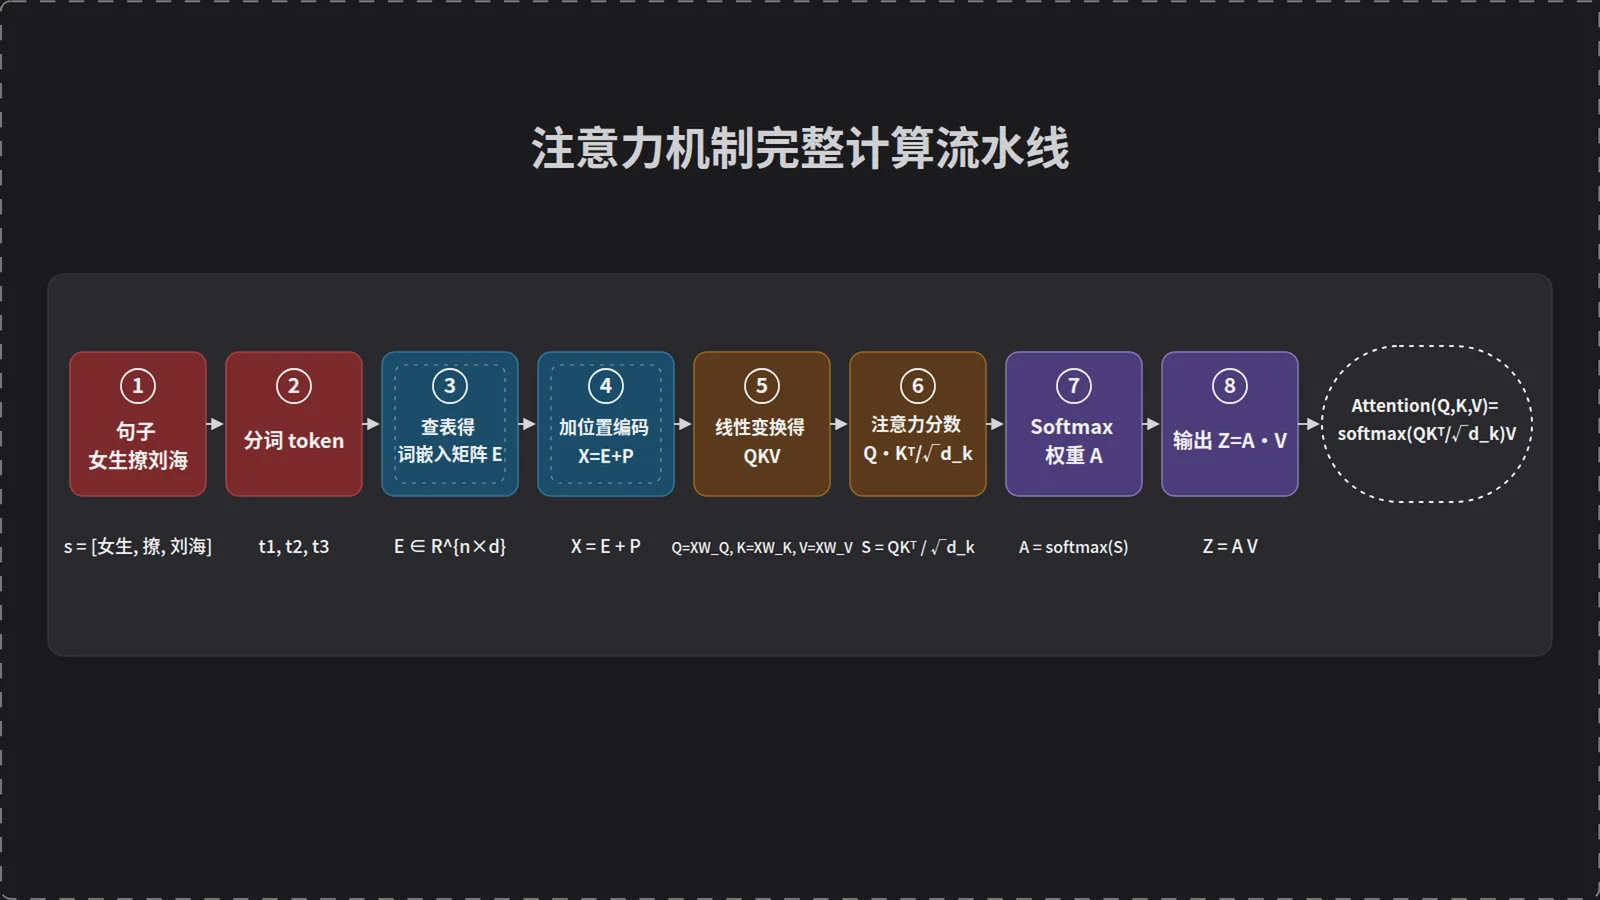
拿「女生撩刘海」这三个 token 为例,把向量维度压到 2,从查表拿到词向量,到最后算出输出矩阵 Z,整条链路一路算到底。
一、一个句子怎么变成矩阵
句子进注意力层之前,先变成一个 3×2 的实数矩阵,行是 token,列是维度。
1.1 分词与 ID 化
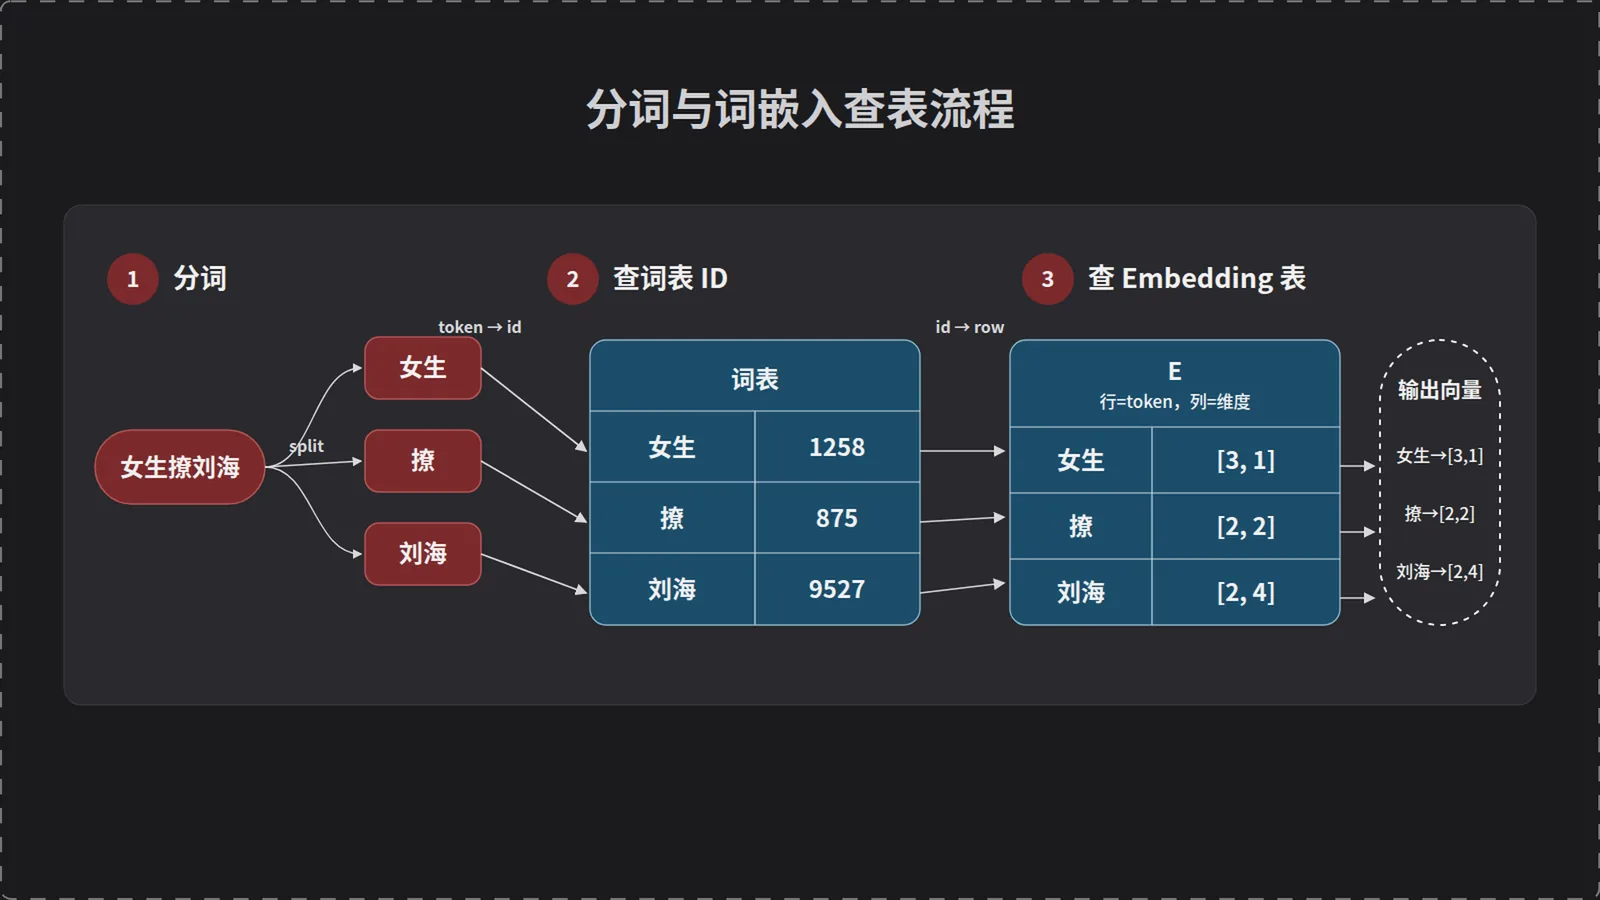
分词器把「女生撩刘海」切成三个 token:女生、撩、刘海。每个 token 在词表里有一个固定编号,这里假设是 1258、875、9527。
编号本身不带语义。9527 不比 875「大」,它只是查表用的行号。
1.2 查表得词嵌入矩阵 E
模型里存着一张完整的词嵌入表,下面叫 EmbeddingTable。它的行数等于词表大小,列数等于模型维度。训练开始前这张表是随机数,训练过程中它跟着梯度一起更新——语义就是在这个过程里长出来的。
拿三个 ID 去查表,各取出一行:
女生 → EmbeddingTable[1258] = [3, 1]撩 → EmbeddingTable[875] = [2, 2]刘海 → EmbeddingTable[9527] = [2, 4]按句子顺序把这三行摞起来,才得到当前句子的词嵌入矩阵 E:
E = [EmbeddingTable[1258] ← 女生 EmbeddingTable[875] ← 撩 EmbeddingTable[9527]] ← 刘海 = [[3, 1] ← 女生 [2, 2] ← 撩 [2, 4]] ← 刘海注意,EmbeddingTable 是整张大表,E 只是当前句子查出来的 3×2 小矩阵。真实模型这里是几千维的小数,本文的两维整数只是为了做手算示例,不代表词表行号本身。
二、位置编码:补上先后顺序
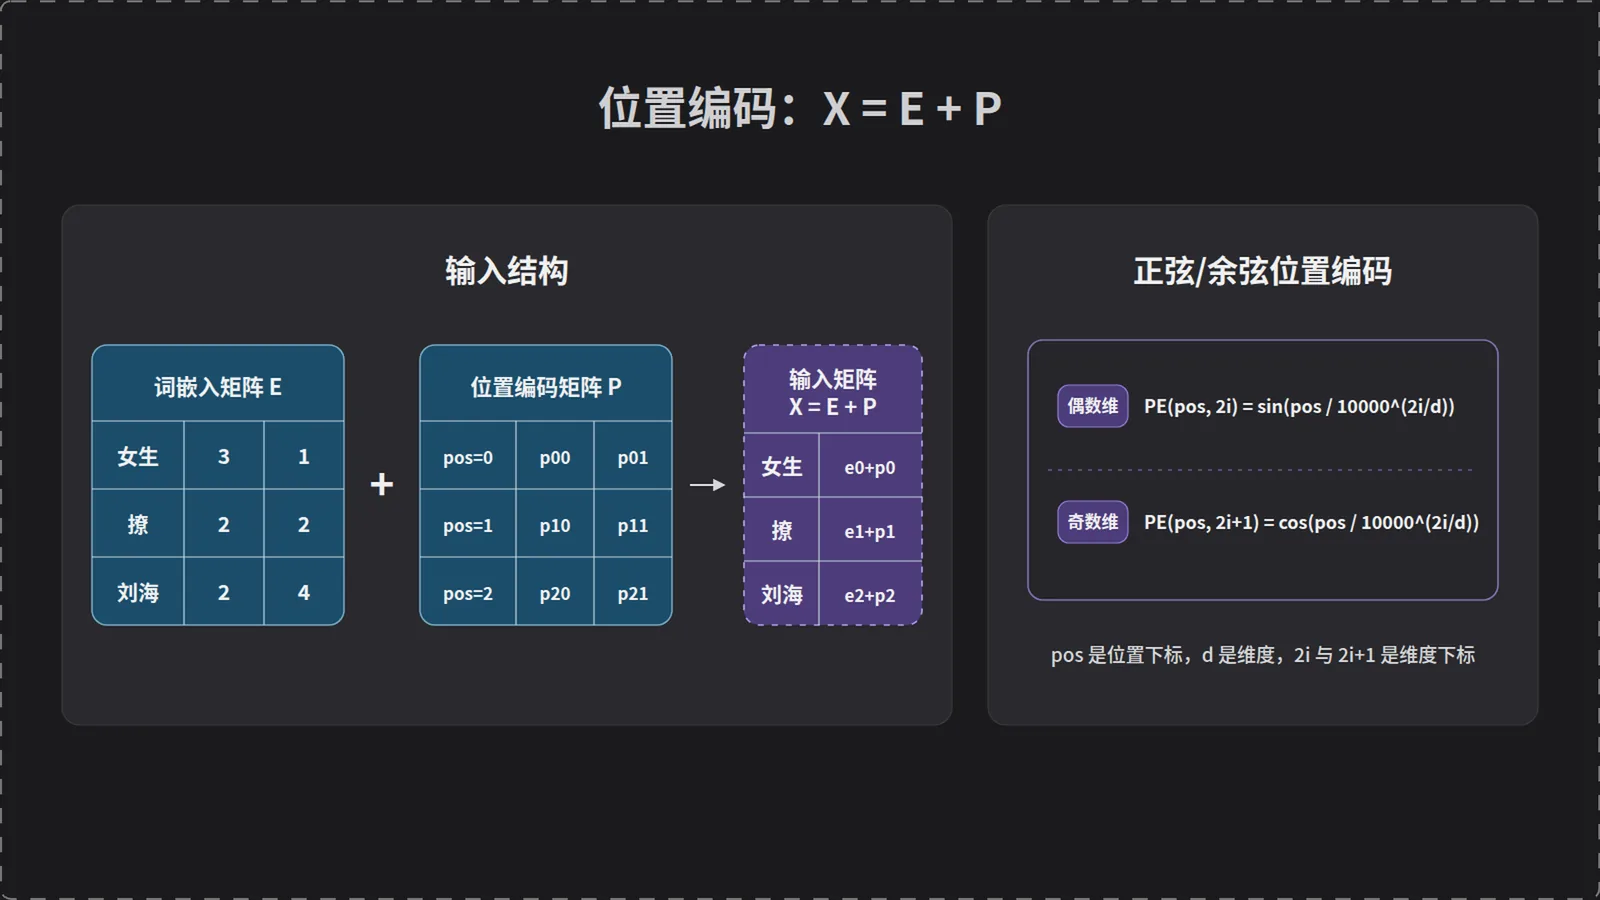
结论:X = E + P,词义向量逐元素加上位置向量。
2.1 Transformer 为什么需要位置信息
注意力的计算方式对顺序是对称的。把 E 的三行打乱,每个 token 算出来的结果只是跟着换个行号,内容一模一样。「女生撩刘海」和「刘海撩女生」在 E 这一层没有区别。
RNN 靠逐步递推天然携带顺序,Transformer 为了并行把递推拆掉了,代价就是必须显式补一个位置向量。位置从 0 开始数:女生 = 0,撩 = 1,刘海 = 2。
2.2 正弦余弦公式
PE(pos, 2i) = sin( pos / 10000^(2i/d) ) 偶数维PE(pos, 2i+1) = cos( pos / 10000^(2i/d) ) 奇数维pos 是 token 的位置下标,d 是向量维度,2i 和 2i+1 是维度下标。同一对维度共用一个频率,偶数维走 sin,奇数维走 cos。
维度下标越大,分母 10000^(2i/d) 越大,角度越小,对应的波长越长。低维负责区分相邻位置,高维负责刻画长距离——一组不同频率的波叠在一起,把绝对位置编成了一个唯一的向量。
2.3 “刘海”的位置向量
本例 d = 2,只有第 0 维和第 1 维,i 只能取 0。于是 2i/d = 0,10000^0 = 1,角度就等于 pos 本身。
刘海排第三,下标 pos = 2:
PE(2, 0) = sin(2) = 0.9093PE(2, 1) = cos(2) = -0.4161三个位置全部算完:
P = [[0.0000, 1.0000] pos=0 sin0=0, cos0=1 [0.8415, 0.5403] pos=1 [0.9093, -0.4161]] pos=22.4 输入矩阵 X = E + P
形状相同,逐元素相加:
女生 [3, 1] + [0.0000, 1.0000] = [3.0000, 2.0000]撩 [2, 2] + [0.8415, 0.5403] = [2.8415, 2.5403]刘海 [2, 4] + [0.9093, -0.4161] = [2.9093, 3.5839]X 就是真正送进注意力层的东西。「女生」的第 1 维从 1 变成 2,多出来的那个 1 全部来自位置;「刘海」的第 1 维反而被压低了 0.42。同一个词出现在不同位置,进注意力层的向量不同。
三、QKV:一个输入,三个角色
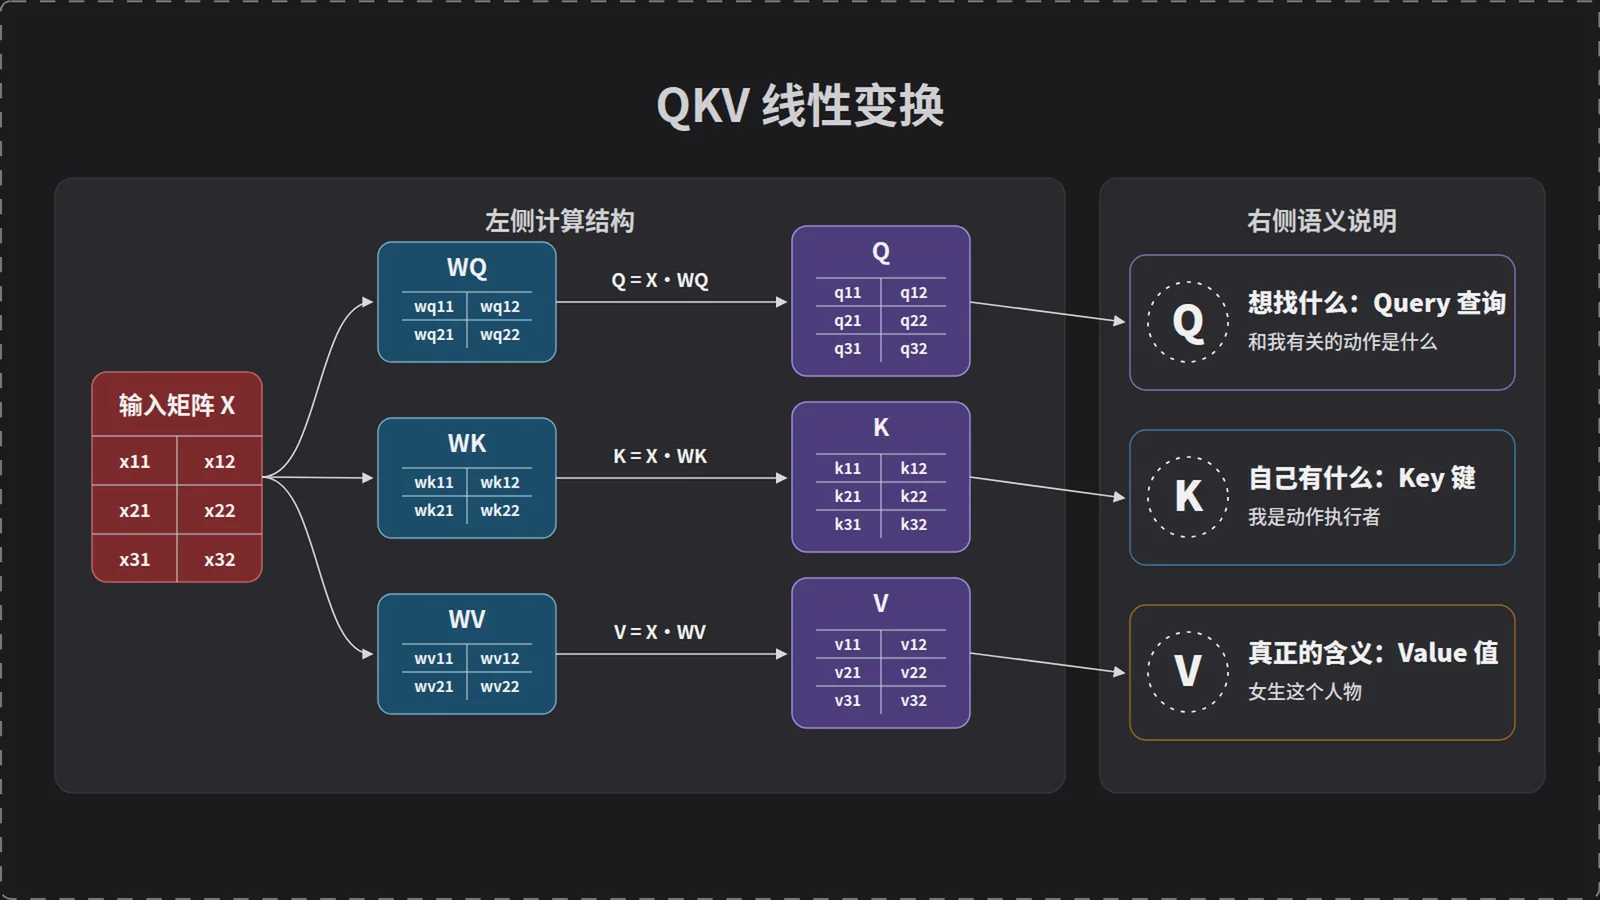
结论:Q = X·W_Q,K = X·W_K,V = X·W_V。三个矩阵形状相同、来源相同,差别全在三个参数矩阵上。
3.1 X 乘三个参数矩阵
W_Q、W_K、W_V 都是 2×2(真实模型是 d_model × d_k),训练前随机初始化,是这一层里仅有的可学参数。本例取:
[ 0.8, -0.5]] [-0.1, 1.4]] [-0.4, 1.2]]算「女生」这一行,X 的第一行是 [3, 2]:
Q女生 = [3×(-0.6) + 2×0.8 , 3×0.9 + 2×(-0.5)] = [-0.2000, 1.7000]K女生 = [3×0.6 + 2×(-0.1) , 3×0.1 + 2×1.4 ] = [ 1.6000, 3.1000]V女生 = [3×1.0 + 2×(-0.4) , 3×(-0.5) + 2×1.2] = [ 2.2000, 0.9000]另外两行同样算法,三个矩阵齐了:
Q = [[-0.2000, 1.7000] K = [[1.6000, 3.1000] V = [[2.2000, 0.9000] [ 0.3274, 1.2872] [1.4509, 3.8406] [1.8254, 1.6276] [ 1.1215, 0.8264]] [1.3872, 5.3083]] [1.4758, 2.8460]]3.2 Q/K/V 各自想表达什么
同一个 X 做三次线性变换,得到三份不同的投影,各自承担一个角色。
Q(Query)是「我想找什么」。「女生」作为主语,它缺的信息是「和我相关的动作、动作的对象是什么」。
K(Key)是「我这儿有什么」。「撩」的 K 里带着「我是一个动作」的标签,等着被检索。
V(Value)是「我实际要交出去的内容」。「女生」的 V 承载的是「人物、女性、动作发出者」这类含义。
拆成三份而不是直接拿 X 互相点积,是为了让匹配用的表示和传递用的表示解耦。判断两个词相不相关时看重的特征,和相关之后要传过去的内容,不是同一批信息。W_Q 和 W_K 学的是检索规则,W_V 学的是内容打包方式。
四、注意力分数:token 之间的关注程度
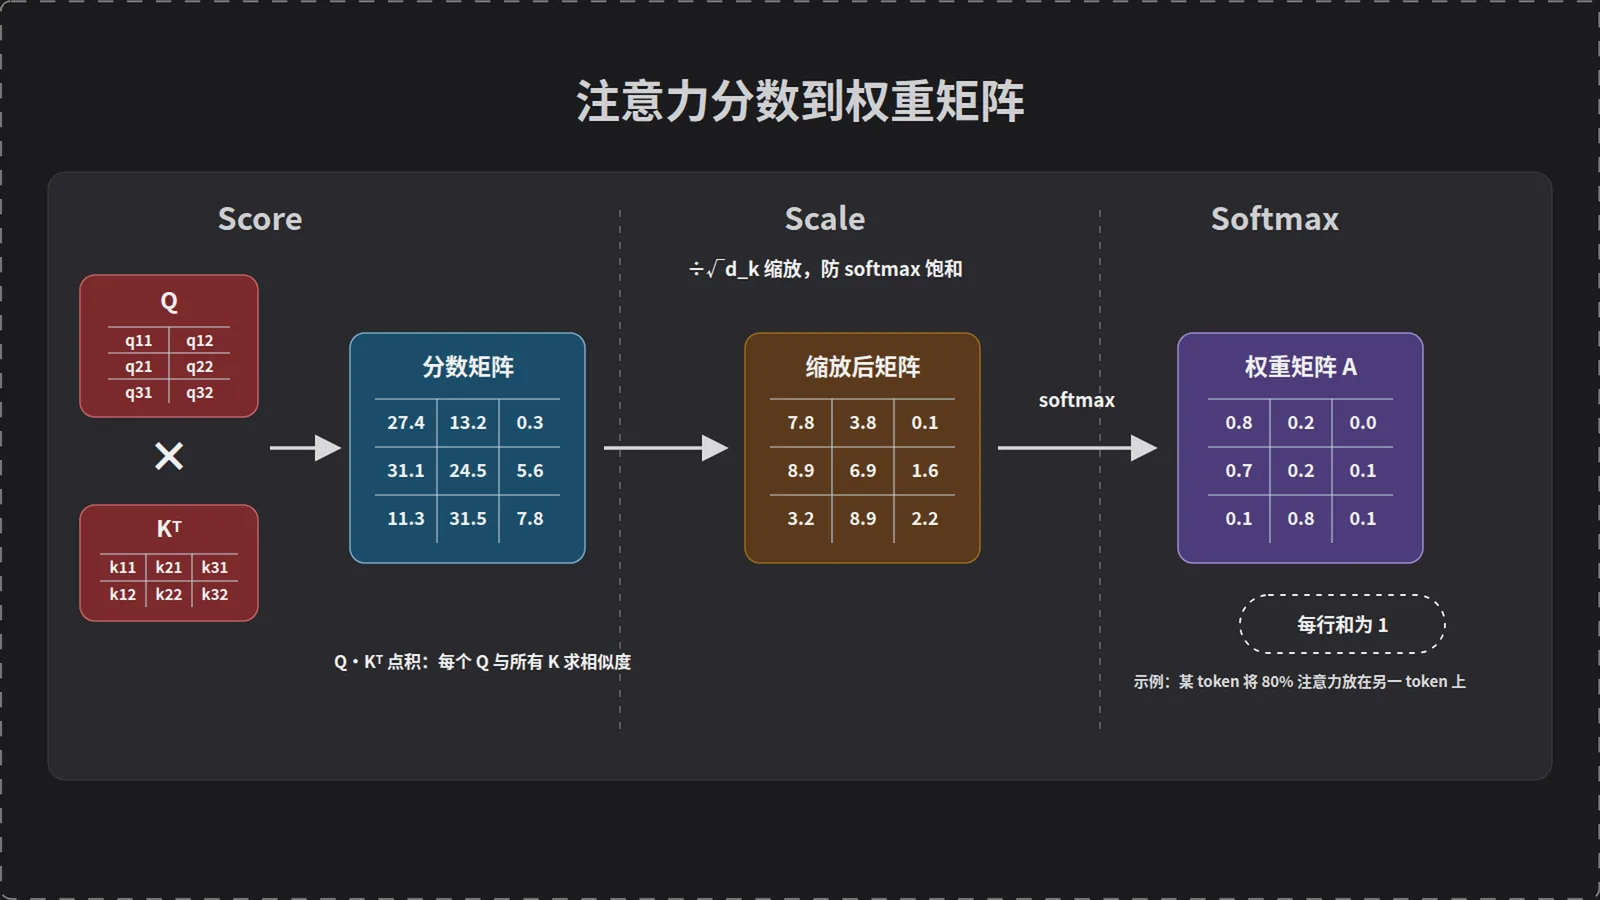
S = Q·Kᵀ / √d_k,得到一个 3×3 矩阵,第 i 行第 j 列表示第 i 个 token 对第 j 个 token 的关注强度。
4.1 Q·Kᵀ 点积
Q 的每一行跟 K 的每一行做点积。点积衡量方向的一致程度,两个向量指得越接近、模越大,值越大。
计算「撩」对「刘海」,落在第 2 行第 3 列:
Q撩 = [0.3274, 1.2872]K刘海 = [1.3872, 5.3083]0.3274×1.3872 + 1.2872×5.3083 = 0.4542 + 6.8326 = 7.2868九个格子全部填满:
Q·Kᵀ = [[4.9500, 6.2388, 8.7467] ← 女生 对 女生/撩/刘海 [4.5140, 5.4184, 7.2868] ← 撩 [4.3564, 4.8011, 5.9428]] ← 刘海矩阵不对称。「女生」对「刘海」是 8.7467,「刘海」对「女生」是 4.3564——关注是单向的,主语找宾语的力度,和宾语回头找主语的力度不一样。
4.2 为什么除以 √d_k
d_k 是键向量的维度,本例 d_k = 2,√2 ≈ 1.4142。每个元素除以它:
S = [[3.5002, 4.4115, 6.1849] [3.1919, 3.8314, 5.1526] [3.0804, 3.3949, 4.2022]]点积是 d_k 个乘积项求和,各维度大致独立时,和的方差随 d_k 线性增长,标准差按 √d_k 增长。d_k = 64 的分数波动幅度是 d_k = 1 的 8 倍,而模型维度动辄几百上千。
分数波动越大,后面的 softmax 越接近 one-hot。把上面第一行不缩放直接 softmax,得到 [0.020, 0.074, 0.906];缩放后是 [0.055, 0.137, 0.808]。d_k = 2 时差距还不明显,把这一行整体放大 8 倍(对应 d_k 上到 128 的量级),结果直接塌成 [0, 0, 1]。
代价落在梯度上,softmax 输出逼近 0 或 1 时,它对输入的导数趋近于 0,反向传播回来的梯度几乎消失,这一层就不再更新了。除以 √d_k 把分数的标准差拉回 1 附近,softmax 停在还有梯度的区间里。
五、Softmax:分数变权重
A = softmax(S),逐行归一化,每行和为 1。
softmax 把一行实数换算成一组占比:先对每个数取 e^x,再除以行内总和。取指数有两个作用——把负数也变成正数,同时放大差距,原本大的数占比更大。
计算第一行 [3.5002, 4.4115, 6.1849]:
e^3.5002 = 33.12e^4.4115 = 82.42e^6.1849 = 485.6行和 = 601.1 33.12 / 601.1 = 0.055182.42 / 601.1 = 0.1371485.6 / 601.1 = 0.8078三行都算完,得到注意力权重矩阵:
A = [[0.0551, 0.1371, 0.8078] ← 女生 [0.1000, 0.1896, 0.7104] ← 撩 [0.1838, 0.2518, 0.5644]] ← 刘海第一行读出来:「女生」把 80.8% 的注意力给了「刘海」,13.7% 给「撩」,只留 5.5% 给自己。第二行「撩」有 71% 落在「刘海」上,动作和它的宾语绑在一起。第三行「刘海」分布最平,56% 留给自己,剩下的分散给前面两个词。
工程实现里,取指数之前要先减去行内最大值。分子分母同时除以同一个常数,数学结果不变,但能避开溢出——真实模型里分数上到 800 的时候,e^800 直接是 inf。
六、加权求和:Z = A·V
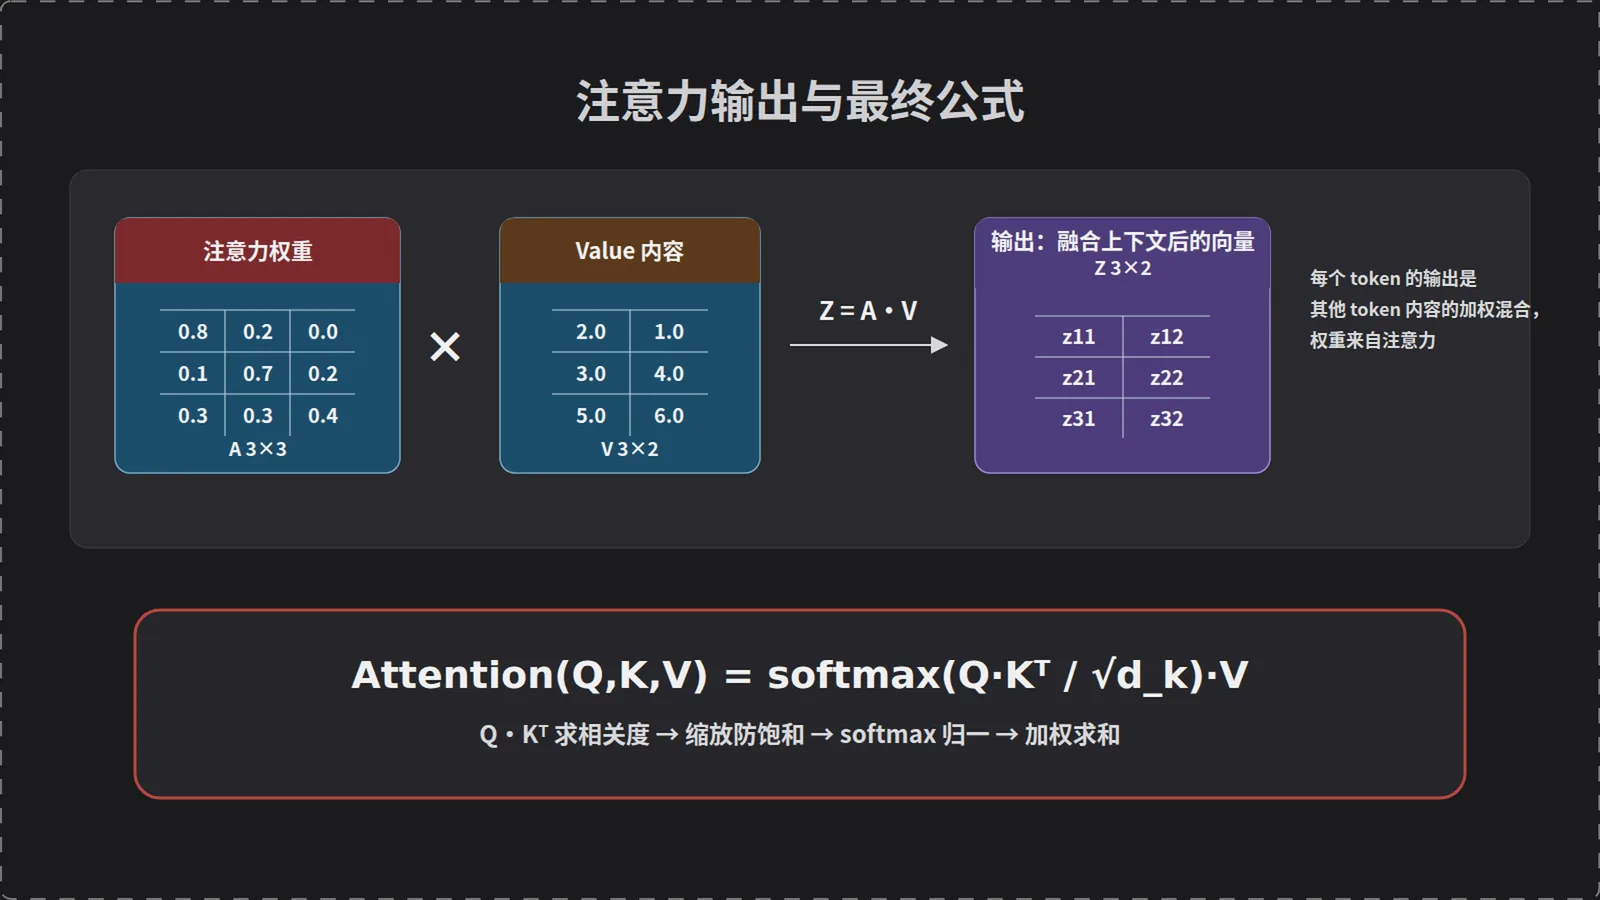
拿 A 的每一行当权重去混合 V 的三行,得到每个 token 的新表示。
计算「女生」这一行:
Z女生 = 0.0551 × [2.2000, 0.9000] + 0.1371 × [1.8254, 1.6276] + 0.8078 × [1.4758, 2.8460] 第 0 维:0.1212 + 0.2503 + 1.1921 = 1.5636第 1 维:0.0496 + 0.2231 + 2.2989 = 2.5716 Z女生 = [1.5636, 2.5716]三行合起来:
Z = [[1.5636, 2.5716] ← 女生 [1.6145, 2.4204] ← 撩 [1.6969, 2.1815]] ← 刘海对照一下进来的 X女生 = [3.0000, 2.0000] 和出去的 Z女生 = [1.5636, 2.5716]。向量被改写了,改写的方向由权重决定:80% 的分量来自「刘海」的 V = [1.4758, 2.8460],Z女生 明显朝它靠了过去。这就是「女生」在这一层里拿到的上下文——它不再是一个孤立的词向量,而是一个知道自己和「刘海」强相关的表示。
Z 和 X 形状相同,都是 3×2。注意力层不改变序列长度,也不改变维度,只改写内容,所以它能一层一层叠上去,每叠一层,每个 token 融合进来的上下文就更广一圈。
七、缩放点积注意力
7.1 完整公式
将前面六步压缩成一行:
逐段对回去:Q·Kᵀ 是第四节的点积打分,/ √d_k 是第四节的缩放,softmax 是第五节的归一化,末尾的 · V 是第六节的加权求和。
公式里没出现的是查表、位置编码和三个 W——它们在这个函数之外,函数拿到的已经是算好的 Q、K、V。注意力函数本身只做四件事:点积、缩放、归一化、加权求和,一个可学参数都没有。模型学到的全部东西,都在 W_Q、W_K、W_V 和词嵌入表里。
7.2 最小 Python 实现
import numpy as np # 只依赖 numpy,不用任何深度学习框架 # ========== 第一步:分词与词嵌入 ==========tokens = ["女生", "撩", "刘海"] # 分词器切出来的三个 tokenvocab_id = {"女生": 1258, "撩": 875, "刘海": 9527} # 每个 token 在词表里的固定编号d_model = 2 # 向量维度,真实模型是几千维,这里压到 2 维方便手算 embedding_table = np.zeros((10000, d_model)) # 词嵌入表:词表大小 × 维度,训练前是随机数embedding_table[1258] = [3.0, 1.0] # 把「女生」那一行固定成手算用的值embedding_table[875] = [2.0, 2.0] # 「撩」embedding_table[9527] = [2.0, 4.0] # 「刘海」 ids = [vocab_id[t] for t in tokens] # 按句子顺序取出三个 IDE = embedding_table[ids] # 按 ID 从整张词嵌入表取出三行,得到当前句子的 3×2 矩阵 E # ========== 第二步:位置编码 ==========def positional_encoding(seq_len, d): # 生成 seq_len × d 的位置编码矩阵 P = np.zeros((seq_len, d)) # 先开一个全 0 矩阵 for pos in range(seq_len): # pos 是 token 的位置下标,从 0 开始数 for i in range(d // 2): # i 遍历维度对,每对占 2i 和 2i+1 两个维度 angle = pos / (10000 ** (2 * i / d)) # 公式里 sin/cos 括号中的角度 P[pos, 2 * i] = np.sin(angle) # 偶数维用 sin P[pos, 2 * i + 1] = np.cos(angle) # 奇数维用 cos return P # 返回位置编码矩阵 P P = positional_encoding(len(tokens), d_model) # 本例 3 个位置、2 个维度X = E + P # 输入矩阵 = 词义 + 位置,逐元素相加 # ========== 第三步:三个投影矩阵 ==========W_Q = np.array([[-0.6, 0.9], # 查询投影矩阵,训练中由梯度更新 [0.8, -0.5]])W_K = np.array([[0.6, 0.1], # 键投影矩阵 [-0.1, 1.4]])W_V = np.array([[1.0, -0.5], # 值投影矩阵 [-0.4, 1.2]]) # ========== 第四到六步:缩放点积注意力 ==========def softmax(scores): # 按行做 softmax m = scores.max(axis=1, keepdims=True) # 取每行最大值 e = np.exp(scores - m) # 减最大值再取指数,防止 e^x 溢出,结果不变 return e / e.sum(axis=1, keepdims=True) # 除以行和,每行归一化成和为 1 的权重 def attention(X, W_Q, W_K, W_V): # 缩放点积注意力的完整计算 Q = X @ W_Q # Q:每个 token 想找什么信息 K = X @ W_K # K:每个 token 自己带着什么信息 V = X @ W_V # V:每个 token 实际要传出去的内容 d_k = K.shape[1] # 键向量的维度,本例为 2 raw = Q @ K.T # Q 与所有 K 做点积,得到 3×3 的原始分数 S = raw / np.sqrt(d_k) # 除以 √d_k 压住量级,避免 softmax 饱和 A = softmax(S) # 分数转成每行和为 1 的注意力权重 Z = A @ V # 按权重混合三行 V,得到融合上下文的新表示 return Q, K, V, raw, S, A, Z # 中间结果一并返回,方便逐步核对 Q, K, V, raw, S, A, Z = attention(X, W_Q, W_K, W_V) # 跑一遍完整流程 np.set_printoptions(precision=4, suppress=True) # 打印保留 4 位小数,关掉科学计数法for name, mat in [("E", E), ("P", P), ("X", X), # 依次打印每一步的中间矩阵 ("Q", Q), ("K", K), ("V", V), ("Q·Kᵀ", raw), ("S", S), ("A", A), ("Z", Z)]: print(f"{name} =\n{mat}\n") # 输出与正文里手算的数字一致真正的 Transformer 在 Z 之后还接着输出投影、残差连接、LayerNorm 和前馈网络;多头注意力则是把上面这套算法在若干个低维子空间里并行跑一遍再拼起来。但是那些是后面的内容,注意力机制本身算到 Z 就结束了。
本文由 AgentPlanFlow 生成