Yinchen 的博客
首页
分类
归档
关于
首页
分类
归档
关于
登录
标签:Transformer
清除筛选
从 Transformer 到大模型
2026/09/12
大模型
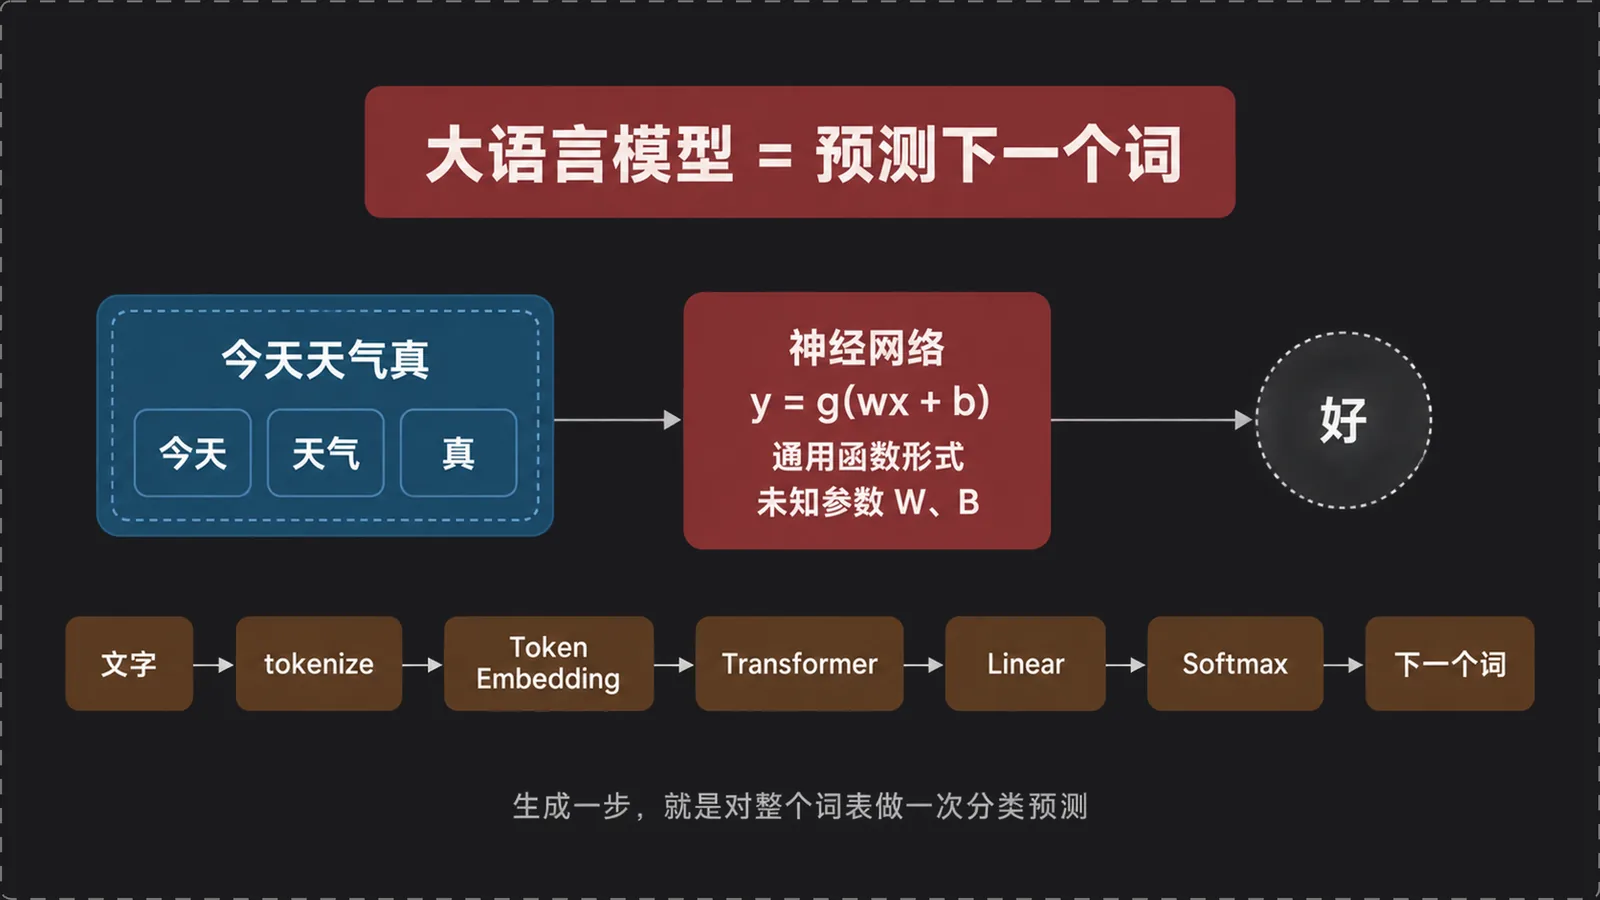
视频素材:[【闪客】一小时从 Transformer 到大模型!] 一、大模型是一台「预测下一个词」的机器 给定一串文字,求下一个词,可以写成一个函数:f(多个词) → 下一个词。输入“飞天闪”,期望输出“客”;输入“今天天气真”,候选答案可能是“好”。大语言模型反复执行的就是这个计算。对话、翻译和写代码的形式看起来差别明显,但模型生成时都会从词表中选择下一个 Token,然后把新 Token 接
大语言模型原理(五):Transformer 多头注意力、残差与归一化
2026/08/19
大模型
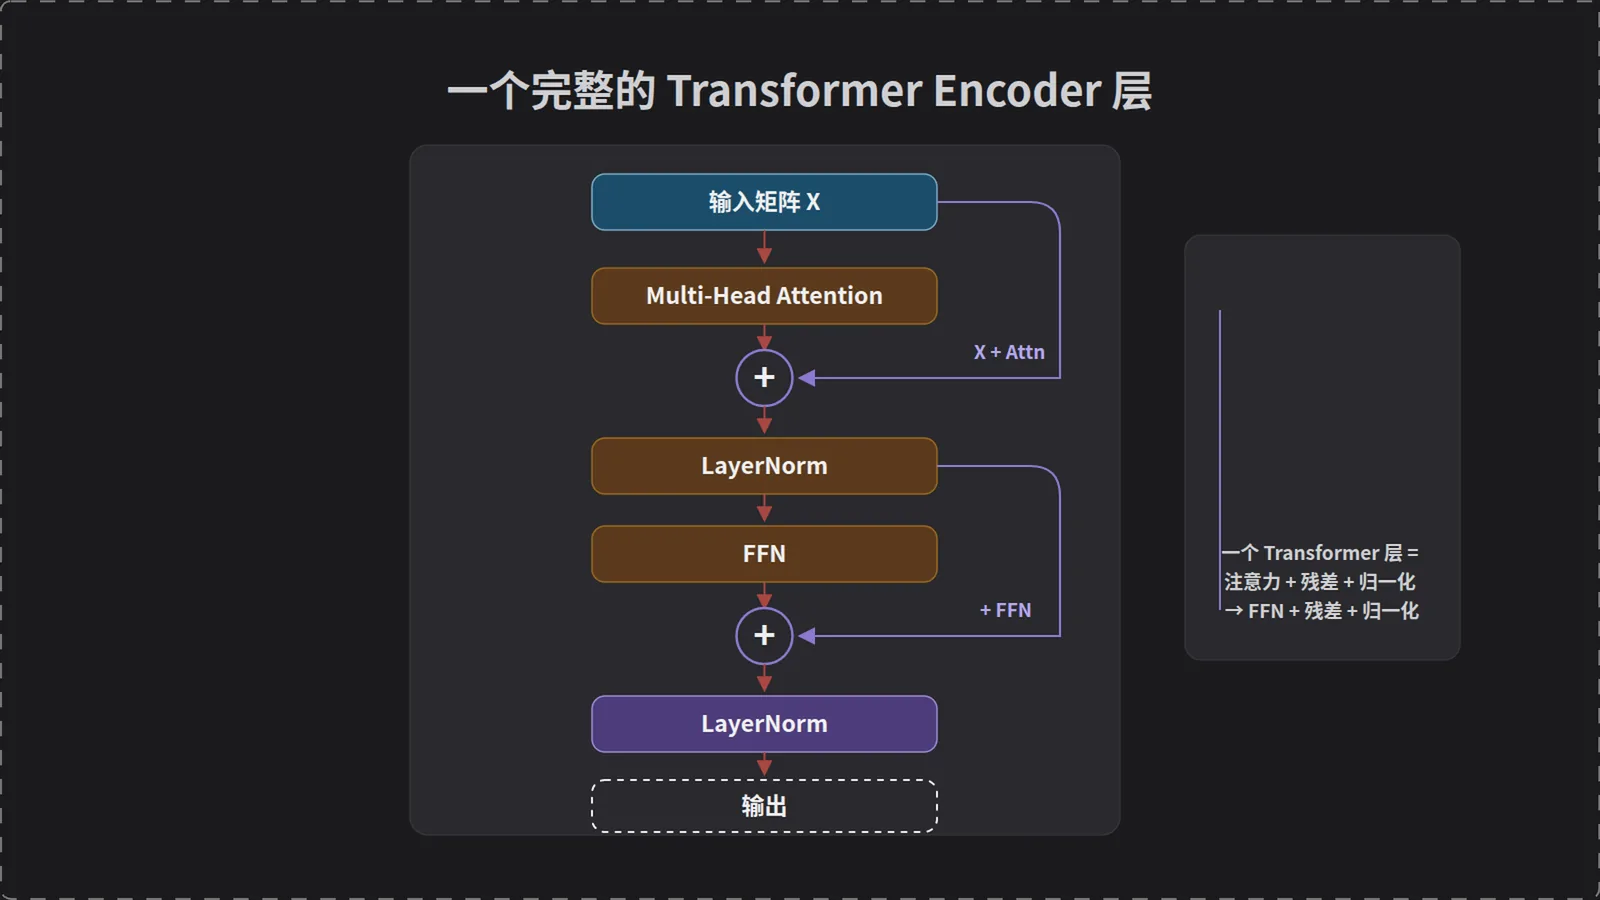
上一篇把「女生撩刘海」这三个 token 算到了注意力的输出 Z。但 Z 还不是这一层的结果。从 Z 到真正送给下一层的东西,中间还隔着多头拼接、两次残差、两次层归一化和一个前馈网络。这几步各自解决一个具体问题,去掉任何一个,模型要么学不到足够丰富的关系,要么深度一堆上去就训不动。 这一篇把它们逐个计算完,例子和维度都沿用上一篇:三个 token,d = 2。 一、回顾:注意力机制算到了哪 输入矩
大语言模型原理(四):注意力机制——缩放点积注意力公式
2026/08/19
大模型
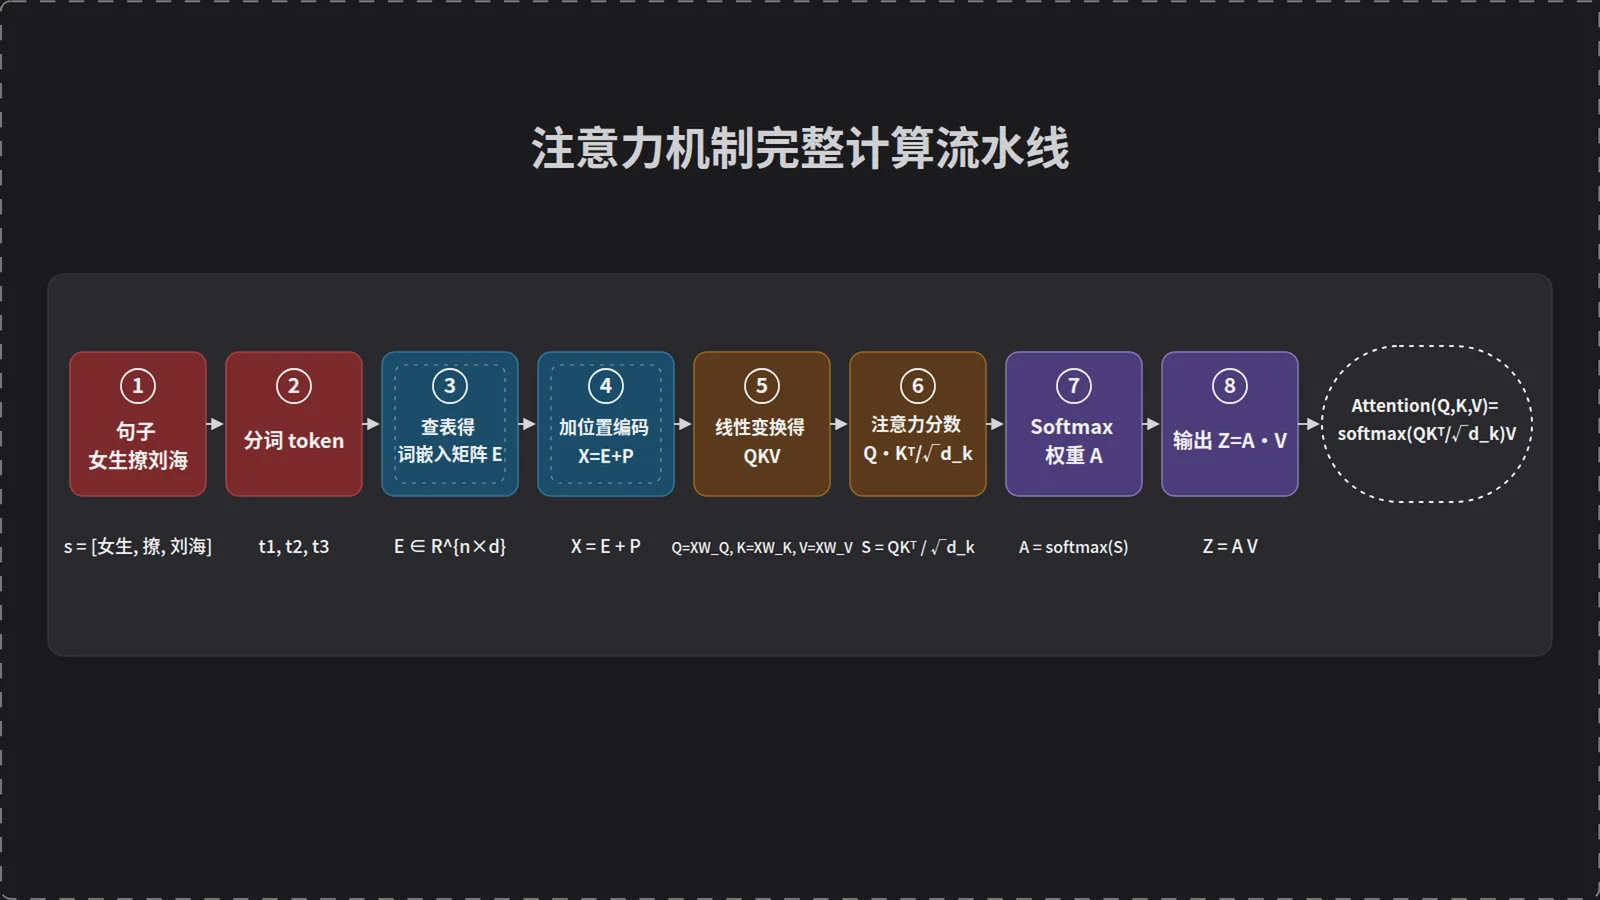
网上自注意力的讲解大多停在「让每个词看到句子里的其他词」这句比喻上。要真正搞清楚这一层在干什么,得回答四个具体问题:Q、K、V 三个矩阵从哪来,分数怎么算出来,为什么要除一个 √d_k,softmax 之后拿到的东西代表什么。 拿「女生撩刘海」这三个 token 为例,把向量维度压到 2,从查表拿到词向量,到最后算出输出矩阵 Z,整条链路一路算到底。 一、一个句子怎么变成矩阵 句子进注意力层之前,
大语言模型原理(二):预训练——从随机向量到接龙大师
2026/08/19
大模型
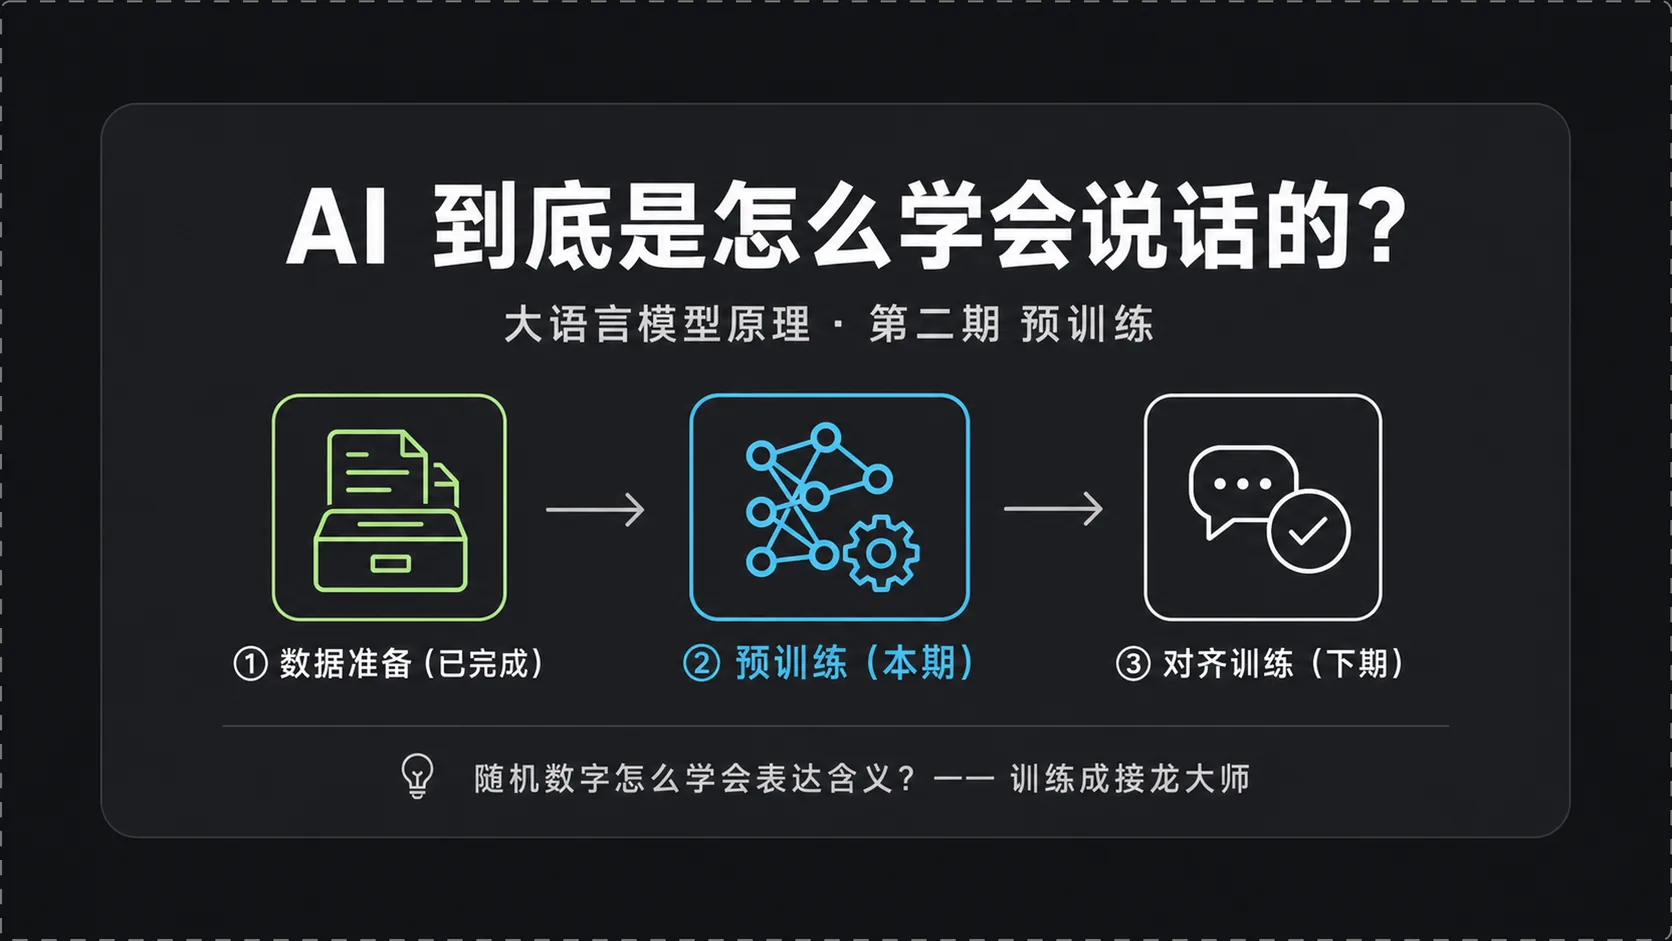
上一篇讲完了数据准备:海量文本被切成带 ID 的 token,再通过预生成的 embedding 矩阵,让每个 token 按 ID 找到自己对应的高维向量。那批向量里的数字全是随机生成的,还没有承载任何语言含义。 随机数字怎么一步步学会表达含义,答案落在第二个阶段:预训练。 一、回顾:数字还没有含义 1.1 数据准备留下的东西 数据准备结束时,模型手上有两样东西:一份把 token 映射成 ID
Transformer 与 MoE:模型骨架上的稀疏化改造
2026/08/19
大模型
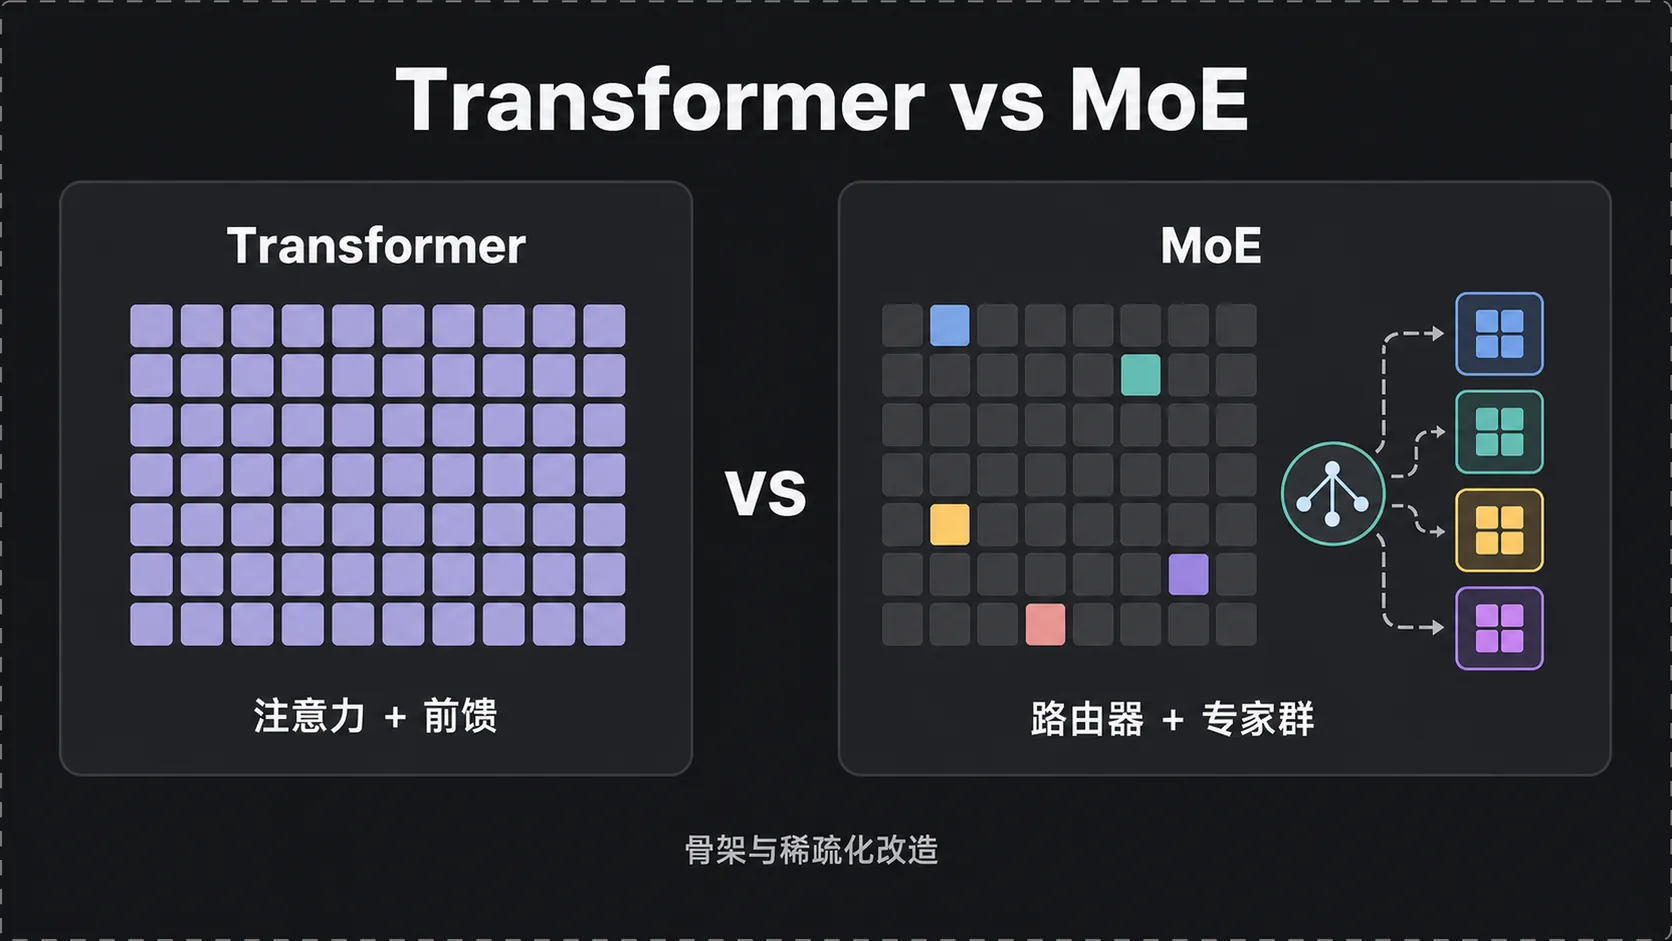
大模型发布会的话术这两年已经固定下来:总参数数万亿,MoE 架构加持,推理成本却比同级别模型低一大截。面试里也常出现同一道题,让人说清 Transformer 和 MoE 的区别,不少答案会把两者摆成并列的两种架构互相比较。 它们处在不同层级。Transformer 定义了「注意力 + 前馈」的主干结构,MoE 是在这条主干上针对前馈层做的一次去密集化改造,把单个庞大的前馈网络换成路由器加一组并行