Yinchen 的博客
首页
分类
归档
关于
首页
分类
归档
关于
登录
标签:LLM
清除筛选
大语言模型原理(四):注意力机制——缩放点积注意力公式
2026/08/19
大模型
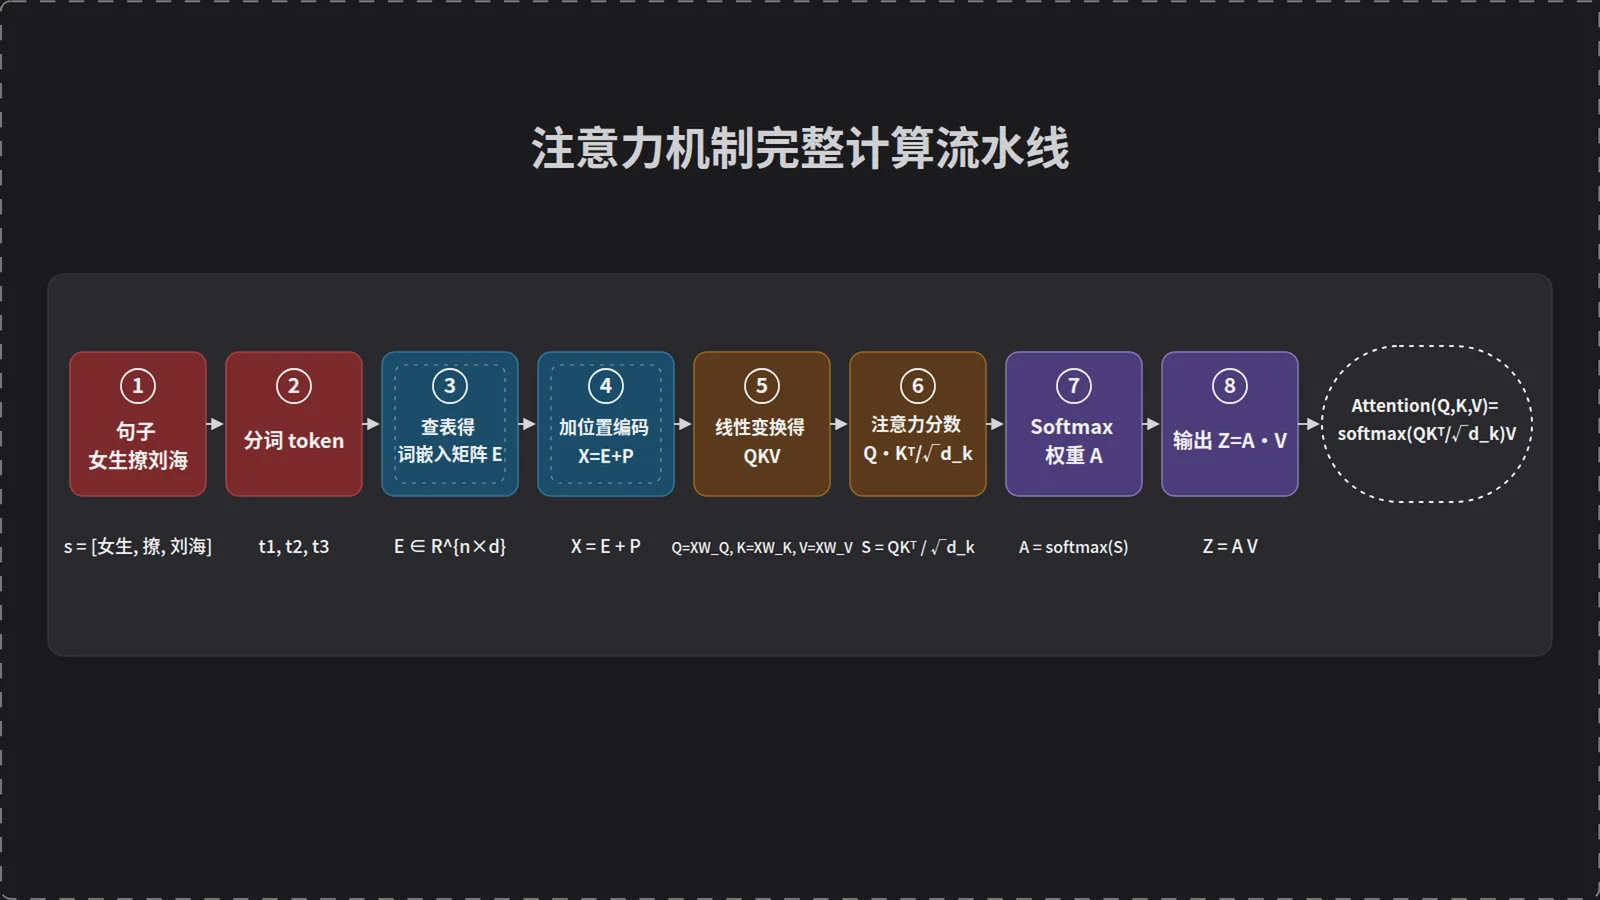
网上自注意力的讲解大多停在「让每个词看到句子里的其他词」这句比喻上。要真正搞清楚这一层在干什么,得回答四个具体问题:Q、K、V 三个矩阵从哪来,分数怎么算出来,为什么要除一个 √d_k,softmax 之后拿到的东西代表什么。 拿「女生撩刘海」这三个 token 为例,把向量维度压到 2,从查表拿到词向量,到最后算出输出矩阵 Z,整条链路一路算到底。 一、一个句子怎么变成矩阵 句子进注意力层之前,
大语言模型原理(三):后训练——让模型学会对话
2026/08/19
大模型
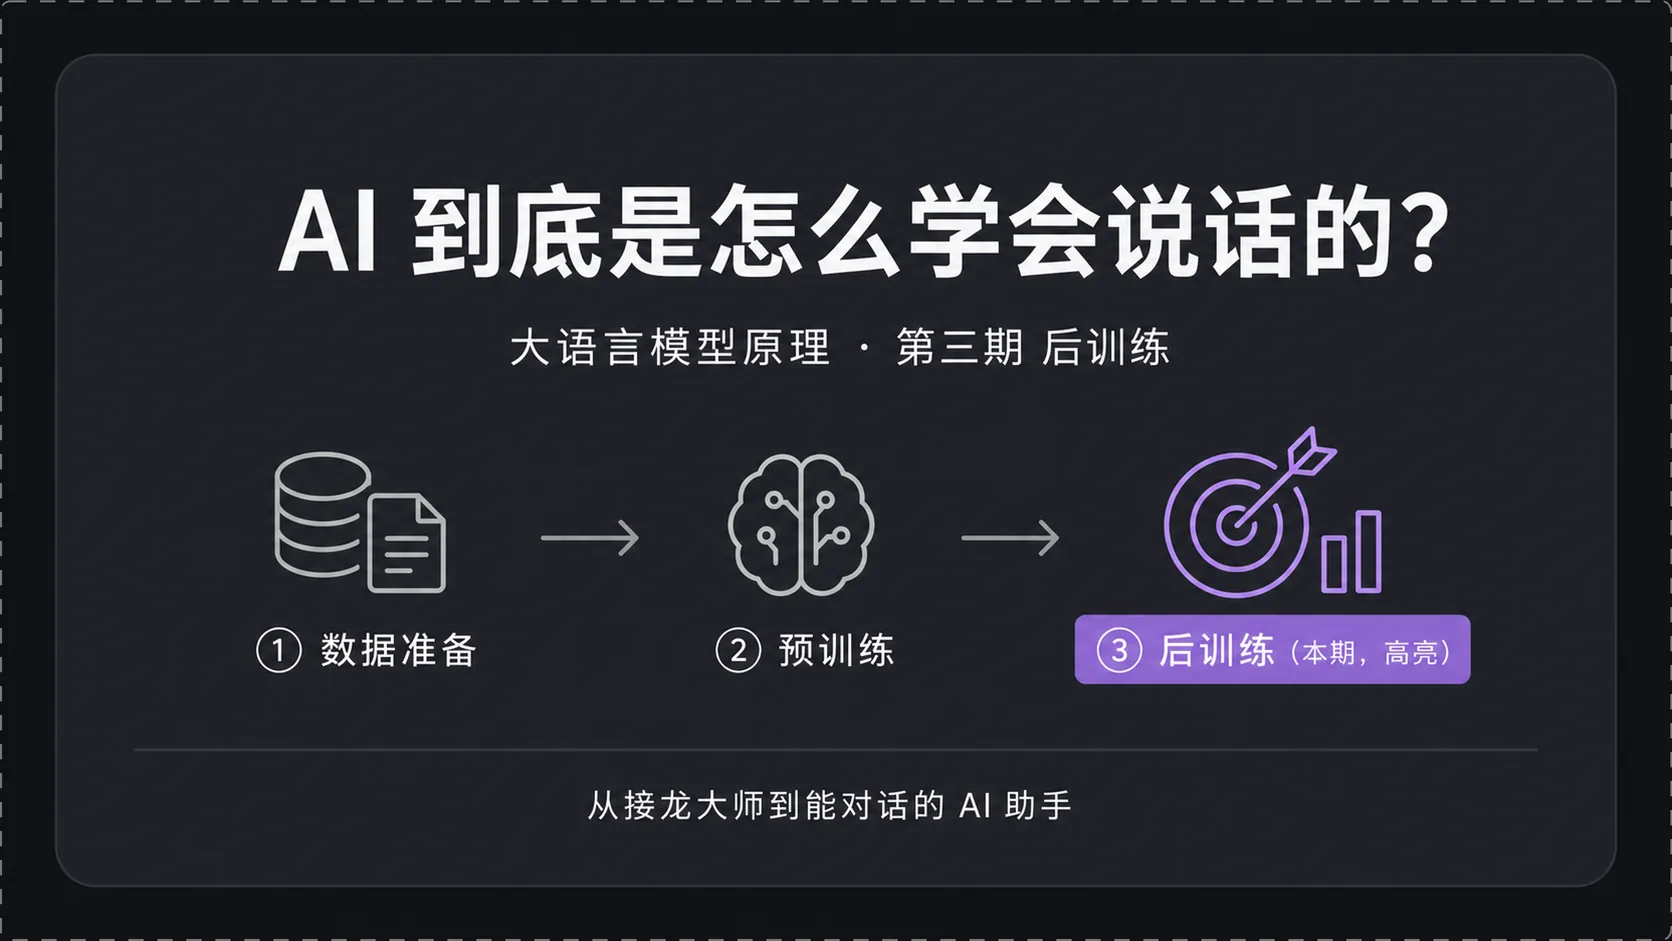
预训练结束时,手上的基座大模型只会做一件事:接着前面的内容往下续写。用户输入「我应不应该好好学习」,它回一句「天天向上」。距离一个能用的 AI 助手,还差最后一个阶段。 一、回顾:从接龙大师说起 1.1 前两个阶段做了什么 第一节讲数据准备:资料收集与清洗得到干净文本,文本切分成 token,每个 token 转换成高维向量,完成从文本到数字的转换。 第二节讲预训练:高维向量输入 Transfor
大语言模型原理(二):预训练——从随机向量到接龙大师
2026/08/19
大模型
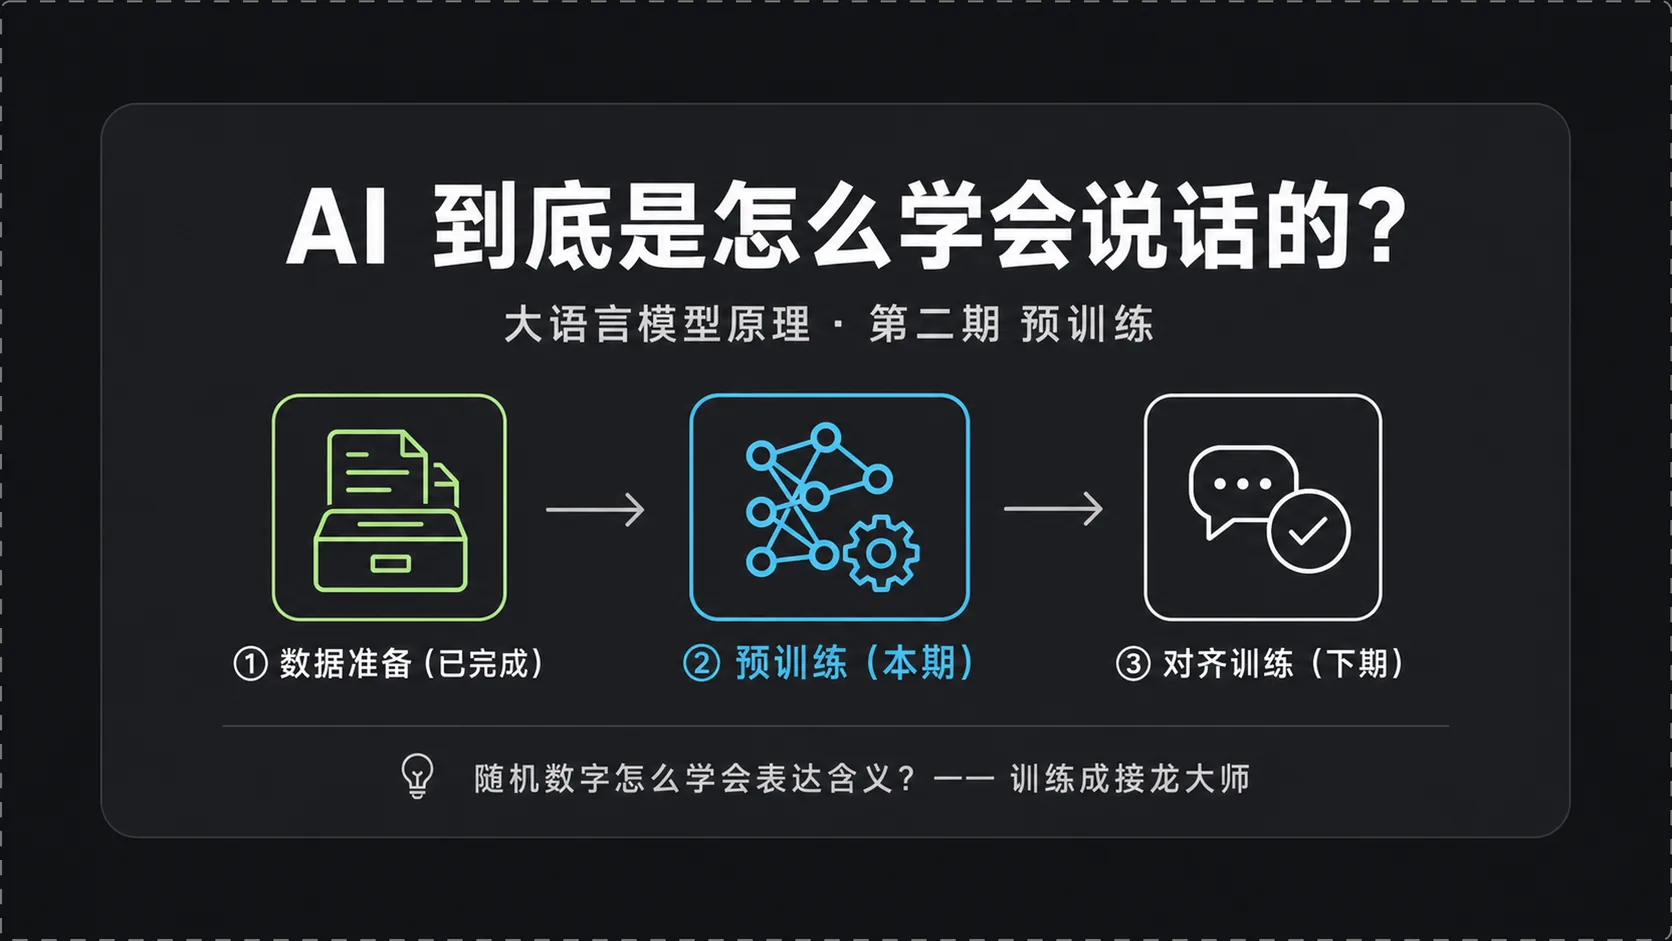
上一篇讲完了数据准备:海量文本被切成带 ID 的 token,再通过预生成的 embedding 矩阵,让每个 token 按 ID 找到自己对应的高维向量。那批向量里的数字全是随机生成的,还没有承载任何语言含义。 随机数字怎么一步步学会表达含义,答案落在第二个阶段:预训练。 一、回顾:数字还没有含义 1.1 数据准备留下的东西 数据准备结束时,模型手上有两样东西:一份把 token 映射成 ID
大语言模型原理(一):数据准备——从文本到数字
2026/08/19
大模型
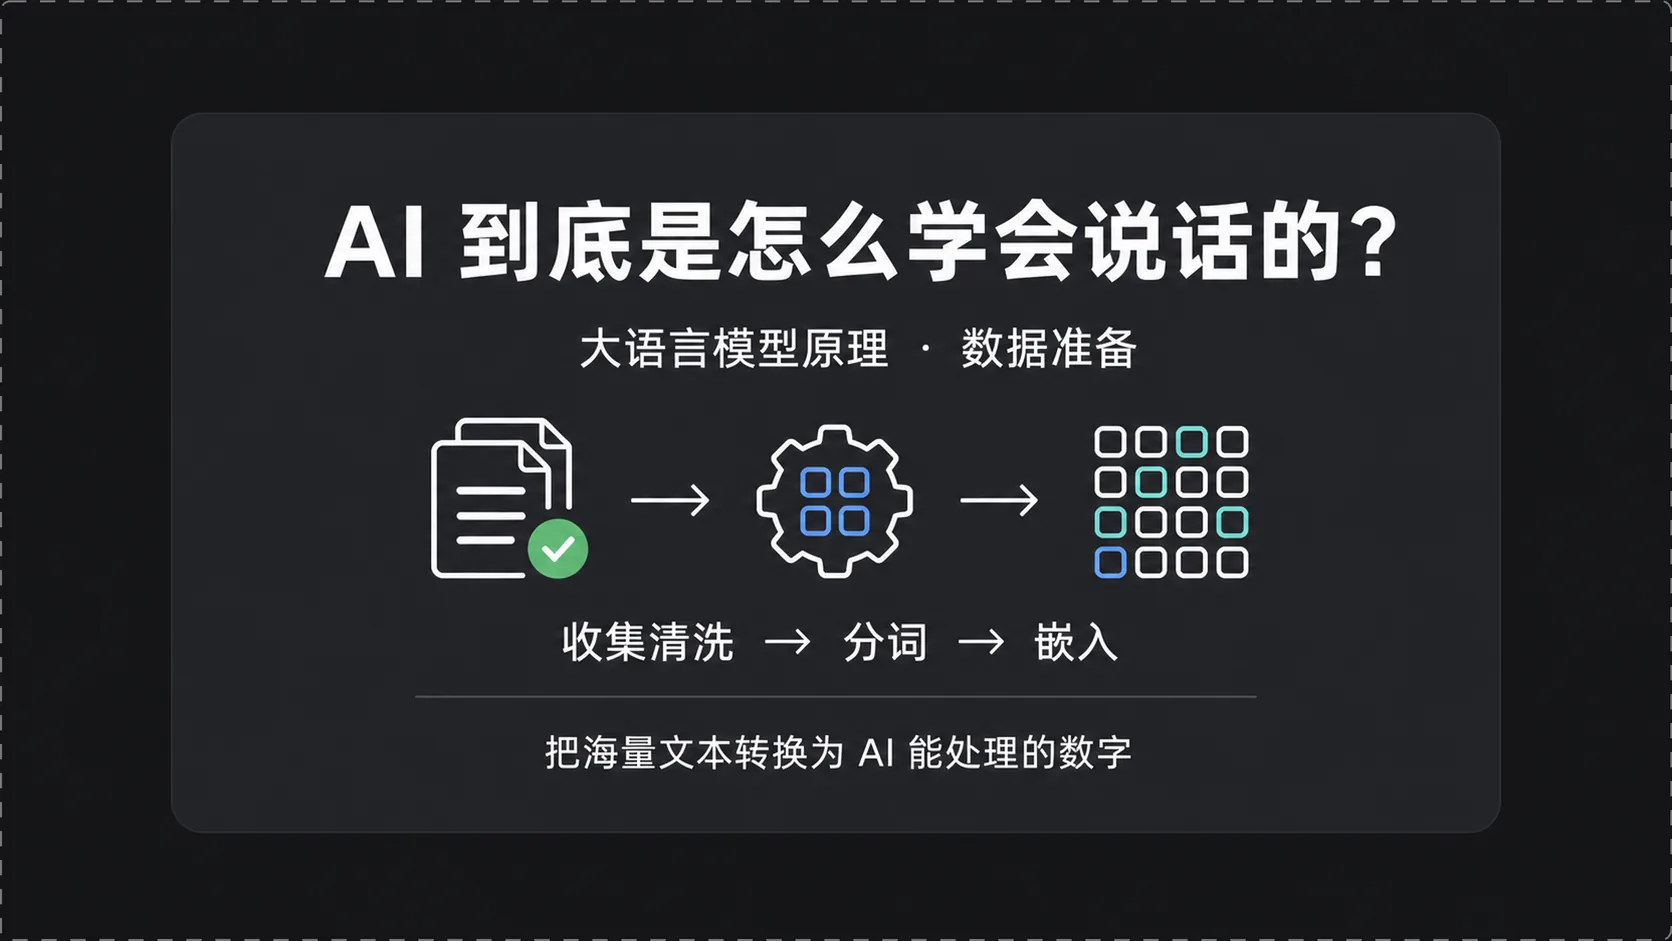
豆包、DeepSeek、ChatGPT 这类能直接对话的 AI,都属于大语言模型。模型在读懂任何一句话之前,得先把语言换成数字,因为计算机能做的只有数字计算。这步转换发生在数据准备阶段,拆开看是三件事:收集清洗、分词、嵌入。 一、三大阶段,与数据准备的目的 1.1 大模型诞生的三个阶段 一个大语言模型从无到有,要经过三个阶段:数据准备、预训练、对齐训练。 数据准备负责把原始语料整理成模型能吃进去的
Transformer 与 MoE:模型骨架上的稀疏化改造
2026/08/19
大模型
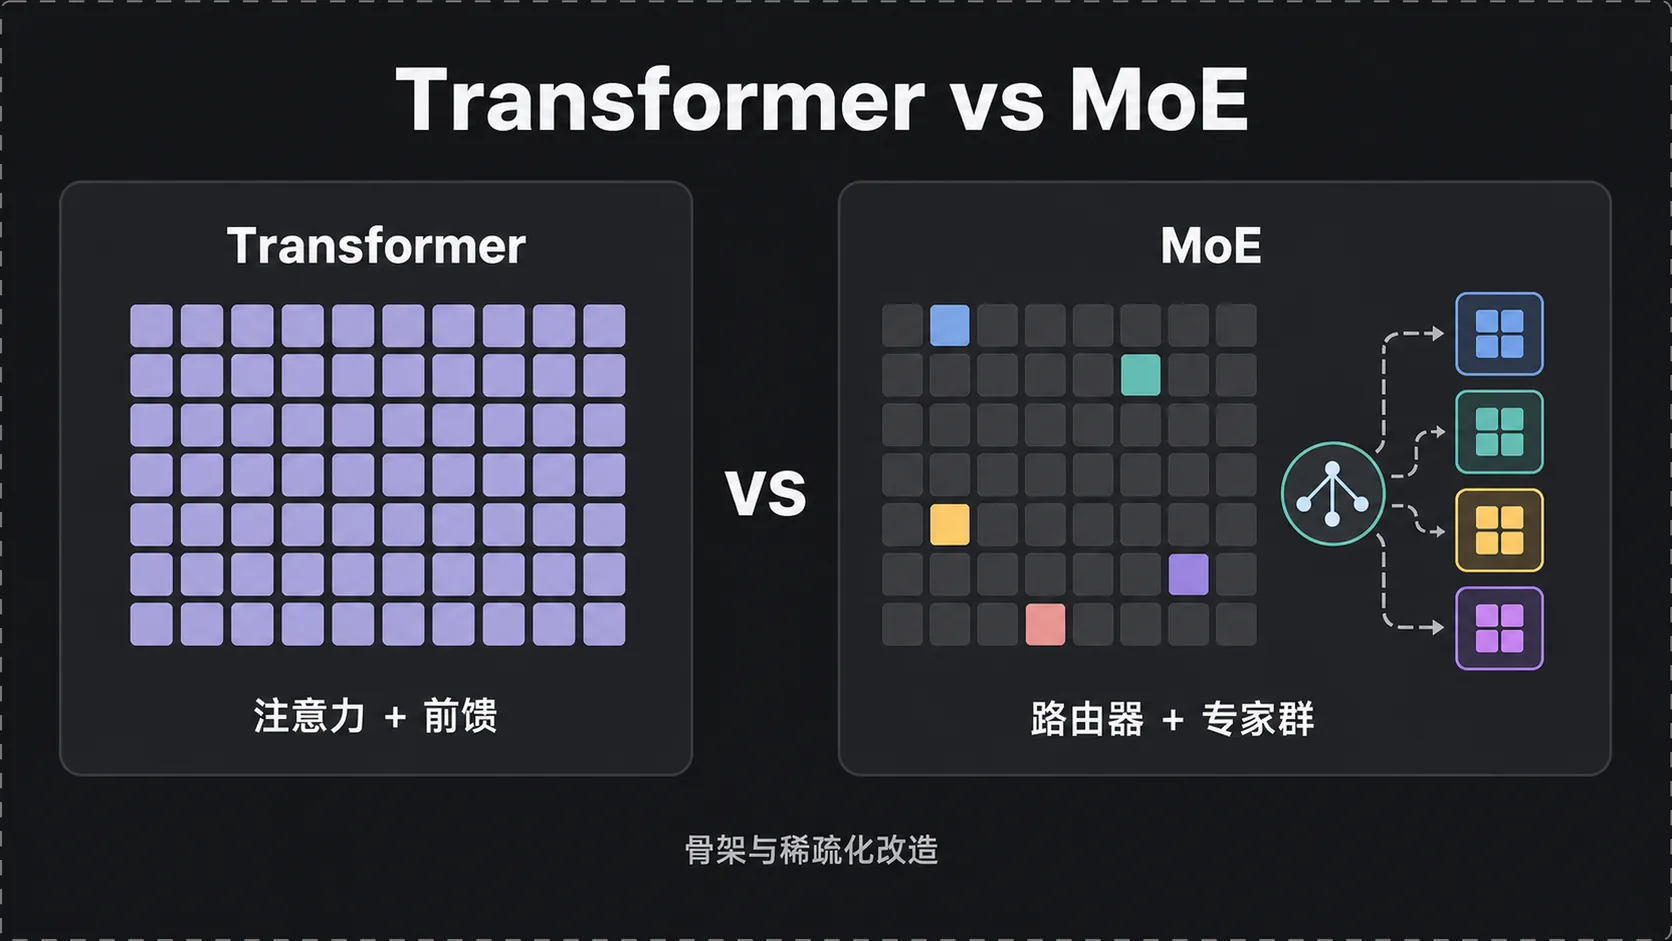
大模型发布会的话术这两年已经固定下来:总参数数万亿,MoE 架构加持,推理成本却比同级别模型低一大截。面试里也常出现同一道题,让人说清 Transformer 和 MoE 的区别,不少答案会把两者摆成并列的两种架构互相比较。 它们处在不同层级。Transformer 定义了「注意力 + 前馈」的主干结构,MoE 是在这条主干上针对前馈层做的一次去密集化改造,把单个庞大的前馈网络换成路由器加一组并行
Agent 越执行越跑偏:操作约束的丢失与注入
2026/08/19
Agent
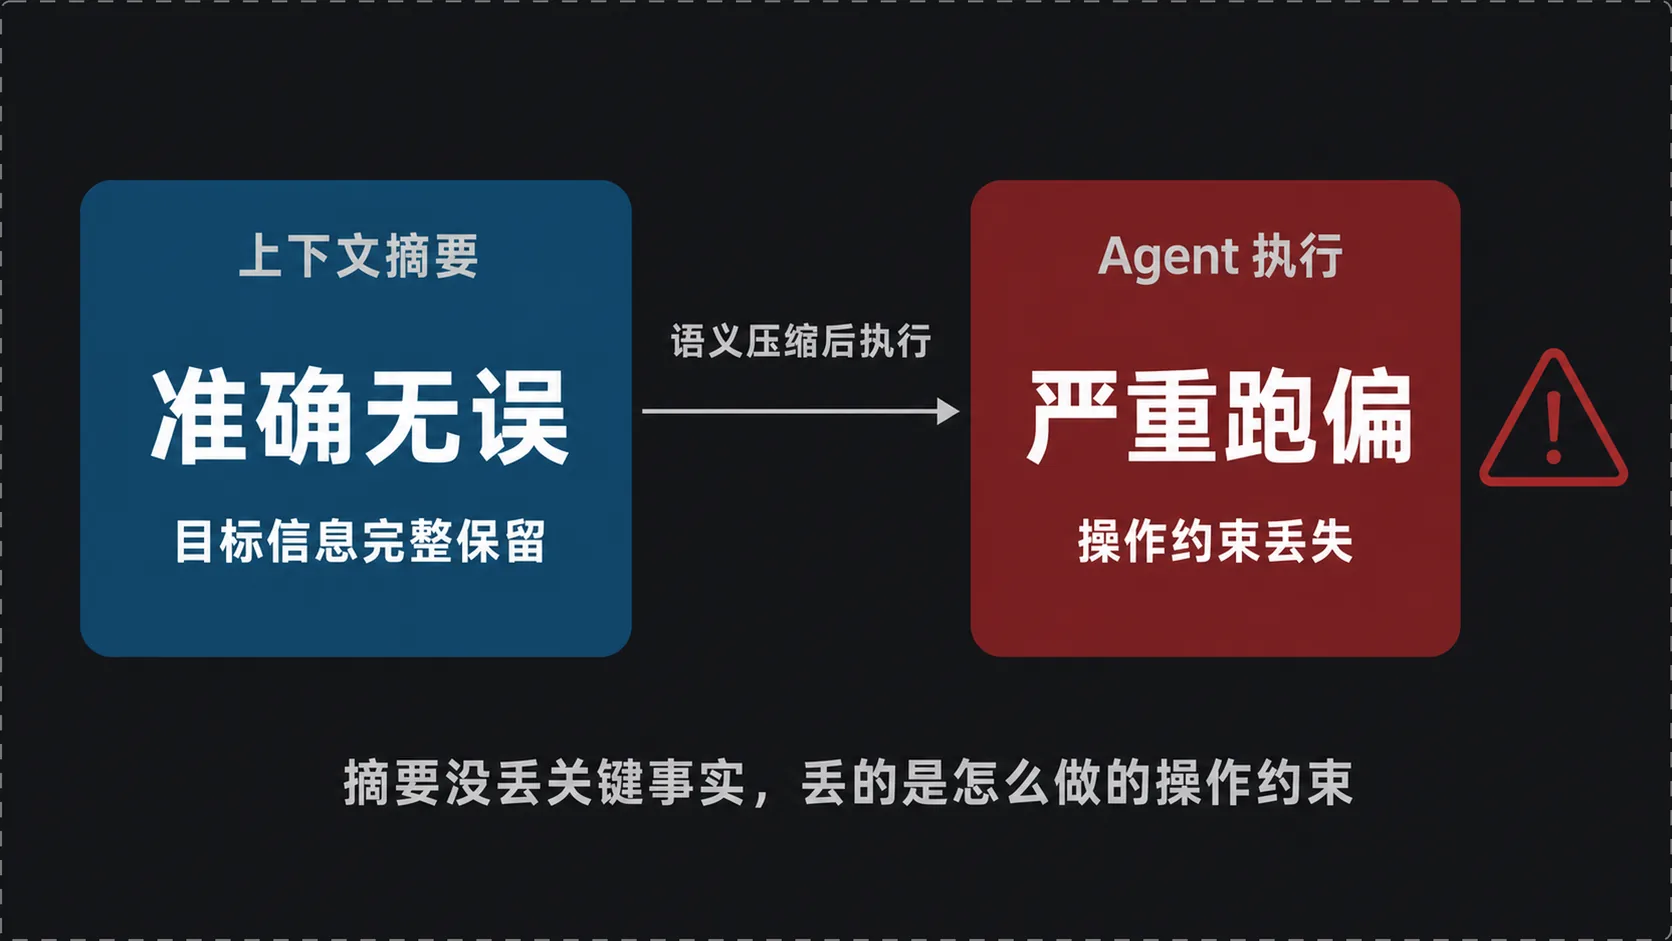
一、问题:摘要没错,执行却跑偏 1.1 现象:上下文摘要准确无误,Agent 却越执行越偏 面试里经常会问一个看似矛盾的问题:上下文摘要明明没有丢事实,Agent 为什么越执行越偏? 用一个数据任务举例:从订单表查出本月已支付订单并生成汇总报表。原始上下文里还有几条执行要求:分页查询,每页 1000 条;逐批处理,直到没有下一页;只能访问只读副本库;SQL 超时 30 秒;失败重试不超过三次。 经
上一页
2
/ 2
下一页